 VLSI Korea
Groq en profundidad: de 6.900 M$ a 3.500 M$ — el precio de lo que queda tras el acuerdo de 20.000 M$ de Nvidia
Groq cerró en agosto de 2026 una ronda de 350 M$ con una valoración reportada de 3.500 M$, cerca de la mitad de los 6.900 M$ de 2025. Tras el acuerdo de licencia de unos 20.000 M$ de Nvidia, ¿qué sostiene el precio de la nube de inferencia que queda?


Resumen en 30 segundos
Groq es una empresa estadounidense de inferencia de IA fundada en 2016 por Jonathan Ross, uno de los creadores del TPU de Google. Su LPU (Language Processing Unit) sirve tokens de LLM con ejecución deterministic y de baja latencia, y GroqCloud vende esa velocidad como API.
En agosto de 2026, Groq cerró una ronda de 350 millones de dólares liderada por Disruptive con una valoración reportada de unos 3.500 millones de dólares (unas 4,9 billones de wones a 1.400 wones por dólar), con la participación prevista de Nvidia. Es aproximadamente la mitad de los 6.900 millones de la ronda de 750 millones de septiembre de 2025.
El reinicio tiene una causa concreta. En diciembre de 2025, Nvidia firmó una licencia non-exclusive sobre la tecnología de inferencia de Groq —reportada en unos 20.000 millones de dólares— y contrató a Ross, al presidente Sunny Madra y a gran parte del equipo senior de ingeniería. El futuro del LPU se entrega ahora dentro de la plataforma Vera Rubin de Nvidia como Groq 3 LPX.
Lo que queda es otra empresa: una neocloud de inferencia con 13 centros de datos, unos seis millones de desarrolladores reportados y un plan para pasar de 54 MW de capacidad a más de 200 MW en 2027. El precio de 3.500 millones es una apuesta por esa nube, no por el chip.
Tabla resumen: Groq en cifras
| Concepto | Detalle |
|---|---|
| Fundación | 2016, Mountain View — Jonathan Ross |
| Producto principal | LPU (Language Processing Unit) / GroqCloud |
| Memoria del LPU | ~230 MB de SRAM en chip, ~80 TB/s de ancho de banda en el die |
| Proceso de 1.ª generación | GlobalFoundries 14 nm |
| Ronda de ago. de 2024 | 640 millones captados, valoración de 2.800 millones |
| Ronda de sep. de 2025 | 750 millones captados, 6.900 millones |
| Acuerdo con Nvidia (dic. de 2025) | Licencia no exclusiva, ~20.000 millones según la prensa |
| Ronda de jun. de 2026 | 650 millones captados, valoración no revelada |
| Ronda de ago. de 2026 | 350 millones captados, 3.500 millones |
| Centros de datos / capacidad | 13 centros de datos, 54 MW → más de 200 MW en 2027 |
Background: el chip que lo programaba todo por adelantado
Groq se fundó en Mountain View, California, en 2016. Ross había liderado el equipo que construyó el primer TPU de Google y salió con una convicción específica: el entrenamiento acapara los titulares, pero la inferencia —ejecutar modelos entrenados, token a token, para usuarios reales— se convertiría en el negocio más grande y más sensible a la latencia. Una GPU está diseñada para ser flexible. La apuesta de Groq fue que la inferencia no necesita flexibilidad; necesita previsibilidad.
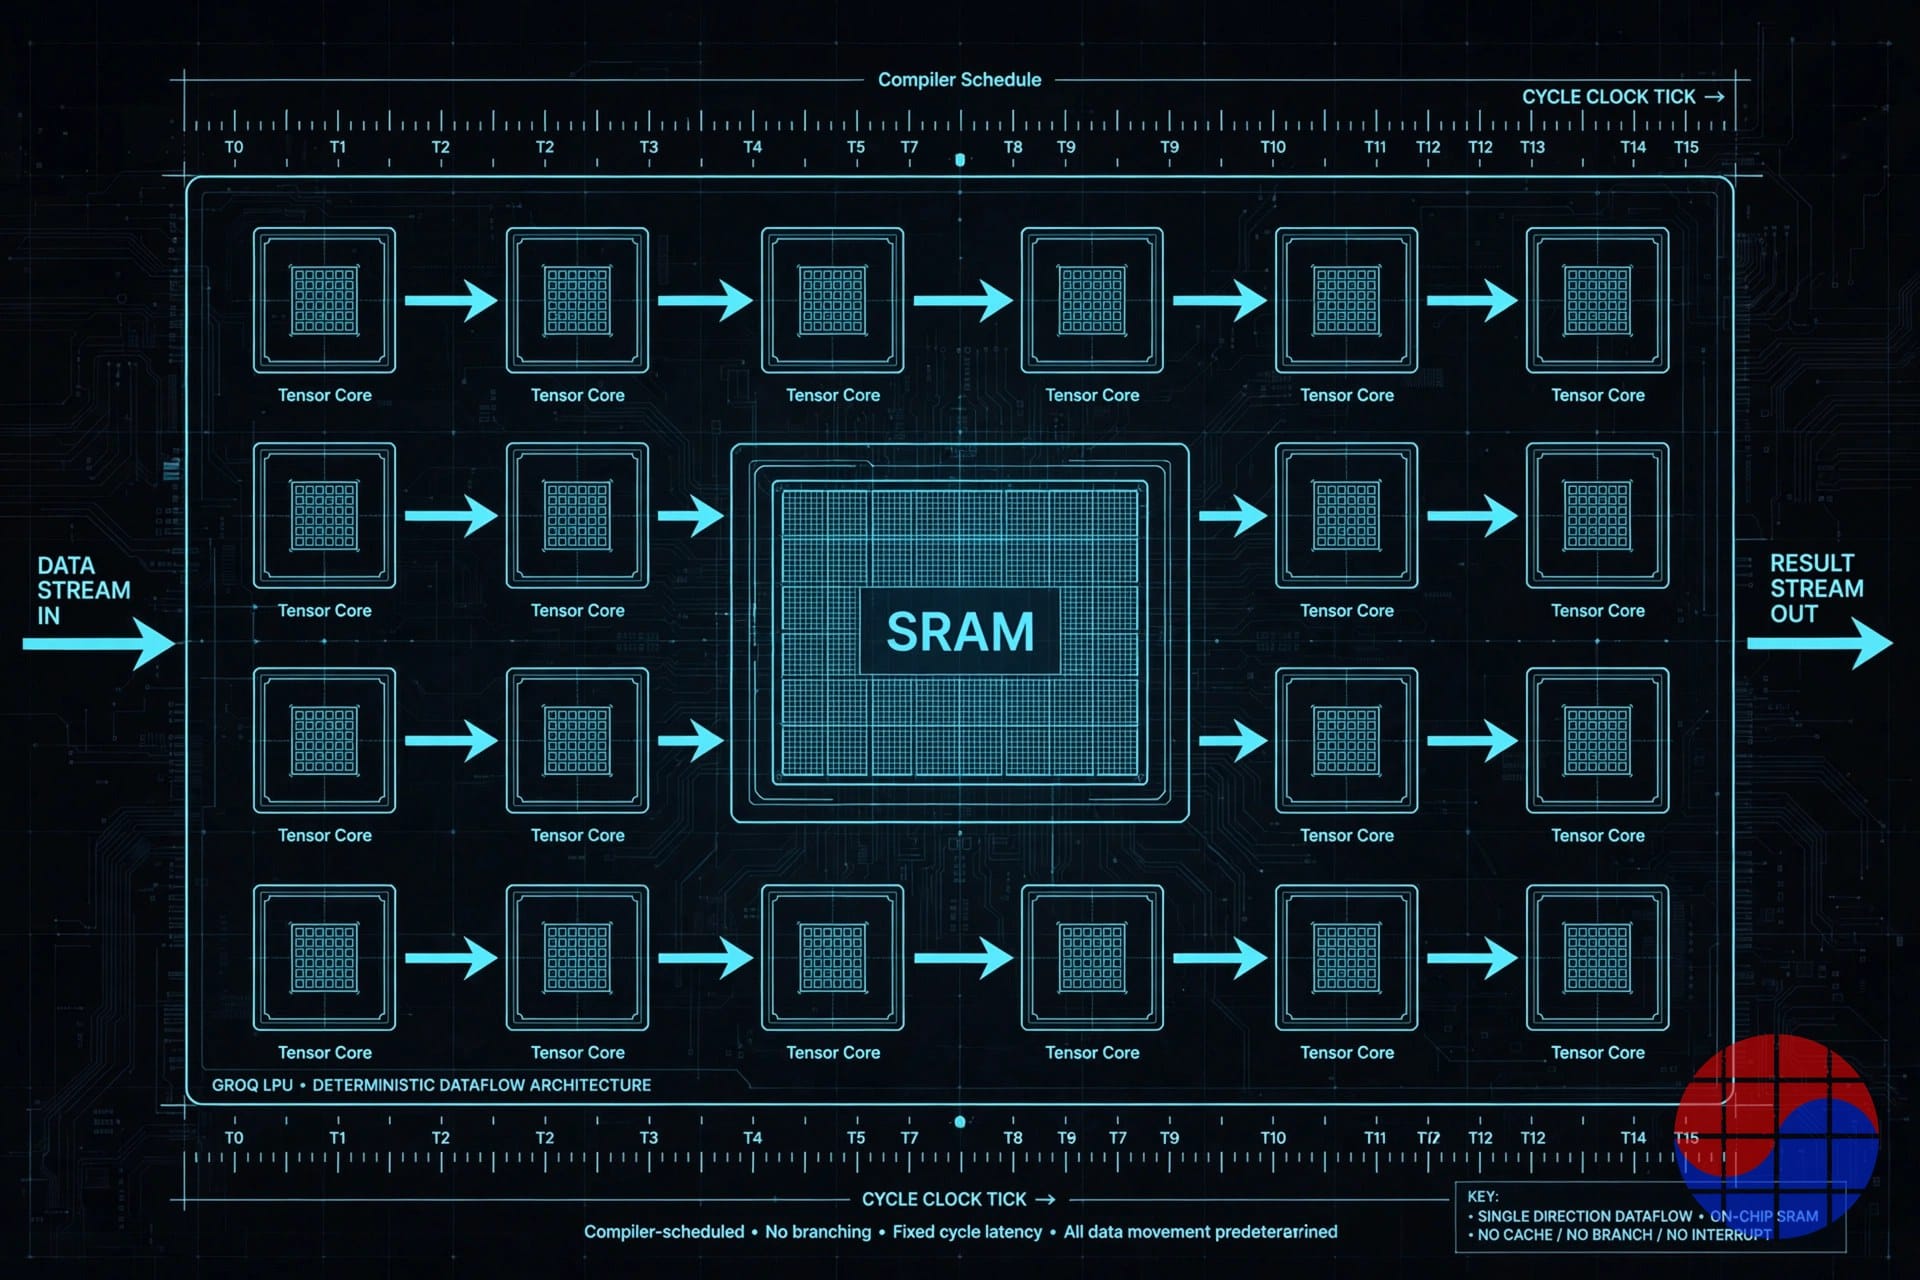
El LPU es un tensor streaming processor con un diseño deliberadamente inusual. La ejecución la programa el compiler en tiempo de compilación, no el hardware en tiempo de ejecución. No hay dynamic scheduling ni caché que adivine qué viene después. Cada ciclo está planificado, así que la latencia no solo es baja en promedio: es deterministic, con jitter mínimo. Para el chat, los agentes de voz y los bucles agentic que encadenan miles de llamadas secuenciales, esa previsibilidad es el producto.
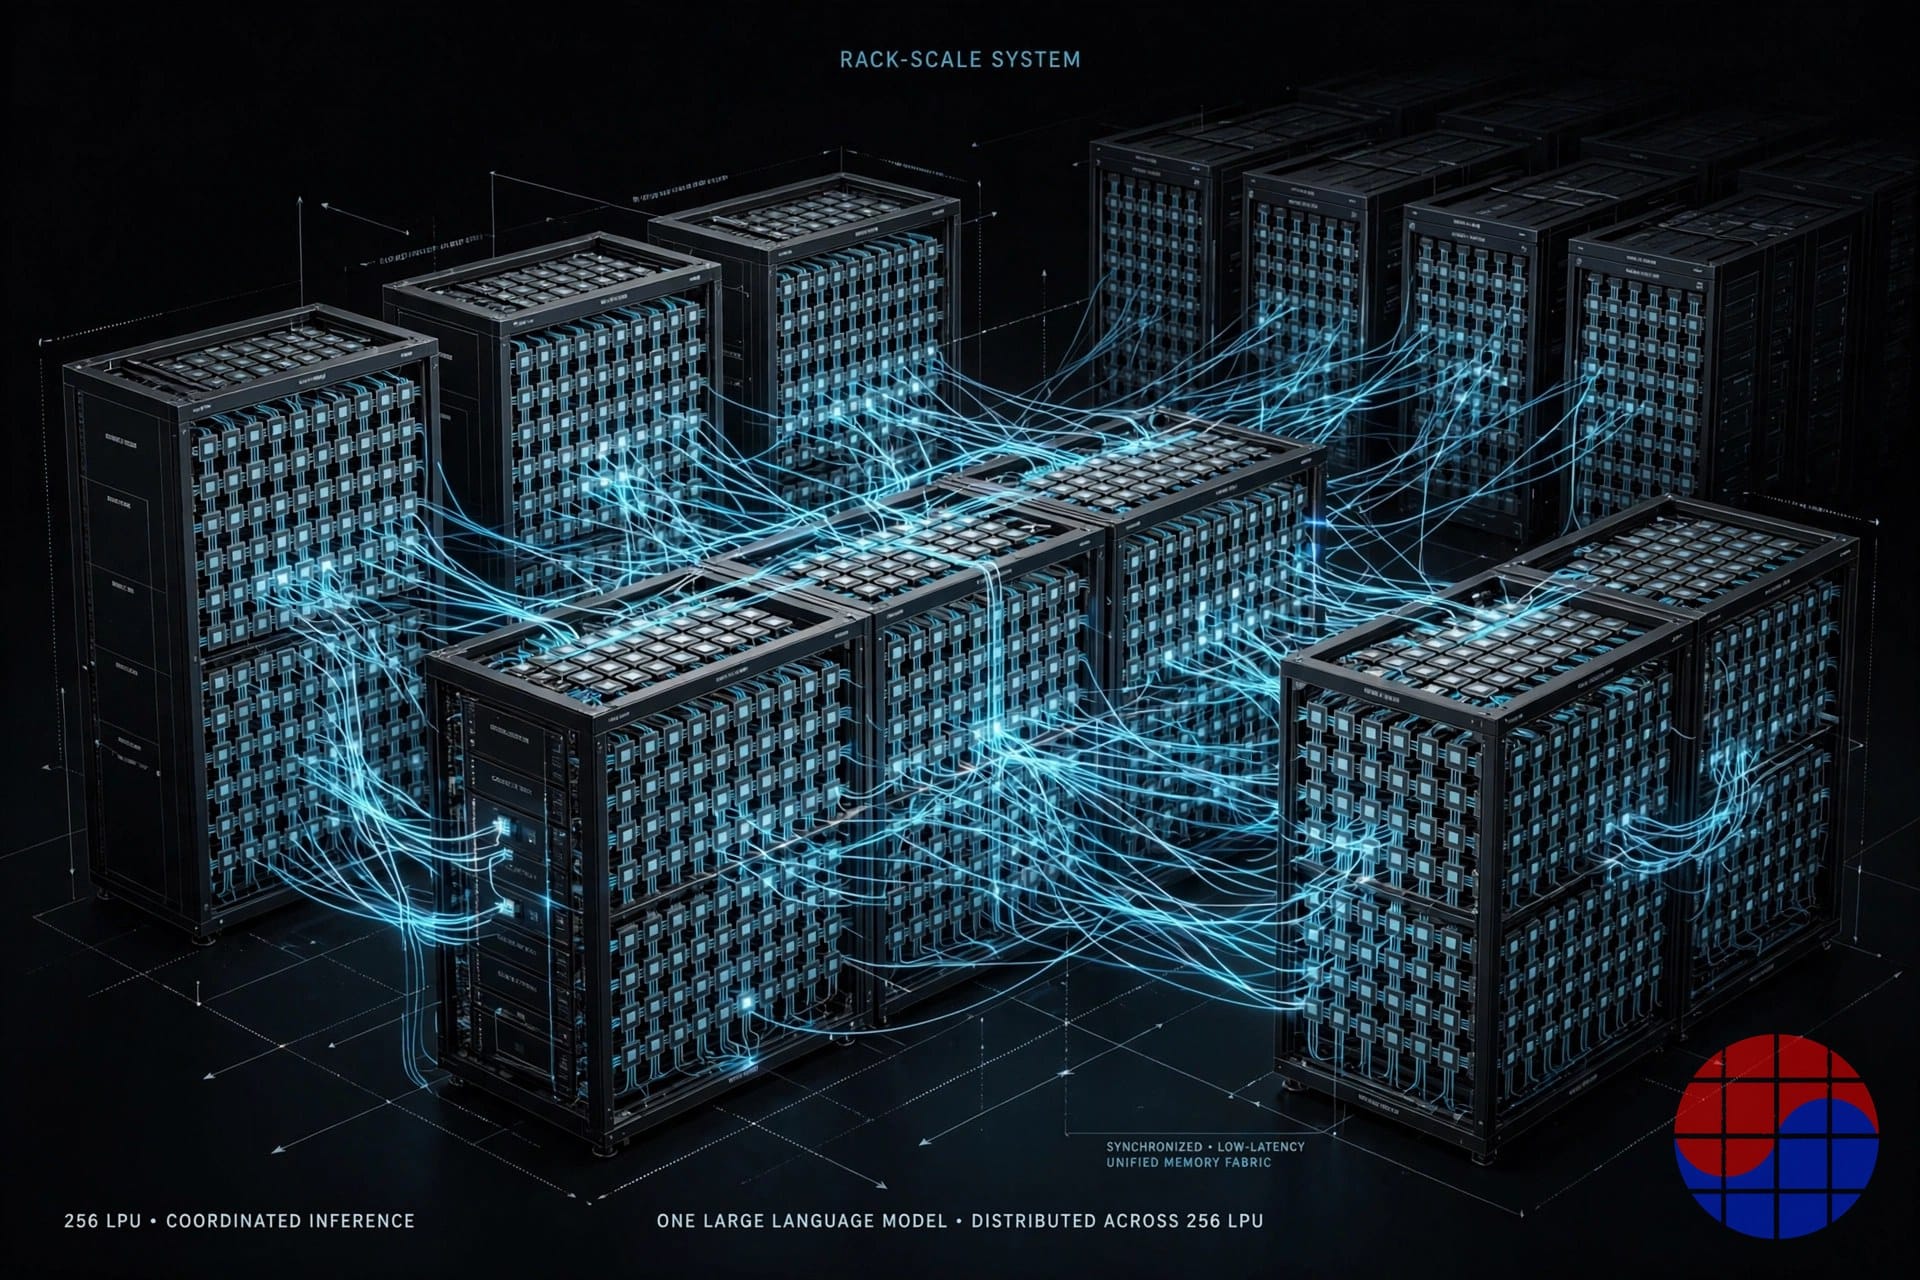
El diseño de memoria hace la misma apuesta. En lugar de HBM externa, el LPU de primera generación lleva unos 230 MB de SRAM on-chip como memoria principal, con unos 80 TB/s de ancho de banda on-die, un orden de magnitud por encima del ancho de banda off-chip de una GPU insignia. El coste es la capacidad: 230 MB no pueden contener un modelo de producción, así que cientos de LPU deben operar como una sola máquina coordinada. Servir un modelo de 70B parámetros ha significado históricamente un sistema a escala de rack de varios cientos de chips. La computadora no es el chip; la computadora es el rack.
El LPU de primera generación lo fabricó GlobalFoundries en un proceso de 14 nm, un nodo maduro elegido porque la arquitectura gana en movimiento de datos, no en densidad de transistores. GroqCloud, el servicio de inferencia alojado de la empresa, expuso el hardware mediante una API compatible con OpenAI que sirve modelos open-weight como Llama, Qwen, Gemma y Whisper. La adopción de desarrolladores creció de forma compuesta: unos 360.000 en agosto de 2024, más de 1,4 millones en abril de 2025, cuando Meta eligió a Groq para servir la API oficial de Llama, y unos seis millones reportados en 2026.
La geografía siguió la demanda de IA soberana. En septiembre de 2024, Groq se asoció con Aramco Digital en Arabia Saudí, puso en línea en ocho días el mayor clúster de inferencia de la región en Dammam en diciembre de 2024 y, en febrero de 2025, aseguró un compromiso de 1.500 millones de dólares del Reino para expandir la infraestructura LPU. Siguió un primer centro de datos europeo en Helsinki con Equinix, junto a una fábrica de IA soberana con Bell Canada. A finales de 2025, Groq operaba 13 centros de datos en Norteamérica, Europa, Oriente Medio y Asia-Pacífico.
Business Deep Dive: anatomía de un reinicio de 3.500 millones
La línea temporal de financiación cuenta la historia. En agosto de 2024, Groq captó 640 millones con una valoración de 2.800 millones. En septiembre de 2025 captó 750 millones a 6.900 millones, liderada por Disruptive con BlackRock, Samsung y Cisco entre los inversores. Tres meses después llegó la transacción con Nvidia. Después, en junio de 2026, Groq captó 650 millones para financiar su giro —con valoración no revelada— y en agosto de 2026 cerró otros 350 millones, presentados como Series A, a 3.500 millones. Mil millones de capital nuevo en unos dos meses, a la mitad del precio titular anterior.
Hay que leer el acuerdo con Nvidia con cuidado, porque define qué se vendió y qué no. Anunciada el 24 de diciembre de 2025, la transacción se estructuró como una licencia non-exclusive sobre la tecnología de inferencia de Groq, no como una adquisición. Groq siguió siendo independiente y GroqCloud continuó bajo el nuevo CEO, Simon Edwards. Las demandas presentadas en un litigio posterior de accionistas describen los reportados 20.000 millones como unos 17.000 millones de tarifa de licencia repartidos entre los inversores más un fondo de unos 3.000 millones en acciones de Nvidia para los ingenieros que se trasladaron —unas 200 personas, según la estimación de los demandantes—. Son alegaciones en un litigio, no conclusiones judiciales, y Groq ha calificado la demanda de infundada. Lo que no se discute: la tecnología y el equipo que la creó trabajan ahora en Nvidia, donde el Groq 3 LPU entró en producción plena en agosto de 2026 como acelerador LPX dentro de la plataforma Vera Rubin —256 LPU y 128 GB de SRAM por rack refrigerado por líquido, con Nebius como primer cliente de despliegue—.
¿Qué posee entonces la Groq restante? Tres activos. Primero, una nube de inferencia en operación: 13 centros de datos, unos 54 MW de capacidad, miles de clientes empresariales y una base de desarrolladores reportada de seis millones que procesa billones de tokens por semana. Segundo, distribución y confianza: GroqCloud fue un endpoint temprano, rápido y compatible con OpenAI que los desarrolladores ya conocen, y en agosto de 2026 Groq fue certificada como NVIDIA Cloud Partner, por lo que ahora puede desplegar sistemas Nvidia junto a su flota existente. Tercero, posiciones soberanas y regionales, sobre todo en Arabia Saudí, donde los gobiernos quieren capacidad de inferencia dentro de sus fronteras y están dispuestos a financiarla.
El historial de ingresos es más delgado que el de valoración. Las estimaciones de terceros sitúan los ingresos de 2024 en unos 90 millones de dólares. Para 2025, Groq guio a los inversores hacia más de 500 millones —revisado a la baja desde una proyección anterior de más de 2.000 millones, atribuyendo el desfase a restricciones de capacidad de centros de datos que desplazaron ingresos a 2026—. Documentos de inversores reportados en su momento mostraban el negocio en la nube con pérdidas, con ingresos cloud por encima de 40 millones frente a gastos cloud por encima de 64 millones en el período cubierto. En otras palabras: la demanda nunca fue el problema. Lo fueron la capacidad, el capital y la economía unitaria.
Ahora, la matemática de la valoración. Frente a la guía de ingresos de 2025 de 500 millones —un objetivo, no un resultado reportado—, 3.500 millones equivalen a 7 veces las ventas futuras. Frente a los estimados 90 millones de 2024, son unas 39 veces las ventas pasadas. Ningún múltiplo es absurdo para la infraestructura de IA en 2026, y ninguno es cómodo para una nube intensiva en capital que debe comprar sus próximos megavatios. Las rondas de junio y agosto inyectaron en conjunto 1.000 millones —cerca del 29 % del propio valor titular post-money de la empresa—, lo que indica cuánto de la historia de los 3.500 millones es capacidad aún por construir, no capacidad que ya gana dinero.
¿Qué debe ser verdad para que 3.500 millones funcione? Cuatro cosas. (1) La expansión de 54 MW a más de 200 MW en 2027 debe llegar a tiempo y llegar utilizada, no ociosa. (2) Los precios por token deben caer más despacio que el coste por token de Groq: todo el modelo neocloud es un spread entre el coste de energía más hardware y el precio de mercado de la inferencia, y ese spread se comprime cada año. (3) Groq debe conservar demanda ancla —programas soberanos, creadores de modelos y clientes empresariales— ahora que su diferenciación es operativa y no de silicio. Su antigua ventaja en chips se entrega literalmente dentro de la plataforma de su mayor socio, disponible para nubes rivales. (4) Nvidia debe seguir siendo socio y no una presión: Nvidia es a la vez licenciante, proveedor de GPU y accionista prospectivo, lo que hoy alinea incentivos y mañana concentra el riesgo.
El escenario a la baja es concreto, no hipotético. La inferencia en GPU se abarata por token con cada generación de Nvidia y AMD, y los hyperscalers ejecutan inferencia en su propio silicio —el TPU de Google, el Trainium de Amazon— a precios internos que ninguna nube independiente puede igualar en cargas comoditizadas. La defensa de Groq es el nivel sensible a la latencia: voz en tiempo real, agentes y código interactivo, donde la velocidad deterministic cobra una prima y la capacidad se agota en lugar de descontarse. Si ese nivel sigue escaso, 3.500 millones parece conservador junto a una licencia de 20.000 millones. Si la inferencia se comoditiza de forma uniforme, la empresa restante es una nube mediana con capital caro, y el reinicio no será el último. Persiste además el riesgo regulatorio: la transacción ha atraído escrutinio antimonopolio y litigios de accionistas que podrían remodelar la relación de la que depende la nueva Groq.
Chase's Take
El número más mal leído de esta historia es el de 20.000 millones. No fue una valoración de Groq como empresa; fue el precio de eliminar a Groq como amenaza mientras se absorbía a Groq como tecnología, y de hacerlo en una estructura que evitaba una revisión de fusión. Nvidia pagó aproximadamente tres veces la valoración privada máxima de Groq por una licencia y un equipo. Eso dice que la arquitectura LPU valía más dentro de la plataforma de Nvidia que toda la empresa independiente construida a su alrededor. Los adquirentes pagan por distribución y control de la hoja de ruta, no por elegancia.
El segundo número mal leído es el «down round» de 3.500 millones. Compararlo con 6.900 millones es el error de manzanas y naranjas que los titulares repiten. El precio de septiembre de 2025 valoraba una empresa de chips verticalmente integrada, con silicio propietario, un equipo fundador y un pipeline soberano de hardware. El precio de agosto de 2026 valora a un operador de nube que licencia su diferenciación de —y compra GPU a— la misma contraparte. La mitad del precio por una reclamación fundamentalmente menor sobre el fondo de beneficios de la industria no es obviamente una ganga, ni obviamente un colapso. Es la revalorización de un activo distinto.
Como ingeniero de infraestructura, encuentro la lección técnica más duradera que la financiera. Groq demostró que la ejecución deterministic y el diseño SRAM-first son genuinamente superiores para la inferencia centrada en decode —tan superiores que el proveedor dominante de GPU pagó una suma récord para poseer la idea y ahora la construye en un proceso avanzado como parte de primera clase de su plataforma insignia—. La arquitectura ganó. La empresa que la inventó aun así tuvo que convertirse en operadora de nube para sobrevivir. En semiconductores, inventar el mejor chip es solo la primera fosa; poseer la relación con el cliente y el balance para desplegarlo a escala es la segunda, y es la que se revalorizó.
Mi veredicto: 3.500 millones es un precio justo o pleno para la Groq restante, defendible solo si la expansión a 200 MW se convierte en capacidad de inferencia contratada y utilizada hasta 2027. Vigila tres señales: clientes ancla revelados para la nueva capacidad, si la participación accionaria de Nvidia se cierra realmente, y los precios por token en el nivel en tiempo real. Si las tres se mantienen, el reinicio fue el suelo. Si la capacidad llega antes que la demanda, esta Series A se recordará como una escala, no como un suelo.
Implications
Para Nvidia: la línea LPX convierte la arquitectura de un antiguo rival en una función de plataforma, lo que le permite vender decode deterministic junto a las GPU Rubin en lugar de perder cargas sensibles a la latencia ante nubes independientes. La carga regulatoria y litigiosa reportada es el coste de ese atajo.
Para los proveedores independientes de inferencia: el arco de Groq reinicia las expectativas. El silicio propietario por sí solo ya no garantiza un resultado independiente; los finales viables son convertirse en una nube con demanda contratada, ser absorbido por una plataforma o poseer un nicho que las plataformas no puedan servir. Cabe esperar que sus pares enfatizen contratos de capacidad firmados por encima de gráficos de benchmark cuando capten capital.
Para hyperscalers y compradores soberanos: la supervivencia de Groq como NVIDIA Cloud Partner muestra la bifurcación del mercado: las plataformas poseen la hoja de ruta del silicio, mientras que los operadores regionales y soberanos poseen permisos, energía y confianza local. El compromiso saudí de 1.500 millones compró exactamente esa capa.
Para Corea: Samsung participó en la ronda de septiembre de 2025 de Groq, y el Groq 3 LPU dentro del LPX de Nvidia se fabrica, según los reportes, por Samsung Electronics —un recordatorio de que los proveedores coreanos de fundición y memoria monetizan todos los lados de la contienda del silicio de IA, gane quien gane la guerra de arquitecturas—. Las startups coreanas de inferencia deberían leer el reinicio de 3.500 millones como el precio actual de mercado de un giro a la nube sin silicio propietario.
*Nota sobre fuentes y límites: Groq es privada. Las cifras de ingresos son estimaciones de terceros u orientación de la empresa tal como se reportó en su momento; el valor de la transacción con Nvidia es una cifra reportada —el anuncio de Groq describió una licencia non-exclusive sin revelar precio—; las caracterizaciones del litigio son alegaciones de los demandantes. Tipo de cambio usado: 1 dólar estadounidense = 1.400 wones coreanos.*
FAQ
¿Cuál es la última valoración de Groq y cuándo se fijó?
La última valoración reportada de Groq es de 3.500 millones de dólares (unas 4,9 billones de wones), fijada por una ronda de 350 millones liderada por Disruptive que cerró el 17 de agosto de 2026, con la participación prevista de Nvidia. Sigue a una captación de 650 millones en junio de 2026 con valoración no revelada, y es aproximadamente la mitad de los 6.900 millones de septiembre de 2025: un reinicio que refleja la transformación de la empresa tras el acuerdo de licencia con Nvidia, no una rebaja equivalente del mismo negocio.
¿Por qué Nvidia pagó unos reportados 20.000 millones si Groq valía 6.900 millones?
La transacción del 24 de diciembre de 2025 fue una licencia non-exclusive sobre la tecnología de inferencia de Groq más la contratación del fundador Jonathan Ross, el presidente Sunny Madra y gran parte del equipo senior, no una adquisición de la empresa. Los reportados 20.000 millones compraron para Nvidia la arquitectura LPU para su plataforma Vera Rubin (que ahora se entrega como Groq 3 LPX) y eliminaron a su rival independiente de inferencia más creíble, en una estructura que no requería aprobación de fusión. Groq siguió siendo independiente y mantuvo GroqCloud en operación.
¿Qué es un LPU y por qué es más rápido que una GPU en inferencia?
El LPU (Language Processing Unit) es el procesador de Groq dedicado solo a inferencia. Programa toda la ejecución en el compiler por adelantado —ejecución deterministic, sin sorpresas de programación en tiempo de ejecución— y usa unos 230 MB de SRAM on-chip con unos 80 TB/s de ancho de banda como memoria principal, en lugar de HBM externa. Eso hace que la generación de tokens sea extremadamente rápida y previsible. La contrapartida es la capacidad: un solo LPU no puede contener un modelo grande, así que cientos de chips deben trabajar juntos como un solo sistema.
¿Qué vende Groq ahora, tras el acuerdo con Nvidia?
Groq opera ahora como una nube de inferencia de IA (una «neocloud»). GroqCloud sirve modelos open-weight mediante una API compatible con OpenAI desde 13 centros de datos, con unos seis millones de desarrolladores reportados y billones de tokens procesados por semana. Certificada como NVIDIA Cloud Partner en agosto de 2026, está expandiendo su capacidad de unos 54 MW a más de 200 MW en 2027, desplegando cada vez más hardware de Nvidia junto a su flota LPU existente, además de despliegues soberanos como su programa de infraestructura en Arabia Saudí.
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.


