 VLSI Korea
HBM4E y la guerra de la jerarquía de memoria: SK Hynix vs Samsung por el estándar post-HBM
SK Hynix y Samsung presentaron HBM4E lado a lado en SEDEX 2026. Las especificaciones están empatadas: la verdadera batalla es quién define la jerarquía de memoria post-HBM. DRAM apilada en 3D y HBF frente a HBM5, HBM personalizada, CXL y PIM.


Resumen en 30 segundos
SK Hynix y Samsung presentaron HBM4E lado a lado en SEDEX 2026, Seúl, el 14 de octubre de 2026. Ambas memorias de nueva generación operan a 14–16 Gb/s por pin: en la práctica, la misma clase. La verdadera batalla no está en la hoja de especificaciones de HBM4E, sino en quién define la jerarquía de memoria que viene después de HBM. SK Hynix apuesta por la "altura" — nuevos niveles como la DRAM apilada en 3D y HBF (High Bandwidth Flash) — mientras Samsung apuesta por "velocidad más pila completa": HBM5, HBM personalizada, CXL, PIM y SSD empresariales de gran capacidad. Con la infraestructura de IA proyectada a expandirse unas 20 veces para 2030 frente a 2026 (SK Hynix, 14 de octubre de 2026), quien escriba el estándar post-HBM capturará la economía de la memoria de IA durante la próxima década.
Antecedentes: HBM4E marca el fin de la guerra de especificaciones
El 14 de octubre de 2026, día inaugural de SEDEX 2026 en COEX Seúl, los stands de SK Hynix y Samsung mostraban la misma palabra: HBM4E. La HBM4E de SK Hynix corre a 16 Gb/s por pin, consume más de un 20% menos de energía que HBM4, y las muestras de 12 alturas (12-high) se enviaron ya en junio de 2026. La HBM4E de Samsung opera entre 14 y 16 Gb/s por pin, alcanza hasta 3,6 TB/s de ancho de banda y combina DRAM de clase 1c con un dado base (base die) de 4 nm.
| Elemento | SK Hynix HBM4E | Samsung HBM4E |
|---|---|---|
| Velocidad por pin | 16 Gb/s | 14–16 Gb/s |
| Ancho de banda máximo | ~2,0 TB/s (base 12-high)* | Hasta 3,6 TB/s |
| Energía | Más de 20% menos que HBM4 | No divulgado (diseño de bajo consumo destacado) |
| Generación DRAM | No divulgada | Clase 1c |
| Dado base | No divulgado | Lógica de 4 nm |
| Muestras 12-high | Enviadas en junio de 2026 | Presentadas en SEDEX 2026 |
| Presentación | SEDEX 2026 (14 oct) | SEDEX 2026 (14 oct) |
*SK Hynix no ha divulgado el ancho de banda máximo. 16 Gb/s por pin × interfaz de 1024 bits equivale a 2,0 TB/s.
La conclusión es simple: HBM4E ya no es un arma de diferenciación técnica. Velocidad por pin, energía y altura de apilado convergen entre ambos fabricantes en una ventana de seis meses: la batalla pasó de "quién gana la hoja de especificaciones" a "quién escribe el próximo estándar". Además, HBM4E casi no aliviará la oferta antes de 2027 —más dados DRAM por pila, dados base en nodos lógicos de vanguardia y nuevos ciclos de calificación por cliente alargan los plazos. Esa rigidez estructural está detrás de las proyecciones de +121% interanual en los precios de contrato de HBM4 para 2027 (Korea Economic Daily, 2026, citando prensa del sector).
En su keynote de SEDEX ese mismo día, el presidente de SK Hynix, Ahn Hyun, lo dijo sin rodeos: "HBM alone is not enough." La infraestructura de IA debe escalar unas 20 veces para 2030 desde los niveles de 2026, la IA agéntica está disparando el uso de tokens, el movimiento de datos del KV-cache es el nuevo cuello de botella y el motor del crecimiento es la inferencia, no el entrenamiento. En una frase: el cuello de botella se ha movido del ancho de banda de HBM a la arquitectura de toda la jerarquía de memoria.
Análisis de negocio: anatomía de una guerra de estándares
La nueva jerarquía de memoria: el mapa de SK Hynix
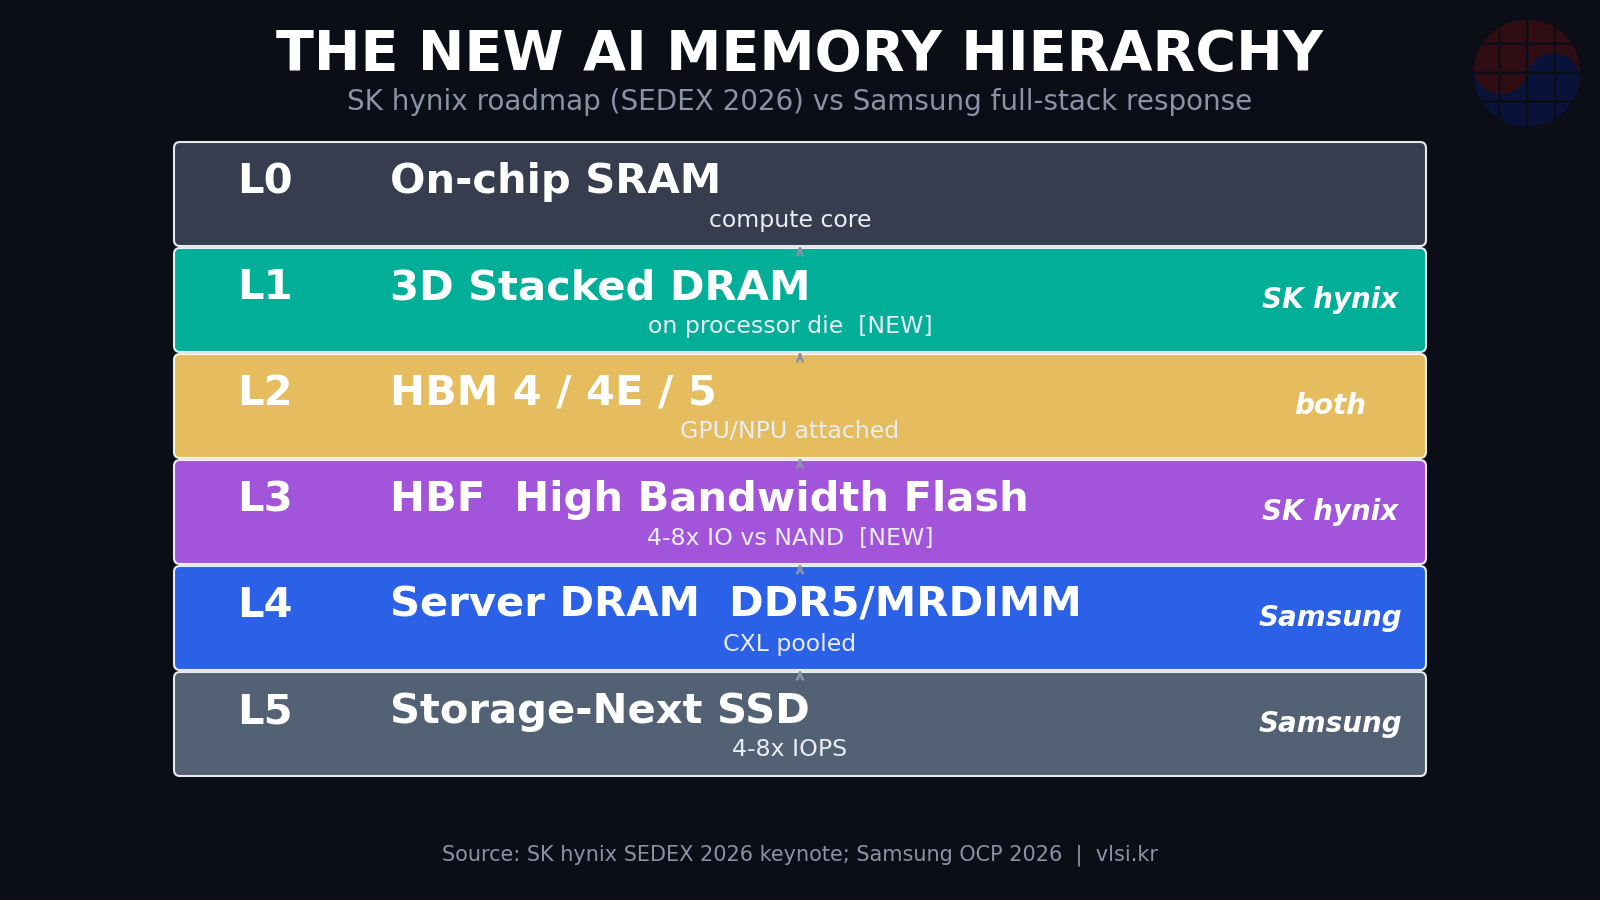
El núcleo de la hoja de ruta de Ahn es añadir niveles. La imagen anterior era relativamente simple: SRAM en chip → HBM → DRAM de servidor → SSD. La jerarquía propuesta por SK Hynix es esta:
| Nivel | Tecnología | Rol | Significado de negocio |
|---|---|---|---|
| L0 | SRAM en chip | Caché junto a los núcleos de cómputo | Dominio de los fabricantes lógicos (sin cambios) |
| L1 (nuevo) | DRAM apilada en 3D | Dados DRAM apilados directamente sobre dados de procesador | Extiende el know-how de apilado TSV; difumina la frontera lógica–memoria |
| L2 | HBM (HBM4 / HBM4E / HBM5) | Memoria de alto ancho de banda junto a GPU/NPU | Centro de la guerra de estándares; la personalización cambia la estructura de márgenes |
| L3 (nuevo) | HBF (High Bandwidth Flash) | 4–8x IO frente a la NAND actual | El contraataque del bando NAND contra el orden de memoria de IA liderado por DRAM |
| L4 | DRAM de servidor (DDR5 / MRDIMM) | Memoria principal de gran capacidad | El pooling CXL cambia la economía de la utilización |
| L5 | SSD empresarial Storage-Next | 4–8x IOPS frente a lo actual | La frontera almacenamiento–memoria se difumina |
Los inversores deben fijarse en las filas L1 y L3. La DRAM apilada en 3D lleva la tecnología de apilado TSV de HBM dentro del encapsulado del procesador, reutilizando directamente la experiencia en apilado y gestión térmica que SK Hynix construyó con HBM. HBF es aún más audaz: promueve la NAND de "almacenamiento" a miembro de pleno derecho de la jerarquía de memoria. Para los fabricantes de NAND es la única rampa de acceso al orden de memoria de IA dominado por DRAM: léase como la declaración de que el contraataque del bando NAND ha comenzado.
La respuesta de Samsung: velocidad más pila completa
Samsung dibujó otro cuadro en el OCP Global Summit 2026 en San José (12–15 de octubre), donde demostró junto a AMD la expansión de memoria CXL. Su estrategia descansa en tres pilares:
- Velocidad (Speed): HBM5, más HBM personalizada con lógica específica del cliente integrada en el dado base: una carta que combina la fortaleza de fundición de Samsung (dados base de clase 4 nm) con su IDM de memoria.
- Expansión de capacidad (Capacity): pooling de memoria basado en CXL, compartiendo DRAM de servidor entre aceleradores para elevar la utilización.
- Almacenamiento (Storage): SSD empresariales de gran capacidad: una propuesta integral que cubre desde memoria hasta almacenamiento con un solo proveedor.
Encima se añade la tecnología PIM (processing-in-memory), que lleva el cómputo dentro de la memoria para reducir el movimiento de datos en sí.
| Eje | SK Hynix | Samsung |
|---|---|---|
| Apuesta central | Altura: nuevos niveles (DRAM 3D, HBF) | Velocidad + pila completa: HBM5, HBM personalizada, CXL, PIM, SSD |
| Fuente de diferenciación | Extensión del know-how de apilado HBM; vínculo con la filial NAND (Solidigm) | Fundición + IDM de memoria; diseño lógico del dado base |
| Personalización | HBM personalizada (lógica del cliente en el dado base) | HBM personalizada + oferta integral ligada a fundición |
| Estrategia NAND | HBF incorpora la NAND a la jerarquía de memoria | SSD de gran capacidad refuerzan el liderazgo en almacenamiento |
| Debilidad | Diseño lógico (dado base) por detrás de Samsung | Cuota de mercado de HBM por detrás de SK Hynix |
El cambio en la estructura de márgenes: lo que cambia la HBM personalizada
La "HBM personalizada" —anunciada por ambos— es la variable más subestimada de esta guerra de estándares. La HBM convencional es casi una commodity: especificaciones fijas, precios fijos, el mismo producto vendido a muchos clientes. La HBM personalizada integra lógica específica del cliente (controladores, seguridad, optimización de interfaz) en el dado base. Es el paso de commodity a silicio específico del cliente.
Tres implicaciones para la estructura de márgenes:
Primero, el poder de fijación de precios se fortalece frente a las piezas estándar. El diseño específico por cliente crea costos de cambio y profundiza el vendor lock-in. Segundo, la capacidad de diseño lógico del dado base se vuelve una competencia central para los fabricantes de memoria: un campo de batalla que favorece a Samsung, con sus activos de fundición y diseño lógico. SK Hynix debe obtener esa capacidad externamente. Tercero, la bifurcación entre HBM estándar y personalizada complica la cadena de suministro. Si el dado base difiere por cliente incluso dentro de la misma generación HBM4E, la planificación de producción y la gestión de inventarios se endurecen, lo que retroalimenta la presión alcista sobre los precios. Detrás de la proyección de +121% interanual en los precios de contrato de HBM4 para 2027 hay impulsores estructurales como este.
Pooling CXL: la economía de la utilización
El pooling de memoria basado en CXL abre una nueva economía de la utilización de memoria. En los servidores de IA, la memoria se asigna por acelerador, pero la utilización real oscila enormemente: una GPU se queda sin memoria mientras la vecina permanece ociosa. Compartir un pool de memoria vía CXL absorbe esa varianza, reduciendo las compras totales de memoria y aliviando cuellos de botella.
Para los hiperescaladores es una carta de reducción del TCO (costo total de propiedad). Para los fabricantes de memoria, un arma de doble filo: a corto plazo el contenido de memoria por servidor puede caer, pero a largo plazo se abre un mercado nuevo —el pool de memoria en sí— más demanda fresca en controladores y conmutadores CXL. Por eso Samsung demostró con AMD en OCP: nadie fija un estándar en solitario; se demuestra con quien tiene las llaves del ecosistema.
Contexto de mercado: la memoria ya supera la mitad de los semiconductores
Las estimaciones de investigación del sector sitúan la memoria en torno al 54% de los ingresos totales de semiconductores en 2026 —casi el doble del 27% de 2025— impulsada por el creciente contenido en dólares de HBM dentro de cada acelerador de IA. Por eso los fabricantes de memoria compiten por convertirse en los definidores de la jerarquía de memoria de IA. Quien define el estándar fija las reglas de precio, especificación y calificación; y quien fija las reglas fija los márgenes.
La visión de Chase: altura vs pila completa — quién escribe el estándar
Esta lucha no es sobre tecnología; es sobre poder de fijación de estándares (standard-setting power). Miremos la historia: JEDEC fijó formalmente los estándares DRAM, pero en la práctica el fabricante que produjo en masa primero y calificó primero se convirtió en el autor de facto del estándar. Con HBM fue igual: SK Hynix entregó HBM3 y HBM3E a NVIDIA primero y escribió el estándar de hecho mientras Samsung perseguía.
Esta vez la forma difiere. SK Hynix dibujó primero en la página en blanco titulada "después de HBM". La DRAM apilada en 3D y HBF son niveles nuevos sin hogar en los estándares JEDEC existentes. Define primero, muestrea primero, alíate con clientes primero —y eso se convierte en el estándar. Samsung, en cambio, pelea en terreno probado: la velocidad de HBM5, la flexibilidad de la HBM personalizada, el ecosistema CXL, PIM, SSD. Ninguno por sí solo detiene la ofensiva de nuevos niveles de SK Hynix, pero empaquetados como pila completa forman una propuesta integral para los clientes —especialmente hiperescaladores: "déjennos sus preocupaciones de memoria a nosotros".
Desde una perspectiva coreana, la ironía es rica. Ambas son campeonas nacionales coreanas. En la era del chicken game de DRAM, las ampliaciones de capacidad de cada una significaban colapso de precios para ambas. Ahora las dos redactan planos contrapuestos para el orden mundial de memoria de IA. Ha llegado la era en que el duopolio coreano de memoria dibuja los documentos de diseño de la infraestructura global de IA. Los riesgos son reales, eso sí. Más niveles implican más complejidad de sistema y carga de calificación. Si HBF puede superar los límites de NAND (resistencia, latencia) en cargas reales, y quién resuelve el problema térmico de la DRAM apilada en 3D, sigue sin probarse. El PIM de Samsung lleva años siendo "gran demo, aún no volumen". El ganador de una guerra de estándares rara vez es la diapositiva más bonita: es el cuadro más realista que se envía primero.
El contraargumento merece aire: algunos sostienen que pasos incrementales como HBM4E y HBM5 pueden absorber la demanda de inferencia, y que si la presión del KV-cache se agrava, las arquitecturas de modelo (optimización de atención, cuantización) se adaptarán primero. Punto válido. Pero para los fabricantes de memoria esa es una estrategia de espera —y mientras esperas, el poder de fijar estándares pasa a otras manos. Por eso SK Hynix y Samsung se movieron a la vez.
Implicaciones de inversión y gestión
Para inversores: - Con la memoria por encima de la mitad de los ingresos de semiconductores, el fabricante que defina los niveles post-HBM gana una prima estructural. Siga la ejecución de la hoja de ruta (plazos de volumen de DRAM 3D, HBF, CXL), no el trading especulativo de corto plazo sobre HBM4E. - La difusión de la HBM personalizada eleva los márgenes de los fabricantes de memoria, pero los fabricantes sin capacidad de diseño lógico del dado base ganan una nueva línea de costo en diseño subcontratado. Los beneficiarios en la cadena de valor se extienden hacia diseño lógico, controladores CXL y empaquetado avanzado (OSAT/equipos). - La proyección de +121% interanual en precios de contrato de HBM4 para 2027 es viento de cola para los resultados de los fabricantes de memoria —y a la vez el disparador que empuja a los hiperescaladores hacia el pooling CXL y la optimización arquitectónica para aliviar la presión del TCO. Vigile el punto donde las subidas de precio empiezan a destruir demanda.
Para gestores: - Toda empresa que construya u opere infraestructura de IA debería elevar su estrategia de compra de memoria de "comprar HBM" a "diseñar la jerarquía de memoria". El momento de adopción del pooling CXL, la madurez de HBF y los plazos de calificación de la HBM personalizada son ahora variables de la hoja de ruta de compras. - Para fabless y empresas de sistemas, la capacidad de personalización del dado base es una nueva carta de negociación. Comprar HBM estándar frente a co-diseñar HBM personalizada implica una relación de poder distinta en la cadena de suministro. - Para los fabricantes de NAND, HBF es una oportunidad de romper la caja de "dispositivo de almacenamiento": unirse al orden centrado en DRAM o seguir una ruta independiente vía SSD avanzados. La bifurcación ya está aquí.
Preguntas frecuentes
P1. ¿Qué diferencia a HBM4E de HBM4? HBM4E es la generación extendida de HBM4, con velocidades por pin en torno a 16 Gb/s y mejor eficiencia energética. SK Hynix anuncia más de 20% menos de energía que HBM4; Samsung publicita hasta 3,6 TB/s de ancho de banda con un dado base de 4 nm. La brecha de especificaciones es pequeña, así que las hojas de ruta más allá de HBM4E —HBM5, HBM personalizada, nuevos niveles de memoria— importan más que HBM4E en sí.
P2. ¿Qué es HBF (High Bandwidth Flash)? Un nuevo nivel de memoria propuesto por SK Hynix en SEDEX 2026, con el objetivo de 4–8x el ancho de banda IO de la flash NAND actual. Se sitúa entre HBM y DRAM de servidor, apuntando a grandes cargas de inferencia como el manejo de KV-cache. Promueve la NAND de "almacenamiento" a la jerarquía de memoria: el desafío del bando NAND al orden de memoria de IA liderado por DRAM.
P3. ¿Por qué importa el pooling de memoria CXL? Con CXL (Compute Express Link), varios aceleradores comparten un pool de memoria, absorbiendo la varianza de utilización por acelerador y reduciendo las compras totales de memoria. Es una carta de reducción del TCO para hiperescaladores y abre un mercado nuevo —controladores y conmutadores CXL— para los fabricantes de memoria. Ese es el trasfondo de la demo conjunta de Samsung con AMD en OCP 2026.
P4. ¿Qué decide al ganador de la guerra de estándares post-HBM? Tres cosas. Primero, el momento del volumen: no demos, sino quién pasa la calificación del cliente y envía volumen primero. Segundo, el ecosistema: quién puede construir el estándar junto a hiperescaladores y fabricantes de GPU. Tercero, la economía: si los nuevos niveles realmente bajan el TCO. El silicio que funciona vence a la hoja de ruta bonita.
Aviso: las cifras y proyecciones de este artículo se basan en materiales públicos e información del sector al 17 de octubre de 2026; las especificaciones reales de producto y los plazos de volumen están sujetos a cambios.


