 VLSI Korea
Normal Computing a fondo: la EDA con IA y el chip termodinámico CN101 de los ex de Google, con 85 millones y Samsung Catalyst
Una empresa que calcula con el ruido en lugar de luchar contra él. La EDA con IA de Normal Computing, lo que el chip termodinámico CN101 demostró de verdad en Hot Chips 2026 y por qué Samsung Catalyst lideró la ronda que llevó la financiación total a más de 85 millones.


Resumen en 30 segundos
- Normal Computing no suprime el ruido: lo usa para computar. Un chip convencional gasta energía suprimiendo las fluctuaciones y el ruido térmico de los transistores para mantener ceros y unos deterministas. La arquitectura Carnot de la compañía hace lo contrario: deja que la dinámica de un sistema físico que relaja hacia el equilibrio ejecute el cómputo probabilístico, y extrae la respuesta muestreando una distribución. La empresa lo llama ASIC físico.
- El motor de ingresos es el EDA, no el chip. Normal EDA es una plataforma de diseño de chips nativa de IA cuyo núcleo es la auto-formalización: combina modelos de lenguaje con lógica formal para convertir especificaciones en modelos formales y automatizar el diseño y la verificación. Según la compañía, más de la mitad de las diez mayores empresas de semiconductores por ingresos son socias, y la meta inmediata es llevar el silicio personalizado al mercado el doble de rápido.
- La demostración en silicio es real pero pequeña. El CN101, con tape-out en julio de 2025, es un chip de pruebas CMOS digital que la compañía llama «el primer chip de computación termodinámica del mundo». Los resultados que publicó en Hot Chips 2026 son generación de dígitos manuscritos MNIST en un solo chip y generación de imágenes CIFAR-10 con seis chips. La propia compañía los describe como «resultados a pequeña escala».
- El factor 1.000x es un objetivo, no una medición. La eficiencia energética de hasta 1.000x que menciona la empresa es una meta para cargas de trabajo objetivo: no está verificada por terceros ni medida en un producto comercial. El CN201 (2026) y el CN301 (finales de 2027-principios de 2028) son los chips que deberán demostrarla.
- El fondo estratégico de Samsung lideró la ronda. En marzo de 2026, Samsung Catalyst Fund lideró una ronda de 50 millones de dólares que elevó el total captado a más de 85 millones, y la empresa anunció oficialmente planes de expansión en Corea.
Perfil de la empresa
| Dato | Contenido |
|---|---|
| Fundación | 2022, sede en Nueva York |
| Fundadores | Faris Sbahi (CEO), Matthias Tan, Antonio Martinez |
| Origen del equipo | Los fundadores vienen de Google Brain, Google X y Palantir. El equipo incluye perfiles de Meta, Apple, NVIDIA, Broadcom, Graphcore y laboratorios nacionales de EE. UU. (según la compañía) |
| Plantilla | Varía por fuente. PitchBook indica 30 personas; algunas plataformas de empleo muestran un rango de 51 a 200. La compañía no publica cifra exacta |
| Oficinas | Nueva York (sede), San Francisco, Londres y Copenhague. La expansión en Corea figura en el comunicado de marzo de 2026 |
| Negocio 1 | Normal EDA: plataforma de diseño de semiconductores nativa de IA basada en auto-formalización (hoy centrada en automatización de DV y RTL) |
| Negocio 2 | Programa Carnot: ASIC físicos de computación termodinámica (CN101, CN201, CN301) |
| Total captado | Más de 85 millones de dólares (marzo de 2026, según la compañía) |
| Inversores clave | Samsung Catalyst Fund, Celesta Capital, Drive Capital, First Spark Ventures (Eric Schmidt), Micron Ventures, Galvanize, Brevan Howard Macro Venture Fund, ArcTern Ventures |
| Programas públicos | Financiación parcial del programa Scaling Compute del ARIA del Reino Unido (proyecto de inversión termodinámica de matrices) |
| Socios | Más de la mitad de las diez mayores empresas de semiconductores por ingresos (afirmación de la compañía, nombres no revelados) |
Historia: de la IA probabilística a los semiconductores
Normal Computing nació en 2022 en Nueva York. Sus fundadores, Faris Sbahi, Matthias Tan y Antonio Martinez, eran ingenieros que habían construido sistemas de IA a gran escala en Google Brain, Google X y Palantir. La primera bandera que la compañía levantó a principios de 2023 no fue la de los semiconductores sino la de la «IA probabilística»: controlar las alucinaciones de la IA generativa con modelos de probabilidad. La ronda semilla de 8,5 millones de dólares cerrada en enero de 2023 (co-liderada por Celesta Capital y First Spark Ventures, con participación de Micron Ventures) se contó en esa dirección.
Pero al mismo tiempo la empresa ya sembraba una segunda semilla. El artículo de principios de 2023 «Thermodynamic AI and the Fluctuation Frontier» agrupó los modelos de difusión, las redes neuronales bayesianas, los métodos de Monte Carlo y el recocido simulado en una sola clase de cómputo probabilístico, y propuso un hardware de probabilidad capaz de acelerarla toda. Después, el centro de gravedad de la compañía se desplazó rápido hacia los semiconductores. Por una razón práctica: el diseño de chips es la industria que más necesita la computación probabilística y la que más paga por equivocarse; una re-spin cuesta decenas de millones.
La lógica del giro es esta. Diseñar un chip es decidir bajo incertidumbre: las especificaciones están incompletas, la verificación no termina nunca y la tasa de éxito del primer silicio es baja. Poner IA en ese proceso exige que su salida sea demostrablemente correcta; no se puede confiar el silicio de producción a un asistente que no se puede verificar. Por eso la respuesta de la compañía fue unirla con métodos formales: la auto-formalización. Y no solo ayudar a los chips de otros con su herramienta: diseñar directamente el tipo de chip que el EDA tradicional peor maneja, su propio chip termodinámico, y convertirlo en la prueba viva de la herramienta.
Anatomía de Normal EDA: qué es la auto-formalización
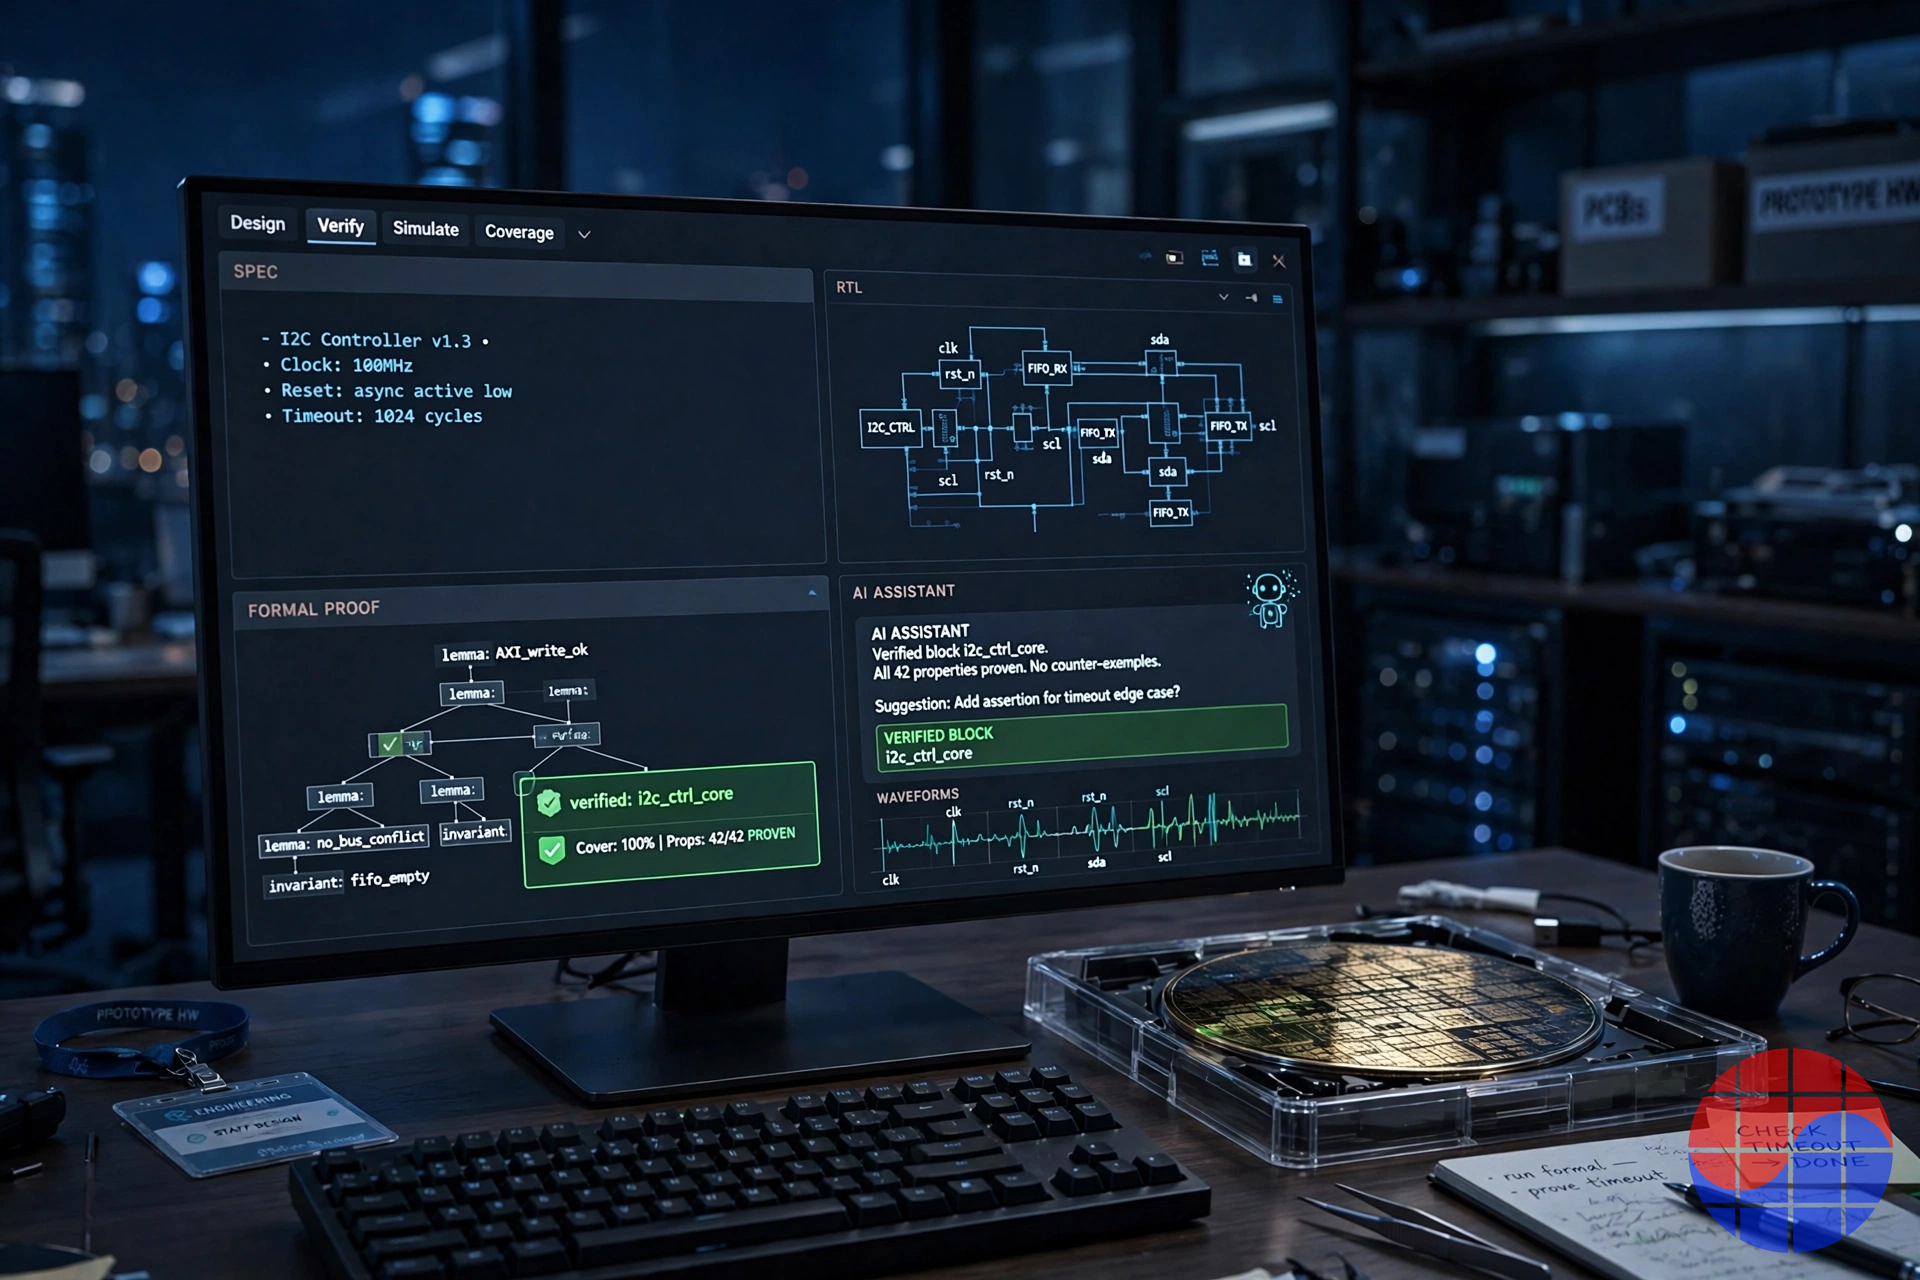
La auto-formalización, el concepto central de Normal EDA, es un término de la vanguardia de la investigación en IA: originalmente se refiere a traducir teoremas matemáticos del lenguaje natural a lenguajes formales. La compañía lo trasplanta al diseño de semiconductores: un LLM lee especificaciones en formatos diversos, desde documentos de arquitectura hasta descripciones de microarquitectura, tablas de verdad y diagramas de temporización, y convierte su intención en un modelo de lógica formal. Una vez que el diseño es un modelo formal, la pregunta cambia: si cumple la especificación ya no es una cuestión de «parece razonable», sino de demostración.
Combinando lo que la compañía ha explicado, la plataforma opera en cuatro etapas. Primero, aprende por completo las especificaciones y los activos de verificación del equipo y construye una representación interna de la intención y los objetivos. Segundo, interpreta de forma multimodal entradas no textuales como diagramas de temporización e imágenes de formas de onda, y deriva estímulos y comprobaciones automáticamente. Tercero, genera y optimiza el diseño sobre el modelo formal mientras demuestra su corrección, y sigue aprendiendo. Cuarto, para los vacíos y ambigüedades de la especificación infiere el comportamiento probable, propone pruebas y un ingeniero las aprueba o corrige: un human-in-the-loop. El alcance comercial actual es la automatización de DV (verificación de diseño) y RTL, y la compañía habla de ampliarlo al diseño de extremo a extremo y a flujos para silicio no convencional.
El punto de colisión con el EDA existente es claro. El EDA agéntico de Synopsys y Cadence también introduce agentes LLM en el flujo de diseño, pero su punto de partida es automatizar sobre cadenas de herramientas acumuladas durante décadas. La afirmación de la compañía es que su orden es el inverso: poner en el centro el modelo formal demostrable, con la IA trabajando a su alrededor. Y, coherente con una compañía cuyo núcleo es la verificación, es miembro fundador de la coalición de benchmarking de LLM del Si2 (Silicon Integration Initiative), participando en los estándares de evaluación del EDA con IA.
También hay que decir los límites con honestidad. Los nombres de los socios no se han revelado, y la cifra de «más de la mitad del top-10» es de la propia compañía. Entre la meta de reducir el ciclo de diseño de años a meses y la declaración actual del CEO, «2x más rápido hoy», hay todavía un tramo. Pero que PitchBook la clasifique como empresa en fase de generar ingresos y que Samsung Catalyst haya liderado tras su due diligence se lee como una señal indirecta de que la plataforma ha superado al menos la fase de pilotos gratuitos.
Principio de la computación termodinámica: los tres costes del determinismo
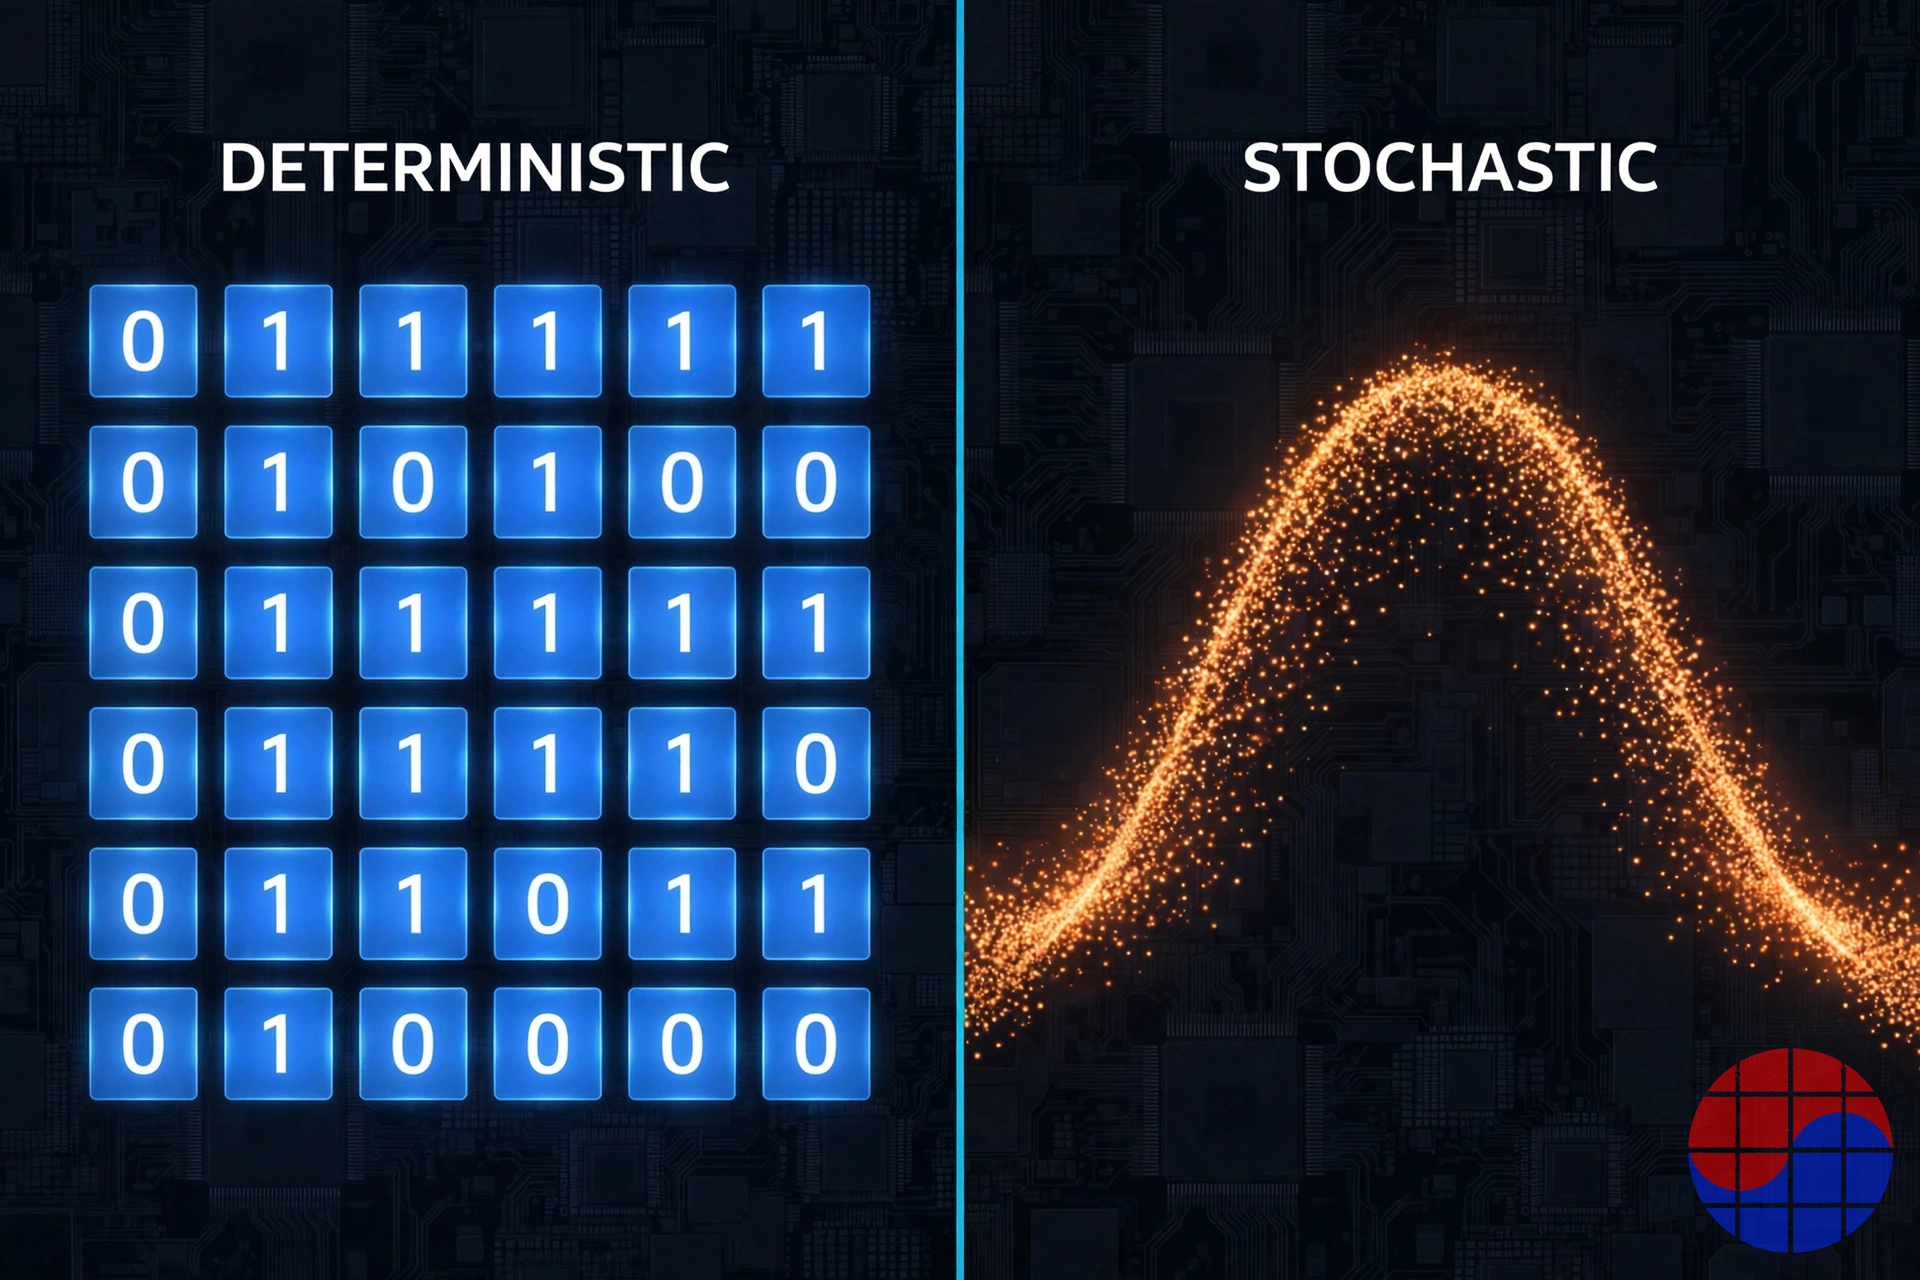
Para entender el programa Carnot hay que empezar por lo que le cuesta la probabilidad a un chip convencional. El marco que la compañía y su equipo fundador repiten en sus publicaciones es que «el determinismo se factura tres veces».
Primero, el coste de suprimir. Los transistores fluctúan por naturaleza. Un circuito digital mantiene ceros y unos estables al precio de márgenes de ruido y supresión de errores, y ese precio es energía. Segundo, el coste de generar. Algoritmos probabilísticos como los modelos de difusión necesitan un término de ruido; una máquina determinista lo imita de la forma más cara: generación de aleatoriedad en software. Tercero, el coste de sincronizar. La sincronización lockstep, innecesaria para la semántica probabilística, consume energía y latencia.
La computación termodinámica rechaza las tres facturas. En lugar de suprimir la fluctuación, la disipación y la estocasticidad del sistema físico, las usa: el proceso por el que el sistema relaja hacia su distribución de equilibrio a lo largo de un paisaje energético es el cómputo. Para problemas cuya respuesta es el muestreo, donde extraer muestras de una distribución de probabilidad es el trabajo en sí, este enfoque es barato en principio. Es simbólico que la ecuación gobernante de la difusión termine en un término de ruido blanco: el ruido que el algoritmo necesita puede venir del ruido que el hardware ya tiene.
La posición hay que fijarla con precisión. Este chip no es un sustituto de la GPU. El cómputo determinista exacto, como la contabilidad o los sistemas operativos, sigue siendo dominio del hardware digital. Lo que Carnot busca es el asiento de acelerador heterogéneo para cargas de trabajo esencialmente probabilísticas: muestreo, álgebra lineal, inferencia bayesiana e inferencia de modelos generativos. Es el asiento vecino al que apunta la computación cuántica, con la diferencia de que se fabrica en CMOS estándar a temperatura ambiente.
CN101: la demostración en silicio y sus límites
Antes del CN101, la compañía publicó en 2025 en Nature Communications su primera computadora termodinámica experimental: una SPU (Stochastic Processing Unit) con ocho celdas analógicas acopladas en una placa de circuito impreso, un prototipo que demostró en hardware los principios de la IA termodinámica. El CN101 es la primera implementación que lo lleva a un chip CMOS digital. Según la compañía, puede fabricarse en procesos estándar y sus tiles funcionan de forma asíncrona con relojes locales.
Las especificaciones publicadas del CN101 son modestas: cuatro tiles de cómputo, 64 variables de estado por tile, problemas de 256 dimensiones, variables de estado de 32 bits y una NoC reconfigurable entre tiles. La compañía lo declara explícitamente un chip de pruebas, con E/S de baja velocidad: su propósito no es el rendimiento comercial, sino verificar que la computación termodinámica escalable funciona en silicio. Apunta a dos operaciones: álgebra lineal y operaciones matriciales, y muestreo probabilístico con su técnica propia de discretización, LRW (Lattice Random Walk). LRW está diseñada para ofrecer las mismas garantías de convergencia que Euler-Maruyama, la discretización estándar de las ecuaciones diferenciales estocásticas, y la compañía dice que el artículo correspondiente fue aceptado en npj Unconventional Computing.
Los resultados que la compañía presentó en Hot Chips 2026 son los siguientes: un VAE condicional (autoencoder variacional) generó dígitos manuscritos MNIST en un solo chip CN101; un modelo convolucional de flow-matching, con seis chips funcionando como un solo sistema, generó imágenes CIFAR-10 coincidiendo con una implementación de referencia en coma flotante a un nivel de unos 0,06 de RMSE por píxel. En una generación de profundidad 100 (una red de 10 capas por 10 pasos de integración), la ejecución concurrente, que relaja todas las capas a la vez, alcanzó la misma calidad con 62x menos ciclos que la ejecución secuencial (según la compañía). La versión académica incluye además resultados de computación científica como la estimación de energía libre de la alanina dipéptido.
La escala hay que leerla con honestidad. MNIST y CIFAR-10 son benchmarks de libro de texto, no cargas de trabajo reales de 2026. La propia compañía los llama «resultados a pequeña escala» y traza la línea: lo verificado son los elementos del principio, que las transiciones de estado estocásticas operan en CMOS digital y pueden ensamblarse en un modelo generativo funcional. La cifra de 62x son ciclos en una comparación de modos de ejecución específicos, no energía. Y la afirmación de eficiencia energética de 1.000x no se midió en este chip.
Hoja de ruta: lo que el CN201 y el CN301 deben demostrar
| Chip | Plazo (según la compañía) | Objetivo | Punto de verificación |
|---|---|---|---|
| CN101 | Tape-out en julio de 2025 | Demostrar en CMOS digital el álgebra lineal y el muestreo termodinámicos | Fase de verificación del principio. Generación a escala MNIST y CIFAR-10 |
| CN201 | 2026 | Difusión de alta resolución, más cargas de IA. Matriz de interacción más compacta, NoC con más tiles, control y caché en chip | Ventaja significativa de rendimiento y potencia frente al hardware convencional en tareas de IA generativa de mediana escala |
| CN301 | Finales de 2027-principios de 2028 | Difusión de vídeo a gran escala | Si la afirmación de la compañía de una mejora de varios órdenes de magnitud se cumple o no |
La estructura de la hoja de ruta es clara. Si el CN101 es el chip que pregunta «¿puede funcionar?», el CN201 es el que pregunta «¿es útil?» y el CN301 el que pregunta «¿cambia el juego?». Desde la óptica de la inversión, el punto de inflexión es el CN201. Si la ventaja de potencia en difusión de alta resolución aparece en una forma verificable por terceros, la computación termodinámica pasará de tema de artículos a tema de compras; si no, el programa seguirá siendo un largo proyecto de investigación.
Finanzas y financiación: qué significa que lidere Samsung Catalyst
| Ronda | Fecha | Importe | Líder y participantes clave |
|---|---|---|---|
| Semilla | Cerrada en enero de 2023, anunciada en junio | 8,5 millones de dólares | Co-liderada por Celesta Capital y First Spark Ventures. Participó Micron Ventures |
| Serie A | Abril de 2024 | No revelado | No revelado (según el registro de rondas de PitchBook) |
| Serie B | Marzo de 2026 | 50 millones de dólares | Liderada por Samsung Catalyst Fund. Nuevos: Galvanize, Brevan Howard Macro Venture Fund, ArcTern Ventures. Repiten Celesta, Drive Capital, First Spark, Micron Ventures |
| Total | Marzo de 2026 | Más de 85 millones de dólares | Según la compañía |
En esta tabla de capital hay que leer la composición más que el importe. Samsung Catalyst Fund es el fondo encargado de la inversión estratégica del grupo Samsung. Su responsable, Dede Goldschmidt, mencionó en el anuncio el potencial de la plataforma de Normal para ofrecer una llegada al mercado más rápida a los clientes de diseño de chips más exigentes. Cuando el líder no es un fondo financiero sino un potencial cliente y el dueño del ecosistema, la lectura razonable es que la plataforma de EDA fue evaluada como producto real durante la due diligence interna de Samsung. Que Micron Ventures haya acompañado desde la semilla hasta la Serie B va en la misma dirección: dos empresas de memoria están en la lista de accionistas desde temprano.
También es singular el apoyo del ARIA del gobierno del Reino Unido a través de su Scaling Compute Programme. Que una compañía estadounidense reciba fondos del programa de investigación de alto riesgo británico, y que la directora del programa dijera públicamente que «sacar silicio funcional en el CN101 es un resultado excepcionalmente raro para un trabajo tan ambicioso», es una forma de due diligence técnica que merece leerse.
La valoración no es pública. Por escala y etapa de las rondas, Normal sigue en la fase de «demostrar ingresos de la plataforma», y el programa de hardware se financia con el tiempo que ese motor de ingresos compra.
Mapa de la competencia
| Bloque | Jugadores | Enfoque | Diferencia con Normal |
|---|---|---|---|
| Computación termodinámica (no equilibrio) | Extropic | TSU (Thermodynamic Sampling Unit) sobre p-bits. Chip X0 y plataforma XTR-0 publicados, Z1 en desarrollo. En 2026 anunció una LOI de hasta 75 millones de dólares en fondos de I+D CHIPS con el Departamento de Comercio de EE. UU. (según la compañía) | Extropic se concentra en el propio elemento de probabilidad que opera con ruido inyectado. Normal apuesta por dinámica de equilibrio y CMOS digital, con negocio de EDA en paralelo |
| Grandes del EDA | Synopsys, Cadence | Estrategia de apilar IA agéntica sobre décadas de cadena de herramientas. Bundling y organización de soporte como fortalezas | Normal afirma una arquitectura nativa de IA centrada en el modelo formal, entrando por DV, RTL y demostración, no por el flujo completo |
| EDA abierto y de agentes | Flujos abiertos y muchas startups | Intentan automatización de verificación y diseño con agentes de IA sobre especificaciones abiertas e infraestructuras como CIRCT | Terreno donde la barrera de entrada baja. La diferenciación de Normal es su plataforma entrenada con datos de clientes y sus credenciales con grandes cuentas (afirmación de la compañía) |
| Aceleradores deterministas | GPU y ASIC de centro de datos | Simulan cargas probabilísticas en hardware determinista | El comparando directo de Carnot. Normal ataca el coste energético de la propia simulación |
La competencia es de dos niveles. En la capa de EDA, «la IA ayuda a diseñar chips» ya es dirección estándar de la industria; el juego pasa a quién gana primero la confianza del silicio de producción. En la capa de hardware, hay un rival del mismo paradigma, Extropic, y detrás la investigación de computación analógica y probabilística de grandes organizaciones como IBM. Lo propio de Normal es tener las dos capas en una sola compañía y usarlas como prueba una de otra.
Perspectiva coreana y perspectiva MBA
Desde Corea, la compañía es interesante por tres motivos. Primero, el líder de la inversión es el fondo estratégico de Samsung y la compañía anunció oficialmente su expansión en Corea. El papel de una oficina coreana es predecible, y el lector debe tomar este párrafo como inferencia a partir del comunicado, no como hecho anunciado: colaborar con Samsung Foundry, System LSI y la división de memoria, los mayores clientes de diseño y fabricación del mundo, y contratar talento coreano de diseño y verificación. Segundo, la estructura de clientes de Normal EDA. Si la afirmación de la compañía de «más de la mitad del top-10» es cierta, es probable que haya empresas coreanas en esa lista. Tercero, la computación en memoria tras la HBM. La computación probabilística y la PIM (procesamiento en memoria) están en capas distintas, pero el problema es el mismo: reducir el movimiento de datos y computar más cerca de la física. Que Micron sea inversor temprano no es ajeno a esa intersección.
Desde la óptica de un MBA, la propia estructura de la compañía es material de caso. Normal corre un modelo de dos motores. El motor 1, el EDA, fabrica ingresos de suscripción y pilotos, credenciales con grandes clientes y, sobre todo, «tiempo». El motor 2, el chip termodinámico, si funciona cambia la identidad de la compañía, pero tiene alta probabilidad de fracaso y años hasta el retorno. La decisión de diseñar el motor 2 con el motor 1, es decir, usar el dogfooding como aparato de demostración, es la jugada más fina de esta estructura: si el chip construido con su propio EDA funciona en silicio, es la prueba de ventas más fuerte para el EDA; y los flujos de trabajo de los clientes del EDA le dirán a la compañía qué chip debe fabricar.
El riesgo inverso también viene de la estructura. Los dos motores tienen mercados de talento, ciclos de venta y definiciones de éxito distintos. Los grandes clientes del EDA son, a la vez, árbitros competidores de la hoja de ruta del hardware. Y este modelo solo funciona si el motor 1 realmente vende. Si los ingresos del EDA se quedan en pilotos y no llegan a contratos formales, la compañía vuelve a ser una organización de investigación cara.
Contrapuntos y riesgos
- La juventud del paradigma. Entre los investigadores del campo circula la analogía de que la computación termodinámica actual es «la computación cuántica de los años noventa»: el principio está demostrado, pero la escala útil está lejos. La hoja de ruta de la compañía promete cerrar esa brecha antes de 2028; hay que leerla con esa distancia en mente.
- La afirmación de 1.000x no está verificada. La eficiencia energética de hasta 1.000x es una meta y una afirmación de la compañía para cargas de trabajo objetivo. Los resultados del CN101 son una demostración de conteo de ciclos y calidad de generación a pequeña escala, no una comparación de potencia en cargas comerciales. La verificación independiente del CN201 será la primera prueba real.
- El problema de verificación del chip probabilístico. Un chip cuya respuesta es una distribución no puede verificarse con las metodologías de signoff existentes. Sobre la pila de verificación construida sobre garantías deterministas de temporización y función hace falta una nueva metodología que acepte garantías estadísticas. Es un riesgo para la compañía y, paradójicamente, el problema que su propio EDA debe vender cómo resolver.
- Falta de ecosistema de software. Por eficiente que sea un chip, si no corre sobre un stack a nivel PyTorch no se vende. La madurez del modelo de programación, el compilador y las librerías importa tanto como el silicio, y esa capa es la más cara para una startup.
- Dependencia de la hoja de ruta de los clientes. Los ingresos del EDA están atados a los calendarios de diseño de unos pocos grandes clientes; el retraso del programa de uno solo puede mover un trimestre.
- Consumo de capital. El camino al CN301 requerirá más financiación a gran escala. Si la pista que construyó la ronda de 2026 se agota antes de que salgan los resultados del CN201, la compañía tendrá que volver al mercado en peores condiciones.
- El bundling de los grandes. Si los grandes del EDA empiezan a incluir funciones agénticas en sus bundles existentes a precio efectivamente cero, el poder de precios de una startup de EDA independiente se estrecha rápido.
Cronología
| Fecha | Hito |
|---|---|
| 2022 | Fundada en Nueva York. Participa en un programa de aceleración (según PitchBook) |
| Principios de 2023 | Artículo «Thermodynamic AI and the Fluctuation Frontier». Propone la dirección del hardware de probabilidad |
| Enero y junio de 2023 | Cierra y anuncia la semilla de 8,5 millones de dólares (liderada por Celesta y First Spark, con Micron Ventures) |
| Abril de 2024 | Serie A (importe no revelado) |
| 2025 | Publica en Nature Communications la primera computadora termodinámica experimental (SPU) |
| Julio de 2025 | Tape-out del CN101 (según la compañía). Primer chip termodinámico en CMOS digital |
| 12 de agosto de 2025 | Anuncia oficialmente el tape-out del CN101 y publica la hoja de ruta: CN201 (2026), CN301 (finales de 2027-principios de 2028) |
| 25 de marzo de 2026 | Anuncia la Serie B de 50 millones de dólares (liderada por Samsung Catalyst Fund, total de más de 85 millones, expansión en Corea) |
| Agosto de 2026 | Presenta los resultados del CN101 en Hot Chips 2026 (MNIST en un chip, generación CIFAR-10 con seis chips) |
| 2026 (previsto) | CN201: apunta a difusión de alta resolución |
| Finales de 2027-principios de 2028 (previsto) | CN301: apunta a difusión de vídeo a gran escala |
FAQ
Q: ¿Qué vende exactamente Normal Computing? A: Vende dos cosas. Una es Normal EDA, una plataforma de diseño de chips nativa de IA que convierte especificaciones en modelos formales con auto-formalización y automatiza el diseño y la verificación. La otra son los chips de computación termodinámica del programa Carnot, pero todavía no es un producto comercial: está en la fase del chip de pruebas CN101.
Q: ¿Qué es la computación termodinámica? A: Un enfoque que no suprime la fluctuación física ni el ruido del chip, sino que los usa directamente para computar. El proceso por el que el sistema relaja hacia su distribución de equilibrio ejecuta el muestreo y el cómputo probabilístico. La compañía afirma que favorece cargas donde extraer muestras de una distribución es la esencia: modelos de difusión, inferencia bayesiana y álgebra lineal.
Q: ¿La eficiencia de 1.000x está verificada? A: No. El factor de hasta 1.000x es una meta y una afirmación de la compañía para cargas de trabajo objetivo. Los resultados publicados del CN101 son una demostración a pequeña escala de generación MNIST y CIFAR-10 y un dato de que la ejecución concurrente usó 62x menos ciclos que la secuencial. La comparación de potencia en cargas comerciales es tarea del CN201 en adelante.
Q: ¿En qué se diferencia la auto-formalización de la IA de los EDA existentes? A: En el punto de partida. La IA agéntica de los grandes EDA apila automatización sobre su cadena de herramientas. Normal afirma que primero traduce la especificación a un modelo de lógica formal con un LLM y pone en el centro la demostración de la corrección del diseño sobre ese modelo. Su alcance comercial actual es la automatización de DV y RTL.
Q: ¿Por qué invirtió Samsung Catalyst Fund? A: Según la declaración oficial, por el potencial de la plataforma de diseño para acortar el time-to-market. El responsable del fondo mencionó el potencial de Normal para ofrecer una llegada al mercado más rápida a los clientes de diseño de chips más exigentes. Sumado al plan de expansión en Corea anunciado por la compañía, se infiere una posible colaboración con el ecosistema Samsung, aunque no se han anunciado proyectos conjuntos concretos.
Q: ¿El chip termodinámico sustituirá a la GPU? A: No. El cómputo determinista exacto seguirá siendo dominio del hardware digital. El asiento que el chip Carnot busca es el de acelerador heterogéneo especializado en cargas probabilísticas, encargándose del muestreo y la inferencia generativa junto a la CPU y la GPU.
Los hechos de este artículo se cotejaron el 22 de octubre de 2026 con comunicados de la compañía, materiales públicos de Hot Chips 2026, artículos académicos y prensa independiente. Las cifras y el estado de los socios marcados como «afirmación de la compañía» o «según la compañía» se citan tal cual provienen de su fuente. Normal Computing es privada y no publica estados financieros auditados. Los datos que varían por fuente o no son públicos, como la plantilla o el importe de la Serie A, se indican como tales en el texto.
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.


