 VLSI Korea
Análisis en profundidad de la CPU NVIDIA Vera: por qué 1,2 TB/s de ancho de banda de memoria importa más que 88 núcleos
Vera ofrece 1,5 TB de LPDDR5X SOCAMM2 y 1,2 TB/s por socket, unos 13,6 GB/s por núcleo. Comparación completa con Grace y EPYC Turin, límites de las afirmaciones del proveedor y la competencia SOCAMM2.


Análisis en profundidad de la CPU NVIDIA Vera: por qué 1,2 TB/s de ancho de banda de memoria importa más que 88 núcleos
TL;DR
- NVIDIA Vera es una CPU para centro de datos con 88 núcleos Olympus personalizados compatibles con Armv9.2-A, presentada con la plataforma Vera Rubin en la GTC de marzo de 2025, con detalles de arquitectura publicados en julio de 2026 (divulgación de arquitectura de NVIDIA, julio de 2026).
- La cifra principal no es el número de núcleos. Cada socket Vera admite hasta 1,5 TB de memoria LPDDR5X SOCAMM2 y hasta 1,2 TB/s de ancho de banda de memoria, unos 13,6 GB/s por núcleo en una división simple (divulgación de arquitectura de NVIDIA, julio de 2026; cálculo a partir de cifras divulgadas, 20 de octubre de 2026).
- Ese ancho de banda por núcleo es unas 1,8 veces el de la CPU Grace anterior y unas 2,8 veces una cifra calculada para un modelo insignia AMD EPYC Turin de 128 núcleos con DDR5-6400 de 12 canales (cálculo a partir de especificaciones del proveedor, 20 de octubre de 2026).
- NVIDIA afirma hasta 1,9 veces más instrucciones por ciclo que EPYC Turin en cargas de trabajo relacionadas con IA, pero es una afirmación del proveedor, y los resultados de benchmarks de socios publicados hasta ahora no divulgan la configuración completa ni los ajustes de TDP (divulgación de NVIDIA, julio de 2026).
- El cambio estratégico es el contenido de memoria por socket: Vera lleva 3 veces la capacidad de memoria de Grace por socket, lo que convierte el socket de CPU en un terreno de competencia por el suministro de LPDDR5X entre Samsung Electronics, SK hynix y Micron (divulgación de arquitectura de NVIDIA, julio de 2026).
Background
Durante dos décadas, el marketing de CPU para centro de datos fue en gran medida una carrera de número de núcleos. Más núcleos significaban más máquinas virtuales, más contenedores y más hilos por rack. Esa lógica funcionaba mientras las cargas de trabajo de propósito general estaban limitadas sobre todo por el rendimiento de cómputo. Funciona menos en la era de la IA con agentes, donde la CPU de un sistema de IA ya no es un host pasivo para las GPU. Orquesta llamadas a herramientas, prepara y mueve datos, ejecuta pasos de recuperación y clasificación, gestiona tráfico de red y almacenamiento, y alimenta aceleradores que se detienen rápido cuando los datos llegan tarde.
NVIDIA entró en este mercado con Grace, una CPU de 72 núcleos basada en núcleos Arm Neoverse V2, con hasta 480 GB de LPDDR5X y 546 GB/s de ancho de banda de memoria (especificaciones de NVIDIA Grace, divulgadas antes de la divulgación de Vera de julio de 2026). Grace demostró que una CPU Arm podía situarse en el centro de un rack NVIDIA. También expuso la siguiente restricción: a medida que los sistemas GPU crecían en velocidad, la CPU host necesitaba más capacidad de memoria, más ancho de banda por hilo y un enlace coherente más rápido con la GPU.
Vera es la respuesta de NVIDIA, presentada como parte de la plataforma Vera Rubin en la GTC de marzo de 2025 y detallada en divulgaciones de arquitectura en julio de 2026 (GTC, marzo de 2025; divulgación de arquitectura de NVIDIA, julio de 2026). Vera sustituye el diseño Neoverse bajo licencia por 88 núcleos Olympus personalizados. NVIDIA informa Spatial Multithreading que expone 176 hilos, un die de cómputo monolítico, 2 MB de caché L2 por núcleo, 164 MB de caché L3 y una Scalable Coherency Fabric de segunda generación (divulgación de arquitectura de NVIDIA, julio de 2026).
Las cifras de plataforma alrededor del núcleo son igual de importantes. Vera ofrece NVLink-C2C a 1,8 TB/s para comunicación coherente CPU-GPU, PCIe Gen6 y CXL 3.1, con un rango de TDP configurable de 250 a 450 W (divulgación de arquitectura de NVIDIA, julio de 2026). Dos CPU Vera forman un Superchip con 176 núcleos, 352 hilos, 16 módulos SOCAMM2, 2,4 TB/s de ancho de banda de memoria agregado y 3 TB de capacidad de memoria. Un diseño de referencia a escala de rack con 128 Superchips alcanza 22.528 núcleos y 384 TB de memoria (divulgación de arquitectura de NVIDIA, julio de 2026). Las ventas de CPU independientes y los primeros envíos a clientes fueron reportados durante 2026, por lo que las afirmaciones de disponibilidad en este artículo se expresan como información reportada, no como confirmación directa de envíos de NVIDIA (información del sector, 2026).
Deep Dive 1: El sistema de memoria — 1,5 TB y 1,2 TB/s por socket
La elección que define a Vera es su sistema de memoria. Cada socket admite hasta 1,5 TB de LPDDR5X SOCAMM2 a velocidades de hasta 9.600 MT/s, con hasta 1,2 TB/s de ancho de banda de memoria (divulgación de arquitectura de NVIDIA, julio de 2026). SOCAMM2 es un estándar de módulo LPDDR con socket impulsado por NVIDIA. A diferencia de la LPDDR soldada, un módulo con socket puede configurarse, mantenerse y escalarse según el diseño del sistema, manteniendo las ventajas de eficiencia energética de LPDDR5X frente a la memoria de servidor DDR5 convencional.
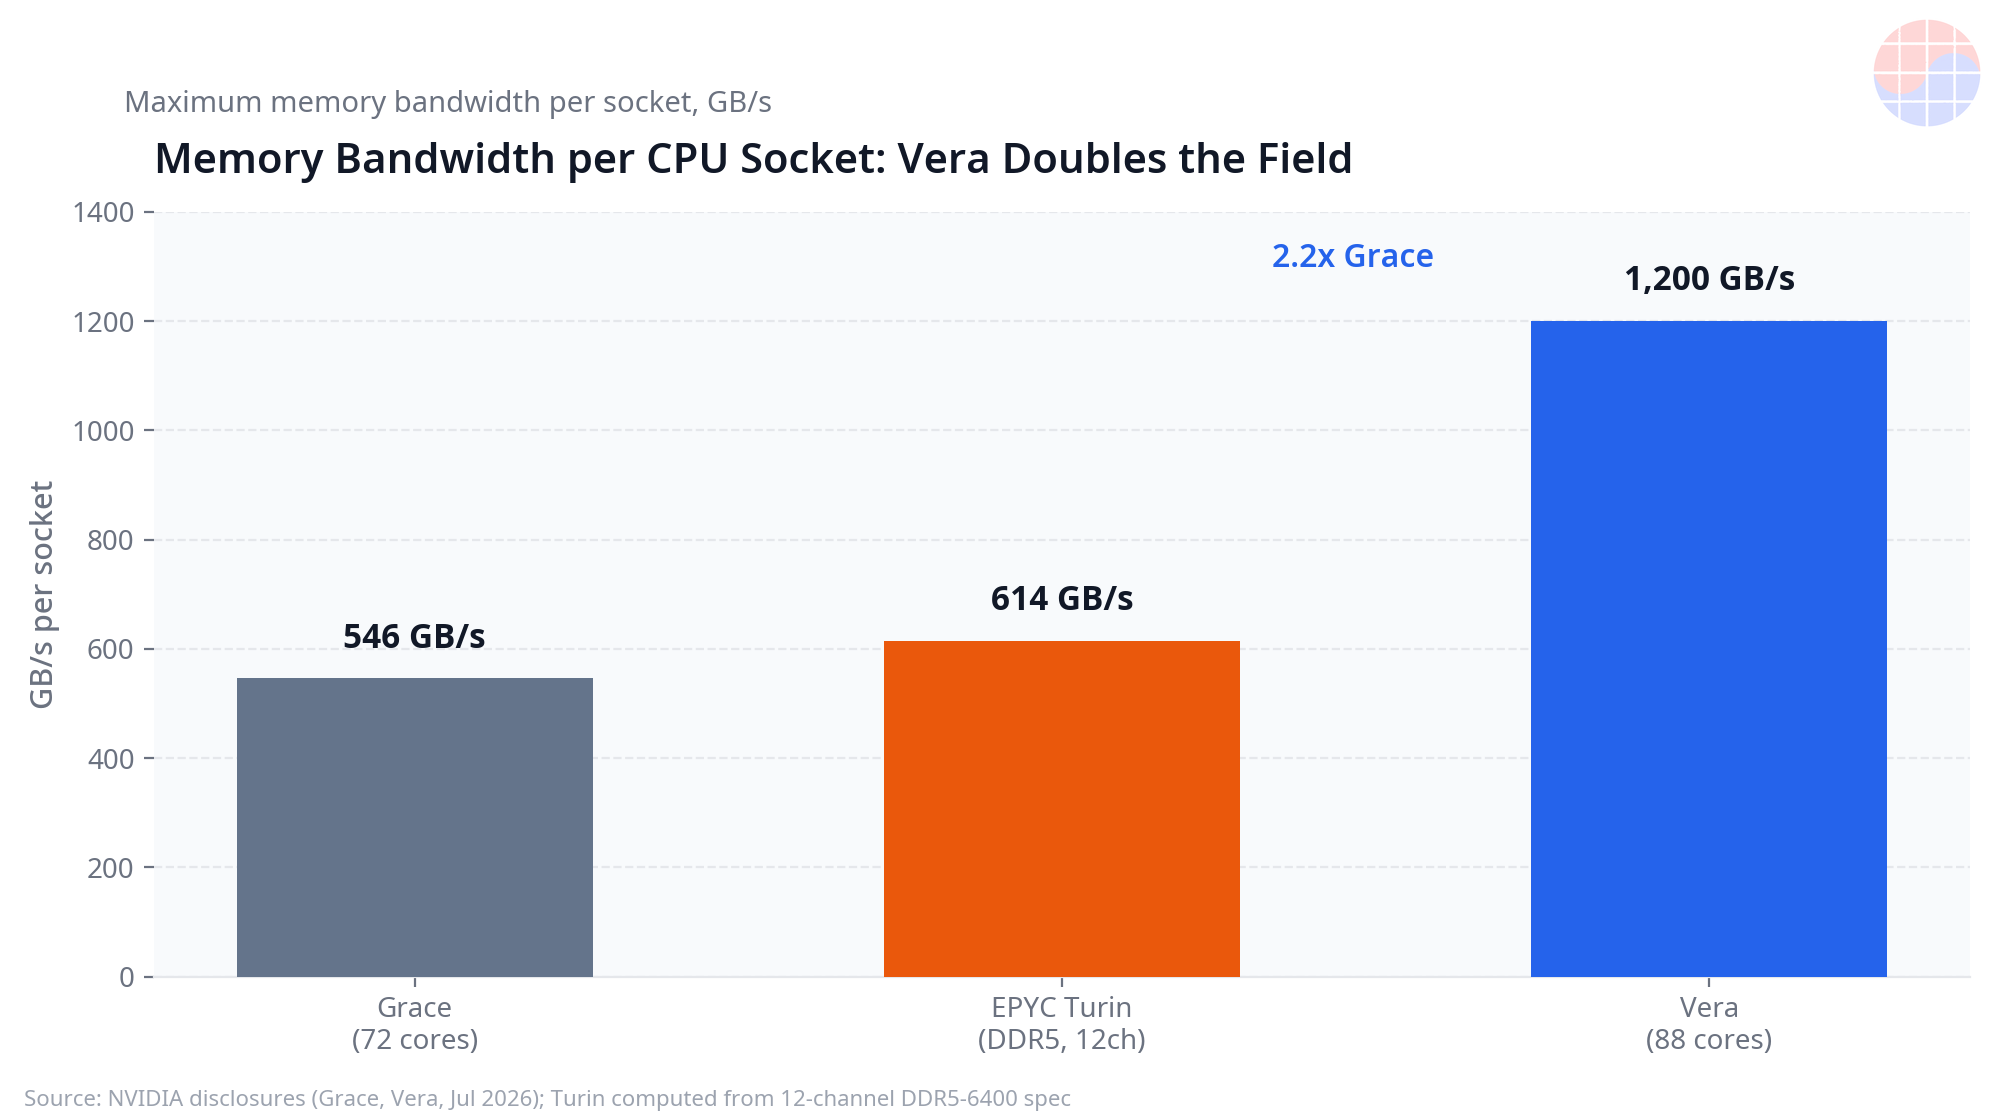
La comparación con Grace muestra cuánto se movió el diseño en una generación. Grace ofrecía hasta 480 GB de LPDDR5X y 546 GB/s de ancho de banda por socket (especificaciones de NVIDIA Grace). Vera triplica la capacidad hasta 1,5 TB y eleva el ancho de banda hasta 1.200 GB/s, un aumento de 2,2 veces (divulgación de arquitectura de NVIDIA, julio de 2026; cálculo, 20 de octubre de 2026). En términos prácticos, un socket Vera puede mantener conjuntos de trabajo más grandes en memoria local: cachés clave-valor más grandes, tablas de embeddings más grandes, más sesiones de agentes simultáneas y más datos preparados para consumo de la GPU sin recurrir a almacenamiento más lento o memoria remota.
Capacidad y ancho de banda deben crecer juntos. Capacidad sin ancho de banda deja a los núcleos esperando en una ruta de memoria congestionada. Ancho de banda sin capacidad obliga a expulsiones y recargas frecuentes. El punto de diseño de Vera — 1,5 TB a 1,2 TB/s — apunta a cargas de trabajo donde muchos hilos tocan conjuntos de datos grandes y cambiantes al mismo tiempo. Ese perfil describe canalizaciones de recuperación, servicio de características, preprocesamiento de búsqueda vectorial, carga de datos y la lógica de control alrededor de la inferencia de modelos grandes mucho mejor que un benchmark entero tradicional.
También hay una consecuencia en la cadena de suministro. Un estándar de módulo LPDDR5X con socket crea una unidad definida y reemplazable de contenido de memoria que los fabricantes de sistemas compran en volumen. Cuando un socket lleva 1,5 TB en lugar de 480 GB, cada sistema Vera multiplica el contenido LPDDR5X asociado a la CPU, antes de contar cualquier HBM asociada a la GPU. La sección 4 retoma lo que esto significa para Samsung Electronics, SK hynix y Micron.
Deep Dive 2: Ancho de banda por núcleo y la comparación con x86
El número de núcleos engaña cuando el ancho de banda de memoria no acompaña. Dividir el ancho de banda del socket entre el número de núcleos da una medida aproximada pero útil de cuánto rendimiento de memoria puede usar cada núcleo cuando todos están ocupados. Para Vera, 1.200 GB/s divididos entre 88 núcleos son unos 13,6 GB/s por núcleo, que NVIDIA redondea a unos 14 GB/s por núcleo (divulgación de arquitectura de NVIDIA, julio de 2026; cálculo, 20 de octubre de 2026). Para Grace, 546 GB/s divididos entre 72 núcleos son unos 7,6 GB/s por núcleo.
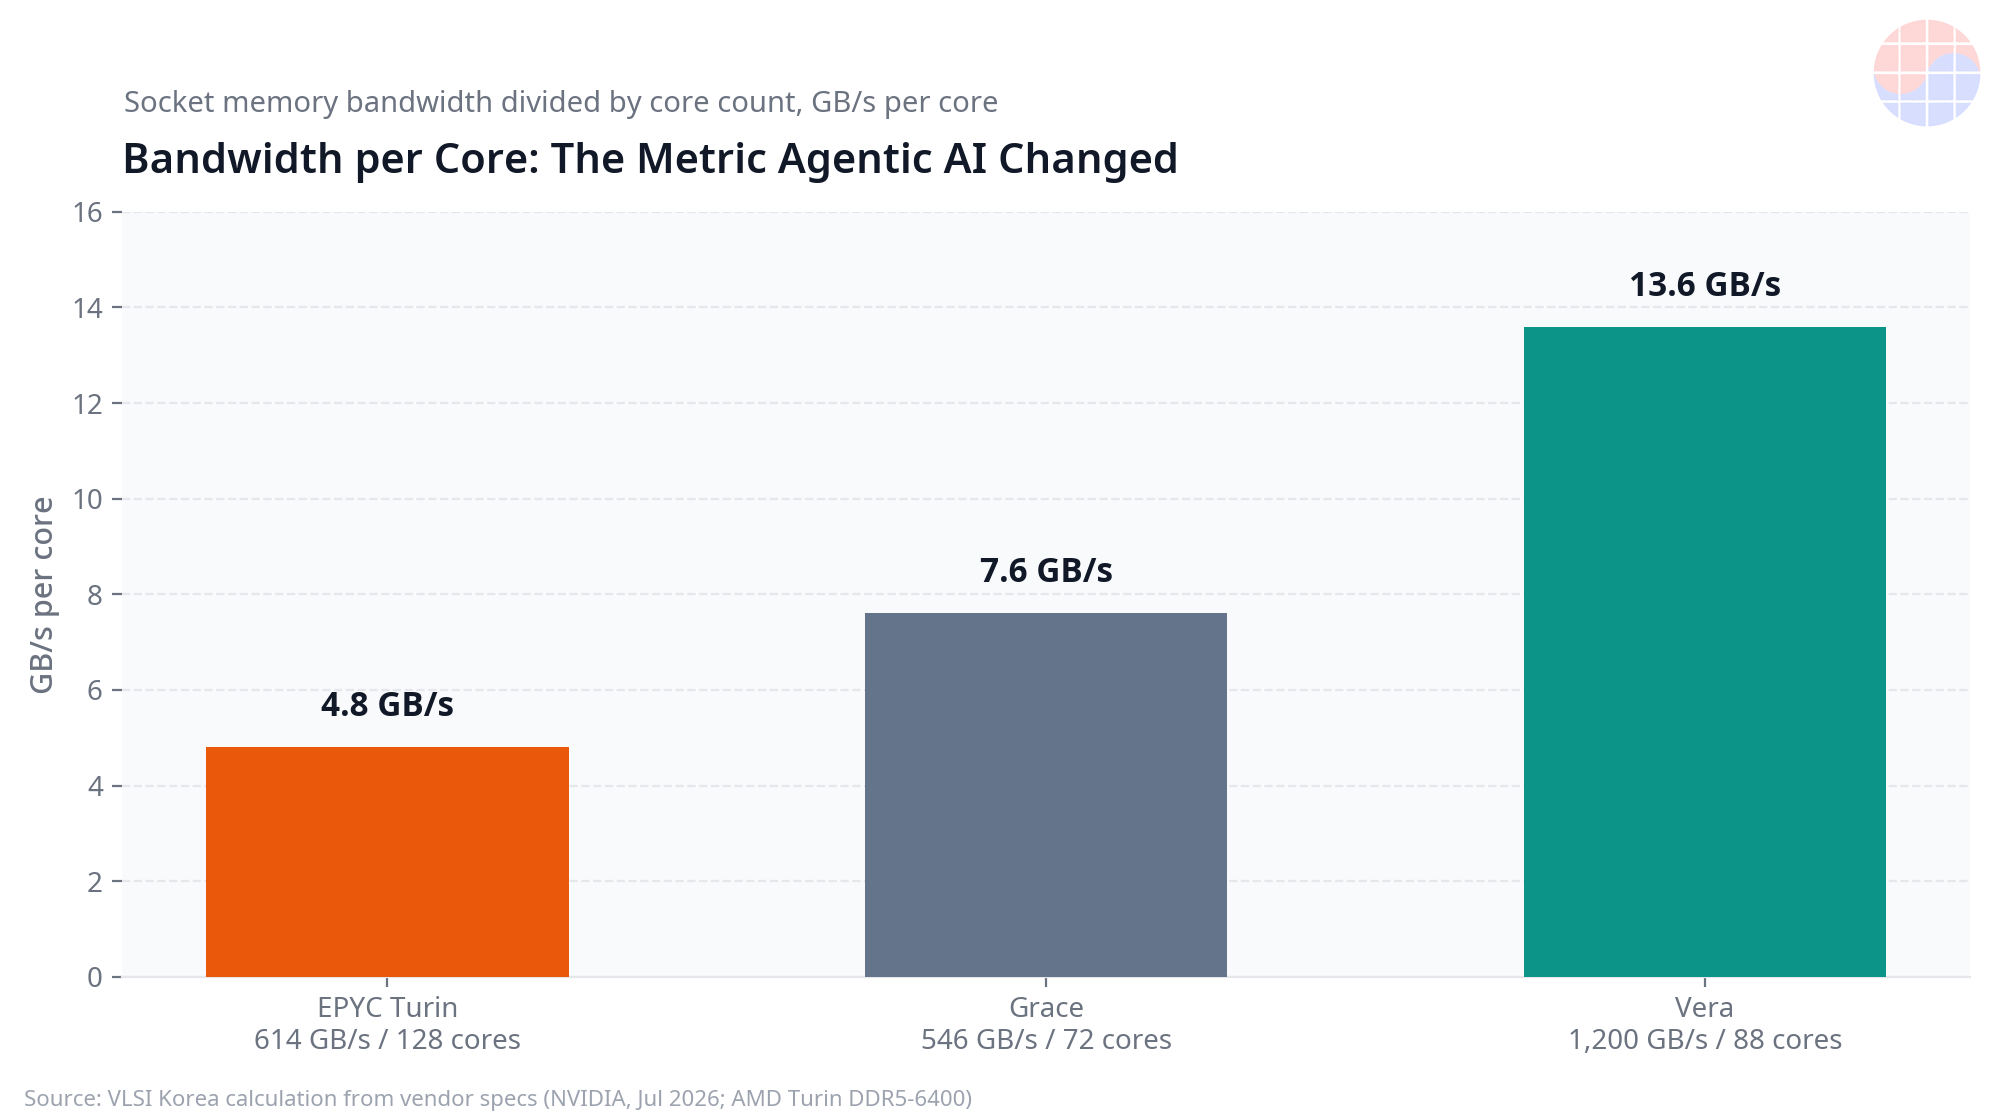
La comparación con x86 requiere un método transparente. Un sistema AMD EPYC Turin con 12 canales de DDR5-6400 tiene un pico teórico de 614 GB/s, calculado como 12 canales multiplicados por 6.400 MT/s multiplicados por 8 bytes por transferencia (cálculo a partir de especificaciones de memoria de AMD EPYC Turin, 20 de octubre de 2026). Repartido en una configuración insignia de 128 núcleos, son unos 4,8 GB/s por núcleo. El ancho de banda sostenido real es inferior al pico teórico en todas las plataformas de esta comparación, por lo que las cifras deben leerse como ratios basados en especificaciones, no como resultados medidos de aplicaciones.
Con esa base, Vera ofrece unas 2,8 veces el ancho de banda por núcleo de la configuración Turin y unas 1,8 veces el de Grace (cálculo, 20 de octubre de 2026). Esta es la parte más sólida del argumento de NVIDIA. Las cargas de trabajo con agentes y con uso intensivo de datos suelen ejecutar muchos hilos que transmiten, filtran o transforman datos. Cuando el ancho de banda por núcleo es bajo, añadir núcleos deja de ayudar porque los núcleos comparten una tubería de memoria fija. Cuando el ancho de banda por núcleo es alto, la escalabilidad de hilos dura más.
NVIDIA también afirma hasta 1,9 veces más instrucciones por ciclo que EPYC Turin en cargas de trabajo relacionadas con IA (afirmación del proveedor, divulgación de NVIDIA, julio de 2026). Esa afirmación debe tratarse con cuidado. Las instrucciones por ciclo dependen mucho de la carga de trabajo, el compilador y la mezcla de instrucciones, y un núcleo Arm personalizado y un núcleo x86 no ejecutan flujos de instrucciones idénticos. La afirmación señala la intención de diseño de NVIDIA — núcleos más anchos y eficientes alimentados con más ancho de banda — pero no es una medición independiente, y los compradores deberían esperar benchmarks reproducibles con configuraciones divulgadas antes de usarla en decisiones de compra.
Deep Dive 3: Núcleos Olympus, coherencia y el Superchip
Los 88 núcleos Olympus de Vera son diseños personalizados compatibles con Armv9.2-A, un paso más allá de los núcleos Neoverse V2 bajo licencia de Grace (divulgación de arquitectura de NVIDIA, julio de 2026). Poseer el diseño del núcleo permite a NVIDIA ajustar el rendimiento vectorial, el comportamiento de saltos y la jerarquía de caché para las cargas de trabajo que sus sistemas de rack ejecutan realmente. Cada núcleo lleva 2 MB de caché L2, y el chip ofrece 164 MB de caché L3, cifras importantes porque las cachés grandes reducen la frecuencia con la que los hilos deben esperar a la memoria principal (divulgación de arquitectura de NVIDIA, julio de 2026).
Spatial Multithreading duplica el número de hilos expuestos hasta 176 hilos por socket (divulgación de arquitectura de NVIDIA, julio de 2026). Duplicar hilos solo compensa si el sistema de memoria puede alimentar los hilos extra, por lo que la cifra de 1,2 TB/s y el número de hilos deben leerse como una sola decisión de diseño, no como dos especificaciones separadas.
La coherencia es el segundo pilar. La Scalable Coherency Fabric de segunda generación de Vera y NVLink-C2C a 1,8 TB/s permiten que CPU y GPU compartan datos de forma coherente a velocidades muy superiores a un enlace PCIe convencional (divulgación de arquitectura de NVIDIA, julio de 2026). Vera también admite PCIe Gen6 y CXL 3.1, por lo que puede conectar aceleradores convencionales, adaptadores de red y dispositivos de expansión de memoria (divulgación de arquitectura de NVIDIA, julio de 2026). En un rack de IA, el uso compartido coherente reduce la sobrecarga de copias explícitas: la CPU puede preparar estructuras de datos que la GPU consume directamente, y los resultados intermedios pueden moverse con menos transferencias gestionadas por software.
La configuración Superchip escala la misma idea. Dos CPU Vera ofrecen 176 núcleos, 352 hilos, 2,4 TB/s de ancho de banda de memoria y 3 TB de memoria en 16 módulos SOCAMM2 (divulgación de arquitectura de NVIDIA, julio de 2026). A escala de rack, el total de referencia de 22.528 núcleos y 384 TB de memoria en 128 Superchips muestra que NVIDIA diseña la capa CPU como infraestructura agrupada para flotas de agentes y canalizaciones de datos, no como un cuidador mínimo de GPU (divulgación de arquitectura de NVIDIA, julio de 2026).
La potencia es configurable entre 250 W y 450 W de TDP (divulgación de arquitectura de NVIDIA, julio de 2026). Ese rango importa para interpretar cualquier benchmark: un resultado a 450 W y un resultado a 250 W describen puntos de operación distintos, y las comparaciones que no indican el ajuste están incompletas.
Deep Dive 4: Los límites honestos — benchmarks, respuesta x86 y coste monolítico
Tres límites merecen atención directa. Primero, la evidencia pública de benchmarks es escasa. Los resultados de socios, incluidos resultados de datos en streaming asociados a Redpanda, se publicaron sin divulgación completa de configuración y ajustes de TDP (publicaciones de benchmarks de socios, 2026). Sin número de núcleos en el momento de la prueba, población de memoria, firmware y ajustes de potencia, los lectores externos no pueden reproducir las cifras ni juzgar si la comparación fue justa. La afirmación de NVIDIA de hasta 1,9 veces más IPC tiene el mismo estatus: es una afirmación del proveedor hasta que pruebas independientes con métodos divulgados la confirmen (divulgación de NVIDIA, julio de 2026).
Segundo, los proveedores x86 no están quietos. Las plataformas de servidor avanzan hacia DDR5 más rápida, memoria MRDIMM que eleva el ancho de banda efectivo por canal y nuevas generaciones con más canales de memoria. MRDIMM y las plataformas x86 de próxima generación reducirán la brecha de ancho de banda por núcleo desde la línea base de especificaciones de 614 GB/s usada arriba, especialmente en configuraciones que intercambian número de núcleos por ancho de banda. La ventaja de Vera es real en las especificaciones divulgadas a 20 de octubre de 2026, pero es una ventaja en un momento dado, no una brecha estructural permanente.
Tercero, el die de cómputo monolítico de Vera tiene un perfil de coste. Un die monolítico grande suele enfrentar una economía de rendimiento (yield) más difícil que un diseño chiplet que puede descartar solo un die pequeño defectuoso y reutilizar dies buenos conocidos en varios productos (principio general de fabricación de semiconductores, expresado el 20 de octubre de 2026). NVIDIA no ha divulgado cifras de rendimiento (yield) ni de coste unitario de Vera, por lo que aquí no se hace ninguna afirmación de coste específica. El punto es direccional: la elección de diseño que ayuda a la latencia y la coherencia también concentra el riesgo de fabricación, y el precio lo reflejará.
Por último, el software decide cuánta ventaja de hardware sobrevive al contacto con producción. La madurez del ecosistema Arm en herramientas empresariales, observabilidad y middleware heredado ha mejorado, pero el esfuerzo de migración sigue siendo un coste real para operadores con grandes instalaciones x86. El ancho de banda gana benchmarks; el coste total de propiedad gana órdenes de compra.
Chase's Take
El cambio importante no es que NVIDIA haya construido una CPU con 88 núcleos. El cambio importante es adónde se movió el cuello de botella. En los sistemas de IA con agentes, la CPU gestiona la orquestación: bucles de planificación, invocación de herramientas, recuperación, gestión de memoria para contextos largos y movimiento de datos entre almacenamiento, red y GPU. Esas tareas son ricas en hilos y hambrientas de memoria. Su recurso limitante no suele ser el pico de rendimiento en coma flotante. Es cuántos datos puede alcanzar cada hilo, a qué velocidad, sin hacer cola detrás de todos los demás hilos. Vera está diseñada alrededor de esa realidad: primero ancho de banda por núcleo y capacidad de memoria por socket, después número de núcleos.
Desde una perspectiva de negocio, SOCAMM2 puede importar incluso más que el núcleo Olympus. Al definir un módulo LPDDR5X con socket para el socket de CPU, NVIDIA convirtió la memoria host en una ranura de contenido estandarizada y de alto volumen. Vera lleva 1,5 TB por socket frente a los 480 GB de Grace, tres veces el contenido de memoria por socket (divulgación de arquitectura de NVIDIA, julio de 2026). Cada rack que adopta Vera arrastra por tanto mucha más LPDDR5X a través de la cadena de suministro.
Eso convierte el socket de CPU en un campo de batalla por el contenido de memoria. Samsung Electronics, SK hynix y Micron compiten en el suministro de LPDDR5X, y la calificación para una plataforma NVIDIA de alto volumen vale más que una sola victoria de diseño: ancla volumen, poder de fijación de precios y una posición en la próxima revisión del módulo. Los proveedores coreanos tienen un interés particular aquí, porque el liderazgo en LPDDR ha sido históricamente una fortaleza coreana, y SOCAMM2 da a esa fortaleza una nueva salida en servidores más allá de los teléfonos inteligentes. La historia de Vera, leída desde Seúl, es en parte una historia de CPU y en parte una historia sobre quién vende la memoria que rodea a la CPU.
Mi juicio: juzgue Vera por el ancho de banda por núcleo entregado en cargas de trabajo reales de agentes en producción, no por el titular de 88 núcleos ni por ajustes de benchmark no divulgados. Si las pruebas independientes confirman aunque sea la mayor parte de la ventaja de especificaciones, la presión sobre las hojas de ruta x86 — más canales, adopción de MRDIMM, menos núcleos por nivel de ancho de banda — será la señal más clara de que Vera cambió el mercado.
Implications
- Para compradores de sistemas de IA: Evalúen Vera por ancho de banda por núcleo y capacidad de memoria por socket para sus propias cargas de trabajo de agentes, recuperación y carga de datos, y exijan TDP y configuración de memoria divulgados en cada benchmark del proveedor (base: divulgación de arquitectura de NVIDIA, julio de 2026).
- Para la planificación de plataformas x86: La brecha de especificaciones — unos 13,6 GB/s por núcleo para Vera frente a unos 4,8 GB/s por núcleo para una configuración Turin de 128 núcleos con DDR5-6400 — convierte MRDIMM y los diseños con más canales en una prioridad de hoja de ruta, no en una opción (cálculo, 20 de octubre de 2026).
- Para proveedores de memoria: SOCAMM2 eleva el contenido LPDDR5X del lado CPU a 1,5 TB por socket, tres veces Grace, por lo que Samsung Electronics, SK hynix y Micron compiten por un socket más grande y más estratégico (divulgación de arquitectura de NVIDIA, julio de 2026).
- Para operadores: El coste de migración, el ajuste del ecosistema de software y el precio de un die monolítico pueden compensar parte de la ventaja de hardware; las pruebas de coste total de propiedad importan más que las afirmaciones titulares de IPC.
- Para el mercado de CPU: Si las cargas de trabajo con agentes siguen creciendo, el ancho de banda por núcleo se convierte en un criterio de compra de primer orden junto al número de núcleos, y el marketing de CPU que lidera solo con núcleos envejecerá mal.
Este artículo se basa en divulgaciones de NVIDIA de marzo de 2025 y julio de 2026 y en cálculos de especificaciones de fecha 20 de octubre de 2026; las afirmaciones de rendimiento del proveedor están etiquetadas como tales y no han sido verificadas de forma independiente.
FAQ
Q1. ¿Qué es la CPU NVIDIA Vera y cuándo fue divulgada? Vera es la CPU para centro de datos de NVIDIA con 88 núcleos Olympus personalizados compatibles con Armv9.2-A y 176 hilos mediante Spatial Multithreading. Fue presentada con la plataforma Vera Rubin en la GTC de marzo de 2025, y NVIDIA publicó divulgaciones detalladas de arquitectura en julio de 2026.
Q2. ¿Cuánto ancho de banda y capacidad de memoria ofrece Vera por socket? Cada socket Vera admite hasta 1,5 TB de LPDDR5X SOCAMM2 a hasta 9.600 MT/s y hasta 1,2 TB/s de ancho de banda de memoria, lo que equivale a unos 13,6 GB/s por núcleo en 88 núcleos (divulgación de arquitectura de NVIDIA, julio de 2026).
Q3. ¿Cómo se compara Vera con Grace y AMD EPYC Turin en ancho de banda por núcleo? Grace ofrece 546 GB/s en 72 núcleos, o unos 7,6 GB/s por núcleo. Una configuración EPYC Turin de 128 núcleos con DDR5-6400 de 12 canales tiene un teórico de 614 GB/s, o unos 4,8 GB/s por núcleo. Los aproximadamente 13,6 GB/s por núcleo de Vera son unas 1,8 veces Grace y unas 2,8 veces esa configuración Turin, sobre una base de especificaciones (cálculo, 20 de octubre de 2026).
Q4. ¿Cuáles son los principales límites y cuestiones abiertas de Vera? La afirmación de NVIDIA de hasta 1,9 veces más IPC frente a Turin es una afirmación del proveedor, benchmarks de socios como los resultados de Redpanda no divulgan la configuración completa ni los ajustes de TDP, las plataformas x86 responden con MRDIMM y diseños de memoria de próxima generación, y el die monolítico de Vera puede tener un coste de fabricación mayor que las alternativas chiplet. Aún se necesitan benchmarks independientes con métodos divulgados (estado a 20 de octubre de 2026).
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.


