 VLSI Korea
Positron AI en profundidad: la valoración de 5.000 millones y el chip de inferencia memory-first
¿Por qué Positron AI vale 5.000 millones? La Series C de 875 millones de septiembre de 2026, los más de 50 racks Atlas en Oracle y el diseño Asimov con LPDDR5X en lugar de HBM.


Resumen en 30 segundos
Positron AI vale 5.000 millones de dólares porque los inversores compran una afirmación concreta: la inferencia de IA está limitada por la memoria, no por el cómputo, y un chip diseñado en torno a memoria LPDDR5X barata puede servir modelos grandes con menor coste por token y menor consumo que una GPU construida en torno a la escasa HBM. La valoración no es un rumor. Positron anunció el 10 de septiembre de 2026 una financiación Series C y Series C-1 de 875 millones de dólares, con una valoración post-money de 5.000 millones. Es unas 4,7 veces la valoración post-money de 1.060 millones de su Series B de 230 millones en febrero de 2026, solo siete meses antes.
La empresa ya envía un producto. Más de 50 racks de Atlas, su sistema de inferencia de primera generación, están desplegados en Oracle Cloud Infrastructure, donde el socio Parasail opera un servicio de inferencia sobre esa capacidad. Entre los clientes de producción de Atlas también figuran Jump Trading e i3d.net. Sin embargo, el producto que debe justificar la mayor parte de los 5.000 millones aún no se envía. Asimov, un ASIC a medida en el proceso N3P de TSMC, tiene como objetivo el tape-out a finales de 2026 y la producción en la segunda mitad de 2027. Sus cifras de eficiencia principales proceden de simulación cycle-accurate, no de silicio de producción.
Esa brecha es toda la historia. Atlas demuestra que Positron puede construir, desplegar y operar hardware de inferencia en un centro de datos real. Asimov es la apuesta de que el mismo equipo puede convertir una arquitectura memory-first —de 288GB a 2.304GB de LPDDR5X por chip, más del 90% de ancho de banda de memoria realizable como objetivo de diseño, unos 400W por chip y ninguna dependencia de HBM ni de CoWoS— en un negocio capaz de sostener una valoración privada de 5.000 millones. Si Asimov llega a tiempo y la ventaja simulada en tokens por dólar sobrevive a las cargas reales, el precio puede parecer anticipado. Si el tape-out, el rendimiento (yield), la cualificación o la adopción de software se retrasan, bajo ese precio hay muy pocos ingresos actuales: Positron no ha publicado ingresos ni una tasa anualizada.
| Concepto | Detalle |
|---|---|
| Fundación | 2023 — sede en Reno, Nevada (EE. UU.) |
| Última ronda | Series C y C-1, 10 de septiembre de 2026 — 875 millones de dólares con una valoración post-money de 5.000 millones |
| Ronda anterior | Series B, febrero de 2026 — 230 millones de dólares con una valoración post-money de 1.060 millones |
| Financiación total revelada | Unos 1.180 millones de dólares |
| Producto en envío | Atlas, un sistema de inferencia basado en FPGA — más de 50 racks desplegados en Oracle Cloud Infrastructure |
| Próximo chip | Asimov, un ASIC personalizado en TSMC N3P — tape-out previsto para finales de 2026 y producción en la segunda mitad de 2027 |
| Objetivos de diseño de Asimov | 288GB–2.304GB de LPDDR5X por chip, 2,76 TB/s de ancho de banda de memoria realizable y unos 400W por chip |
Background: una empresa de tres años construida solo para inferencia
Positron AI fue fundada en 2023 y tiene su sede en Reno, Nevada. Fue cofundada por Thomas Sohmers, su director de tecnología, y Edward Kmett, su científico jefe, ambos procedentes de otra startup de inferencia, Groq. Mitesh Agrawal, antes director de operaciones y responsable de nube en Lambda, se incorporó como consejero delegado para escalar las operaciones comerciales. El equipo técnico fundador venía de la inferencia, no del diseño de GPU de propósito general, y el consejero delegado venía de vender y operar cómputo de IA, no de un laboratorio.
Positron no intenta entrenar modelos frontier. El entrenamiento es una competición de densidad de cómputo dominada por grandes clústeres de GPU y una pila de software madura. La inferencia —ejecutar un modelo entrenado para usuarios, agentes, copilotos, búsqueda, trading y generación de medios— es un problema operativo distinto. Funciona de forma continua, se paga por token y su economía la fijan tres restricciones que se endurecen a la vez: capacidad de memoria, ancho de banda de memoria y potencia. La capacidad decide qué modelos caben y cuánto contexto y KV cache cabe; el ancho de banda decide la velocidad de tokens; y la potencia decide cuánta capacidad puede encender un centro de datos: una instalación gana dinero con los tokens entregados dentro de su límite de potencia, no con FLOPS pico que no puede alimentar.
Atlas se diseñó para llegar al mercado antes de que Positron gastara años y cientos de millones en un ASIC a medida. Atlas es un sistema de inferencia basado en FPGA, fabricado en Estados Unidos y entregado como un appliance que los clientes pueden desplegar sin reconstruir su flujo de software. Positron llevó Atlas al mercado en unos 18 meses y lo presenta como refrigerado por aire y apto para envolventes de potencia de rack convencionales.
El historial de financiación muestra lo rápido que el mercado revalorizó esa evidencia. Positron levantó 23,5 millones en financiación seed, después una Series A de 51,6 millones en julio de 2025, después la Series B de 230 millones en febrero de 2026 con una valoración post-money superior a 1.000 millones, y después los 875 millones de Series C y C-1 en septiembre de 2026 a 5.000 millones post-money. La financiación total revelada es de unos 1.180 millones. La ronda de septiembre se dividió en una Series C de 375 millones con valoración pre-money de 3.500 millones y una Series C-1 de hasta 500 millones. Fue coliderada por NEA, Atreides Management, Valor Equity Partners, Andra Capital, SemiAnalysis Capital y Jim Clark, con Qatar Investment Authority, Cisco Investments y Naver Ventures entre los demás participantes.
Business Deep Dive: qué vende realmente Positron
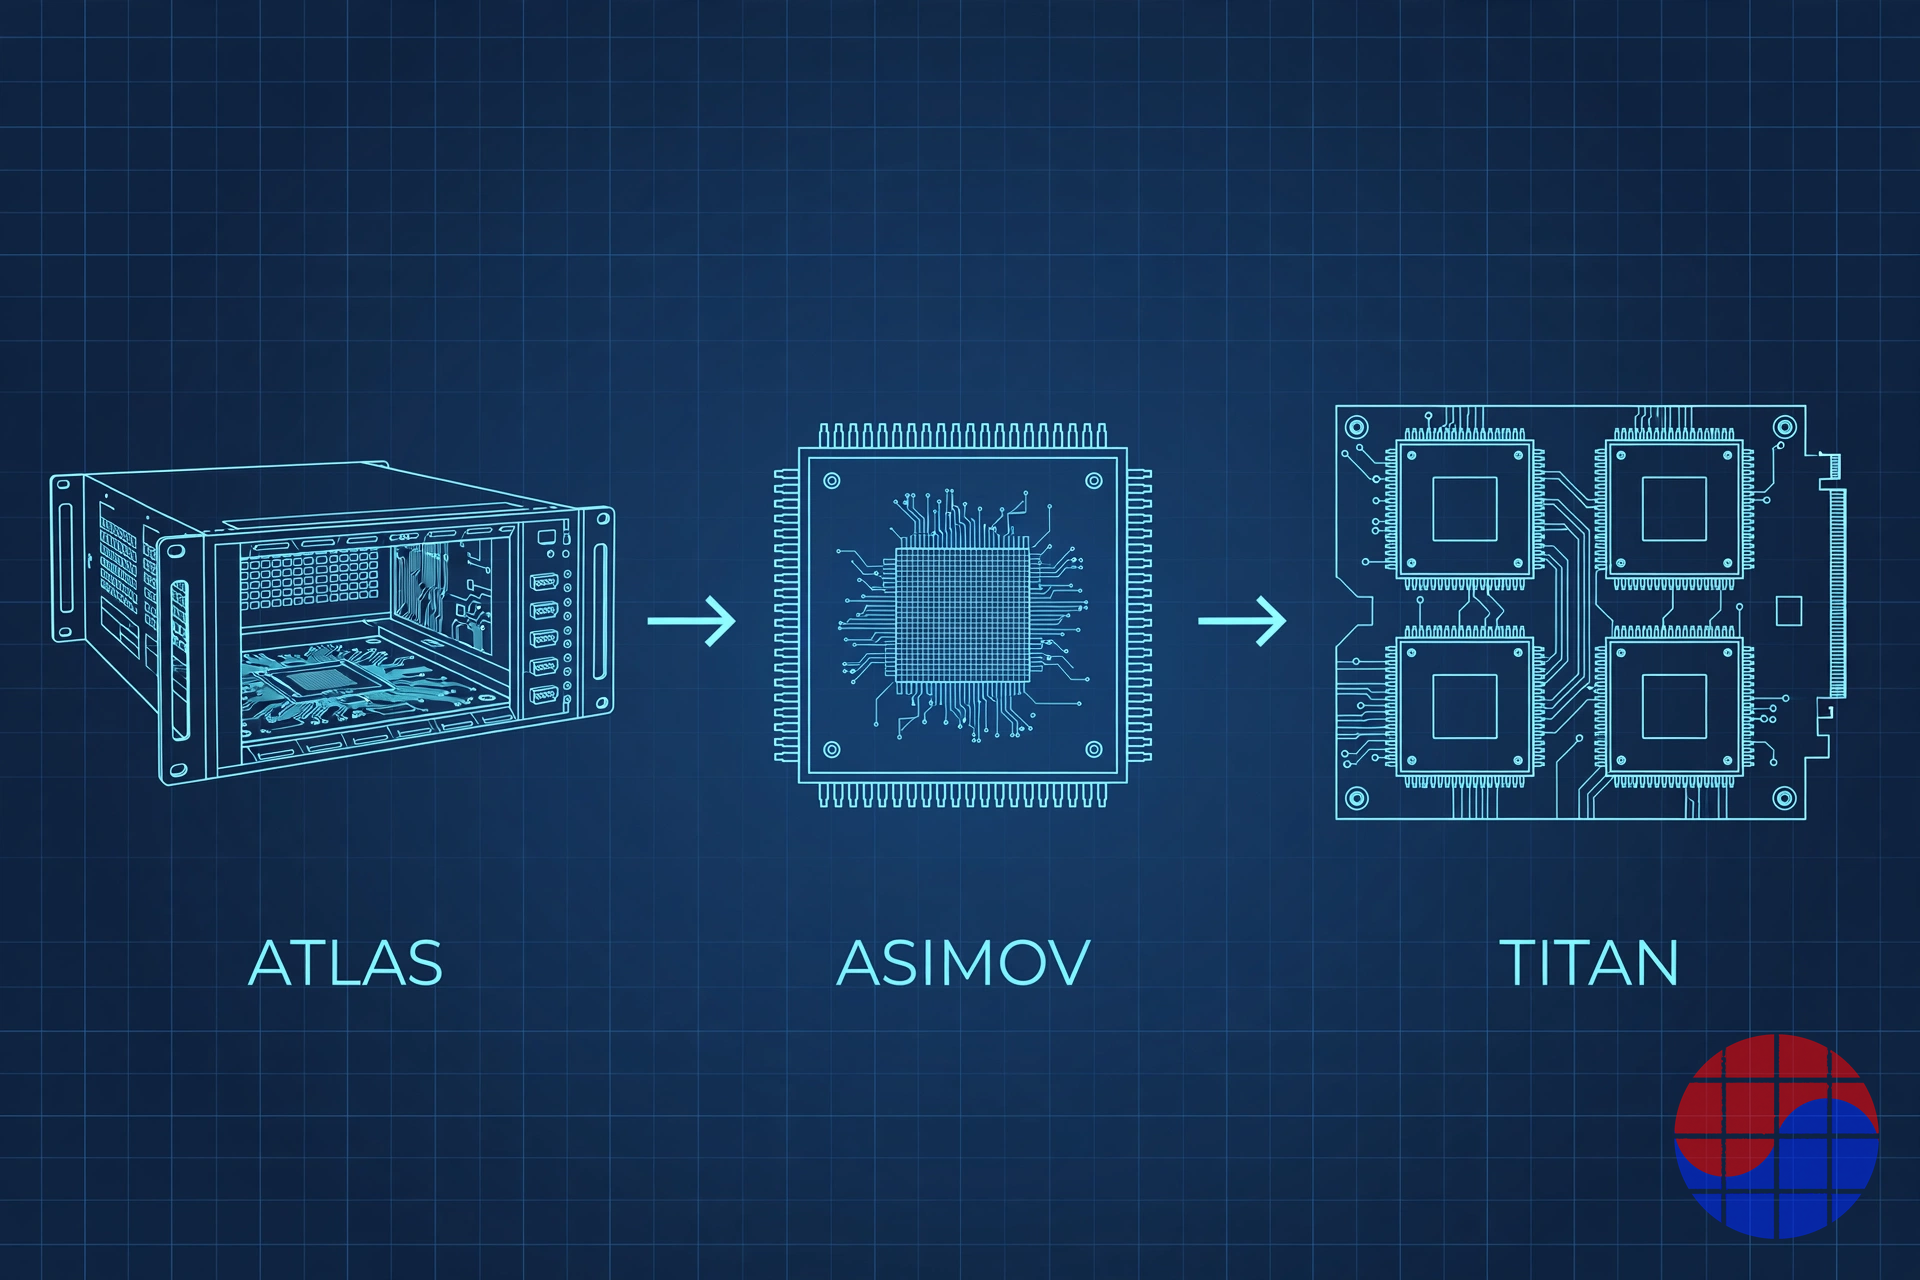
La escalera de productos: Atlas hoy, Asimov y Titan después
Positron vende sistemas de inferencia, no una hoja de ruta de chips. Atlas es la primera generación en envío. Asimov es el ASIC a medida de próxima generación. Titan es el sistema construido en torno a Asimov, con cuatro a ocho chips Asimov por nodo. Positron afirma que Titan está diseñado para modelos de más de 16 billones de parámetros y ventanas de contexto de más de 10 millones de tokens en un solo nodo. Son objetivos de diseño para cargas muy grandes, de contexto largo y agénticas, no la afirmación de que todos los clientes necesiten hoy esa escala.
El modelo de negocio sigue al hardware. Positron suministra capacidad de inferencia completa —sistemas que un proveedor de nube, una neocloud, una firma de trading o un operador de hosting puede poner en producción— en lugar de pedir a los clientes que integren un componente y construyan el resto. El despliegue en Oracle ilustra el modelo: los racks Atlas están dentro de Oracle Cloud Infrastructure y Parasail usa esa capacidad para su servicio de inferencia. Jump Trading es instructivo de otro modo: primero usó Atlas como cliente y después colideró la Series B. Que un cliente se convierta en inversor no prueba una gran base de ingresos, pero es una señal más fuerte que un logotipo en una presentación.
La arquitectura memory-first, en términos de ingeniería
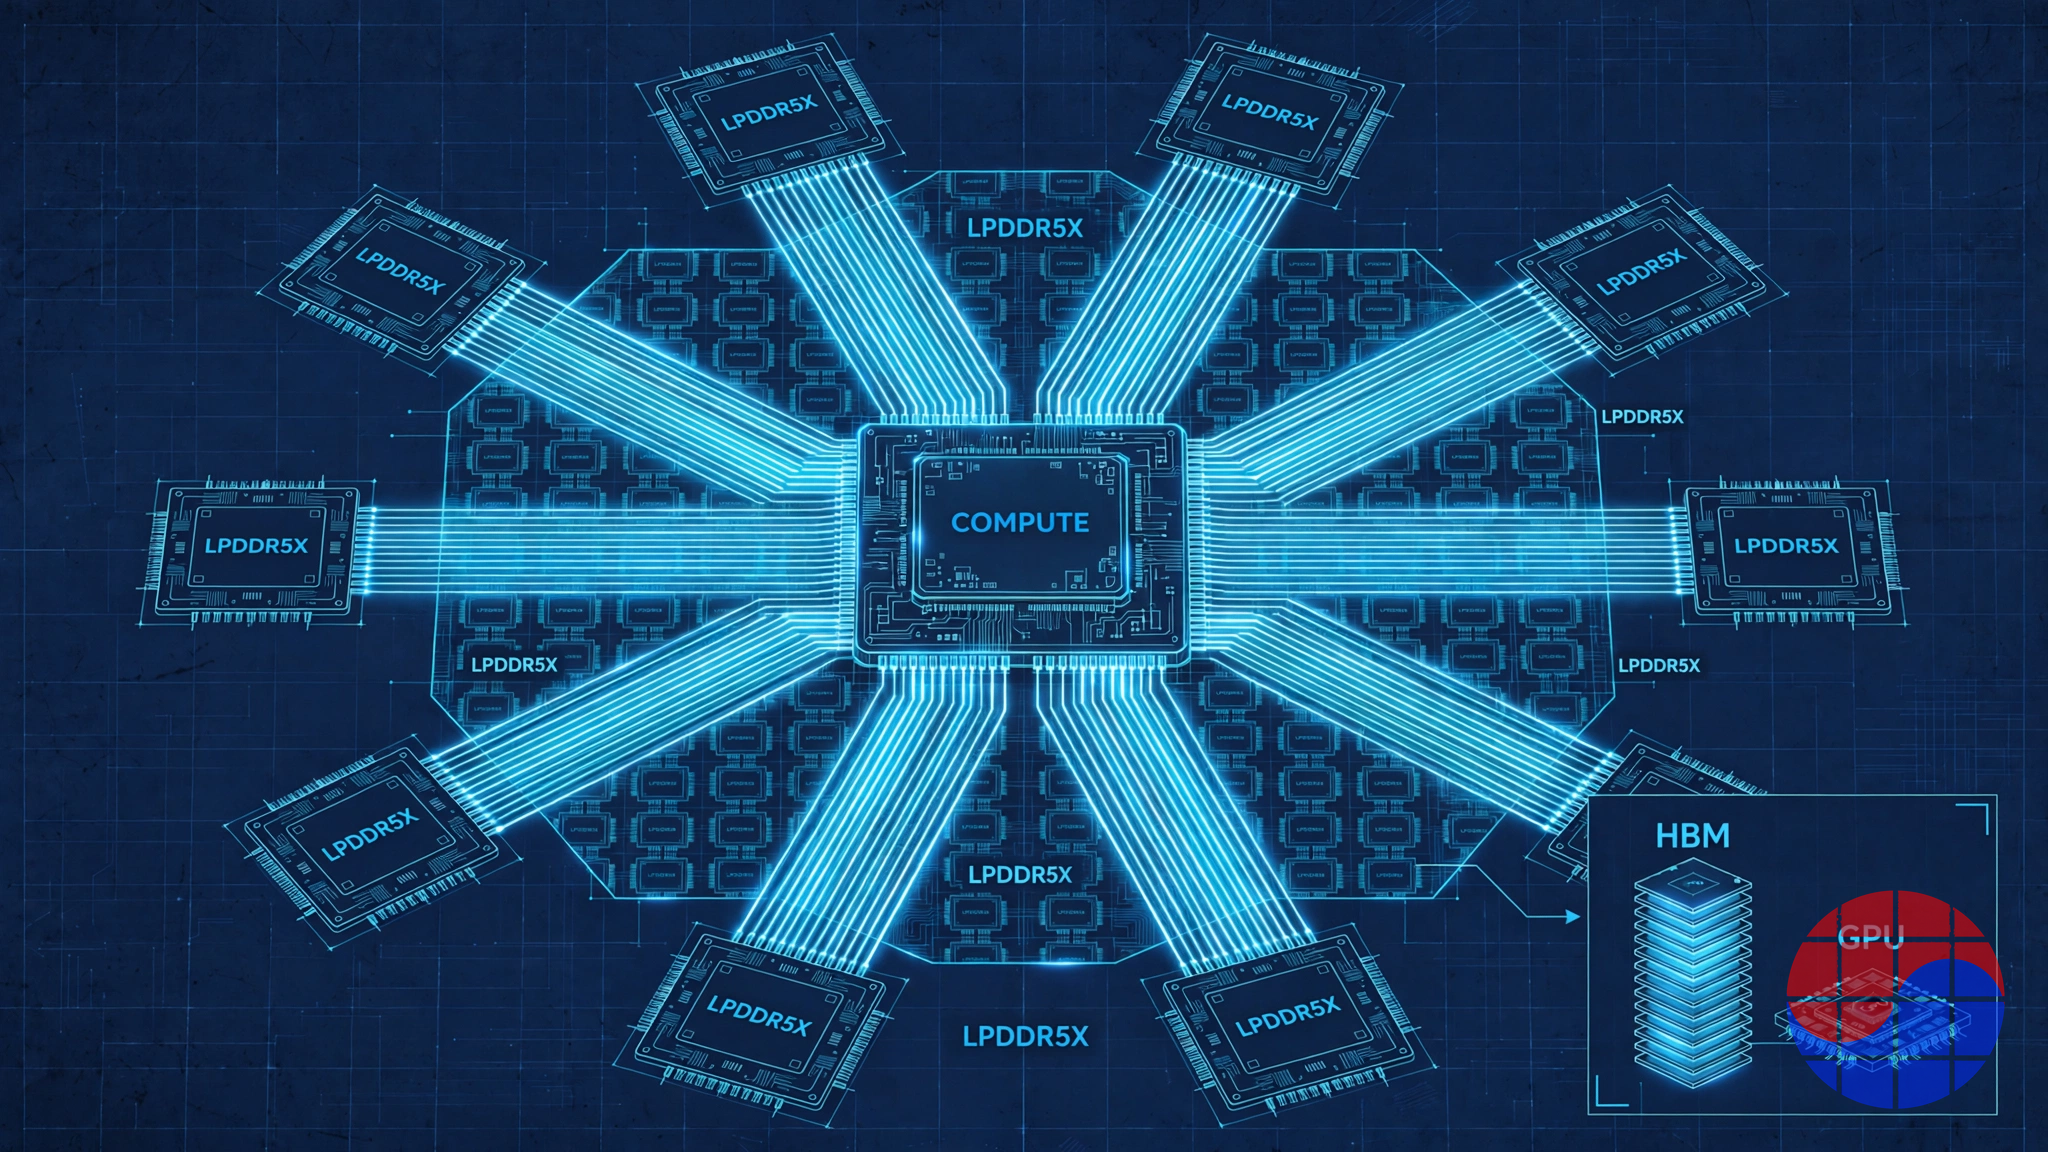
La mayoría de los aceleradores de IA parten del cómputo y le acoplan la memoria más rápida disponible. Esa memoria es HBM, DRAM apilada junto al procesador y entregada mediante encapsulado avanzado como CoWoS. HBM ofrece un ancho de banda pico muy alto, pero es cara, limitada en capacidad por paquete y expuesta a una cadena de suministro concentrada. Positron invierte el orden de diseño. Parte de la observación de que la inferencia con transformers suele estar limitada por la memoria: el sistema pasa gran parte del tiempo moviendo pesos, activaciones y KV cache, no calculando a velocidad pico.
Por eso Asimov usa memoria commodity LPDDR5X —la clase de memoria de teléfonos y portátiles— en lugar de HBM. El compromiso es explícito. LPDDR5X tiene mucho menos ancho de banda por pin que HBM, así que Positron debe agregar muchos canales y mantenerlos ocupados. A cambio, puede acoplar mucha más capacidad por chip, evitar los cuellos de botella de HBM y CoWoS y apoyarse en una base de suministro de memoria más profunda y barata. Los objetivos publicados de Asimov incluyen de 288GB a 2.304GB de memoria por chip, 2,76 TB/s de ancho de banda de memoria realizable, soporte de PCIe Gen6 y CXL, y una envolvente de potencia de unos 400W con soporte de refrigeración por aire. Para conectar tanta LPDDR, Positron usa un enfoque de fan-out de memoria basado en chiplets, incluido el chiplet Weaver desarrollado con Credo.
La afirmación técnica central es la utilización. Positron afirma que sus sistemas memory-first pueden realizar más del 90% del ancho de banda de memoria disponible, y Atlas se ha descrito con hasta un 93% de utilización. Las cargas de inferencia en GPU, en cambio, suelen describirse como capaces de realizar una fracción mucho menor del ancho de banda pico de HBM en condiciones reales de servicio. Por eso una simple comparación de ancho de banda pico engaña. Una GPU puede anunciar un pico mucho mayor y aun así entregar menos ancho de banda útil en un modelo dado si los patrones de acceso, el batching y el comportamiento de la caché dejan ese pico inalcanzable. El argumento de Positron no es que LPDDR sea más rápida que HBM. Es que una arquitectura equilibrada puede extraer más de un fondo de ancho de banda más pequeño y barato, albergando a la vez mucho más modelo y contexto en memoria.
Potencia: la afirmación y su nivel de evidencia
Positron afirma que Atlas entrega unas tres veces más cómputo por vatio que una Nvidia H100 y, en algunas descripciones, más de un 70% más de rendimiento de tokens con aproximadamente dos tercios menos de potencia que sistemas Hopper comparables. Para Asimov, la empresa ha afirmado cinco veces más tokens por vatio que la próxima GPU Rubin de Nvidia en sus cargas centrales, y las comparaciones de Titan basadas en simulación se han presentado hasta en 26 veces más tokens por dólar que un sistema GB300 NVL72 a una velocidad de tokens por usuario especificada. Estos números deben leerse en dos niveles de evidencia. Atlas se está enviando, pero sus comparaciones siguen siendo datos reportados por la empresa y no han sido zanjadas por un único benchmark independiente aceptado en toda la industria. Asimov aún no ha hecho tape-out, así que sus cifras son objetivos de diseño derivados de simulación. Ninguna de las dos categorías debe escribirse como un hecho medido.
El argumento de potencia sigue siendo comercialmente coherente incluso tras ese descuento. Los centros de datos existentes contienen mucha capacidad refrigerada por aire construida para densidades de rack menores. Un sistema desplegable sin reconstruir la refrigeración líquida amplía la base instalada alcanzable. También cambia la unidad de competición a los tokens entregados por megavatio ya disponible, la métrica que compra un operador limitado por la potencia.
Qué debe suponer una valoración de 5.000 millones
Una valoración post-money de 5.000 millones tras levantar 875 millones significa que los nuevos inversores pagaron por futuros ingresos de sistemas, no por efectivo en el balance. En aritmética simple, los 875 millones son el 17,5% de los 5.000 millones post-money, aunque la estructura en dos tramos y las condiciones de los valores hacen que ese porcentaje no sea un cálculo exacto de participación. El valor restante debe proceder de que Asimov y Titan se conviertan en ventas de sistemas repetibles y de alto volumen.
Para que eso funcione, al menos cinco condiciones deben cumplirse a la vez. Primero, Asimov debe hacer tape-out a finales de 2026 sin un re-spin importante. Segundo, la producción en la segunda mitad de 2027 debe lograr un yield utilizable y la cualificación del sistema en el N3P de TSMC. Tercero, la utilización del ancho de banda y la ventaja en tokens por vatio simuladas deben aparecer en modelos de clientes, con tamaños de batch de producción y objetivos de latencia, no solo en cargas seleccionadas. Cuarto, los clientes deben poder ejecutar sus modelos sin una migración de software dolorosa; los compradores de inferencia pagan por tokens entregados, no por elegancia arquitectónica. Quinto, Positron debe fabricar y dar soporte a sistemas a escala mientras el precio y el suministro de LPDDR sigan siendo lo bastante favorables para preservar su argumento de coste frente a los sistemas con HBM.
La revelación de ingresos es la variable que falta. Positron ha dicho que espera un fuerte crecimiento de ingresos y su consejero delegado ha descrito acuerdos de Atlas por decenas de millones de dólares, pero la empresa no ha publicado una cifra de ingresos ni una tasa que permita calcular un múltiplo precio-ventas. Cualquier múltiplo citado hoy para Positron sería, por tanto, inventado. La afirmación honesta sobre la valoración es más estrecha y más útil: 5.000 millones es el precio negociado de los valores de septiembre de 2026, sostenido por un negocio Atlas en envío y una expectativa muy grande para Asimov.
Chase's Take
Mi juicio es que la tesis memory-first es real, y la valoración sigue por delante de la evidencia. Ambas afirmaciones no se contradicen. La economía de la inferencia se desplaza del cómputo bruto hacia la capacidad de memoria, el ancho de banda realizado y la potencia, sobre todo a medida que crecen las ventanas de contexto, las trazas de razonamiento y las KV caches. Usar LPDDR5X para escapar de la cola de HBM y CoWoS es una idea genuina de arquitectura y de cadena de suministro, no un cambio de etiqueta comercial. Construir Atlas primero sobre FPGA también fue la secuencia correcta: Positron aprendió de racks en producción antes de comprometer su balance en un ASIC N3P.
Lo que compran los 5.000 millones, sin embargo, no es el negocio Atlas tal como existe en octubre de 2026. Compran un lanzamiento exitoso de Asimov en 2027, una rampa de Titan después, y suficiente cambio de clientes en un mercado donde el ecosistema de software del incumbente es la opción por defecto. El calendario ya merece atención: en febrero de 2026 la producción se discutía para principios de 2027; en la financiación de septiembre, el objetivo era la segunda mitad de 2027. Puede ser un plan más preciso y no un retraso, pero para un chip anterior al tape-out, el tiempo es riesgo. Cada trimestre de deslizamiento da a las hojas de ruta de GPU, a los ASIC de inferencia rivales y al silicio a medida de los hyperscalers otro trimestre para cerrar la brecha de eficiencia.
La prueba que yo vigilaría no es otro gráfico simulado de tokens por dólar. Son tres hechos operativos en secuencia: el tape-out de Asimov anunciado a tiempo, mediciones independientes o publicadas por clientes sobre silicio de producción, y pedidos repetidos de Titan de un cliente que primero pagó por Atlas. Si llegan esos tres, 5.000 millones parecerá el precio de entrada. Si el primero se retrasa, la discusión sobre la valoración cambia de inmediato, porque no hay una base de ingresos revelada que absorba la decepción.
Implications
Para los operadores de centros de datos, Positron es un recordatorio de que las compras de inferencia deben evaluarse por tokens realizados por dólar y por vatio, con sus propias longitudes de contexto y objetivos de latencia, no por FLOPS pico ni ancho de banda pico. La capacidad de memoria por nodo también se convierte en una variable de compra a medida que crecen las cargas de contexto largo y agénticas.
Para la industria de la memoria, Asimov es una señal de demanda fuera de la ruta HBM. Una plataforma de inferencia basada en LPDDR5X con éxito a escala ampliaría el mercado de DRAM commodity en centros de datos y crearía un nuevo centro de diseño en torno a chiplets de fan-out de memoria y expansión CXL. No sustituiría a HBM en el entrenamiento, pero demostraría que el nivel de inferencia puede segmentarse por economía de memoria.
Para los inversores, la ronda de septiembre marca dónde se concentra el capital a finales de 2026: no en otro clúster de entrenamiento, sino en el coste de servir modelos ya entrenados. También fija un estándar de diligencia claro: preguntar si una cifra vino de silicio en envío o de simulación, si el cliente pagó y repitió pedido, y si la valoración sigue funcionando si la producción se mueve dos trimestres.
FAQ
¿Cuál es la última valoración de Positron AI y cuándo se fijó?
Positron AI anunció el 10 de septiembre de 2026 una financiación Series C y Series C-1 de 875 millones de dólares, con una valoración post-money de 5.000 millones de dólares. La ronda siguió a una Series B de 230 millones en febrero de 2026, con una valoración post-money de 1.060 millones.
¿Qué vende Positron AI hoy?
Positron vende Atlas, un sistema de inferencia de IA de primera generación basado en FPGA, ya desplegado en más de 50 racks en Oracle Cloud Infrastructure. Entre los clientes de producción nombrados están Jump Trading e i3d.net, y el socio Parasail opera un servicio de inferencia sobre la capacidad de Oracle.
¿En qué se diferencia Asimov de una GPU que usa HBM?
Asimov es un ASIC memory-first que usa LPDDR5X commodity en lugar de HBM, con objetivos de 288GB a 2.304GB de memoria por chip, más del 90% de ancho de banda de memoria realizable como meta de diseño, unos 400W por chip y ninguna dependencia del suministro de HBM o CoWoS. Su tape-out está previsto para finales de 2026 en el N3P de TSMC, con producción en la segunda mitad de 2027.
¿Están verificadas de forma independiente las afirmaciones de eficiencia de Positron?
Ningún benchmark independiente publicado zanja las afirmaciones principales de Positron. Las comparaciones de Atlas, como unas tres veces más cómputo por vatio que una H100, son datos reportados por la empresa. Las cifras de Asimov, incluidos cinco veces más tokens por vatio que Rubin en cargas centrales, se basan en simulación previa al tape-out y deben tratarse como objetivos de diseño.
Nota: las cifras de valoración y financiación son las condiciones anunciadas por la empresa el 10 de septiembre de 2026; las comparaciones de rendimiento son afirmaciones de la empresa u objetivos de simulación, según se identifica en el texto, y Positron no ha publicado una cifra de ingresos.
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.


