 VLSI Korea
Startup Files #1: FuriosaAI — el chip de inferencia de IA que rechazó los $800M de Meta
FuriosaAI es una fabless de chips de inferencia de IA fundada en Seúl en 2017. Con RNGD, su chip de 2ª generación en TSMC 5nm (FP8 512 TFLOPS, TDP 180W), captó $246M acumulados, se volvió unicornio en julio de 2025 y rechazó los $800M de Meta.


Empecemos por la conclusión. FuriosaAI es una rara startup coreana de chips de IA que demostró con silicio que tenía motivos para rechazar una oferta de adquisición de $800M. Fundada en Seúl en 2017, esta empresa fabless alcanzó en julio de 2025 una financiación acumulada de $246M y una valoración de 1 billón de KRW (unicornio), y en enero de 2026 inició la producción en masa de RNGD, su chip de inferencia de segunda generación basado en el nodo de proceso de 5nm de TSMC. Tras rechazar la propuesta de adquisición de Meta en marzo de 2025, sumó como clientes a LG AI Research, Samsung SDS y Equinix, y avanza hacia una IPO en 2027~2028.
Company in a Nutshell
FuriosaAI es una startup fabless de semiconductores con sede en Seúl, fundada en 2017. Diseña exclusivamente NPU dedicadas a la inferencia de IA (inference) y delega la producción en TSMC. Como base en el extranjero cuenta con una oficina en Santa Clara, Estados Unidos, y en septiembre de 2026 abrió una filial en Singapur.
- Fundador y CEO June Paik — diseñaba GPU en AMD y en 2013 regresó a Corea, donde lideró un pequeño equipo de desarrollo de nuevos productos de memoria en Samsung Electronics. El cofundador y CTO Hanjoon Kim también procede de Samsung Electronics.
- CRO Jeehoon Kang — profesor de KAIST (especializado en sistemas paralelos) que ejerce como responsable de investigación, mientras que el VP of Hardware Youngjin Cho es un experto en SoC que fue Corporate VP de Samsung Electronics.
- El nombre de la empresa procede de Furiosa, el personaje de la película Mad Max: Fury Road.
- La participación del CEO June Paik es del 17.6% (según la declaración pública de mediados de 2025).
Core Technology
El núcleo de FuriosaAI es la arquitectura TCP (Tensor Contraction Processor). No trata la multiplicación de matrices (matmul), sino la propia contracción de tensores (tensor contraction) como unidad nativa de operación. La idea también cuenta con validación académica: se han publicado dos artículos, "TCP: A Tensor Contraction Processor for AI Workloads" (ISCA 2024) y "FuriosaAI RNGD: A Tensor Contraction Processor for Sustainable AI Computing" (Hot Chips 2024).
Por qué tensor contraction. La etapa de decodificación de la inferencia de LLM es una fase memory-bound en la que el cuello de botella no es el cálculo, sino el ancho de banda de memoria. Lo que determina los tokens por vatio es cuánto se mueven los datos y con qué eficiencia. TCP es un diseño que ataca de frente ese cuello de botella.
Warboy (1ª generación, para visión por computadora)
Warboy es un acelerador de IA para inferencia de visión por computadora en centros de datos, fabricado con el proceso FinFET de 14nm de Samsung Foundry (diseñado sobre la AI Inference SoC Platform de SEMIFIVE). Obtuvo su primer silicio en 2021, entró en producción en masa en abril de 2023 y registró un one-shot silicon success.
- MLPerf Inference v1.1 (2021) — aproximadamente 1.5 veces frente a Nvidia T4 en object detection e image classification. Fue la única startup que presentó resultados con un chip de silicio.
- MLPerf Inference Edge v2.0 (2022) — con el mismo silicio, solo mejoras del compilador duplicaron el rendimiento. SSD-MobileNetV1 offline throughput 8,762 frente a Nvidia A2 4,856 (aproximadamente 1.8 veces).
- Se desplegó realmente en los principales centros de datos en la nube de Corea, y Kakao Enterprise lo probó (prensa de 2023).
RNGD ("Renegade", 2ª generación, para inferencia de LLM)
Es el chip de segunda generación presentado en agosto de 2024 en Hot Chips (Stanford). Se desarrolló conjuntamente con GUC (Global Unichip) de Taiwán, funciona a 1.0GHz con TSMC 5nm e integra 2 stacks de HBM sobre un interposer CoWoS-S. Según la documentación oficial para desarrolladores (developer.furiosa.ai), las especificaciones clave son las siguientes.
| Concepto | RNGD |
|---|---|
| Proceso / frecuencia de funcionamiento | TSMC 5nm / 1.0GHz |
| BF16 / FP8 | 256 TFLOPS / 512 TFLOPS |
| INT8 / INT4 | 512 TOPS / 1024 TOPS |
| Memoria | HBM3 48GB, 1.5TB/s (SRAM en chip de 256MB) |
| Interconexión | PCIe Gen5 x16 |
| TDP | 180W |
| Factor de forma | PCIe dual-slot, full-height 3/4 length, passive cooling |
| Virtualización y seguridad | Multi-instance 8, SR-IOV 8 VF, ECC, secure boot |
La línea de productos consta de dos opciones: la tarjeta PCIe RNGD y el servidor NXT RNGD (lanzado en septiembre de 2025). El servidor NXT es un servidor 4U con 8 tarjetas, con 4 petaflops en FP8, un total de 384GB de HBM3 y un ancho de banda total de 12TB/s, con 3kW por servidor. En un rack de 15kW caben 5 unidades, mientras que en el mismo rack solo cabe 1 Nvidia DGX H100 (máximo 10.2kW).
La pila de software está formada por compilador, runtime, compresor de modelos, profiler y framework de serving, se integra con PyTorch 2.x y es compatible con TensorFlow Lite y ONNX. También admite entornos Kubernetes, contenedores y SR-IOV.
La producción en masa comenzó en enero de 2026. Recibió de TSMC un primer volumen de producción de 4,000 unidades y empezó a suministrarlas a clientes en forma de encapsulado y tarjetas (TheElec, abril de 2026).
La tercera generación correrá a cargo de la asociación de desarrollo conjunto con Broadcom anunciada en mayo de 2026. Se trata de una plataforma de inferencia de IA a escala de rack basada en chiplets, con planes de incluir un compute die de 2nm y HBM4/4E (prensa de fuentes secundarias).
Funding & Investors
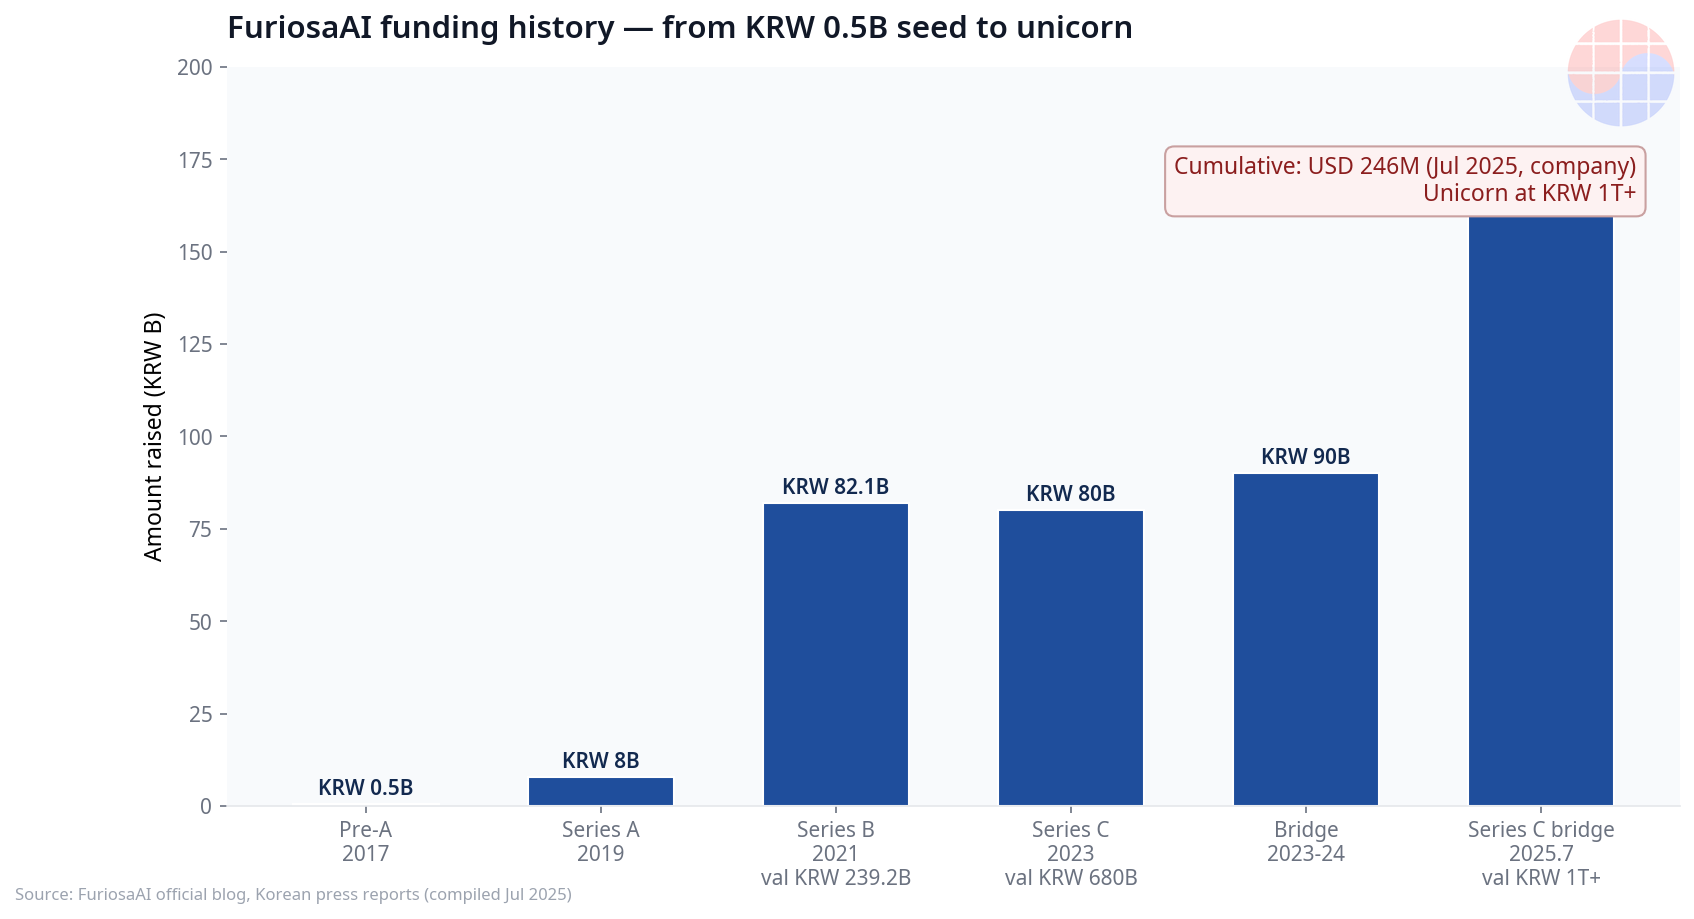
La captación de inversión de FuriosaAI es un manual de escalado gradual a lo largo de 8 años. Según los anuncios oficiales de la empresa, la financiación acumulada es de $246M (julio de 2025).
| Ronda | Fecha | Importe | Inversores principales | Valoración |
|---|---|---|---|---|
| Pre-A | 2017 | ₩0.5B | Naver D2SF | — |
| Series A | 2019 | ₩8B | Industrial Bank of Korea, DSC Investment | — |
| Series B | 2021 | ₩82.1B | DSC Investment, IMM Investment | ₩239.2B |
| Series C | 2023 | aprox. ₩80B | Mubadala, Qatar Investment Authority | aprox. ₩680B |
| Bridge | 2023–24 | hasta ₩90B | Industrial Bank of Korea | — |
| Series C bridge | 2025.7 | ₩170B (aprox. $125M) | KDB (₩30B), Keistone (₩20B), PI Partners, Kakao Investment y otros, unos 40 inversores en total | ₩1T+ (unicornio) |
En julio de 2025, con la Series C bridge (₩170B, aprox. $125M — no son "$170M", sino 170,000 millones de wones) superó el billón de wones de valoración y se convirtió en unicornio. Actualmente está captando una ronda pre-IPO/Series D de $300M~$500M (asesoría conjunta de Morgan Stanley y Mirae Asset Securities, valoración prevista de ₩2T~₩3T, según Bloomberg, enero de 2026). En mayo de 2026 se informó de una inversión directa de ₩800B del National Growth Fund, pero a octubre de 2026 no se ha confirmado si se cerró.
Los $800M rechazados
En febrero de 2025 aparecieron las primeras informaciones sobre las negociaciones de adquisición por parte de Meta, y el 24 de marzo de 2025 FuriosaAI rechazó definitivamente la oferta de $800M (aprox. 1.1 billones de KRW) (según Bloomberg). El motivo de la ruptura no fue el precio, sino las diferencias sobre la dirección del negocio y la estructura organizativa tras la adquisición. La interpretación del sector es que Meta no buscaba tanto entrar en el mercado de semiconductores de IA como asegurarse un sistema y un talento ya verificados para desarrollar chips personalizados para sus propios servicios de IA. Cuatro meses después del rechazo, la empresa se convirtió en unicornio, y seis meses después inició la producción en masa.
Traction
La lista de clientes de FuriosaAI en 2025~2026 es inusualmente sólida para una startup de chips de inferencia.
- LG AI Research (julio de 2025) — contrato oficial de suministro de RNGD para el LLM EXAONE. Fue seleccionada tras meses de evaluación y se aplicará al modelo EXAONE 3.5 y al agente de IA empresarial ChatExaone. Según cifras reportadas por la empresa, ofrece 2.25 veces más inference performance per watt que las soluciones basadas en GPU y 3.75 veces más generación de tokens en un rack con el mismo consumo de energía.
- Samsung SDS (octubre de 2026) — NPU-as-a-Service (el primero en Corea) que ofrece RNGD en Samsung Cloud Platform. Despliega RNGD en el IDC de Dongtan y lo ofrece en instancias on-demand de 1/2/4/8 tarjetas (suministro desde julio de 2026).
- Equinix Lisbon (julio de 2026) — primer despliegue comercial de RNGD en Europa. Construyó un hub de inferencia de IA basado en RNGD en el centro de datos LS2 de Lisboa.
- Proyecto de 15MW en Estocolmo (agosto de 2026) — junto con Velox e I/ONX HPC, construirá un centro de datos de inferencia de IA de 15MW. La primera fase, de 2MW (en funcionamiento a principios de 2027), incorporará 1,800 unidades de RNGD, y en la ampliación completa se desplegarán más de 8,800.
- Consorcio 'AI for Everyone' de Kakao (agosto de 2026) — participa en el consorcio liderado por Kakao dentro del proyecto seleccionado por el Ministerio de Ciencia y TIC.
- Aramco — en fase de pruebas y muestreo de RNGD (prensa de diciembre de 2024). Es una cabeza de puente para entrar en Oriente Medio.
Las cifras públicas de benchmark (reportadas por la empresa, sin verificación independiente) son las siguientes: hasta 3 veces más inference performance per watt que Nvidia H100, 7.4 veces más usuarios simultáneos con el mismo consumo de energía que RTX Pro 6000 (Renegade Summit 2026.3), una reducción del TCO del centro de datos de aproximadamente el 40% y 2,000~3,000 TPS por tarjeta con Llama 3.1 8B.
Moat Analysis — VLSI's View
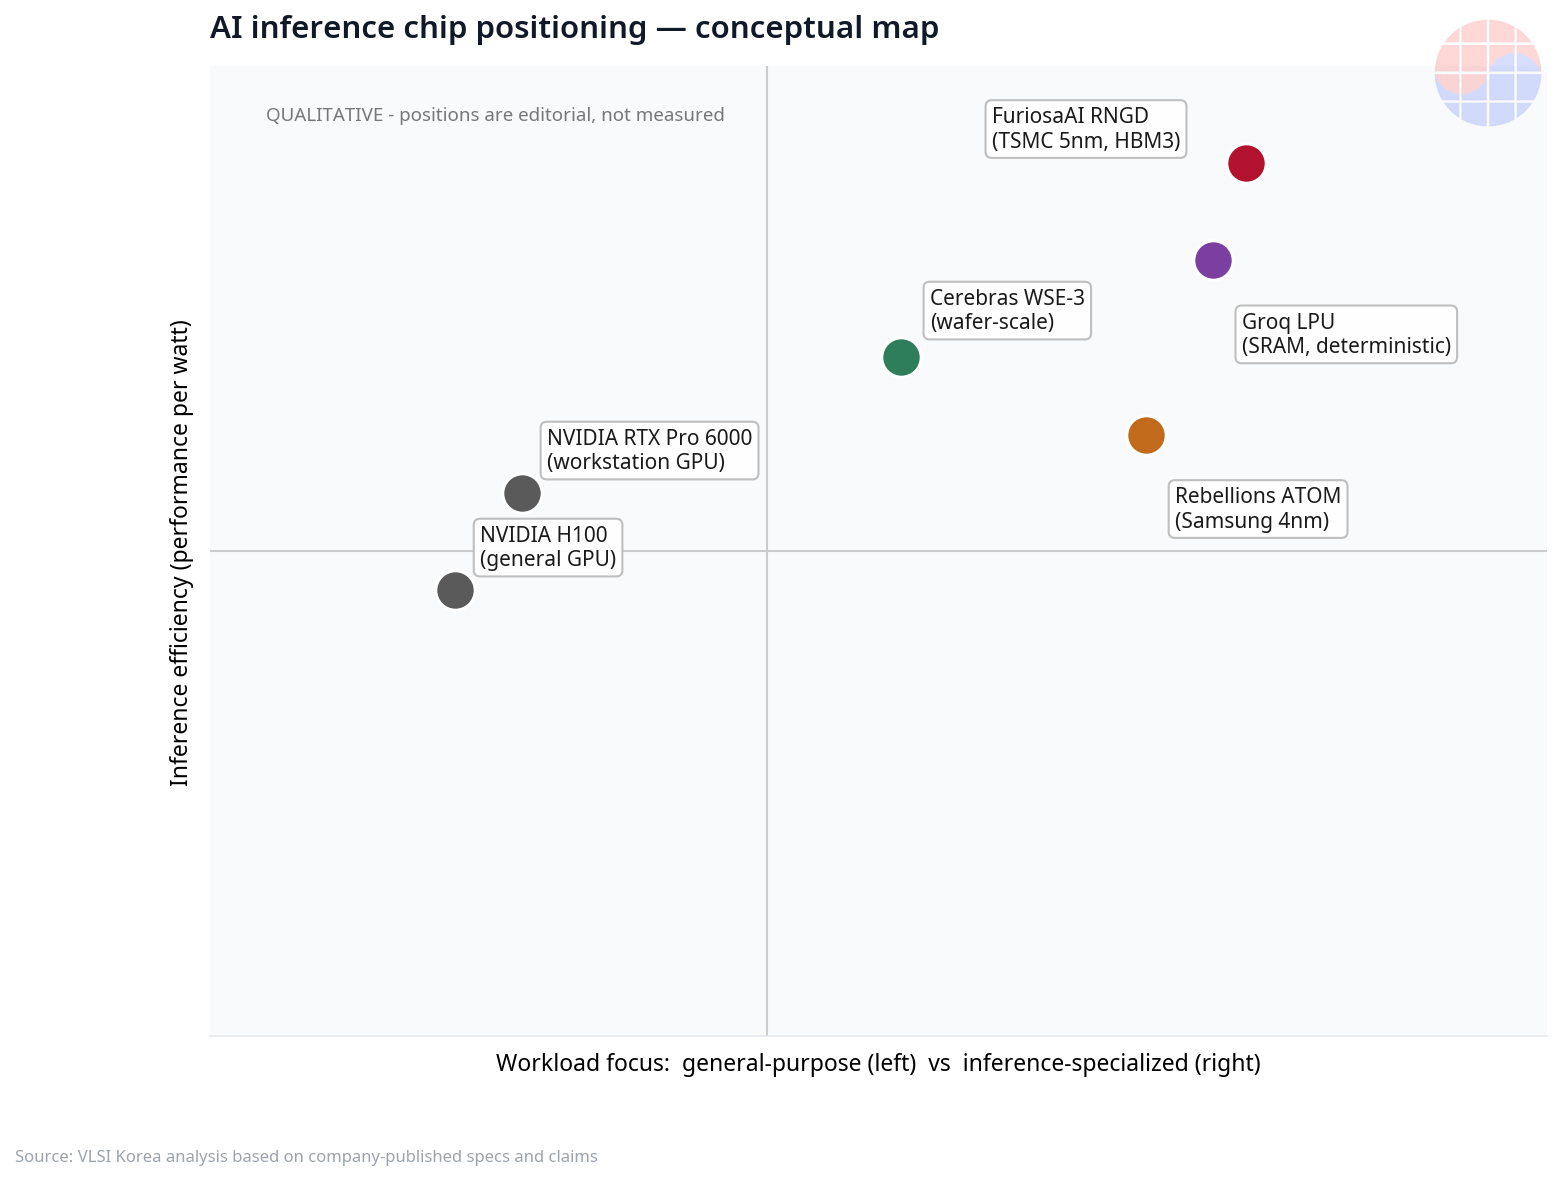
Foso 1 — la base académica de la arquitectura. TCP no es un eslogan de marketing, sino una arquitectura verificada con un artículo en ISCA 2024. El punto de partida del diseño es la convicción de que el campo de batalla del mercado de inferencia no es el entrenamiento, sino la fase memory-bound de la decodificación. A diferencia de Groq, que adoptó una ruta determinista (deterministic) centrada en SRAM, FuriosaAI eligió la ruta práctica de montar un modelo de clase 70B en una sola tarjeta con HBM3 de 48GB. Ambas rutas son válidas, pero la ruta HBM apunta en la misma dirección que la hoja de ruta de ampliación de memoria de los centros de datos existentes.
Foso 2 — un software demostrado por el compilador. En MLPerf 2022 extrajo el doble de rendimiento del mismo silicio Warboy solo con mejoras del compilador. La inferencia es una carrera software-defined, y esta empresa demostró con números que su equipo de software trabaja tanto como el de hardware. Añadiendo una perspectiva de STA y timing: cerrar el timing a 1.0GHz en TSMC 5nm con un interposer CoWoS-S y una PHY HBM3 (1.5TB/s) no es un tape-out sencillo. El one-shot silicon success de Warboy y el desarrollo conjunto de RNGD con GUC son pruebas de su capacidad de ejecución.
Foso 3 — la economía de los tokens por vatio. El TDP de RNGD es de 180W, frente a los 350W de H100. El CEO June Paik afirmó en el Renegade Summit (marzo de 2026) que "hasta 2030 los centros de datos de IA de todo el mundo añadirán 100GW, y el 70% de ellos será para inference". La inferencia es el juego de los tokens por vatio, y en una época en la que la infraestructura eléctrica es el cuello de botella, una tarjeta de 180W cambia el grado de libertad del diseño de racks.
Riesgo — los ingresos deben alcanzar a la valoración. Los ingresos de 2024 fueron de ₩3B y la pérdida neta de ₩152.2B (declaración pública, citada por Bloomberg). Una valoración de ₩1T+ es una apuesta por los ingresos futuros. El foso de CUDA y de la cadena de suministro de Nvidia sigue en pie, y los clientes se concentran en unos pocos, como LG y Samsung SDS. Tampoco se ha confirmado el cierre de la ronda pre-IPO de $300M~$500M. En Corea se está formando un duopolio con Rebellions: Rebellions usa Samsung 4nm, ha recibido inversión de Samsung y SK y aspira a cotizar en KOSPI en la primera mitad de 2027. No obstante, es muy probable que el mercado de inferencia sea un mercado segmentado por cargas de trabajo, más que de ganador único.
Chase's Take. El motivo por el que sigo a esta empresa no es la audacia de haber rechazado $800M. Es la capacidad de ejecución de haberse convertido en unicornio apenas 4 meses después del rechazo y de haber recibido volumen de producción en masa de TSMC 6 meses después. FuriosaAI superó con silicio el punto en el que muchas startups de chips de IA se detienen en las presentaciones. Los indicadores que habrá que vigilar son tres: si el volumen de 8,800 unidades de Estocolmo se convierte en ingresos recurrentes reales, si se cierra la ronda pre-IPO y si los ingresos trimestrales entran en órbita antes de la IPO de 2027~2028. Si los tres se cumplen, el rechazo de los $800M se convertirá en leyenda; si falla uno solo, será una lección muy cara.
Verdict
Un caso raro que demostró con silicio la base técnica para rechazar los $800M de Meta: ahora lo que necesita son ingresos.
FAQ
¿Qué tipo de empresa es FuriosaAI?
Es una empresa fabless de NPU dedicadas exclusivamente a la inferencia de IA, fundada en Seúl en 2017. La lidera su fundador y CEO June Paik (procedente de AMD y Samsung Electronics), y su arquitectura central es el Tensor Contraction Processor (TCP). En julio de 2025 alcanzó el estatus de unicornio (valoración superior a 1 billón de KRW) con una financiación acumulada de $246M.
¿Cuáles son las especificaciones clave del chip RNGD?
Es un chip de inferencia de segunda generación basado en TSMC 5nm a 1.0GHz, con FP8 512 TFLOPS, INT8 512 TOPS e INT4 1024 TOPS, HBM3 48GB (1.5TB/s), TDP 180W y compatibilidad con PCIe Gen5. Se presentó en Hot Chips en agosto de 2024 y su producción en masa comenzó en enero de 2026.
¿Por qué rechazó la oferta de adquisición de $800M de Meta?
La rechazó definitivamente el 24 de marzo de 2025 (según Bloomberg). El motivo de la ruptura no fue el precio, sino las diferencias sobre la dirección del negocio y la estructura organizativa tras la adquisición. Después, la empresa siguió una ruta de crecimiento independiente y logró convertirse en unicornio e iniciar la producción en masa.
¿Cuál es su situación de financiación y sus planes de IPO?
A julio de 2025 había captado un acumulado de $246M y actualmente está captando una ronda pre-IPO/Series D de $300M~$500M (valoración prevista de ₩2T~₩3T). El objetivo de IPO es 2027~2028.
Límites de la evidencia: las cifras de performance per watt, TCO y usuarios simultáneos comparados de este artículo se basan en anuncios de la empresa o de su cliente (LG AI Research) y no han sido verificadas de forma independiente. A 18 de octubre de 2026 no se ha confirmado el cierre de la ronda pre-IPO de 2026 ni de la inversión del National Growth Fund.
Fuentes principales: Blog oficial de FuriosaAI (anuncio de la Series C bridge) · Documentación para desarrolladores de FuriosaAI (especificaciones de RNGD) · Pulse (noticia del unicornio) · Korea Herald (Renegade Summit) · Data Center Dynamics (Samsung SDS NPUaaS) · TheElec (volumen de producción en masa)


