 VLSI Korea
Tensordyne a fondo: el chip de inferencia LNS que convierte la multiplicación en suma y qué es en realidad el precio de $1.000 millones
El chip Napier de Tensordyne apuesta por la matemática LNS para rehacer el coste de la inferencia. Sus $176M captados se confirman, pero la valoración de ~$1.000M descansa en una estimación secundaria y en la propia cifra de la empresa.


Resumen en 30 segundos
Tensordyne es una startup de chips de IA con sede en Estados Unidos y Alemania que apuesta por un sistema numérico logarítmico (LNS, Logarithmic Number System) —convertir la multiplicación en suma— para reducir el coste de la inferencia de IA. Fundada en 2017 como Recogni para fabricar chips de visión para automoción, cambió su nombre a Tensordyne en septiembre de 2025 y giró hacia la inferencia en centros de datos. Su primer chip para centros de datos, Napier (TDN), anunciado el 15 de junio de 2026, completó el tape-out en el proceso de 3 nm de TSMC y está en fabricación de obleas. Según sus propias simulaciones, la empresa afirma 13 veces más rendimiento (tokens per second) y 17 veces más eficiencia energética (tokens per watt) que un rack Nvidia GB300 NVL72. La financiación acumulada, de unos 176 millones de dólares (unos 246.400 millones de wones a 1.400 wones por dólar), está confirmada por varias fuentes. La valoración de unos 1.000 millones de dólares es otra cosa: no es un valor post-money revelado en ninguna ronda primaria. Se apoya en una estimación de una plataforma de mercado secundario (unos 992 millones de dólares) combinada con la propia estimación de la empresa, y no ha sido verificada de forma independiente. La pregunta central de este artículo es una: ¿cómo hay que leer el precio de una empresa con tan poca información verificada?
Background — De la visión para automoción a la inferencia en centros de datos
Tensordyne nació en septiembre de 2017 como Recogni. Sus cofundadores son R.K. Anand (Chief Product Officer) y Gilles Backhus (Head of AI), con Emily Stuart también registrada como cofundadora. Anand desarrolló su carrera en Sun Microsystems y Juniper Networks; Backhus, graduado de la Universidad Técnica de Múnich, investigó comunicaciones inalámbricas full-duplex en Stanford. El denominador común de ambos es el procesamiento de señales y las comunicaciones, un hilo que reaparece en el diseño de su red en chip basada en celdas (NoC) y su tejido de baja latencia.
La Recogni original apuntaba a chips de inferencia de visión para vehículos autónomos. En diciembre de 2020 presentó Scorpio, un producto de inferencia de visión de clase 1 PFLOP con menos de 25 W y menos de 10 ms de latencia. Pero el silicio para automoción tiene ciclos largos de diseño a ingresos y volúmenes incomparables con los centros de datos. Coincidiendo con la llegada del CEO Marc Bolitho, exdirectivo de ZF Group incorporado en julio de 2022, la empresa empezó a desplazar su centro de gravedad hacia la inferencia de IA generativa.
El historial de financiación está comparativamente bien documentado. Tras una Serie A de 25 millones de dólares en 2019 y una Serie B de 48,9 millones en 2021, el 20 de febrero de 2024 cerró una Serie C de 102 millones coliderada por Celesta Capital y GreatPoint Ventures, con los inversores existentes Mayfield, DNS Capital y BMW i Ventures, los nuevos Pledge Ventures y Tasaru Mobility Investments —filial del fondo soberano saudí PIF— y deuda de HSBC Innovation Banking. La empresa no reveló valoración en la Serie C. En las bases de datos figuran rondas de extensión posteriores sin importes revelados. En septiembre de 2025 se renombró Tensordyne, en junio de 2026 presentó Napier y afirma estar preparando una Serie D. Su sede está en Sunnyvale, California (antes figuraba San Jose), con oficina en Múnich, y la plantilla se estima en unas 120–150 personas.
Una advertencia enmarca todo lo que sigue. Casi todo lo público sobre esta empresa procede de anuncios de la propia compañía, un whitepaper propio y entrevistas con sus directivos. A octubre de 2026 no existe en el registro público ningún benchmark independiente, ningún caso de cliente en producción con nombre ni ninguna cifra de ingresos auditada. Todos los números de rendimiento de este artículo deben leerse bajo esa premisa.
Business Deep Dive — La sustancia de la apuesta LNS
La idea central: la multiplicación se convierte en suma
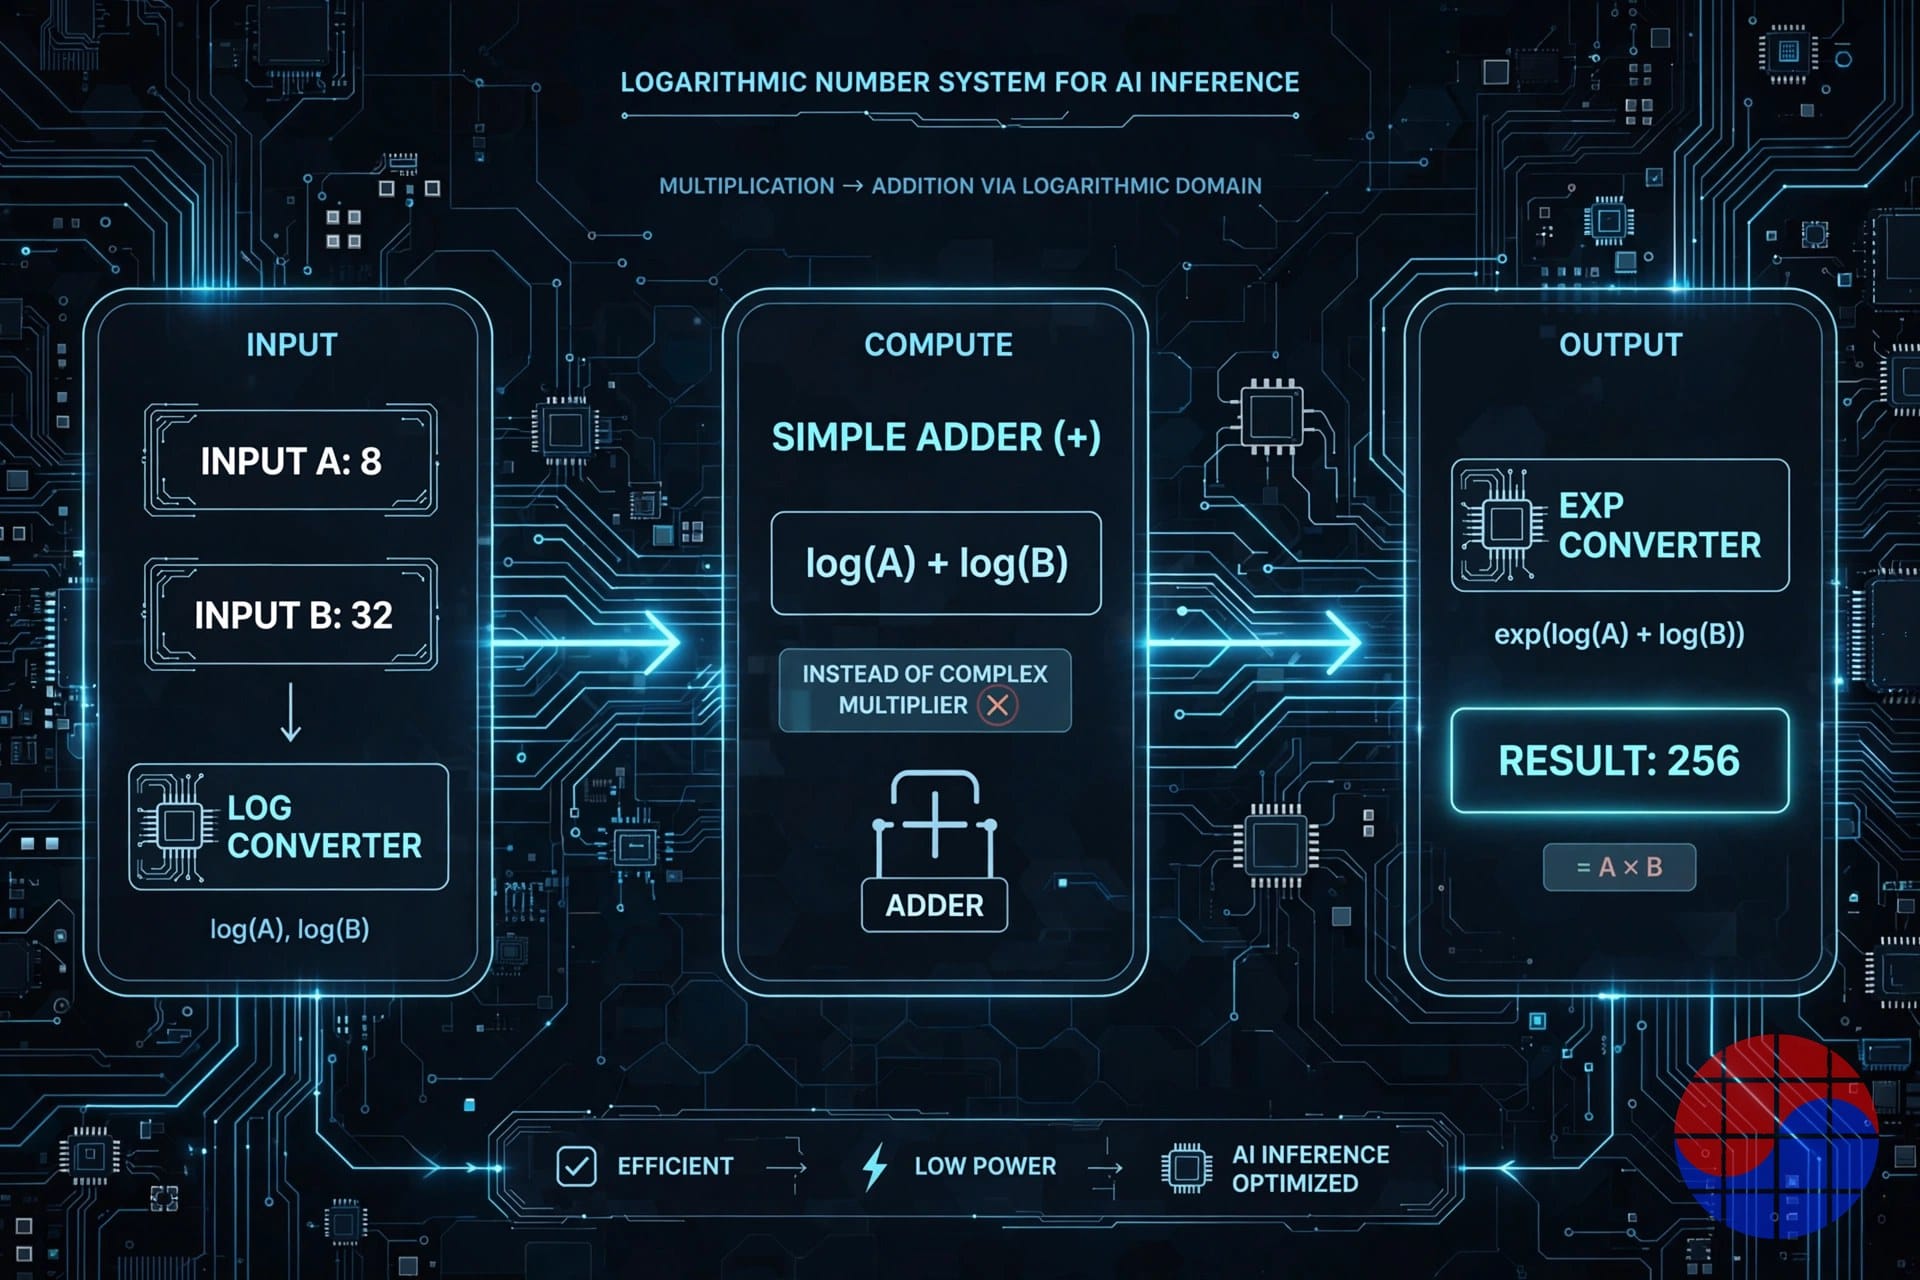
La inferencia de redes neuronales está dominada por la multiplicación de matrices, es decir, operaciones multiply-accumulate sin fin. Un multiplicador de coma flotante cuesta mucha más área de silicio y energía que un sumador. LNS lo rodea: como log(A×B) = log(A) + log(B), basta convertir los números una vez al dominio logarítmico para que la multiplicación se vuelva suma. Es el mismo principio de las tablas de logaritmos que John Napier publicó en 1614 para facilitar los cálculos astronómicos, y el nombre del chip lo homenajea. Tensordyne llama a esta ganancia la «zeroth scaling law», un beneficio que queda por debajo de cualquier otra decisión de diseño.
Las cifras a nivel de circuito que presenta la empresa son llamativas: donde una multiplicación convencional en coma flotante de 16 bits cuesta unos 1,1 pJ y 1.640 µm², su versión logarítmica haría el mismo trabajo con unos 0,05 pJ y 67 µm², unas 22 veces menos energía y 25 veces menos área. A nivel de sistema, sin embargo, las ganancias afirmadas se reducen a unas 3 veces en área de cómputo y 5 veces en potencia de cómputo, según el propio resumen de su whitepaper. Esa distancia entre la matemática de circuito y la de sistema es la primera pista para leer esta apuesta: el multiplicador no es el único cuello de botella.
Por qué LNS no se impuso en cuatro décadas
LNS no es nuevo. Se ha estudiado durante décadas sin llegar a producirse en hardware dedicado, por tres razones. Primero, la suma en el dominio logarítmico es difícil: acumular los resultados de las multiplicaciones exige una función de aproximación costosa (el logaritmo gaussiano). Segundo, la conversión entre los dominios lineal y logarítmico cuesta tiempo y precisión, sobre todo cerca de cero y al acumular muchos valores pequeños. Tercero, gran parte de la inferencia está limitada por la memoria (memory-bound) y no por el cómputo: abaratar la multiplicación no resuelve el coste de traer datos desde la HBM.
La afirmación de propiedad intelectual de Tensordyne se sitúa exactamente en el primer punto. Su sistema numérico propietario, Pareto (TDN Math), se basaría en una aproximación eficiente de la suma en dominio logarítmico y su implementación en hardware. La empresa dice que los modelos se ejecutan sin reentrenamiento ni calibración, y que ha validado la precisión mediante emulación bit-accurate en modelos de lenguaje, mixture-of-experts, imagen, audio y vídeo, con una pila de software que oculta la conversión y soporta PyTorch y Triton. Si fuera cierto, se habría cruzado la mayor barrera histórica. Pero la evidencia hasta ahora es emulación interna, no silicio medido.
El chip Napier y el sistema TDN72
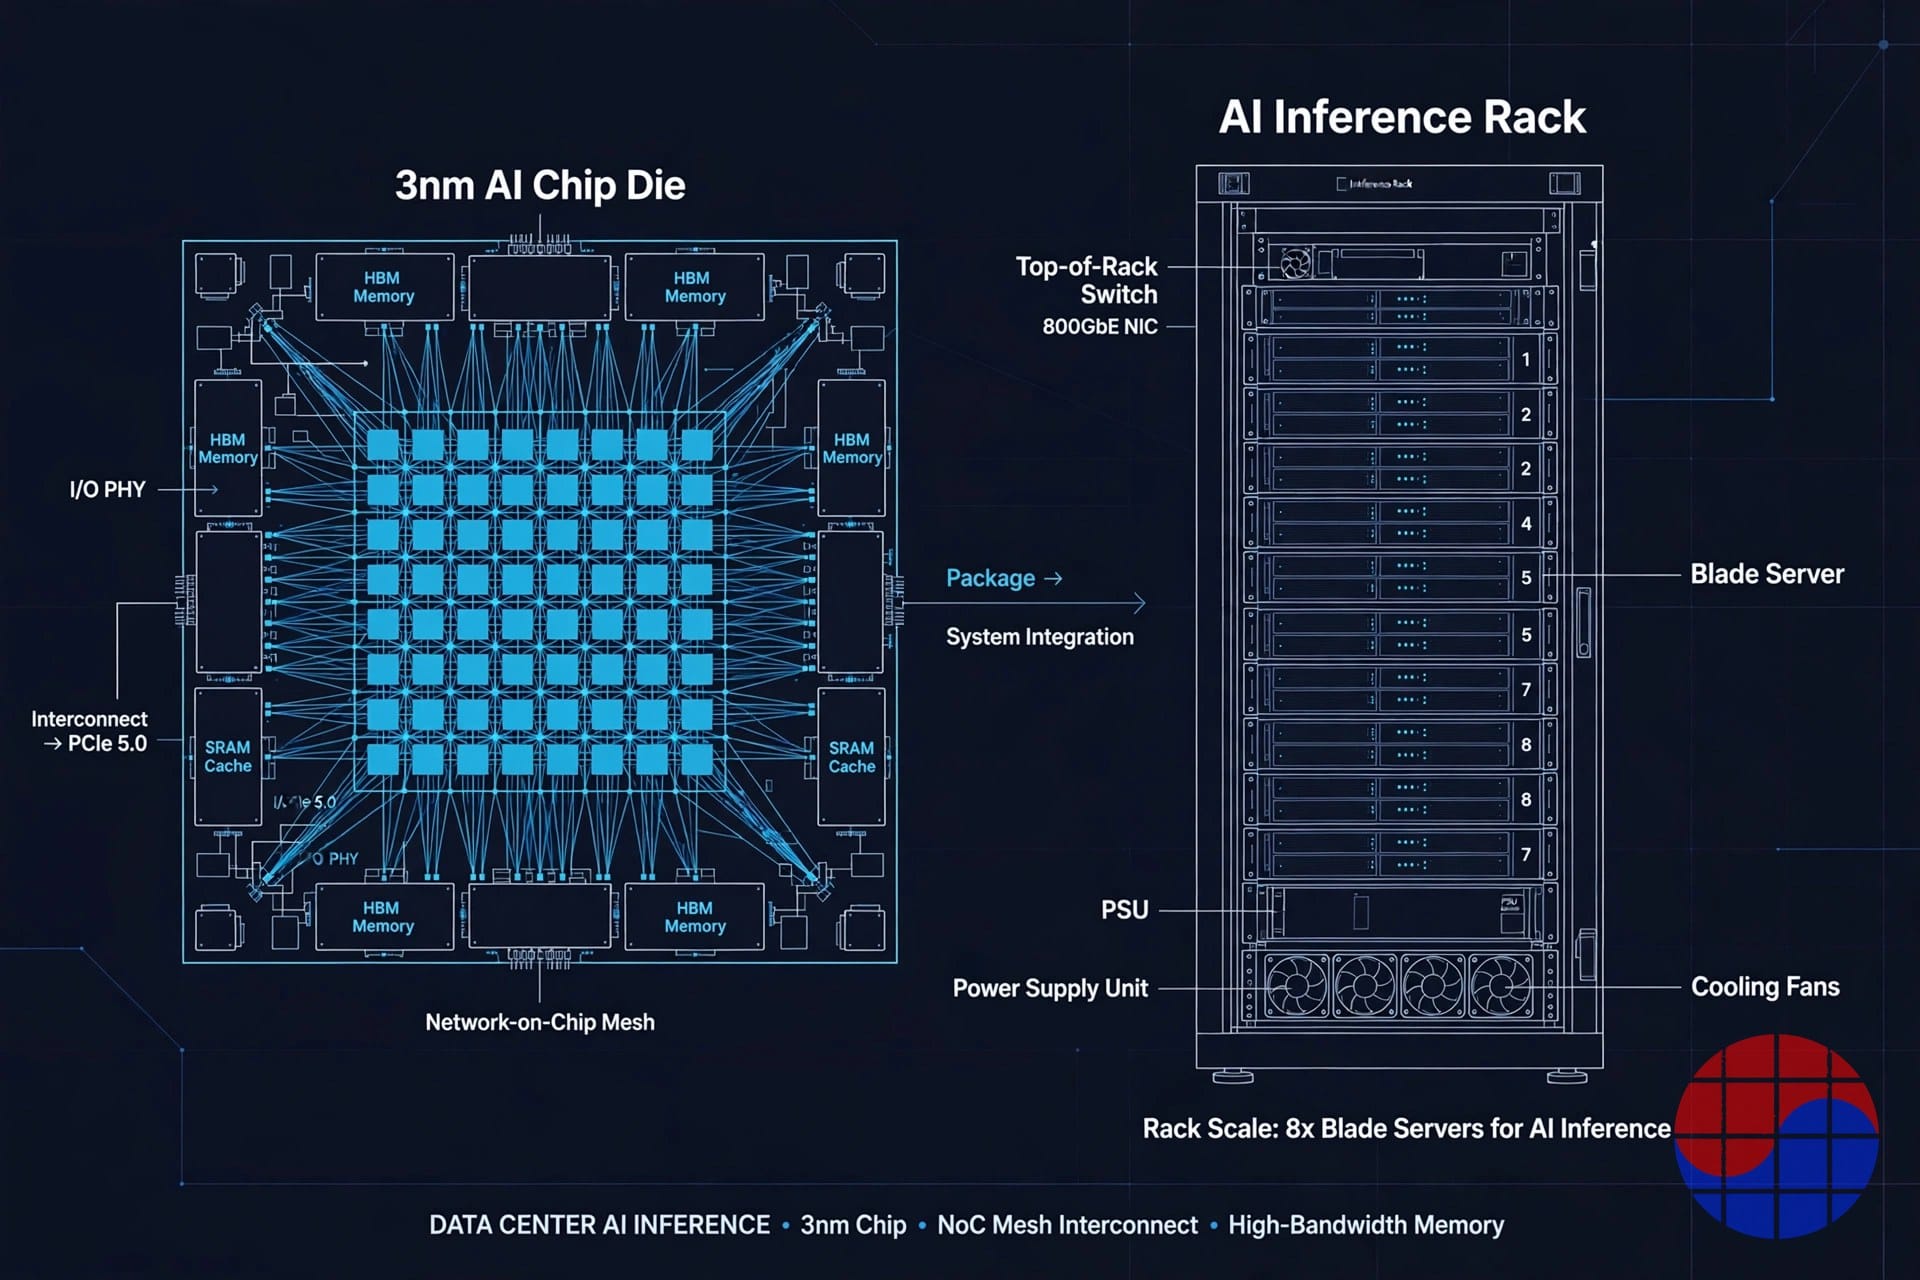
Las especificaciones de hardware verificables son las siguientes. El procesador Napier (TDN AIP) se fabrica en 3 nm de TSMC, con 138.000 millones de transistores, 300 W por paquete, 2,11 PFLOPS de cómputo denso FP8, 256 MB de SRAM y 144 GB de HBM3e. Tiene 48 núcleos de cómputo, con núcleos RISC-V que se ocupan de tareas dentro del bucle, como el enrutamiento MoE. El tejido de escalado TDN LINK afirma una latencia de un solo salto inferior a 1 µs y agrupa 72 chips en un pod.
| Elemento | Napier (cifras de la empresa) |
|---|---|
| Proceso | TSMC 3 nm, tape-out completado, en fabricación |
| Cómputo | 2,11 PFLOPS FP8 denso, 300 W |
| Memoria | 144 GB HBM3e, 256 MB SRAM |
| Pod TDN72 (72 chips) | 30 kW, refrigeración por aire, 10,4 TB HBM |
| Rack completo (4 pods, 288 chips) | 608 PFLOPS FP8, 42 TB HBM, 120 kW, refrigeración por aire |
La lista de socios es una de las pocas señales duras de la empresa. Broadcom codiseñó el silicio, TSMC lo fabrica y HPE Juniper aporta el chasis de escalado y el tejido; Juniper es además inversor. Un tape-out en 3 nm cuesta decenas de millones de dólares y exige superar la diligencia de un socio ASIC como Broadcom: una evidencia indirecta pero real de la capacidad y la financiación para construir silicio de verdad.
Las afirmaciones de rendimiento, y lo que son
La afirmación principal, en una carga DeepSeek-R1, es de 363.000 tokens por segundo por rack frente a 27.400 de un rack Nvidia GB300 NVL72: 13 veces más. Por megavatio, la empresa cita 3 millones de tokens por segundo frente a 183.000: 17 veces más. En un modelo MoE de 2 billones de parámetros, dice que uno de sus racks hace el trabajo de una combinación competidora de nueve racks, entregando 1.300 tokens por segundo por usuario a unos 11 dólares por millón de tokens frente a unos 150. Todas estas cifras proceden de modelos y simulaciones de la empresa. Parte de las referencias se tomaron de datos públicos de benchmark, pero no existe ningún resultado medido del silicio de Tensordyne. Los chips apenas salen de la fábrica: se promete una nube de desarrollo para finales de 2026, sistemas beta para el primer trimestre de 2027 y envíos de producción para la segunda mitad de 2027 (algunas fuentes dicen el segundo trimestre).
Señales de clientes: una LOI no es ingreso
La señal comercial se resume en «más de 200 millones de dólares de demanda prevista». La empresa afirma que más de una docena de firmas han firmado cartas de intención (LOI) para evaluar sistemas beta, y se ha nombrado a dos proveedores de infraestructura como interesados. Sin embargo, una LOI no es una orden de compra vinculante, y no se ha revelado ningún cliente de producción de pago ni cifra de ingresos. Históricamente, la conversión de LOI a ingresos en startups de chips de IA es baja. Esta señal debe leerse como interés, no como demanda confirmada.
Chase's Take — ¿Por qué el mercado le pone este precio?
¿De dónde sale entonces «unos 1.000 millones de dólares»? La verificación cruzada muestra que no es un precio fijado por una nueva ronda de inversión. La empresa no reveló valoración ni siquiera en su gran Serie C de febrero de 2024. La cifra pública más cercana es la valoración implícita de una plataforma de negociación secundaria, de unos 992 millones de dólares a octubre de 2026. Una estimación de mercado secundario es un precio de referencia derivado de unas pocas operaciones y cotizaciones, no un precio que un inversor institucional haya firmado tras una diligencia. Si se suma la propia estimación de la empresa, difundida antes de una Serie D, se obtiene «about $1B». Distinguir estos dos tipos de números tan diferentes es el punto de partida para leer esta compañía.
En wones, son unos 1,4 billones de wones (a 1.400 wones por dólar), unas 5,7 veces los aproximadamente 246.400 millones de wones que ha captado. Para que una empresa en fase pre-revenue o cercana a ella sostenga ese precio, el mercado está apostando de hecho por tres cosas a la vez: que la barrera de precisión de LNS se ha cruzado de verdad; que incluso la mitad de la ventaja simulada, si se mide, cambia la estructura de costes de la inferencia; y que para la fecha de envío de 2027 el mercado de inferencia será mucho mayor, con la energía como criterio central de compra. Si falla cualquiera de las tres, el precio se reajustará rápido.
Para ser justos, la apuesta no carece de base. La energía y la refrigeración representan de verdad una parte creciente del coste de inferencia, y un rack de 120 kW refrigerado por aire es un atractivo real para centros de datos actuales que afrontan costosas adaptaciones a refrigeración líquida. La combinación Broadcom–TSMC–HPE Juniper no es lo que monta una empresa de papel. La parte débil es igualmente clara: rendimiento sin medir, una etapa comercial sin ingresos y un incumbente que no se queda quieto. Cuando Napier se envíe a finales de 2027, el rack competidor también habrá avanzado una generación. La brecha de 13 veces es menos «el rack de mañana contra el de hoy» que «nuestro rack futuro contra su rack actual».
Mi lectura: Tensordyne apuesta a que cambiar el sistema numérico cambia la pendiente del propio coste de inferencia, una apuesta que, de verificarse, reconfigura la estructura de la industria. Pero a octubre de 2026, la evidencia de esa apuesta es simulación, no silicio. Por tanto, su precio debe leerse como precio de opción, no como precio de tecnología: un activo cercano a lo binario, cuyo valor subirá o bajará en escalón en cuanto lleguen datos medidos. No hay por qué tomar los 1.000 millones al pie de la letra, ni base para descartarlos como invención. Es un precio de referencia a mantener mientras se esperan dos cosas: cuánto firman de verdad las instituciones en la Serie D y qué miden los terceros cuando se abra la nube de desarrollo a finales de 2026.
Implications — Qué vigilar
Para inversores: tres puntos de control. (1) La valoración post-money real de la Serie D y quién la lidera. (2) Mediciones independientes de la nube de desarrollo de finales de 2026, sobre todo tokens per watt y si la precisión de los modelos se mantiene. (3) Si las LOI se convierten en betas de pago y contratos de producción. Hasta que eso ocurra, los 1.000 millones son una expectativa que el mercado ha puesto en precio, no un valor verificado.
Para la industria: sea cual sea el destino de Tensordyne, la pregunta que plantea sobrevive. Que un intento de sacudir una convención de coma flotante de 40 años a nivel de sistema numérico haya llegado a un tape-out en 3 nm con socios de primer nivel muestra que el eje de la competencia en inferencia se desplaza de «una GPU más grande» a «un token más barato». La disputa por los formatos numéricos y la cuantización continuará con o sin LNS.
Para los semiconductores coreanos: cada chip Napier lleva 144 GB de HBM3e; un rack completo, 42 TB. Si los ASIC solo de inferencia como este empiezan a enviarse en volumen, la demanda de HBM se ampliará desde una única base de clientes GPU hacia muchos proveedores de ASIC: una oportunidad de diversificación de clientes y, a la vez, una carga, porque cada ASIC trae su propia especificación de memoria y su proceso de cualificación.
Nota sobre los límites de las fuentes: la información de la empresa en este artículo se contrastó con anuncios públicos de la compañía, resúmenes de su whitepaper, entrevistas en prensa y bases de datos de transacciones disponibles a 19 de octubre de 2026. Todas las cifras de rendimiento son afirmaciones de la empresa y no han sido verificadas de forma independiente; la valoración no es una cifra revelada de una ronda primaria. Las cifras de ingresos, clientes y pedidos que no pudieron confirmarse se omitieron.
FAQ
¿Es la valoración de 1.000 millones de dólares de Tensordyne una cifra confirmada?
No. La empresa nunca ha revelado una valoración en ninguna ronda, incluida la Serie C de 2024. Los aproximadamente 1.000 millones se apoyan en la estimación de una plataforma de negociación secundaria (unos 992 millones de dólares, octubre de 2026) y en la propia estimación de la empresa. Es un tipo de número distinto de una valoración post-money fijada por inversores institucionales en una ronda primaria. La revelación de la Serie D es el evento que puede confirmarla o reajustarla.
¿Por qué LNS llega al silicio solo ahora?
El principio es antiguo, pero la suma en dominio logarítmico y la precisión de conversión eran las barreras. La multiplicación se convierte en suma barata, pero acumular los productos y manejar valores cercanos a cero siguió siendo caro e impreciso. Tensordyne afirma que la aproximación de su sistema numérico Pareto cruza esa barrera, pero la evidencia es emulación interna y los resultados medidos en silicio aún no se han publicado.
¿Son fiables las afirmaciones de rendimiento de 13 y 17 veces?
Por ahora deben tratarse estrictamente como resultados de simulación de la empresa. Ambas cifras proceden de modelos propios sobre una carga DeepSeek-R1 y, con los chips aún en fabricación, no existe medición independiente. Los datos de terceros de la nube de desarrollo prometida para finales de 2026 son el primer punto de control real.
¿Cuándo podrán comprarse los sistemas de Tensordyne?
Según el calendario de la empresa: nube de desarrollo a finales de 2026, sistemas beta en el primer trimestre de 2027 y envíos de producción en la segunda mitad de 2027. La evidencia comercial hasta ahora se limita a las declaraciones de la empresa de más de 12 LOI de evaluación y más de 200 millones de dólares de demanda prevista; no se ha revelado ningún contrato de producción vinculante ni ingreso alguno.
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.


