 VLSI Korea
Unconventional AI a fondo: cómo una startup sin chip alcanzó una valoración de 4.500 millones de dólares
Dos meses después de su fundación, sin chip ni ingresos, Unconventional AI recaudó 475 millones con una valoración reportada de 4.500 millones. Los inversores valoraron a un fundador, un equipo y una opción sobre la computación basada en la física, no un producto. Desmontamos el precio.


Resumen en 30 segundos
- Unconventional AI anunció el 8 de diciembre de 2025 que había cerrado una ronda semilla de 475 millones de dólares con una valoración reportada de 4.500 millones de dólares, unos dos meses después de la fundación de la compañía, sin chip, sin producto y sin ingresos. A 1.400 wones por dólar, 4.500 millones de dólares son unos 6,3 billones de wones, y la ronda de 475 millones, unos 665.000 millones de wones.
- La ronda fue coliderada por Andreessen Horowitz y Lightspeed Venture Partners, con participación de Lux Capital, DCVC, Databricks y Jeff Bezos. El CEO, Naveen Rao, invirtió 10 millones de dólares de su propio dinero en los mismos términos. Los 475 millones son la primera parte de una captación prevista de hasta 1.000 millones.
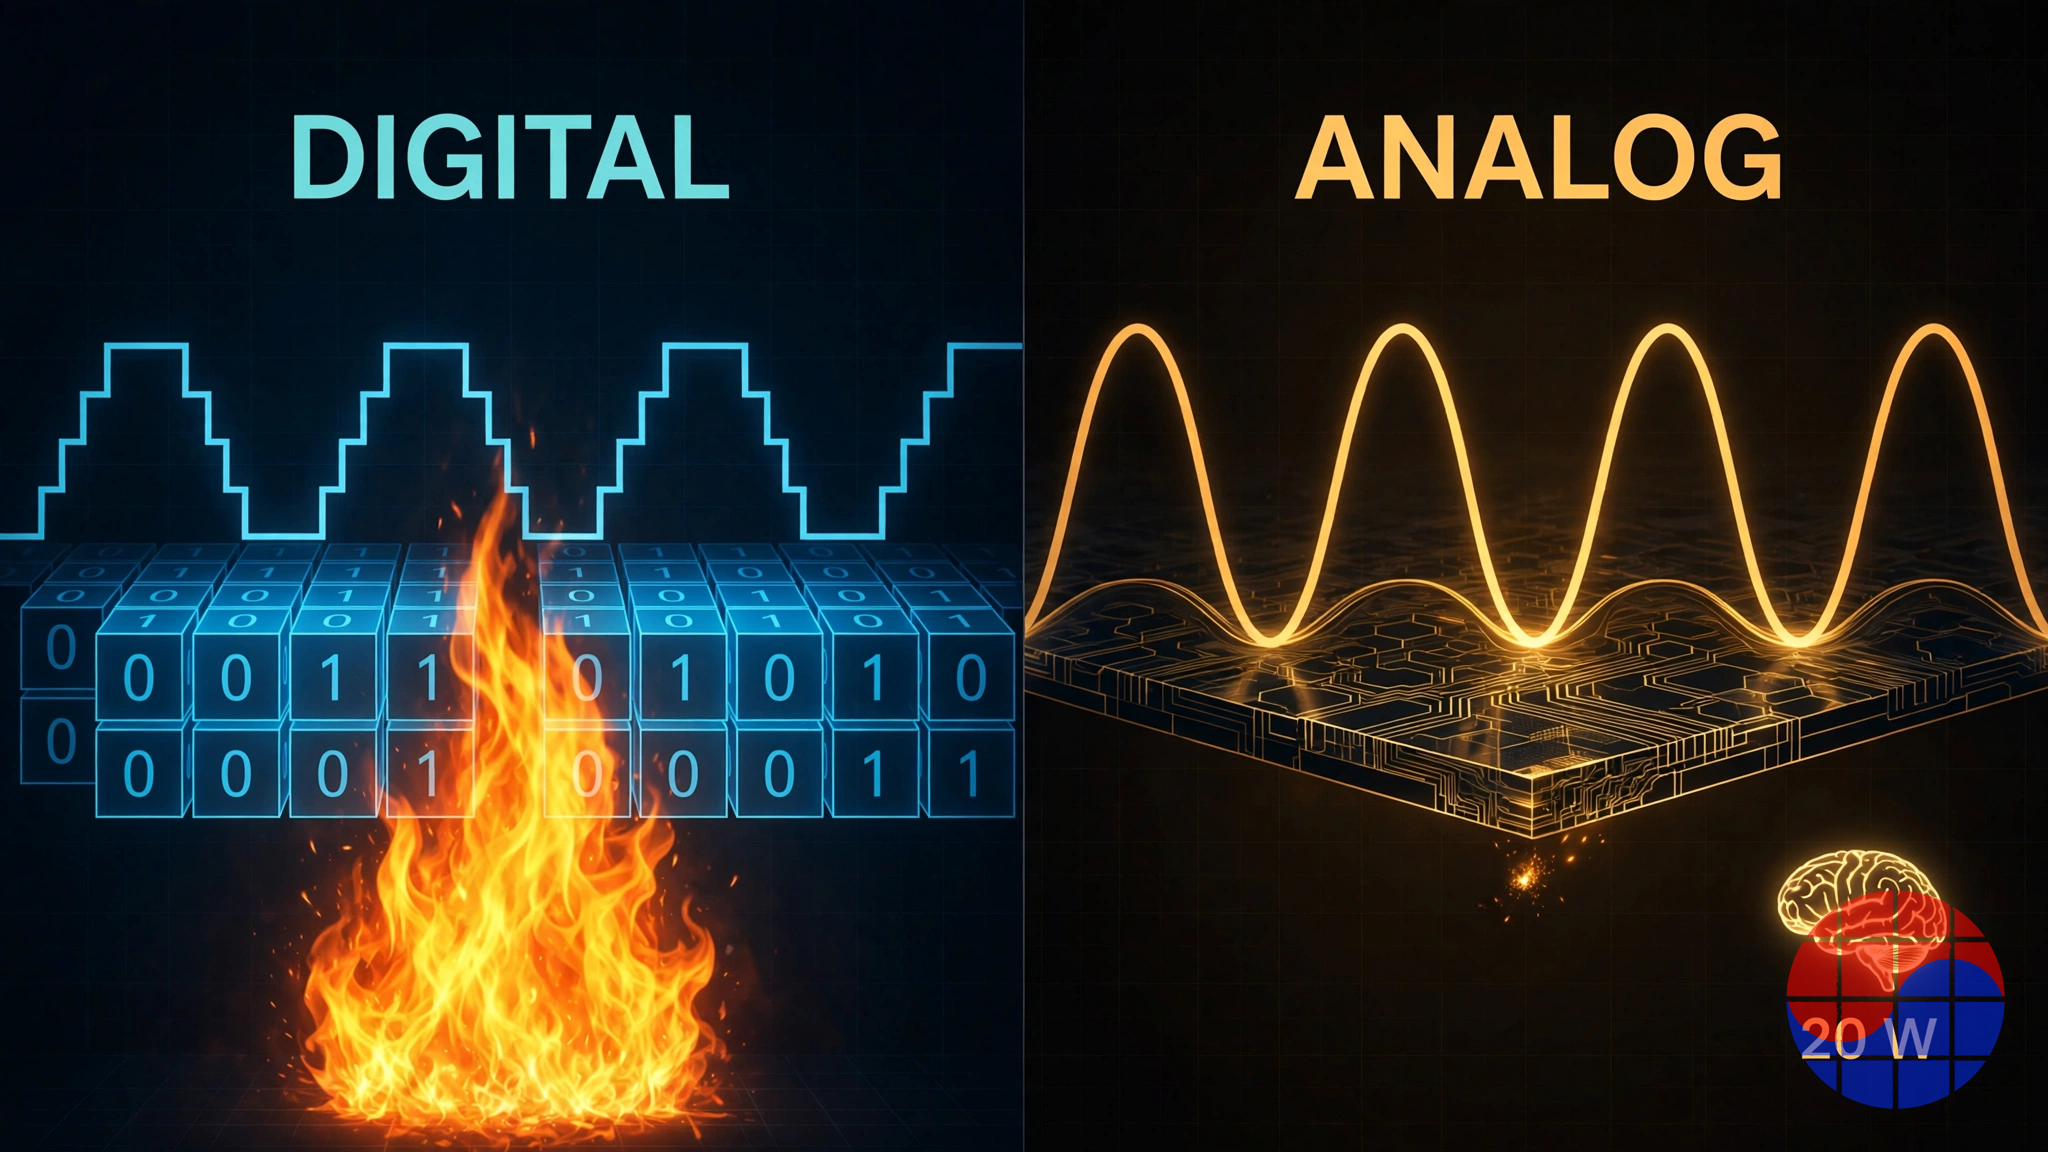
- La compañía construye una computadora analógica, basada en la física, para IA: en lugar de simular redes neuronales en chips digitales, quiere que la física del silicio —un tejido de osciladores acoplados (coupled oscillators)— haga el cálculo directamente, con un objetivo de unas 1.000 veces menos energía que el hardware actual. El punto de referencia es el cerebro humano, que funciona con unos 20 vatios.
- Lo que existe hoy es una simulación, no silicio. Su primer modelo, Un-0 (junio de 2026), genera imágenes con un sistema simulado de osciladores acoplados y alcanza un FID de 6,74 en ImageNet 64x64, comparable a los primeros generadores convencionales. Pero fue entrenado y ejecutado en GPU B200 convencionales. No se ha mostrado ningún chip físico.
- El precio de 4.500 millones no es, por tanto, el precio de un producto. Es el precio de un fundador con dos salidas (Nervana a Intel, MosaicML a Databricks por 1.300 millones), un equipo fundador de cuatro personas que abarca el MIT, Stanford y el diseño analógico en producción, y una opción sobre la posibilidad de que el muro energético de la computación digital fuerce un nuevo sustrato (substrate). Este deep dive desmonta ese precio.
Background: una ronda semilla sin nada que enviar
Las rondas semilla suelen comprar un prototipo. La de Unconventional AI compró un programa de investigación, y lo valoró como una empresa en fase tardía.
La compañía salió a la luz en septiembre de 2025, cuando Naveen Rao insinuó en X que estaba cofundando una empresa para construir una computadora con «eficiencia a escala cerebral». Dos meses después, el 8 de diciembre de 2025, Rao y sus tres cofundadores publicaron el artículo de lanzamiento: 475 millones recaudados con una valoración de 4.500 millones, y la tesis de que la industria de la IA está chocando con un muro energético que no puede superar solo con ingeniería sobre chips digitales.
Los cuatro fundadores son la primera línea de la valoración. Rao es el raro fundador que ha estado en ambos lados del problema. Se formó como ingeniero eléctrico en Duke, trabajó como arquitecto de computadoras en Sun Microsystems y luego dejó la ingeniería para doctorarse en neurociencia computacional en Brown, estudiando cómo el cerebro convierte la entrada sensorial en acción con un presupuesto de unos 20 vatios. Trabajó en computación neuromórfica en Qualcomm y cofundó Nervana Systems en 2014 para construir hardware de aprendizaje profundo diseñado en torno a la carga de trabajo, no adaptado desde los gráficos. Intel lo adquirió en 2016 por un precio reportado de unos 400 millones de dólares, y Rao pasó a dirigir el grupo de productos de IA de Intel. En 2021 cofundó MosaicML, que abarató el entrenamiento de modelos grandes; Databricks la adquirió en 2023 por 1.300 millones y Rao se convirtió en vicepresidente de IA de Databricks. Dos salidas, unos 1.700 millones de dólares en valor reportado combinado, ambas construidas sobre la misma obsesión: el costo de la IA es un problema de hardware.
A su lado: Michael Carbin, profesor asociado del MIT cuyo trabajo abarca los sistemas de programación y los fundamentos de la computación sobre nuevos sustratos —y, notablemente, cofundador de MosaicML—. Sara Achour, profesora asistente de Stanford que trabaja en compiladores y computación con base física. Y MeeLan Lee, diseñadora de circuitos analógicos procedente de Google, Qualcomm e Intel, la persona del equipo que realmente ha construido silicio analógico en entornos de producción. La composición es deliberada: un CEO con salidas repetidas, dos teóricos que trabajan en cómo el software se mapea a la dinámica física y una profesional que sabe dónde mueren los diseños analógicos.
El planteamiento del problema es simple y, hasta ahora, empíricamente cierto. La capacidad de la IA ha escalado con el cómputo, y el cómputo ha escalado con la energía. Los centros de datos se planifican hoy en torno a la disponibilidad de energía —capacidad de generación, conexiones a la red, refrigeración— y no en torno a los chips. En palabras de Rao: «La IA está intrínsecamente ligada al hardware, y el hardware está intrínsecamente ligado a la energía. No podemos escalar más allá de un cierto número de inferencias por unidad de tiempo por el problema energético. No podemos producir tanta energía adicional en los próximos 10 años». La compañía sostiene que el crecimiento de la demanda alcanzará el crecimiento lineal de la oferta de energía en tres o cuatro años. Sea o no exacto ese calendario, la dirección no es controvertida: la energía por inferencia es ahora un costo de primer orden y una restricción de primer orden.
Sobre ese fondo, la compañía propone abandonar la abstracción que ha dominado la computación durante 80 años. Las computadoras digitales lo representan todo como números y simulan la dinámica paso a paso, con un enorme costo energético. Los sistemas naturales de aprendizaje nunca hicieron eso. «Los sistemas naturales de aprendizaje nunca usaron números —dice Rao—. No simularon la dinámica del aprendizaje. Usan la física intrínseca del sustrato en el que están para construir un sistema de aprendizaje. Creemos que podemos recapitular ese comportamiento en silicio».
Business Deep Dive
1. La aritmética del acuerdo: qué dice 475 millones a 4.500 millones
Empieza por la aritmética, porque la aritmética es la historia. Una ronda primaria de 475 millones con una valoración post-money de 4.500 millones significa que los nuevos inversores compraron aproximadamente el 10,6% de la compañía, y que la valoración pre-money —el precio de la idea, del equipo y de nada más— fue de unos 4.030 millones de dólares. A modo de comparación, esa cifra pre-money es aproximadamente el triple de lo que Databricks pagó en 2023 por MosaicML, una compañía con producto, clientes e ingresos.
La estructura importa tanto como el tamaño. Los 475 millones son, según la propia compañía, la primera parte de una captación que podría llegar a 1.000 millones; informaciones anteriores situaban el objetivo de la compañía en una valoración de 5.000 millones para esa ronda mayor. Una captación por tramos de este tipo es una máquina de hitos: el primer cierre valora la visión, y el segundo cierre valorará lo que la visión haya producido para entonces. Los 10 millones del propio Rao, invertidos en los mismos términos que las instituciones, son pequeños frente a 475 millones (un 2%), pero simbólicamente estructurales: convierten «el fundador cree» de una frase de pitch en un hecho del balance.
¿Qué suscribieron realmente los inversores? No un flujo de caja descontado: no hay flujos de caja. Lo suscrito es una opción ponderada por probabilidad: una pequeña probabilidad de que este equipo funde el sustrato posterior a la GPU, multiplicada por el valor de poseer una parte significativa del cómputo de IA si lo consigue, más un valor suelo derivado de la demostrada capacidad del equipo para ser adquirido. La sección 6 hace explícita esa opción.
2. La ciencia: que la física haga el cálculo
La apuesta técnica tiene tres capas.
Capa uno: analógico en lugar de digital. Un circuito analógico representa las cantidades como voltajes y corrientes continuos, no como bits. Para las operaciones que la IA ejecuta en realidad —enormes cantidades de multiply-accumulate, dinámica y muestreo de distribuciones—, un sistema físico a menudo puede ser el cálculo en lugar de simularlo. El ejemplo del propio Rao es el túnel de viento: los ingenieros siguen construyendo túneles de viento porque un modelo físico del flujo de aire calcula cosas que la dinámica de fluidos digital aproxima a gran costo. La afirmación es que una red neuronal se parece más a un túnel de viento que a una hoja de cálculo: es un sistema dinámico estocástico y distribuido, y forzarlo sobre un sustrato numérico determinista y preciso desperdicia la mayor parte del presupuesto energético en una abstracción que la carga de trabajo nunca pidió.
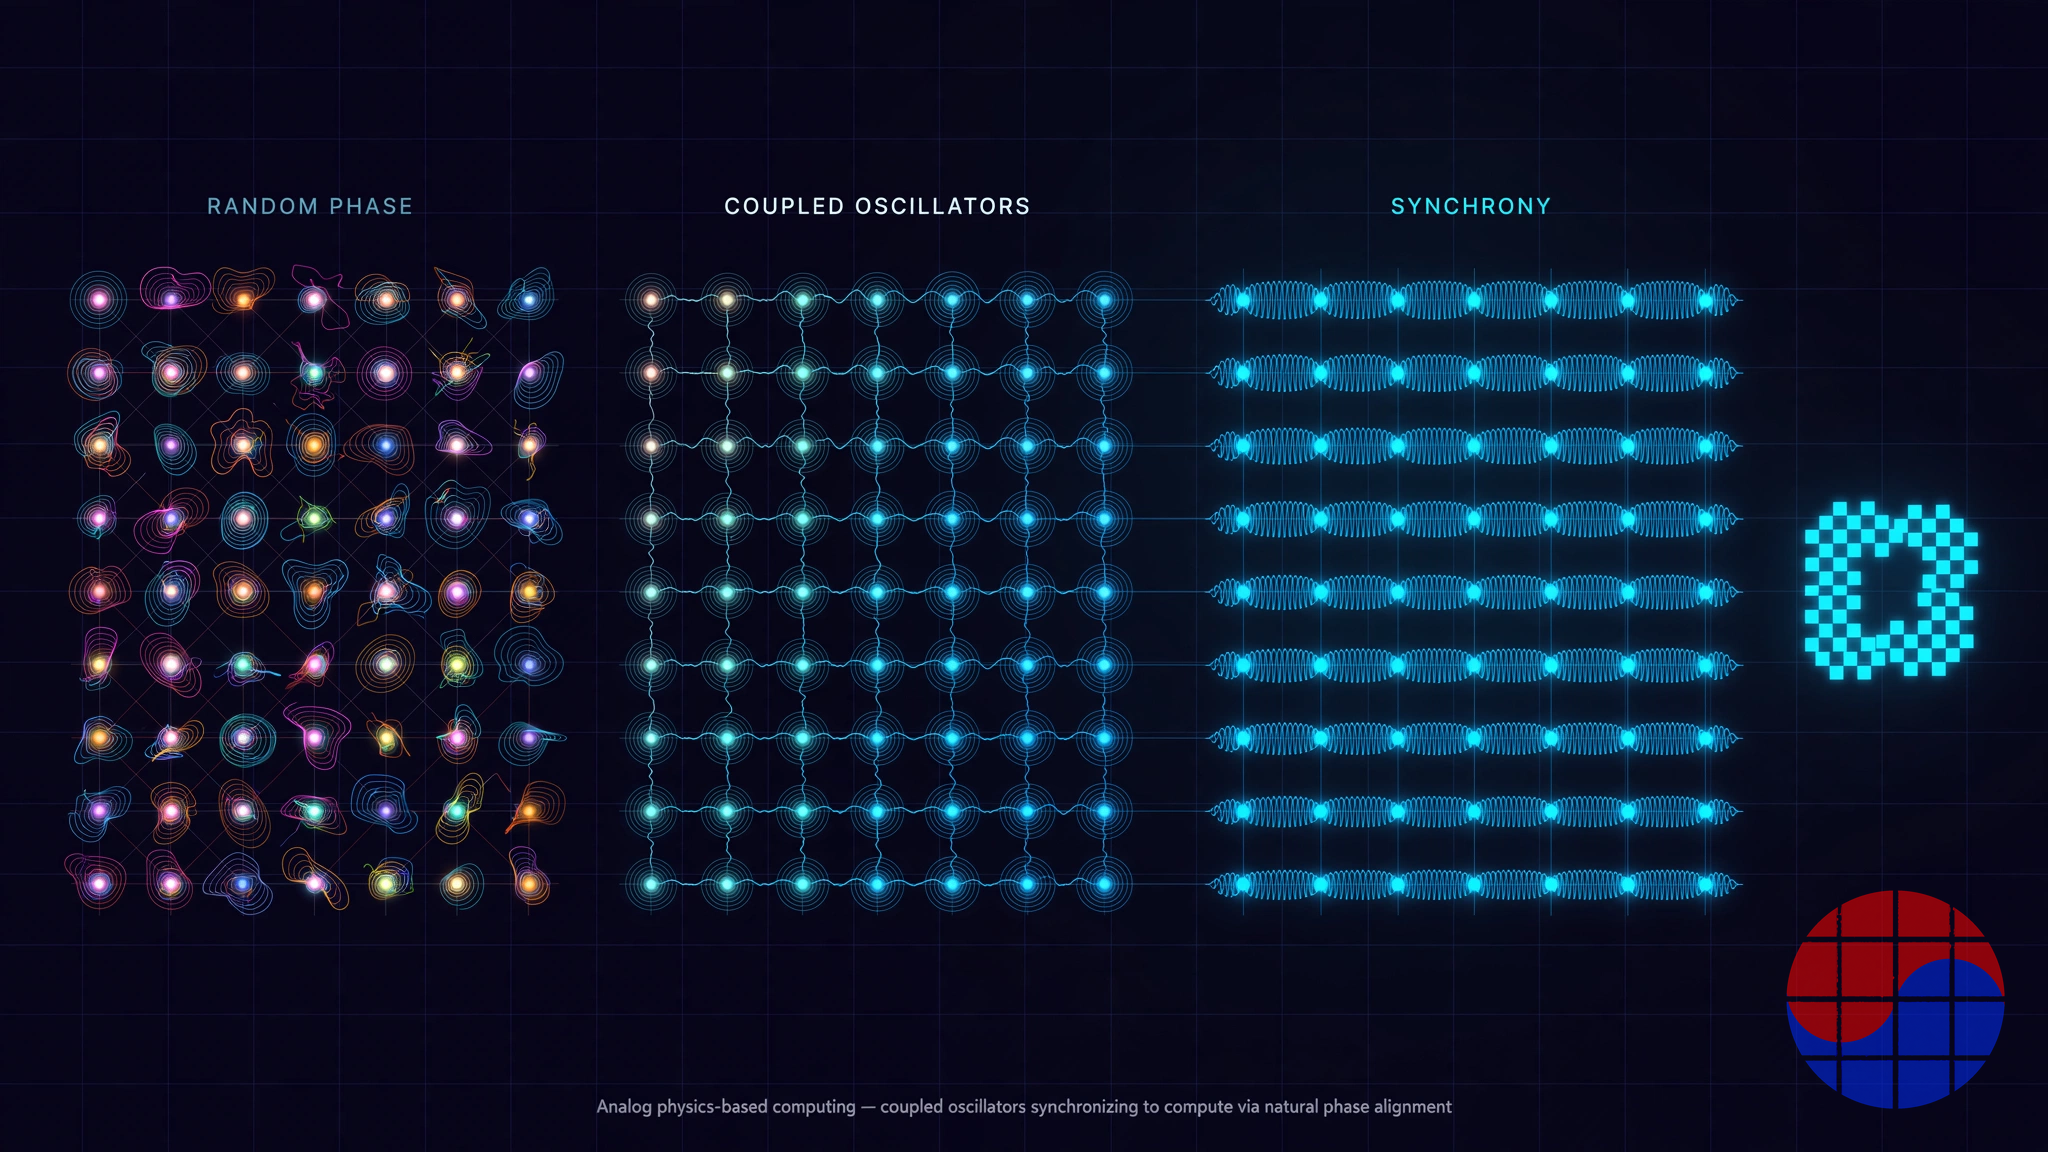
Capa dos: osciladores acoplados como primitiva. El primer artefacto público de la compañía, Un-0, hace concreta la afirmación abstracta. Un-0 es un generador de imágenes cuyo motor de cálculo es una gran población de osciladores acoplados, modelada con el modelo de Kuramoto: las matemáticas de cómo las unidades rítmicas (metrónomos sobre una mesa compartida, luciérnagas, células marcapasos) se atraen mutuamente hacia la sincronía. Cada oscilador tiene una fase; los parámetros aprendibles son las fuerzas de acoplamiento entre cada par de osciladores y la frecuencia natural de cada uno. Para generar una imagen, el sistema parte de fases aleatorias, un pequeño grupo de osciladores de condicionamiento sesga la población hacia la clase pedida, se deja evolucionar la física y el patrón final de fases se lee y se decodifica en píxeles. Aprender significa aprender los acoplamientos: el decodificador representa menos del 13% de los parámetros del modelo, y las ablaciones de la compañía indican que los osciladores mismos hacen un cálculo útil, en lugar de decorar un generador convencional.
Capa tres: codiseño, o «coevolución neuronal». La compañía sostiene que el modelo y el hardware deben diseñarse juntos: mantener la memoria físicamente cerca del cómputo, reutilizar el estado físico en el tiempo en lugar de recargar miles de millones de parámetros para cada token, y tratar las imperfecciones del hardware como algo que el modelo aprende, en vez de algo que la ingeniería debe eliminar. El ruido es el ejemplo más claro. En el diseño digital, el ruido es un enemigo que se paga con energía para suprimirlo. En esta arquitectura, la IA generativa parte de todos modos de la aleatoriedad, y una red entrenada sobre un sustrato específico puede aprender las variaciones de ese sustrato. La energía que los chips digitales gastan en forzar una uniformidad perfecta, en este relato, simplemente no se gasta.
El objetivo de eficiencia procede de la termodinámica, no de un benchmark: la compañía argumenta que la brecha entre el punto en el que opera el hardware digital de IA y lo físicamente posible es de aproximadamente tres órdenes de magnitud, de ahí la cifra de ~1.000x. Es importante ser preciso sobre el estatus de ese número. Es una estimación de una brecha teórica, no una medición. No ha sido demostrado en hardware, y los resultados de Un-0 —FID de 6,74 en ImageNet 64x64 con 16.384 osciladores y 322 millones de parámetros, en el rango de los primeros generadores convencionales cuando aparecieron— validan la afirmación del aprendizaje (un sistema dinámico físico puede ser entrenado para hacer una tarea generativa real a escala moderada), no la de la eficiencia, porque el propio Un-0 se ejecutó en GPU B200.
3. Qué existe hoy: una simulación, un rastro de papel y un reloj de cinco años
En el último hito público de la compañía, el inventario es corto. Hay un artículo de lanzamiento y un blog técnico con los pesos, el código de entrenamiento y el código de ablación de Un-0 abiertos: un artefacto de investigación genuinamente abierto, más de lo que publican muchas startups de hardware en modo sigiloso. No hay chip. No hay fecha de tape-out publicada. Rao ha dicho que los próximos años serán para «probar una serie de ideas y prototipos y dar con el paradigma exacto» que escale, ha descrito un horizonte de unos cinco años para construir el chip, ha dicho que la compañía se asociará con TSMC y ha llamado al primer prototipo «probablemente uno de los chips analógicos más grandes, quizá el más grande, que se haya construido». La compañía posiciona su producto final como una jugada de sistemas —silicio más la pila completa de inferencia, compitiendo en última instancia como proveedor de cómputo— y no como una venta de componentes.
Entre aquí y allí se interpone el problema más antiguo de la computación analógica, que el propio Rao nombra: las computadoras analógicas están entre las primeras computadoras, son inherentemente eficientes, y perdieron frente a lo digital por la variabilidad de fabricación: no podían escalarse. Cada dispositivo difiere ligeramente; los cambios de temperatura y la variación de proceso introducen errores que se acumulan. Lo digital ganó precisamente porque es indiferente a ese desorden. Toda la apuesta científica de Unconventional AI es que ese veredicto de hace 80 años puede revertirse en el caso específico de las cargas de trabajo neuronales, porque las redes neuronales toleran —y pueden entrenarse en torno a— exactamente las variaciones que hicieron inutilizable lo analógico para las tablas de artillería y la contabilidad.
4. El caso del escéptico
El contraargumento honesto tiene cuatro partes, ninguna trivial.
Precisión y sobrecosto de conversión. El cálculo analógico es ruidoso, y el ruido se acumula en los cálculos grandes. Históricamente, los aceleradores analógicos lucen mejor en la operación matricial central y peor a nivel de sistema, porque convertir señales entre los dominios analógico y digital —ADC y DAC en cada frontera— puede consumir gran parte de la energía que el núcleo analógico ahorró. Toda afirmación de eficiencia que no se mida en el enchufe, de extremo a extremo, sobre una carga de trabajo real, debe descontarse. El 1.000x de Unconventional es hoy una proyección sobre un sustrato que no existe.
Programabilidad. La fosa de la GPU no es solo el rendimiento; es que el mismo silicio entrena un modelo el lunes y sirve otro el martes. Los sistemas analógicos tienden a incrustar el cálculo en la estructura física, lo que los vuelve rígidos. La respuesta de la compañía —una interfaz de software a la física, más compiladores de dos fundadores especializados exactamente en eso— es plausible sobre el papel y no está probada en la práctica. La historia del hardware de IA está llena de chips más rápidos que perdieron frente a la flexibilidad de CUDA.
Escalado. Una población simulada de 16.384 osciladores generando imágenes de 64x64 es un resultado de investigación. Un sustrato de inferencia en producción necesita la dinámica equivalente a la escala de los modelos de lenguaje modernos, fabricada con una variación que el entrenamiento pueda absorber, con rendimientos (yield) que una foundry firme. Cada paso —de la simulación al prototipo, del prototipo al producto, de la generación de imágenes a la inferencia de LLM— ha matado antes a empresas analógicas. El campo tampoco está vacío: la computación analógica en memoria lleva años siendo perseguida por otros (Mythic ha enviado procesadores analógicos para inferencia en el borde), y un equipo de la Universidad de Pekín reportó a finales de 2025 un sistema analógico de cálculo matricial basado en RRAM con grandes ganancias de eficiencia reclamadas frente a las GPU: evidencia tanto de que la dirección está científicamente viva como de que Unconventional no la posee en exclusiva.
La línea base que se mueve. La eficiencia digital no es estática. El propio Rao, en Databricks, señaló que el costo de la IA por unidad de capacidad caía alrededor de 4x por año —diez veces más rápido que la ley de Moore— gracias a mejores modelos, cuantización y trabajo de sistemas. Un sustrato analógico que llegue dentro de cinco años no compite con la GPU de hoy; compite con cinco años de eficiencia digital acumulada, en costo por token, con un ecosistema de software maduro. El objetivo de 1.000x es, en parte, un reconocimiento de exactamente eso.
5. Qué debe ser verdad para que valgan 4.500 millones
Reduce el precio a sus supuestos estructurales. Para que una valoración semilla de 4.500 millones parezca razonable en retrospectiva, aproximadamente deben cumplirse estas cosas:
| # | Supuesto | Estado hoy |
|---|---|---|
| 1 | La energía se convierte en la restricción vinculante del crecimiento de la IA en la década | Dirección ampliamente aceptada; el calendario de 3-4 años es afirmación de la compañía |
| 2 | Un sustrato de osciladores acoplados / analógico puede entrenarse para cargas reales de IA | Mostrado en simulación a escala de generación de imágenes (Un-0, FID 6,74) |
| 3 | El enfoque escala de 16.000 osciladores e imágenes a la inferencia a escala LLM | Sin probar: el riesgo científico central |
| 4 | La variabilidad analógica puede absorberse con entrenamiento a escala de fabricación (TSMC) | Sin probar: el riesgo de ingeniería central |
| 5 | La eficiencia de extremo a extremo (conversión incluida) supera a lo digital por un múltiplo grande | ~1.000x teórico reclamado; 0x demostrado en hardware |
| 6 | Una pila de software hace el sustrato suficientemente programable para los clientes | La experiencia de los fundadores encaja; nada enviado |
| 7 | Los hyperscalers cualifican un sustrato no digital para inferencia en producción | Sin clientes ni design wins divulgados |
Lee la tabla como un embudo. Los supuestos 1 y 2 son los que los inversores pudieron suscribir en diciembre de 2025 con una confianza razonable. Los supuestos 3 a 5 son donde vive realmente los 4.500 millones: son binarios, están correlacionados (los tres son facetas de «¿escala la física?») y tardarán años en resolverse. El supuesto 7 es el riesgo de negocio apilado sobre el riesgo científico: incluso un sustrato que funcione debe desplazar la cadena de suministro más atrincherada de la tecnología.
Y ahora la aritmética de retorno que hace firmar a inversores sofisticados de todos modos. Los retornos del venture siguen una ley de potencias: un fondo no necesita que Unconventional sea probable; necesita que la recompensa en la rama de éxito sea enorme y que la participación de entrada sea significativa. Si un nuevo sustrato de cómputo captura aunque sea un porcentaje bajo de un dígito del gasto en inferencia de IA con márgenes de tipo software, la compañía vale decenas o cientos de miles de millones: el incumbente al que desplazaría parcialmente se valora en billones. Frente a esa recompensa, un cheque de 475 millones por ~10,6% es una opción con precio, y el precio de ejercicio es el tiempo: la opción caduca si la física no escala antes de que se acabe el dinero, o la paciencia de la industria. El segundo tramo previsto hacia los 1.000 millones es la fecha de renovación de la opción: se valorará con la evidencia de prototipo que exista para entonces, y es el futuro dato más informativo sobre esta compañía.
6. El lado negativo: de qué está hecho el suelo
El análisis del lado negativo de una compañía sin producto suele ser una palabra —cero—, pero aquí el suelo tiene algo de estructura. Primero, el suelo del equipo: las dos compañías anteriores de Rao fueron adquiridas por unos 400 millones reportados y 1.300 millones, y un equipo que combina la red de exalumnos de MosaicML con grupos de investigación del MIT y Stanford seguiría siendo adquirible en un escenario de fracaso, aunque a valoraciones posteriores a la semilla muy por debajo de 4.500 millones, lo cual es un frío consuelo para la aritmética de retorno de los inversores semilla, aun suavizando la pérdida absoluta. Segundo, el suelo de la IP: el trabajo de modelos publicado en abierto construye reputación y gravedad de contratación más que IP defendible; la capa defendible, si la hay, será el hardware y la pila de compiladores, que aún no existen. Tercero, el suelo de caja: 475 millones son años de pista para una compañía en fase de investigación, lo cual corta en ambos sentidos: elimina el riesgo de financiación de la fase de exploración y elimina la disciplina que ese riesgo impone. El mal resultado realista no es un colapso repentino; es uno lento: prototipos que funcionan a pequeña escala, una eficiencia que se encoge a nivel de sistema, y un mundo en los años 2030 en el que la compañía es un respetado laboratorio de investigación con una tabla de capitalización cara.
Chase's Take
Deja la física a un lado un momento y mira la transacción. Una semilla de 475 millones a 4.500 millones, dos meses después de la fundación, no es en realidad una valoración de Unconventional AI. Es la valoración de una afirmación de categoría: que el reinado de 80 años de la abstracción digital está terminando porque la energía, y no los transistores, es ahora el recurso escaso. Los inversores no compraban un chip. Compraban el derecho a llegar temprano si el sustrato de la computación cambia, y pagaron una prima de fundador a la única persona cuya biografía se lee como una preparación para exactamente esta apuesta: el ingeniero que se hizo neurocientífico, construyó hardware específico para la carga de trabajo antes de que estuviera de moda, lo vendió, y luego vendió también la capa de software de eficiencia.
Mi lectura es que el precio se descompone en tres partes, en orden descendente de tamaño. La mayor es la opción sobre un cambio de sustrato, valorada por el tamaño de la inferencia de IA y no por nada que la compañía haya construido. La segunda es el equipo, genuinamente escaso: hay muy pocos grupos que combinen diseño analógico en producción, teoría de compiladores para sistemas físicos y un CEO con dos salidas en eficiencia de IA. La tercera, y la menor, es la ciencia hasta ahora: Un-0 es un hito de investigación creíble —osciladores entrenados haciendo un trabajo generativo real, publicado abiertamente— y también está, medido contra la afirmación, a tres órdenes de magnitud de simulación de la evidencia. Un FID de 6,74 en imágenes de 64x64 te dice que el aprendizaje funciona. Todavía no dice nada sobre si la física se puede enviar como producto.
El detalle al que sigo volviendo es el tramo. Rao no tomó 1.000 millones de una vez; los primeros 475 millones son explícitamente una primera parte. Eso es, o bien confianza («valdrémos más quando el segundo cierre fije el precio»), o bien disciplina («demuestra el paradigma antes de valorar la compañía»), y viniendo de un fundador que ha vendido dos compañías, lo leo como ambas cosas, y como la pista de cómo seguir a esta compañía. No mires los titulares de valoración. Mira tres cosas: si el segundo tramo se cierra, a qué precio y respaldado por qué artefacto; si el programa de osciladores escapa de la generación de imágenes hacia una demostración a escala de modelo de lenguaje, aunque sea en simulación; y si aparece un prototipo físico con cifras de eficiencia en el enchufe. Hasta que ocurra lo tercero, cada cifra de eficiencia de esta compañía —incluido el 1.000x— es una afirmación sobre termodinámica, no sobre un producto.
Para la industria de semiconductores, la señal más profunda es dónde se movió el cuello de botella. Hace una década, lo escaso eran los FLOPS. Después fue el ancho de banda de memoria: la era de la HBM. Unconventional AI es un argumento de 475 millones de que lo próximo escaso son los julios, y de que cuando los julios aprieten lo suficiente, la industria tolerará reabrir preguntas que cerró en los años 40: computación no numérica, la física como algoritmo, hardware que se entrena en lugar de programarse. Aunque esta compañía concreta fracase, ese argumento ha sido financiado a una escala que garantiza imitadores, artículos y prototipos. Precios como este son la manera en que una industria anuncia que una dirección de investigación se ha convertido en estrategia.
Una última calibración. El prior correcto para «4.500 millones, sin chip» no es «burbuja» ni «visión». Es «riesgo sin precio, deliberadamente». Los inversores saben exactamente cuántos de los siete supuestos de la tabla anterior están sin probar; firmaron el term sheet de todos modos, porque el único escenario en el que todos se cumplen vale más de lo que cuestan los otros seis. El resto podemos ver un experimento limpio: la prueba con más capital de la historia de si la forma de computar del cerebro puede reconstruirse en silicio. Ese experimento merece ser seguido con precisión: hito a hito, en público, con los números adjuntos.
Implications
Para inversores. Trata la posición como una opción binaria con una fecha de renovación visible. Los datos que revaloran esta compañía son, en orden: (1) el segundo tramo hacia los 1.000 millones; su precio y su momento son la estimación de probabilidad actualizada del mercado; (2) una demostración del enfoque de osciladores a escala de modelo de lenguaje, aunque sea simulada; (3) el primer silicio con datos de eficiencia de extremo a extremo (en el enchufe); (4) cualquier evaluación de un hyperscaler divulgada. A falta de eso, marca la tesis, no la valoración del titular. El riesgo comparable no son otras startups de chips de IA con productos y órdenes de compra; son las apuestas de sustrato en fase de investigación, donde los calendarios se deslizan en años, no en trimestres.
Para estrategas de semiconductores. La composición del equipo fundador es la señal estratégica: los compiladores y los sistemas de programación se sientan junto a los circuitos analógicos porque el asesino histórico de los sustratos alternativos fue la interfaz de software, no la física del dispositivo. Si compites en silicio de IA, el elemento a vigilar no son las puntuaciones FID de Unconventional, sino si su enfoque de interfaz de software a la física atrae a los teóricos y a los ingenieros de compiladores que harían programable un sustrato no digital. El flujo de talento mostrará la credibilidad del paradigma antes que los benchmarks.
Para planificadores de centros de datos y energía. No pongas un factor de eficiencia de 1.000x en ningún plan de capacidad. El propio calendario de la compañía es de años de prototipado, y la eficiencia digital sigue componiéndose mientras tanto. Lo que la ronda sí valida —al nivel de la asignación de capital, no de la ingeniería— es que la energía por inferencia está ahora valorada como una restricción estratégica por los mayores inversores en IA. Los planes que suponen que la demanda de inferencia puede crecer sin una respuesta energética son exactamente los planes contra los que se recaudaron estos 475 millones.
Para investigadores. La publicación abierta de Un-0 —pesos, código de entrenamiento, ablaciones— hace que el enfoque de osciladores sea falsable en público, que es exactamente como debe probarse una afirmación de sustrato. Las preguntas abiertas son específicas y comprobables: el comportamiento de escalado de la calidad frente al número de osciladores contra la frontera convencional, la robustez de los acoplamientos aprendidos frente a la variación de dispositivos, y el tamaño del sobrecosto de conversión en cualquier implementación física. El progreso en esas tres, en ese orden, es el marcador científico.
FAQ
¿Tiene Unconventional AI un chip? No. En su último hito público (Un-0, junio de 2026), el sistema demostrado por la compañía es una simulación por software de osciladores acoplados ejecutada en GPU convencionales. Un chip analógico físico está en desarrollo, con un programa de prototipado de varios años y una asociación con TSMC descritos por la compañía, pero no se ha mostrado silicio ni se ha publicado fecha de tape-out.
¿Por qué una empresa sin producto vale 4.500 millones de dólares? Los 4.500 millones reportados son una valoración post-money de fase semilla de diciembre de 2025, no un precio de mercado de un producto. Valoran tres cosas: un equipo fundador con dos salidas previas (Nervana, unos 400 millones reportados a Intel; MosaicML, 1.300 millones a Databricks), una experiencia combinada escasa en diseño analógico y teoría de compiladores, y una opción sobre un nuevo sustrato de computación si la restricción energética de la IA fuerza uno. Los inversores compraron aproximadamente el 10,6% de la compañía por 475 millones.
¿Qué es el enfoque de osciladores acoplados, en términos sencillos? En lugar de computar con interruptores digitales que simulan una red neuronal paso a paso, la compañía quiere que redes de osciladores físicos —circuitos que ciclan rítmicamente, como metrónomos— realicen el cálculo mediante su sincronización mutua. Los parámetros aprendibles son las fuerzas de acoplamiento entre osciladores. Que la física se asiente en un patrón sincronizado es la inferencia, y por eso la compañía cree que puede usar mucha menos energía que simulando la misma dinámica numéricamente.
¿Qué deberíamos vigilar a continuación? Tres hitos, en orden de valor informativo: el cierre y el precio del segundo tramo previsto hacia una captación total de 1.000 millones; una demostración del enfoque en una tarea a escala de modelo de lenguaje (Un-0 cubre la generación de imágenes); y el primer silicio físico con mediciones de eficiencia de extremo a extremo. Hasta el último de ellos, la cifra de ~1.000x de eficiencia sigue siendo una estimación teórica, no un resultado demostrado.
Nota sobre fuentes y estado: la valoración, el tamaño de la ronda y la composición de inversores son los reportados en el anuncio del 8 de diciembre de 2025 y se indican como cifras reportadas; la compañía es privada y sus términos no están auditados de forma independiente. Los resultados técnicos (Un-0) son las cifras publicadas por la propia compañía en su lanzamiento de junio de 2026. La conversión de divisas utiliza 1 USD = 1.400 KRW en todo el texto.
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.


