VLSI Korea
Matematika Produksi Vera Rubin: 576 Stack HBM4 per Rak, 300.000 Wafer per Sejuta GPU (TSMC, SK hynix, Samsung, Micron)
Vera Rubin kini produksi penuh: satu rak NVL72 memakai 576 stack HBM4 dan ~21,5 wafer. Satu juta GPU butuh ~300.000 wafer, dan bottleneck 2027 adalah HBM4, bukan GPU.


Kesimpulan satu baris — Kecepatan produksi Vera Rubin ditentukan bukan oleh GPU, melainkan oleh bit HBM4. Dalam struktur di mana satu rak mengonsumsi 576 stack HBM4 dan lebih dari 21 wafer, batas atas peningkatan produksi 2027 digambar oleh wafer para produsen memori.
Ringkasan 30 Detik
- Pada 21 Oktober 2026, dalam keynote GTC Berlin, CEO Jensen Huang menyatakan bahwa Vera Rubin "kini dalam produksi penuh." Waktu perakitan node turun dari dua jam pada Grace Blackwell menjadi kurang dari lima menit, dan pendinginan 100% cair.
- Satu rak NVL72 menampung 72 GPU Rubin, 36 CPU Vera, dan 576 stack HBM4 (20,7 TB = 165.888 Gb). Per GPU, HBM4 terdiri dari delapan stack 12-high 36 GB, 288 GB (2.304 Gb).
- Volume hanya tersedia sebagai estimasi. Kasus dasar pasar saat ini adalah 5.000–7.000 rak pada H2 2026 (estimasi rantai pasok) dan 11.000–21.000 rak pada 2027 (0,8–1,5 juta GPU).
- Dikonversi ke wafer, satu GPU mengonsumsi 0,037 wafer logika + 0,143 wafer CoWoS + 0,118 wafer DRAM HBM — total kira-kira 0,30 wafer. Satu juta GPU berarti kira-kira 300.000 wafer.
- Putusan bottleneck: pertama, HBM4 (volume 2026 secara efektif sudah teralokasi, laporan pemangkasan alokasi, prospek harga kontrak 2027 yang naik tajam); kedua, CoWoS. Wafer logika dan perakitan rak bukan kendala.
1. Deklarasi Berlin — Fakta Terkonfirmasi Terlebih Dahulu
Pada 21 Oktober 2026, Jensen Huang mengangkat sebuah node Vera Rubin dalam keynote GTC Berlin dan mengonfirmasi tiga hal. Pertama, Vera Rubin kini dalam produksi penuh. Kedua, waktu perakitan node telah turun dari dua jam pada generasi Grace Blackwell menjadi kurang dari lima menit — hasil dari penghapusan kabel dan kawat. Ketiga, pendinginan 100% cair, naik dari 80% cair pada generasi sebelumnya, dengan suhu masuk cairan pendingin 45°C.
Produksi itu sendiri bukan berita baru. NVIDIA mengumumkan masuk ke produksi pada CES Januari 2026, dan rilis GTC Taipei pada 31 Mei menetapkan pengiriman produksi untuk musim gugur. Pada 1 Juni, operator cloud CoreWeave menyelesaikan bring-up rak NVL72 pertama dan mengonfirmasi operasi langsung. Yang dikonfirmasi Berlin adalah bahwa "dalam produksi" kini berarti peningkatan penuh, bukan sampel dan unit awal. Huang juga mencatat bahwa 150 mitra rantai pasok Taiwan berdiri di balik Vera Rubin.
Artikel ini membedah deklarasi tersebut dalam angka: berapa banyak sistem yang dibangun, apa yang masuk ke satu rak dan dalam jumlah berapa, bagaimana volume itu dikonversi menjadi wafer, dan perusahaan mana memasok apa, dan berapa banyak. Angka dari pengungkapan resmi dan pelaporan mencantumkan sumbernya; angka yang diperoleh melalui perhitungan diberi label estimasi dengan asumsi yang ditampilkan.
2. Anatomi Satu Rak — Di Dalam NVL72
Unit penjualan Vera Rubin bukan chip GPU melainkan sebuah rak. Satu NVL72 terdiri dari 18 tray komputasi dan 9 tray switch NVLink, dengan 72 GPU yang diikat oleh fabric NVLink 6 menjadi sesuatu yang berperilaku seperti satu akselerator raksasa tunggal.
| Komponen | Jumlah / Spesifikasi | Catatan |
|---|---|---|
| GPU Rubin | 72 | 336B transistor per GPU (dua die), TSMC 3nm |
| CPU Vera | 36 | Arm 88-core, NVLink-C2C ke GPU |
| HBM4 | 576 stack, 20,7 TB | 8 stack × 36 GB per GPU |
| LPDDR5X (untuk CPU) | Hingga 54 TB | Hingga 1,5 TB per CPU, modul SOCAMM2 (menurut analisis broker) |
| Fabric NVLink 6 | 260 TB/s per rak | 3,6 TB/s per GPU |
| Jaringan | NIC ConnectX-9, DPU BlueField-4 | Scale-out melalui Spectrum-X Ethernet |
| Pendinginan | 100% cair | Suhu masuk cairan pendingin 45°C |
| Konsumsi daya | ~190–230 kW | Estimasi rantai pasok |
| Harga rak | $5M–$7,8M | Pelaporan Maret 2026 dan analisis BOM broker |
Sumber: Spesifikasi NVL72 yang diterbitkan NVIDIA, liputan keynote GTC Berlin 2026 (21 Oktober 2026), analisis daftar material (BOM) broker.
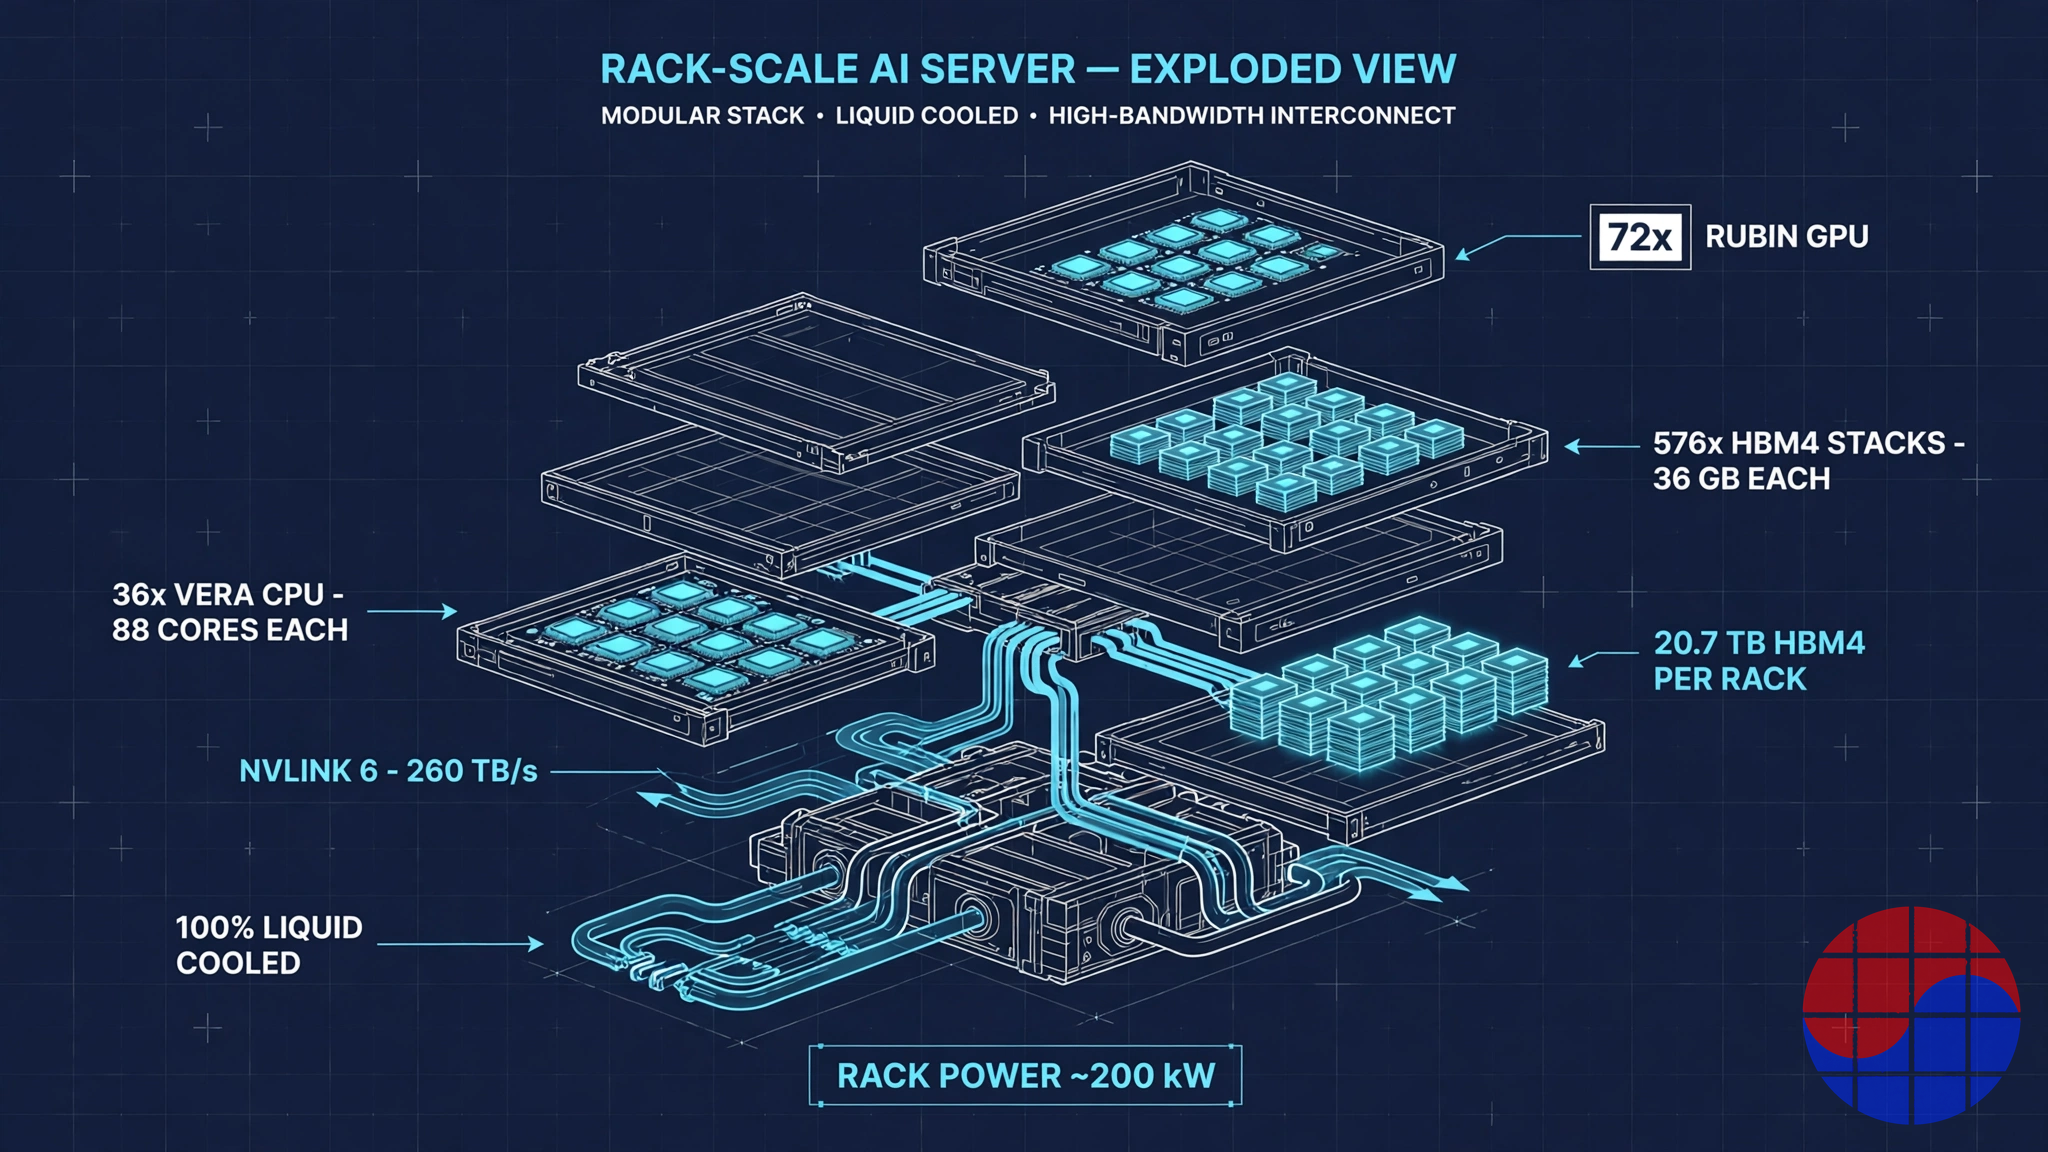
Anatomi rak Vera Rubin NVL72 — 72 GPU dan 576 stack HBM4 dalam satu rak. Source: VLSI Korea
Aritmetika HBM4
Platform ini, pada intinya, adalah sistem memori. Membongkar HBM4 satu GPU dalam bit:
| Item | Nilai | Perhitungan |
|---|---|---|
| Satu stack HBM4 | 36 GB (288 Gb) | Dua belas die 24 Gb ditumpuk |
| Stack per GPU | 8 | Spesifikasi NVIDIA |
| HBM4 per GPU | 288 GB (2.304 Gb) | 8 × 36 GB |
| Lebar pita per GPU | 22 TB/s | Spesifikasi NVIDIA |
| Stack per rak | 576 | 72 × 8 |
| HBM4 per rak | 20,7 TB (165.888 Gb) | 72 × 288 GB |
| Die DRAM HBM per rak | 6.912 | 576 stack × 12 die |
Dibandingkan Blackwell, kapasitas HBM per GPU naik 1,5×, dari 192 GB menjadi 288 GB, dan lebar pita 2,75×, dari 8 TB/s menjadi 22 TB/s. Jumlah stack tetap delapan, tetapi setiap stack tumbuh dari 24 GB menjadi 36 GB dan kecepatan pin meningkat. Yang penting bagi produksi adalah bahwa seluruh kenaikan kapasitas ditagih dalam wafer DRAM tambahan: setiap stack membutuhkan dua belas die 24 Gb, dan dengan memperhitungkan yield die, konsumsi wafer aktual berjalan lebih tinggi lagi.
3. Berapa Banyak yang Dibangun — Skenario Volume
NVIDIA tidak mengungkapkan pengiriman unit Rubin. Setiap angka yang beredar adalah estimasi, dan artikel ini hanya menggunakan angka dengan metode yang transparan.
Hitung Balik 1: Dari Pendapatan
Diskusi pasar, yang didasarkan pada panduan NVIDIA dan komentar eksekutif, mempertimbangkan laju di mana Vera Rubin menyumbang kira-kira $20 miliar pendapatan kuartalan. Membagi dengan rentang harga rak yang dilaporkan ($5M–$7,8M) menghasilkan 2.550–3.975 rak per kuartal, atau kira-kira 10.000–16.000 rak per tahun. Perhatikan bahwa hitung balik ini mengasumsikan semua pendapatan Rubin berasal dari rak NVL72, sehingga menjadi referensi batas atas — penjualan tingkat board dan modul serta pendapatan Blackwell paralel tercampur di dalamnya, pada kenyataannya.
Hitung Balik 2: Estimasi Rantai Pasok
Analis yang melacak rantai pasok Taiwan menempatkan pengiriman rak VR200 H2 2026 pada 5.000–7.000 unit (dilaporkan sebagai estimasi Ming-Chi Kuo), yang dikonversi menjadi 360.000–500.000 GPU. Dengan laporan pemangkasan alokasi HBM4 dalam campuran, konsensus paralel menempatkan total GPU Rubin 2026 pada 250.000–350.000. Untuk 2027, tahun penskalaan, skenario dasar adalah 0,8–1,5 juta GPU (11.000–21.000 rak). Estimasi industri juga memproyeksikan pengiriman rak kelas NVL72 secara keseluruhan (GB300 + VR200 + VR300) tumbuh lebih dari 50% year over year pada 2027, dengan VR200 mengambil pangsa terbesar.
| Periode | Rak (est.) | GPU (est.) | Stack HBM4 (est.) | Dasar |
|---|---|---|---|---|
| H2 2026 | 3.500–7.000 | 250K–500K | 2,0M–4,0M | Estimasi rantai pasok; awal pengiriman musim gugur |
| Per kuartal pada puncak peningkatan | 2.550–3.975 | 180K–290K | 1,47M–2,29M | Hitung balik dari pendapatan kuartalan ~$20B |
| 2027 | 11.000–21.000 | 0,8M–1,5M | 6,4M–12,0M | Rentang skenario dasar |
Setiap angka dalam tabel ini adalah estimasi, bukan angka terkonfirmasi. Yang terkonfirmasi adalah produksi itu sendiri, dan awal pengiriman pada musim gugur.
Dikonversi ke bit HBM4, gambarannya berubah skala. Bahkan ujung bawah kasus dasar 2027 (0,8 juta GPU) membutuhkan 230 PB (230.400 TB) HBM4; ujung atas (1,5 juta GPU) mencapai 432 PB. Satu platform menyerap bagian substansial dari seluruh output HBM dunia.
4. Konversi Wafer — Satu GPU = 0,30 Wafer
Mengonversi volume menjadi wafer mengungkapkan di mana bottleneck berada. Model di bawah ini adalah model kami sendiri, dengan setiap asumsi diungkapkan; baca output sebagai rentang.
Asumsi
| Jenis wafer | Asumsi | Hasil |
|---|---|---|
| Logika (TSMC 3nm) | Luas die ~800 mm² × 2 (dekat batas reticle 858 mm²), ~65 die kotor per wafer 300 mm, yield die 85% | ~55 die baik per wafer = ~27 GPU |
| Pengemasan CoWoS | Jejak paket ~4.700 mm² (kelas 5,5-reticle 2026), 6–8 paket per wafer | ~7 GPU per wafer |
| DRAM HBM4 | Die 24 Gb ~60 mm², ~1.090 die kotor per wafer, yield efektif KGD/penumpukan 75% | ~820 die per wafer = ~8,5 GPU |
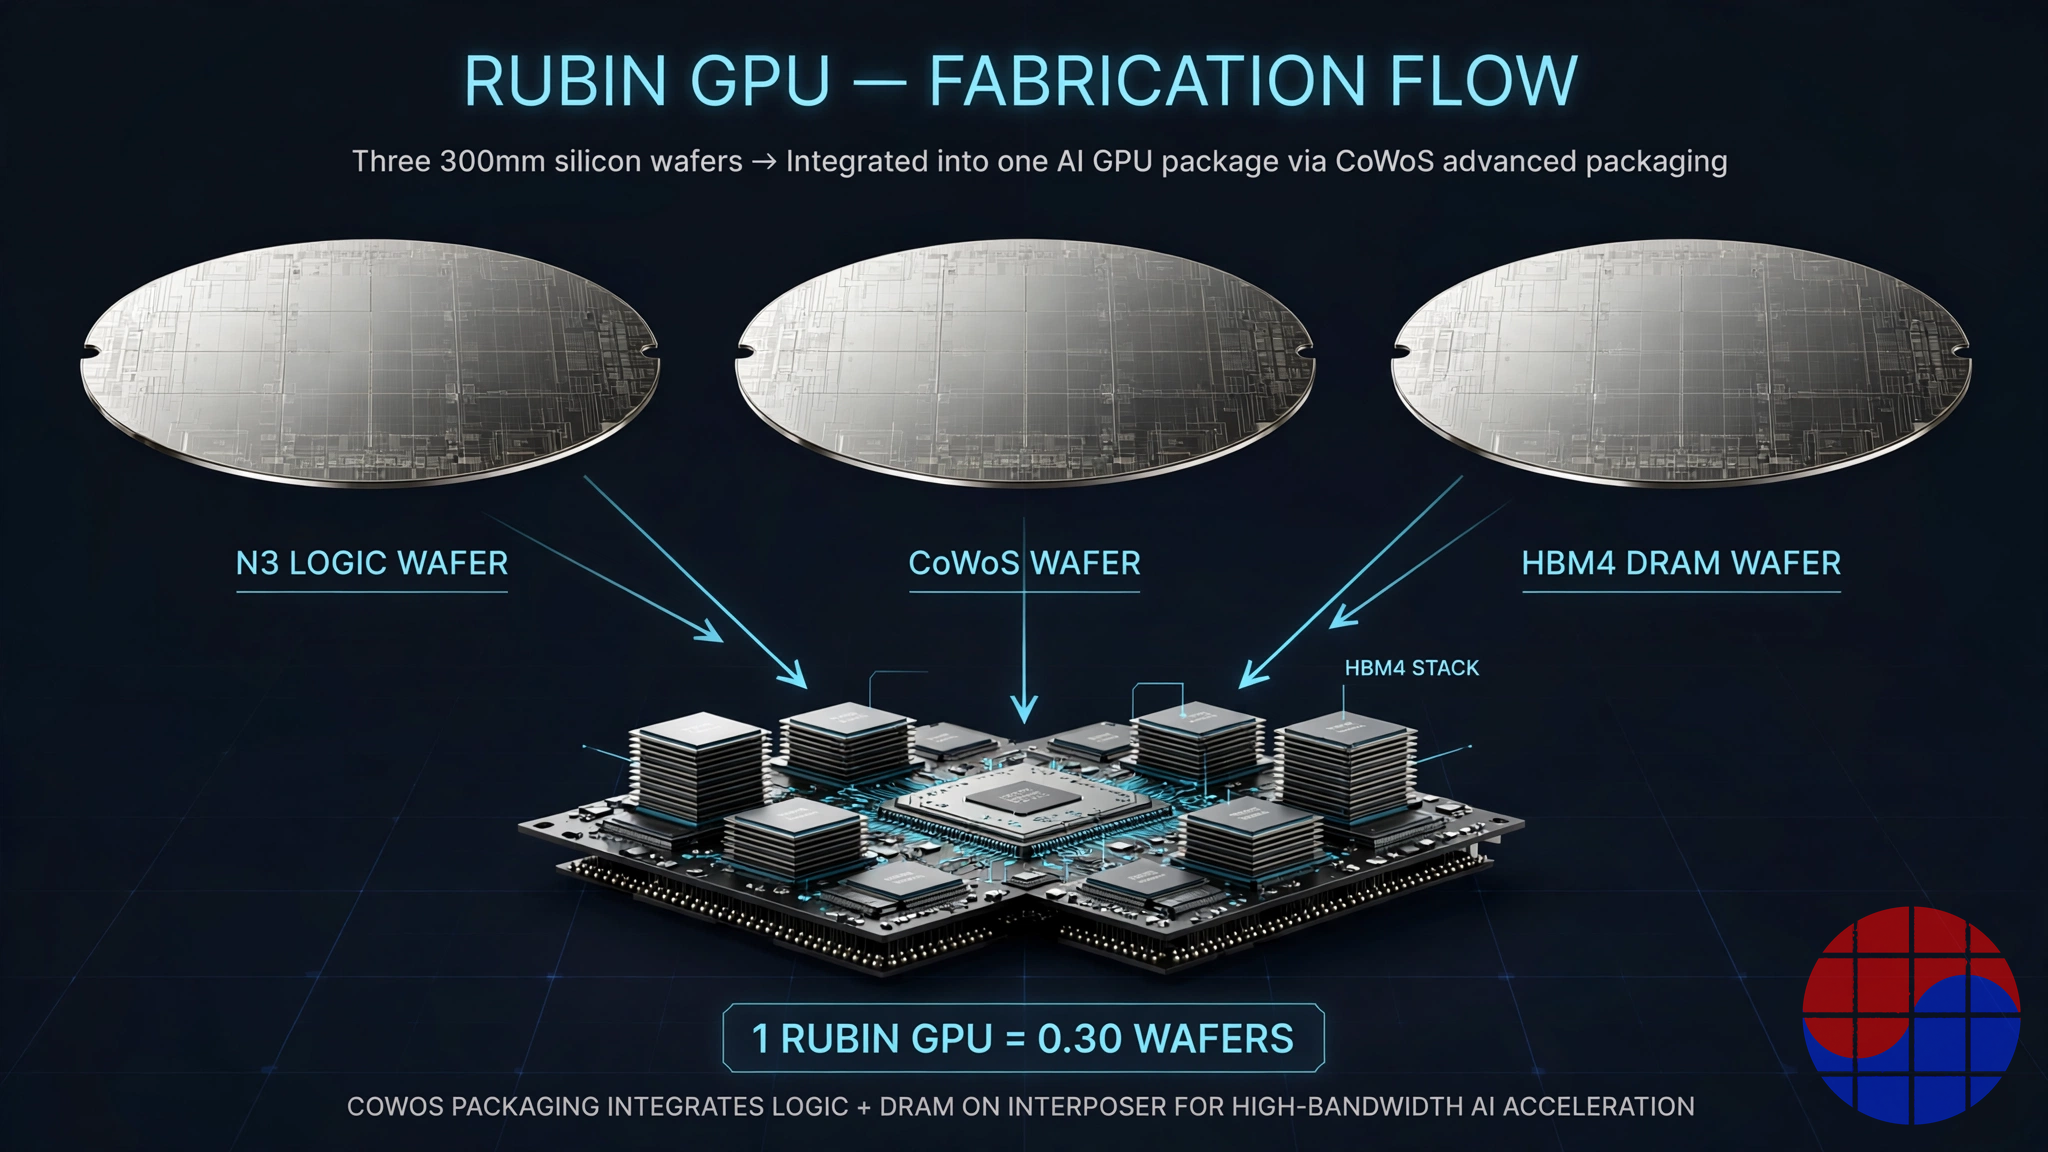
Tiga jenis wafer yang dikonsumsi satu GPU — logika, CoWoS, dan DRAM HBM. Source: VLSI Korea
Hasil Konversi
| Kategori | Per GPU | Per rak (72 GPU) | 2027 (0,8M–1,5M GPU) |
|---|---|---|---|
| Wafer logika (3nm) | 0,037 | ~2,7 | 30K–56K |
| Wafer CoWoS | 0,143 | ~10,3 | 114K–214K |
| Wafer DRAM HBM4 | 0,118 | ~8,5 | 94K–176K |
| Total | ~0,30 | ~21,5 | ~240K–450K |
Kesimpulannya tidak ambigu. Membangun satu juta GPU membutuhkan kira-kira 300.000 wafer di ketiga jenis, dan hampir 90% di antaranya adalah wafer pengemasan (CoWoS) dan memori (DRAM). Wafer logika murni hanya sekitar 12% dari total. Pelaporan juga menunjukkan bahwa empat desainer chip AI teratas hanya mengonsumsi sekitar 12% dari output logika node mutakhir — yang justru menjadi alasan mengapa fab logika bukan kendala pada peningkatan AI.
Dibandingkan dengan pasokan: TSMC mencapai estimasi 120.000–150.000 wafer CoWoS per bulan pada akhir 2026, dan dengan kapasitas mitra OSAT total industri mendekati kira-kira 200.000 per bulan. NVIDIA dilaporkan telah memesan di muka sekitar 60% CoWoS TSMC 2026. Kebutuhan CoWoS Rubin 2027 (114K–214K wafer per tahun) adalah persentase satu digit dari kapasitas tahunan TSMC, sehingga aritmetikanya bekerja bahkan jika dibagi dengan Blackwell — masalahnya adalah pertumbuhan paket: seiring jejak paket membesar, paket per wafer turun, dan ekspansi terus dimakan oleh luas.
5. Peta Pemasok — Siapa Memasok Apa, dan Berapa Banyak
Di balik satu rak Vera Rubin berdiri ratusan pemasok, termasuk 150 mitra Taiwan yang dikutip Huang. Peta intinya:
| Perusahaan | Yang dipasok | Volume / peran |
|---|---|---|
| TSMC | Die GPU 3nm, pengemasan CoWoS-L | Semua die GPU. NVIDIA dilaporkan memesan ~60% kapasitas CoWoS 2026 |
| SK hynix | HBM4, LPDDR5X SOCAMM2 | Rentang pertengahan 50% dari alokasi HBM4 awal (dilaporkan). Stack 12-high 36 GB; SOCAMM2 ditampilkan untuk CPU Vera |
| Samsung | HBM4 | Rentang pertengahan 20% dari alokasi awal (dilaporkan). DRAM 1c + base die 4nm; spesifikasi tercepat hingga 3,0 TB/s per stack, 11,7 Gbps. Sampel HBM4E menargetkan Rubin Ultra |
| Micron | HBM4 | ~20% dari alokasi awal (dilaporkan). 36 GB 12-high dalam pengiriman volume tinggi sejak Q1 2026; >2,8 TB/s per stack |
| Ibiden, Shinko, Unimicron, Nan Ya PCB | Substrat ABF | Substrat build-up untuk paket kelas 5,5-reticle; luas substrat adalah kapasitas |
| ASE, Amkor | Back-end (luapan CoWoS) | Estimasi 50K–60K WPM kapasitas OSAT baru menyerap luapan TSMC |
| Foxconn, Quanta, Wistron, Inventec | Perakitan & integrasi rak | Foxconn disebut sebagai perakit terbesar; desain node 5 menit menetapkan throughput |
| Dell, HPE, Lenovo, Supermicro, GIGABYTE | Pengiriman sistem | Rak lengkap ke CSP dan perusahaan |
| Vertiv, Schneider Electric, Delta | Daya & pendinginan | CDU dan daya untuk rak ~200 kW; mitra DSX POD |
| NVIDIA (in-house) | ConnectX-9, BlueField-4, switch NVLink, Spectrum-X Photonics | Pangsa BOM in-house meningkat — bagian NVIDIA dari pendapatan rak tumbuh setiap generasi |
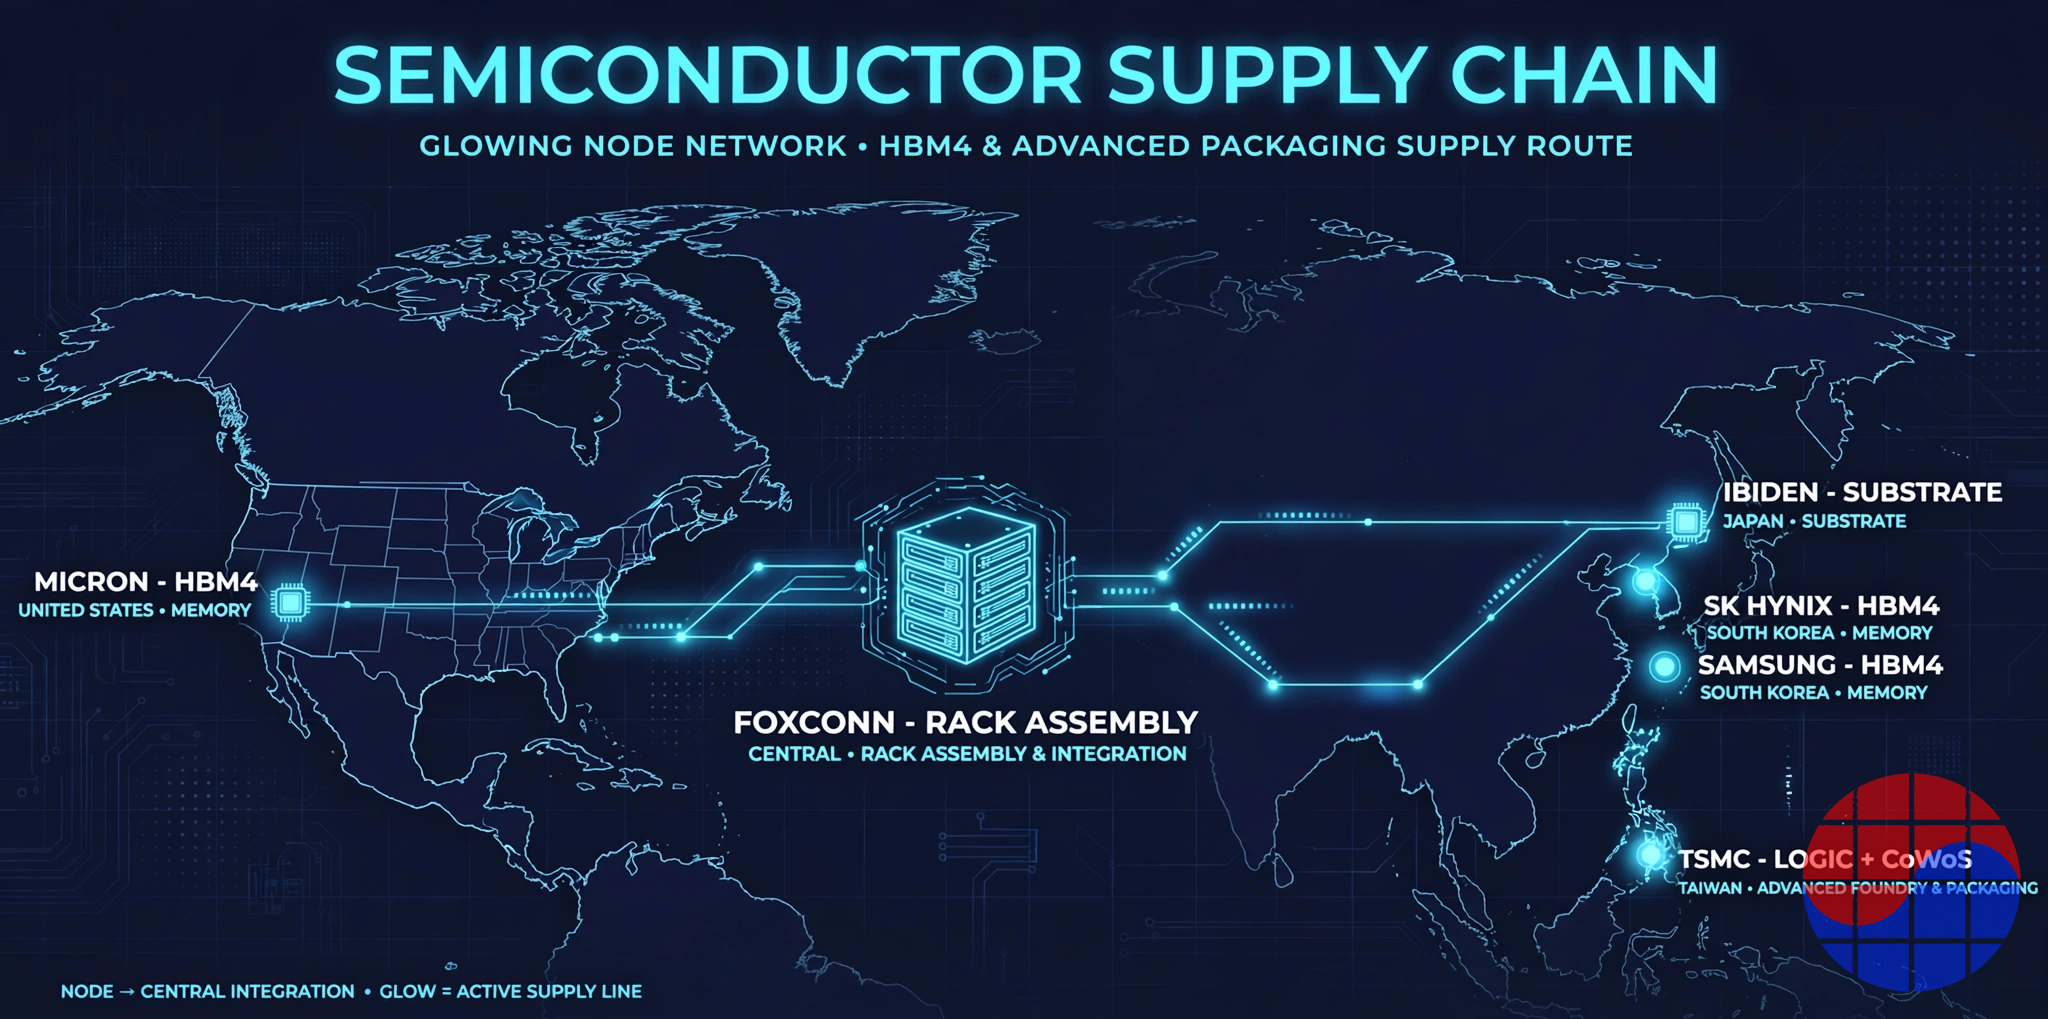
Rantai pasok Vera Rubin — logika dan pengemasan di Taiwan, HBM4 terbagi antara Korea dan AS, substrat di Jepang. Source: VLSI Korea
Alokasi HBM4 didasarkan pada pelaporan penugasan volume NVIDIA akhir 2025: SK hynix terbesar dalam rentang pertengahan 50%, Samsung dalam rentang pertengahan 20%, Micron sekitar 20%. Pembagian ini tidak tetap. Samsung memulai pengiriman produksi massal HBM4 pertama di industri pada Februari 2026 dan memimpin dalam spesifikasi kecepatan, sementara pelaporan pada April menunjukkan SK hynix mempertimbangkan memangkas pengiriman HBM4 2026 ke NVIDIA sebesar 20–30% di tengah waktu peningkatan — struktur di mana alokasi kuartalan dapat bergerak.
Ekonomi perakitan rak juga berubah. Dengan perakitan node turun dari dua jam menjadi lima menit, kapasitas perakitan bukan lagi masalah tenaga kerja melainkan masalah kedatangan komponen. Bagi perakit, Vera Rubin adalah rak yang dikirim secepat komponen tiba — artinya HBM4 dan paket CoWoS yang selesai menetapkan utilisasi kapasitas lini. Artikel pendamping kami tentang desain pabrik AI modular NVIDIA, pendalaman Vera Rubin DSX POD, membahas kecepatan penerapan; artikel ini berfokus pada berapa banyak sistem yang dibangun, dan dari berapa banyak wafer.
6. Putusan Bottleneck — Apa yang Sebenarnya Menghambat Peningkatan
| Proses | Putusan | Bukti |
|---|---|---|
| HBM4 | Kendala utama | Volume 2026 secara efektif habis terjual. Laporan tinjauan pemangkasan pengiriman. Stack 12-high 36 GB diproyeksikan naik dari ~$600 pada 2026 menjadi ~$1.300 pada 2027 (estimasi harga kontrak +121% YoY, dilaporkan) |
| CoWoS | Ketat, dapat dikelola | Kapasitas naik ~8× dalam tiga tahun, tetapi pertumbuhan luas paket mengimbangi ekspansi. Kekurangan pasokan industri 10–20% bertahan dalam estimasi |
| Substrat ABF | Pantau | Terpapar langsung pada pertumbuhan luas paket besar; pernah secara diam-diam menjadi bottleneck sebelumnya |
| Wafer logika 3nm | Bukan kendala | 4 desainer AI teratas mengonsumsi ~12% output logika node mutakhir (dilaporkan) |
| Perakitan rak | Bukan kendala | Perakitan node 5 menit, desain modular; kendalanya adalah kedatangan komponen |
| Daya & lokasi | Kendala sisi pelanggan | 190–230 kW per rak; transisi 800VDC dan infrastruktur pendinginan cair adalah tantangan lokasi |
Kesimpulannya sederhana. Fungsi produksi Vera Rubin terbaca min(stack HBM4 ÷ 576, paket CoWoS ÷ 72, die logika ÷ 144), dan pada 2026–2027 istilah yang menetapkan minimum adalah HBM4. Jika pendapatan Rubin meleset dari panduan dalam rilis laba NVIDIA, curigai pengiriman HBM4 sebelum permintaan. Sebaliknya, jika harga kontrak HBM4 benar-benar hampir dua kali lipat pada 2027, itu adalah sinyal bahwa trio memori telah mulai mengumpulkan bagiannya dari ekonomi peningkatan.
Pandangan Chase
Dengan semua angka dipaparkan, Vera Rubin kurang merupakan produk GPU melainkan bentuk fisik dari kontrak pembelian memori. Dari harga rak $5M–$7,8M, biaya wafer die GPU itu sendiri adalah pangsa yang lebih kecil daripada yang disarankan intuisi; uang dan kapasitas terkunci dalam 576 stack HBM4 dan luas CoWoS.
Dari sudut pandang Korea, perhatikan kemiringan alokasi. Rentang pertengahan 50% SK hynix adalah kontinuitas dari generasi Blackwell, tetapi rentang pertengahan 20% Samsung terlihat seperti lantai untuk comeback — jika kartu kecepatan dan HBM4E-nya bermain pada reset alokasi 2027, kemiringannya berubah. Dan yang menentukan kemiringan itu bukan pemasaran; melainkan yield KGD kuartal demi kuartal dan throughput penumpukan.
Terakhir, angka 0,30 wafer layak diingat. Kompetisi akselerator AI kini secara bersamaan adalah kontes desain dan kontes alokasi atas tiga jenis wafer. Roadmap TSMC, yang menunjuk ke HBM5 dan paket kelas 14-reticle untuk generasi berikutnya, mengatakan kontes alokasi ini tidak berakhir — hanya menjadi lebih mahal.
Sumber: Spesifikasi yang diterbitkan NVIDIA dan liputan keynote GTC Berlin 2026 (21 Oktober 2026), pelaporan rantai pasok dan laba Korea dan internasional, analisis daftar material (BOM) broker. Konversi volume dan wafer adalah estimasi kami sendiri di bawah asumsi yang dinyatakan dan dapat berbeda dari pengiriman aktual. Artikel ini bukan saran investasi.
FAQ
Q: Berapa banyak stack HBM4 yang masuk ke satu rak Vera Rubin? A: 576. Setiap GPU membawa delapan stack 12-high 36 GB (288 GB), dan satu rak menampung 72 GPU, jadi 72 × 8 = 576 stack — total 20,7 TB (165.888 Gb).
Q: Berapa banyak sistem Vera Rubin yang akan diproduksi pada 2027? A: Tidak ada angka terkonfirmasi. Menggabungkan estimasi rantai pasok dan hitung balik pendapatan, skenario dasar untuk 2027 adalah 11.000–21.000 rak, atau 0,8–1,5 juta GPU. H2 2026 diestimasi kira-kira 3.500–7.000 rak.
Q: Berapa banyak wafer yang dibutuhkan untuk membangun satu GPU? A: Sekitar 0,30 wafer di tiga jenis: 0,037 wafer logika 3nm, 0,143 wafer CoWoS, dan 0,118 wafer DRAM HBM4 — estimasi kami sendiri di bawah asumsi yang diungkapkan dalam artikel ini (luas die, yield, jejak paket). Per rak, itu sekitar 21,5 wafer.
Q: Apa bottleneck sebenarnya dalam produksi Vera Rubin? A: HBM4. Volume 2026 secara efektif sudah teralokasi, dan laporan tinjauan pemangkasan pengiriman serta prospek harga kontrak 2027 yang tajam mendukung putusan itu. CoWoS ketat tetapi berkembang; wafer logika 3nm dan perakitan rak sulit disebut kendala.
Q: Perusahaan mana yang memasok HBM4, dan dalam pangsa berapa? A: Menurut pelaporan alokasi akhir 2025, SK hynix memegang rentang pertengahan 50%, Samsung rentang pertengahan 20%, dan Micron sekitar 20%. Samsung membawa pengiriman produksi massal pertama di industri (Februari 2026) dan spesifikasi tercepat, SK hynix alokasi terbesar dan SOCAMM2, dan Micron pengiriman volume tinggi sejak Q1 2026 — dan alokasi dapat disesuaikan kuartal demi kuartal.
📩 Berlangganan VLSI Korea
Dapatkan analisis semikonduktor harian kami lebih dulu di email Anda. Berlangganan gratis.