 VLSI Korea
Startup Files #1: FuriosaAI — Metaの8億ドル買収を断った韓国のAI推論チップ
FuriosaAIはMetaの$800M買収提案を拒否し、2025年7月に累計$246M調達でユニコーン入り。TSMC 5nmの第2世代推論チップRNGD(FP8 512 TFLOPS、HBM3 48GB、TDP 180W)が2026年1月に量産開始。LG・Samsung SDS・Equinixを顧客に2027〜2028年IPOを目指す。


結論から言おう。 FuriosaAIは$800Mの買収提案を断るだけの理由をシリコンで証明した、稀有な韓国のAIチップ・スタートアップだ。2017年にソウルで設立されたこのファブレスは、2025年7月に累計調達額$246Mで企業価値1兆ウォン(ユニコーン)に達し、2026年1月からTSMC 5nmベースの第2世代推論チップRNGDの量産を開始した。Metaの買収提案を2025年3月に断った後、LG AI Research、Samsung SDS、Equinixを顧客として獲得し、2027〜2028年のIPOに向かっている。
Company in a Nutshell
FuriosaAIは2017年設立のソウル本社のファブレス(fabless)半導体スタートアップだ。AI推論(inference)専用NPUのみを設計し、生産はTSMCに委託する。海外拠点として米国Santa Claraオフィスを置き、2026年9月にシンガポール子会社を開設した。
- 創業者兼CEO June Paik — AMDでGPUを設計し、2013年に韓国に戻ってサムスン電子でメモリ新製品開発の小規模チームを率いた経歴の持ち主だ。共同創業者兼CTO Hanjoon Kimもサムスン電子出身だ。
- CRO Jeehoon Kang — KAIST教授(並列システム専攻)が研究責任者を務めており、VP of Hardware Youngjin Choは元サムスン電子Corporate VP出身のSoC専門家だ。
- 社名は映画Mad Max: Fury RoadのキャラクターFuriosaに由来する。
- CEO June Paikの持分率は17.6%(2025年半ばの公開届出書基準)だ。
Core Technology
FuriosaAIの中核はTCP(Tensor Contraction Processor)アーキテクチャだ。行列積(matmul)ではなく、tensor contraction自体をネイティブな演算単位として処理する。このアイデアは学術的にも検証されている — 「TCP: A Tensor Contraction Processor for AI Workloads」(ISCA 2024)、「FuriosaAI RNGD: A Tensor Contraction Processor for Sustainable AI Computing」(Hot Chips 2024)の2本の論文が公開されている。
なぜtensor contractionか。LLM推論のdecoding段階は、演算ではなくメモリ帯域幅がボトルネックとなるmemory-bound区間だ。データをどれだけ少なく、どれだけ効率的に動かすかがワット当たりトークンを決める。TCPはこのボトルネックを正面から狙った設計だ。
Warboy(第1世代、コンピュータビジョン用)
WarboyはSamsung Foundry 14nm FinFETプロセスで製造したデータセンター用コンピュータビジョン推論アクセラレータだ(SEMIFIVEのAI Inference SoC Platformベースの設計)。2021年に初シリコン、2023年4月に量産に入り、one-shot silicon successを記録した。
- MLPerf Inference v1.1(2021) — Nvidia T4比でobject detection・image classificationで約1.5倍。シリコンチップで結果を提出した唯一のスタートアップだった。
- MLPerf Inference Edge v2.0(2022) — 同一シリコンでコンパイラ改善のみで2倍の性能向上。SSD-MobileNetV1 offline throughput 8,762 vs Nvidia A2 4,856(約1.8倍)。
- 韓国の主要クラウドデータセンターに実際に配備され、Kakao Enterpriseがテストした(2023年報道)。
RNGD("Renegade"、第2世代、LLM推論用)
2024年8月にHot Chips(Stanford)で公開された第2世代チップだ。台湾GUC(Global Unichip)と共同開発し、TSMC 5nm・1.0GHzで動作し、CoWoS-SインターポーザにHBM 2スタックを統合した。公式開発者ドキュメント(developer.furiosa.ai)基準の主要スペックは以下の通りだ。
| 項目 | RNGD |
|---|---|
| プロセス / 動作周波数 | TSMC 5nm / 1.0GHz |
| BF16 / FP8 | 256 TFLOPS / 512 TFLOPS |
| INT8 / INT4 | 512 TOPS / 1024 TOPS |
| メモリ | HBM3 48GB, 1.5TB/s(オンチップSRAM 256MB) |
| インターコネクト | PCIe Gen5 x16 |
| TDP | 180W |
| フォームファクタ | PCIe dual-slot, full-height 3/4 length, passive cooling |
| 仮想化・セキュリティ | Multi-instance 8, SR-IOV 8 VF, ECC, secure boot |
製品構成はRNGD PCIeカードとNXT RNGDサーバー(2025年9月発売)の2つだ。NXTサーバーは8枚のカードを搭載した4Uサーバーで、FP8基準4 petaflops、HBM3合計384GB・合計帯域幅12TB/s、サーバー当たり3kWだ。15kWラックに5台を収容できるが、同じラックにNvidia DGX H100は1台(最大10.2kW)しか入らない。
ソフトウェアスタックはコンパイラ・ランタイム・モデル圧縮ツール・プロファイラ・サービングフレームワークで構成され、PyTorch 2.xと統合され、TensorFlow Lite・ONNXをサポートする。Kubernetes・コンテナ・SR-IOV環境もサポートする。
量産は2026年1月に開始された。TSMCから初の量産ロット4,000個を受け取り、パッケージング・カード形態で顧客供給を開始した(TheElec、2026年4月)。
第3世代は2026年5月に発表されたBroadcomとの共同開発パートナーシップが担う。Chipletベースのrack-scale AI inferenceプラットフォームで、2nm compute dieとHBM4/4Eの搭載が計画されている(二次ソース報道)。
Funding & Investors
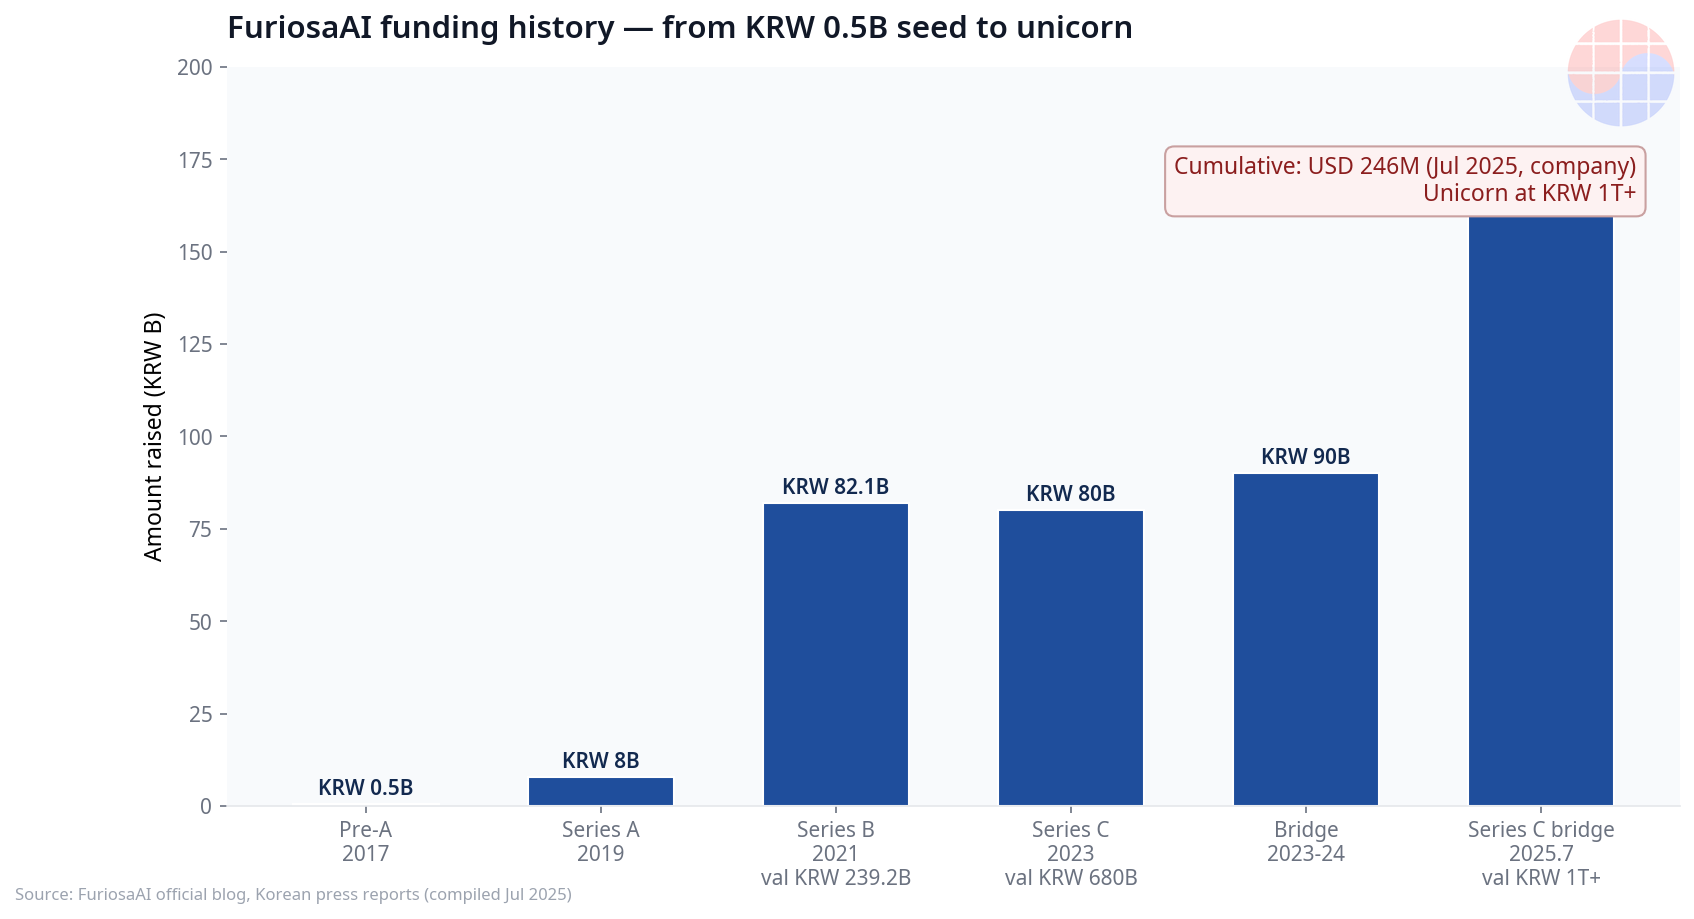
FuriosaAIの資金調達は8年にわたる段階的スケールアップの教科書だ。会社公式発表基準の累計調達額は$246M(2025年7月)だ。
| ラウンド | 時期 | 金額 | 主要投資家 | 企業価値 |
|---|---|---|---|---|
| Pre-A | 2017 | ₩0.5B | Naver D2SF | — |
| Series A | 2019 | ₩8B | Industrial Bank of Korea, DSC Investment | — |
| Series B | 2021 | ₩82.1B | DSC Investment, IMM Investment | ₩239.2B |
| Series C | 2023 | 約₩80B | Mubadala, Qatar Investment Authority | 約₩680B |
| Bridge | 2023–24 | 最大₩90B | Industrial Bank of Korea | — |
| Series C bridge | 2025.7 | ₩170B(約$125M) | KDB(₩30B)、Keistone(₩20B)、PI Partners、Kakao Investmentなど約40社の投資家 | ₩1T+(ユニコーン) |
2025年7月のSeries C bridge(₩170B、約$125M — 「$170M」ではなくウォン建て1,700億ウォンだ)調達で企業価値1兆ウォンを超え、ユニコーンとなった。現在は$300M〜$500M規模のpre-IPO/Series Dを募集中だ(Morgan Stanley・Mirae Asset Securities共同アドバイザー、企業価値₩2T〜₩3T想定、Bloomberg 2026年1月報道)。2026年5月にはNational Growth Fundの₩800B直接投資調達の報道が出たが、2026年10月現在クロージングの有無は確認されていない。
拒否された$800M
2025年2月にMetaの買収交渉報道が初めて出て、2025年3月24日、FuriosaAIは$800M(約1.1兆ウォン)提案を最終的に拒否した(Bloomberg報道)。決裂の理由は価格ではなく、買収後の事業方向と組織構造に対する意見の相違だった。業界の解釈としては、MetaがAI半導体市場参入自体よりも、自社AIサービス用カスタムチップ開発のための検証済みシステム・人材確保を狙ったという分析が出ている。拒否から4か月後、同社はユニコーンとなり、6か月後に量産を開始した。
Traction
2025〜2026年のFuriosaAIの顧客リストは、推論チップ・スタートアップとしては異例なほど強固だ。
- LG AI Research(2025年7月) — EXAONE LLM向けRNGD公式供給契約。数か月の評価を経て選定され、EXAONE 3.5モデルと企業向けAIエージェントChatExaoneに適用される。会社発表基準でGPUベースソリューション比inference performance per watt 2.25倍、同一電力ラック基準で3.75倍のトークン生成量だ。
- Samsung SDS(2026年10月) — Samsung Cloud PlatformでRNGDを提供するNPU-as-a-Service(韓国初)。ドンタンIDCにRNGDを配置し、1/2/4/8カード単位のon-demandインスタンスを提供する(供給は2026年7月から)。
- Equinix Lisbon(2026年7月) — 欧州初のRNGD商用配備。リスボンLS2データセンターにRNGDベースのAI inference hubを構築した。
- ストックホルム15MWプロジェクト(2026年8月) — Velox・I/ONX HPCとともに15MW級AI inferenceデータセンターを建設する。第1次2MW(2027年初頭稼働)にRNGD 1,800個、全体拡張時には8,800個以上が投入される。
- Kakao 'AI for Everyone'コンソーシアム(2026年8月) — 科学技術情報通信部選定プロジェクトのKakao主導コンソーシアムに参加する。
- Aramco — RNGDのテスト・サンプリング中(2024年12月報道)。中東進出の橋頭堡だ。
公開ベンチマーク数値(会社発表基準、独立検証ではない)は以下の通りだ。Nvidia H100比で最大3倍のinference performance per watt、RTX Pro 6000比で同一電力で7.4倍の同時ユーザー処理(Renegade Summit 2026.3)、データセンターTCO約40%削減、Llama 3.1 8B基準でカード当たり2,000〜3,000 TPSだ。
Moat Analysis — VLSI's View
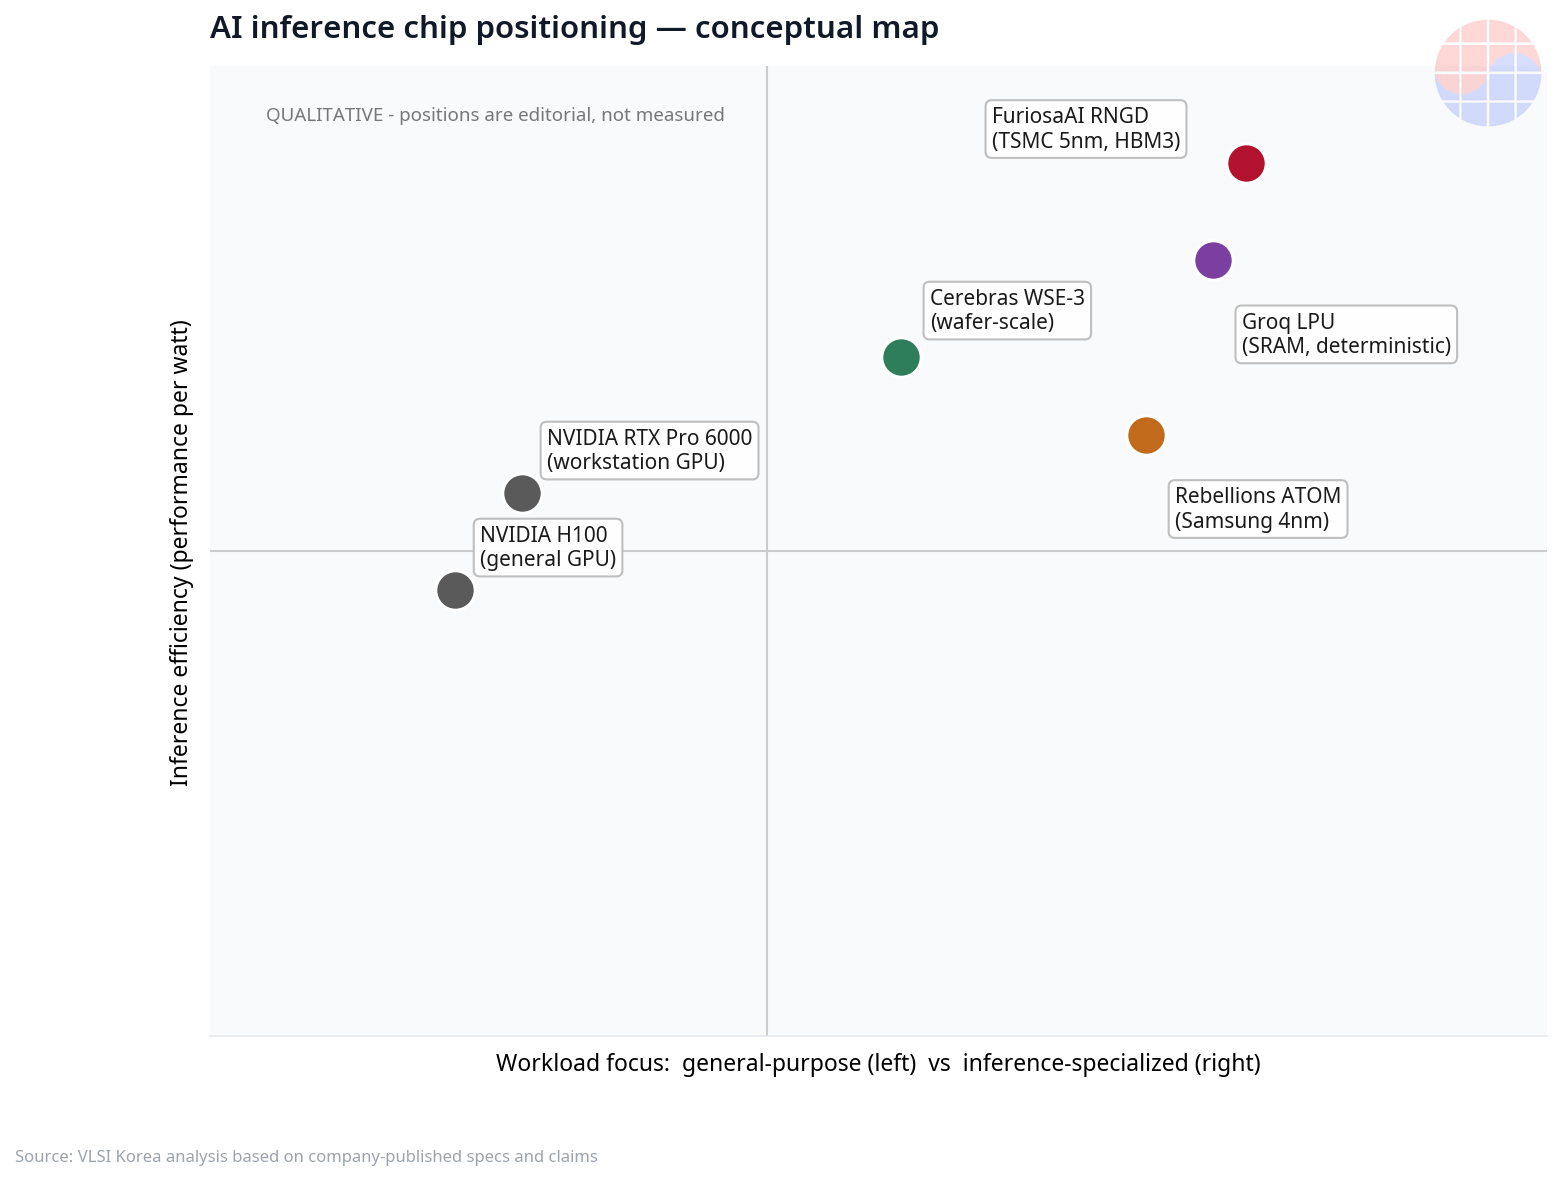
モート1 — アーキテクチャの学術的基盤。 TCPはマーケティングスローガンではなく、ISCA 2024論文で検証されたアーキテクチャだ。推論市場の勝負どころが学習ではなくdecoding段階のmemory-bound区間だという判断が設計の出発点だ。GroqがSRAM中心のdeterministicな路線を選んだのとは異なり、FuriosaAIはHBM3 48GBで70B級モデルを単一カードに載せる現実的な路線を選んだ。両路線とも有効だが、HBM路線は既存データセンターのメモリ拡張ロードマップと同じ方向を見ている。
モート2 — コンパイラが証明したソフトウェア。 MLPerf 2022で同一のWarboyシリコンからコンパイラ改善のみで2倍の性能を引き出した。推論はsoftware-definedなレースであり、同社はハードウェアチームと同じくらいソフトウェアチームが機能していることを数字で示した。STA・タイミングの観点で付け加えると、TSMC 5nm 1.0GHzにCoWoS-Sインターポーザ・HBM3 PHY(1.5TB/s)のtiming closureは容易なtape-outではない。Warboyのone-shot silicon successとGUCとのRNGD共同開発は実行力の証拠だ。
モート3 — ワット当たりトークンの経済学。 RNGDのTDPは180Wで、H100の350Wと比較される。June Paik CEOはRenegade Summit(2026年3月)で「2030年までに世界のAIデータセンターが100GW増設され、そのうち70%はinference用だ」と述べた。推論はワット当たりトークンのゲームであり、電力インフラがボトルネックの時代に180Wカードはラック設計の自由度を変える。
リスク — 売上高がバリュエーションに追いつかなければならない。 2024年の売上高は₩3B、純損失は₩152.2Bだった(公開届出書、Bloomberg引用)。₩1T+のバリュエーションは将来の売上高への賭けだ。NvidiaのCUDA・サプライチェーンのモートは依然として健在で、顧客もLG・Samsung SDSなど少数に集中している。pre-IPO $300M〜$500Mのクロージングも未確認だ。韓国国内ではRebellionsとの2強構図が形成されている — RebellionsはSamsung 4nm、Samsung・SKの投資を受け、2027年上半期のKOSPI上場を目指す。ただし推論市場は勝者総取りよりもワークロード別の分割市場になる可能性が高い。
Chase's Take。 私がこの会社に注目する理由は$800Mを断った度胸ではない。断った後4か月でユニコーンとなり、6か月でTSMCから量産ロットを受け取った実行力だ。多くのAIチップ・スタートアップがプレゼンテーションで止まる地点を、FuriosaAIはシリコンで通過した。今後見るべき指標は3つだ。ストックホルム8,800個のロットが実際の継続売上に転換するか、pre-IPOラウンドがクローズするか、そして2027〜2028年のIPO前に四半期売上高が軌道に乗るか。この3つが揃えば$800M拒否は伝説となり、1つでも外れれば高い授業料となる。
Verdict
Metaの$800Mを断る技術的根拠をシリコンで証明した稀有なケース — 今必要なのは売上高だ。
FAQ
FuriosaAIとはどのような会社ですか?
2017年にソウルで設立されたAI推論専用NPUファブレスだ。創業者兼CEO June Paik(AMD・サムスン電子出身)が率い、中核アーキテクチャはTensor Contraction Processor(TCP)だ。2025年7月に累計$246M調達でユニコーン(企業価値1兆ウォン以上)に上がった。
RNGDチップの主要スペックは何ですか?
TSMC 5nm・1.0GHzベースの第2世代推論チップで、FP8 512 TFLOPS・INT8 512 TOPS・INT4 1024 TOPS、HBM3 48GB(1.5TB/s)、TDP 180W、PCIe Gen5をサポートする。2024年8月にHot Chipsで公開され、2026年1月に量産を開始した。
Metaの$800M買収提案をなぜ断ったのですか?
2025年3月24日に最終的に拒否した(Bloomberg報道)。決裂の理由は価格ではなく、買収後の事業方向と組織構造に対する意見の相違だった。その後同社は独自成長路線を歩み、ユニコーン入りと量産開始を成し遂げた。
資金調達の現況とIPO計画はどうなっていますか?
2025年7月基準で累計$246Mを調達し、現在$300M〜$500M規模のpre-IPO/Series Dを募集中だ(企業価値₩2T〜₩3T想定)。IPO目標時期は2027〜2028年だ。
根拠の限界:本記事のperformance per watt・TCO・同時ユーザー比較数値は会社または顧客(LG AI Research)発表基準であり、独立して検証されたものではない。2026年のpre-IPOラウンドとNational Growth Fund投資案件は2026-10-18現在クロージングの有無が確認されていない。
主な出典: FuriosaAI公式ブログ(Series C bridge発表) · FuriosaAI開発者ドキュメント(RNGDスペック) · Pulse(ユニコーン報道) · Korea Herald(Renegade Summit) · Data Center Dynamics(Samsung SDS NPUaaS) · TheElec(量産ロット)


