 VLSI Korea
Tensordyne深掘り:乗算を加算に変えるLNS推論チップと約10億ドル評価額の実像
LNSで乗算を加算に変えるTensordyneのNapierチップと約10億ドルのバリュエーションを検証する。調達1億7,600万ドルは確認できるが、評価額は二次市場の推定と自社見積もりが根拠で、性能数値はすべてシミュレーションだ。


30秒要約
Tensordyneは、対数数体系(LNS、Logarithmic Number System)で乗算を加算に置き換え、AI推論のコストを下げようとする米国・ドイツ拠点のAIチップスタートアップである。2017年にRecogniとして創業し車載ビジョンチップを手がけた後、2025年9月にTensordyneへ社名変更し、データセンター推論へピボットした。2026年6月15日に発表した初のデータセンター向けチップNapier(TDN)は、TSMCの3nmプロセスノードでテープアウトを終え、ウェハー生産に入っている。同社は自社シミュレーション基準で、NVIDIA GB300 NVL72ラック比13倍の処理量(tokens per second)と17倍の電力効率(tokens per watt)を主張する。累計調達額は約1億7,600万ドル(1ドル=1,400ウォン換算で約2,464億ウォン)で、複数の報道で交差確認できる。一方、約10億ドルというバリュエーションは、一次発行ラウンドで開示されたpost-money価値ではない。二次取引プラットフォームの推定値(約9億9,200万ドル)と同社の自己見積もりが重なった数字で、独立検証はされていない。本稿の中心的な問いは一つだ。検証情報がこれほど少ない会社の価格を、どう読むべきか。
Background — 車載ビジョンからデータセンター推論へ
Tensordyneの起点は2017年9月、Recogniという名前だった。共同創業者はR.K. Anand(Chief Product Officer)とGilles Backhus(Head of AI)で、Emily Stuartも共同創業者として名を連ねる。AnandはSun MicrosystemsとJuniper Networksでキャリアを積んだ信号処理・ネットワーキングの専門家、Backhusはミュンヘン工科大学出身でスタンフォードで全二重無線の研究を行った。両者の共通項はプロセッサそのものより信号処理と通信に近い。この背景は、後に登場するcell-basedネットワークオンチップ(NoC)と低遅延ファブリック設計に再び現れる。
初期のRecogniは自動運転向けビジョン推論チップを狙った。2020年12月には1 PFLOP級のビジョン推論製品Scorpioを公開し、25W以下の消費電力と10ms以下の遅延を掲げた。しかし車載半導体は設計から売上までのサイクルが長く、物量はデータセンターと比べものにならない。2022年7月、元ZF Group幹部のMarc BolithoがCEOに就任した時期と重なり、同社は生成AI推論へ重心を移し始めた。
調達履歴は比較的明確に確認できる。2019年のSeries A 2,500万ドル、2021年のSeries B 4,890万ドルを経て、2024年2月20日にSeries C 1億200万ドルをCelesta CapitalとGreatPoint Venturesの共同リードでクローズした。既存投資家のMayfield、DNS Capital、BMW i Venturesに加え、新規のPledge Ventures、サウジ国富ファンド(PIF)傘下のTasaru Mobility Investmentsが参加し、HSBC Innovation Bankingがデットを提供した。Series C時点で同社はバリュエーションを公開していない。その後の拡張ラウンドはデータベースに記録があるが金額は非公開だ。2025年9月にTensordyneへ改称してピボットを公式化し、2026年6月にNapierを発表、Series Dを準備中としている。本社はカリフォルニア州Sunnyvale(初期はSan Jose表記)とドイツ・ミュンヘンにあり、従業員数は約120〜150人と報じられている。
価格の話の前に一つ明確にしておく。2026年10月現在、この会社について公開されている情報の大半は、会社発表、会社ホワイトペーパー、経営陣インタビューに由来する。独立ベンチマーク、顧客名義の導入事例、監査済み売上数値は公開されていない。本稿の性能数値はすべてこの前提で読む必要がある。
Business Deep Dive — LNSという数体系ベットの実体
核心のアイデア:乗算が加算になる
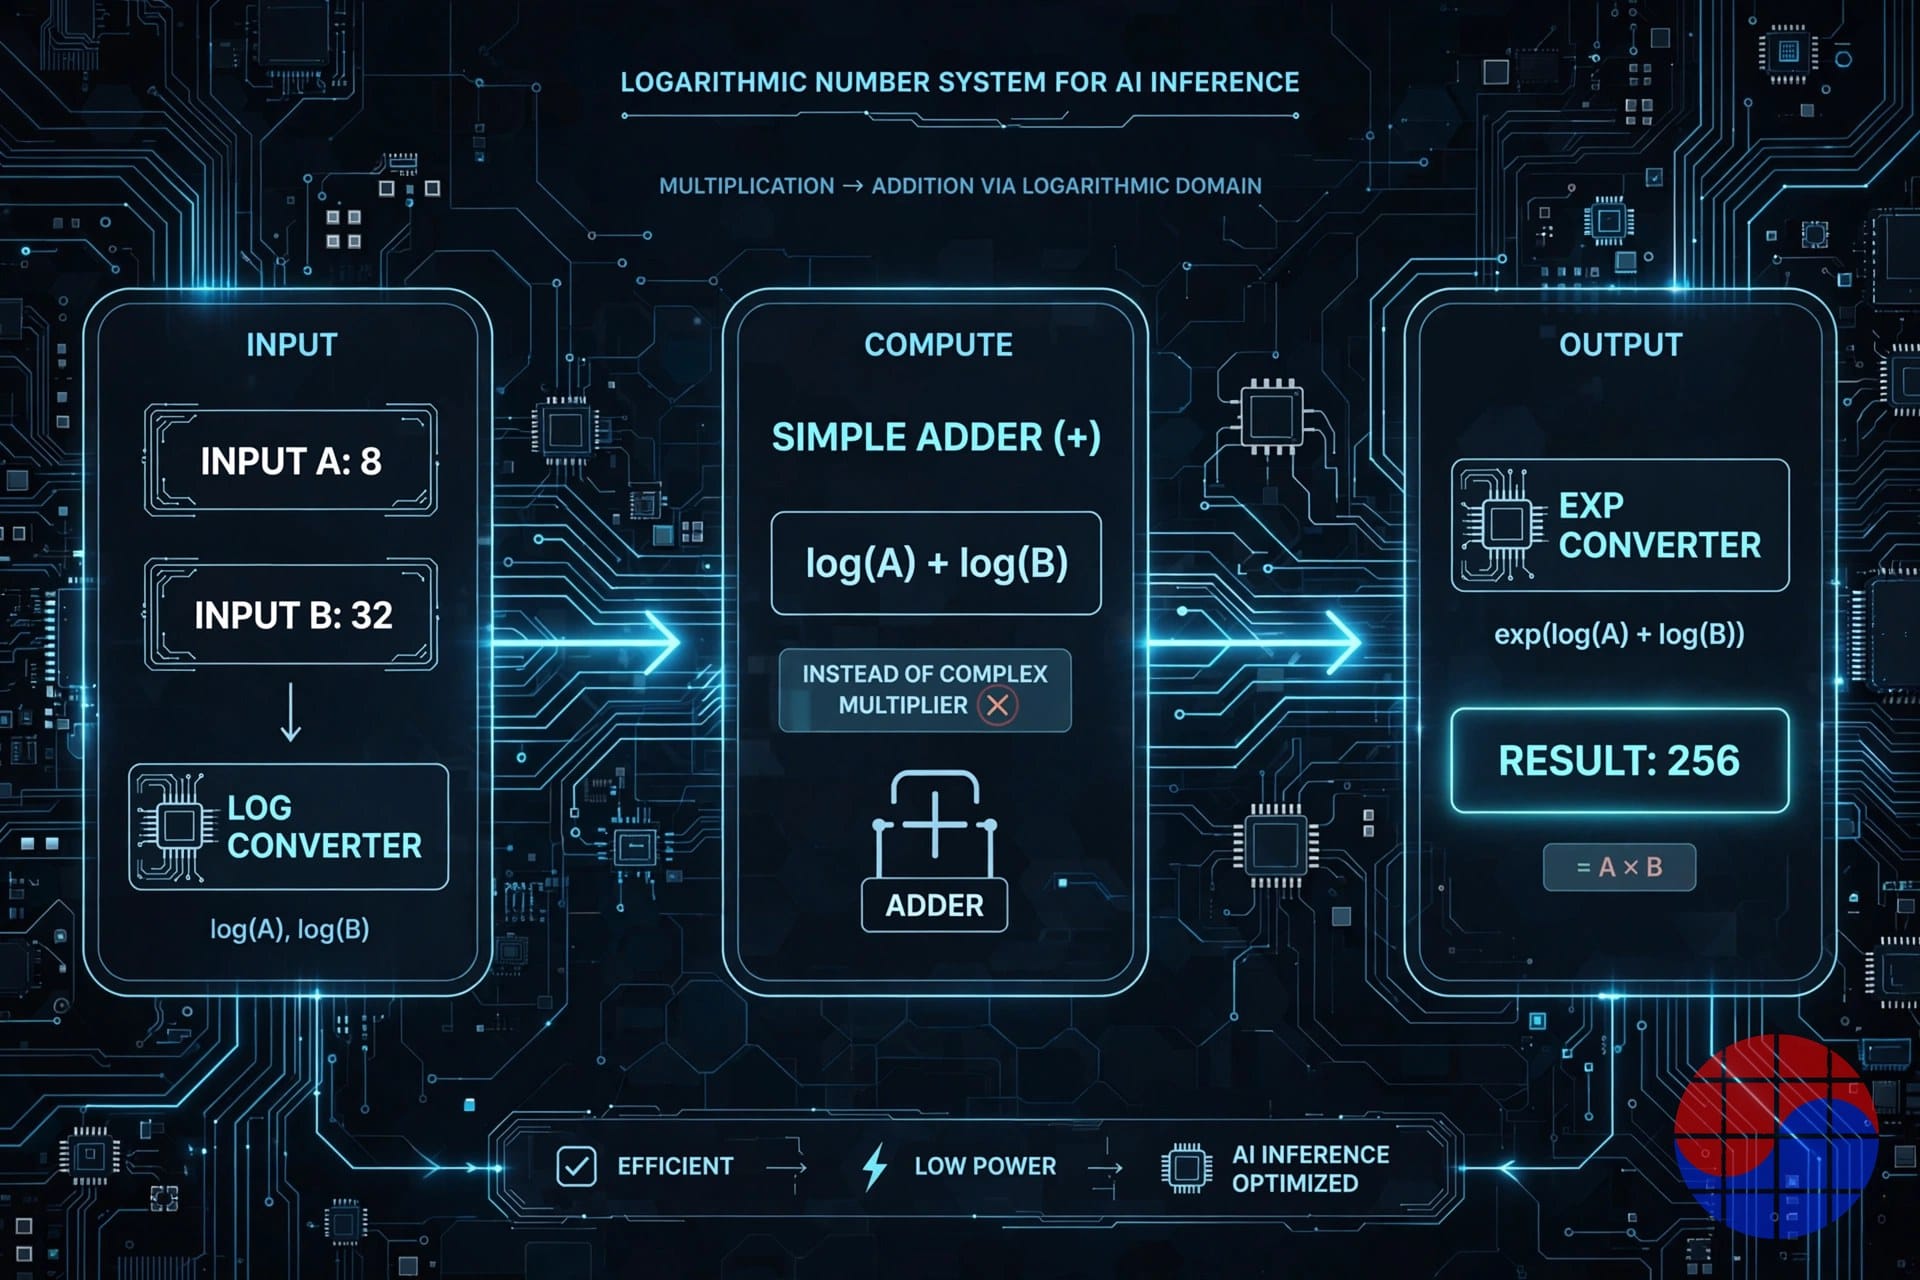
ニューラルネットワークの推論演算は大部分が行列乗算、すなわち乗算と累積加算(multiply-accumulate)の繰り返しだ。浮動小数点の乗算器は加算器よりシリコン面積もエネルギーもはるかに多く使う。LNSはこの乗算を迂回する。log(A×B)=log(A)+log(B)であるため、数値を対数領域へ一度変換しておけば乗算が加算に変わる。1614年にJohn Napierが天文計算を楽にするために作った対数表と同じ原理で、チップ名Napierもここに由来する。同社はこれを、すべての設計判断の下に敷かれる利得という意味で「zeroth scaling law」と呼ぶ。
同社が提示する回路レベルの数値はこうだ。同一プロセスで16-bit浮動小数点乗算が約1.1 pJと1,640 µm²を使うのに対し、対数方式は約0.05 pJと67 µm²で同じ処理を行うという。エネルギー約22倍、面積約25倍の差である。ただしシステムレベルに上がると利得は縮む。会社ホワイトペーパーの要約基準では、演算面積約3倍、演算電力約5倍の改善がシステム主張に近い。回路数値とシステム数値の間隔そのものが、このベットを読む最初の手がかりだ。ボトルネックは乗算器だけではないからである。
なぜLNSは40年以上主流にならなかったのか
LNSは新しいアイデアではない。学界で数十年研究されながら、専用ハードウェアとして製品化されたことは事実上なかった。理由は三つある。第一に、対数領域での加算が難しい。乗算は加算に変わるが、乗算結果を再び足し合わせる累積演算は対数領域で高コストな近似関数(Gaussian logarithm)を必要とする。第二に、線形領域と対数領域の間の変換オーバーヘッドと精度損失、特に0に近い値や小さな値の累積で生じる誤差が問題になる。第三に、推論ワークロードの相当部分は演算ではなくメモリ帯域幅に律速される(memory-bound)。乗算を安くしても、HBMからデータを持ってくるボトルネックは残る。
Tensordyneの知的財産(IP)の主張は、正確に第一の点にある。独自数体系Pareto(TDN Math)の核心は、対数領域の加算を効率的に近似する方式とそのハードウェア実装だという。同社は、再学習やキャリブレーションなしに既存モデルをそのまま載せられ、bit-accurateなエミュレーションで言語・MoE・画像・音声・ビデオのモデル全般で精度を検証したと述べる。ソフトウェアスタックが変換を隠し、PyTorchとTritonをサポートするという説明だ。この主張が正しければ、歴史的障壁の最大の一つを越えたことになる。ただし検証方法が社内エミュレーションである点、シリコンの実測結果がまだない点は切り分けて見る必要がある。
NapierチップとTDN72システム
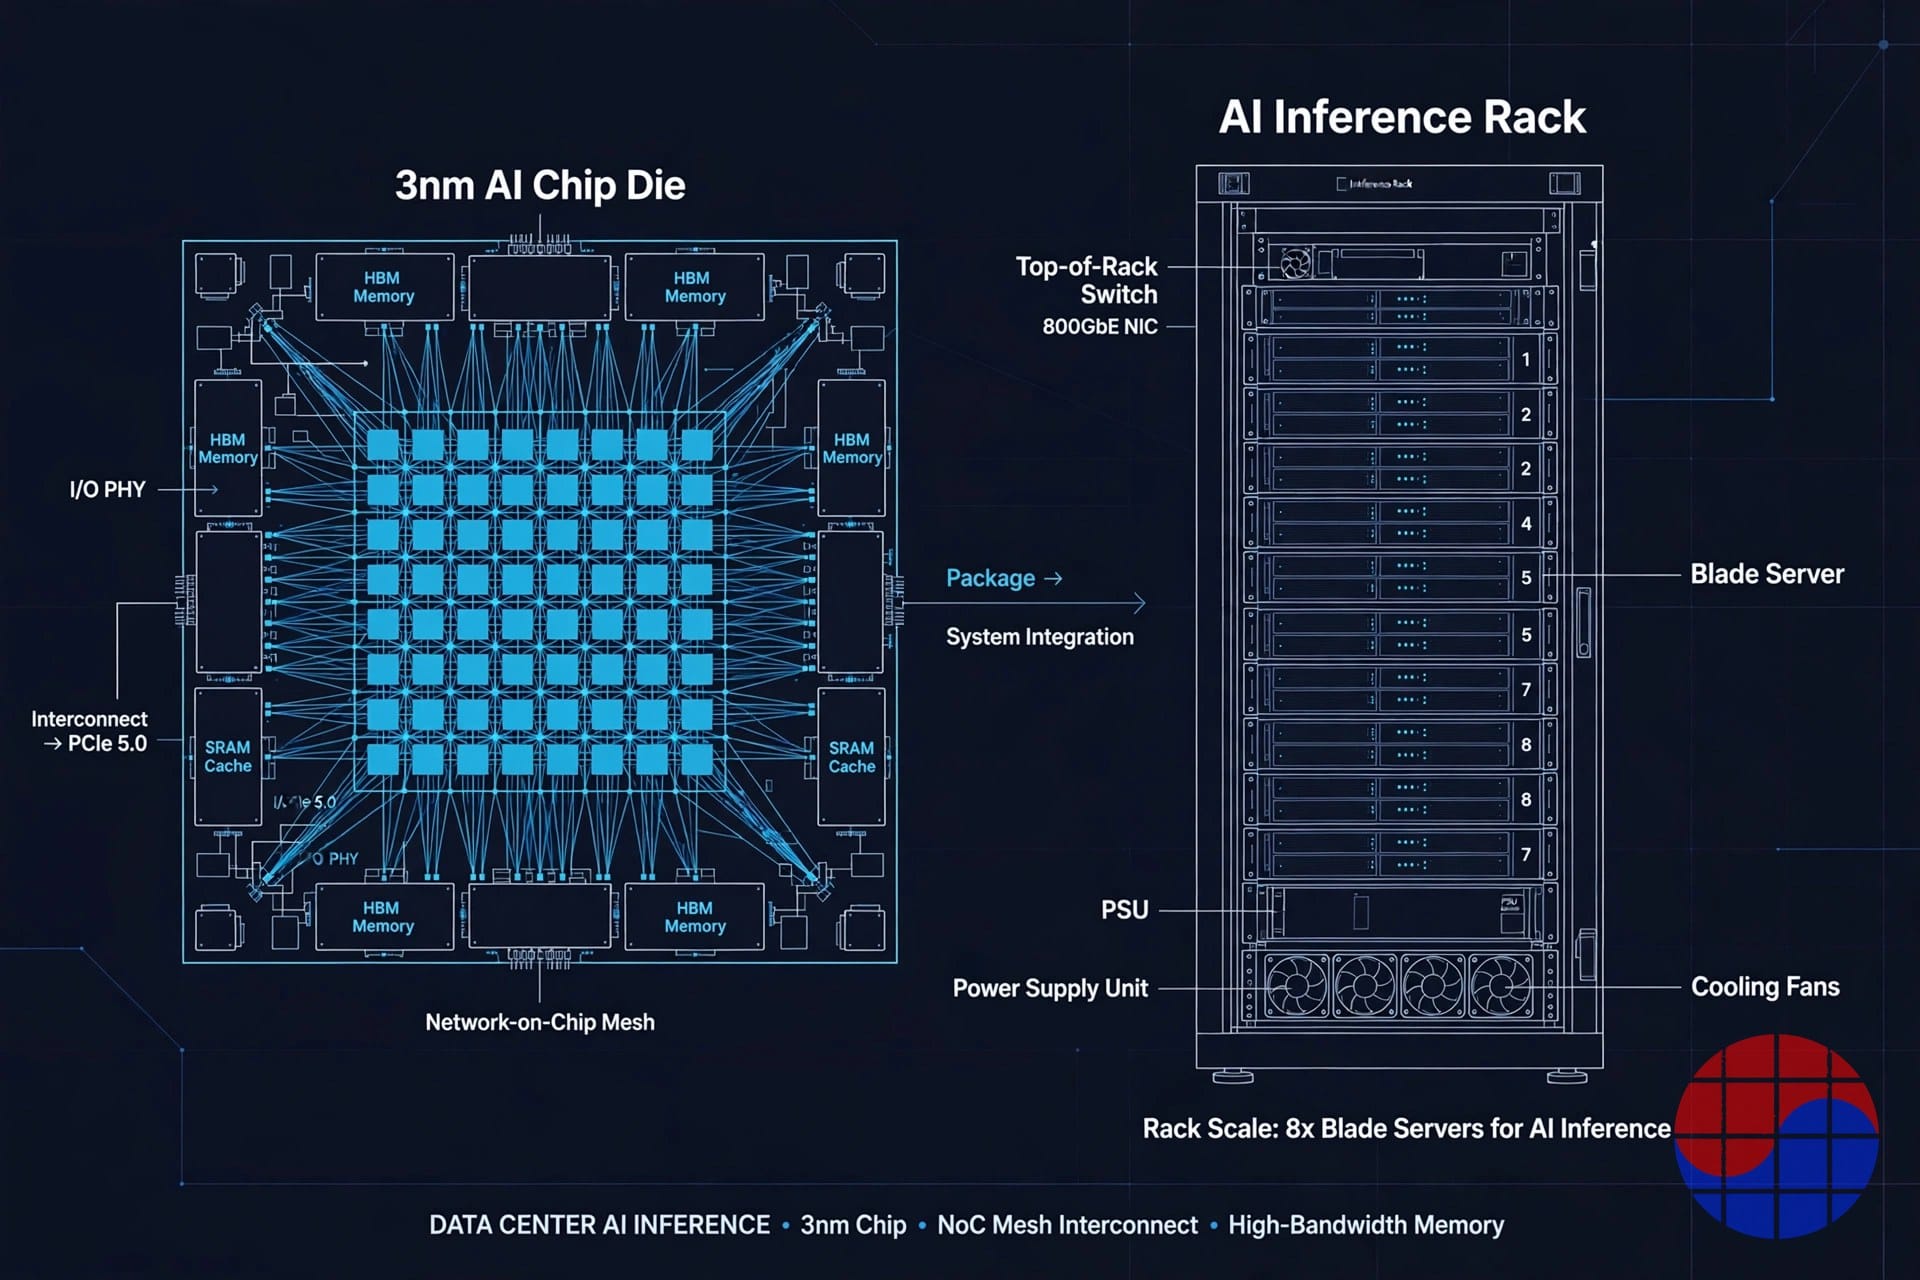
確認可能なハードウェア仕様は以下の通りだ。Napier(TDN AIP)はTSMC 3nm、138B(1,380億個)のトランジスタ、パッケージ当たり300W、dense FP8基準2.11 PFLOPS、256MBのSRAM、144GBのHBM3eを搭載する。演算コアは48個で、RISC-VコアがMoEルーティングのようなトークンループ内処理を担う。チップ間scale-upファブリックTDN LINKは単一ホップ遅延1µs未満を掲げ、72チップを一つのpodに束ねる。
| 項目 | Napier(会社発表) |
|---|---|
| プロセス | TSMC 3nm、テープアウト完了・ウェハー生産中 |
| 演算 | 2.11 PFLOPS dense FP8、300W |
| メモリ | 144GB HBM3e、256MB SRAM |
| TDN72 pod(72チップ) | 30kW、空冷、10.4TB HBM |
| フルラック(4 pods、288チップ) | 608 PFLOPS FP8、42TB HBM、120kW、空冷 |
パートナー構成は、この会社の数少ない強いシグナルだ。シリコン共同設計はBroadcom、製造はTSMC、scale-upシャーシとファブリックはHPE Juniperが担う。Juniperは投資家でもある。3nmのテープアウトと量産には数千万ドル単位のコストがかかり、BroadcomのようなASICパートナーの審査を通過する必要があるため、少なくとも「シリコンを作る能力と資金」に対する間接的な証拠としては読める。
性能主張とその性質
同社の代表的主張は、DeepSeek-R1ワークロード基準でラック当たり363,000 tokens/sec対NVIDIA GB300 NVL72ラックの27,400 tokens/sec、すなわち13倍だ。電力当たりでは1MW当たり300万tokens/sec対18万3,000で17倍を提示する。2兆パラメータMoEモデルでは自社ラック1台が競合の組み合わせ9ラック分の仕事をし、ユーザー当たり1,300 tokens/secを100万トークン当たり約11ドルで提供するのに対し、競合の組み合わせは約150ドルという比較も出した。これらの数値はすべて会社のモデリングとシミュレーションだ。比較基準の一部は公開ベンチマーク数値を用いたが、Tensordyne側の実測は存在しない。シリコンはようやくファブから出てくるところで、開発クラウドは2026年末、ベータシステムは2027年第1四半期、量産出荷は2027年下半期(一部報道では第2四半期)と予告されている。
顧客シグナル:LOIは売上ではない
商業的シグナルは「2億ドル以上の予想需要(forecasted demand)」という表現に集約される。同社は12社以上がベータ評価のための意向書(LOI)を出したと明かし、インフラ事業者2社の名前が挙がったことがある。しかしLOIは拘束力のある購買契約ではなく、有料の量産顧客と売上は公開されていない。AIチップスタートアップでLOIが実際の売上に転換する比率は歴史的に低い。このシグナルは「関心」としては読めても「需要確定」としては読めない。
Chase's Take — 市場はなぜこの価格を付けるのか
ここからが本題だ。約10億ドルという数字はどこから来たのか。確認した結果、このバリュエーションは新規投資ラウンドが決めた価格ではない。直近の大型ラウンドである2024年のSeries Cでも、同社はバリュエーションを公開していない。10億ドルに最も近い公開数値は、二次取引プラットフォームが算出した推定値約9億9,200万ドル(2026年10月時点)だ。二次市場の推定値は、実際の取引数件と気配をもとにした参考価格であり、機関投資家がデューデリジェンスの末に署名した価格ではない。そこに同社が次のラウンド(Series D)を前に提示する自己見積もりが重なると、「約1B」という数字が生まれる。性質の全く異なる二つの数字を区別することが、この会社を読む出発点だ。
ウォン換算では約1兆4,000億ウォン(1ドル=1,400ウォン)になる。累計調達額約2,464億ウォンの5.7倍に当たる。売上が公開されていないpre-revenueに近い会社がこの価格を受けるには、市場は実質的に三つのことに同時に賭けていることになる。第一に、LNSの精度の壁を実際に越えたこと。第二に、シミュレーション数値の半分だけでも実測で出れば推論コスト構造が変わること。第三に、2027年の出荷時点で推論市場が今よりはるかに大きくなり、電力ボトルネックが購買基準の中心に立つことだ。三つのうち一つでも外れれば、価格は速く再調整される。
公平に見れば、この賭けに根拠がないわけではない。推論コストに占める電力と冷却の比重は実際に大きくなっており、空冷で120kWラックを回せる点は液体冷却への転換負担が大きい既存データセンターに実質的な魅力だ。Broadcom・TSMC・HPE Juniperというパートナーの組み合わせも、紙の上の会社とは距離がある。逆にダウンサイドも明確だ。実測のない性能、売上のない商業段階、そして比較対象のNVIDIAも止まっていないという点だ。Napierが出荷される2027年下半期には、競合ラックも次世代へ移っている。13倍という格差は、今日のラックと明日のラックの比較ではなく、明日の自社ラックと今日の競合ラックの比較に近い数値だ。
私の判断はこうだ。Tensordyneは「数体系を変えれば推論コストの傾き自体が変わる」という、検証されれば産業構造を変える賭けである。しかし2026年10月現在、その賭けの証拠はシリコンではなくシミュレーションだ。したがってこの会社の価格は技術価格ではなくオプション価格として読むべきだ。実測データが出た瞬間に価値が階段状に上がるか下がるかする、二値(binary)に近い資産である。約10億ドルという数字を額面通りに信じる必要も、虚構と断定する必要もない。それは、Series Dで機関が実際にいくらに署名するのか、そして開発クラウドが開く2026年末に第三者がどんな数字を出すのかを待ちながら読む参考価格だ。
Implications — 何を見守るべきか
投資の観点:確認ポイントは三つだ。(1)Series Dの実際のpost-moneyバリュエーションとリード投資家が誰か、(2)2026年末の開発クラウドから出てくる独立測定値、特にtokens per wattとモデル精度の維持状況、(3)LOIが有料ベータと量産契約に転換するかどうかだ。この三つが確認されるまで、10億ドルは検証済みの価値ではなく市場が付けた期待値である。
産業の観点:Tensordyneの成否にかかわらず、この会社が投げかけた問いは残る。浮動小数点乗算という40年の慣行を数体系のレベルで揺さぶる試みが、大手パートナーと3nmテープアウトまで来たという事実自体が、推論時代の競争軸が「より大きなGPU」から「より安いトークン」へ移っていることを示している。LNSでなくとも、数体系と量子化を巡る競争は続くだろう。
韓国半導体の観点:Napier 1チップには144GBのHBM3eが入る。フルラック基準では42TBだ。こうした推論専用ASICが実際に物量を作り始めれば、HBM需要の軸はGPU一か所から多数のASICへ広がる。韓国のメモリ業界には顧客多角化の機会である一方、ASICごとに求めるメモリ仕様と認証手続きが変わる負担でもある。
資料の限界についての注記:本稿の会社情報は、2026年10月19日までに公開された会社発表・ホワイトペーパー要約・報道インタビューと取引データベースを交差確認したものである。性能数値はすべて会社の主張であり独立検証されておらず、バリュエーションは一次ラウンドの開示値ではない。確認できなかった売上・顧客・受注数値は本文に載せていない。
FAQ
Tensordyneのバリュエーション10億ドルは確定した数値か?
否。2024年のSeries Cを含め、同社はどのラウンドでもバリュエーションを開示していない。約10億ドルは二次取引プラットフォームの推定値(約9億9,200万ドル、2026年10月)と会社の自己見積もりが根拠の参考価格であり、機関のデューデリジェンスを経た一次ラウンドのpost-money価値とは性質が異なる。確定かどうかはSeries Dの開示で判断すべきだ。
LNS(対数数体系)はなぜ今になってチップ化されるのか?
原理自体は古いが、対数領域での加算の近似と変換精度が壁だった。乗算は安い加算に変わる一方、乗算結果を再び加える累積演算と0近傍の値の処理が高コストで不正確だった。Tensordyneは独自数体系Paretoの近似方式がこの壁を越えたと主張するが、根拠は社内エミュレーションであり、シリコン実測はまだ公開されていない。
Napierの13倍・17倍という性能主張は信じられるか?
現時点では会社のシミュレーション数値としてのみ扱うべきだ。13倍の処理量と17倍の電力効率はDeepSeek-R1基準の会社モデリング結果であり、チップがファブで生産中の段階のため独立測定値はない。開発クラウドが予告された2026年末以降に第三者の測定値が出るかどうかが最初の検証ポイントだ。
Tensordyneの製品はいつ買えるのか?
会社の日程では、開発クラウドが2026年末、ベータシステムが2027年第1四半期、量産出荷が2027年下半期だ。現在確認できる商業シグナルは、12社以上の評価意向書(LOI)と2億ドル以上の予想需要という会社発表のみで、拘束力のある量産契約と売上は公開されていない。
📩 VLSI Korea ニュースレター
毎日配信の半導体ディープダイブを、メールでいち早くお届けします。購読は無料です。


