VLSI Korea
d-Matrix 기업가치 20억 달러 해부 — SRAM 안에서 연산하는 Corsair와 3DIMC의 베팅
d-Matrix는 2025년 11월 Series C 2억 7,500만 달러를 기업가치 20억 달러에 마감했다. SRAM 내부에서 연산하는 DIMC 아키텍처 Corsair는 왜 이 가격을 받는가. 대역폭의 물리, SRAM 공정 경제학, Raptor 3DIMC 로드맵과 20억 달러가 성립할 조건을 해부한다.


30초 요약
d-Matrix의 기업가치 20억 달러(약 2조 8,000억 원, 1달러=1,400원 기준)는 추론 경제학이 부족한 단 하나, 칩 밖으로 나가지 않는 메모리 대역폭을 사기 때문이다. 미국 샌타클래라의 스타트업 d-Matrix는 2025년 11월 12일 2억 7,500만 달러 규모의 Series C를 기업가치 20억 달러에 종결했고, 누적 조달액은 4억 5,000만 달러가 됐다. 주력 가속기 Corsair는 SRAM 내부에서 연산하는 Digital In-Memory Computing(DIMC) 구조로 카드당 150TB/s의 온칩 대역폭, Llama 70B 기준 초당 30,000토큰·토큰당 2ms를 주장하며, GPU 기반 시스템 대비 에너지 효율 3~5배를 내세운다. Corsair는 2026년 6월 양산에 들어갔다. 20억 달러는 오늘의 매출에 대한 대가가 아니다. 추론이 AI 비용의 중심이 될 때 승자 아키텍처는 산술이 아니라 메모리를 제품으로 삼는 쪽이라는 옵션에 대한 대가다.
| 항목 | 내용 |
|---|---|
| 기업가치 | $2B (Series C, 2025-11-12) |
| 누적 조달 | $450M |
| 제품 | Corsair (DIMC, TSMC 6nm) |
| 연산 성능 | 2,400 TFLOPS (8-bit) |
| 온칩 메모리 | 2GB SRAM, 150 TB/s |
| 오프칩 메모리 | 최대 256GB LPDDR5 |
| 차세대 | Raptor / 3DIMC (2026년 말 테이프아웃 목표) |
Background: AI의 후반전을 위해 설립된 회사
d-Matrix는 2019년 미국 캘리포니아주 샌타클래라에서 Sid Sheth(CEO)와 Sudeep Bhoja(CTO)가 설립했다. 창립 베팅은 당시에는 비주류였다. 학습(training)이 AI의 병목으로 남지 않으리라는 판단이다. 모델은 한 번 학습되지만, 질문에는 유료 사용자를 상대로 계속, 대규모로 답해야 한다. 그 서빙 단계인 추론(inference)이 업계 최대 비용이 될 것이라는 전망 아래, 회사는 시장이 동의하기 6년 전부터 그 단계를 위한 실리콘을 만들어 왔다.
조달 이력은 이 가설에 동조자가 늘어 온 궤적이다. 2023년 1억 1,000만 달러 라운드에서 Microsoft의 벤처 펀드 M12가 들어왔다. 2025년 11월 Series C는 BullhoundCapital, Triatomic Capital, Temasek이 공동 주도했고, 카타르투자청(QIA)과 싱가포르 EDBI가 신규로 참여했으며, M12, Nautilus Venture Partners, Industry Ventures, 미래에셋이 후속 투자했다. 누적 조달 4억 5,000만 달러, 인력은 샌타클래라·토론토·시드니·벵갈루루·베오그라드에서 250명을 넘겼다.
시점도 중요하다. 2025년 말 하이퍼스케일러들은 capex의 무게중심을 학습 클러스터에서 추론 플릿으로 옮기고 있었고, 업계의 질문은 "얼마나 빨리 학습하는가"에서 "토큰 하나의 원가가 얼마인가"로 바뀌었다. d-Matrix는 첫날부터 두 번째 질문을 위해 설계한 몇 안 되는 스타트업이다. 양산 전 단계 칩 회사의 20억 달러 밸류에이션은 이 배경 위에서 읽어야 한다.
Business Deep Dive
제품: 가중치가 있는 자리에서 연산한다
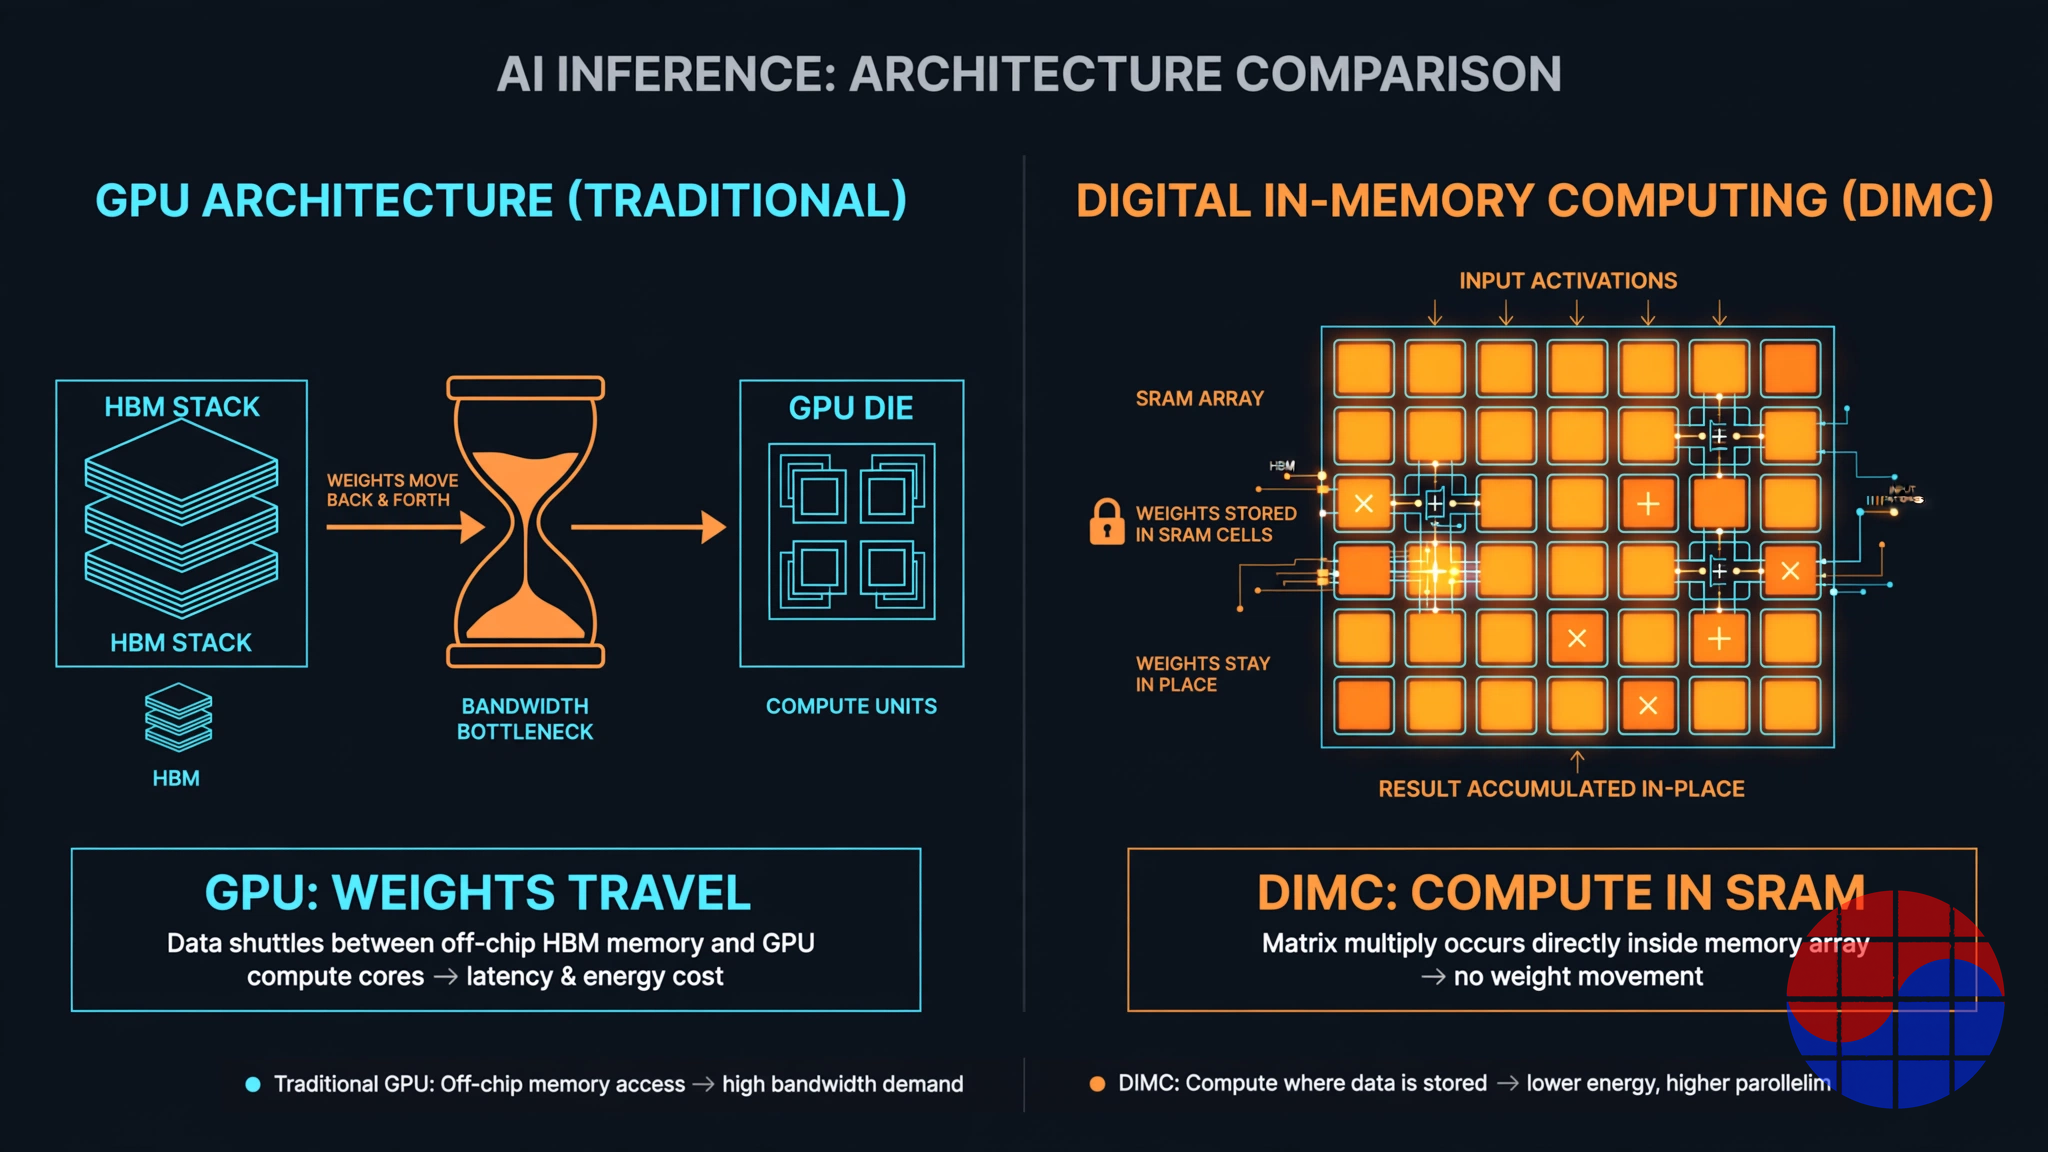
디코드 단계 추론은 메모리 바운드다. 토큰을 하나 생성할 때마다 모델 가중치를 읽어야 하고, GPU는 그 가중치를 HBM 스택과 연산 유닛 사이에서 오가게 하는 데 시간과 전력의 상당 부분을 쓴다. Corsair는 이동 자체를 공격한다. DIMC 코어는 SRAM 어레이 내부에서 행렬 연산을 수행한다. 가중치가 연산을 위해 어딘가로 실려 가는 것이 아니라, 앉아 있는 자리에서 계산된다.
양산 카드의 수치가 트레이드오프를 정의한다. TSMC 6nm 공정, 표준 PCIe Gen5 폼팩터의 Corsair 카드는 8-bit 피크 연산 2,400 TFLOPS, 150TB/s로 동작하는 2GB 온칩 Performance Memory(SRAM), 최대 256GB의 오프칩 LPDDR5 Capacity Memory를 제공한다. 대역폭을 HBM과 비교하면, 최신 HBM3e 스택은 개당 약 1.2TB/s, GPU 패키지 전체로 합산해도 8TB/s 수준이다. Corsair의 150TB/s는 패키지 대역폭이 아닌 온칩 SRAM 대역폭이라 성격이 다른 수치이고, 이 비교는 d-Matrix에 유리하게 기울어 있다. 그러나 방향은 실재한다. 작은 배치·지연 민감 디코드에서는 가중치를 SRAM에 두는 것만으로 GPU 토큰 지연을 지배하는 왕복을 제거할 수 있다.
Series C 자금이 실제로 사는 것은 칩 주변의 플랫폼이다. JetStream NIC는 카드와 랙을 저지연으로 연결한다. Aviator 소프트웨어 스택은 PyTorch와 Triton으로 작성된 모델을 DIMC 패브릭에 컴파일한다. Arista, Broadcom, Supermicro와 함께 만든 레퍼런스 랙 아키텍처 SquadRack은 카드를 배포 가능한 시스템으로 묶고, 2026년 10월 정식 출시가 발표된 Squadron 클러스터는 표준 공랭 데이터센터에서 16개 랙·최대 1,024개의 Corsair XPU까지 확장된다. Corsair는 2026년 6월 양산에 들어갔고, 물량은 하이퍼스케일러·네오클라우드·프런티어 AI 랩을 우선 대상으로 한다. 2026년 4월에는 GigaIO의 데이터센터 사업을 인수해 FabreX 메모리 패브릭과 SuperNODE 시스템 설계도 확보했다.
폼팩터 선택 자체가 GTM 전략이다. Corsair는 액체 냉각이 필요한 전용 랙이 아니라 표준 PCIe 카드와 공랭 랙으로 기존 데이터센터에 그대로 들어가도록 설계됐다. 하이퍼스케일러의 신규 홀에서는 사소한 조건이지만, 엔터프라이즈와 소버린 고객에게는 도입 여부를 가르는 조건이다. 전력과 냉각을 새로 공사하지 않고 추론 용량을 얹을 수 있다는 점이, d-Matrix가 말하는 '데이터센터 1곳으로 10곳의 일을 한다'는 효율 주장과 별개로, 영업 현장에서 작동하는 실질적 차별점이다. 칩 스타트업의 실패 원인이 대개 성능이 아니라 도입 마찰이라는 점을 감안하면, 이 설계 선택은 스펙표만큼 중요하다.
SRAM의 천장, 그리고 Raptor가 존재하는 이유
이 아키텍처의 강점은 곧 천장이다. SRAM은 빠르고 비트당 가격이 비싸다. Corsair의 Performance Memory 2GB로는 70B 모델을 담을 수 없고, 나머지는 LPDDR5 Capacity Memory에 있으며, 실제 성능은 Aviator가 두 계층 사이에서 작업을 얼마나 영리하게 타일링하느냐에 달려 있다. SRAM은 로직처럼 축소되지도 않는다. 첨단 노드에서도 밀도 개선이 느려, 순수 SRAM 로드맵은 세대마다 토큰 생성 용량당 원가가 오르는 구조다. 모든 인메모리 컴퓨팅 스타트업이 답해야 하는 공정 경제학의 질문이 이것이다.
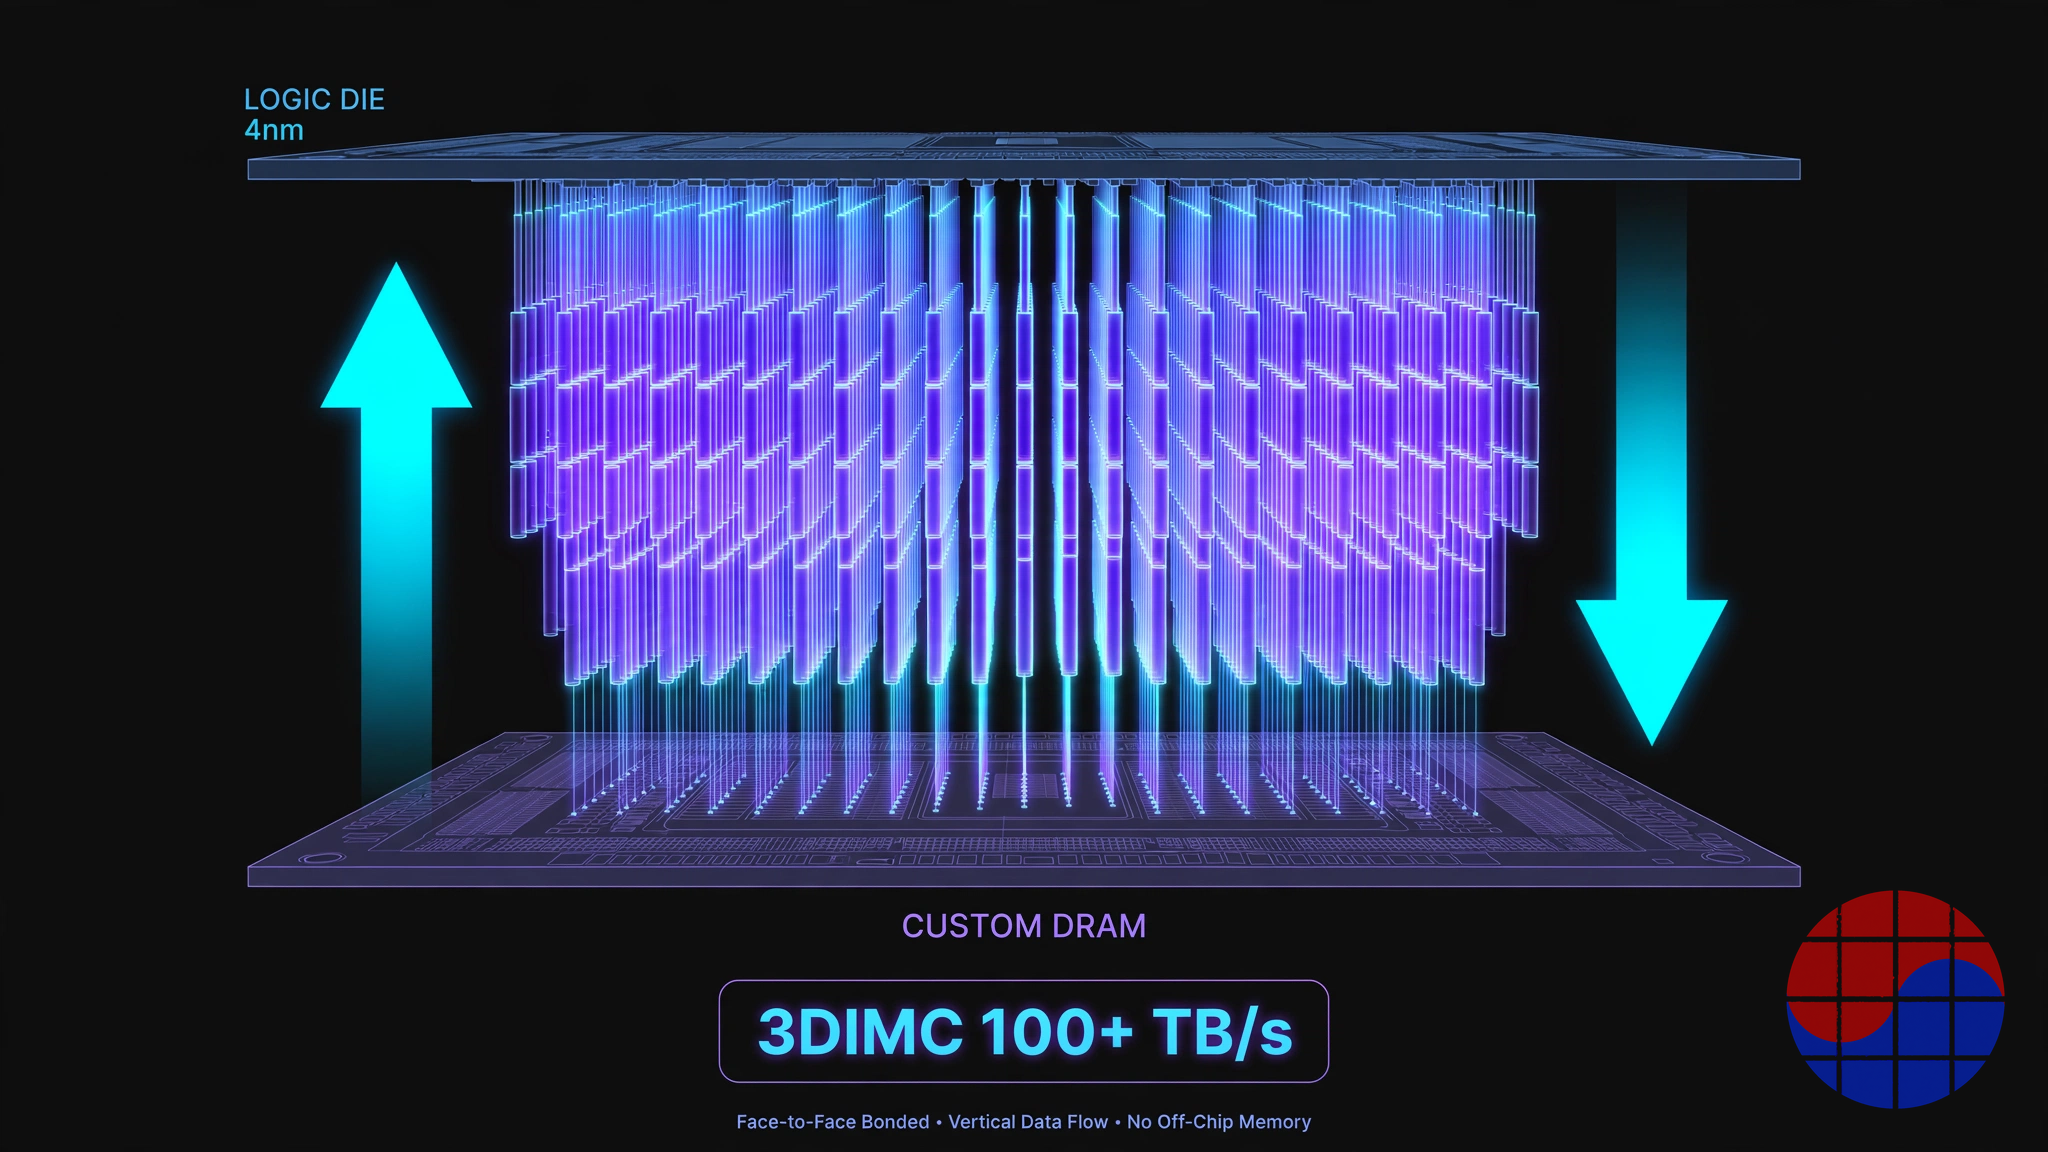
d-Matrix의 답은 3DIMC, 차세대 Raptor 플랫폼이다. 2025년 11월 Alchip과 함께 Pavehawk 테스트 차량으로 공개된 Raptor는 TSMC 4nm 로직 다이를 36마이크론 피치로 커스텀 DRAM 다이에 face-to-face 본딩한다. 회사는 가속기당 100TB/s 이상의 대역폭과 32GB(256Gb)의 적층 메모리, 0.37pJ/bit를 전망하고, 2026년 공개된 초기 실리콘 결과에서는 HBM 기반 구성 대비 가속기당 추론 처리량이 약 4.7배라고 보고했다. Raptor는 2026년 말 테이프아웃, 2027년 4분기 랙 공급이 목표다. 2026년 9월 d-Matrix는 NVIDIA의 NVLink Fusion 생태계에 합류해, Raptor XPU가 GPU를 통째로 교체하라고 요구하는 대신 NVIDIA MGX 랙 안에 꽂히도록 설계됐다.
20억 달러가 성립하려면 무엇이 참이어야 하는가
이야기를 산술로 벗겨 보자. 매출이 본격화되기 전, 누적 조달 4억 5,000만 달러 위에 선 20억 달러 밸류에이션은 d-Matrix를 부품 업체가 아닌 미래의 플랫폼 사업자로 가격 매긴 것이다. 세 가지가 성립해야 한다. 첫째, 추론 지출이 계속 복리로 성장해, 전용 디코드 레이어가 GPU와 별도의 예산 항목이 되어야 한다. 둘째, Corsair가 주장하는 경제성 — 상호작용 속도 10배, TCO당 성능 3배, 에너지 효율 3~5배, 모두 회사 발표 수치 — 이 Llama 벤치마크가 아니라 실명을 밝힌 고객의 프로덕션 워크로드에서 버텨야 한다. 셋째, 소프트웨어 해자가 형성되어야 한다. NVIDIA나 AMD, 혹은 하이퍼스케일러 자체 ASIC 팀이 '충분히 좋은' 답을 내놓을 때 고객이 하드웨어를 교체 가능한 상품으로 취급하지 않을 만큼 Aviator가 sticky해져야 한다.
지금까지의 트랙션 증거는 실재하지만 불완전하다. 양산 진입, Supermicro가 만드는 랙 라인, 시스템 패브릭을 더한 인수, Temasek·QIA·EDBI 같은 국부펀드 중심 투자자 구성은 모두 정교한 매수자들이 실사를 하고 남아 있다는 신호다. 아직 없는 것은 칩 스타트업의 가격을 궁극적으로 정하는 증거, 즉 실명 하이퍼스케일러의 프로덕션 배포 공개와 재주문이다. 2026년 7월 더 높은 밸류에이션으로 추가 조달을 추진한다는 보도와 NVIDIA의 투자 검토 보도는 확인되지 않은 reported 수준으로 취급해야 한다.
다운사이드: HBM 진영의 반격과 소프트웨어라는 세금
약세 논거는 두 갈래다. 첫째는 물리와 로드맵이다. HBM은 멈춰 있지 않다. HBM4는 스택당 인터페이스를 2,048bit로 넓히고, GPU 업체들은 더 큰 SRAM, 더 빠른 인터커넥트, 추론 최적화 SKU를 자사 라인업에 통합하고 있다. 세대마다 별도 가속기를 정당화하는 지연 격차는 좁혀지고, GPU 진영은 학습과 추론을 하나의 소프트웨어 스택으로 제공한다. 둘째는 도입 세금이다. CUDA가 아닌 모든 플랫폼은 고객에게 모델 포팅, 젊은 컴파일러에 대한 신뢰, 스타트업의 재무 상태에 대한 벤더 리스크를 요구한다. d-Matrix는 이종(heterogeneous) 포지셔닝으로 이를 완화한다. NVLink Fusion 합류와 Attention-FFN Disaggregation(AFD) 시연이 그 형태다. AFD는 attention을 GPU에, feed-forward 레이어를 Corsair XPU에 나눠 동시 사용자 64명에서 사용자당 초당 845토큰을 보였다. 완화는 제거가 아니다. 이 세금은 매 영업 사이클마다 치러진다.
Chase's Take
대부분의 AI 칩 스타트업은 더 빠른 엔진을 판다. d-Matrix는 다른 회계 항등식을 판다. 디코드 추론에서 초당 토큰 수는 대략 대역폭을 모델 크기로 나눈 값이다. 대역폭을 소유한 회사가 마진을 소유한다. 인메모리 컴퓨팅을 아날로그가 아닌 디지털로 구현한 선택은 조용히 옳았다. 아날로그 IMC는 데모에서는 아름답고 캘리브레이션에서는 무너지지만, DIMC는 SRAM의 결정성을 유지하고 공정 이전에도 버틴다. 정직한 질문은 물리가 동작하느냐가 아니다. Pavehawk와 2026년 실리콘 결과가 동작한다고 말한다. 질문은 SRAM 경제학과 젊은 소프트웨어 스택이, 이미 산 GPU 랙에 답을 번들로 끼워 넣을 수 있는 incumbent 앞에서 방어 가능한 레이어를 유지할 수 있느냐다. NVLink Fusion 결정은 경영진이 이를 이해하고 있음을 보여준다. d-Matrix는 NVIDIA의 랙을 이기려는 것이 아니라, 그 랙 안의 한 항목(line item)이 되려 한다. 20억 달러에서 투자자들은 그 결과를 사는 것이 아니다. 아직 빠진 두 가지 증명, 즉 실명 프로덕션 규모와 Raptor의 일정 준수를 Series C 자금으로 사는 확률 가중 경로를 사는 것이다.
Implications
하이퍼스케일러와 네오클라우드에게: Corsair급 가속기는 추론을 이종 설계 문제로 바꾼다. 조달의 질문은 "어떤 GPU인가"에서 "어떤 레이어를 어디서 돌리는가"로 이동하고, AFD식 분해는 실험이 아니라 용량 계획의 규율이 된다.
메모리 업계에게: d-Matrix는 경고가 붙은 수요 신호다. 현재 제품은 SRAM과 LPDDR5로 HBM을 우회하고, Raptor의 커스텀 적층 DRAM은 장기전의 본질이 'HBM 대 무(無)'가 아니라 '표준 HBM 대 특정 연산 다이에 맞춰 설계된 메모리'임을 시사한다. 가속기 스타트업과 스택을 공동 설계하는 메모리 업체는 GPU 양강이 통제하지 않는 채널을 얻는다.
투자자에게: 20억 달러라는 가격은 두 개의 관찰 가능한 사건으로 다시 매겨질 것이다. Corsair의 첫 실명·반복 하이퍼스케일 배포, 그리고 2026년 말 Raptor 테이프아웃이다. 그전까지 이 밸류에이션은 벤치마크 주장과 투자자의 질에 기대어 있다. 강한 신호이지만, 신호는 현금흐름이 아니다.
FAQ
d-Matrix는 무엇을 하는 회사인가?
d-Matrix는 AI 추론 전용 데이터센터 가속기를 만든다. Corsair 플랫폼은 SRAM 내부에서 연산하는 Digital In-Memory Computing(DIMC)에 JetStream 네트워킹과 Aviator 소프트웨어 스택을 결합해, 모델 학습이 아닌 저지연·고효율 토큰 생성을 겨냥한다.
d-Matrix의 기업가치가 20억 달러인 이유는?
20억 달러 밸류에이션은 2025년 11월 12일 종결된 2억 7,500만 달러 Series C에서 정해졌다. BullhoundCapital, Triatomic Capital, Temasek이 공동 주도하고 QIA, EDBI, Microsoft의 M12가 참여했다. 투자자들은 추론이 AI 인프라 최대 비용이 되고, 메모리 중심 아키텍처가 그 비용의 지속 가능한 몫을 차지한다는 기대를 가격에 반영한 것이다.
Corsair는 GPU와 무엇이 다른가?
GPU는 토큰마다 HBM에서 모델 가중치를 읽어 오며, 패키지 대역폭은 8TB/s 수준이다. Corsair는 자주 쓰는 가중치를 온칩 SRAM에 두고 메모리 어레이 안에서 연산해 카드당 150TB/s의 온칩 대역폭에 도달한다. GPU가 가장 비효율적인 작은 배치·저지연 디코드 워크로드를 겨냥한 설계다. 카드당 SRAM Performance Memory 2GB와 최대 256GB의 LPDDR5 Capacity Memory를 갖췄다.
3DIMC와 Raptor란 무엇인가?
3DIMC는 d-Matrix 인메모리 아키텍처의 3D 적층 진화형이다. Raptor 플랫폼은 4nm 로직 다이를 커스텀 DRAM 다이에 face-to-face 본딩해 가속기당 100TB/s 이상의 대역폭과 32GB(256Gb) 메모리를 전망한다. Raptor는 2026년 말 테이프아웃, 2027년 4분기 랙 공급이 목표이며 NVIDIA NVLink Fusion 랙과의 통합도 포함된다.
주: 성능·효율 수치(상호작용 10배, TCO당 성능 3배, 에너지 효율 3~5배, 150TB/s)는 본문에 표기한 날짜 기준 회사 발표 수치다. 20억 달러 기업가치는 2025년 11월 Series C 발표의 보고된 post-money 수치다. 원화 환산은 1달러=1,400원을 적용했다.
📩 VLSI Korea 뉴스레터 구독하기
매일 발행되는 반도체 심층 분석을 이메일로 가장 먼저 받아보세요. 구독은 무료입니다.