VLSI Korea
DRAM 안에서 계산해도 데이터 재배치가 느리면 진다
메모리 내부 연산의 성능은 산술 회로만으로 결정되지 않는다. RAPID 연구를 출발점으로, 데이터 배치와 CPU 왕복 비용이 PIM의 승패를 바꾸는 조건을 따진다.


DRAM 내부의 계산이 빨라도, CPU가 읽을 수 있는 형태로 데이터를 되돌리는 시간이 길면 응용 프로그램은 느려진다. 연산 위치를 옮기는 것과 데이터 이동을 없애는 것은 서로 다른 설계 과제다.
2026-10-01 제출된 RAPID 프리프린트는 이 간극을 겨냥한다. 저자들은 DDR4 구성에서 SIMDRAM 대비 5.9배의 성능을 보고하지만, 같은 논문의 메모리 내부 연산만 비교하면 SIMDRAM의 처리량이 더 높다. 차이를 만드는 핵심은 비교에 포함한 데이터 전치 비용이다. RAPID, §VI–VII
VLSI Korea view: PIM을 평가할 때의 단위는 명령 하나가 아니라, 호스트가 입력을 넘긴 시점부터 다음 연산이 결과를 사용할 수 있는 시점까지다.
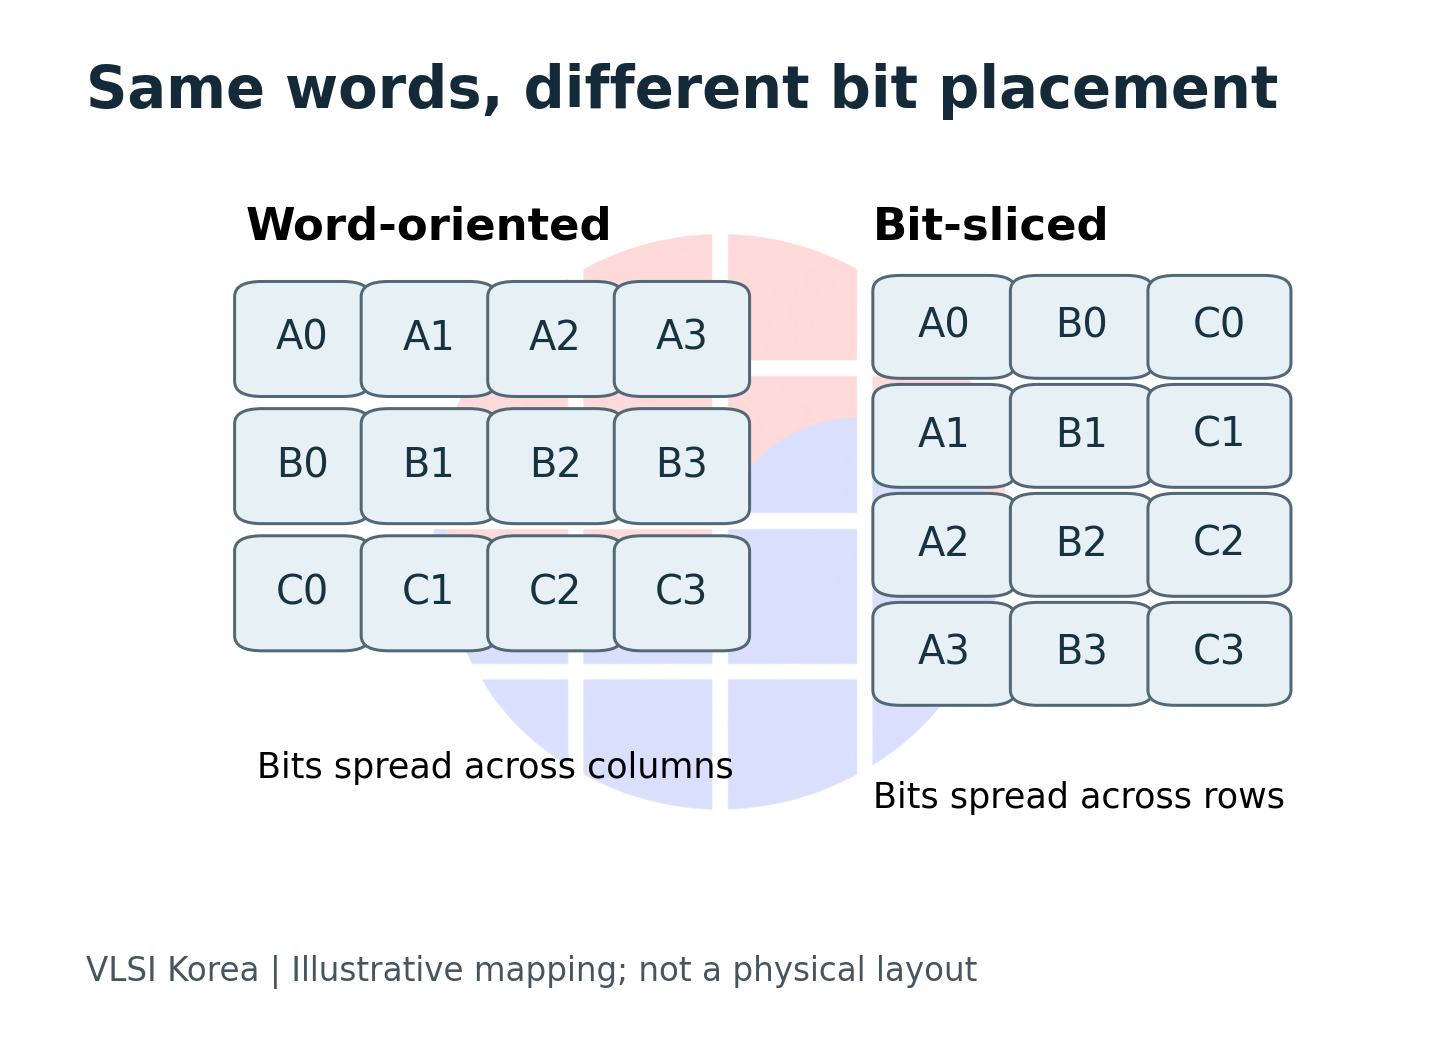
같은 데이터도 비트가 놓인 방향이 다르다
CPU가 정수를 다룰 때는 한 값의 여러 비트를 묶어 읽는다. 반면 bit-serial DRAM 연산은 서로 다른 값의 같은 자리 비트를 한꺼번에 처리하기 편하도록 데이터를 배치한다. 여기서 가로와 세로는 C 배열의 행 우선·열 우선 저장 순서만을 뜻하지 않는다. 한 값의 비트가 DRAM의 여러 bitline에 나뉘는지, 같은 bitline의 여러 row에 나뉘는지가 핵심이다.
SIMDRAM은 각 DRAM column을 독립적인 SIMD lane으로 활용하고, 비트 단위 연산을 이어 복잡한 계산을 수행하는 연구다. 여러 값을 동시에 처리할 수 있는 대신, 호스트와 연산기가 기대하는 배치가 다르면 입력과 출력의 변환을 고려해야 한다. SIMDRAM, 저자 초록
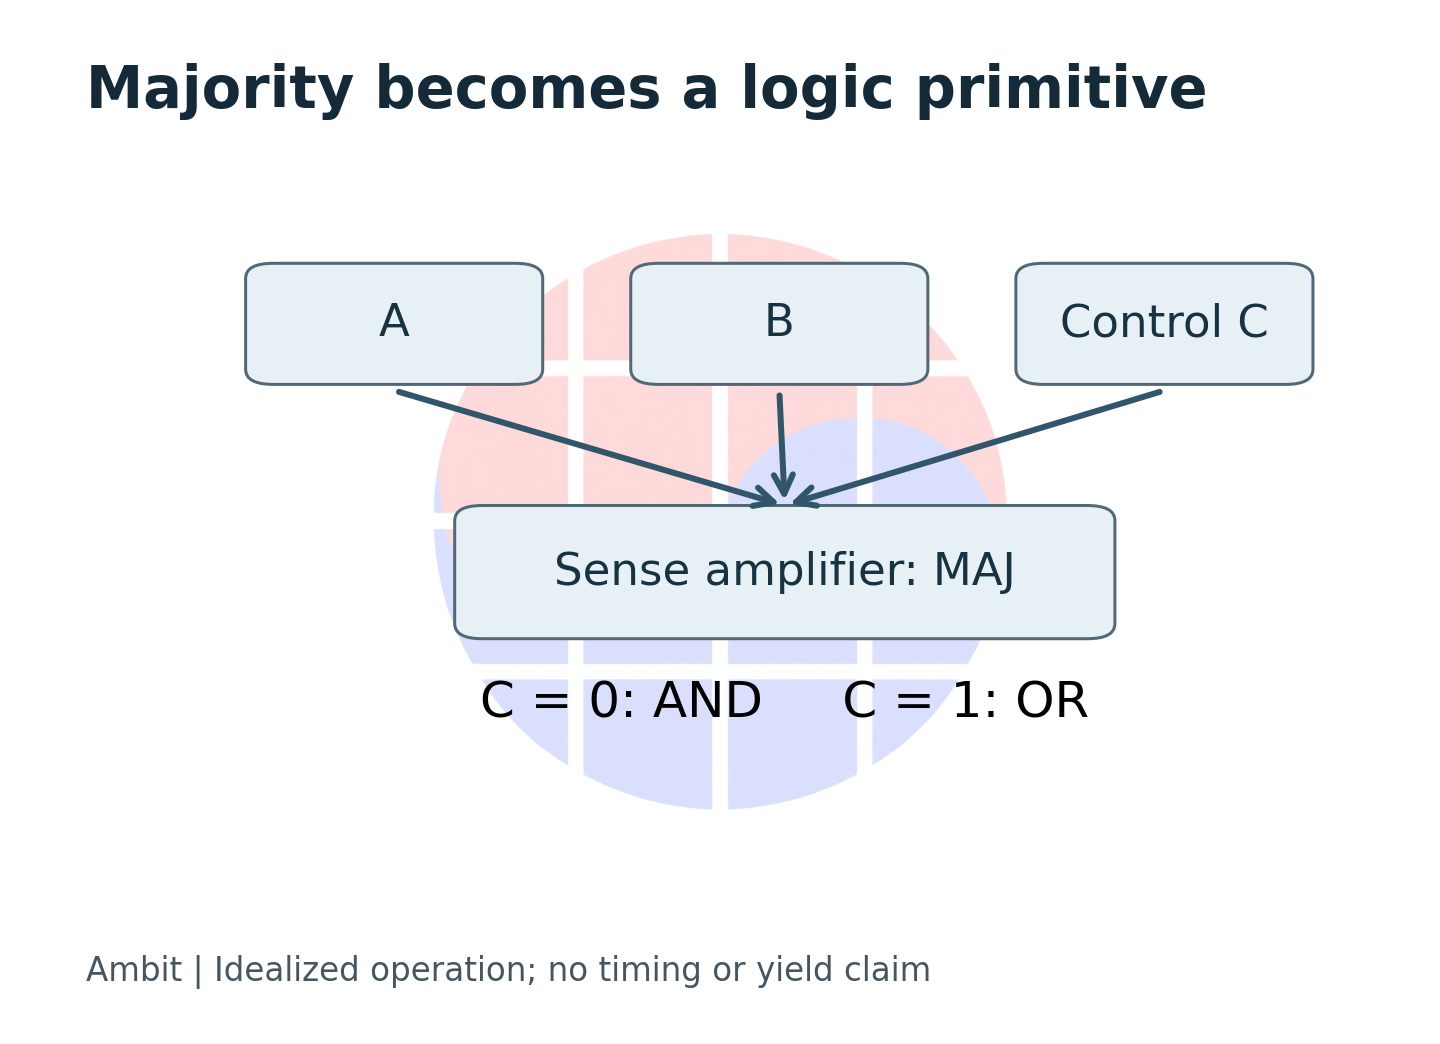
이런 연산의 출발점은 DRAM이 가진 전하와 sense amplifier다. Ambit은 같은 sense amplifier를 공유하는 여러 row를 함께 활성화해 bitwise 연산을 수행하는 구조를 제안했다. 세 입력의 다수결을 생각하면, 한 입력을 낮게 고정할 때 AND, 높게 고정할 때 OR가 되는 관계를 이해할 수 있다. Ambit, MICRO 2017
그러나 같은 bitline 위의 전하를 결합하는 능력이 옆 column으로 carry를 전달하는 능력까지 주지는 않는다. 산술 연산을 만들려면 비트의 자리 이동, 중간 결과 저장, 입력 보존을 함께 설계해야 한다. 논리식을 계산할 수 있다는 사실과 원하는 처리량을 얻는다는 주장은 별개다.
| Approach | Main operation site | Layout question |
|---|---|---|
| Host CPU | Processor logic | How are words fetched and reused? |
| Bit-serial PUM | DRAM bitlines and sense amplifiers | How are word bits distributed across rows? |
| Row-parallel PUM | Modified DRAM array | How do adjacent bit positions communicate? |
| HBM-PIM with PCU | Added computing units in memory | How are operands delivered to the units? |
Table 1. Architectural distinctions, not a performance ranking. Sources: SIMDRAM, RAPID and Samsung.
가로로 계산하려면 가로로 움직일 수 있어야 한다
RAPID는 이웃 bitline 사이의 이동을 돕는 migration cell과 반전을 위한 cell을 추가한다. 이를 통해 같은 값의 비트들을 가로 방향에 둔 채 산술 연산을 구성하려 한다. 기존 DRAM 모듈에 소프트웨어만 설치하는 제안이 아니라, DRAM 내부 구조를 바꾸는 연구다. RAPID, §III
내부 복사는 그 기반이 된다. RowClone의 Fast Parallel Mode는 같은 subarray 안에서 source와 destination row를 연달아 활성화해 데이터를 복사하는 방식이다. 이 원리를 이용하면 전체 데이터를 CPU까지 읽어 왔다가 되쓰는 경로를 줄일 수 있다. 다만 row 복사와 비트 전치는 같은 연산이 아니다. RowClone, 저자 초록
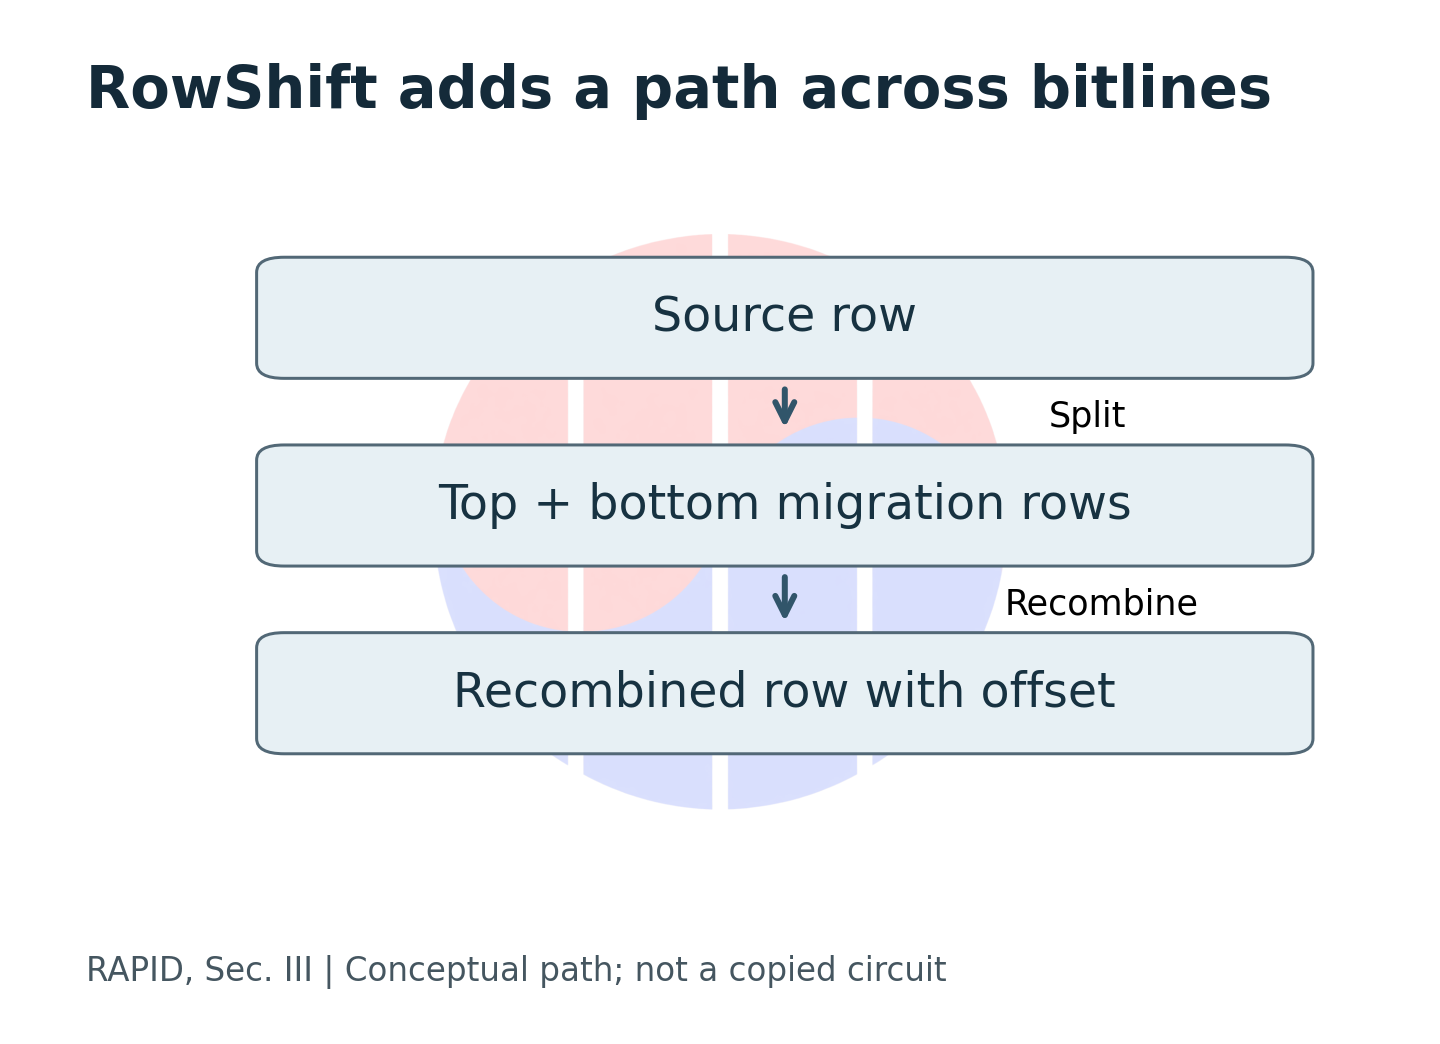
가로 이동이 가능해져도 비용이 사라지지는 않는다. 여러 비트로 된 값을 한 row에 붙여 놓으면, 값을 넘나드는 이동이 옆 operand를 오염시키지 않도록 경계를 마련해야 한다. 회로 설계자는 이동을 허용하는 공간과 그 때문에 줄어드는 유효 데이터 공간을 함께 계산해야 한다.
같은 이유로 “bit-parallel이면 병렬성이 높다”는 표현도 충분하지 않다. 한 값의 계산이 빨리 끝나는 것과 한 번에 많은 값을 계산하는 것은 다르다. 하나의 값이 더 많은 column과 보호 공간을 점유한다면, 동시에 담을 수 있는 값의 수는 감소한다.
맨 위의 Micron MT4C1024 사진은 이러한 논의를 실제 DRAM 어레이와 연결하는 역사적 참고다. 반복되는 메모리 영역과 주변 회로는 볼 수 있지만, 개별 연산 경로나 새 cell의 배치를 사진에서 추정할 수는 없다. 이 사진은 RAPID 구현 칩의 증거가 아니다. 사진 원출처
| Evidence layer | What it supports | What it does not establish |
|---|---|---|
| Circuit simulation | Feasibility under modeled conditions | Production yield and retention |
| Host conversion measurement | Cost on the tested host | Cost on every processor |
| Composed GEMV evaluation | Comparison within the modeled workload | Full-model silicon speedup |
Table 2. Keep evidence layers separate when interpreting RAPID. Source: RAPID §VI; VLSI Korea.
성능 역전은 측정 구간을 넓히면 나타난다
RAPID의 32-bit 비교에서 SIMDRAM은 PUM-only 처리량이 2.7–2.8배 높지만, DDR4에서 전치를 포함한 비교는 반대가 된다. 본문의 평가 대상은 19개 모델에서 추출한 GEMV 연산이며, 회로·아키텍처 시뮬레이션에 ARM 호스트의 전치 측정값을 결합한다. 따라서 결과를 완성된 상용 AI 서버나 전체 모델의 실측 가속률로 옮겨 읽어서는 안 된다. RAPID, §VI-D·VII-C
이 연구가 던지는 실무 질문은 분명하다. 산술 부분에서 번 시간을 데이터 형식 전환이 얼마나 가져가는가. 전치란 결과값을 바꾸는 계산이 아니라 같은 비트의 자리를 바꾸는 작업이므로, 연산 횟수만 세는 성능 지표에서는 쉽게 사라진다.
설계 예제: 순차 실행만 고려하고 bit-serial 계산 시간 C를 100 µs, 배치 호환 방식의 계산 시간 H를 280 µs, 배치가 바뀌는 경계 한 번의 비용 X를 25 µs로 가정한다. 경계 수가 N이면 전자의 총시간은 C + N × X다. 이 값들은 논문의 재현값이나 제품 사양이 아니다.
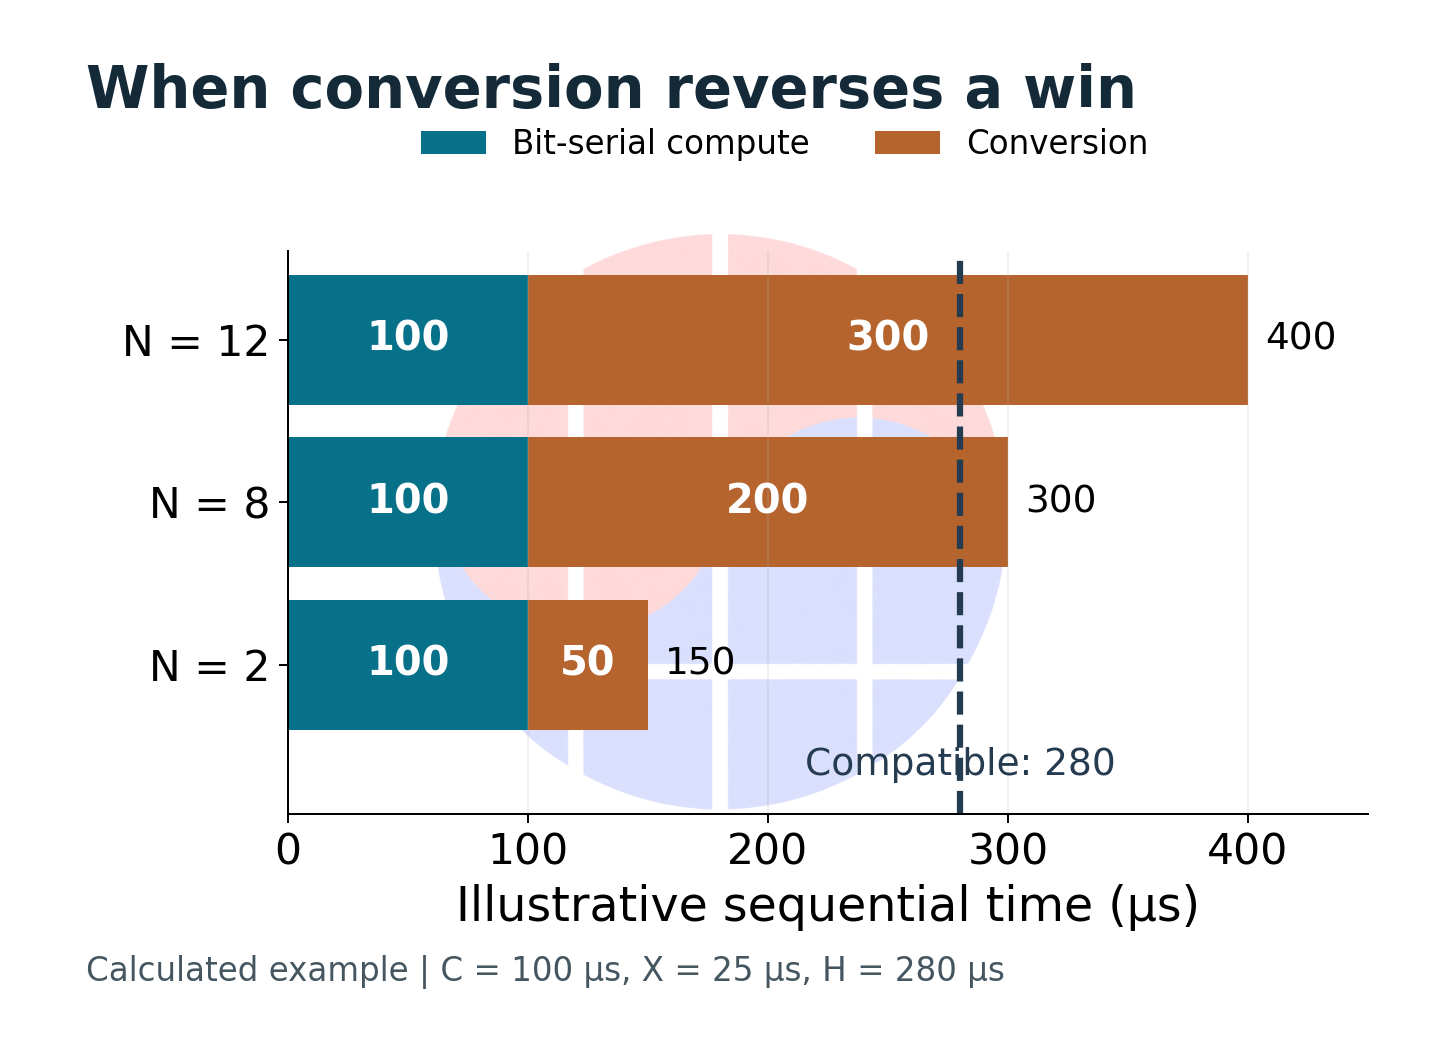
이 조건에서는 N이 7.2보다 커질 때 배치 호환 방식이 유리하다. 경계 수가 정수이므로 최소 8번의 전환이 필요하다. 반대로 중간 결과를 같은 형식으로 오래 유지해 경계 수를 줄이면 bit-serial 방식이 다시 유리해질 수 있다.
| Layout boundaries N | Bit-serial total (microseconds) | Compatible total (microseconds) | Lower latency |
|---|---|---|---|
| 2 | 150 | 280 | Bit-serial |
| 8 | 300 | 280 | Compatible layout |
| 12 | 400 | 280 | Compatible layout |
Table 3. Calculated illustration, not measured hardware. Boundary count is the number of actual layout changes, not the number of operators.
같은 예제에서 변환 한 번의 비용이 10 µs로 낮아지면 임계값은 18번이 되고, 실제 이득은 19번부터 나타난다. 변환을 빠르게 만드는 호스트 명령이나 전용 엔진도 메모리 연산기의 경쟁력을 바꾼다. 더 빠른 외부 인터페이스만을 해법으로 가정하면 비트 재배열 자체의 비용을 놓칠 수 있다.
실제 시스템에서는 변환과 계산이 겹칠 수도 있다. 이때는 단순 합계 대신 critical path와 버퍼 점유를 측정해야 한다. 또 PUM에 보내지 않는 연산이 전체 실행시간의 대부분이라면, 경계 비용을 없애도 응용 프로그램 전체의 개선폭은 작다.
VLSI Korea view: 호스트가 데이터를 거의 돌려받지 않고 연산을 길게 이어갈 수 있다면, 배치 호환성을 위해 추가한 하드웨어의 이점은 줄어든다. 이 조건에서 얻은 비교 결과가 주장의 반증 시험이다.
컴파일러가 고를 대상은 연산기와 데이터 형식의 쌍이다
PIM offload를 연산자별로 독립 결정하면 빠른 kernel들을 이어도 느린 프로그램이 나올 수 있다. 생산자가 출력한 형식과 소비자가 요구하는 형식이 다를 때마다 변환이 끼어들기 때문이다. 데이터 배치를 단순한 저장 옵션이 아니라 연산 사이의 계약으로 다뤄야 하는 이유다.
컴파일러가 알아야 할 상태에는 값의 위치, 비트 배치, 유효 범위, 다음 소비자가 포함된다. 같은 산술 결과라도 한쪽은 호스트가 바로 읽을 수 있고 다른 쪽은 재배열이 필요하다면, 두 결과의 사용 가능 시점은 다르다. 완료 신호만 같게 만드는 것으로 이 차이를 숨길 수 없다.
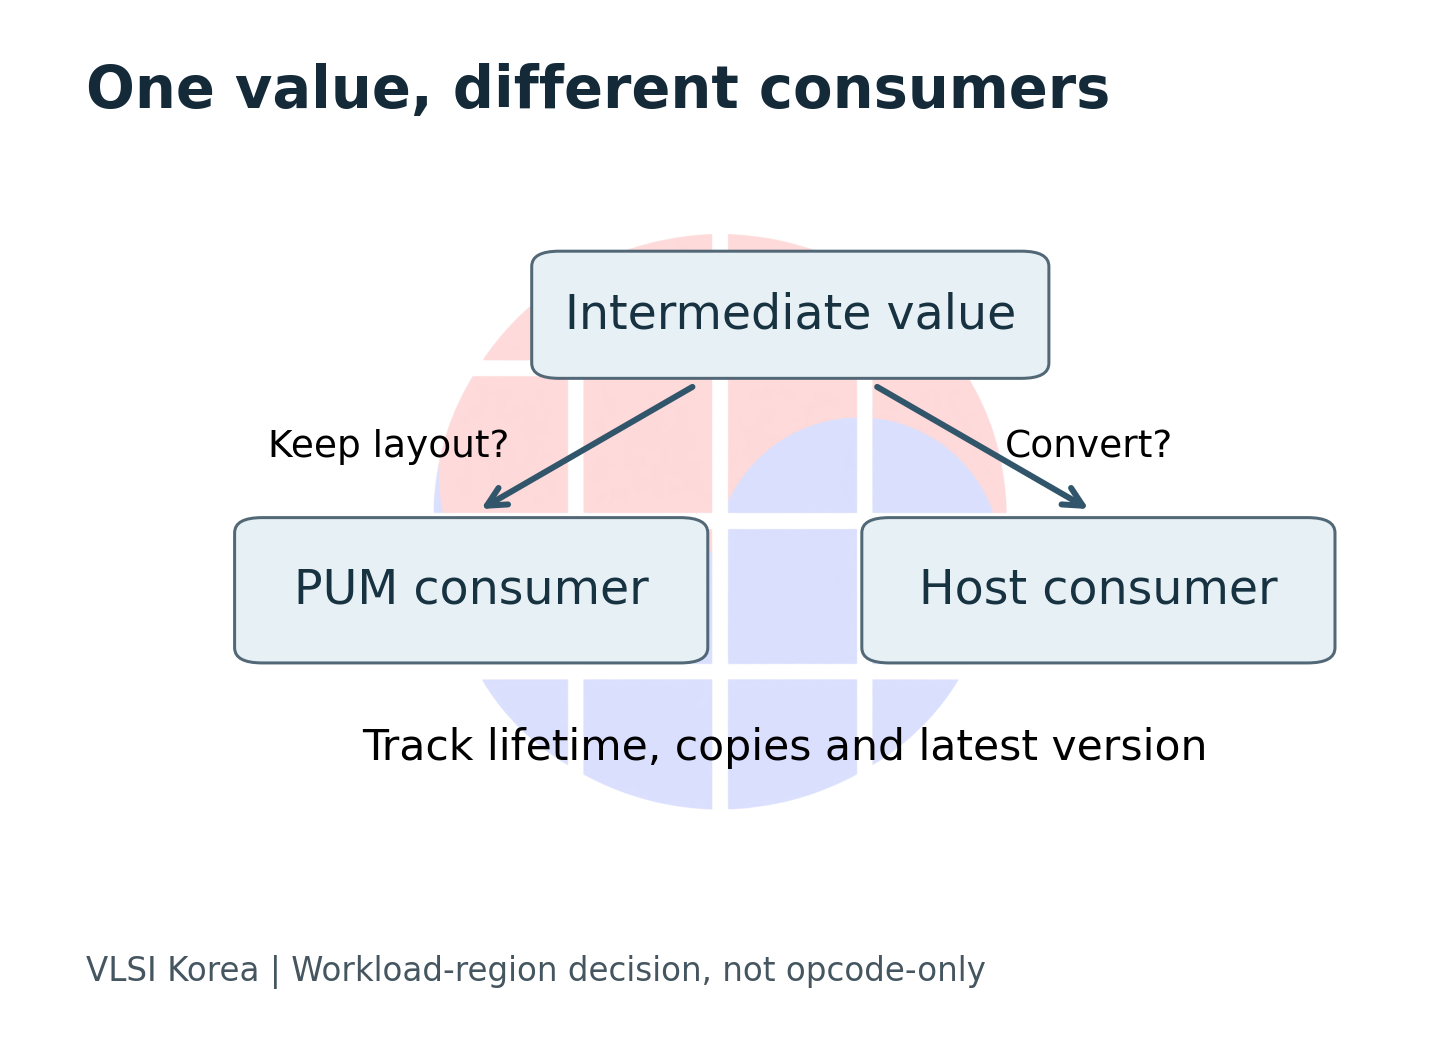
예를 들어 두 메모리 연산 사이의 짧은 호스트 처리가 중간에 있다면 선택지는 여러 개다. 호스트 처리를 메모리 쪽으로 옮기거나, 연산을 묶어 왕복을 줄이거나, 아예 전체 구간을 CPU에 남길 수 있다. 어느 쪽이 유리한지는 그 구간의 실제 입력 크기와 재사용 횟수로 판단해야 한다.
입력이 여러 소비자로 갈라지는 경우에는 더 복잡하다. 한 소비자를 위해 만든 변환본을 다른 소비자도 쓸 수 있으면 비용을 공유할 수 있지만, 오래 보관하려면 추가 용량이 든다. 서로 다른 형식의 사본을 유지한다면 어느 사본이 최신인지 추적하는 규칙도 필요하다.
따라서 최적화 보고서에는 kernel 시간 외에 변환 횟수, 변환한 byte 수, 중간 버퍼의 수명과 최대 점유량이 들어가야 한다. 산술 처리량만 개선되고 이 값들이 악화되면 시스템 관점의 진전이라고 판단하기 어렵다. 모두 같은 조건으로 측정해야 비교가 성립한다.
| Decision | Potential benefit | Cost to measure |
|---|---|---|
| Keep bit-sliced data | Fewer repeated conversions | Host access and output conversion |
| Preserve word-oriented data | Easier host handoff | Array occupancy and local movement |
| Fuse operators | Fewer execution boundaries | Scratch capacity and supported operations |
| Retain host execution | Avoid offload overhead | External traffic and CPU time |
Table 4. Decisions belong to a workload region, not just to one arithmetic opcode. Source: VLSI Korea.
배치 호환성 다음에는 메모리의 정상 동작이 남는다
어레이 연산의 결과가 맞는지 확인하는 것과 시스템 메모리로 안전하게 쓰는 것은 또 다른 층위다. 호스트 cache가 이전 값을 가진 상태에서 메모리 내부 계산을 끝내면, CPU는 갱신되지 않은 값을 읽을 수 있다. 계산 시작·종료 시점의 소유권과 가시성은 인터페이스 계약에 포함돼야 한다.
ECC도 같은 관점으로 봐야 한다. 데이터를 메모리 내부에서 바꿨는데 보호 정보가 그 변경을 반영하지 못하면 이후 읽기에서 문제가 발생한다. 어느 단위의 데이터와 보호 비트를 함께 갱신할지, 원자성이 필요한지, 예외가 발생했을 때 어떻게 복구할지가 설계 질문이다.
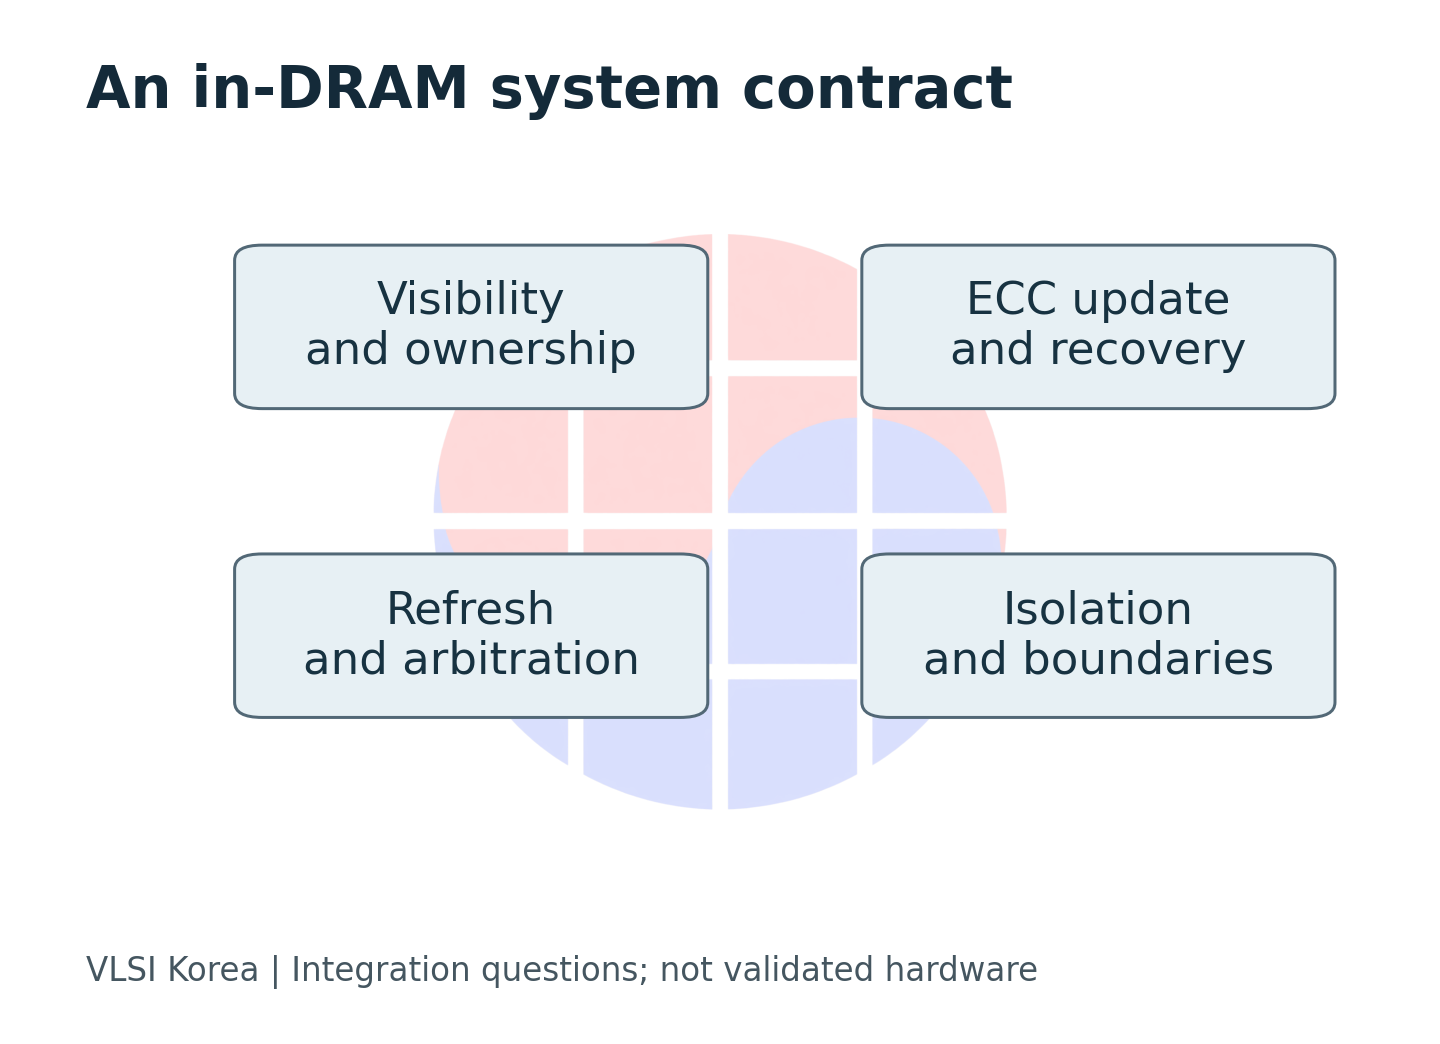
여기에 refresh와 일반 읽기·쓰기의 중재가 더해진다. 특정 bank를 계산에 오래 붙잡아 두면 다른 요청의 지연이 늘 수 있다. 평균 처리량이 개선돼도 지연에 민감한 요청의 대기시간이 악화되는 경우를 분리해야 한다. 시험에는 계산 전용 상태뿐 아니라 일반 메모리 트래픽이 공존하는 상태가 필요하다.
추가 cell의 동작 검증도 생산 가능한 DRAM 공정의 증거와 구분해야 한다. RAPID는 45 nm FreePDK layout과 추출 기생 성분을 이용한 SPICE 검증을 제시한다. 이 결과는 연구 구조의 회로 타당성을 검토하는 근거이며, 특정 제조사의 DRAM 공정에서 수율·retention·repair가 검증됐다는 뜻은 아니다. RAPID, §VI-A·VI-G
한국 메모리 산업이 확인할 것은 연산 위치보다 경계 비용이다
PIM이라는 이름 아래 모든 구조를 한 묶음으로 놓으면 설계 선택이 흐려진다. 삼성전자가 설명한 HBM-PIM은 메모리 내부에 Programmable Computing Unit을 넣는 접근이다. DRAM cell의 전하 공유를 산술의 기본 재료로 쓰는 PUM과는 연산 구현 위치가 다르다. 삼성전자 기술 설명
한국의 메모리·가속기·시스템 팀에 공통인 판단 기준은 그 경계를 오가는 비용이다. 메모리 업체는 필요한 어레이 변경과 유효 용량을, 가속기 업체는 데이터 배치와 명령 인터페이스를, 소프트웨어 팀은 변환을 실제로 생략할 수 있는 실행 구간을 같은 workload에서 맞춰 봐야 한다.
| Evidence to request | Decision it supports |
|---|---|
| Measured conversion time and boundary count | Whether layout compatibility pays off |
| Equal arithmetic semantics and precision | Whether outputs are actually comparable |
| Mixed host and PUM traffic | Whether memory service remains acceptable |
| Capacity and scratch-space accounting | Whether the useful system still fits |
| Silicon results across operating conditions | Whether simulation gains survive implementation |
Table 5. Evidence requests for a joint memory, accelerator and compiler evaluation. Source: VLSI Korea.
향후 6–12개월의 관찰점은 새로운 최고 배수보다 재현 가능한 비교다. 독립 팀이 같은 입력·정밀도·출력 조건에서 변환 시간을 측정하고, 호스트와 PUM을 섞은 구간의 실행시간을 공개하는지 확인할 필요가 있다. 연구 회로를 실제 DRAM 환경에서 검증한 결과가 나오면 설계 판단의 무게도 달라진다.
반대로 변환을 한 번만 수행한 뒤 데이터를 오래 재사용하는 작업에서 기존 구조가 계속 유리하다면, 배치 호환 방식의 목표 시장은 더 좁아진다. 이 경계를 먼저 찾는 편이 모든 AI 작업을 대상으로 최대 성능을 주장하는 것보다 유용하다.
PIM의 성능표는 연산기에서 끝나면 안 된다. 입력을 배치하고, 계산하고, 다음 소비자에게 넘기는 전체 경로에서 이득이 남는지 확인해야 한다. DRAM 안으로 계산을 가져오는 다음 경쟁은 그 경로를 얼마나 짧고 일관되게 만들 수 있는가에 달려 있다.
Sources and evidence note
RAPID v1, 2026-10-01: 제출 이력이 확인된 프리프린트이며 학회 채택은 확인되지 않았다. 본문과 평가 방법을 읽었고, 결과는 저자 보고다. 신규 상용 제품 발표로 다루지 않았다.
SIMDRAM, RowClone, Ambit: 이 글은 해당 저자 초록·기관 설명에 있는 메커니즘을 사용한다. 이들의 과거 성능 수치를 오늘의 동일 조건 비교로 재사용하지 않았다. 서로 연관된 연구 계보이며 독립적인 RAPID 재현 실험으로 세지 않는다.
Samsung HBM-PIM: 회사가 설명한 구조를 구분하기 위한 자료다. ZeptoBars 사진·원출처, 사용권: 역사적 DRAM 실물 사진이며 새 연구 하드웨어를 보여 주지 않는다.
Disclosure: 회로 개념도와 손익분기 예제는 VLSI Korea가 작성한 설명·계산이다. 수치 예제는 측정값이 아니며, 그림과 표는 성능 순위나 제품 추천을 뜻하지 않는다.