VLSI Korea
Google TPU v1에서 Ironwood까지: 칩이 아니라 AI 공장을 설계한 10년
TPU v1부터 Ironwood까지, 연산·HBM·광스위치·컴파일러가 어떻게 하나의 Google AI 공장으로 진화했는지 분석합니다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
이 글은 cloud AI accelerator의 세대별 architecture와 system economics를 비교해 구매·투자·공급망 판단을 내리려는 독자를 위한 글이다. 읽고 나면 peak 수치와 실제 model-level TCO를 분리하고, 다음 세대에서 검증할 지표를 선택할 수 있다.
자료 기준일: 2026-08-02
TL;DR
Google TPU의 핵심은 systolic array가 아니다. v1은 검색·음성 같은 99th-percentile 추론 지연을 안정적으로 줄인 데이터센터 ASIC이었고, v2·v3는 bfloat16과 HBM, Pod interconnect를 넣어 학습 장치가 됐다. v4는 4,096개 칩과 Optical Circuit Switch를 결합해 네트워크를 컴파일 가능한 자원으로 만들었다. v5e·v5p는 비용형과 성능형을 분리했고, v6e Trillium은 Transformer 범용성을 높였다. v7x Ironwood는 192 GiB HBM, 7.38 TB/s, FP8 4.614 PFLOPS, 9,216-chip Pod를 결합하며 다시 하나의 대형 AI system으로 수렴한다.
Google이 가진 가장 큰 우위는 칩 성능보다 workload-model-compiler-network를 10년 동안 함께 바꾼 경험이다. 가장 큰 약점은 CUDA와 다른 개발 경로, 세대별 최적화 재작업, 외부 고객이 Google 내부와 같은 운영 효율을 얻기 어렵다는 점이다.
Generation map
| Generation | Role | Peak per chip | Memory | System inflection |
|---|---|---|---|---|
| TPU v1 | Inference | 92 INT8 TOPS | 8 GiB DDR3, 28 MiB on-chip | Deterministic datacenter ASIC |
| TPU v2 | Training and inference | 45 BF16 TFLOPS | 16 GiB HBM | First Cloud TPU and 256-chip Pod |
| TPU v3 | Training and inference | 123 BF16 TFLOPS | 32 GiB HBM2, 900 GB/s | Liquid cooling and 1,024-chip Pod |
| TPU v4 | Large-scale training | 275 BF16 TFLOPS | 32 GiB HBM2, 1.2 TB/s | 4,096-chip optical reconfigurable Pod |
| TPU v5e | Cost-efficient train and serve | 197 BF16 TFLOPS | 16 GB, 800 GiB/s | 256-chip elastic 2D torus |
| TPU v5p | Frontier training | 459 BF16 TFLOPS | 95 GiB, 2.765 TB/s | Up to 6,144-chip single slice |
| TPU v6e | General train and serve | 918 BF16 TFLOPS | 32 GB, 1.638 TB/s | 256-chip Transformer-optimized Pod |
| TPU7x | Frontier train and serve | 2,307 BF16 / 4,614 FP8 TFLOPS | 192 GiB, 7.38 TB/s | 9,216-chip Ironwood Pod |
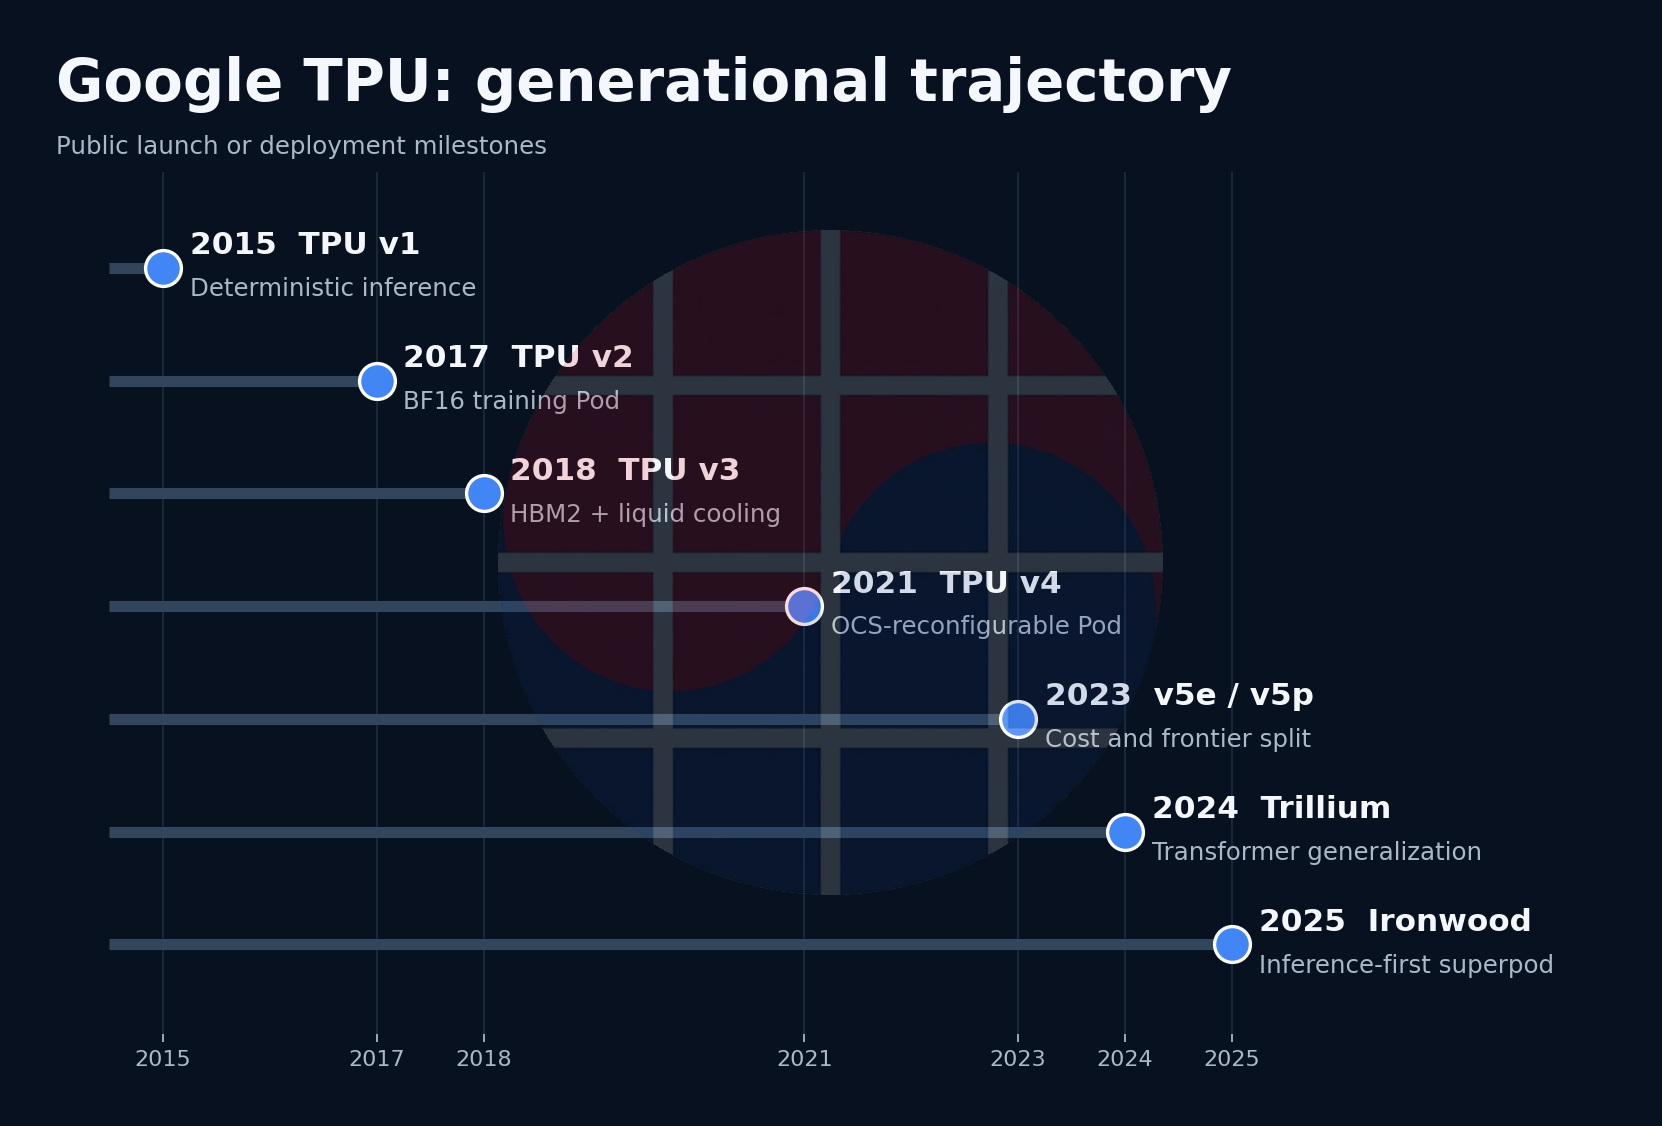
표의 수치는 Google 공식 문서와 논문 기준이다. v1의 DDR3와 v2 초기 수치는 공개 논문의 표기 관행을 따랐고, 최신 제품의 GB와 GiB는 Google 문서의 단위를 그대로 유지했다. 정밀도가 다른 peak 수치를 세대 성능 배수로 직접 나누면 안 된다.
1세대: deterministic inference라는 출발점
TPU v1은 2013년 설계를 시작해 2015년 데이터센터에 배포된 PCIe 보조 가속기다. 핵심은 65,536개의 8-bit MAC으로 구성된 256 x 256 matrix multiply unit, 28 MiB software-managed on-chip memory, 92 TOPS다. 당시 Google production neural network 수요의 95%를 차지하던 MLP, CNN, LSTM 추론을 대상으로 CPU와 NVIDIA K80을 비교했다.
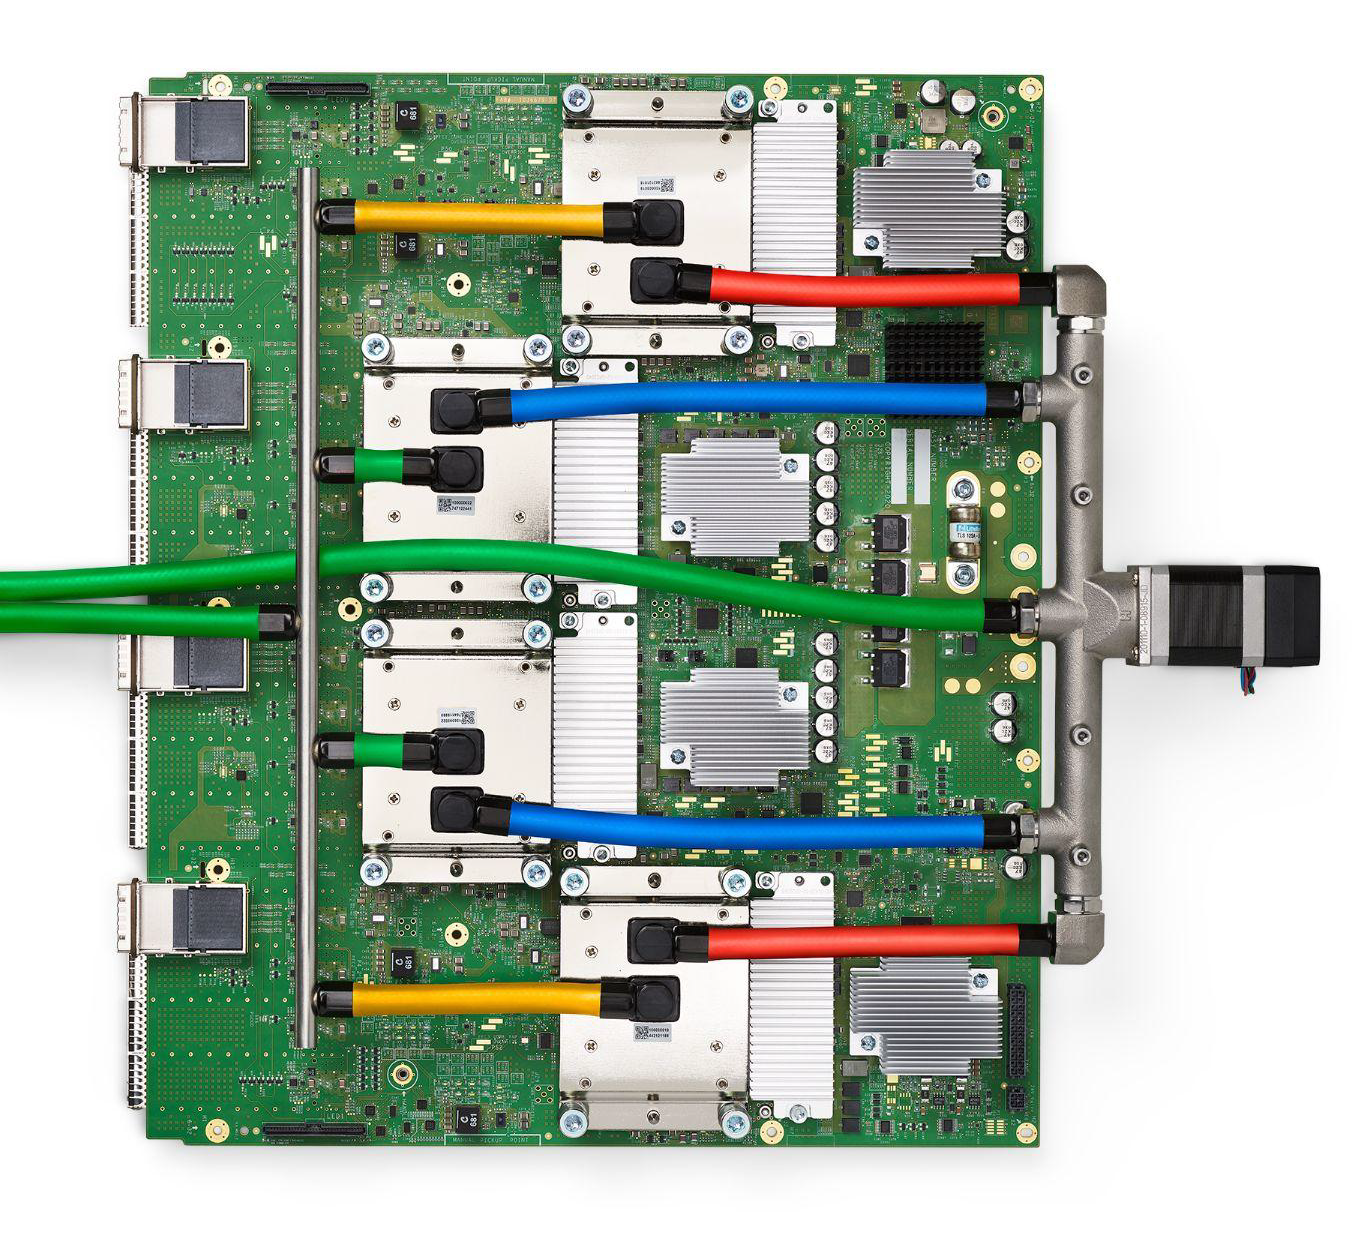
여기서 중요한 설계 판단은 out-of-order execution, cache hierarchy, speculative execution 같은 평균 성능 최적화를 덜어낸 것이다. 검색과 음성 서비스는 평균 throughput보다 tail latency가 중요했다. 실행 시간을 compiler와 소프트웨어가 더 직접 통제하면 대형 MAC array의 이용률이 완벽하지 않아도 99th-percentile 지연을 예측하기 쉬웠다. Google 논문은 당시 CPU·GPU 대비 평균 15-30배 성능, 30-80배 TOPS/W를 보고했다. 이는 동일 시대 Google 내부 workload에서의 결과이며 현대 GPU와의 비교가 아니다.
v1의 한계도 명확했다. 8 GiB DDR3의 약한 대역폭 때문에 arithmetic intensity가 낮은 모델은 MAC array를 채우지 못했다. 이 경험은 이후 TPU가 연산량만 늘리지 않고 HBM과 interconnect를 함께 키운 이유다.
2·3세대: 추론 ASIC에서 학습 Pod로
TPU v2는 세 가지를 바꿨다. 첫째, INT8 중심 추론기에서 bfloat16 학습기로 확장했다. bfloat16은 FP32와 같은 8-bit exponent를 유지하면서 mantissa를 줄여 dynamic range를 보존하고 matrix unit 면적과 데이터 이동량을 낮춘다. 둘째, DDR3 대신 HBM을 사용했다. 셋째, 칩을 고속 interconnect로 연결해 256-chip Pod를 만들었다. 이때부터 TPU의 unit of design은 단일 칩보다 Pod가 됐다.
TPU v3는 칩당 BF16 123 TFLOPS, HBM2 32 GiB와 900 GB/s, 1,024-chip Pod로 올라갔다. 평균 전력이 약 220 W 수준으로 높아지며 liquid cooling을 도입했다. v2에서 v3의 본질은 단순한 compute 증가가 아니다. 더 큰 모델과 batch, 더 많은 activation을 HBM에 두고, data·model parallel collective를 2D torus에서 처리하는 학습 시스템으로 안정화한 것이다.
이 단계에서 XLA의 역할이 커졌다. Python 또는 TensorFlow graph를 device instruction으로 바꾸는 것만이 아니라 operation fusion, tensor layout, sharding, collective 삽입을 결정해야 했다. 가속기의 deterministic 특성은 compiler가 충분히 좋은 schedule을 만들 때 강점이지만, unsupported op나 dynamic shape가 많으면 host fallback과 recompilation으로 약점이 된다.
4세대: Optical Circuit Switch가 만든 시스템 우위
TPU v4는 칩당 BF16 또는 INT8 275 TFLOPS, HBM2 32 GiB·1.2 TB/s, 측정 평균 전력 170 W, 4,096-chip Pod를 제공했다. 각 칩은 6개의 ICI link를 갖고 3D mesh 또는 torus를 구성한다. Pod peak는 1.1 EFLOPS, all-reduce bandwidth는 1.1 PB/s, bisection bandwidth는 24 TB/s다.
가장 큰 변화는 MEMS Optical Circuit Switch다. 전기 packet switch만으로 고정 토폴로지를 만들지 않고, 광 경로를 재구성해 장애 chip과 link를 우회하고 job 크기에 맞는 slice를 만든다. OCS는 packet마다 routing하는 장비가 아니라 비교적 긴 시간 유지되는 circuit를 바꾸므로 AI job의 규칙적 collective traffic과 잘 맞는다. Google은 twisted torus로 wrap-around link 길이와 배선을 줄이고, compiler의 logical topology를 physical slice에 매핑했다.
v4가 보여준 교훈은 advanced node만으로 대형 학습 시스템을 만들 수 없다는 것이다. 4,096개 칩 중 일부가 불량이거나 link가 고장 나도 전체 Pod를 폐기하지 않고 usable slice를 구성해야 한다. scheduling yield가 silicon yield만큼 중요해졌다. embedding workload를 위한 SparseCore도 이 세대에 system feature로 자리 잡았다. 추천 모델은 dense GEMM보다 sparse lookup, gather, reduction이 병목이어서 범용 matrix unit 증설만으로 해결되지 않는다.
5세대: v5e와 v5p로 갈라진 경제성
Google은 v5에서 하나의 최대 칩을 만들기보다 두 제품점을 분명히 했다. v5e는 197 BF16 TFLOPS, 16 GB HBM, 800 GiB/s, 400 GB/s bidirectional ICI, 256-chip 2D torus다. 작은 slice부터 256개까지 쪼개고 학습과 serving을 모두 지원한다. 공개 MLPerf와 내부 측정에서 v4 대비 더 높은 performance per dollar를 제시했지만, 이는 모델·정밀도·가격 시점에 의존한다.
v5p는 459 BF16 TFLOPS, 95 GiB HBM, 2.765 TB/s, 1.2 TB/s ICI, 4 SparseCore를 갖는다. Pod에는 8,960개 칩이 있고 단일 slice는 최대 6,144개, Multislice는 18,432개까지 확장된다. v5e보다 칩당 compute가 약 2.3배지만 HBM 용량은 약 5.9배, 대역폭은 약 3.5배다. frontier training에서 optimizer, activation, checkpoint와 model state를 더 적은 chip에 담아 parallelism communication을 줄이는 쪽이다.
이 분화는 cloud 경제학을 반영한다. 모든 고객이 가장 큰 Pod를 지속 사용하지 않는다. 작은 fine-tuning과 inference는 낮은 시간당 비용, 다양한 slice, 빠른 provisioning이 중요하다. 대형 pretraining은 더 큰 HBM과 3D topology, 높은 ICI로 wall-clock time을 줄이는 것이 중요하다. 같은 compiler surface를 유지하면서 silicon balance를 달리하면 fleet utilization을 높일 수 있다.
6세대 Trillium: 큰 MXU와 범용 Transformer
v6e Trillium은 256-chip Pod라는 v5e footprint를 유지하면서 칩당 BF16 918 TFLOPS, INT8 1,836 TOPS로 높였다. HBM은 32 GB·1.638 TB/s, bidirectional ICI는 800 GB/s다. 기존 128 x 128에서 256 x 256 MXU로 커지고 clock이 높아졌다. Google은 v5e 대비 peak compute 4.7배, HBM 용량·대역폭 2배, ICI 2배, 에너지 효율 67% 이상 향상을 발표했다.
하지만 큰 systolic array는 작은 matrix와 irregular operator에서 utilization을 낮출 수 있다. Trillium은 Transformer, text-to-image, CNN을 명시적 target으로 삼고 XLA fusion과 layout을 통해 더 큰 tile을 지속 공급해야 한다. 2개의 SparseCore는 추천 workload를 보완한다. 256-chip Pod를 넘어서는 job은 DCN과 Multislice 또는 Pathways를 사용하므로 chip ICI와 datacenter network 사이의 계층을 compiler/runtime가 인식해야 한다.
7세대 Ironwood: inference age라 부르지만 training system이다
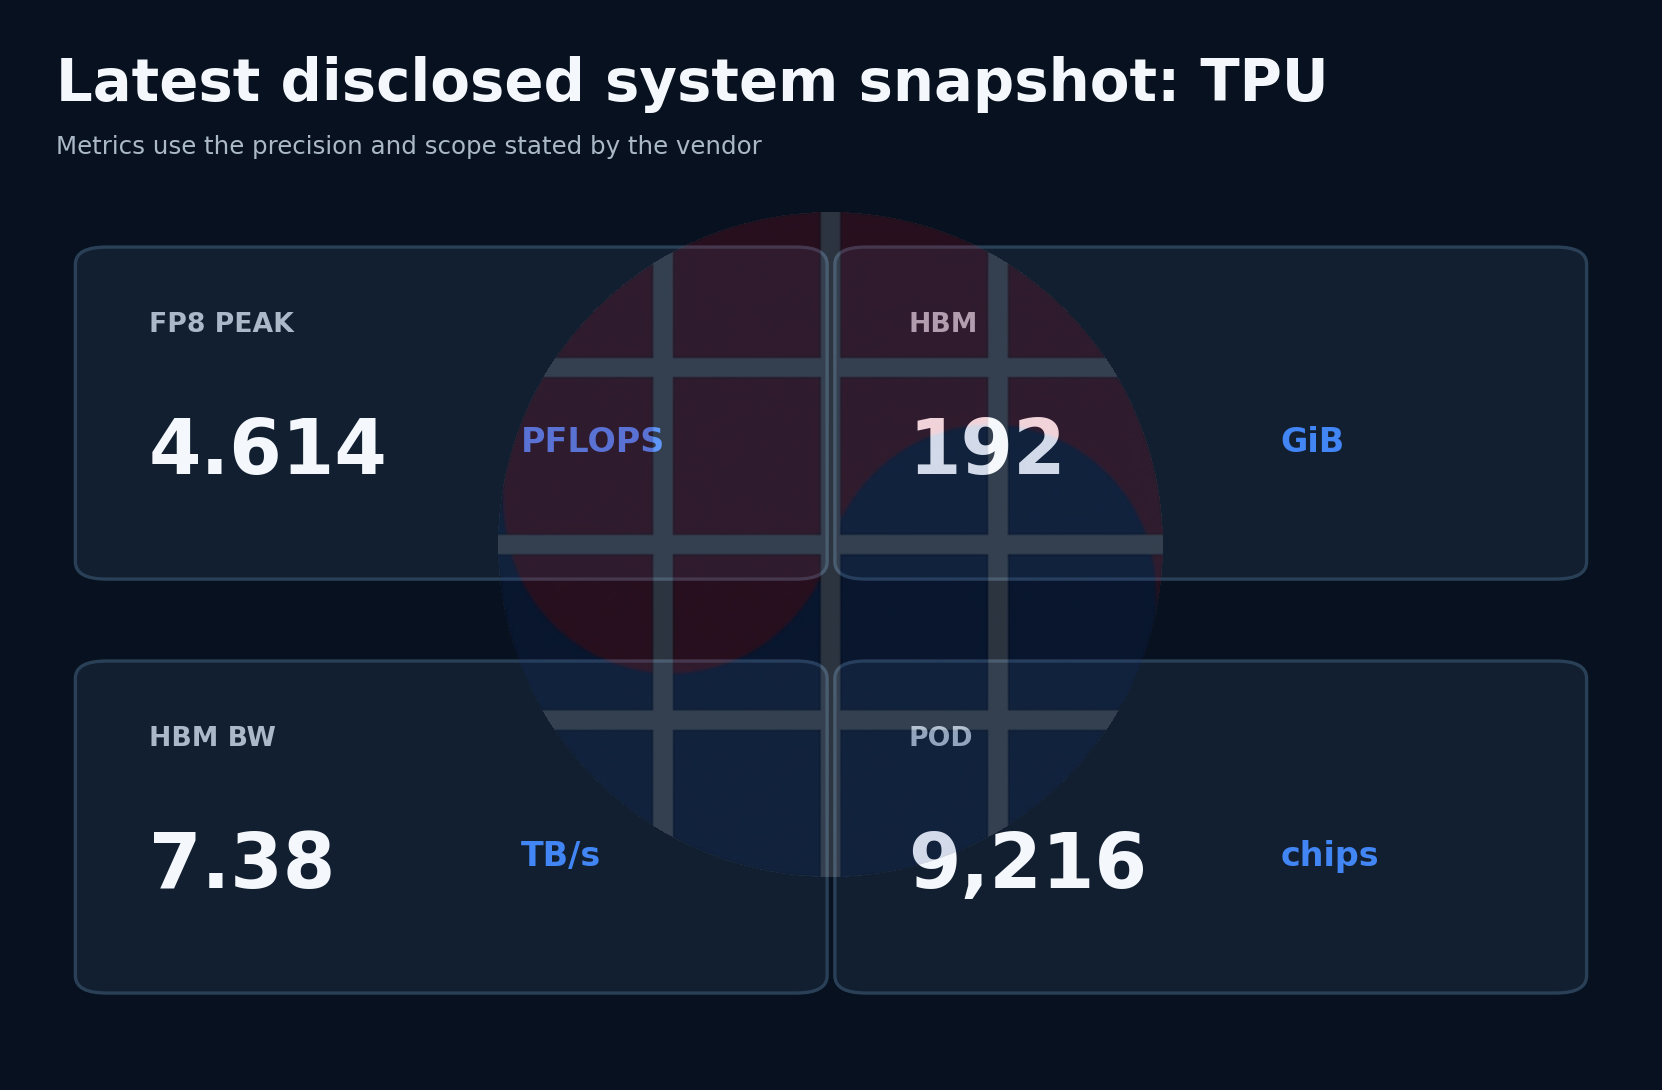
TPU7x Ironwood는 2개의 TensorCore, 4개의 SparseCore, 192 GiB HBM, 7.38 TB/s HBM bandwidth, 1.2 TB/s bidirectional ICI를 갖는다. peak는 BF16 2.307 PFLOPS, FP8 4.614 PFLOPS다. Pod는 9,216개 칩으로 구성된다. v6e 대비 BF16은 약 2.5배, FP8은 약 5배, HBM 용량은 6배, 대역폭은 4.5배이지만 ICI는 1.5배다.
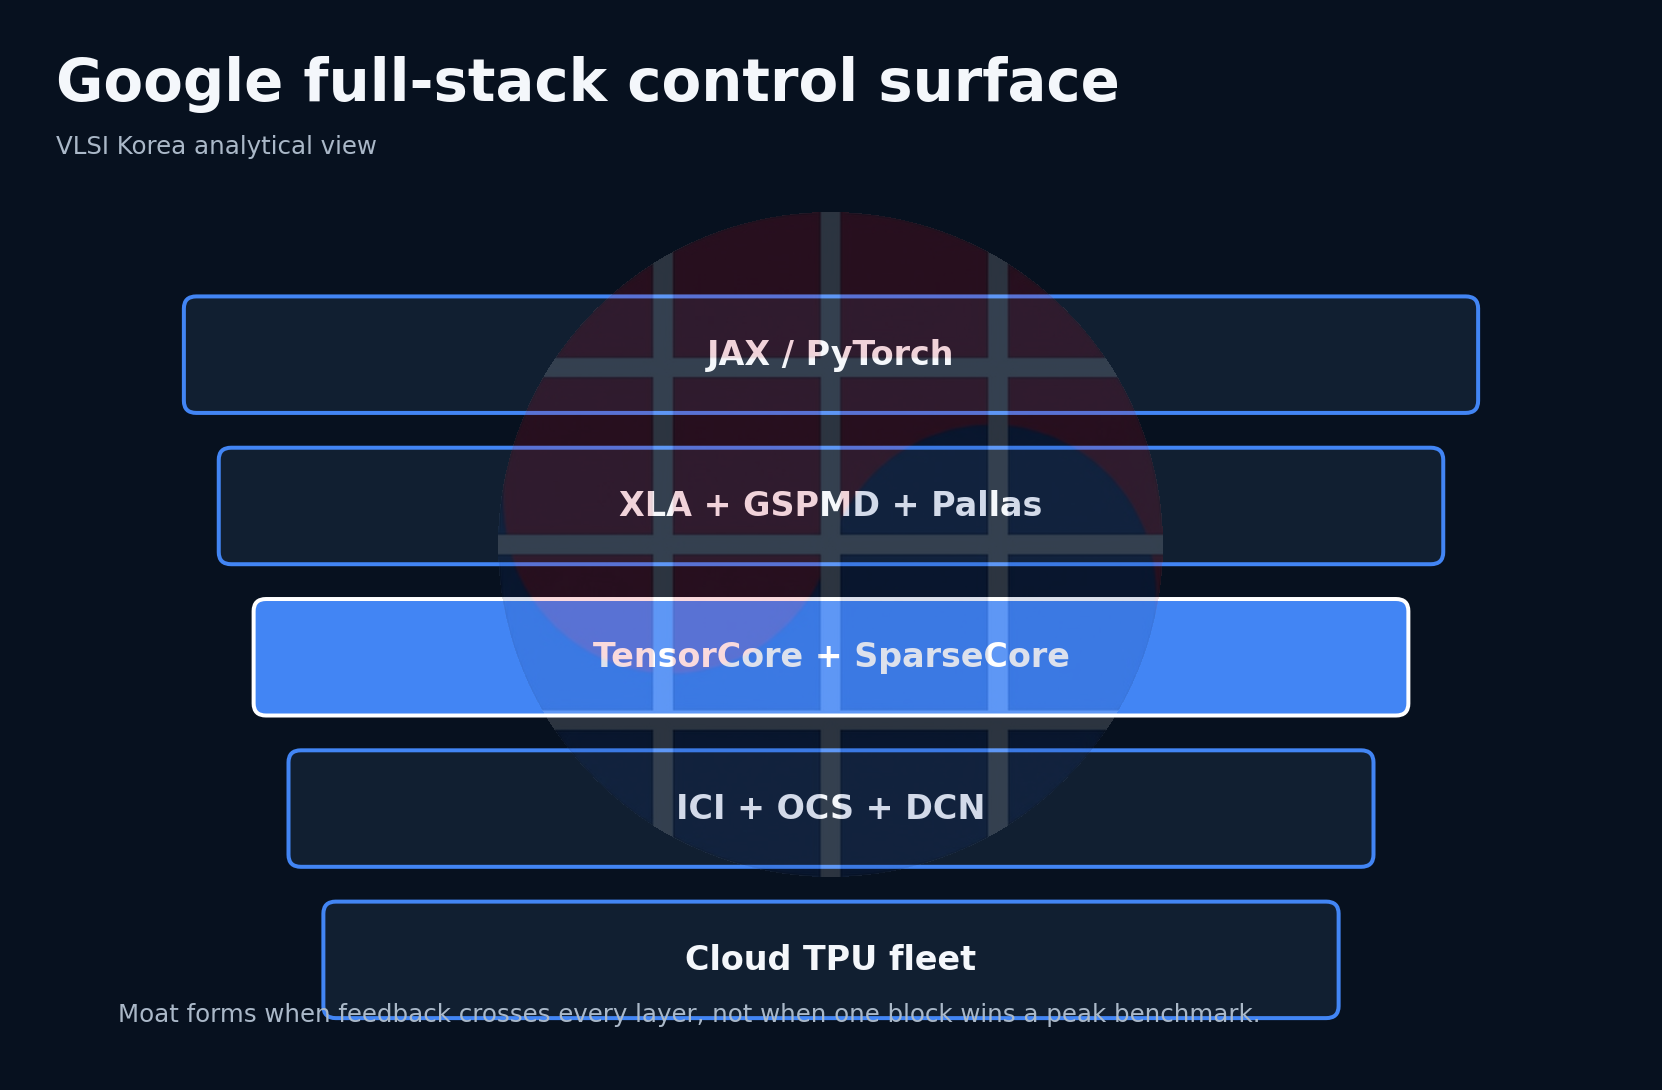
이 비율이 중요하다. Ironwood는 decode의 weight·KV cache streaming과 대형 model residency를 위해 memory subsystem을 훨씬 크게 늘렸다. 반면 칩당 ICI가 compute와 HBM만큼 증가하지 않았기 때문에 locality와 sharding quality가 더 중요해졌다. Google은 ICI, OCS, DCN을 묶어 9,216-chip Pod를 운영하고 Pallas custom kernel, XLA, JAX, PyTorch/XLA로 software control을 넓힌다.
Google은 Ironwood를 inference 시대의 칩으로 소개했지만 공식 문서는 대규모 학습, reinforcement learning, serving을 모두 target으로 둔다. inference-first라는 표현은 단일-purpose ASIC이라는 뜻보다 fleet의 경제성 중심이 training peak에서 token throughput과 responsiveness로 이동했다는 의미에 가깝다.
흥미로운 변화는 TPU7x에서 TensorFlow를 지원하지 않고 JAX와 PyTorch를 지원한다는 점이다. TPU를 탄생시킨 프레임워크보다 현재 frontier model 개발자가 실제 쓰는 interface를 우선한 것이다. 하드웨어 moat를 유지하려면 software surface는 오히려 업계 표준에 가까워져야 한다는 역설을 보여준다.
Google의 진짜 moat
첫째, production workload가 설계 입력이다. Search, YouTube recommendation, Gemini, Veo, Imagen, Anthropic Claude 같은 workload가 hardware counterexample을 빠르게 제공한다. 둘째, XLA·GSPMD는 model graph를 single-device kernel과 multi-device sharding으로 함께 낮춘다. 셋째, OCS와 datacenter network를 포함한 physical topology를 직접 설계한다. 넷째, Cloud TPU라는 외부 판매 채널이 있어 내부 workload가 비는 시간과 장기 capacity를 monetization할 수 있다.
그러나 moat는 lock-in이기도 하다. CUDA kernel을 그대로 실행할 수 없고, JAX·XLA compilation과 sharding model을 배워야 한다. TPU generation을 바꾸면서 chip count나 topology가 달라지면 same code라도 significant tuning이 필요하다고 Google 문서가 명시한다. peak FLOPS가 높아도 unsupported custom op, compile time, input pipeline, small batch inference가 병목이면 실효 성능은 떨어진다.
Watch points
- Ironwood의 FP8 training이 BF16 대비 실제 convergence와 time-to-train에서 얼마나 안정적인가.
- 9,216-chip Pod에서 HBM과 compute 증가에 비해 ICI 증가가 작은데, model parallel efficiency가 유지되는가.
- PyTorch/XLA와 Pallas가 CUDA·Triton 자산의 전환 비용을 얼마나 낮추는가.
- v5p와 Ironwood의 fleet mix가 frontier training, RL, high-volume serving 사이에서 어떻게 배분되는가.
- OCS fault rerouting이 대규모 job scheduling yield와 long-running training availability를 얼마나 개선하는가.
Contrarian read: TPU의 강점이 범용 AI 시장에서는 약점일 수 있다
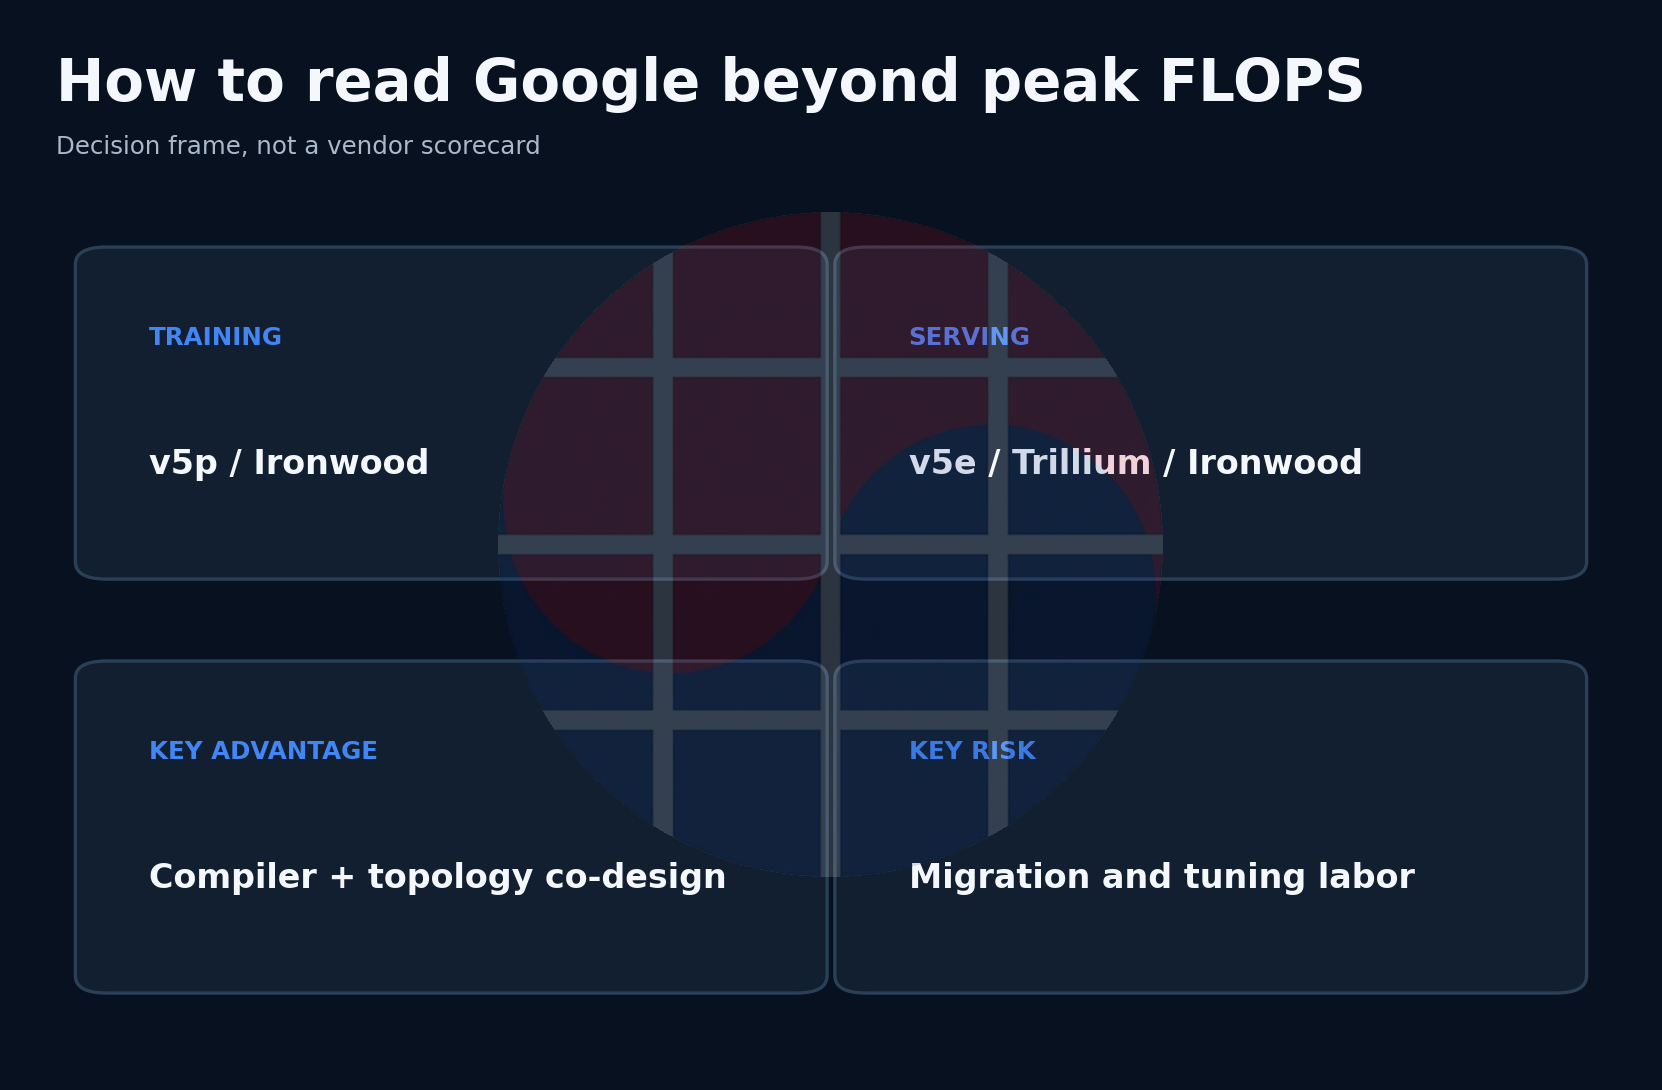
내 결론이 틀릴 가장 큰 조건은 model architecture 변화 속도가 Google의 compiler·silicon co-design보다 빨라지는 경우다. sparse MoE, state-space model, multimodal preprocessing, agent runtime은 matrix multiplication 이외의 비중을 높인다. Google은 vector unit, SparseCore, Pallas로 대응하지만, GPU의 SIMT 유연성과 CUDA ecosystem이 새로운 operator를 더 빨리 흡수할 수 있다.
또 하나는 customer boundary다. Google 내부 팀은 hardware designers와 compiler engineers에 가까운 지원을 받을 수 있지만 외부 고객은 동일한 optimization loop를 갖기 어렵다. Ironwood의 공식 peak가 압도적이어도 외부 고객의 usable model coverage, reservation availability, migration labor를 포함한 비용이 GPU보다 낮지 않다면 TPU는 Google 내부 AI 공장의 우위로 남고 범용 merchant platform을 대체하지 못한다.
Korean lens
한국 공급망 관점에서 TPU는 HBM 수요만 보면 부족하다. 세대가 갈수록 HBM capacity와 bandwidth, advanced packaging, optical connectivity, liquid cooling, power delivery가 함께 증가한다. Ironwood 9,216-chip Pod는 accelerator die 수보다 HBM stack, substrate, optical module, switch, rack power와 유지보수 부품의 qualified output이 deployment 속도를 제한할 수 있다.
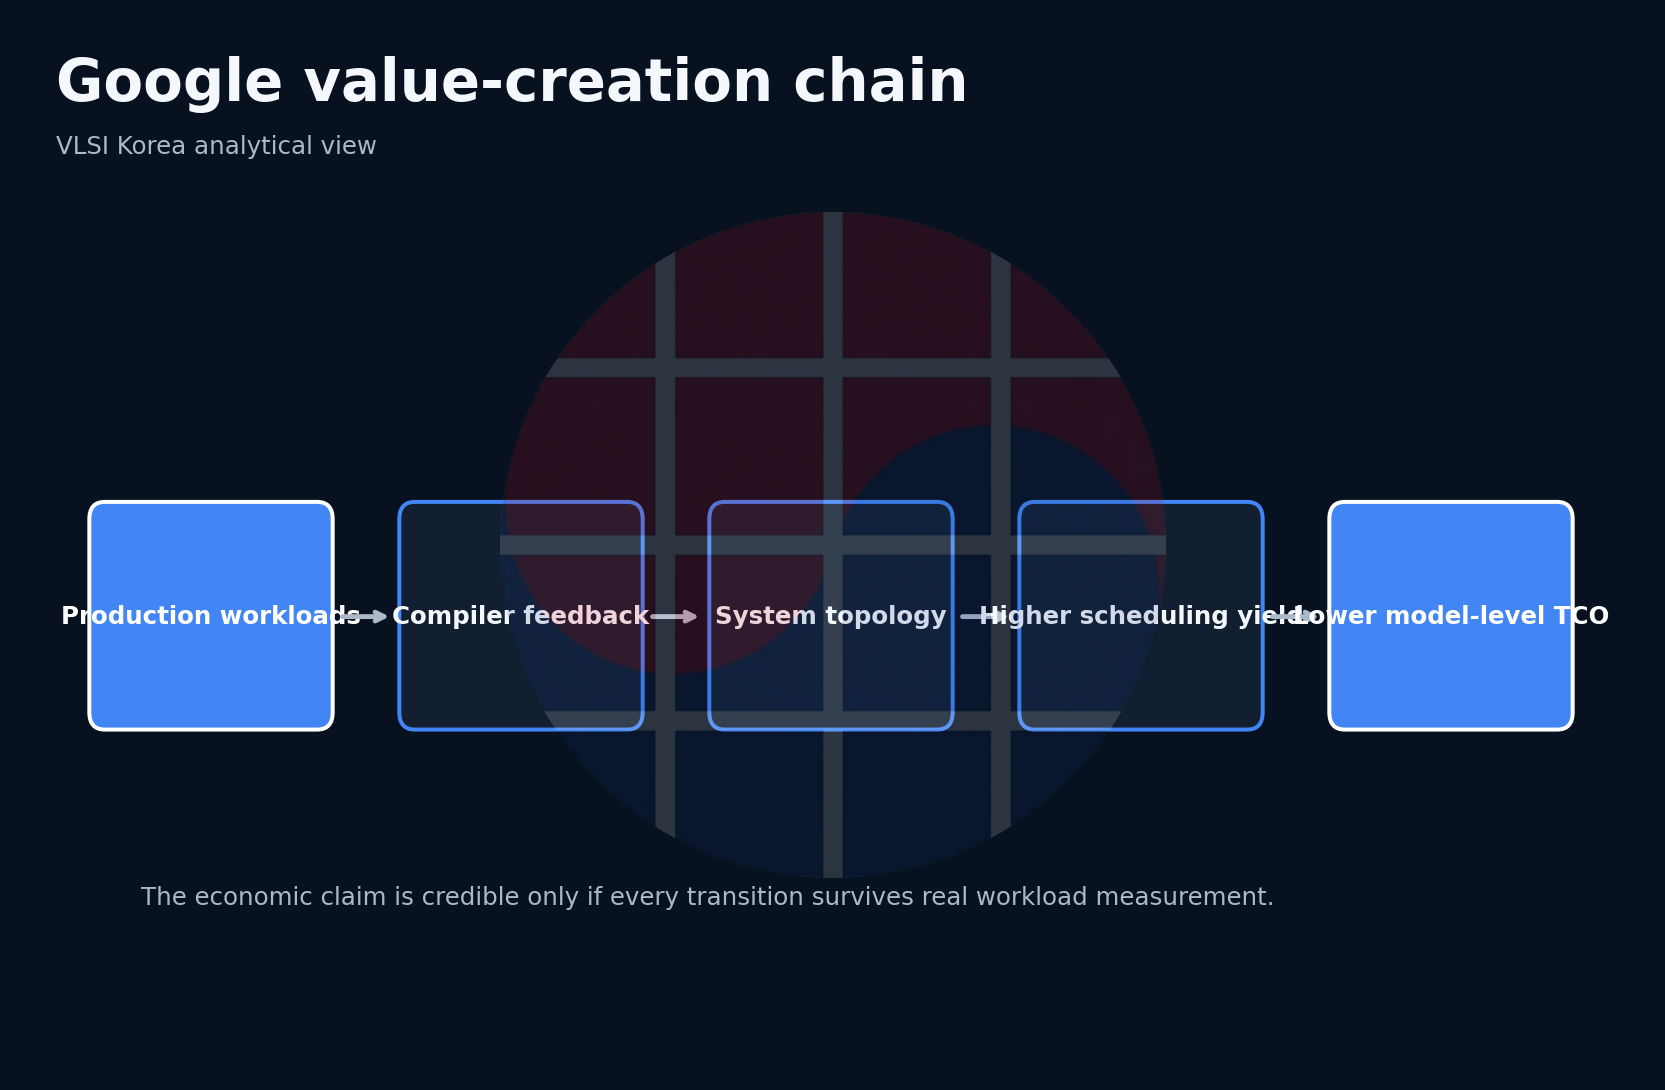
국내 NPU 기업이 배울 점은 systolic array를 만드는 법보다 세대의 연속성이다. 첫 칩에서 최고 peak를 만들기보다 compiler IR, kernel library, runtime observability, interconnect collective를 다음 세대에 재사용해야 한다. 고객의 모델이 바뀌어도 software surface와 operational tooling이 남아 있어야 ASIC 원가 절감이 실제 TCO로 전환된다.
Sources
- In-Datacenter Performance Analysis of a Tensor Processing Unit
- Cloud TPU architecture
- TPU v3 specifications
- TPU v4 specifications
- TPU v5e specifications
- TPU v5p specifications
- Introducing Trillium
- TPU v6e specifications
- TPU7x Ironwood specifications
- Training large models on Ironwood
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.