VLSI Korea
GPU 메모리는 왜 계속 커질까
모델이 들어가는 것과 서비스가 돌아가는 것은 다르다. 70B 모델의 메모리 장부를 따라가면, 긴 대화와 동시 처리 성능이 왜 GPU 옆의 HBM에 달려 있는지 보인다.


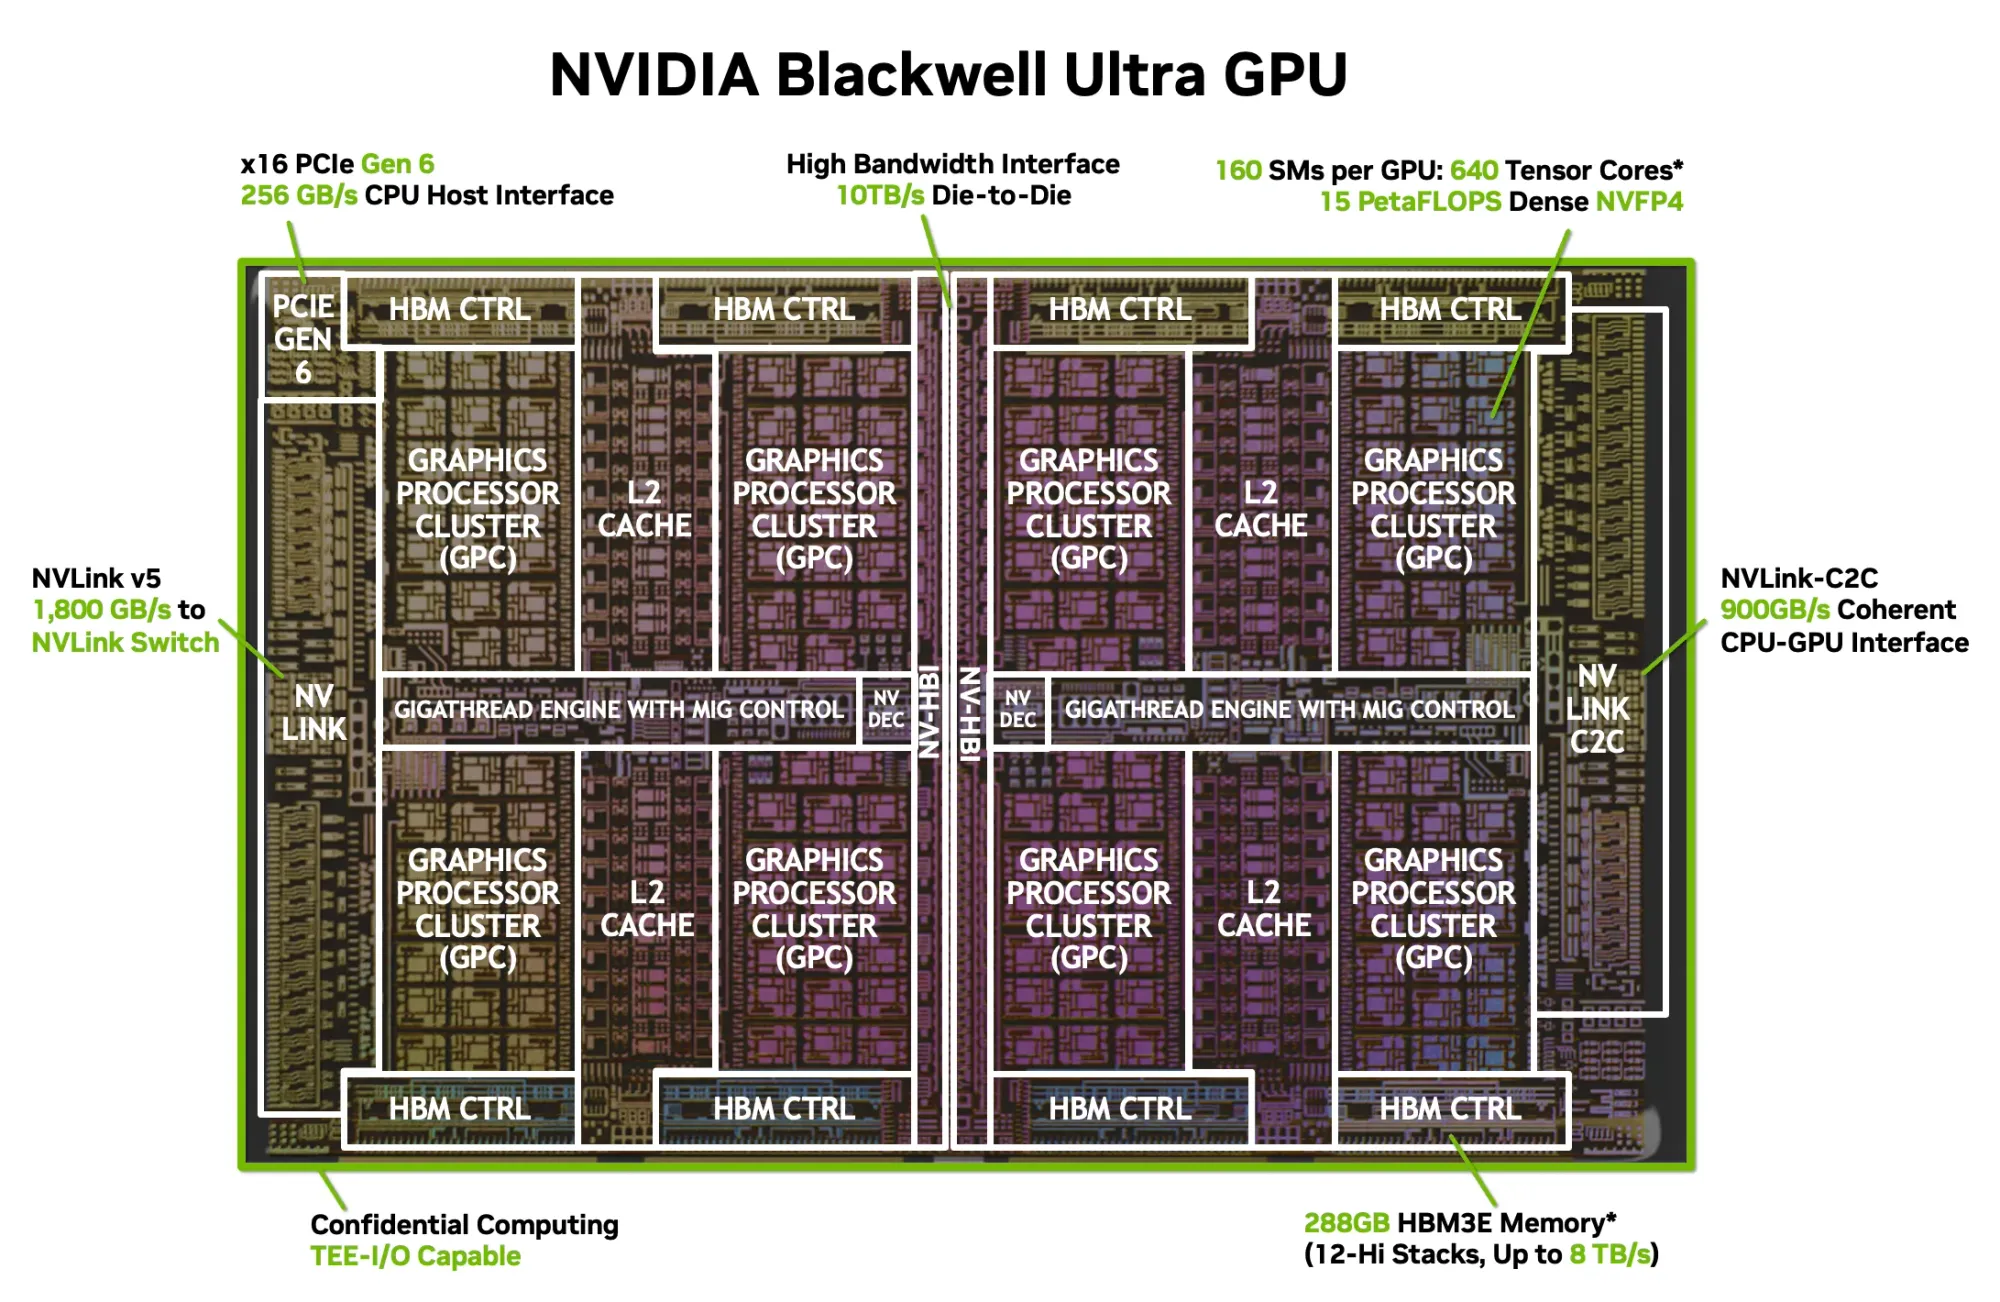
위의 NVIDIA Blackwell Ultra 패키지에서 중앙의 큰 연산 칩 주변에 놓인 작은 직사각형들은 메모리다. DRAM 칩을 여러 층 쌓은 HBM이 여덟 묶음 들어간다. 공개된 최대 용량은 GPU 하나에 288GB. H100 SXM의 80GB보다 3.6배 크다. 연산 칩을 둘러싼 메모리가 고급 GPU의 사양과 패키지 설계를 함께 바꾸고 있다.[1][3]
큰 AI 모델을 넣으려면 큰 메모리가 필요하다는 설명은 절반만 맞다. 모델이 이미 들어가더라도 사용자가 긴 문서를 붙여 넣거나, 서버가 여러 사람의 답을 동시에 만들기 시작하면 메모리가 다시 부족해진다. 더 큰 HBM을 사는 이유는 모델을 담기 위해서이면서, 같은 연산기를 더 잘 쓰기 위해서다. 그 연결을 이해하려면 저장 용량, 데이터를 읽는 속도, 동시에 진행하는 대화 수를 함께 봐야 한다.
용량과 대역폭은 서로 다른 질문에 답한다
GPU의 연산기는 숫자를 곱하고 더한다. 계산에 쓸 숫자는 GPU 옆 메모리에서 가져온다. HBM은 High Bandwidth Memory의 약자로, 많은 신호선을 병렬로 연결해 큰 데이터를 짧은 거리로 운반하는 DRAM이다. 연산 중간에 쓸 작은 데이터는 연산 칩 안의 더 빠른 메모리에도 보관하지만, 수십~수백 GB짜리 모델 전체는 그 안에 들어가지 않는다.
여기서 용량은 ‘계산할 데이터를 곁에 얼마나 남겨 둘 수 있는가’, 대역폭은 ‘그중 초당 몇 byte를 읽고 쓸 수 있는가’를 뜻한다. 물탱크를 크게 만든다고 배관이 저절로 넓어지지 않듯, 용량 증가율과 대역폭 증가율은 같지 않다.
NVIDIA H200은 이를 보기 좋은 비교 대상이다. H100과 같은 Hopper 아키텍처를 사용하면서 HBM을 더 크고 빠르게 바꿨다. SXM 제품끼리 비교하면 용량은 80GB에서 141GB로 약 76% 늘었고, 대역폭은 3.35TB/s에서 4.8TB/s로 약 43% 늘었다. 다음 두 증가분이 서로 다른 문제를 푼다.[2][3]
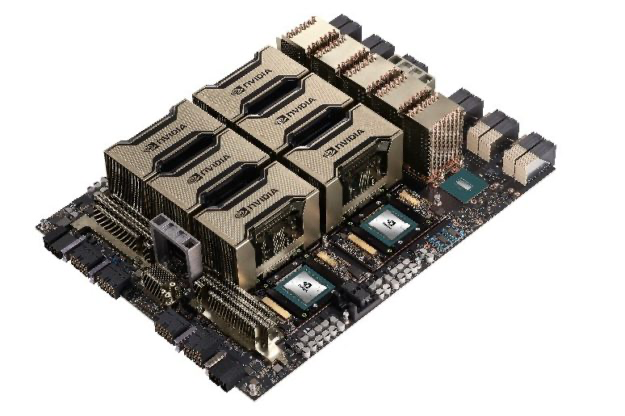
| GPU | Published HBM capacity | Peak memory bandwidth |
|---|---|---|
| H100 SXM | 80 GB | 3.35 TB/s |
| H200 SXM | 141 GB | 4.8 TB/s |
| Blackwell Ultra | Up to 288 GB | Up to 8 TB/s |
Table 1. Published specifications, not a performance ranking. Blackwell Ultra capacity varies by SKU. Sources: NVIDIA [1–3].
모델을 올리고 나면, 대화를 위한 공간이 필요하다
먼저 GPU 메모리의 장부를 세 칸으로 나눠 보자. 첫째는 학습으로 얻은 숫자들, 즉 가중치(weight)다. 질문이 달라도 같은 모델의 가중치는 함께 사용할 수 있다. 둘째는 각각의 대화를 이어 가기 위해 저장하는 상태다. 셋째는 계산 중간 결과와 실행 도구가 사용하는 작업 공간이다. 이 글은 모델을 학습시키는 과정이 아니라, 학습된 언어 모델이 답을 만드는 추론을 중심으로 본다.
가중치부터 계산하면 크기가 실감 난다. 70B는 약 700억 개의 매개변수를 뜻한다. 숫자 하나를 16-bit 형식인 BF16으로 저장하면 2byte이므로, 700억 × 2byte = 약 140GB다. 숫자를 8-bit로 줄이면 원시 가중치는 약 70GB, 4-bit면 약 35GB가 된다. 여기에는 변환에 필요한 보조 숫자나 작업 공간이 빠져 있다. ‘70B 모델’이라는 반올림된 이름을 쓴 근삿값이지, 실제 실행 파일의 정확한 크기가 아니다.[4][8]
그래서 141GB HBM에 140GB 가중치가 들어간다고 해서 곧바로 긴 대화를 서비스할 수 있다고 판단하면 안 된다. 아직 두 번째와 세 번째 칸이 남아 있다. 메모리가 부족하면 조금 느려지는 정도로 끝나지 않고, 실행 도구가 추가 공간을 확보하지 못해 오류를 내거나 동시 요청 수를 낮춰야 한다. 명목 용량만 보고 ‘모델이 들어간다’를 ‘서비스가 된다’로 바꾸면 여기서 계산이 틀어진다.[8]
AI가 앞의 말을 기억할수록 메모리가 늘어난다
언어 모델은 문장을 token이라는 작은 단위로 나눠 다룬다. token은 단어 하나와 같지 않으며, 언어나 표현에 따라 단어의 일부가 될 수도 있다. 입력 문서를 한꺼번에 읽고 계산하는 단계를 prefill, 이후 답을 한 token씩 생성하는 단계를 decode라고 부른다. 일반적인 자기회귀 생성에서는 앞 token이 정해져야 다음 token을 이어 만들 수 있다.
새 token을 만들 때는 앞서 읽은 내용 중 무엇을 참고할지 결정해야 한다. 이를 위해 과거 token에서 계산한 두 종류의 숫자 묶음을 보관한다. 현재 질문과 관련성을 비교할 key, 그 비교 결과에 따라 가져올 내용을 표현하는 value다. 이 둘의 저장 공간이 KV cache다. 모델을 다시 학습시키는 기억이 아니라, 해당 요청의 계산 결과를 재사용하는 메모리다.[4][5]
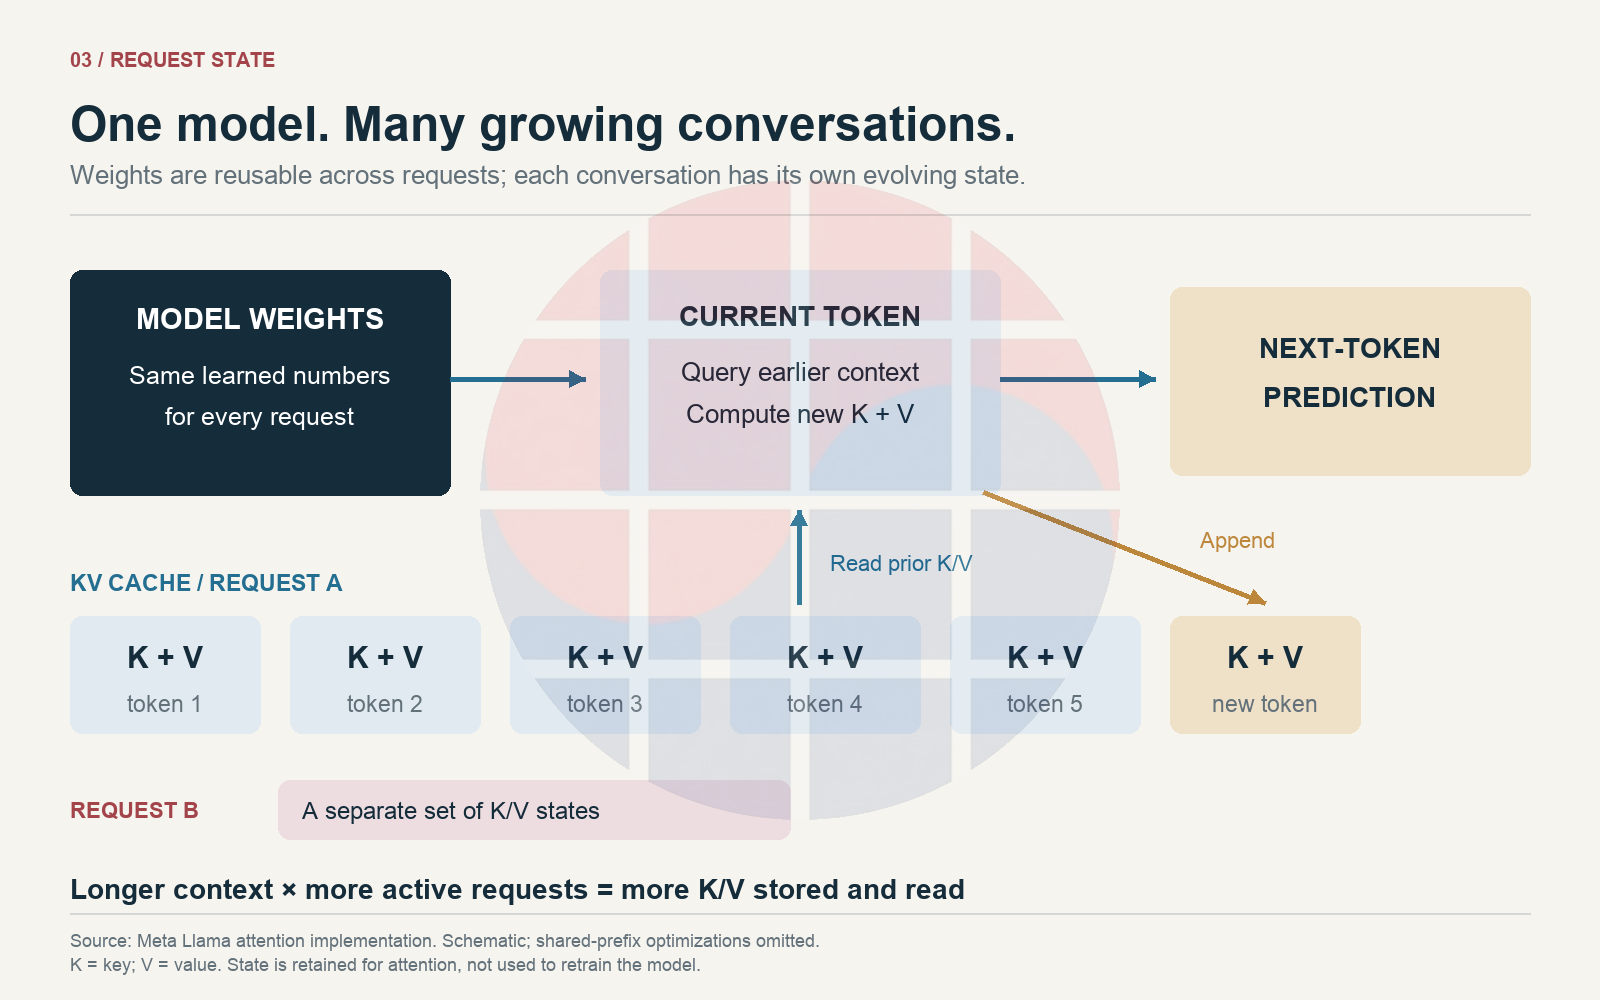
KV cache 덕분에 과거 token의 key와 value를 매번 처음부터 계산하지 않아도 된다. 대신 이전 상태를 계속 저장하고 읽어야 한다. 긴 대화는 저장량과 읽는 양을 함께 키운다. 같은 길이의 대화가 여러 개 동시에 진행되면, 서로 다른 대화의 상태도 각각 필요하다. 공통 문맥을 공유하는 최적화가 없다면 대화 길이와 요청 수가 모두 용량에 곱해진다.
Meta Llama 3.1 70B의 공개 설정으로 계산해 보자. 계산 층은 80개이고, 각 층은 token마다 8개의 KV head를 저장한다. head는 정보를 나눠 처리하는 묶음이며, 여기서는 묶음 하나가 128개의 숫자를 갖는다. key와 value 두 종류를 BF16으로 저장하므로 token당 용량은 2 × 80 × 8 × 128 × 2byte = 327,680byte, 즉 320KiB다.[4][5]
8,192token이면 요청 하나에 2.5GiB, 131,072token이면 40GiB다. 여기서 GiB는 2³⁰byte이고, GB는 10억 byte다. 따라서 40GiB는 약 42.95GB다. 입력뿐 아니라 생성된 token도 전체 문맥 길이에 포함되며, 실제 서비스는 설정한 최대 문맥 한도 안에서 이를 나눠 쓴다. 이 모델에서 길이가 16배가 되면 KV cache도 16배가 되는 셈이다.
이미 메모리를 아낀 구조인데도 이 정도다. Llama 3.1 70B는 정보를 조회하는 64개 query head가 8개 KV head를 나눠 쓰는 GQA(Grouped-Query Attention)를 쓴다. 만약 KV head도 64개였다면 다른 조건이 같을 때 위 용량이 8배가 된다. GQA는 모델 구조 단계에서 저장량을 줄이는 방법이며, 모든 모델이 같은 KV cache 크기를 갖지 않는 이유이기도 하다.[4][6]
여유 메모리는 긴 대화와 동시 처리 사이에서 나눠 쓴다
가중치와 작업 공간을 제외하고 KV cache에 쓸 수 있는 공간이 40GiB 남았다고 가정하자. 위 조건에서는 128K 길이의 요청 하나, 또는 8K 길이의 요청 16개를 담을 수 있다. 두 서비스는 같은 메모리를 쓰지만 사용자 경험과 처리량이 다르다. 이 숫자는 저장 가능량을 설명하는 계산이며, 응답 속도까지 보장하는 동시 접속자 수는 아니다.
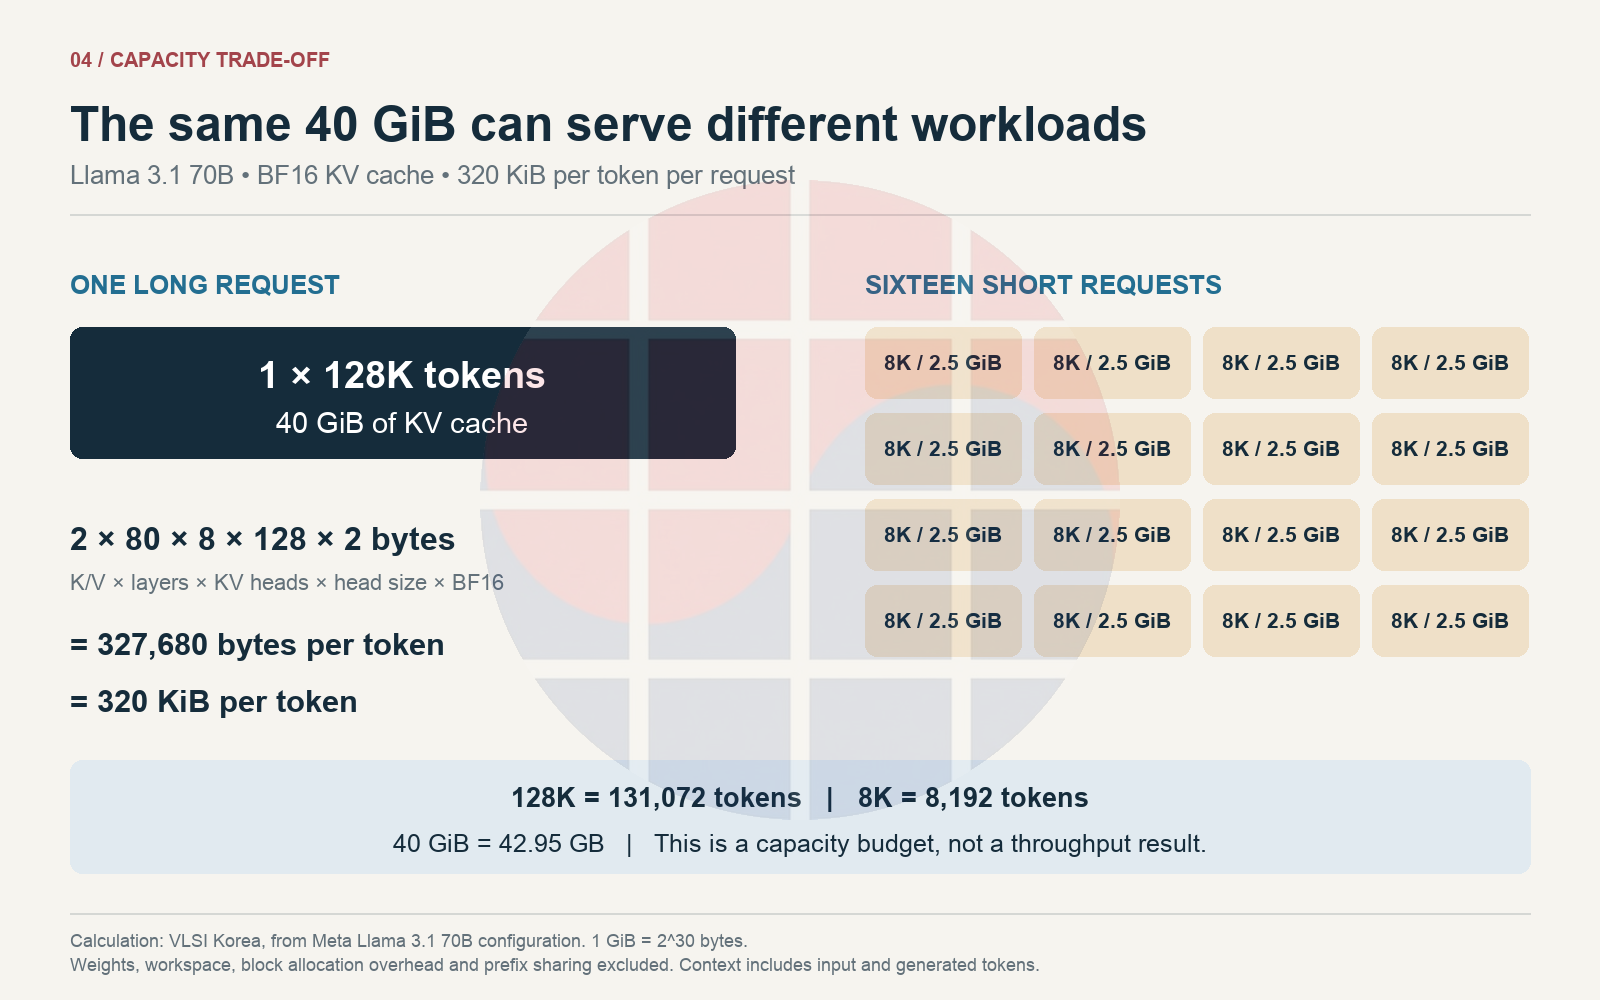
큰 모델을 올리는 데 용량을 거의 다 쓰면, 서버에는 여러 요청을 함께 진행할 공간이 남지 않는다. 반대로 더 큰 HBM은 같은 모델을 유지한 채 긴 문서를 받거나, 동시에 계산할 요청 수를 늘릴 선택권을 준다. 메모리 용량은 지원 가능한 모델의 크기뿐 아니라 서비스를 어떻게 운영할지도 결정한다.
여러 사람의 답을 묶으면, 가중치를 읽는 비용을 나눌 수 있다
이제 용량이 속도로 이어지는 지점이다. 한 사용자의 다음 token을 만들 때, 큰 행렬로 저장된 가중치의 상당 부분을 읽어 계산한다. 연산기는 빨라도 숫자가 도착하는 속도가 느리면 기다려야 한다. 특히 적은 수의 요청을 처리하는 decode는 읽어 온 데이터에 비해 수행하는 계산이 적어 메모리 대역폭의 제약을 받기 쉽다.[7]
크기 감각을 잡기 위해, 한 단계에서 읽을 가중치를 70GB로 놓고 H200의 최대 대역폭 4,800GB/s로 나누면 약 14.6ms다. 이는 그 양의 데이터를 완벽하게 연속 전송할 때의 시간이다. KV cache 읽기, 중간 결과, 계산, 비효율을 빼 놓았으므로 실제 token 지연시간이나 벤치마크가 아니다. 연산 코어의 숫자만으로 답이 나오는 속도를 계산할 수 없다는 뜻이다.[2]
엔지니어는 여러 사람의 ‘다음 token’ 계산을 한 묶음으로 모은다. 이를 batching이라고 한다. 각 사람의 대화 내용은 다르지만 사용하는 모델 가중치는 같다. GPU가 가중치의 작은 블록을 빠른 내부 메모리로 가져왔을 때, 이를 여러 요청의 계산에 재사용하면 가중치를 옮기는 비용을 나눌 수 있다. 전체 모델을 내부 메모리에 한꺼번에 넣는다는 뜻은 아니다.[7]
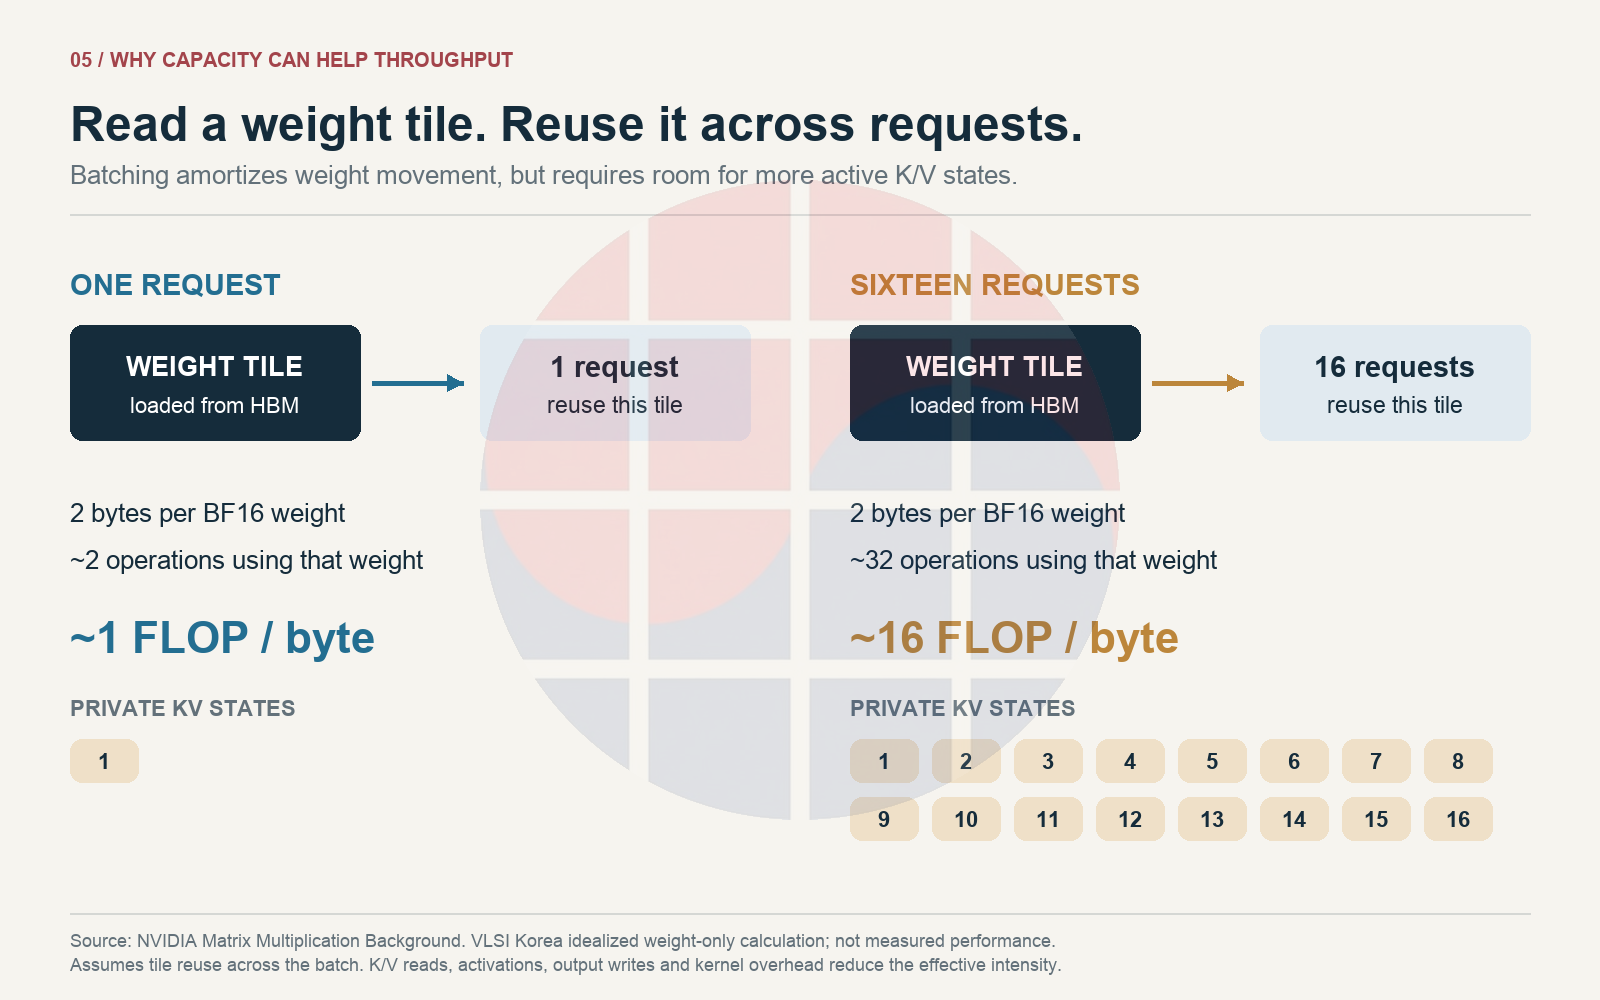
단순화하면 BF16 가중치 하나를 읽는 데 2byte, 한 요청에 곱셈과 덧셈을 하는 데 약 2회 연산이 든다. 한 요청만 처리하면 약 1FLOP/byte다. 같은 가중치를 16개 요청에 재사용하면 가중치 읽기만 고려한 이상적 비율은 약 16FLOP/byte로 올라간다. 데이터 1byte를 옮겨 얼마나 많이 계산하는지를 나타내는 이 비율이 연산 집약도다. 비율이 커지면 놀던 연산기를 더 채울 수 있다.[7]
그런데 16개 요청을 묶으려면 16개 요청의 KV cache를 보관해야 한다. HBM 용량 증가 → 함께 처리할 요청 증가 → 가중치 재사용 증가 → 처리량 개선이라는 연결이 여기서 생긴다. 용량이 대역폭 자체를 높이는 것은 아니지만, 한 번 옮긴 가중치로 더 많은 일을 하게 만들 수 있다.
실제 홍보 수치도 이 관점으로 읽어야 한다. NVIDIA의 H200 페이지는 Llama 2 70B 추론에서 1.9배 처리량을 제시하면서, 조건에 H100은 한 번에 8개 요청, H200은 32개 요청을 처리했다고 적었다. 입력 2K·출력 128token 조건의 회사 측 비교다. 이를 한 사용자의 답이 1.9배 빨라졌다는 뜻이나, 메모리 용량만의 효과로 해석할 수 없다. 더 큰 묶음을 처리한 시스템 전체의 결과다.[2]
묶음을 무한히 키울 수도 없다. KV cache를 읽는 양과 계산량이 늘고, 묶음 하나를 처리하는 시간이 길어지며, 요청을 모으는 정책에 따라 대기시간도 생긴다. 운영자는 초당 전체 token 수와 사용자 한 명이 다음 token을 기다리는 시간을 함께 맞춰야 한다. 충분한 HBM이 생기면 다음 한계는 연산 처리량, KV 읽기 대역폭, 또는 응답시간 목표로 이동한다.
공간이 부족하면, 줄이거나 나누거나 밖으로 보낸다
첫 번째 해법은 저장하는 byte 자체를 줄이는 것이다. 앞의 140GB를 70GB나 35GB로 낮추는 양자화가 여기에 속한다. 다만 숫자를 표현할 수 있는 범위와 정밀도가 달라지므로 모델·작업별 품질 검증이 필요하고, 크기를 복원하는 보조값과 변환 연산도 생긴다. 가중치를 4-bit로 바꿨다고 KV cache까지 자동으로 4-bit가 되는 것도 아니다. 둘은 별도로 선택하는 설계다.[9]
두 번째는 비어 있거나 중복된 공간을 되찾는 것이다. 요청마다 최대 길이의 연속 공간을 미리 잡으면 짧게 끝나는 대화에서 낭비가 생긴다. vLLM의 PagedAttention은 KV cache를 작은 블록으로 나눠 필요할 때 배정하고, 흩어진 블록을 찾아 읽는다. 페이지를 관리하는 비용을 들여 단편화와 중복을 줄이는 방법이다. 실제 40GiB의 서로 다른 상태를 손실 없이 갑자기 4GiB로 압축하는 기술은 아니다.[10]
세 번째는 HBM까지 왕복하는 중간 데이터를 줄이는 것이다. FlashAttention은 attention 계산을 작은 타일로 나누고 칩 내부의 빠른 메모리를 활용해 중간 행렬을 HBM에 쓰고 다시 읽는 일을 줄인다. 계산 순서와 데이터 배치를 바꿔 전송 부담을 낮추지만, 모델 가중치나 지속적으로 필요한 KV cache 전체를 없애지는 않는다. 같은 ‘메모리 최적화’라도 PagedAttention과 해결하는 낭비가 다르다.[11]
그래도 부족하면 모델을 여러 GPU에 나눠 올린다. 행렬 계산을 나눠 맡는 tensor parallelism에서는 각 GPU가 계산한 일부 결과를 합치는 통신이 필요하다. GPU를 추가하면 메모리와 연산력은 늘지만, 통신과 동기화 비용도 늘어난다. 더 큰 HBM으로 분할 수를 줄일 수 있어도 무조건 더 빠른 것은 아니다. GPU 수를 줄인 만큼 합산 연산력과 메모리 대역폭도 줄기 때문이다.[12]
또는 덜 급한 데이터를 CPU 메모리에 두고 필요할 때 가져온다. 이런 offload는 느린 메모리를 용량 확장에 쓰는 방법이다. CPU 메모리와 GPU 메모리를 하나의 주소 공간으로 보이게 해도 물리적 거리는 사라지지 않는다. NVIDIA의 CPU–GPU 메모리 공유 자료도 용량 부족을 해소하는 경로를 보여주지만, HBM과 같은 속도를 약속하지 않는다. 자주 읽는 데이터가 연결 경로를 반복해서 건너면 전송이 새 병목이 된다.[8]
9월 10일 발표된 d-Matrix의 NVLink Fusion 채택도 추론 칩이 서버와 랙의 연결 구조를 함께 설계하는 사례다. 개별 칩의 사양을 넘어 데이터가 어디에 있고 어떻게 이동하는지가 배치 규모를 결정한다. 다만 이 발표 자체가 HBM 용량 증가의 성능 효과를 검증한 벤치마크는 아니다.[15]
메모리를 더 붙이자, 패키지가 어려워졌다
처음의 Blackwell Ultra로 돌아가 보자. 288GB는 여덟 개의 12층 HBM 묶음으로 구성된다. 공개 구조도에는 메모리 제어 회로가 연산 칩 가장자리를 따라 자리 잡고 있다. 총 8,192-bit의 넓은 인터페이스는 많은 데이터를 동시에 옮기지만, 그만큼 신호선과 접속점, 제어 회로가 필요하다. HBM을 늘리는 일이 보드의 빈 소켓에 메모리를 꽂는 작업과 다른 이유다.[1]
용량을 늘리는 경로는 세 가지다. DRAM 한 장에 더 많은 bit를 넣거나, 한 묶음에 더 많은 장을 쌓거나, GPU 주변의 묶음 수를 늘린다. Micron의 HBM3E 제품은 8층 24GB에서 12층 36GB로, 같은 배치 위치당 용량을 50% 높였다. 더 높이 쌓으면 가로 면적을 아낄 수 있지만, 얇은 칩들을 정렬·접합하고 층 사이를 연결하는 공정의 중요성이 커진다.[13]
층 사이 신호는 실리콘을 관통하는 TSV라는 미세 연결을 통해 이동한다. 여러 층의 접속과 열 배출을 함께 관리해야 하므로 단순히 DRAM 장수만 늘린다고 완성되는 제품이 아니다. 반대로 묶음을 옆으로 더 놓으면 GPU와 HBM을 연결할 패키지 면적과 배선 공간이 커진다. 더 넓은 조립체는 휘어짐과 접합 신뢰성도 관리해야 한다.[13][16]
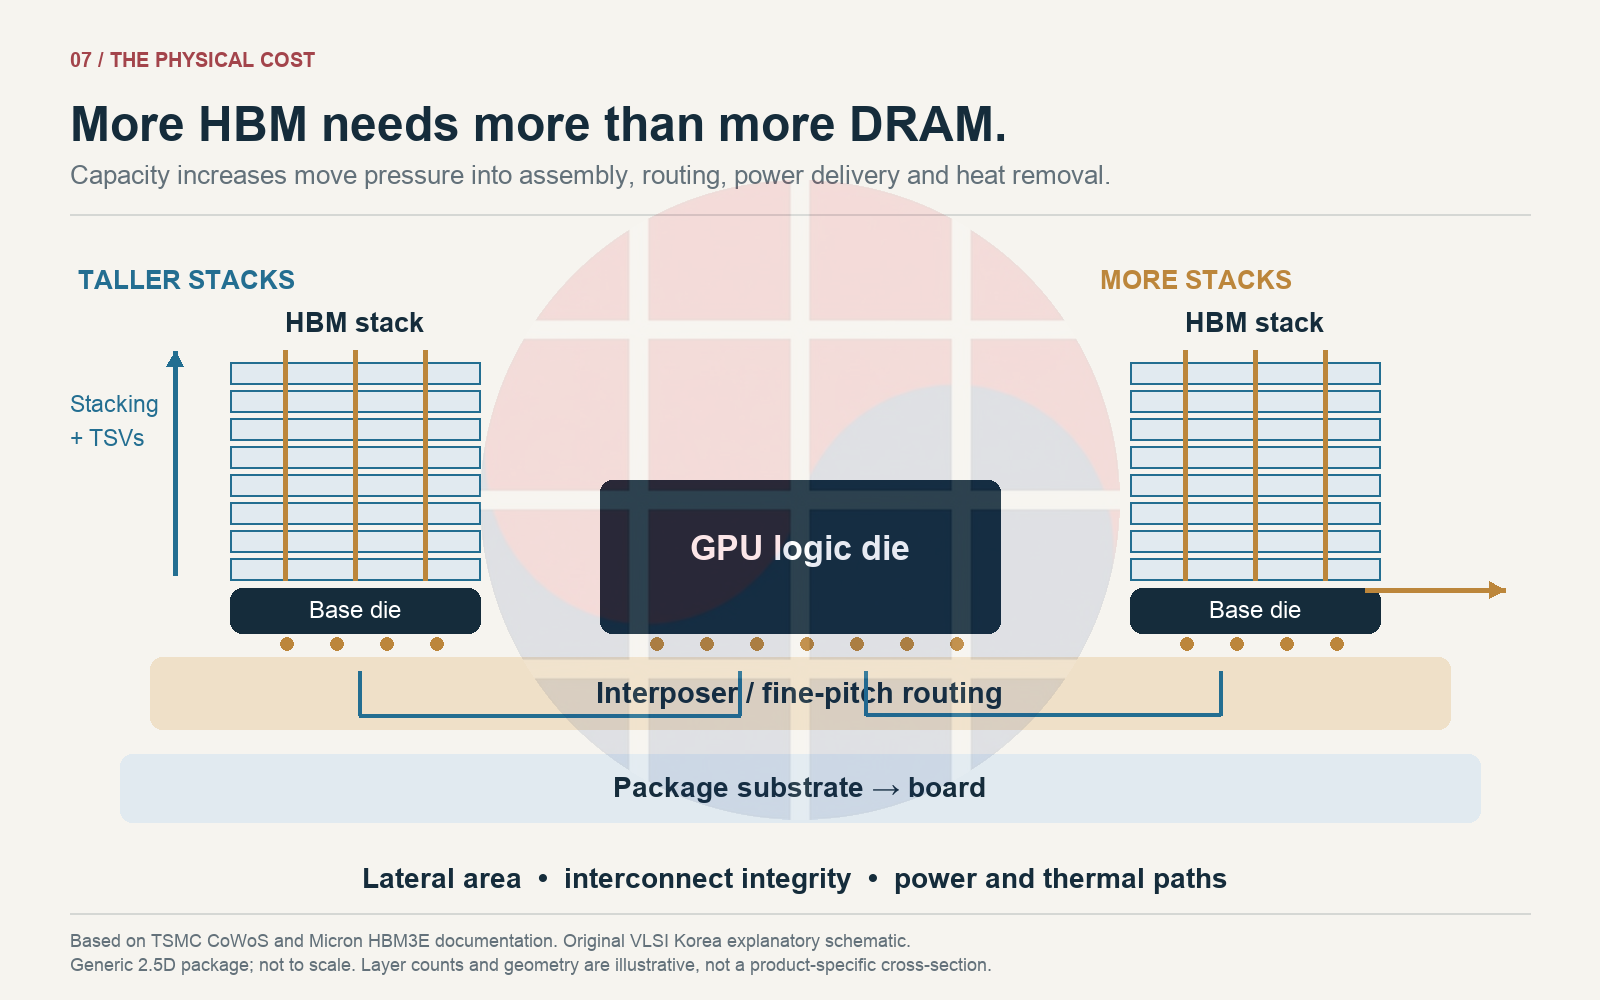
TSMC의 CoWoS는 이런 로직 칩과 HBM을 한 패키지로 묶는 기술이다. 중간 연결층인 interposer가 미세한 배선을 제공하며, CoWoS-L은 국소 실리콘 연결과 재배선 구조를 결합한다. 메모리를 가까이 둬 얻은 전송 이점의 반대편에는 큰 면적의 정밀 조립, 전력 공급, 열 관리가 있다. HBM 공급과 패키징 생산능력이 함께 맞아야 완제품 GPU가 나온다.[14]
희소한 것은 DRAM bit만이 아니다
이 구조에서 공급의 가치는 일반 DRAM 생산량만으로 결정되지 않는다. 요구한 속도와 전력 조건을 만족하는 HBM 묶음, 이를 로직 칩과 연결할 패키징 공정, 정상 접속을 확인하는 검사 능력이 함께 필요하다. Micron 같은 메모리 업체와 TSMC 같은 패키징 제공자의 기술이 만나는 지점이다. 어느 한 단계의 생산량만 늘려서는 출하 가능한 패키지가 같은 비율로 늘지 않는다.
더 큰 HBM이 언제나 더 큰 이익을 보장하지도 않는다. 고객이 지불할 근거는 ‘GB가 늘었다’가 아니라, 같은 품질과 응답시간 조건에서 처리할 요청이 얼마나 늘었는가다. 양자화나 cache 관리가 필요한 byte를 줄이면 같은 하드웨어로 더 많은 요청을 받을 수 있다. 반대로 긴 문맥과 더 많은 동시 요청이 그 여유를 다시 채우면 HBM과 패키징 수요는 또 커진다.
GPU 메모리가 계속 커지는 이유는 세 단계로 이어진다. 먼저 모델이 들어가야 하고, 그다음 대화의 상태가 들어가야 하며, 마지막으로 여러 요청을 묶어 비싼 연산기를 충분히 활용해야 한다. 큰 HBM의 경제성은 그 공간을 실제 처리량으로 바꿀 수 있을 때 생긴다. 이제 GPU의 GB 숫자를 볼 때는 모델 크기와 함께 문맥 길이, 동시 요청 수, 대역폭, 그리고 그 모두를 묶어 내는 패키지를 봐야 한다.
Sources
- NVIDIA, Inside NVIDIA Blackwell Ultra, 2025-08-22. Package illustration, architecture, 288GB, eight 12-Hi stacks, 8,192-bit interface and 8TB/s.
- NVIDIA, H200 GPU. H200 SXM specifications and Llama 2 70B comparison conditions; vendor-reported preliminary performance.
- NVIDIA, HGX H100/H200/B200 Components. H100/H200 SXM memory specifications and HGX baseboard image.
- Meta, Llama model configurations and Llama 3.1 model card. Llama 3.1 70B: 80 layers, 64 query heads, 8 KV heads, dimension 8,192, 128K context.
- Meta, Llama attention implementation. K/V cache allocation, update and attention reads.
- Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, 2023. Grouped query/key-value head mechanism.
- NVIDIA, Matrix Multiplication Background User's Guide and GPU Performance Background. Arithmetic intensity, tiling and memory/compute limits.
- NVIDIA, LLM Inference and KV Cache Offload with CPU–GPU Memory Sharing, 2025-09-05. Model memory, allocation failure and offload mechanism.
- NVIDIA, Working with Quantized Types. Low-precision storage, scales, accuracy and conversion overhead.
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, 2023. Allocation fragmentation and cache sharing.
- Dao et al., FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, 2022. Tiled attention and reduced HBM traffic.
- NVIDIA, Megatron Core tensor parallel mappings. Split, gather and reduction operations across devices.
- Micron, HBM3E and HBM3E volume production announcement, 2024-02-26. 24GB/8H, 36GB/12H and TSV integration.
- TSMC, CoWoS platform. Interposer options and logic/HBM integration.
- NVIDIA, d-Matrix Adopts NVLink Fusion, 2026-09-10. Recent rack-scale inference infrastructure decision.
- TSMC, Wafer-Level Integration of an Advanced Logic-Memory System Through the Second-Generation CoWoS Technology, IEEE Transactions on Electron Devices, 2017. Large-package warpage and yield engineering.
편집 노트
자료 확인일은 2026년 9월 13일이다. 공식 제품 이미지는 원본 출처를 표시했고, 직접 작성한 설명도는 VLSI Korea로 표시했다. 용량·전송시간·연산 집약도 계산은 본문에 적힌 조건의 추정이며 측정 성능이 아니다. 제품 사양은 제조사의 GB 표기를 보존하고, KV cache 계산은 byte에서 GiB로 환산했다. 이 글은 이메일과 구독자 알림이 없는 preview/sample이다.
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.