VLSI Korea
AI가 고친 HLS, ‘PASS’는 어디까지 보증하나
실행 가능한 테스트는 자동 수정의 출발점이다. 테스트 입력, 결과 판정, 합성 후 검증을 구분해야 소스 코드의 성공을 하드웨어의 성공으로 잘못 읽지 않는다.


HLS 코드 수정 도구가 초록색 PASS를 표시했다. 이 결과를 믿고 가속기 설계를 다음 단계로 넘겨도 될까. 답은 그 표시를 만든 검사에 달려 있다. 컴파일러가 코드를 받아들였다는 뜻일 수도 있고, 준비한 입력의 출력이 기준값과 같았다는 뜻일 수도 있다. 회로를 합성해 검증했다는 뜻은 별도의 근거가 필요하다. 엔지니어가 받아야 할 결과물은 성공 표시와 함께 그 표시가 다루는 범위를 설명하는 기록이다.
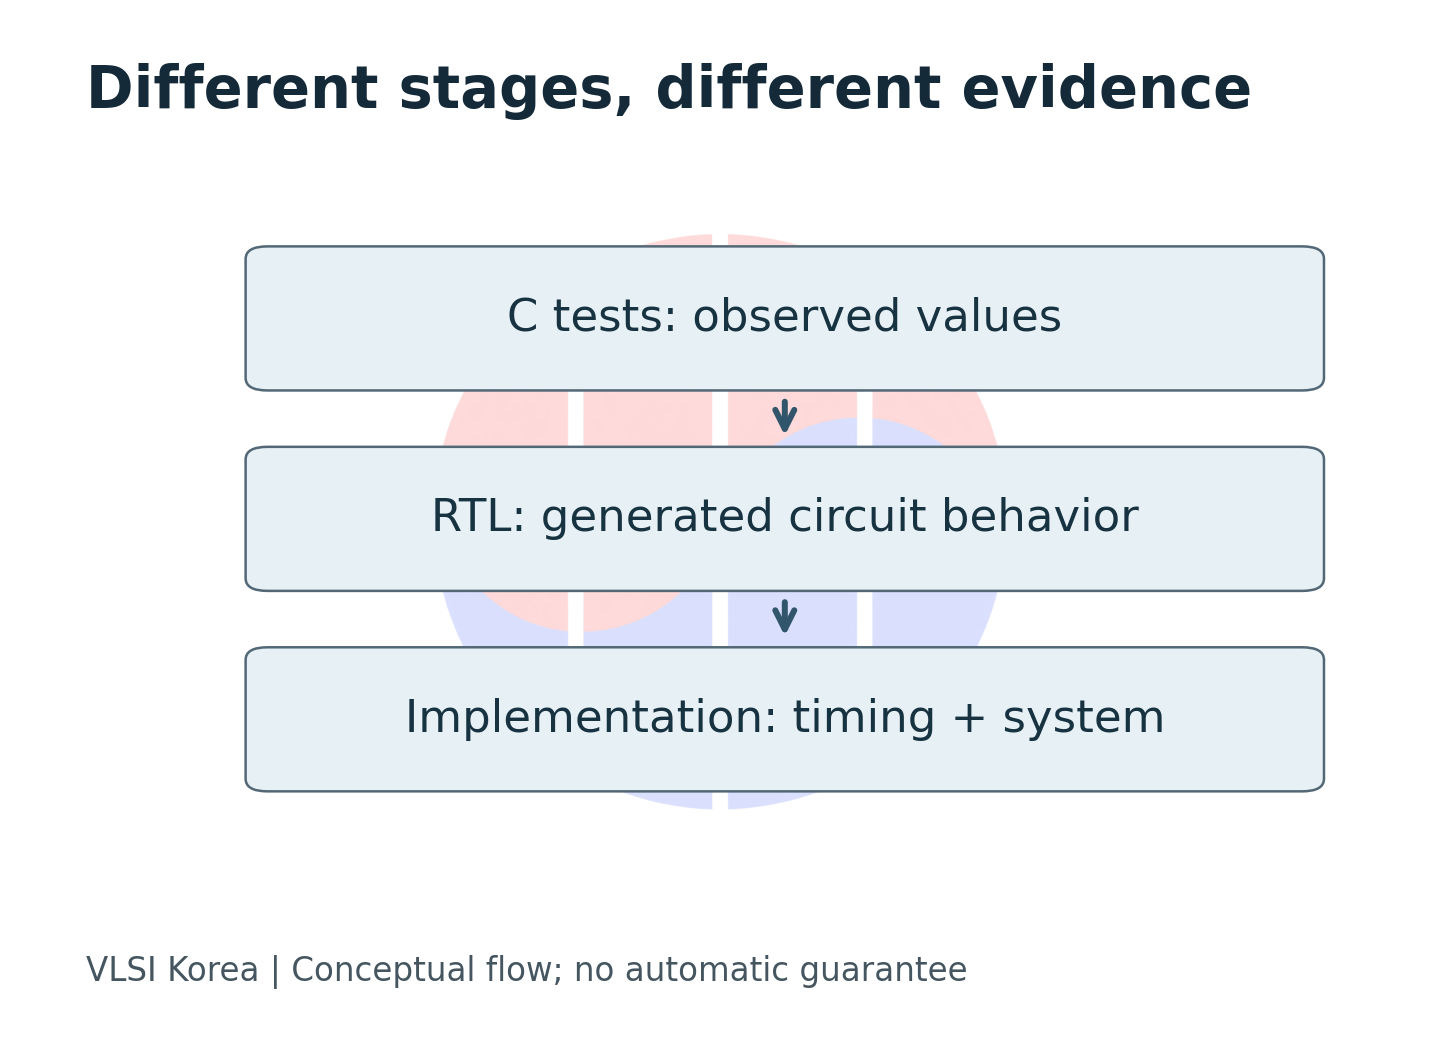
최근 공개 목록에 오른 뉴햄프셔대 연구진의 HLS 자동 수정 연구는 이 질문을 다시 꺼내게 한다. 연구진은 125개 버그 사례를 실행 가능한 판정기로 평가했다. 평가 대상은 C 수준의 기능 수정이며, 합성 후 정확성은 범위 밖이다. 이 구분을 출발점으로, 현업 팀이 어떤 증거를 더 붙여야 하는지 살펴보자. 아래 계산과 검증 예제는 논문 수치를 재현한 것이 아니라 VLSI Korea가 만든 설명용 사례다. 연구 원문
| Study scope | Beyond the reported experiment |
|---|---|
| Executable C-level repair checks | Generated-RTL correctness and physical implementation |
소스 파일의 정답과 칩의 동작 사이
고수준 합성, 즉 High-Level Synthesis는 알고리즘을 표현한 C 또는 C++ 코드를 하드웨어 구조로 옮기는 설계 방식이다. 같은 계산을 어떤 연산기에 배치하고 언제 실행할지 결정해야 하므로, 소프트웨어 실행 결과와 회로 구현의 조건을 함께 다룬다. 여기서 수정 도구가 고친 대상이 알고리즘인지, 합성 지시문인지, 인터페이스인지 먼저 정해야 한다. 서로 다른 대상에 같은 성공 기준을 적용하면 정답은 같아도 요구 성능을 잃은 수정을 받아들일 수 있다.
기사의 실제 사진은 Altera의 초기 FPGA인 Cyclone EP1C3 다이다. 중앙의 논리 배열과 주변 회로는 코드가 최종적으로 물리 자원을 이용해야 한다는 사실을 구체적으로 보여 준다. 2013년에 공개된 역사적 참고 사진으로, 이번 연구의 시험 칩이나 현재 도구의 지원 대상이라는 뜻은 아니다. FPGA는 구성 가능한 논리·배선·메모리·입출력 자원을 비트스트림으로 설정한다. 따라서 C 파일에서 계산이 맞았다는 증거만으로 이러한 자원에 놓인 설계의 인터페이스와 타이밍까지 설명할 수 없다. 사진 원본, Altera의 FPGA 설명
| Evidence | Question answered | Still open |
|---|---|---|
| Compilation | Is this source accepted? | Functional correctness |
| C test | Do observed outputs match? | Untested inputs, RTL behavior |
| RTL co-simulation | Does generated RTL pass these tests? | Physical timing, system behavior |
| Implementation and board test | Does this configured system meet its checks? | Untested operating conditions |
기능 요구사항을 글로 먼저 고정하면 검사 범위가 선명해진다. 예를 들어 ‘입력 배열의 유효 원소를 더한다’에는 유효 길이가 비어 있어도 되는지, 부호와 표현 범위는 무엇인지, 출력이 넘치면 어떻게 처리하는지가 빠져 있다. 이런 빈칸을 구현 코드에서 거꾸로 추측하면 잘못된 구현을 명세로 받아들이기 쉽다. 수정 전후가 같아야 할 동작과 바꿔도 되는 구현 선택을 나누고, 판정기는 그 요구사항을 독립적으로 확인하도록 작성해야 한다.
PASS를 읽을 때 먼저 확인할 것은 성공률이 아니라, 무엇을 입력하고 무엇과 비교했는가다. (VLSI Korea 편집 해석)
테스트도 먼저 실패할 줄 알아야 한다
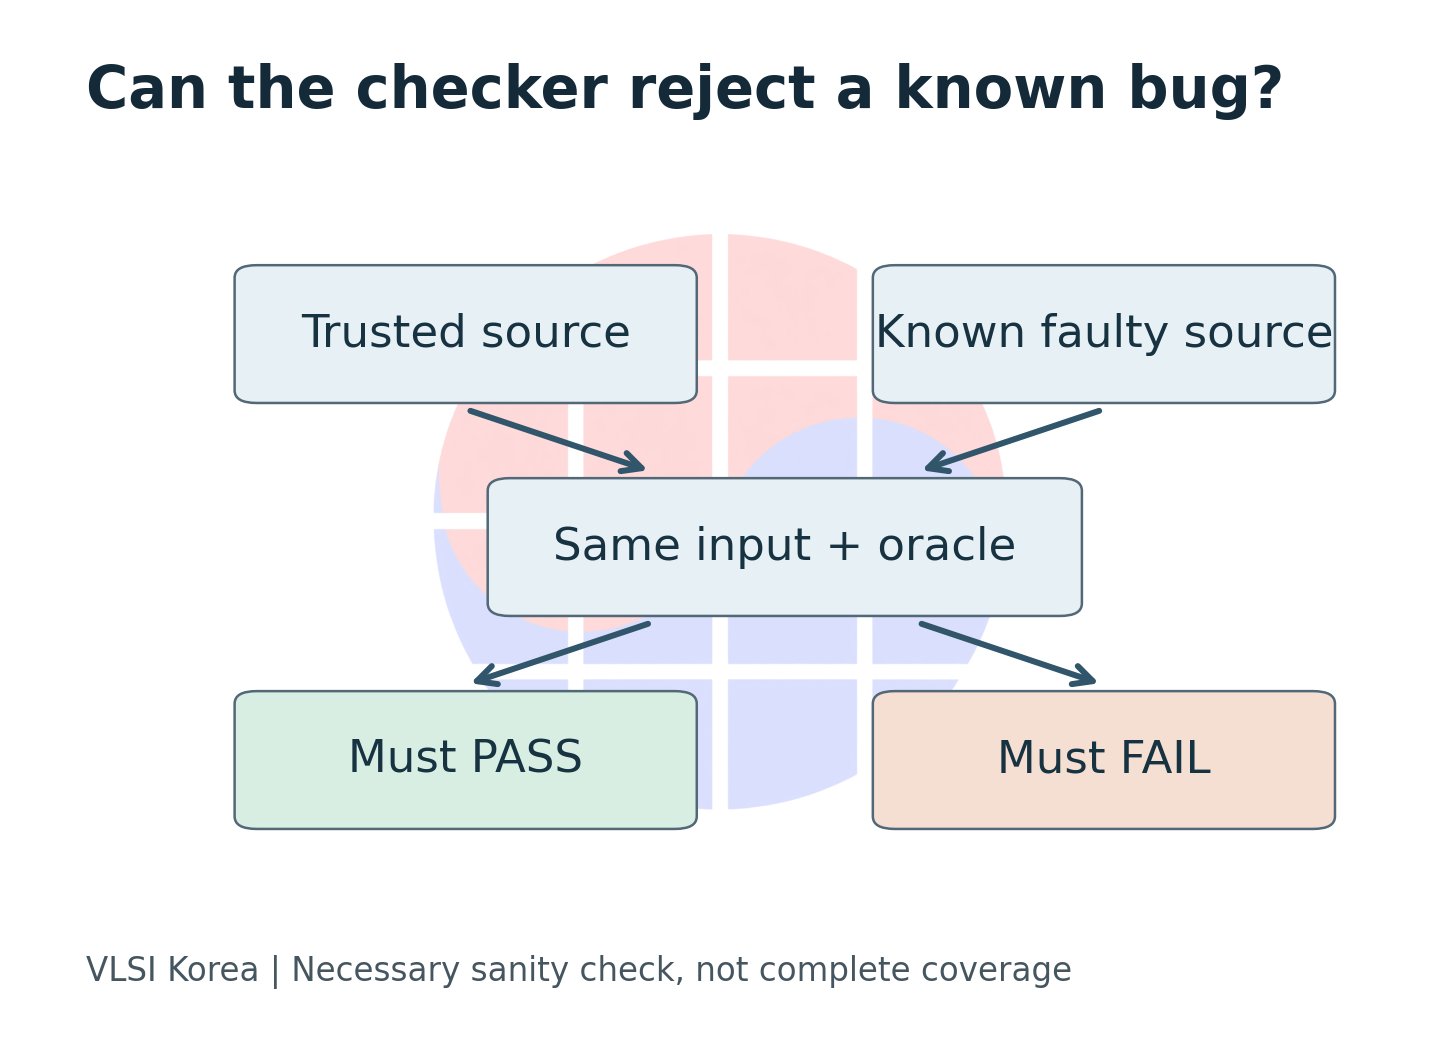
자동 수정의 판정기, 즉 oracle은 실행 결과를 정답과 비교하는 장치다. 원본의 실행을 복사하는 것과 요구사항을 검증하는 것은 다르다. 원본에 이미 오류가 있으면 복사된 기준도 틀릴 수 있다. 반대로 올바른 코드를 일부러 깨뜨렸는데 검사 결과가 계속 성공이라면, 그 검사는 적어도 해당 결함을 발견하지 못한다. 팀은 수정 모델을 비교하기 전에 판정기가 정상 구현과 의도적으로 망가뜨린 구현을 구분하는지 확인할 수 있다.
CHStone은 다양한 응용에서 고른 C 기반 고수준 합성 벤치마크다. 그 논문 초록은 설계 도구와 아이디어를 정량 평가하기 위한 목적을 설명한다. 이런 공개 계산 커널을 수정 평가에 쓰려면, 원래의 평가 목적과 지금 필요한 오류 탐지 범위가 일치하는지 따로 살펴야 한다. 설계 성능을 비교하기에 유용한 입력이 모든 기능 결함을 드러내는 입력이라는 보장은 없다. CHStone 논문 초록
작은 누산기를 생각해 보자. 입력은 정수 배열이고 출력은 유효 원소의 합이다. 설명을 단순하게 하기 위해 길이가 비어 있는 입력은 합이 0이며, 아래 입력에는 산술 오버플로가 없다고 정한다. 정상 구현은 모든 유효 원소를 더하고, 결함 구현은 마지막 원소를 빠뜨린다. 입력이 [1, 2, 3]이면 정상 출력은 6, 결함 출력은 3이다. 이 검사는 해당 누락 오류를 구분한다. 하지만 이것만으로 임의의 수정이 올바른지를 판정할 수는 없다.
| Checker sanity test | Expected result | Interpretation |
|---|---|---|
| Trusted sum on [1, 2, 3] | 6, pass | Positive control works |
| Omit last element | 3, fail | This defect is observable |
| Always return 6 | 6, pass | A false repair can still pass |
마지막 행이 핵심이다. 항상 6을 반환하는 수정은 단일 입력을 통과하지만 배열 합을 구현하지 않는다. 오류가 보인다는 조건과 잘못된 수정이 통과하지 못한다는 조건은 강도가 다르다. 따라서 결함을 주입한 검사에서 한 번 실패했다고 테스트를 완전한 명세로 취급해서는 안 된다. 어느 입력에서 어떤 차이가 드러났는지까지 남겨야 다음 단계에서 빠진 동작을 찾을 수 있다.
입력을 늘릴 때는 정답을 가르는 차이를 넣는다
테스트의 개수보다 후보 구현을 구분하는 입력이 중요하다. 누산기에 [2, 2, 2]를 추가하면 합은 다시 6이다. 앞의 잘못된 상수 반환 구현을 걸러내지 못한다. 대신 [1, 2, 4]를 넣으면 기대값이 7이어서 바로 구분된다. 빈 입력과 원소가 하나인 입력은 반복문의 시작과 종료 조건을 드러낸다. 입력의 숫자만 무작위로 바꾸기보다, 길이·경계·값의 분포가 어떤 실패를 드러낼지 설명할 수 있어야 한다.
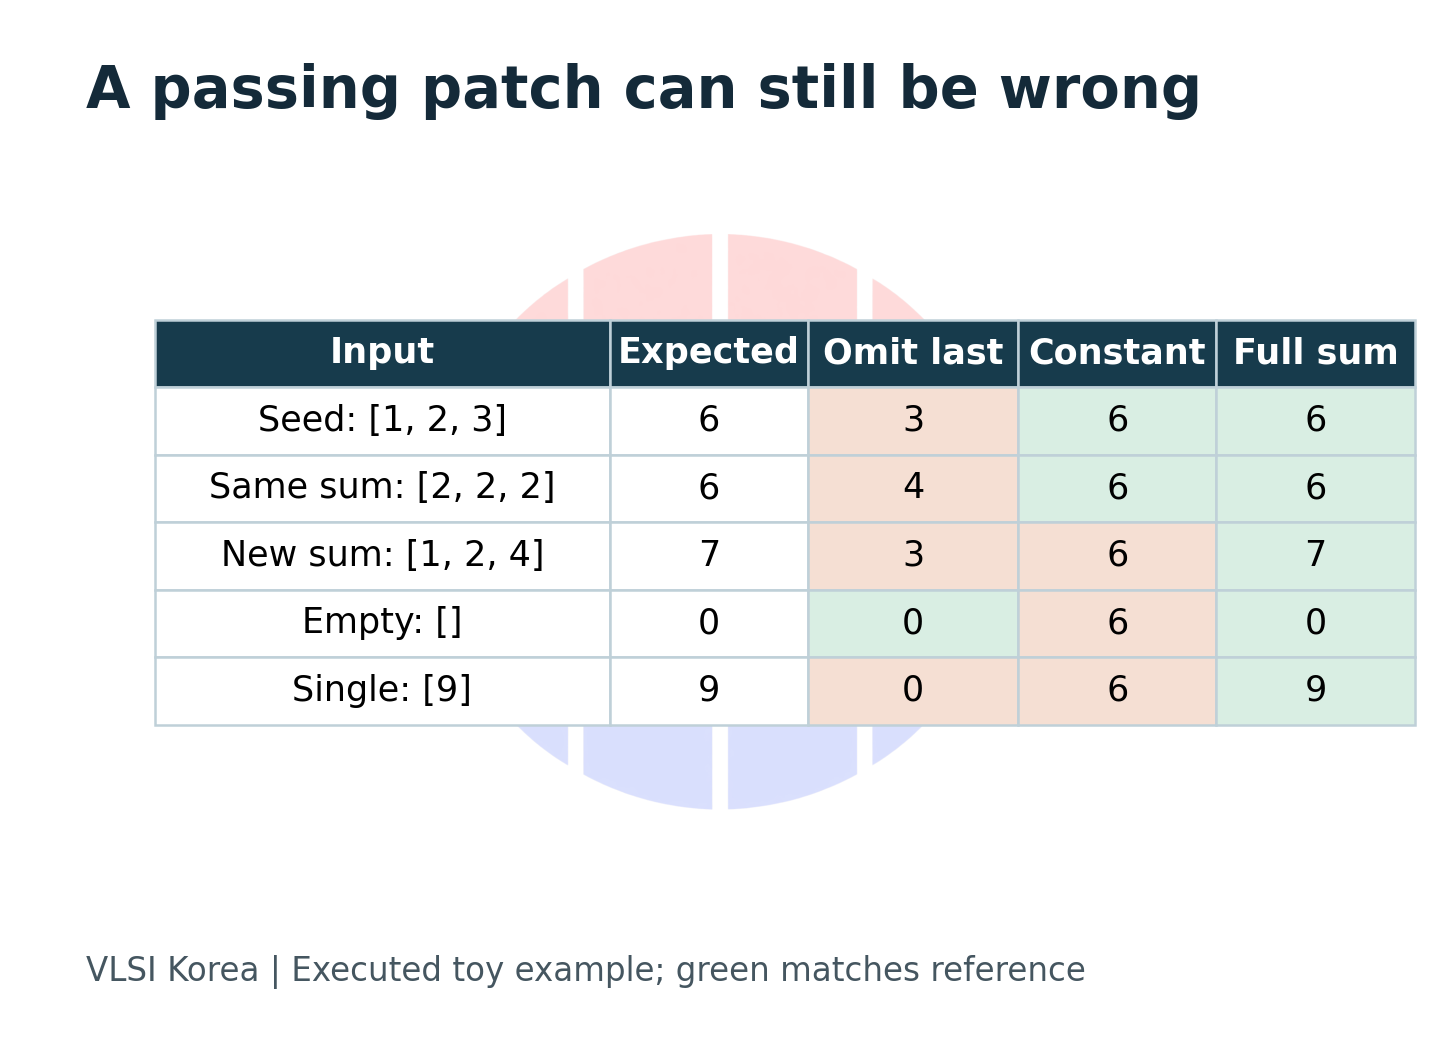
검증용 입력은 수정기가 참고한 입력과도 구분하는 편이 좋다. 같은 테스트만 반복해서 보여 주며 수정하면, 도구가 구현해야 할 동작보다 보이는 검사를 만족시키는 방향으로 움직일 수 있다. 검토자는 보류한 입력을 별도로 실행하고, 실패한 사례를 추가할 때 그 입력이 어느 규칙을 검증하는지 기록한다. 보류한 입력도 유한하므로 완전성을 증명하지는 못하지만, 눈앞의 예제에만 맞춘 수정을 발견할 기회를 넓힌다.
| Input class | Example here | Intended distinction |
|---|---|---|
| Seed | [1, 2, 3] → 6 | Known missing-element bug |
| Same total | [2, 2, 2] → 6 | Does not reject constant output |
| Changed total | [1, 2, 4] → 7 | Rejects constant output |
| Boundary | [] → 0; [9] → 9 | Empty and single-element handling |
MachSuite의 공식 저장소 README에는 검증 방식의 이식성 문제와 최종 출력 검사가 수행되지 않는다는 경고가 있다. 이 경고를 모든 후속 연구의 검사 실패로 확대할 수는 없다. 연구자가 별도의 판정기를 구성했을 수 있기 때문이다. 실무적으로 얻을 교훈은 저장소 이름만으로 검증 능력을 가정하지 말라는 것이다. 사용한 버전과 하네스, 실패 반환값, 실제 비교 경로를 확인해야 한다. 종료 코드가 성공이어도 비교 함수가 호출되지 않았다면 기능 검사 성공으로 집계할 근거가 없다. MachSuite 공식 저장소
반복해서 같은 답을 내도 정확성은 별개의 문제다
수정 결과가 매번 달라지면 원인을 조사할 가치가 있다. 설명이 부족하거나, 실패 위치를 좁히지 못했거나, 생성 과정 자체가 다양할 수 있다. 그러나 텍스트가 여러 형태라는 사실과 기능이 여러 형태라는 사실은 같지 않다. 앞의 합산을 for 반복문과 while 반복문으로 각각 구현하면 코드 문자열은 달라도 정의된 입력에서 같은 계산을 할 수 있다. 반대로 매번 동일하게 상수 6을 반환하는 모델은 안정적으로 같은 오답을 낸다.
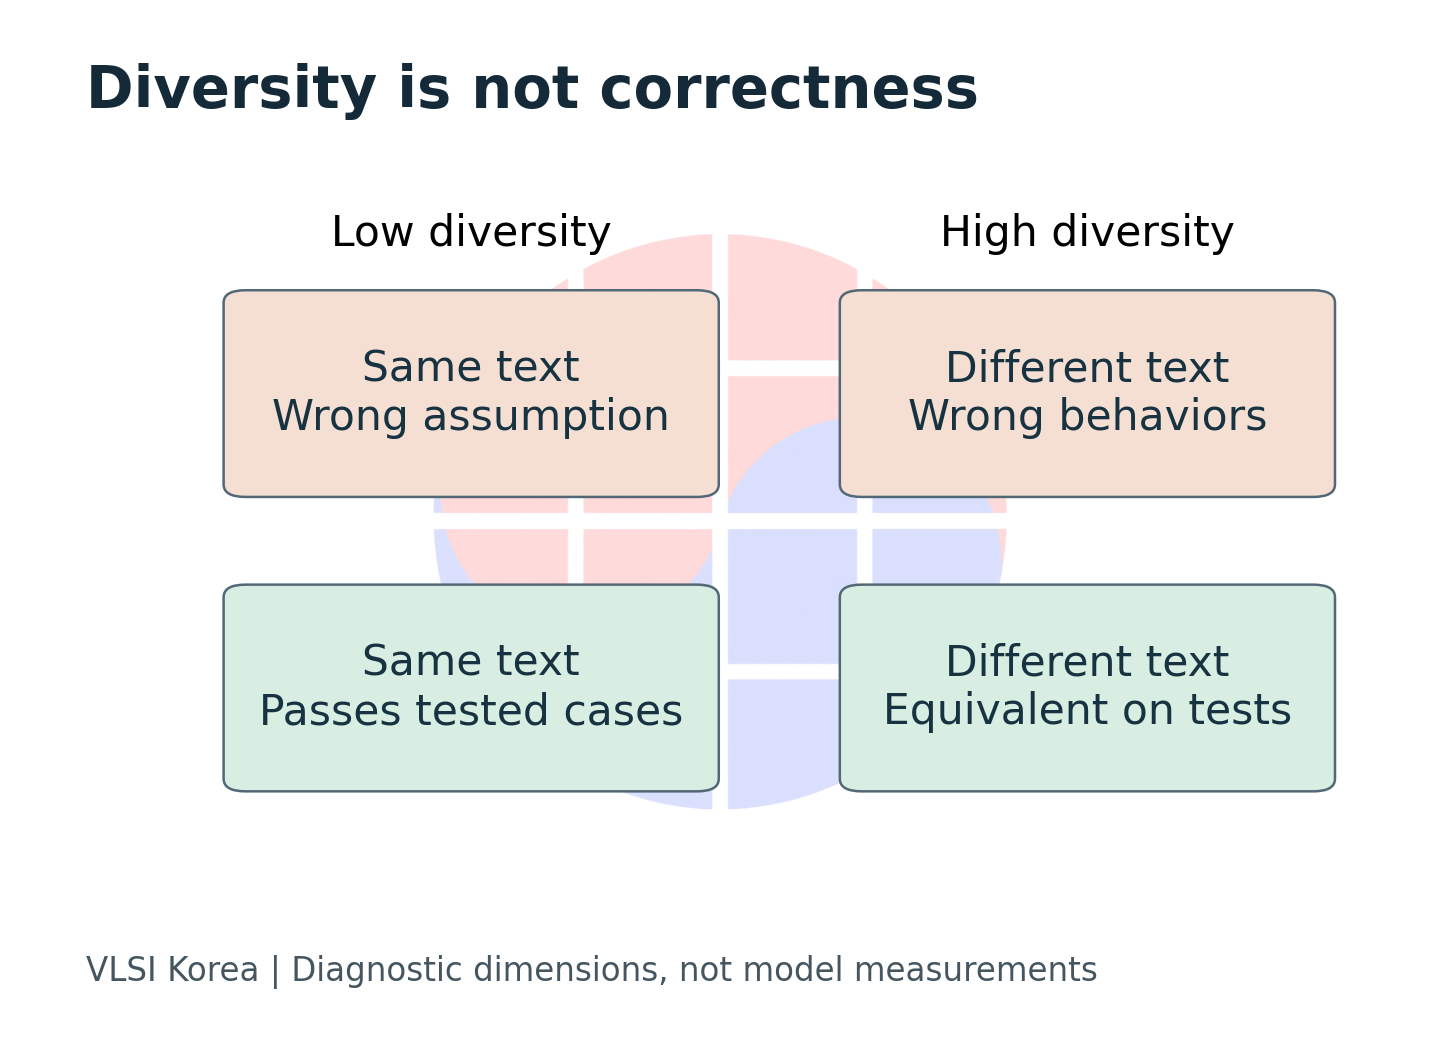
따라서 수정의 다양성은 다음 검사를 고르는 단서로 쓰는 편이 적절하다. 서로 다른 후보가 어느 입력에서 갈라지는지 찾으면 판정기를 강화할 수 있다. 모든 후보가 같은 경계 사례에서 실패하면 명세나 입력 범위부터 점검한다. 한 후보만 컴파일에 실패하면 문법·자료형 문제를 먼저 분리한다. 이런 진단은 모델의 전반적인 능력을 단정하지 않고, 지금 설계에서 실패를 줄이는 데 필요한 정보를 만들어 준다.
| Repeated outcome | Next question |
|---|---|
| Same patch, tests fail | Is the model repeating one wrong assumption? |
| Different patches, same tested outputs | Which new input distinguishes their behavior? |
| Different patches, different failures | Is the defect localized and the contract explicit? |
| Tests pass consistently | What remains outside these tests? |
수정 도구의 비교표도 같은 원칙으로 읽을 수 있다. 시도 횟수와 검사 입력이 바뀌면 성공률의 뜻이 달라진다. 한 번에 맞힌 비율과 여러 후보 중 적어도 하나가 맞힌 비율은 선택 비용까지 같다는 뜻이 아니다. 후보를 더 생성하는 동안 검사가 느려지거나 합성 대기가 길어질 수 있다. 모델 선택에는 정답 후보의 존재뿐 아니라 그 후보를 식별하는 데 드는 시간과, 이후 단계에서 탈락하는 이유가 함께 필요하다.
C에서 통과한 수정을 RTL과 시간축으로 옮긴다
AMD의 Vitis HLS 문서는 C/RTL co-simulation에서 C 테스트벤치로 입력을 만들고, 생성된 RTL을 시뮬레이션한 뒤, 그 출력을 다시 테스트벤치에서 검사하는 흐름을 설명한다. 테스트벤치는 결과를 스스로 판정해야 한다. 이 절차는 합성된 회로에 검사 범위를 확장하지만, 검사의 입력과 비교 조건이 부실하면 그 한계도 함께 따라간다. AMD UG1399
현업에서는 기능 비교와 시간 조건을 함께 적어야 한다. 예를 들어 결과가 같아도 새로운 입력을 받아들이는 간격이 길어지면 스트리밍 처리의 요구량을 만족하지 못할 수 있다. Latency는 한 작업의 시작부터 완료까지 걸리는 시간이고, Initiation Interval은 연속 작업을 시작할 수 있는 간격이다. 아래는 latency가 12 cycles, interval이 3 cycles인 이상적인 예제다. 작업 4개의 시작은 0, 3, 6, 9이고 완료는 12, 15, 18, 21이다. 마지막 완료까지는 21 cycles다.
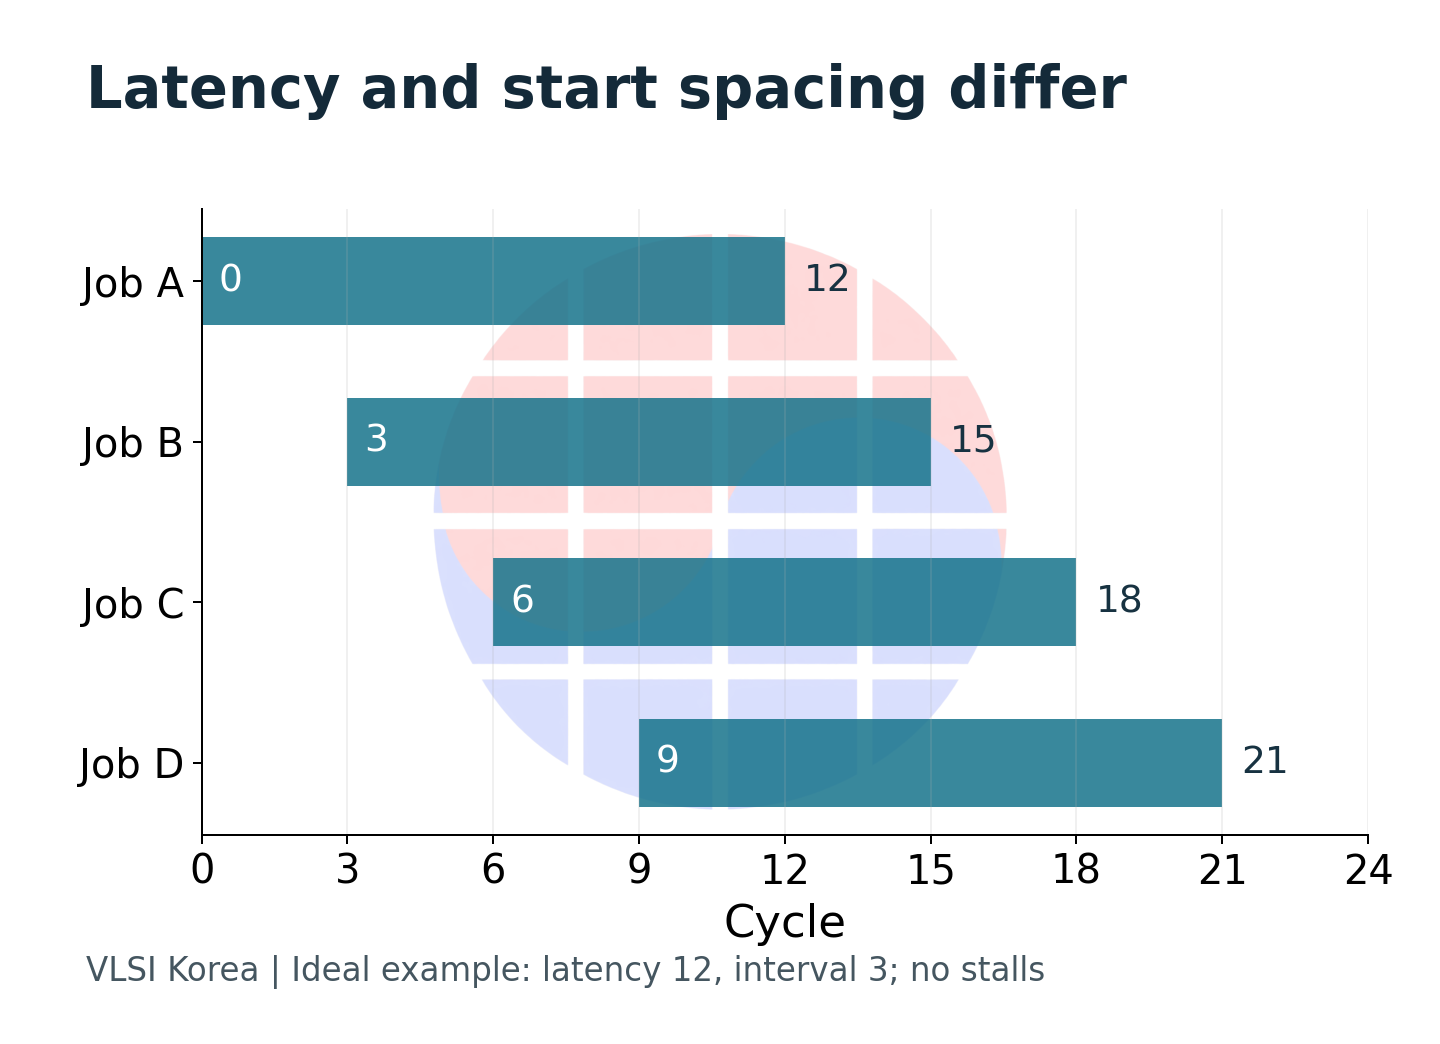
같은 latency라도 작업을 겹치지 않게 실행하면 총 48 cycles가 필요하다. 이것은 실제 제품의 속도 측정이 아니라 조건을 고정한 시간표 계산이다. 수정기가 연산 결과를 보존하면서 자원 공유나 메모리 접근 방식을 바꾸면 이런 중첩 조건이 달라질 수 있다. 그래서 출력값 검사에 더해, 허용한 입력 속도에서 실제로 작업을 받는지와 결과가 필요한 시점에 도착하는지를 확인해야 한다.
| Acceptance layer | Record with the patch |
|---|---|
| Source behavior | Input domain, reference result, compiler configuration |
| Generated RTL | Tool version, interfaces, testbench, observed outputs |
| Timing and resources | Clock target, latency, initiation interval, resource limits |
| System operation | Reset behavior, stalls, backpressure, allowed operating conditions |
외부 인터페이스가 멈춤 신호를 줄 때, 리셋이 동작 중에 들어올 때, 길이가 바뀌는 입력이 연속으로 들어올 때도 계약이 필요하다. 모든 설계에 같은 검사를 추가하라는 뜻은 아니다. 해당 제품의 합법적인 동작 조건을 기준으로 빠진 사례를 고른다는 뜻이다. 합성 보고서의 목표 주파수와 실제 구현의 타이밍 결과도 구분해야 한다. 기능과 시간 조건을 별도로 적으면, 기능을 고친 패치가 처리량 요구를 깨뜨린 경우를 분명히 설명할 수 있다.
소스의 정답을 하드웨어의 정답으로 옮기려면, 출력값뿐 아니라 그 출력이 나오는 조건도 함께 옮겨야 한다. (VLSI Korea 편집 해석)
국내 설계팀이 남겨야 할 것은 성공률의 분모다
국내 팹리스나 FPGA 가속기 팀이 자동 수정 도구를 도입한다면, 공개 커널 점수와 자사 IP의 적용 조건 사이에 작은 내부 평가를 둘 수 있다. 기밀 설계 자료를 외부 서비스에 보내야 한다는 뜻은 아니다. 승인된 환경과 공개 또는 사용 허가된 예제로 시작하고, 결함 종류와 입력 조건이 실제 업무를 어느 정도 대표하는지 확인한다. 결과는 컴파일 실패, 기능 실패, 합성 후 실패, 성능 조건 미충족으로 나누면 개선할 지점을 찾기 쉽다.
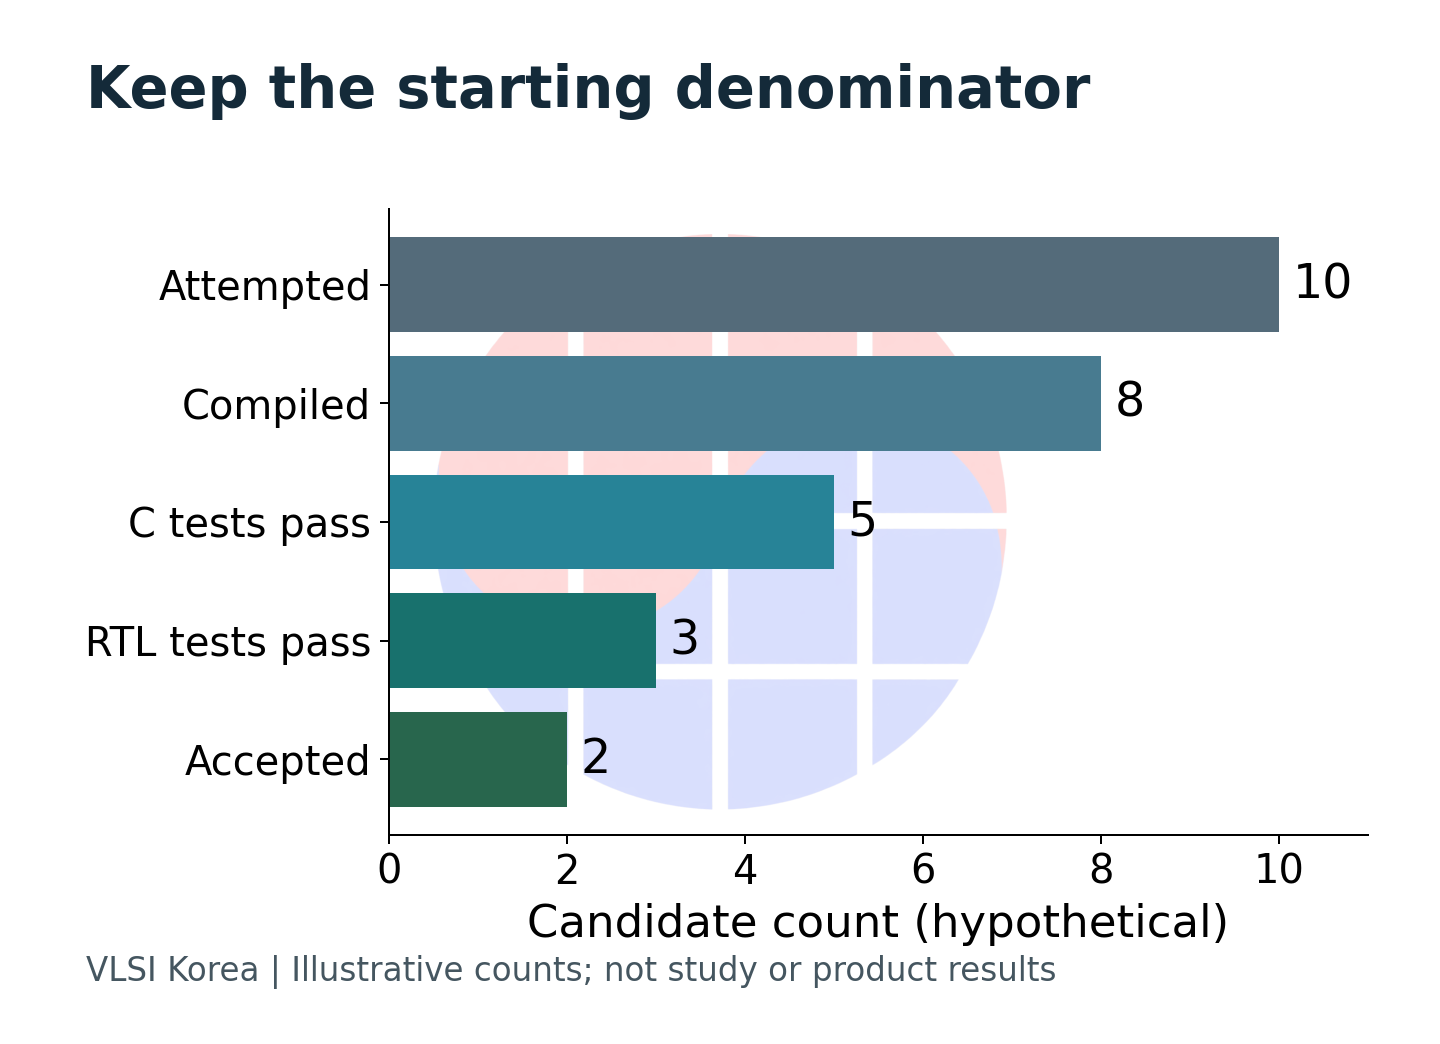
예를 들어 후보 10개 중 컴파일에서 2개, C 검사에서 3개, RTL 검사에서 2개, 타이밍·자원 조건에서 1개가 탈락하면 최종 후보는 2개다. C 검사에 도달한 후보만 분모에 넣으면 전체 작업의 수율을 알기 어렵다. 반대로 모든 실패를 ‘AI 오답’ 하나로 묶으면 도구 설정 문제와 기능 오류를 구분하지 못한다. 같은 시작 집합을 추적하면서 단계별 이유를 기록해야 도입 전후의 비교가 가능해진다.
| Decision record | Why it matters |
|---|---|
| All attempted candidates | Preserves the denominator |
| Failure stage and reason | Separates configuration from functional defects |
| Human review and tool time | Exposes the cost of finding an acceptable patch |
| Rejected and held-out cases | Prevents easy cases from silently defining the score |
향후 6~12개월 동안 볼 변화는 더 높은 단일 점수보다 검증 범위의 연결이다. 공개 평가가 사용한 입력과 판정기 버전을 제공하는지, 생성된 RTL 검사로 이어지는지, 처리량·자원 조건까지 기록하는지가 중요하다. 이 제안이 실제로 유용한지는 내부 시험에서 반증할 수 있다. 강화한 검사로 추가 결함을 거의 찾지 못하고 검토 시간만 크게 늘어난다면, 입력 선정과 검사 순서를 다시 설계해야 한다. 모든 단계의 비용을 숨긴 채 검사 수만 늘리는 것은 목표가 아니다.
자동 수정의 가치는 사람이 검토할 수 있는 후보를 더 빨리 만드는 데서 확인해야 한다. 그 후보를 제품 설계로 받아들일 근거는 요구사항, 입력, 판정기, 합성된 회로와 구현 조건을 연결한 기록이다. PASS 옆에 이 기록이 있을 때 팀은 무엇을 확인했고 무엇을 다음 단계에서 확인해야 하는지 판단할 수 있다. 그런 판단을 가능하게 하는 자동화가 실제 설계 업무에 남는다.
Sources and evidence scope
- HLS repair study, arXiv v1: 2026-10-02 제출, 2026-10-06 공개 목록에서 확인. 본문은 ICCD 2026 채택을 명시한다. 채택은 저자 표기이며 행사 발표·정식 게재를 별도 확인한 것은 아니다. 본문 전체를 읽었으며 실험은 재현하지 않았다. 초록과 표의 수치·분포 표현에 불일치가 있어 모델별 성공률 비교는 사용하지 않았다.
- CHStone: 2009년 논문 초록·메타데이터 확인. MachSuite: 공식 README 확인. 서로 다른 연구 자산이며 이 글에서 실행한 누산기와 별개다.
- AMD UG1399: 2026.1 문서의 C/RTL 검증 절차. Altera: FPGA 구성 방식에 관한 기업 설명.
- ZeptoBars photo, rights: 실제 Cyclone EP1C3 다이 사진. 원본을 수정하지 않았다. 기사 내 도표·표·판단 기준과 누산기·시간표 예제는 VLSI Korea 제작이며 측정된 제품 성능이 아니다.
이 원고는 AI의 조사·집필 지원을 사용했다. 설명용 계산과 예제는 별도로 확인했으며, 모델 성능이나 실제 하드웨어를 재현 실험한 기사로 제시하지 않는다.
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글의 사실은 인용한 공개 논문, 기술 문서와 벤치마크 자료에 근거하며, 설명용 예제와 계산은 VLSI Korea가 작성했습니다. 출처 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.