VLSI Korea
NVIDIA Vera CPU 심층 분석 — 88코어보다 중요한 1.2TB/s 메모리 대역폭
Vera는 소켓당 1.5TB SOCAMM2 LPDDR5X와 1.2TB/s 대역폭, 코어당 약 13.6GB/s를 제공한다. Grace와 EPYC Turin 비교, 벤더 주장의 한계, 삼성전자·SK하이닉스·Micron의 SOCAMM2 경쟁까지 분석한다.


NVIDIA Vera CPU 심층 분석 — 88코어보다 중요한 1.2TB/s 메모리 대역폭
TL;DR
- NVIDIA Vera는 Armv9.2-A 호환 custom Olympus 코어 88개를 탑재한 데이터센터 CPU로, 2025년 3월 GTC에서 Vera Rubin 플랫폼과 함께 공개됐고 아키텍처 상세는 2026년 7월 NVIDIA 공개 자료로 확인됐다 (NVIDIA 아키텍처 공개, 2026년 7월).
- 핵심 수치는 코어 수가 아니다. Vera 소켓 1개는 최대 1.5TB SOCAMM2 LPDDR5X와 최대 1.2TB/s 메모리 대역폭을 지원하며, 단순 나눗셈 기준 코어당 약 13.6GB/s다 (NVIDIA 아키텍처 공개, 2026년 7월; 공개 수치 기준 계산, 2026년 10월 20일).
- 코어당 대역폭은 전작 Grace의 약 1.8배, 12채널 DDR5-6400 기준 128코어 AMD EPYC Turin 플래그십 계산값의 약 2.8배다 (벤더 스펙 기준 계산, 2026년 10월 20일).
- NVIDIA는 AI 관련 워크로드에서 Turin 대비 IPC 최대 1.9배를 주장하지만 이는 벤더 주장이며, 지금까지 공개된 파트너 벤치마크는 전체 설정과 TDP를 공개하지 않았다 (NVIDIA 공개, 2026년 7월).
- 전략적 변화는 소켓당 메모리 탑재량이다. Vera는 Grace의 3배 용량을 소켓에 싣기 때문에 CPU 소켓이 삼성전자·SK하이닉스·Micron의 LPDDR5X 공급 경쟁 무대가 된다 (NVIDIA 아키텍처 공개, 2026년 7월).
Background
지난 20년간 데이터센터 CPU 마케팅은 대부분 코어 수 경쟁이었다. 코어가 많으면 가상머신도, 컨테이너도, 랙당 스레드도 많아진다는 논리였다. 범용 워크로드가 주로 연산 처리량에 막히던 시절에는 맞는 말이었다. 하지만 agentic AI 시대에는 이 논리가 약해진다. AI 시스템의 CPU는 더 이상 GPU 옆에서 대기하는 host가 아니다. Tool 호출을 조율하고, 데이터를 준비·이동시키고, retrieval과 ranking 단계를 실행하고, 네트워크와 스토리지 트래픽을 처리하며, 데이터가 늦게 도착하면 곧바로 멈추는 가속기에 데이터를 공급한다.
NVIDIA는 Grace로 이 시장에 들어왔다. Grace는 Arm Neoverse V2 코어 72개, 최대 480GB LPDDR5X, 546GB/s 메모리 대역폭을 갖춘 CPU였다 (2026년 7월 Vera 공개 이전에 공개된 NVIDIA Grace 스펙 기준). Grace는 Arm CPU가 NVIDIA 랙의 중심에 설 수 있음을 증명했다. 동시에 다음 병목도 드러냈다. GPU 시스템이 빨라질수록 host CPU에는 더 많은 메모리 용량, 스레드당 더 많은 대역폭, GPU와의 더 빠른 coherent 연결이 필요해졌다.
Vera는 그 답이다. 2025년 3월 GTC에서 Vera Rubin 플랫폼의 일부로 공개됐고, 2026년 7월 아키텍처 공개에서 상세가 나왔다 (GTC, 2025년 3월; NVIDIA 아키텍처 공개, 2026년 7월). Vera는 라이선스 Neoverse 설계를 버리고 custom Olympus 코어 88개로 바꿨다. NVIDIA에 따르면 Spatial Multithreading으로 176스레드를 제공하고, monolithic compute die, 코어당 L2 2MB, L3 164MB, 2세대 Scalable Coherency Fabric를 갖췄다 (NVIDIA 아키텍처 공개, 2026년 7월).
코어 주변의 플랫폼 수치도 중요하다. Vera는 coherent CPU-GPU 통신을 위한 NVLink-C2C 1.8TB/s, PCIe Gen6, CXL 3.1을 제공하고 TDP는 250~450W로 설정 가능하다 (NVIDIA 아키텍처 공개, 2026년 7월). Vera 2개로 구성하는 Superchip은 176코어, 352스레드, SOCAMM2 모듈 16개, 합산 메모리 대역폭 2.4TB/s, 메모리 3TB를 제공한다. Superchip 128개 랙 레퍼런스 디자인은 22,528코어와 384TB 메모리에 도달한다 (NVIDIA 아키텍처 공개, 2026년 7월). 단독 CPU 판매와 초기 고객 출하는 2026년 보도로 전해졌으므로, 이 글의 가용성 관련 서술은 NVIDIA의 직접 출하 확인이 아닌 보도 기준으로 표기한다 (업계 보도, 2026년).
Deep Dive 1: 메모리 시스템 — 소켓당 1.5TB와 1.2TB/s
Vera를 규정하는 선택은 메모리 시스템이다. 소켓 1개는 최대 9,600MT/s SOCAMM2 LPDDR5X 최대 1.5TB를 지원해 최대 1.2TB/s 메모리 대역폭을 제공한다 (NVIDIA 아키텍처 공개, 2026년 7월). SOCAMM2는 NVIDIA가 주도한 소켓형 LPDDR 모듈 규격이다. 납땜된 LPDDR과 달리 소켓형 모듈은 시스템 설계에 따라 구성·교체·확장이 가능하면서도, 일반 DDR5 서버 메모리보다 LPDDR5X의 전력 효율 이점을 유지한다.
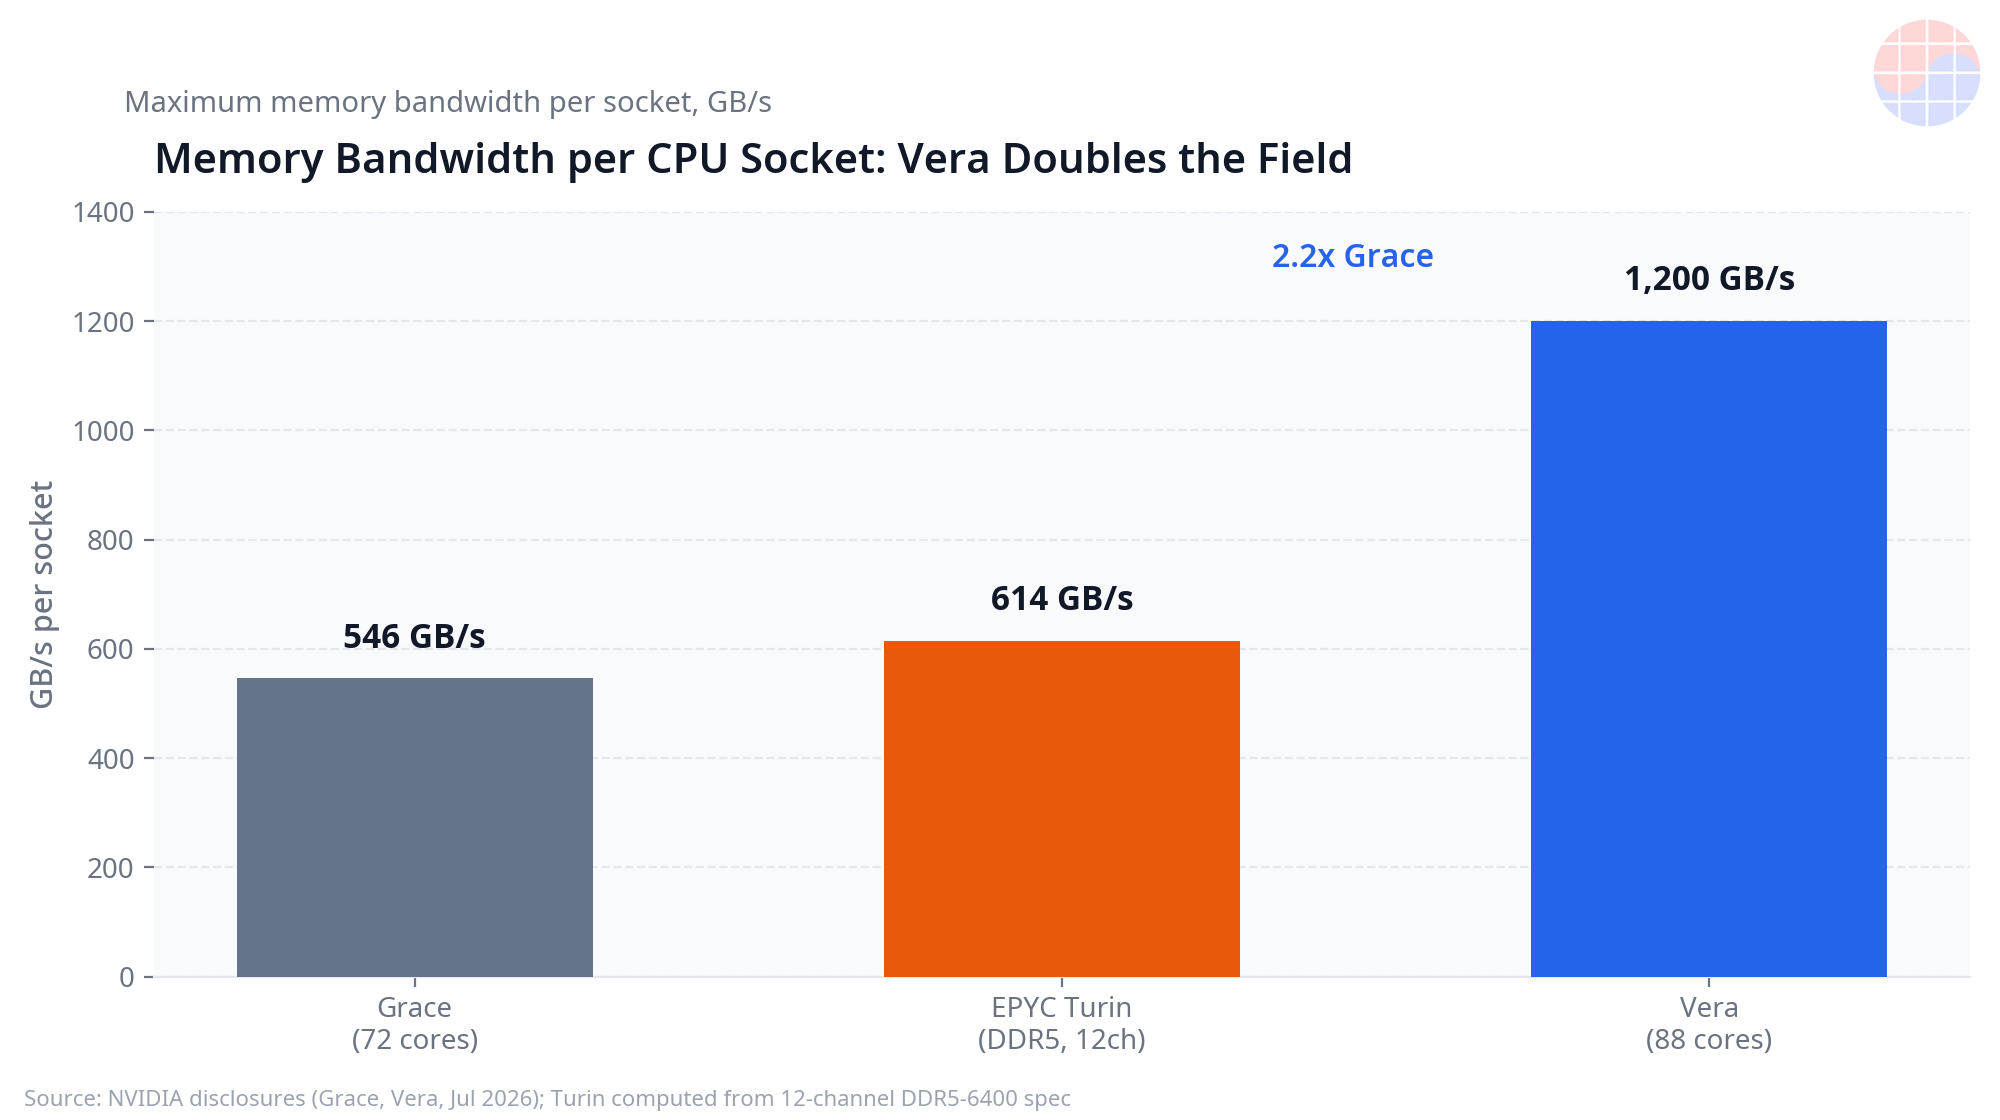
Grace와 비교하면 한 세대의 이동 폭이 보인다. Grace는 소켓당 최대 480GB LPDDR5X와 546GB/s 대역폭을 제공했다 (NVIDIA Grace 스펙). Vera는 용량을 1.5TB로 3배로 늘리고 대역폭은 1,200GB/s로 약 2.2배 높였다 (NVIDIA 아키텍처 공개, 2026년 7월; 계산, 2026년 10월 20일). 실무적으로 Vera 소켓은 더 큰 working set을 로컬 메모리에 둘 수 있다. 더 큰 key-value 캐시, 더 큰 embedding 테이블, 더 많은 동시 agent 세션, GPU가 소비할 데이터를 느린 스토리지나 원격 메모리로 떨어지지 않고 더 많이 준비해 둘 수 있다는 뜻이다.
용량과 대역폭은 함께 올라야 한다. 용량만 크고 대역폭이 부족하면 코어는 혼잡한 메모리 경로에서 기다린다. 대역폭만 크고 용량이 부족하면 잦은 eviction과 refetch가 발생한다. Vera의 설계점인 1.5TB와 1.2TB/s는 많은 스레드가 크고 계속 바뀌는 데이터셋을 동시에 건드리는 워크로드를 겨냥한다. Retrieval 파이프라인, feature serving, vector search 전처리, 데이터 로딩, 대규모 모델 추론을 둘러싼 제어 로직이 정확히 그 프로필에 해당하고, 전통적인 정수 연산 벤치마크와는 거리가 있다.
공급망 차원의 결과도 있다. 소켓형 LPDDR5X 모듈 규격은 시스템 빌더가 대량으로 구매하는, 교체 가능한 표준 메모리 content 단위를 만든다. 소켓 1개가 480GB가 아니라 1.5TB를 실으면, GPU에 붙는 HBM을 세기 전에 CPU에 붙는 LPDDR5X content만으로 Vera 시스템 1대의 메모리 탑재량이 배가된다. 4번 섹션에서 이 점이 삼성전자·SK하이닉스·Micron에 무엇을 의미하는지 다룬다.
Deep Dive 2: 코어당 대역폭과 x86 비교
메모리 대역폭이 따라가지 못하면 코어 수는 오해를 부른다. 소켓 대역폭을 코어 수로 나누면 모든 코어가 바쁠 때 코어 1개가 끌어 쓸 수 있는 메모리 처리량의 대략적인 지표가 된다. Vera는 1,200GB/s를 88코어로 나누면 코어당 약 13.6GB/s로, NVIDIA가 표기하는 코어당 약 14GB/s와 일치한다 (NVIDIA 아키텍처 공개, 2026년 7월; 계산, 2026년 10월 20일). Grace는 546GB/s를 72코어로 나누면 코어당 약 7.6GB/s다.
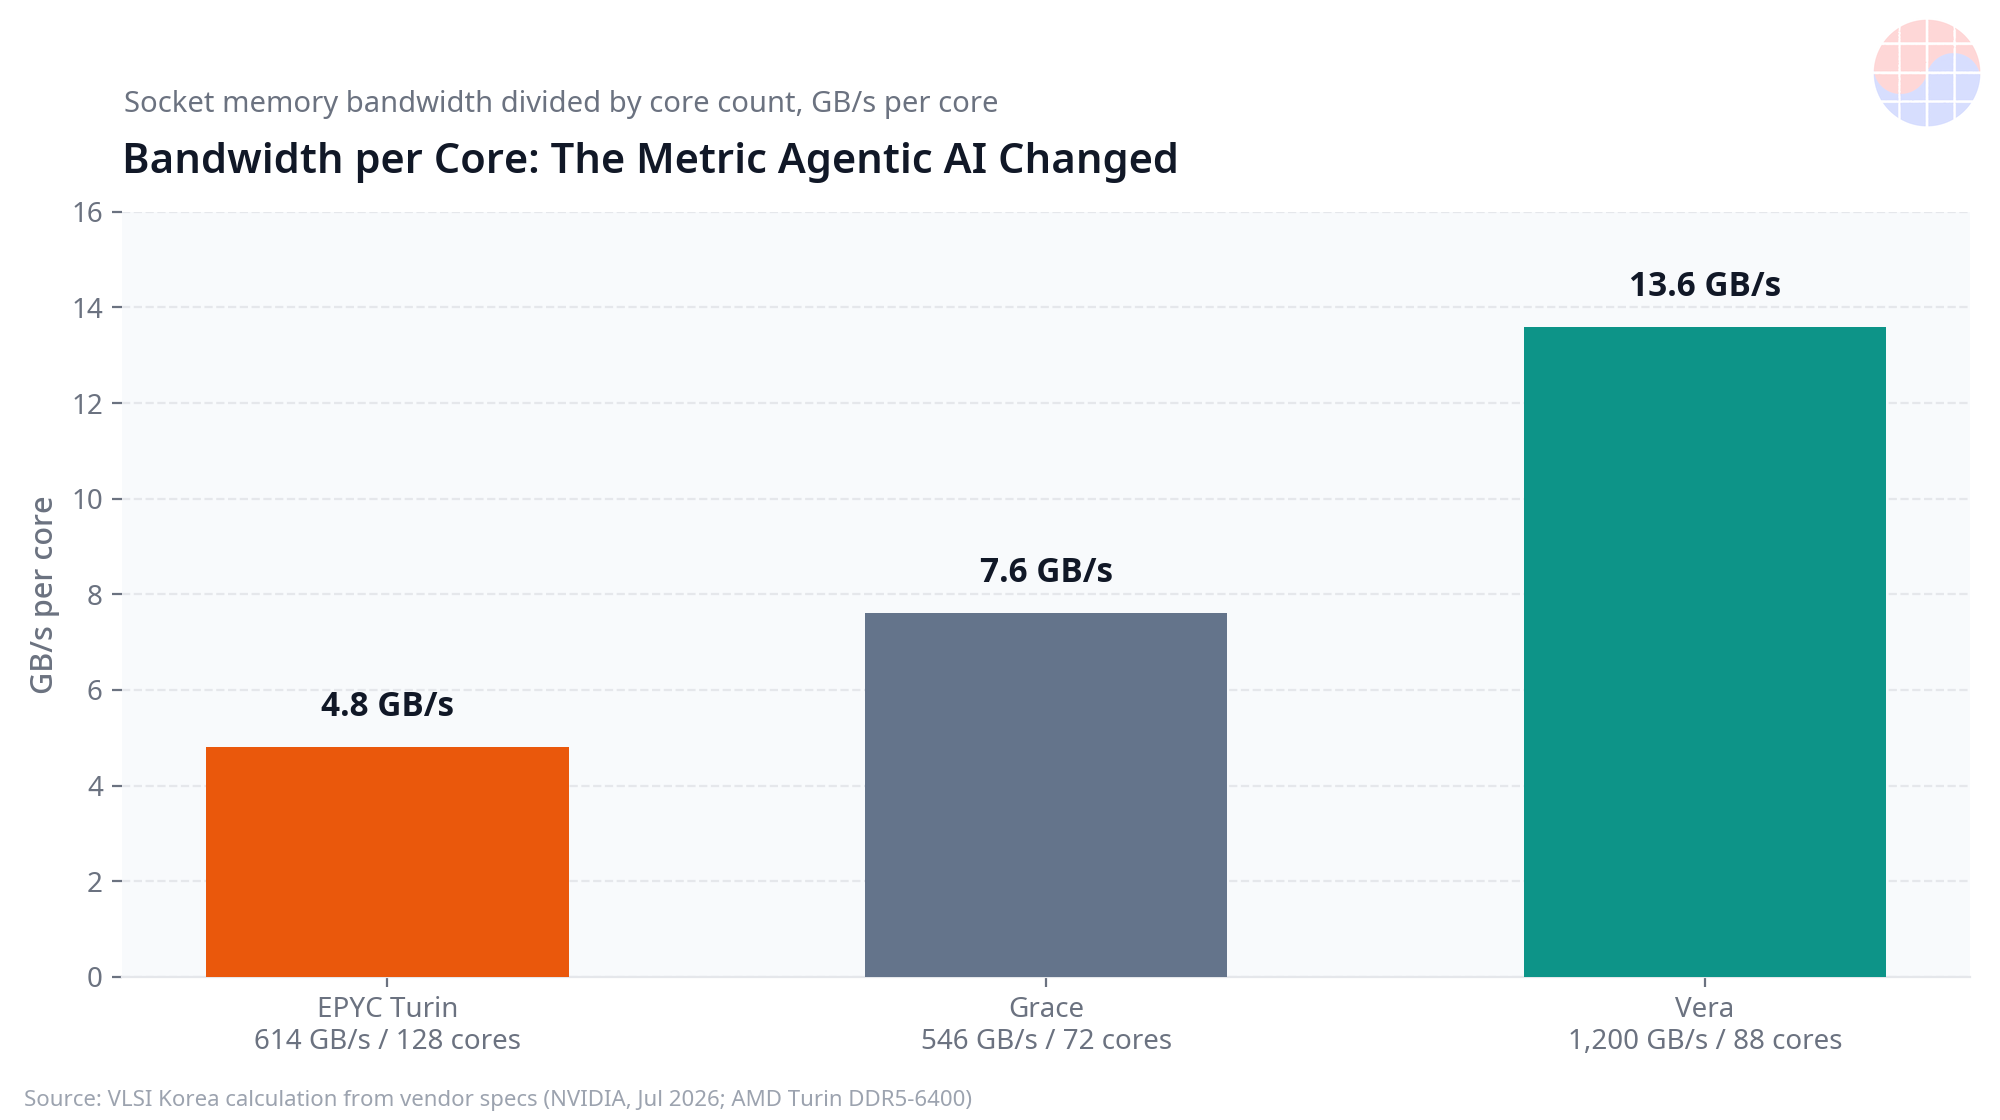
x86 비교에는 투명한 방법론이 필요하다. 12채널 DDR5-6400을 쓰는 AMD EPYC Turin 시스템의 이론상 최대값은 12채널 × 6,400MT/s × 전송당 8바이트로 계산한 614GB/s다 (AMD EPYC Turin 메모리 스펙 기준 계산, 2026년 10월 20일). 이를 128코어 플래그십 구성에 나누면 코어당 약 4.8GB/s다. 이 비교의 모든 플랫폼에서 실제 지속 대역폭은 이론상 최대값보다 낮으므로, 수치는 측정된 애플리케이션 결과가 아니라 스펙 기준 비율로 읽어야 한다.
이 기준으로 Vera는 해당 Turin 구성의 약 2.8배, Grace의 약 1.8배 코어당 대역폭을 제공한다 (계산, 2026년 10월 20일). 이것이 NVIDIA 주장 중 가장 강한 부분이다. Agentic 워크로드와 데이터 집약적 워크로드는 데이터를 streaming, filtering, transforming하는 많은 스레드를 돌리는 경우가 많다. 코어당 대역폭이 낮으면 코어를 늘려도 고정된 메모리 파이프를 나눠 쓰기 때문에 효과가 멈춘다. 코어당 대역폭이 높으면 스레드 확장이 더 오래 통한다.
NVIDIA는 AI 관련 워크로드에서 EPYC Turin 대비 IPC 최대 1.9배도 주장한다 (벤더 주장, NVIDIA 공개, 2026년 7월). 이 주장은 신중하게 다뤄야 한다. IPC는 워크로드, 컴파일러, 명령어 믹스에 크게 좌우되고, Arm custom 코어와 x86 코어는 동일한 명령어 흐름을 실행하지 않는다. 이 주장은 더 넓고 효율적인 코어에 더 많은 대역폭을 공급한다는 NVIDIA의 설계 의도를 보여주지만 독립 측정값은 아니며, 구매 결정에 쓰려면 설정이 공개된 재현 가능한 벤치마크를 기다려야 한다.
Deep Dive 3: Olympus 코어, Coherency, Superchip
Vera의 Olympus 코어 88개는 Armv9.2-A 호환 custom 설계로, Grace의 라이선스 Neoverse V2 코어에서 한 단계 나아갔다 (NVIDIA 아키텍처 공개, 2026년 7월). 코어 설계를 직접 보유하면 NVIDIA 랙 시스템이 실제로 돌리는 워크로드에 맞춰 vector 처리량, 분기 동작, 캐시 계층을 조정할 수 있다. 코어당 L2 2MB, 칩 전체 L3 164MB라는 수치도 중요하다. 캐시가 클수록 스레드가 메인 메모리에서 기다리는 빈도가 줄기 때문이다 (NVIDIA 아키텍처 공개, 2026년 7월).
Spatial Multithreading은 노출 스레드 수를 소켓당 176개로 두 배로 만든다 (NVIDIA 아키텍처 공개, 2026년 7월). 스레드 두 배는 메모리 시스템이 추가 스레드를 먹일 수 있을 때만 효과가 있다. 그래서 1.2TB/s라는 수치와 스레드 수는 별개의 스펙이 아니라 하나의 설계 결정으로 읽어야 한다.
두 번째 축은 coherency다. Vera의 2세대 Scalable Coherency Fabric와 1.8TB/s NVLink-C2C는 일반 PCIe 링크를 크게 웃도는 속도로 CPU와 GPU가 데이터를 coherent하게 공유하게 한다 (NVIDIA 아키텍처 공개, 2026년 7월). Vera는 PCIe Gen6와 CXL 3.1도 지원해 일반 가속기, 네트워크 어댑터, 메모리 확장 장치를 붙일 수 있다 (NVIDIA 아키텍처 공개, 2026년 7월). AI 랙에서 coherent 공유는 명시적 복사 오버헤드를 줄인다. CPU가 준비한 데이터 구조를 GPU가 직접 소비하고, 중간 결과도 소프트웨어가 관리하는 전송을 줄여 이동할 수 있다.
Superchip 구성은 같은 아이디어를 확장한다. Vera CPU 2개는 176코어, 352스레드, 2.4TB/s 메모리 대역폭, SOCAMM2 모듈 16개로 메모리 3TB를 제공한다 (NVIDIA 아키텍처 공개, 2026년 7월). 랙 규모에서는 Superchip 128개 기준 22,528코어와 384TB 메모리라는 레퍼런스 총량이, NVIDIA가 CPU 레이어를 GPU를 보조하는 최소 구성이 아니라 agent fleet과 데이터 파이프라인을 위한 pooled 인프라로 설계하고 있음을 보여준다 (NVIDIA 아키텍처 공개, 2026년 7월).
전력은 TDP 250~450W 범위에서 설정 가능하다 (NVIDIA 아키텍처 공개, 2026년 7월). 이 범위는 모든 벤치마크 해석에 중요하다. 450W 결과와 250W 결과는 서로 다른 동작점을 설명하며, 설정을 명시하지 않은 비교는 불완전하다.
Deep Dive 4: 정직한 한계 — 벤치마크, x86의 대응, Monolithic 비용
직접 짚어야 할 한계는 세 가지다. 첫째, 공개 벤치마크 근거가 얇다. Redpanda와 연관된 streaming 데이터 결과를 포함한 파트너 결과는 설정과 TDP를 전체 공개하지 않은 채 발표됐다 (파트너 벤치마크 발표, 2026년). 테스트 시점의 코어 수, 메모리 구성, 펌웨어, 전력 설정이 없으면 외부 독자는 수치를 재현할 수도, 비교가 공정했는지 판단할 수도 없다. NVIDIA의 IPC 최대 1.9배 주장도 같은 지위를 갖는다. 공개된 방법으로 독립 테스트가 확인하기 전까지는 벤더 주장이다 (NVIDIA 공개, 2026년 7월).
둘째, x86 벤더는 멈춰 있지 않다. 서버 플랫폼은 더 빠른 DDR5, 채널당 유효 대역폭을 높이는 MRDIMM 메모리, 메모리 채널을 늘린 새 세대로 이동하고 있다. MRDIMM과 차세대 x86 플랫폼은 위에서 쓴 614GB/s 스펙 기준선으로부터 코어당 대역폭 격차를 좁힐 것이며, 특히 코어 수와 대역폭을 맞바꾸는 구성에서 그렇다. Vera의 우위는 2026년 10월 20일 기준 공개 스펙에서는 실재하지만, 한 시점의 우위이지 영구적인 구조적 격차는 아니다.
셋째, Vera의 monolithic compute die에는 비용 구조가 있다. 큰 monolithic die는 일반적으로, 결함 있는 작은 die만 버리고 정상 die를 여러 제품에 재사용할 수 있는 chiplet 설계보다 수율 경제성이 어렵다 (일반적인 반도체 제조 원칙, 2026년 10월 20일 서술). NVIDIA는 Vera의 수율이나 단위 비용을 공개하지 않았으므로 이 글에서 구체적인 비용 주장은 하지 않는다. 방향성의 지적이다. Latency와 coherency에 유리한 설계 선택은 제조 리스크도 집중시키며, 가격은 이를 반영할 것이다.
마지막으로, 하드웨어 우위 중 얼마가 실제 운영에서 살아남는지는 소프트웨어가 결정한다. 엔터프라이즈 툴링, 관측 가능성, 레거시 미들웨어에서 Arm 생태계의 성숙도는 개선됐지만, 대규모 x86 자산을 가진 운영자에게 마이그레이션 비용은 여전히 실재한다. 대역폭은 벤치마크에서 이기고, 총소유비용은 구매 발주에서 이긴다.
Chase's Take
중요한 변화는 NVIDIA가 88코어 CPU를 만들었다는 사실이 아니다. 병목이 이동했다는 사실이다. Agentic AI 시스템에서 CPU는 오케스트레이션을 담당한다. Planning loop, tool 호출, retrieval, 긴 context를 위한 메모리 관리, 스토리지·네트워크·GPU 사이의 데이터 이동이다. 이런 작업은 스레드가 많고 메모리를 많이 쓴다. 제한 자원은 보통 최대 부동소수점 처리량이 아니다. 각 스레드가 다른 모든 스레드 뒤에서 줄 서지 않고 얼마나 많은 데이터에 얼마나 빨리 닿을 수 있는가다. Vera는 그 현실에 맞춰 설계됐다. 코어 수보다 먼저 코어당 대역폭과 소켓당 메모리 용량이다.
비즈니스 관점에서는 SOCAMM2가 Olympus 코어보다 더 중요할 수 있다. NVIDIA는 CPU 소켓용 소켓형 LPDDR5X 모듈을 규정함으로써 host 메모리를 표준화된 대량 content 슬롯으로 만들었다. Vera는 소켓당 1.5TB를 실어 Grace의 480GB 대비 3배의 메모리 content를 싣는다 (NVIDIA 아키텍처 공개, 2026년 7월). Vera를 채택하는 랙은 그만큼 훨씬 많은 LPDDR5X를 공급망에서 끌어온다.
그래서 CPU 소켓은 메모리 content 경쟁의 무대가 된다. 삼성전자, SK하이닉스, Micron은 모두 LPDDR5X 공급에서 경쟁하고, 대량 플랫폼인 NVIDIA 플랫폼의 자격 확보는 단일 design win 이상의 가치가 있다. 물량, 가격 협상력, 다음 모듈 개정에서의 위치를 고정하기 때문이다. 한국 공급사에게는 각별한 의미가 있다. LPDDR 리더십은 역사적으로 한국의 강점이었고, SOCAMM2는 그 강점에 스마트폰을 넘어서는 서버 쪽 출구를 새로 열어주기 때문이다. 서울에서 읽는 Vera 이야기는 절반은 CPU 이야기이고, 절반은 CPU를 둘러싼 메모리를 누가 파는가의 이야기다.
내 판단은 이렇다. Vera는 88코어라는 헤드라인도, 설정이 공개되지 않은 벤치마크도 아닌, 실제 agent 워크로드에서 delivered되는 코어당 대역폭으로 평가해야 한다. 독립 테스트가 스펙 우위의 대부분만 확인해도, x86 로드맵에 가해지는 압력 — 채널 확대, MRDIMM 채택, 대역폭 등급별 코어 수 축소 — 이 Vera가 시장을 바꿨다는 가장 분명한 신호가 될 것이다.
Implications
- AI 시스템 구매자: 자체 agent, retrieval, 데이터 로딩 워크로드 기준으로 소켓당 코어당 대역폭과 메모리 용량을 평가하고, 모든 벤더 벤치마크에 TDP와 메모리 구성 공개를 요구할 것 (근거: NVIDIA 아키텍처 공개, 2026년 7월).
- x86 플랫폼 기획: 스펙 격차 — Vera 코어당 약 13.6GB/s 대 DDR5-6400 기준 128코어 Turin 구성 코어당 약 4.8GB/s — 는 MRDIMM과 채널 확대 설계를 선택이 아닌 로드맵 우선순위로 만든다 (계산, 2026년 10월 20일).
- 메모리 공급사: SOCAMM2는 CPU 쪽 LPDDR5X content를 소켓당 1.5TB, Grace의 3배로 끌어올리므로 삼성전자·SK하이닉스·Micron은 더 크고 더 전략적인 소켓을 놓고 경쟁한다 (NVIDIA 아키텍처 공개, 2026년 7월).
- 운영자: 마이그레이션 비용, 소프트웨어 생태계 적합성, monolithic die 가격은 하드웨어 우위의 일부를 상쇄할 수 있다. 헤드라인 IPC 주장보다 총소유비용 테스트가 중요하다.
- CPU 시장: Agentic 워크로드가 계속 성장하면 코어당 대역폭은 코어 수와 나란히 1차 구매 기준이 되고, 코어만 앞세우는 CPU 마케팅은 빠르게 낡을 것이다.
이 글은 2025년 3월과 2026년 7월 NVIDIA 공개 자료와 2026년 10월 20일 기준 스펙 계산에 근거하며, 벤더 성능 수치는 벤더 주장으로 표기했고 독립 검증되지 않았다.
FAQ
Q1. NVIDIA Vera CPU란 무엇이고 언제 공개됐나요? Vera는 Armv9.2-A 호환 custom Olympus 코어 88개와 Spatial Multithreading 기준 176스레드를 갖춘 NVIDIA의 데이터센터 CPU입니다. 2025년 3월 GTC에서 Vera Rubin 플랫폼과 함께 공개됐고, NVIDIA는 2026년 7월 상세 아키텍처 자료를 공개했습니다.
Q2. Vera는 소켓당 얼마나 많은 메모리 대역폭과 용량을 제공하나요? Vera 소켓 1개는 최대 9,600MT/s SOCAMM2 LPDDR5X 최대 1.5TB와 최대 1.2TB/s 메모리 대역폭을 지원하며, 88코어 기준 코어당 약 13.6GB/s입니다 (NVIDIA 아키텍처 공개, 2026년 7월).
Q3. 코어당 대역폭 기준으로 Vera는 Grace 및 AMD EPYC Turin과 어떻게 비교되나요? Grace는 72코어에 546GB/s로 코어당 약 7.6GB/s입니다. 12채널 DDR5-6400 기준 128코어 EPYC Turin 구성은 이론상 614GB/s로 코어당 약 4.8GB/s입니다. Vera의 코어당 약 13.6GB/s는 스펙 기준으로 Grace의 약 1.8배, 해당 Turin 구성의 약 2.8배입니다 (계산, 2026년 10월 20일).
Q4. Vera의 주요 한계와 남은 질문은 무엇인가요? Turin 대비 IPC 최대 1.9배라는 NVIDIA 수치는 벤더 주장이고, Redpanda 등 파트너 벤치마크는 전체 설정과 TDP를 공개하지 않으며, x86 플랫폼은 MRDIMM과 차세대 메모리 설계로 대응 중이고, Vera의 monolithic die는 chiplet 대안보다 제조 비용이 높을 수 있습니다. 방법이 공개된 독립 벤치마크가 여전히 필요합니다 (2026년 10월 20일 기준).
📌 반도체 완전 가이드
반도체의 원리부터 종류·제조 공정·밸류체인과 한국 반도체 산업 지도까지 한 편으로 정리했습니다. 이 글의 배경 지식을 한 번에 잡고 싶다면 반도체 완전 가이드 — 반도체란 무엇인가를 먼저 읽어보세요.
📩 VLSI Korea 뉴스레터 구독하기
매일 발행되는 반도체 심층 분석을 이메일로 가장 먼저 받아보세요. 구독은 무료입니다.