VLSI Korea
Ray-Ban Meta의 AR1 해부: 카메라·음성·AI를 동시에 처리하는 반도체 설계
Ray-Ban Meta의 AR1을 CPU·ISP·NPU, 영상 버퍼, 음성 지연과 AI 메모리 계산으로 해부하고 Gen 2·Gen 3의 변화를 비교합니다.


스마트 글래스의 어려운 문제는 사진을 찍는 순간에도 음성을 놓치지 않고, 영상과 AI가 같은 메모리·전력 예산을 나눠 쓰게 만드는 것이다. Snapdragon AR1 Gen 1은 이를 위해 CPU, ISP, NPU, 저전력 센싱 기능을 한 플랫폼에 모은다. 연산 속도보다 먼저 봐야 할 것은 데이터가 어디서 커지고, 어느 단계에서 줄어들며, 어떤 회로가 계속 깨어 있어야 하는지다.
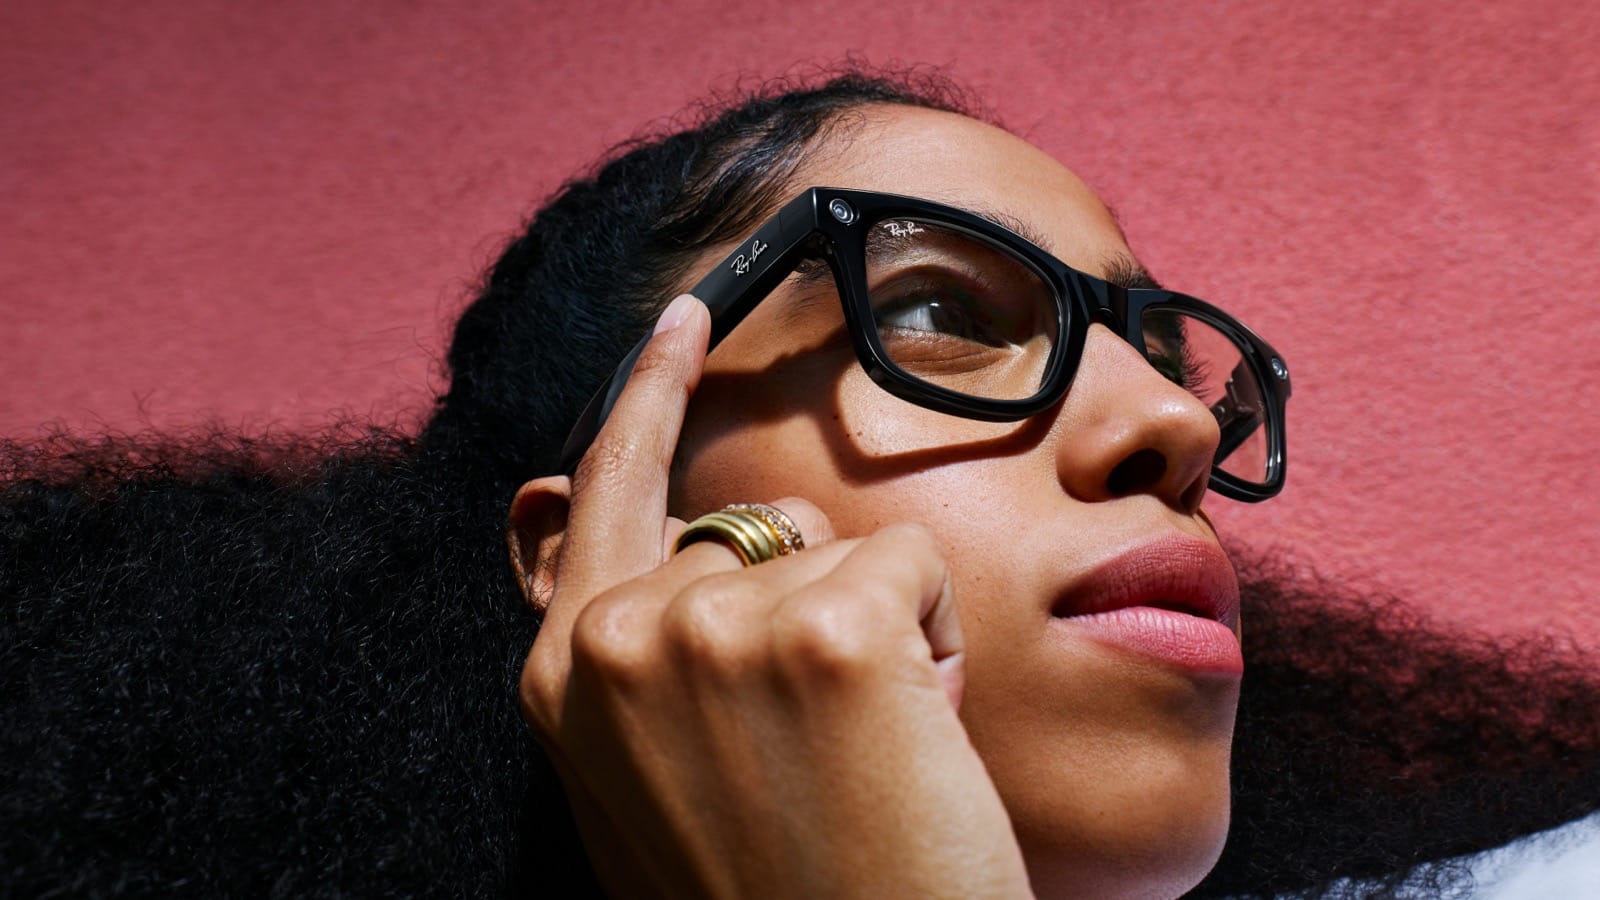
이번 회차는 AR1을 채택한 2023년형 Ray-Ban Meta에서 출발한다. 카메라 경로를 설계하는 엔지니어에게는 버퍼·대역폭·지연의 계산 기준을, 제품 개발자에게는 상시 감지와 촬영·AI 응답을 나눌 기준을 제공한다. 최근 변화는 Meta가 발표한 Gen 2와 2026-09-23의 Gen 3, Qualcomm의 AR1+까지 연결한다. Meta의 AR1 채택 발표
VLSI Korea view: 스마트 글래스의 경쟁력은 가장 큰 연산기를 계속 켜두는 데서 나오지 않는다. 필요한 순간에 적절한 처리기를 깨우고, 다음 단계로 넘길 데이터의 양을 줄이는 설계에서 나온다.
1. AR1 안에서 CPU·ISP·NPU가 나누는 일
CPU는 앱의 상태와 작업 순서를 관리한다. 촬영 버튼 입력을 받아 센서를 설정하고, 버퍼를 배정하고, 완료 이벤트를 받아 저장이나 전송으로 연결한다. 반면 ISP는 픽셀이 끊임없이 들어오는 경로를, NPU는 신경망 연산을 맡도록 구성된다.
Qualcomm의 AR1 제품 자료에는 듀얼 ISP와 Hexagon NPU가 나온다. 공개 Product Brief Rev B는 Kryo CPU, LPDDR4x 지원, 오디오·센서용 Sensing Hub도 명시한다. 이 구성은 제어, 영상, 추론, 상시 감지의 부하를 분리해 읽으면 이해하기 쉽다. AR1 제품 소개 · Product Brief Rev B
| AR1 platform block | Public specification | Design job |
|---|---|---|
| Kryo CPU | 4 cores, up to 1.9 GHz; 64-bit | Control and application software |
| Spectra ISP | Dual 14-bit ISPs | Image processing |
| Hexagon NPU | INT4 / INT8 support | Neural-network inference |
| Sensing Hub | Micro NPU; INT8 | Low-power audio and sensors |
| Memory interface | LPDDR4x, up to 2100 MHz | Shared working data |
| Audio input | Up to 8 microphones | Multi-channel capture |
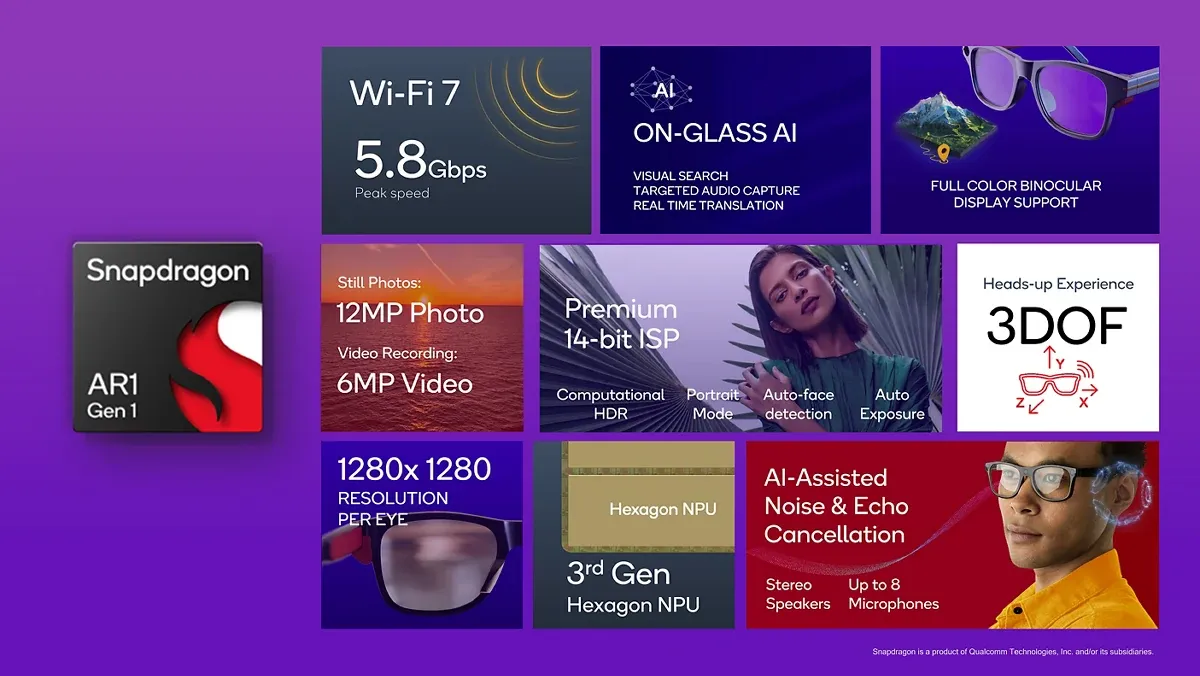
이 표에서 CPU 주파수와 메모리 주파수는 서로 다른 일을 한다. CPU가 빠르게 명령을 실행해도 ISP와 NPU가 동시에 메모리를 기다리면 처리 시간이 늘어난다. 영상 경로에서는 버퍼 소유권과 접근 순서가 클록만큼 중요한 설계 변수가 된다.
센서 DMA가 쓰는 버퍼를 CPU가 동시에 읽으면 아직 완성되지 않은 프레임을 볼 수 있다. 처리 완료를 알리는 fence, 캐시 일관성, 버퍼 재사용 시점을 맞춰야 한다. 운영체제는 작업을 관리하고, 데이터 경로는 준비된 버퍼를 다음 처리기에 넘기는 식으로 역할이 나뉜다.
| Buffer handoff | Release condition |
|---|---|
| Sensor DMA → ISP | Capture completed |
| ISP → encoder / NPU | Processing fence signaled |
| Consumer → producer | All readers finished |
또 하나의 쟁점은 처리량과 지연의 차이다. 초당 프레임을 충분히 처리하는 시스템도 대기열이 길면 사용자의 촬영 결과나 AI 응답은 늦게 도착한다. 평균 처리율뿐 아니라 가장 오래 기다린 작업의 지연을 관찰해야 한다.
예를 들어 사진 보정이 메모리를 오래 점유하는 동안 음성 입력 DMA가 제때 버퍼를 비우지 못하면 소리가 끊긴다. 단순히 CPU 코어를 더 쓰기보다 오디오에 짧고 예측 가능한 서비스 시간을 보장하고, 큰 영상 전송을 적절히 나누는 접근이 필요하다.
이때 하드웨어 가속은 연산 횟수뿐 아니라 데이터 이동 횟수도 줄여야 효과가 크다. CPU가 픽셀을 반복 복사하는 경로보다 ISP가 처리한 버퍼를 인코더나 NPU가 직접 소비하는 경로가 메모리 트래픽과 CPU 개입을 줄인다.
2. 카메라: 12 MP는 출발점이고, 병목은 중간 데이터에 있다
2023년형 Ray-Ban Meta는 12 MP 카메라, 1080p 동영상과 마이크 5개를 갖췄다. AR1 플랫폼이 지원하는 기능 중 제품이 선택한 구성을 보여주는 사례다. 광각 렌즈로 들어온 빛은 이미지 센서에서 전기 신호와 픽셀 값으로 바뀐 뒤 영상 처리 경로로 이동한다. Meta 출시 자료
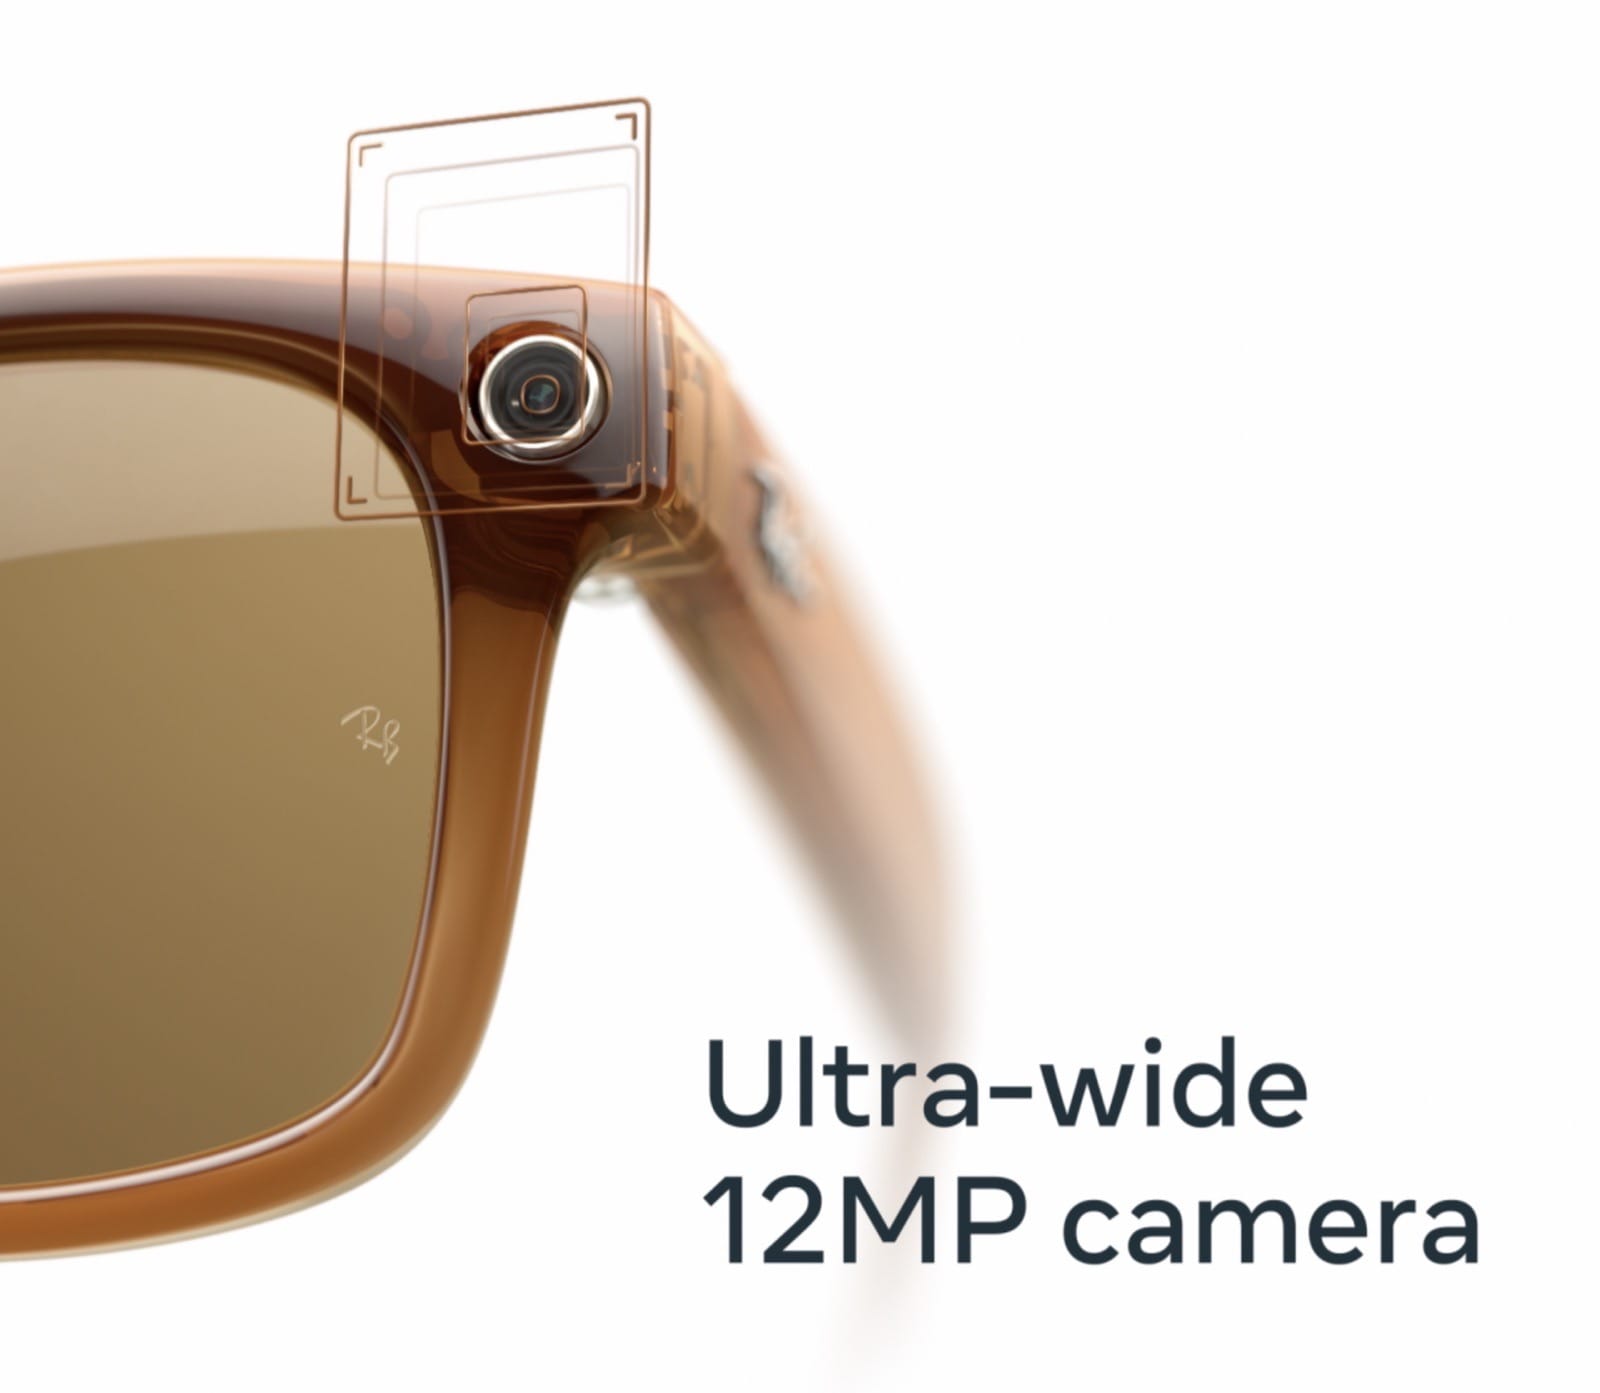
일반적인 Bayer 센서에서는 각 위치가 빨강·초록·파랑 중 한 색의 정보를 읽는다. ISP는 주변 픽셀을 사용해 색을 복원하고, 검은색 기준과 색 균형을 조정하며, 잡음을 줄인다. 광각 렌즈의 왜곡·색수차와 손떨림까지 다루면 센서에서 나온 값과 저장되는 이미지 사이에 여러 중간 표현이 생긴다.
노출을 길게 하면 더 많은 빛을 모을 수 있지만 머리를 움직일 때 흐림이 커진다. 노출을 짧게 하고 gain을 올리면 움직임은 덜 번지지만 잡음이 두드러진다. 여러 프레임을 정렬해 결합하는 처리는 이 교환 관계를 개선하는 대신 이전 프레임을 저장하고 읽는 비용을 추가한다.
HDR도 비슷하다. 밝은 영역과 어두운 영역을 함께 살리려면 서로 다른 노출의 정보를 정렬하고 합쳐야 한다. 걸어가며 촬영할 때는 피사체와 카메라가 동시에 움직이므로 결합 오차가 경계의 잔상으로 나타날 수 있다. 영상 품질은 픽셀 수뿐 아니라 움직임 추정과 메모리 접근에 영향을 받는다.
설계 예제의 입력을 12 MP, RAW12, 30 FPS로 고정해 보자. 이는 계산용 센서 스트림이다. 픽셀당 12 bits를 조밀하게 저장하면 프레임 하나가 12,000,000 × 12 ÷ 8 = 18 MB, 연속 유입은 18 × 30 = 540 MB/s가 된다. MB는 10진 단위다.
같은 프레임을 RGB888로 펼치면 36 MB이고, 초당 데이터는 1,080 MB/s다. 8-bit YUV 4:2:0은 평균 1.5 bytes/pixel이므로 18 MB, 540 MB/s다. 센서 출력, ISP 내부 표현, 인코더 입력을 어떤 형식으로 보관하는지에 따라 버스 부하가 달라진다.
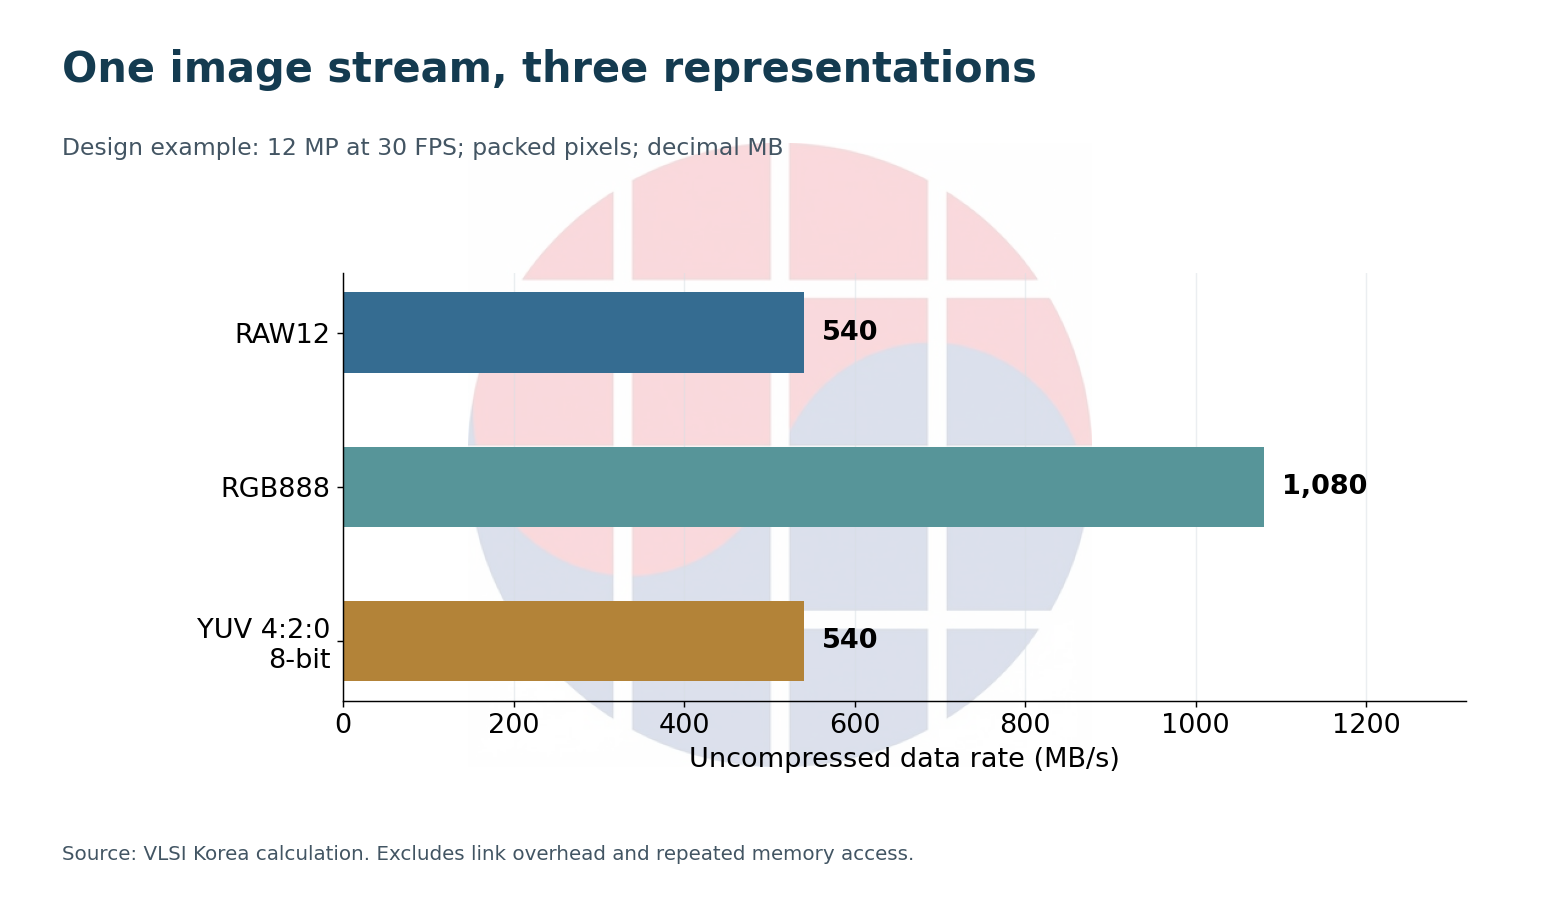
12 MP와 30 FPS를 곱한 결과를 동영상 파일의 비트레이트로 읽으면 안 된다. 압축 전 이미지 데이터는 픽셀 배열이고, 인코더 출력은 장면의 변화와 압축 설정에 따라 크기가 달라지는 비트스트림이다. 개발자는 센서 링크, 작업 메모리, 저장장치, 무선 링크에 서로 다른 예산을 잡는다.
센서에서 프로세서로 이미지를 보내는 인터페이스의 공개 예가 MIPI CSI-2다. MIPI는 고속·저전력 영상 전송과 lane 확장성을 설명한다. 여기서 필요한 설계 구분은 센서 링크가 감당할 유입량과 SoC 안에서 같은 프레임을 여러 번 만질 때의 메모리 대역폭이다. MIPI CSI-2 공개 개요
| Consumer | Buffer policy |
|---|---|
| Latest-frame recognition | Prefer freshness; discard stale work |
| Temporal image filtering | Retain required frame history |
전자식 손떨림 보정은 출력 화면보다 넓게 읽은 영역에서 움직임에 맞는 부분을 고르는 방식으로 구현할 수 있다. 이동 여유를 넓게 잡으면 읽고 처리할 픽셀이 늘어난다. 출력 해상도를 유지하면서 보정 여유를 늘리는 선택은 센서와 ISP의 부하로 돌아온다.
시간축 잡음 제거에서 이전 프레임을 보관하는 경우에도 버퍼 설계가 필요하다. 최신 프레임만 필요한 시각 인식 작업과, 과거 프레임을 참조하는 영상 보정은 같은 폐기 정책을 쓸 수 없다. 프레임의 용도에 따라 수명과 우선순위를 분리해야 한다.
3. 메모리와 인코더: 작은 버퍼는 지연을 줄이고, 큰 버퍼는 변동을 흡수한다
앞의 RAW12 예제에서 프레임 3개를 보관하면 54 MB다. 30 FPS의 프레임 간격은 약 33.3 ms이고, 처리 전에 완성된 프레임 3개가 대기한다면 대기 시간만 약 100 ms가 추가된다. 메모리 용량과 사용자에게 보이는 지연이 같은 큐에서 연결된다.
인코더·NPU가 같은 유입 데이터를 별도로 복사해 쓰는 구조에서는 읽기와 쓰기가 반복된다. 반대로 zero-copy 공유는 복사를 줄이지만 버퍼가 사용 중인 동안 덮어쓰지 못한다. 공유 버퍼를 몇 개 확보할지, 어느 소비자가 늦으면 프레임을 버릴지가 시스템 정책이 된다.
대역폭 예산 예제로, 540 MB/s 스트림을 메모리에 한 번 쓰고 다음 단계가 한 번 읽으면 최소 1,080 MB/s의 트래픽이 생긴다. 처리 결과를 별도 버퍼에 쓰고 다른 단계가 다시 읽는다면 추가 왕복이 붙는다. 인터페이스의 이론상 최대 전송률에는 이런 모든 소비자가 함께 들어간다.
LPDDR4x 지원 주파수만으로 AR1 완제품의 메모리 대역폭을 확정할 수는 없다. 설계 계산에는 실제 데이터 전송률, 버스 폭, 채널 구성과 효율이 필요하다. 첫 번째 예산은 전송률 × 버스 폭 ÷ 8로 잡고, 이후 충돌·전환·refresh·다른 처리기의 접근을 반영한다.
인코더는 매 프레임을 독립된 사진처럼 저장하는 대신 프레임 사이의 유사성을 활용할 수 있다. 움직임이 많거나 장면이 급변하면 필요한 출력량이 달라진다. 평균 비트레이트를 맞추더라도 순간적으로 커지는 출력이 있으므로 짧은 구간을 흡수할 버퍼가 필요하다.
가상의 압축 출력이 12 Mb/s라면 1분은 12 × 60 ÷ 8 = 90 MB다. 무선 링크의 실효 전송률을 24 Mb/s로 가정하면 이 파일을 보내는 이상적인 최소 시간은 30초다. 프로토콜 오버헤드와 재전송을 넣기 전의 계산이다.
| Example transport budget | Value |
|---|---|
| Encoded input | 12 Mb/s |
| Effective file-transfer rate | 24 Mb/s |
| Ideal transfer of a 90 MB file | 30 s |
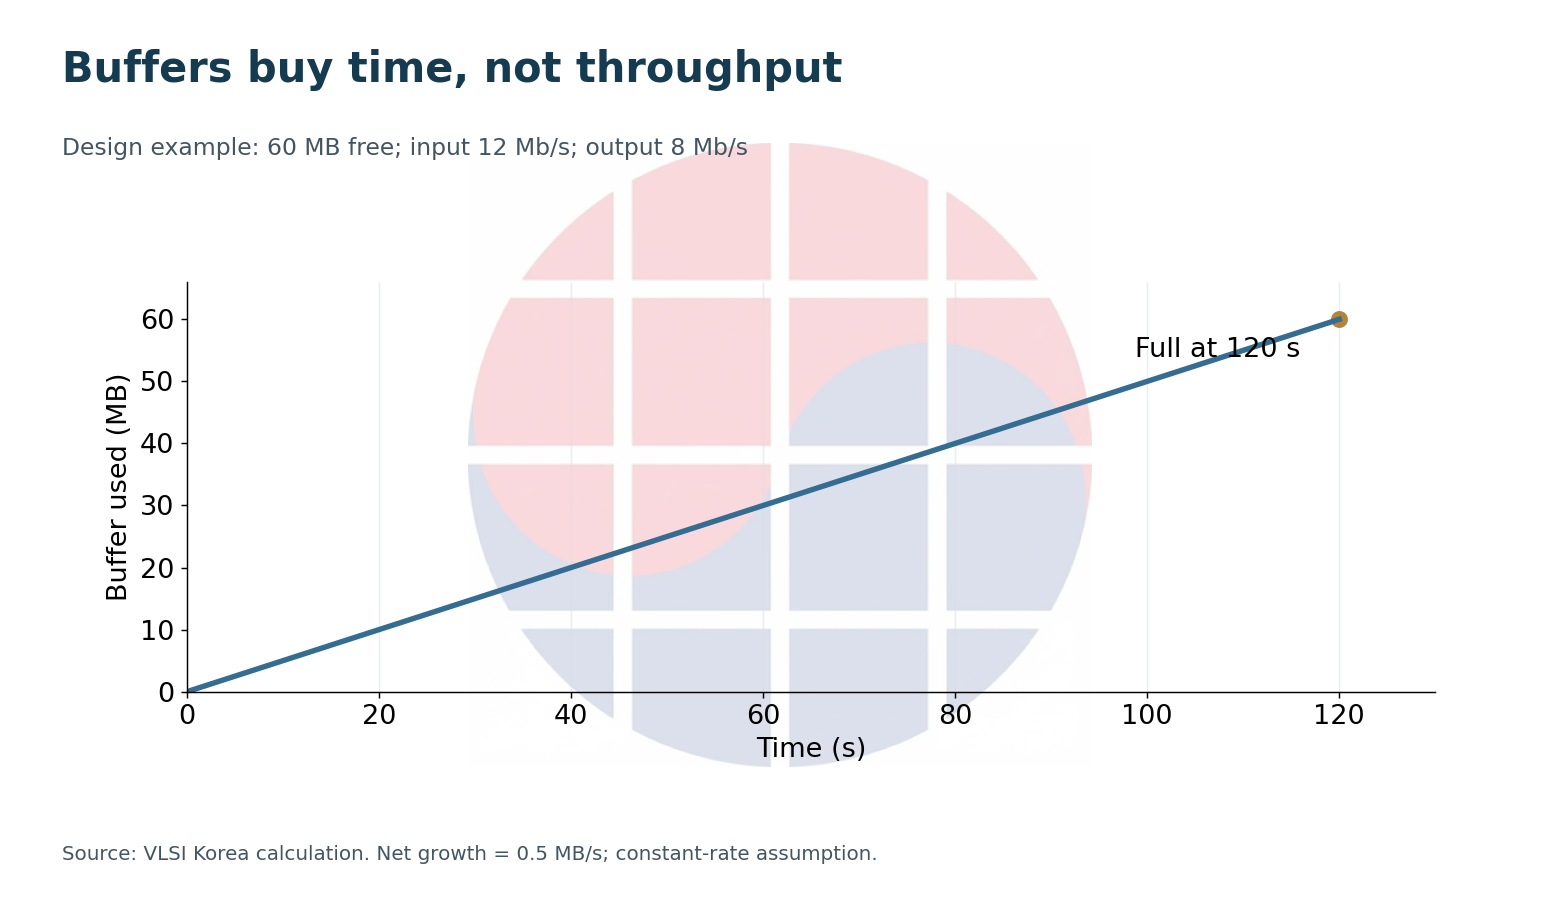
지속 촬영 중 전송한다면 문제는 달라진다. 평균 유출량이 평균 유입량보다 작으면 버퍼는 결국 찬다. 12 Mb/s로 만들어지는 데이터에 유출이 8 Mb/s밖에 없으면 차이는 4 Mb/s, 즉 0.5 MB/s다. 남은 버퍼 60 MB는 120초 후 소진된다.
이 관계는 저장 용량을 늘리기 전에 제품 동작을 결정하게 한다. 촬영을 계속할지, 품질을 낮출지, 전송을 미룰지, 사용자에게 중단을 알릴지를 정해야 한다. 버퍼는 전송 불균형을 영구히 해결하지 않고 일정 시간 동안 숨겨준다.
실제 시험에서는 평균 네트워크 속도보다 전송이 멈춘 구간의 길이도 중요하다. 휴대전화가 멀어지거나 다른 트래픽과 경쟁할 때, 큐가 커지는 속도와 회복 후 비워지는 속도를 함께 기록하면 필요한 메모리를 계산할 수 있다.
4. 음성: 마이크 수보다 타이밍과 깨우는 경로가 중요하다
안경은 입에서 조금 떨어져 있고, 사용자가 바라보는 방향과 바람 방향도 계속 바뀐다. 여러 마이크의 입력을 함께 쓰면 소리가 들어오는 시간 차이와 방향 정보를 활용할 수 있다. 동시에 스피커에서 재생한 자신의 소리가 다시 마이크로 들어오는 경로도 다뤄야 한다.
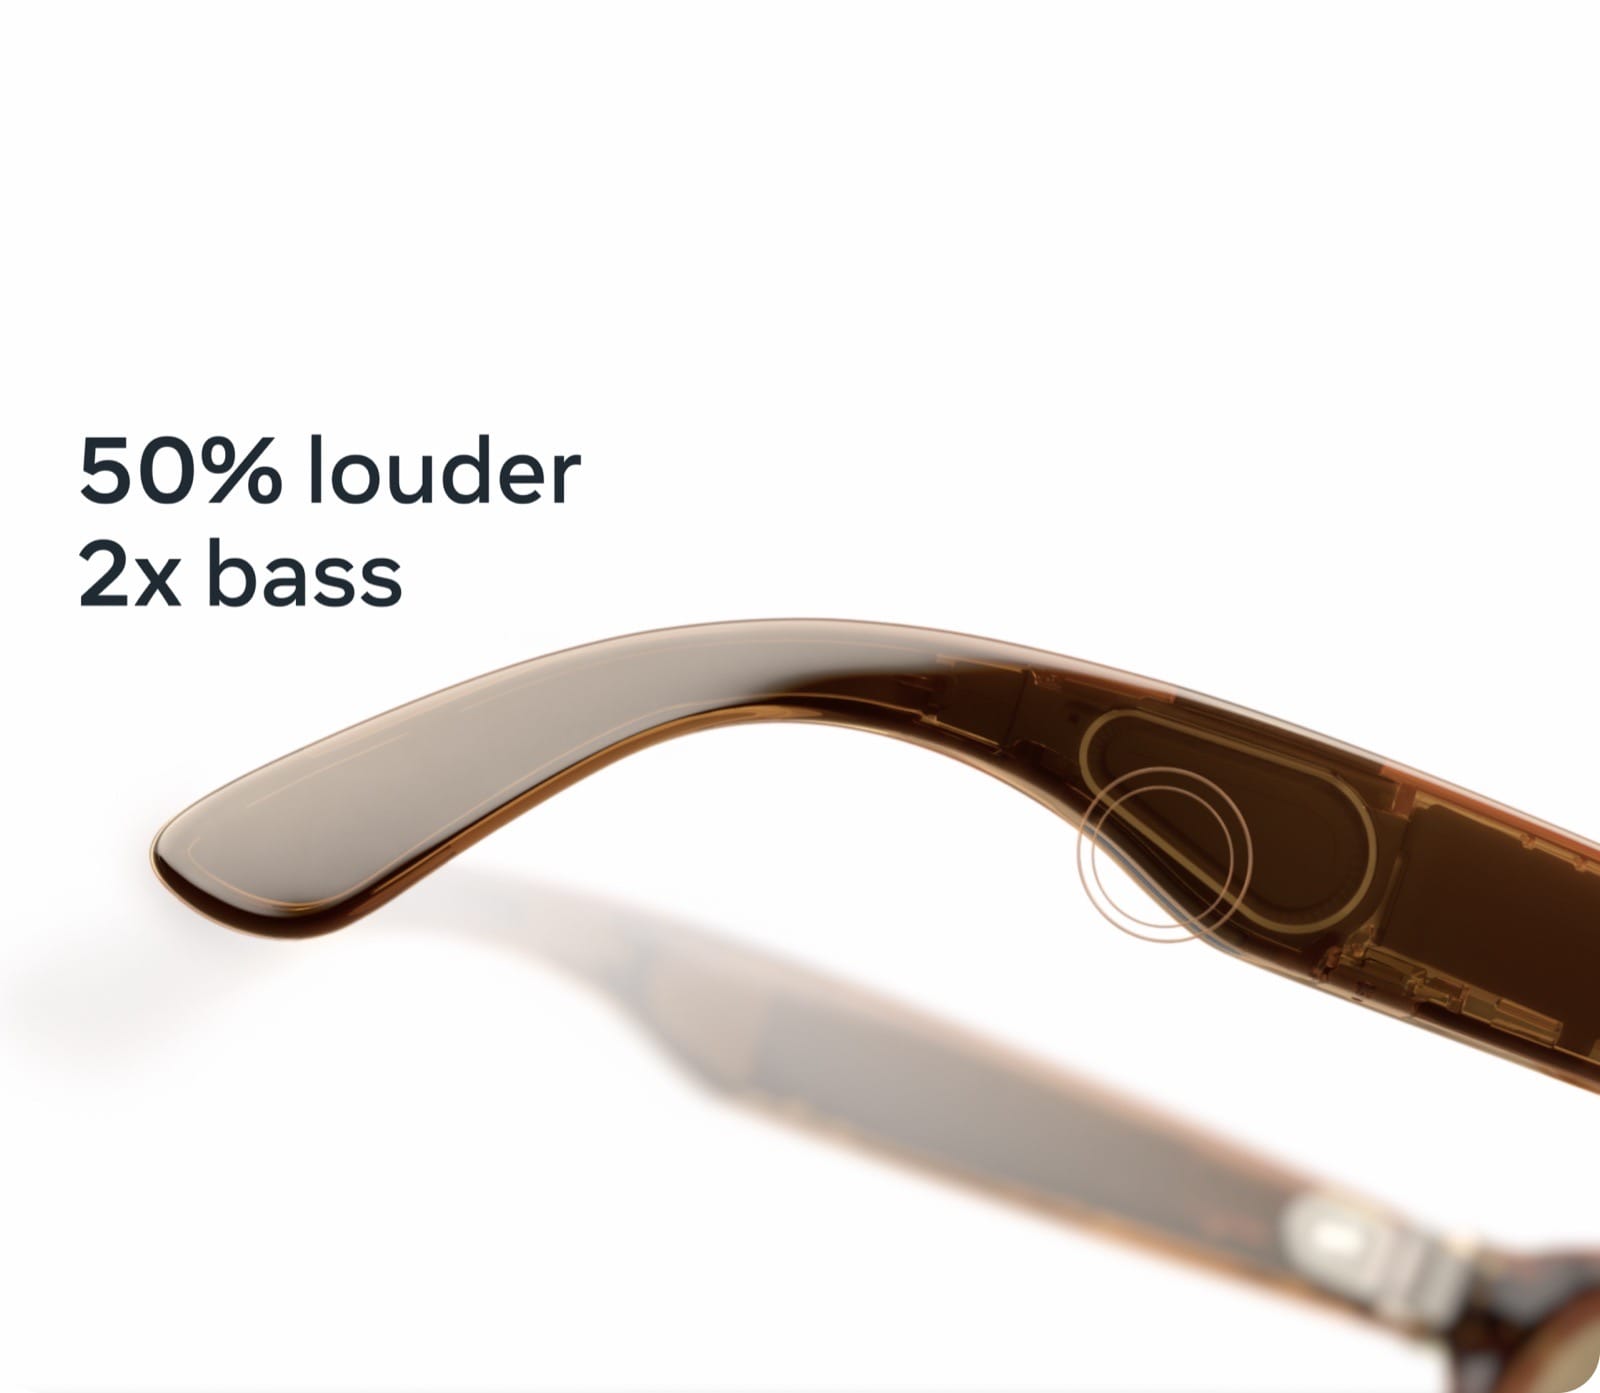
beamforming은 여러 입력을 시간·위상에 맞춰 결합해 원하는 방향의 신호를 강조하는 방식이다. echo cancellation은 재생 신호를 참조해 마이크에 되돌아온 성분을 추정한다. 바람·프레임 진동·마이크 간 감도 차이는 이 처리의 입력 조건을 바꾼다.
입력 개수가 늘면 계산량뿐 아니라 시간 정렬과 보정의 부담도 늘어난다. 마이크 하나의 샘플 위치가 어긋나면 같은 소리가 다른 시간에 들어온 것처럼 보인다. DMA 타임스탬프, 공통 클록, 채널 간 지연을 먼저 맞춰야 다채널 알고리즘을 안정적으로 적용할 수 있다.
가상의 입력을 5채널, 48 kHz, 24 bits/sample로 잡으면 PCM 유입량은 5 × 48,000 × 24 ÷ 8 = 720 kB/s다. 10 ms 블록마다 채널당 480 samples, 전체 7.2 kB가 들어온다. 32-bit 컨테이너에 저장하면 같은 샘플도 메모리에서 960 kB/s, 블록당 9.6 kB를 차지한다.
중간 연산은 흔히 입력보다 넓은 정밀도를 필요로 한다. 여러 마이크 값을 더할 때는 누적 범위를 확보하고, 필터 계수와의 곱셈 후에는 반올림·포화 처리를 설계한다. 입력이 24-bit라는 사실과 내부 버퍼가 사용하는 byte 수는 구분해서 계산해야 한다.
| PCM storage example | Packed 24-bit | 32-bit container |
|---|---|---|
| Stream rate | 720 kB/s | 960 kB/s |
| Data per 10 ms block | 7.2 kB | 9.6 kB |
10 ms 블록을 받아 12 ms씩 처리하는 작업은 꾸준히 뒤처진다. 처음 몇 블록이 정상처럼 들려도 큐가 늘어나 지연이나 드롭으로 드러난다. 평균 처리 시간이 충분히 짧아도 사진 촬영과 겹칠 때의 최악 처리 시간이 deadline을 넘는지 확인해야 한다.
상시 음성 경로는 전체 애플리케이션을 계속 실행할 이유가 없다. 작은 특징 추출과 wake detection을 지속하고, 유효한 이벤트가 생기면 큰 처리기를 깨우는 구성이 가능하다. AR1의 Sensing Hub와 micro NPU는 이러한 작업 분담을 읽는 데 유용한 공개 구성 요소다.
깨우기 앞부분의 소리를 보존하려면 짧은 순환 버퍼가 필요하다. 예를 들어 mono 16 kHz·16-bit 음성의 2초 구간은 64 kB다. 오디오 이벤트를 감지한 뒤 이 선행 구간을 함께 넘기면 단어 시작이 잘리는 문제를 줄일 수 있다.
| Wake-path measurement | Quantity |
|---|---|
| Continuous sensing | Power during uninterrupted listening |
| Event handling | Energy per wake and wakes per day |
VLSI Korea view: 상시 감지의 전력과 이벤트 한 번의 에너지는 따로 측정해야 한다. 감지를 싸게 유지해도 오탐이 자주 큰 처리기를 깨우면 하루 소비량은 커진다.
5. AR1+가 옮기는 AI 경계: 모델 가중치도 전력 예산을 쓴다
Qualcomm은 2025-06-10 AWE 시연에서 안경 위에서 Llama 1B를 실행한 사례를 공개했다. AR1+ Gen 1의 방향은 작은 언어 모델을 안경 안으로 가져오는 것이다. AR1+ 제품 소개는 전 세대 대비 26% 작은 크기와 on-glass SLM 실행을 내세운다. Qualcomm 시연 설명 · AR1+ 제품 자료
플랫폼의 변화는 AI를 전부 안경으로 옮길지의 이분법보다 어떤 작업을 안경에 남길지로 읽는 편이 유용하다. 간단한 명령 분류와 짧은 응답은 작은 로컬 모델의 후보가 되고, 큰 지식 검색이나 복잡한 요청은 연결된 호스트·서비스를 쓰는 구성이 가능하다.
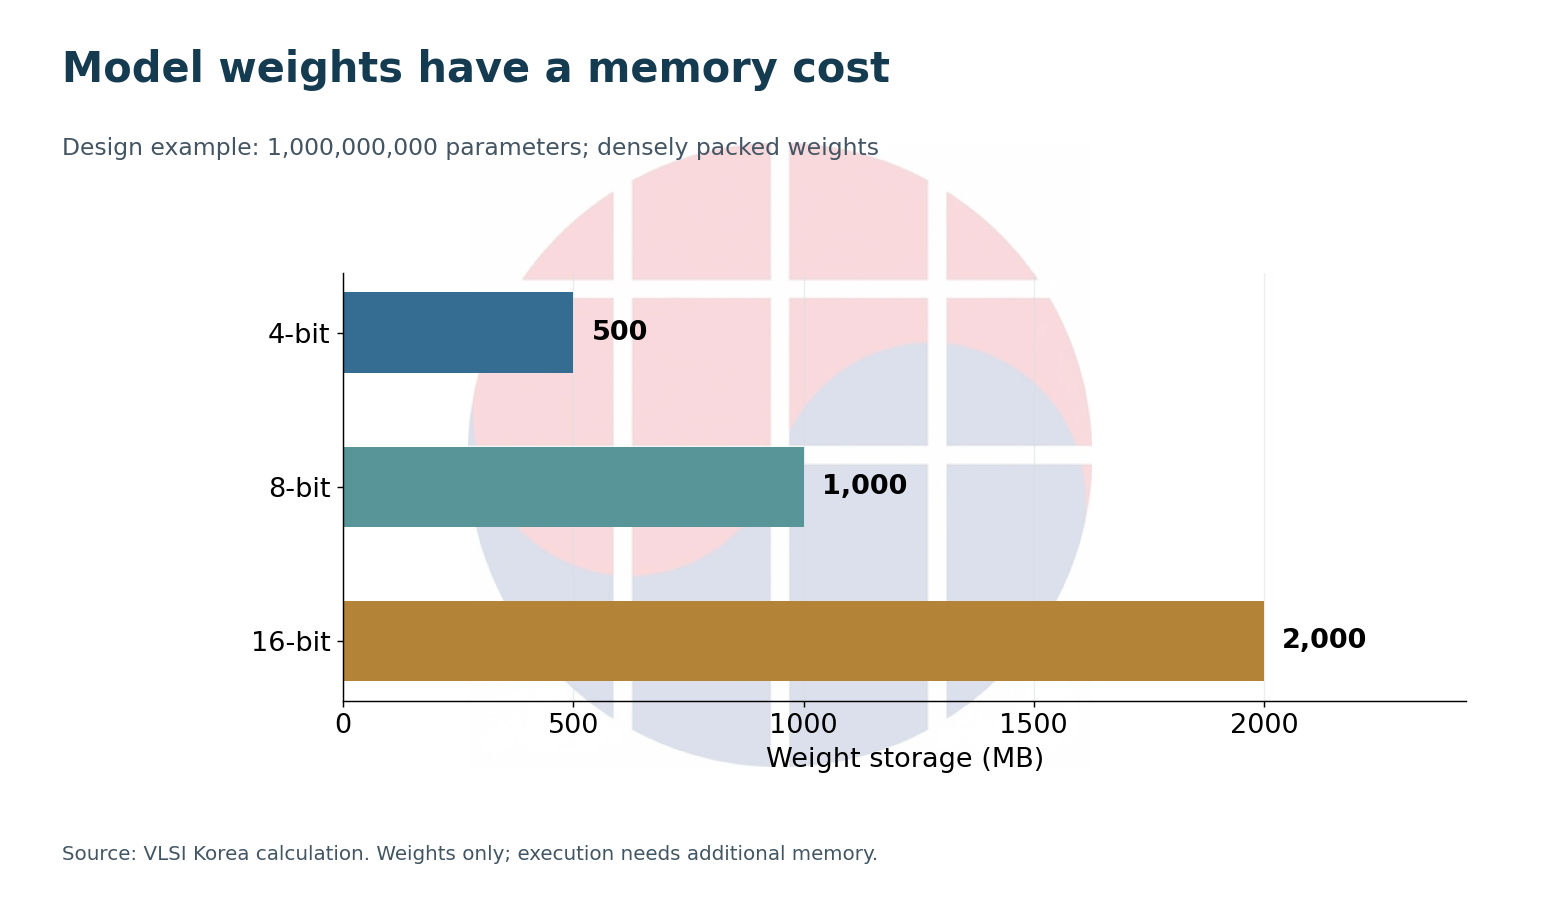
가중치 저장량을 계산해 보면 local inference의 부담이 드러난다. 설계 예제로 파라미터가 1,000,000,000개인 모델을 조밀하게 저장하면 4-bit는 500 MB, 8-bit는 1,000 MB, 16-bit는 2,000 MB다. 이는 순수 가중치이며 실행에는 activation, 캐시와 관리 데이터가 추가된다.
낮은 bit 수는 저장량과 읽기 트래픽을 줄인다. 대신 양자화 오차가 생기므로 실제 음성 명령·짧은 문장·여러 언어에서 정확도를 확인해야 한다. 모델을 작게 만들었다는 사실보다 사용자의 요청을 올바르게 수행하는 비율이 제품의 기준이다.
생성형 모델은 입력을 한꺼번에 처리하는 prefill과 출력 토큰을 순차적으로 만드는 decode의 성격도 다르다. 충분한 연산 병렬성을 가진 구간과, 다음 결과를 기다리며 가중치를 읽는 구간을 같은 평균 TOPS로 표현하면 병목이 가려진다.
단순한 대역폭 예제로 500 MB 가중치를 출력 토큰마다 한 번 읽고 재사용 이득이 없다고 놓으면 10 tokens/s에서 5 GB/s가 필요하다. 실제 트래픽은 캐시·batch·모델 구조·실행 방식에 따라 달라진다. 이 계산의 목적은 연산기뿐 아니라 메모리 이동을 함께 예산화하는 것이다.
| Inference phase | Useful measurement |
|---|---|
| Input / prefill | Time until generation can begin |
| Token decode | Token cadence and memory traffic |
| Speech output | Time to first audible response |
응답 속도를 제품 수준에서 보려면 음성 입력, 전처리, 추론, 음성 출력까지 시간을 합해야 한다. 첫 토큰이 빨리 나와도 사용자가 들을 첫 음성이 늦으면 체감은 느리다. 네트워크를 쓰는 경로에서는 요청 크기·왕복 시간·서버 대기도 별도 항목으로 측정한다.
AR2 Gen 1은 다른 설계 축을 보여준다. Qualcomm은 안경 내부의 processor·co-processor와 Wi-Fi로 연결한 호스트에 일을 분산하는 구조를 설명한다. 카메라·오디오 중심 제품, on-glass SLM, 공간 추적을 위한 분산 AR 구조는 각각 다른 작업량을 겨냥한다. AR2 공식 구조 설명
전력 비교에서는 같은 질문을 같은 정확도로 처리한 에너지를 비교해야 한다. 로컬 처리가 무선 전송을 줄여도 모델 실행 시간이 길면 에너지가 커질 수 있다. 반대로 짧은 요청을 위해 매번 통신을 시작하는 비용이 크면 로컬 처리가 유리할 수 있다.
6. Gen 2·Gen 3의 변화와 안경 전체의 설계 예산
Meta의 2025년 발표는 Gen 2의 3K 영상과 최대 8시간의 일반 사용 배터리 수명을 제시했다. 2026-09-23 발표의 Gen 3는 12 MP 카메라·3K 영상, 마이크 6개, 최대 9시간, 사용자 지정 action button을 내세운다. 아래 표는 각 제품의 공식 발표 내용이다. Gen 2 · Gen 3
| Product | Camera / video | Audio capture | Battery claim |
|---|---|---|---|
| Ray-Ban Meta, 2023 | 12 MP / 1080p | 5 microphones | Up to 4 h |
| Ray-Ban Meta Gen 2, 2025 | 3K video | See product configuration | Up to 8 h, typical use |
| Ray-Ban Meta Gen 3, 2026 | 12 MP / 3K | 6 microphones | Up to 9 h |
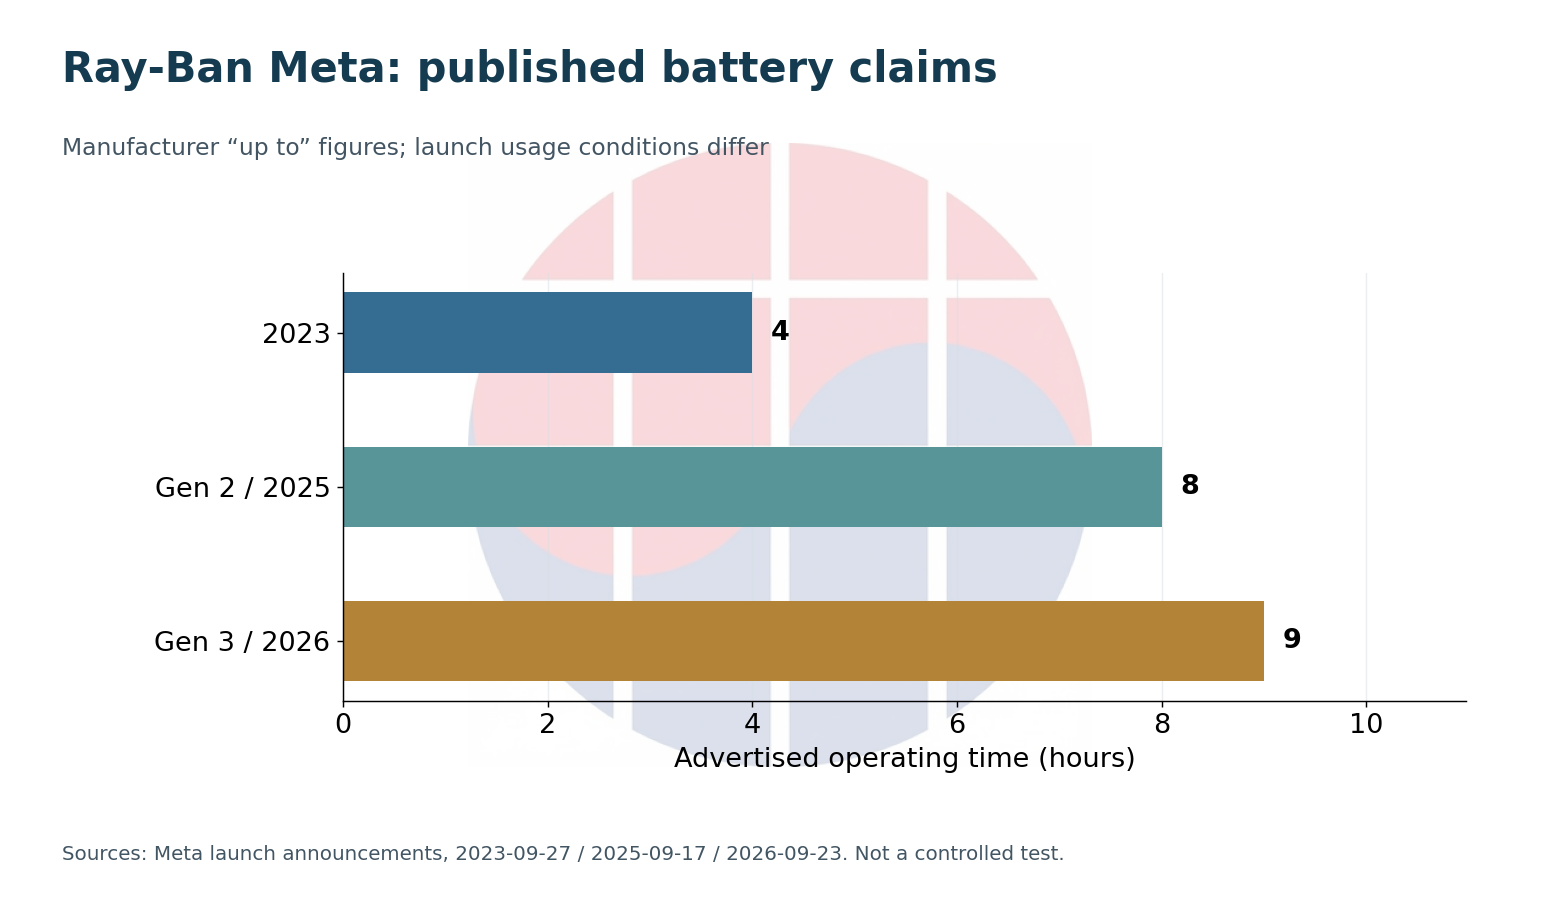
이 비교가 만드는 설계 질문은 세 가지다. 더 큰 영상 데이터를 얼마나 효율적으로 줄이는가, 추가 오디오 입력을 얼마나 낮은 전력으로 처리하는가, 새로운 기능이 들어와도 평균 활성 시간을 얼마나 짧게 유지하는가다. 제품 세대의 변화가 바로 이 세 예산을 압박한다.
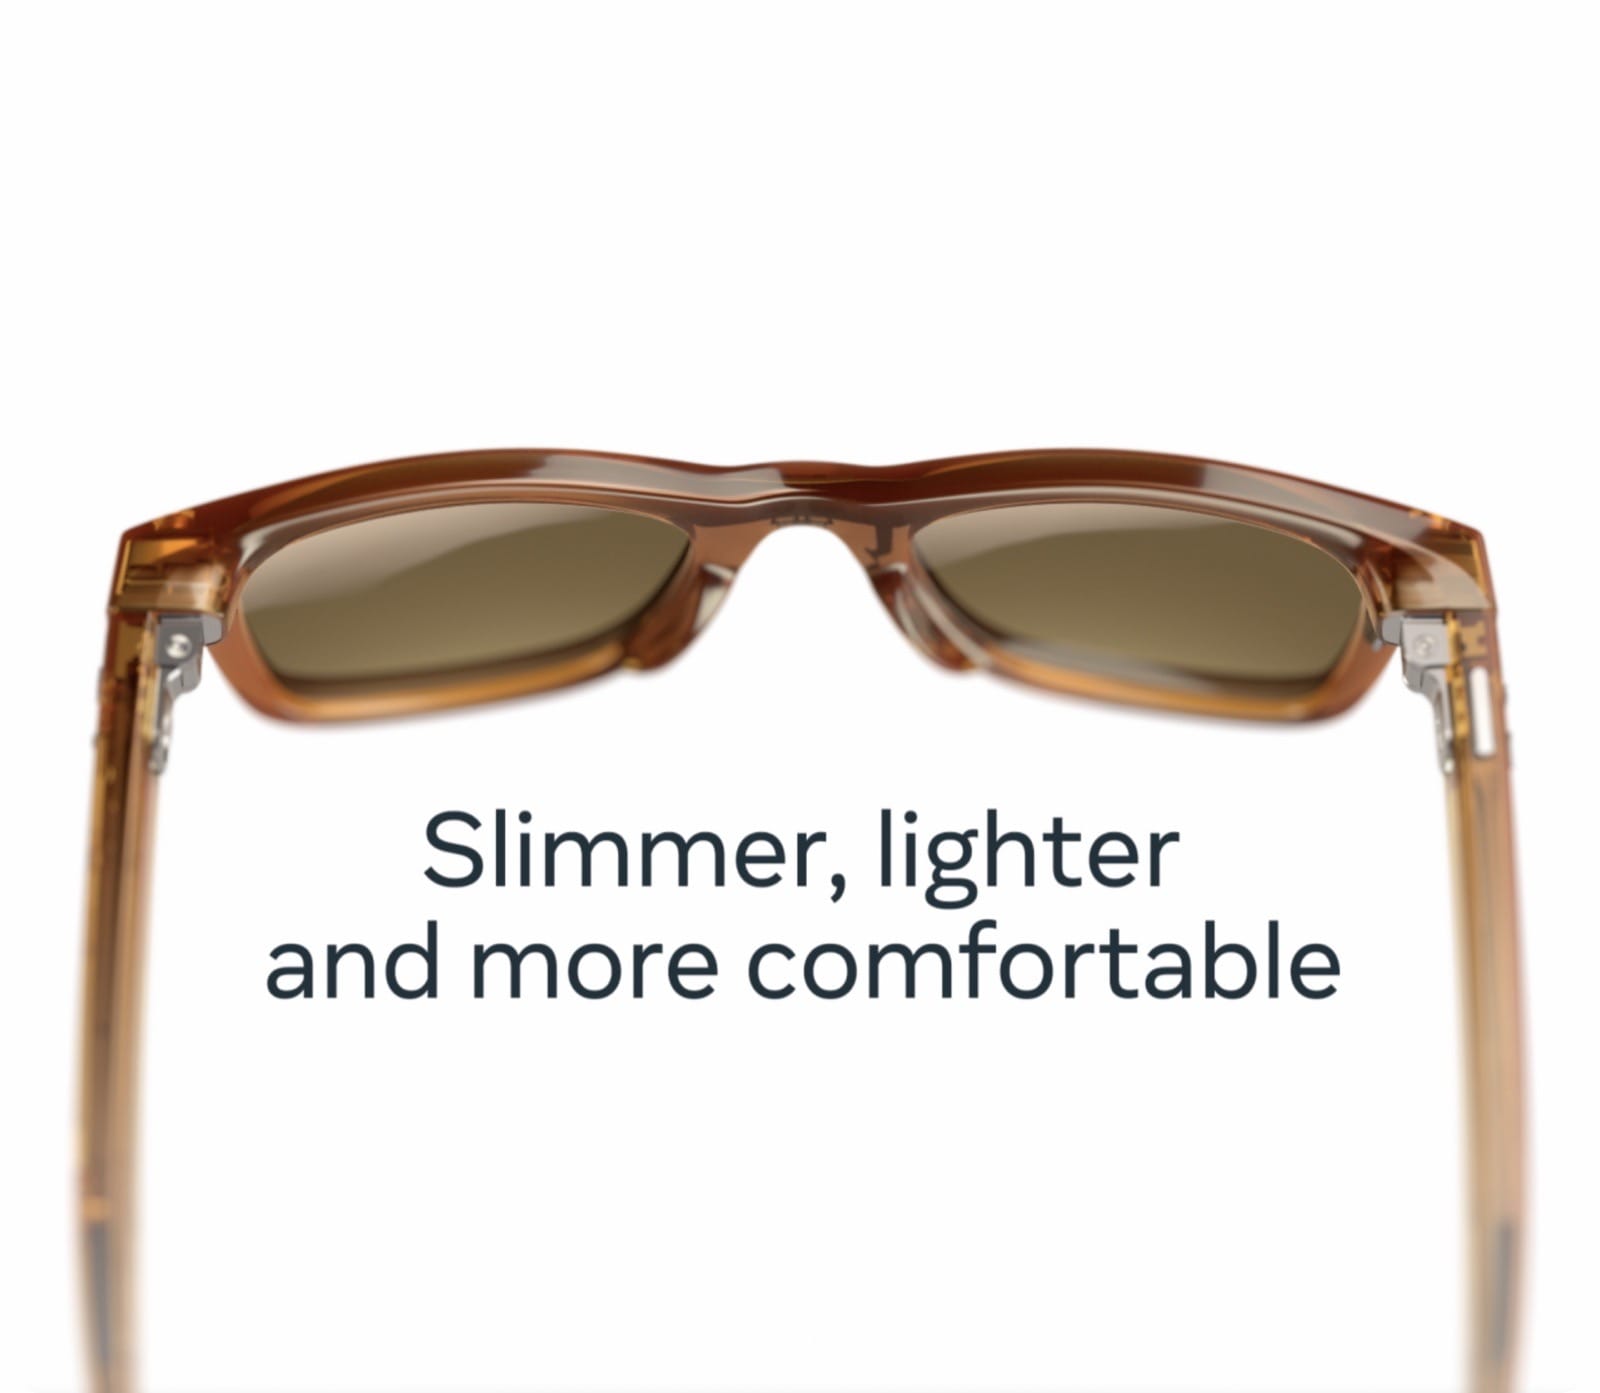
안경 다리에는 연산 칩만 들어가는 것이 아니다. 전원 회로, 메모리, 배터리, 스피커, 배선, 안테나와 기구 구조가 함께 공간을 쓴다. 패키지가 작아지면 배치 선택지가 늘어나지만, 주변 부품의 높이와 열 경로까지 맞춰야 얇은 프레임이 된다.
카메라가 있는 모서리에서 처리 회로까지 데이터가 이동하고, 좌우 오디오와 전원 경로가 이어진다. 보드 면적을 줄이는 동시에 굽힘·조립 공차·접촉부 신뢰성을 확보해야 한다. 열을 넓게 퍼뜨리기 위한 재료와 구조도 피부에 닿는 면과 외부로 노출된 면에 따라 달라진다.
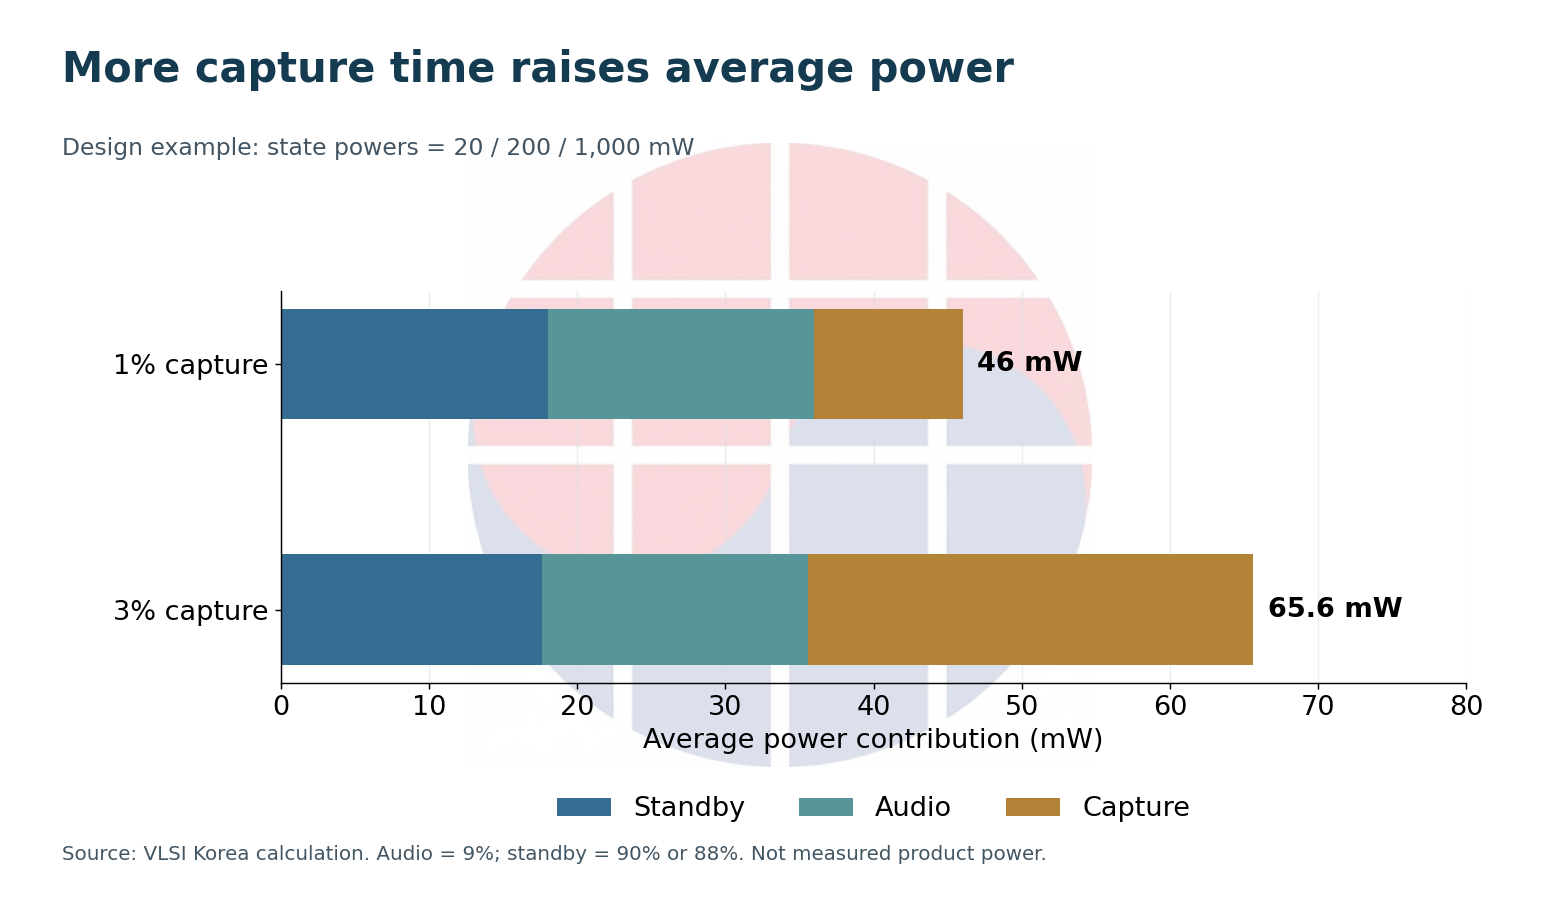
평균 전력은 Pavg = Σ(Pstate × tstate) ÷ T로 계산한다. 가상 상태 예제에서 대기 20 mW·90%, 오디오 200 mW·9%, 촬영 1,000 mW·1%라면 평균은 46 mW다. 짧은 촬영은 전체 시간의 일부지만 평균에 10 mW를 더한다.
같은 상태 전력을 유지하며 촬영을 3%, 오디오를 9%, 대기를 88%로 바꾸면 평균은 65.6 mW다. 공칭 에너지가 같아도 사용 패턴만으로 시간이 달라진다. 따라서 배터리 시간 비교와 별개로 촬영·통화·AI 질의를 각각 반복하는 부하 프로파일이 필요하다.
촬영 직후 무선 업로드와 AI 추론을 모두 시작하면 순간적인 전력 피크가 겹칠 수 있다. 제품이 허용하는 지연 안에서 작업을 순차화하면 피크를 낮출 수 있지만, 대기 시간이 늘어난다. 이 선택은 전원 무결성과 발열, 사용자 응답 시간을 함께 바꾼다.
충전 케이스는 또 다른 에너지 저장소다. 사용 중인 안경의 연속 동작 시간과 하루 동안 케이스로 보충할 수 있는 시간은 분리해 설계해야 한다. Meta는 Gen 2 케이스에 추가 48시간의 충전 여력을 제시했다. Gen 2 공식 발표
검증을 시작한다면 유휴 상태, 통화, 연속 촬영, 촬영과 전송의 중첩, AI 질의의 다섯 경로를 나눠 기록할 수 있다. 각 경로에서 버퍼 최고 점유량, 프레임 드롭, 오디오 deadline 위반, 평균·피크 전력과 첫 응답 시간을 같은 시간축에 놓으면 원인이 연결된다.
| Validation path | Watch on the same timeline |
|---|---|
| Calling during capture | Audio deadline and frame drops |
| Capture plus transfer | Queue growth and power peaks |
| AI query | Memory traffic and first response |
| Idle listening | Wake count and standby power |
칩 설계자는 메모리 중재와 power domain을, 펌웨어 개발자는 버퍼 수명과 wake 빈도를, 제품 개발자는 촬영 길이와 기능 동시 사용 정책을 조정할 수 있다. AR1을 이해하는 실무적 출발점은 이 조정 가능한 항목을 데이터 흐름 위에 놓는 것이다.
웨어러블 반도체 입문편에서는 스마트 링과 글래스의 반도체 구성을 함께 비교했다. 이번 편의 계산은 그중 글래스의 영상·음성·AI 경로를 세분화한 것이다.
Sources
- Meta, Ray-Ban Meta launch, 2023-09-27.
- Qualcomm, AR1 Gen 1 platform and Product Brief Rev B, 0625B.
- MIPI Alliance, CSI-2 public overview.
- Qualcomm, On-glass GenAI demonstration, 2025-06-10; AR1+; AR2.
- Meta, Ray-Ban Meta Gen 2, 2025-09-17; Gen 3 announcement, 2026-09-23.
자료 확인: 2026-09-30. 설계 예제의 입력과 계산은 VLSI Korea 작성.
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.