VLSI Korea
A matemática da produção da Vera Rubin: 576 pilhas HBM4 por rack e 300 mil wafers por milhão de GPUs (TSMC, SK hynix, Samsung, Micron)
A Vera Rubin já está em produção plena: um rack NVL72 consome 576 pilhas HBM4 e cerca de 21.5 wafers. Cada milhão de GPUs exige cerca de 300,000 wafers, e o gargalo da rampa 2026–2027 é a HBM4, não a lógica de 3nm.


A conclusão em uma linha — a velocidade de produção da Vera Rubin não é definida pelas GPUs, mas pelos bits de HBM4. Em uma estrutura em que um rack consome 576 pilhas HBM4 e mais de 21 wafers, o teto da rampa de 2027 é desenhado pelos wafers dos fabricantes de memória.
Resumo em 30 segundos
- Em 21 de outubro de 2026, na keynote do GTC Berlin, o CEO Jensen Huang declarou que a Vera Rubin está "agora em produção plena". O tempo de montagem de um nó caiu de duas horas na Grace Blackwell para menos de cinco minutos, e o resfriamento é 100% líquido.
- Um rack NVL72 abriga 72 GPUs Rubin, 36 CPUs Vera e 576 pilhas HBM4 (20.7 TB = 165,888 Gb). Por GPU, a HBM4 são oito pilhas de 36 GB e 12 camadas (12-high), 288 GB (2,304 Gb).
- Os volumes existem apenas como estimativas. O caso base atual do mercado é de 5,000–7,000 racks no segundo semestre de 2026 (estimativas da cadeia de suprimentos) e de 11,000–21,000 racks em 2027 (0.8–1.5 milhão de GPUs).
- Convertido em wafers, uma GPU consome 0.037 wafers de lógica + 0.143 wafers CoWoS + 0.118 wafers DRAM HBM — cerca de 0.30 wafers no total. Um milhão de GPUs significa cerca de 300,000 wafers.
- Veredito sobre o gargalo: primeiro, a HBM4 (o volume de 2026 está efetivamente comprometido, cortes de alocação foram reportados e a perspectiva de preços de contrato para 2027 é de forte alta); segundo, o CoWoS. Wafers de lógica e montagem de racks não são restrições.
1. A declaração de Berlim — primeiro os fatos confirmados
Em 21 de outubro de 2026, Jensen Huang ergueu um nó Vera Rubin na keynote do GTC Berlin e confirmou três coisas. Primeiro, a Vera Rubin está agora em produção plena. Segundo, o tempo de montagem de um nó caiu de duas horas na geração Grace Blackwell para menos de cinco minutos — resultado da eliminação de cabos e fios. Terceiro, o resfriamento é 100% líquido, contra 80% líquido na geração anterior, com temperatura de entrada do refrigerante de 45°C.
A produção em si não era novidade. A NVIDIA anunciou a entrada em produção na CES de janeiro de 2026, e seu comunicado do GTC Taipei de 31 de maio fixou os embarques de produção para o outono. Em 1º de junho, a operadora de nuvem CoreWeave concluiu a ativação do primeiro rack NVL72 e confirmou a operação ao vivo. O que Berlim confirmou é que "em produção" agora significa uma rampa completa, não amostras e unidades iniciais. Huang também observou que 150 parceiros taiwaneses da cadeia de suprimentos sustentam a Vera Rubin.
Este artigo disseca essa declaração em números: quantos sistemas serão construídos, o que vai em um rack e em que quantidade, como esse volume se converte em wafers, e qual empresa fornece o quê, e quanto. Os números provenientes de divulgações oficiais e da cobertura jornalística trazem suas fontes; os números derivados por cálculo são rotulados como estimativas, com suas premissas expostas.
2. Anatomia de um rack — dentro do NVL72
A unidade de venda da Vera Rubin não é um chip GPU, mas um rack. Um NVL72 consiste em 18 bandejas de computação e 9 bandejas de comutação NVLink, com 72 GPUs unidas pela malha NVLink 6, comportando-se como um único acelerador gigante.
| Componente | Quantidade / Especificação | Notas |
|---|---|---|
| GPU Rubin | 72 | 336B transistores por GPU (dois dies), TSMC 3nm |
| CPU Vera | 36 | Arm de 88 núcleos, NVLink-C2C para as GPUs |
| HBM4 | 576 pilhas, 20.7 TB | 8 pilhas × 36 GB por GPU |
| LPDDR5X (para a CPU) | Até 54 TB | Até 1.5 TB por CPU, módulos SOCAMM2 (segundo análise de corretoras) |
| Malha NVLink 6 | 260 TB/s por rack | 3.6 TB/s por GPU |
| Rede | NICs ConnectX-9, DPUs BlueField-4 | Scale-out via Ethernet Spectrum-X |
| Resfriamento | 100% líquido | Entrada do refrigerante a 45°C |
| Consumo de energia | ~190–230 kW | Estimativas da cadeia de suprimentos |
| Preço do rack | $5M–$7.8M | Cobertura de março de 2026 e análise de BOM de corretoras |
Fonte: especificações publicadas do NVL72 da NVIDIA, cobertura da keynote do GTC Berlin 2026 (21 de outubro de 2026), análise de lista de materiais (BOM) de corretoras.
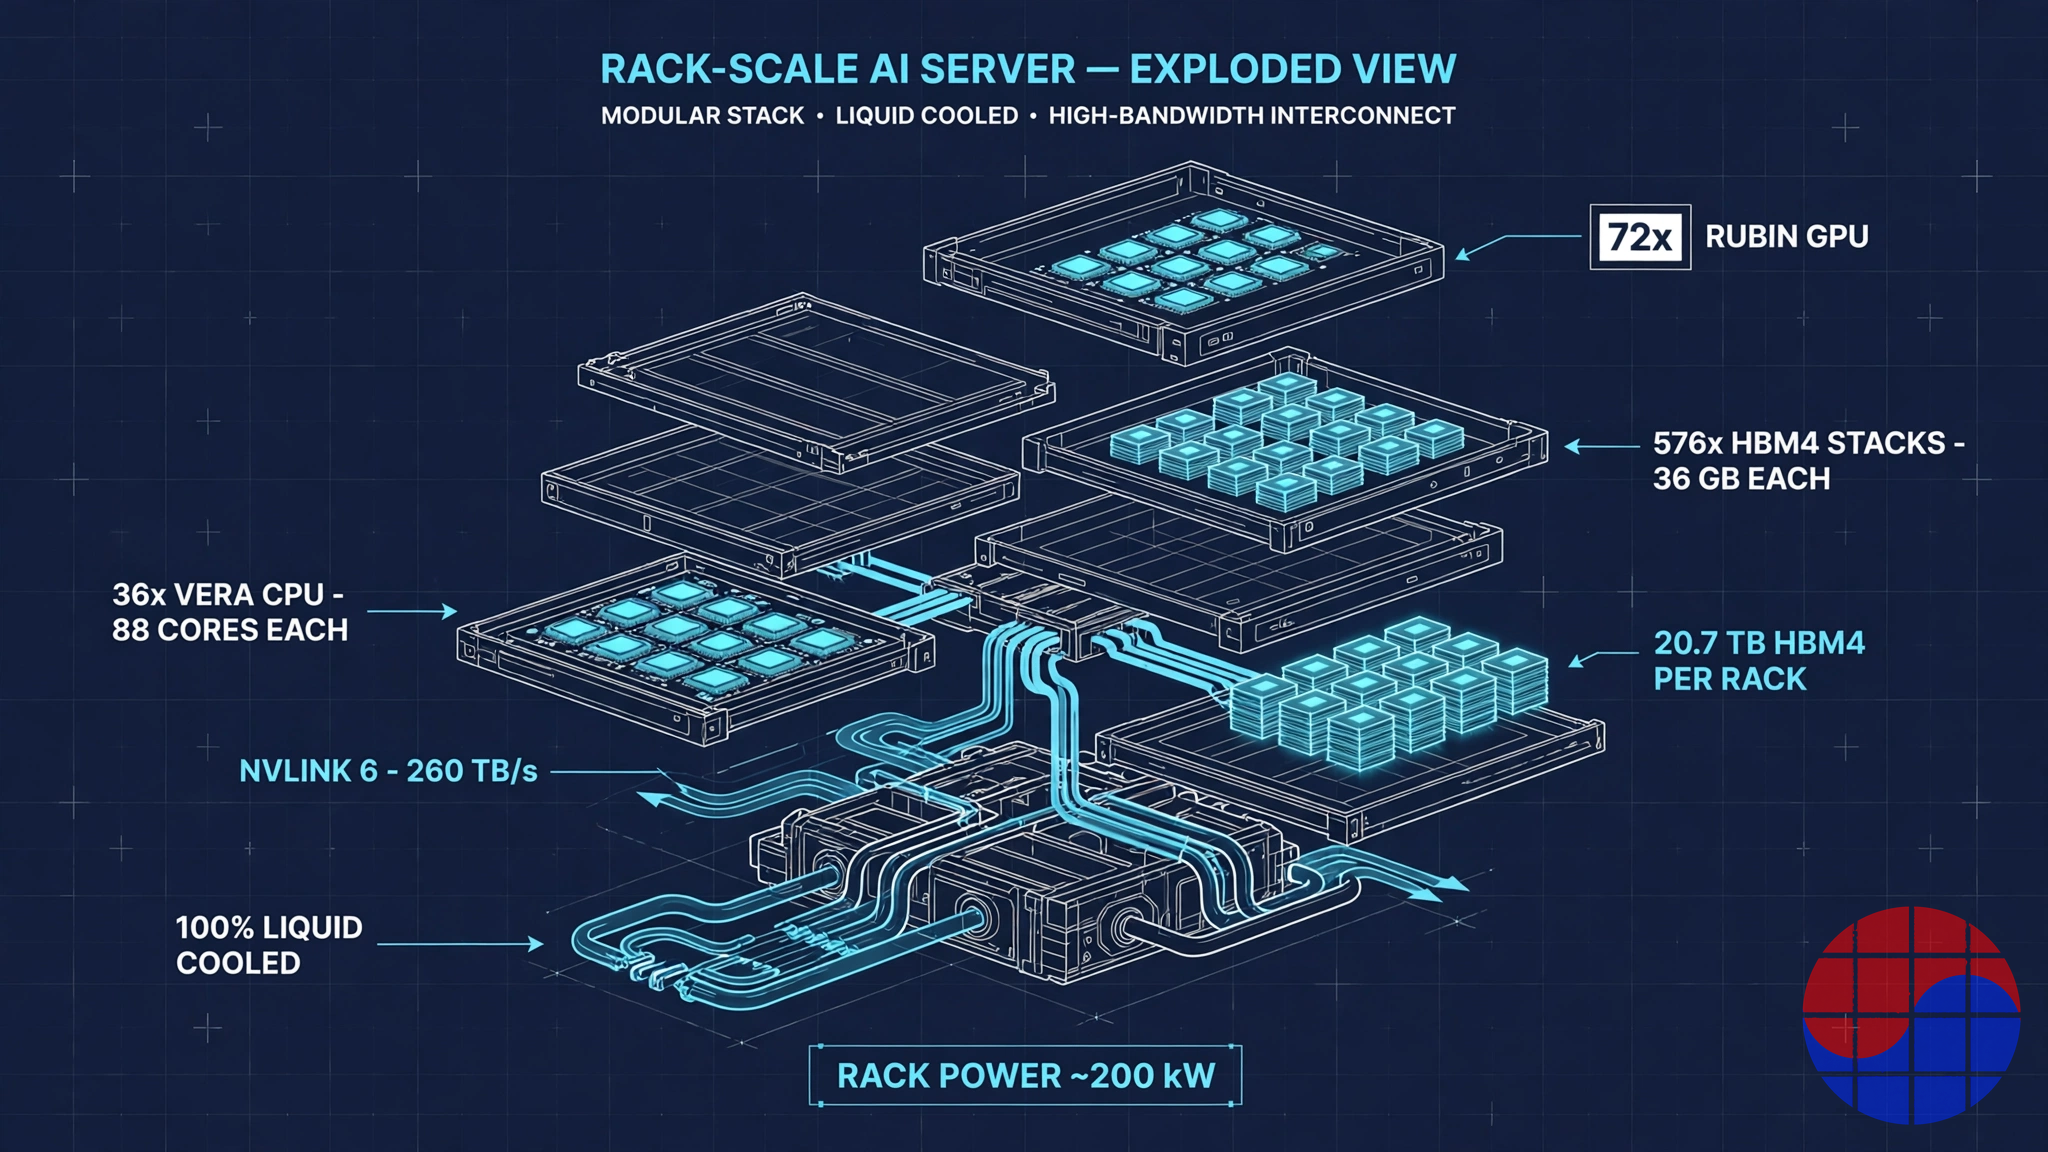
Anatomia de um rack Vera Rubin NVL72 — 72 GPUs e 576 pilhas HBM4 em um único rack. Source: VLSI Korea
A aritmética da HBM4
Esta plataforma é, em sua essência, um sistema de memória. Desdobrando a HBM4 de uma GPU em bits:
| Item | Valor | Cálculo |
|---|---|---|
| Uma pilha HBM4 | 36 GB (288 Gb) | Doze dies de 24 Gb empilhados |
| Pilhas por GPU | 8 | Especificação da NVIDIA |
| HBM4 por GPU | 288 GB (2,304 Gb) | 8 × 36 GB |
| Largura de banda de memória por GPU | 22 TB/s | Especificação da NVIDIA |
| Pilhas por rack | 576 | 72 × 8 |
| HBM4 por rack | 20.7 TB (165,888 Gb) | 72 × 288 GB |
| Dies DRAM HBM por rack | 6,912 | 576 pilhas × 12 dies |
Em relação à Blackwell, a capacidade HBM por GPU subiu 1.5×, de 192 GB para 288 GB, e a largura de banda 2.75×, de 8 TB/s para 22 TB/s. O número de pilhas permaneceu em oito, mas cada pilha cresceu de 24 GB para 36 GB e as velocidades por pino aumentaram. O que importa para a produção é que todo o aumento de capacidade é cobrado em wafers DRAM adicionais: cada pilha exige doze dies de 24 Gb e, levando em conta o rendimento (yield) dos dies, o consumo real de wafers é ainda maior.
3. Quantos serão construídos — cenários de volume
A NVIDIA não divulga os embarques de unidades da Rubin. Cada número em circulação é uma estimativa, e este artigo usa apenas aqueles com métodos transparentes.
Cálculo reverso 1: a partir da receita
A discussão de mercado, fundamentada na orientação da NVIDIA e em comentários de executivos, contempla um ritmo em que a Vera Rubin contribui com cerca de $20 bilhões em receita trimestral. Dividir pela faixa de preço de rack reportada ($5M–$7.8M) resulta em 2,550–3,975 racks por trimestre, ou cerca de 10,000–16,000 racks anualizados. Note que esse cálculo reverso pressupõe que toda a receita da Rubin vem de racks NVL72, o que o torna uma referência de limite superior — vendas em nível de placa e módulo e receita paralela da Blackwell estão misturadas, na realidade.
Cálculo reverso 2: estimativas da cadeia de suprimentos
Analistas que acompanham a cadeia de suprimentos taiwanesa estimam os embarques de racks VR200 do segundo semestre de 2026 em 5,000–7,000 unidades (reportado como estimativa de Ming-Chi Kuo), o que se converte em 360,000–500,000 GPUs. Com os cortes de alocação de HBM4 reportados na mistura, um consenso paralelo coloca o total de GPUs Rubin de 2026 em 250,000–350,000. Para 2027, o ano de escalada, o cenário base é de 0.8–1.5 milhão de GPUs (11,000–21,000 racks). Estimativas do setor também projetam que os embarques totais de racks da classe NVL72 (GB300 + VR200 + VR300) cresçam mais de 50% ano a ano em 2027, com o VR200 ficando com a maior fatia.
| Período | Racks (est.) | GPUs (est.) | Pilhas HBM4 (est.) | Base |
|---|---|---|---|---|
| 2º semestre de 2026 | 3,500–7,000 | 250K–500K | 2.0M–4.0M | Estimativas da cadeia de suprimentos; início dos embarques no outono |
| Por trimestre no pico da rampa | 2,550–3,975 | 180K–290K | 1.47M–2.29M | Cálculo reverso a partir de ~$20B de receita trimestral |
| 2027 | 11,000–21,000 | 0.8M–1.5M | 6.4M–12.0M | Faixa do cenário base |
Cada número desta tabela é uma estimativa, não um número confirmado. O que está confirmado é a própria produção, e o início dos embarques no outono.
Convertido em bits de HBM4, o quadro muda de escala. Mesmo o extremo inferior do caso base de 2027 (0.8 milhão de GPUs) exige 230 PB (230,400 TB) de HBM4; o extremo superior (1.5 milhão de GPUs) chega a 432 PB. Uma única plataforma absorve uma parcela substancial de toda a produção mundial de HBM.
4. A conversão em wafers — uma GPU = 0.30 wafers
Converter o volume em wafers revela onde fica o gargalo. O modelo abaixo é nosso, com cada premissa divulgada; leia os resultados como faixas.
Premissas
| Tipo de wafer | Premissa | Resultado |
|---|---|---|
| Lógica (TSMC 3nm) | Área do die ~800 mm² × 2 (perto do limite de retícula de 858 mm²), ~65 dies brutos por wafer de 300 mm, rendimento (yield) de die de 85% | ~55 dies bons por wafer = ~27 GPUs |
| Encapsulamento CoWoS | Pegada do encapsulamento ~4,700 mm² (classe de 5.5 retículas de 2026), 6–8 encapsulamentos por wafer | ~7 GPUs por wafer |
| DRAM HBM4 | Die de 24 Gb ~60 mm², ~1,090 dies brutos por wafer, rendimento (yield) efetivo KGD/empilhamento de 75% | ~820 dies por wafer = ~8.5 GPUs |
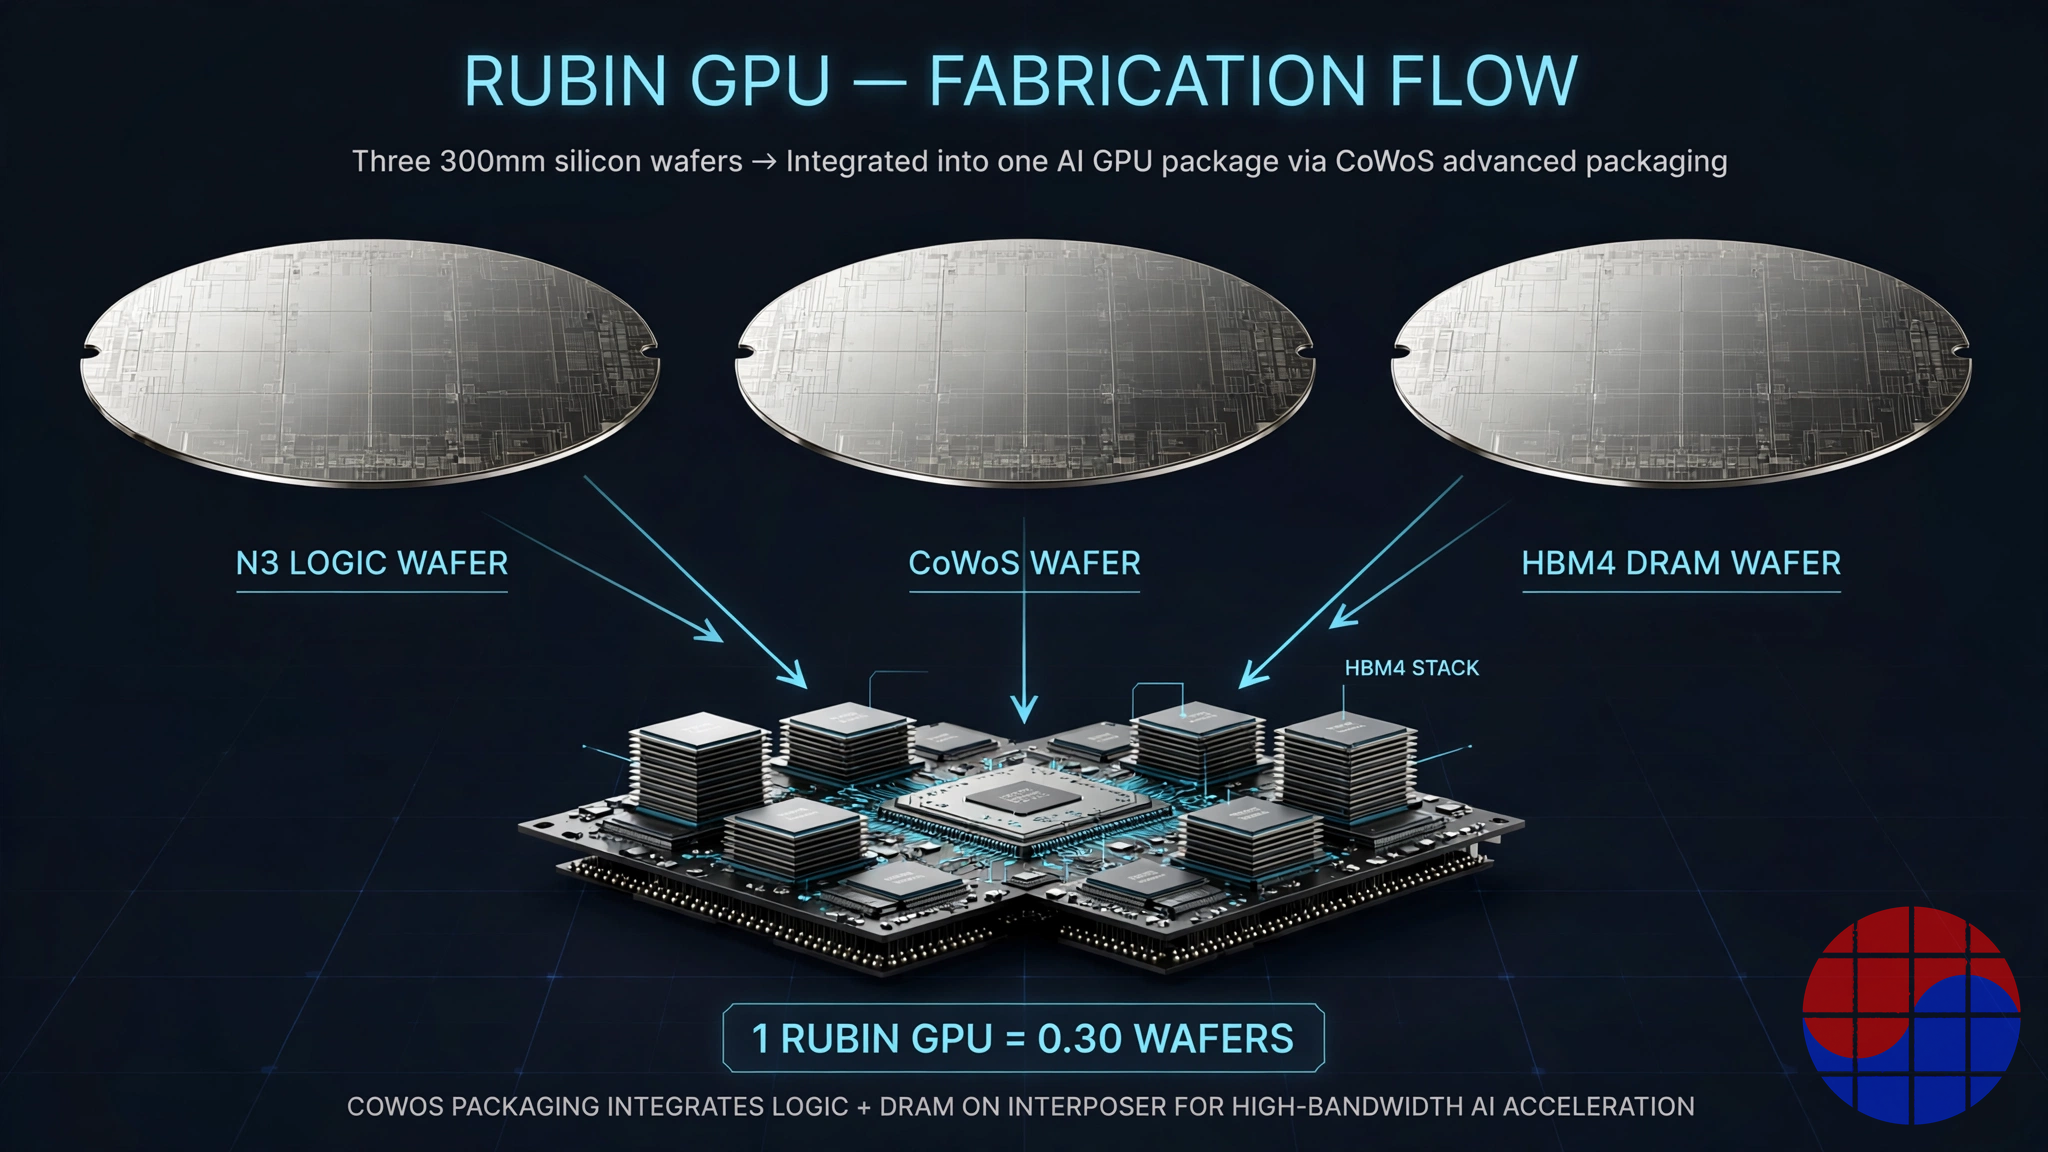
Os três tipos de wafer que uma GPU consome — lógica, CoWoS e DRAM HBM. Source: VLSI Korea
Resultados da conversão
| Categoria | Por GPU | Por rack (72 GPUs) | 2027 (0.8M–1.5M GPUs) |
|---|---|---|---|
| Wafers de lógica (3nm) | 0.037 | ~2.7 | 30K–56K |
| Wafers CoWoS | 0.143 | ~10.3 | 114K–214K |
| Wafers DRAM HBM4 | 0.118 | ~8.5 | 94K–176K |
| Total | ~0.30 | ~21.5 | ~240K–450K |
A conclusão é inequívoca. Construir um milhão de GPUs exige cerca de 300,000 wafers entre os três tipos, e perto de 90% deles são wafers de encapsulamento (CoWoS) e de memória (DRAM). Os wafers de lógica pura são apenas cerca de 12% do total. A cobertura jornalística indica igualmente que os quatro principais projetistas de chips de IA consomem apenas cerca de 12% da produção de lógica de nó avançado — que é precisamente por isso que as fabs de lógica não são a restrição da rampa da IA.
Em contraste com a oferta: a TSMC alcança estimados 120,000–150,000 wafers CoWoS por mês até o fim de 2026, e com a capacidade dos parceiros OSAT o total do setor se aproxima de cerca de 200,000 por mês. Segundo reportado, a NVIDIA reservou antecipadamente cerca de 60% do CoWoS da TSMC de 2026. A necessidade de CoWoS da Rubin em 2027 (114K–214K wafers por ano) é um percentual de um dígito da capacidade anual da TSMC, então a aritmética funciona mesmo compartilhada com a Blackwell — o problema é o crescimento do encapsulamento: à medida que as pegadas dos encapsulamentos se expandem, os encapsulamentos por wafer caem, e a expansão continua sendo devorada pela área.
5. O mapa de fornecedores — quem fornece o quê, e quanto
Por trás de um rack Vera Rubin estão centenas de fornecedores, incluindo os 150 parceiros taiwaneses citados por Huang. O mapa central:
| Empresa | O que fornece | Volume / papel |
|---|---|---|
| TSMC | Dies GPU de 3nm, encapsulamento CoWoS-L | Todos os dies GPU. A NVIDIA teria reservado ~60% da capacidade CoWoS de 2026 |
| SK hynix | HBM4, LPDDR5X SOCAMM2 | Faixa de meados de 50% da alocação inicial de HBM4 (reportado). Pilhas de 36 GB e 12 camadas; SOCAMM2 apresentado para a CPU Vera |
| Samsung | HBM4 | Faixa de meados de 20% da alocação inicial (reportado). DRAM 1c + die base de 4nm; a especificação mais rápida, até 3.0 TB/s por pilha, 11.7 Gbps. Amostras de HBM4E miram a Rubin Ultra |
| Micron | HBM4 | ~20% da alocação inicial (reportado). 36 GB e 12 camadas em embarque de alto volume desde o 1º trimestre de 2026; >2.8 TB/s por pilha |
| Ibiden, Shinko, Unimicron, Nan Ya PCB | Substratos ABF | Substratos build-up para encapsulamentos da classe de 5.5 retículas; a área do substrato é capacidade |
| ASE, Amkor | Back-end (transbordo de CoWoS) | Uma estimada nova capacidade OSAT de 50K–60K WPM absorve o transbordo da TSMC |
| Foxconn, Quanta, Wistron, Inventec | Montagem e integração de racks | Foxconn citada como a maior montadora; o design de nó de 5 minutos define a vazão |
| Dell, HPE, Lenovo, Supermicro, GIGABYTE | Entrega de sistemas | Racks completos para CSPs e empresas |
| Vertiv, Schneider Electric, Delta | Energia e resfriamento | CDUs e energia para racks de ~200 kW; parceiros DSX POD |
| NVIDIA (interno) | ConnectX-9, BlueField-4, switches NVLink, Spectrum-X Photonics | Participação interna crescente no BOM — a fatia da NVIDIA na receita do rack cresce a cada geração |
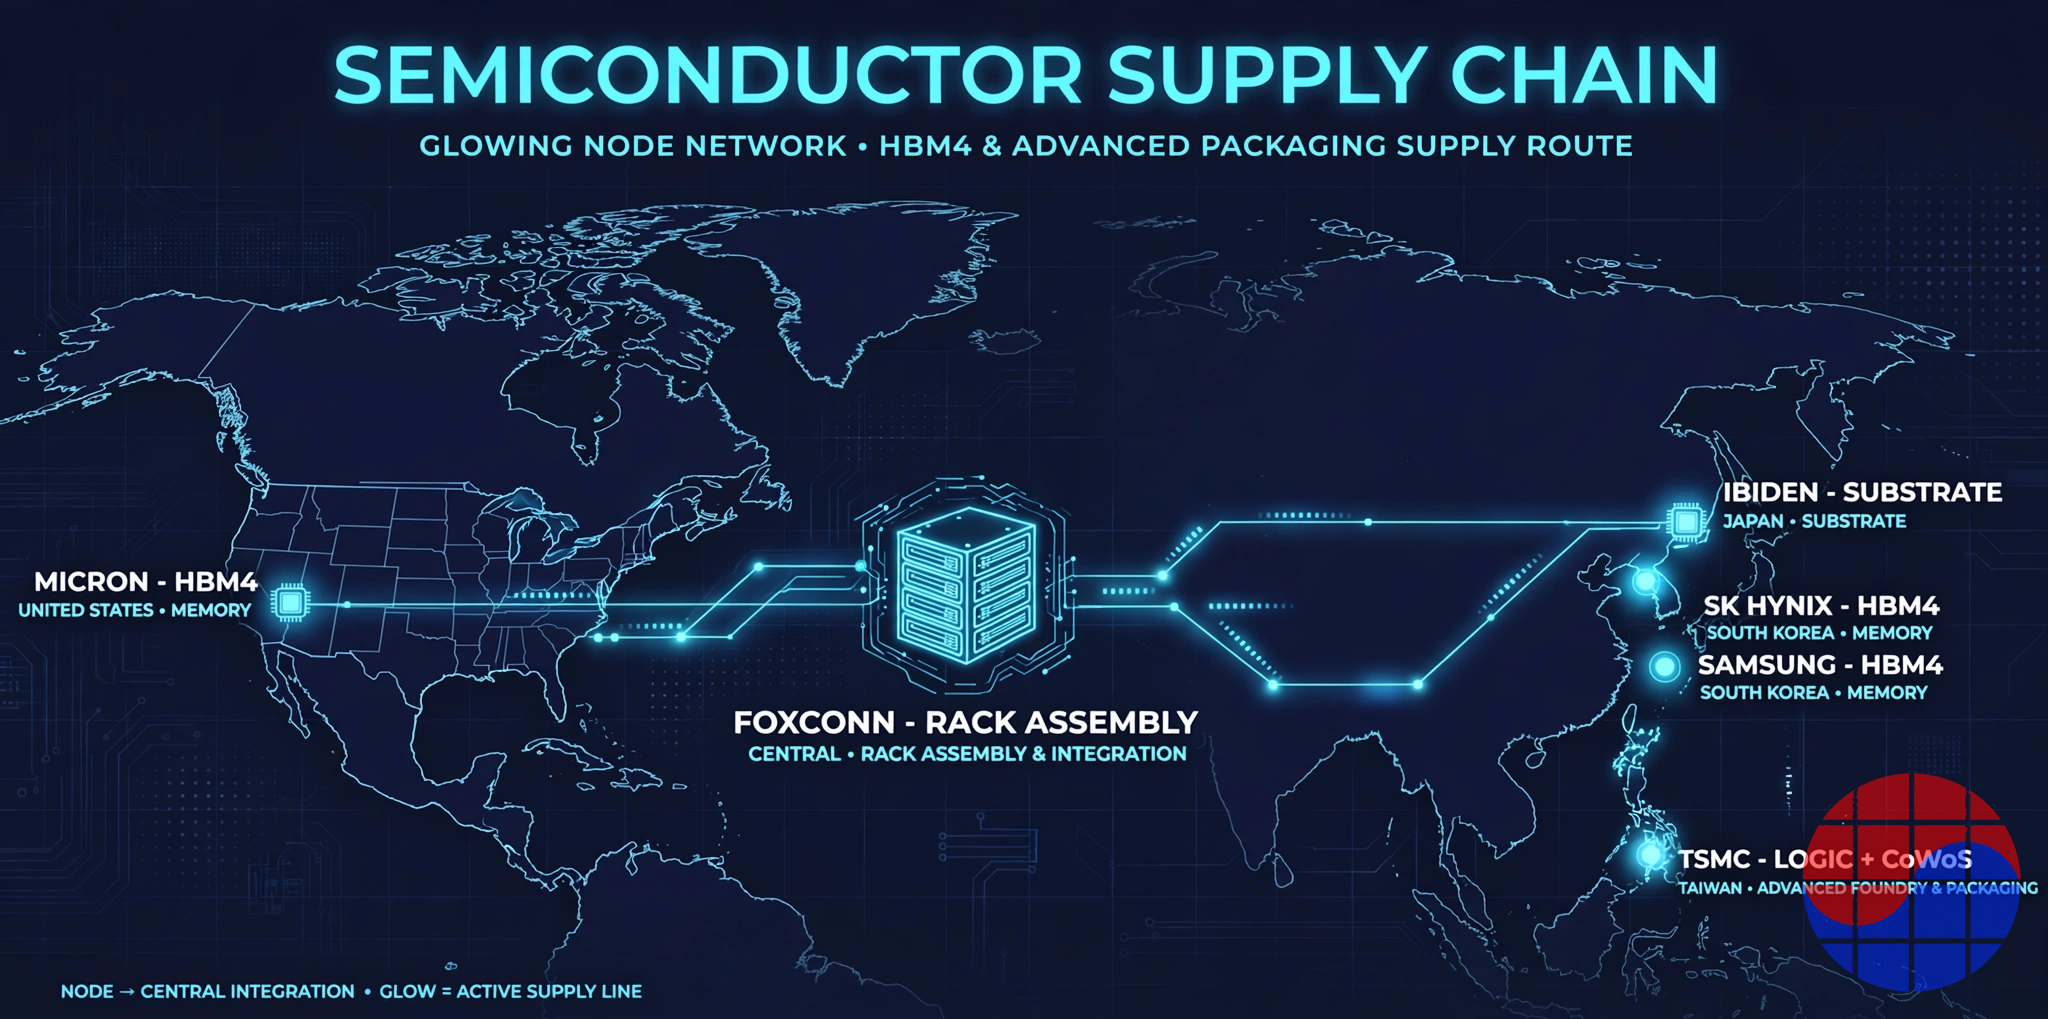
A cadeia de suprimentos da Vera Rubin — lógica e encapsulamento em Taiwan, HBM4 dividida entre Coreia e EUA, substratos no Japão. Source: VLSI Korea
A alocação de HBM4 se apoia na cobertura das atribuições de volume da NVIDIA do fim de 2025: SK hynix a maior, na faixa de meados de 50%, Samsung na faixa de meados de 20% e Micron em torno de 20%. Essa divisão não é fixa. A Samsung iniciou em fevereiro de 2026 os primeiros embarques de produção em massa de HBM4 do setor e lidera nas especificações de velocidade, enquanto a cobertura de abril indicou que a SK hynix avaliou cortar seus embarques de HBM4 de 2026 para a NVIDIA em 20–30% em meio ao cronograma da rampa — uma estrutura em que as alocações trimestrais podem se mover.
A economia da montagem de racks também mudou. Com a montagem de um nó reduzida de duas horas para cinco minutos, a capacidade de montagem não é mais um problema de mão de obra, mas um problema de chegada de peças. Para as montadoras, a Vera Rubin é um rack que embarca na velocidade em que as peças chegam — ou seja, a HBM4 e os encapsulamentos CoWoS acabados definem a utilização da linha. Nosso artigo complementar sobre o design modular de fábrica de IA da NVIDIA, a análise aprofundada do Vera Rubin DSX POD, cobre a velocidade de implantação; este artigo se concentra em quantos sistemas serão construídos, e a partir de quantos wafers.
6. Veredito sobre o gargalo — o que realmente limita a rampa
| Processo | Veredito | Evidência |
|---|---|---|
| HBM4 | A restrição principal | O volume de 2026 está efetivamente esgotado. Revisão de corte de embarques reportada. Projeta-se que uma pilha de 36 GB e 12 camadas suba de ~$600 em 2026 para ~$1,300 em 2027 (estimativa de preço de contrato de +121% ano a ano, reportado) |
| CoWoS | Apertado, administrável | Capacidade multiplicada por ~8 em três anos, mas o crescimento da área do encapsulamento compensa a expansão. Nas estimativas, persiste um déficit de oferta do setor de 10–20% |
| Substratos ABF | Em observação | Diretamente exposto ao crescimento da área dos encapsulamentos grandes; já foi um gargalo silencioso antes |
| Wafers de lógica de 3nm | Não é uma restrição | Os 4 principais projetistas de IA consomem ~12% da produção de lógica de nó avançado (reportado) |
| Montagem de racks | Não é uma restrição | Montagem de nó de 5 minutos, design modular; a restrição é a chegada de peças |
| Energia e locais | Uma restrição do lado do cliente | 190–230 kW por rack; a transição para 800VDC e a infraestrutura de resfriamento líquido são desafios de local |
A conclusão é simples. A função de produção da Vera Rubin se lê min(pilhas HBM4 ÷ 576, encapsulamentos CoWoS ÷ 72, dies de lógica ÷ 144), e em 2026–2027 o termo que define o mínimo é a HBM4. Se a receita da Rubin ficar abaixo da orientação em um resultado da NVIDIA, suspeite das entregas de HBM4 antes da demanda. Por outro lado, se os preços de contrato da HBM4 realmente quase dobrarem em 2027, esse é o sinal de que o trio da memória começou a cobrar sua parte da economia da rampa.
A opinião de Chase
Com todos os números sobre a mesa, a Vera Rubin é menos um produto de GPU do que a forma física de um contrato de compra de memória. Do preço de um rack de $5M–$7.8M, o custo em wafers dos próprios dies GPU é uma parcela menor do que a intuição sugere; o dinheiro e a capacidade estão presos em 576 pilhas HBM4 e na área CoWoS.
De um ponto de vista coreano, observe a inclinação da alocação. A faixa de meados de 50% da SK hynix é continuidade em relação à geração Blackwell, mas a faixa de meados de 20% da Samsung parece um piso para um retorno — se suas cartas de velocidade e HBM4E jogarem no reinício de alocação de 2027, a inclinação muda. E o que decide essa inclinação não é marketing; é o rendimento (yield) KGD trimestre a trimestre e a vazão do empilhamento.
Por fim, o número de 0.30 wafers merece ser lembrado. A competição em aceleradores de IA é agora, simultaneamente, uma disputa de design e uma disputa de alocação sobre três tipos de wafer. O roteiro da TSMC, apontando para HBM5 e encapsulamentos da classe de 14 retículas para a próxima geração, diz que essa disputa de alocação não termina — apenas fica mais cara.
Fontes: especificações publicadas da NVIDIA e cobertura da keynote do GTC Berlin 2026 (21 de outubro de 2026), cobertura coreana e internacional da cadeia de suprimentos e de resultados, análise de lista de materiais (BOM) de corretoras. As conversões de volume e de wafers são estimativas nossas sob as premissas declaradas e podem diferir dos embarques reais. Este artigo não é recomendação de investimento.
FAQ
Q: Quantas pilhas HBM4 vão em um rack Vera Rubin? A: 576. Cada GPU carrega oito pilhas de 36 GB e 12 camadas (288 GB), e um rack abriga 72 GPUs, então 72 × 8 = 576 pilhas — 20.7 TB (165,888 Gb) no total.
Q: Quantos sistemas Vera Rubin serão produzidos em 2027? A: Não há um número confirmado. Combinando as estimativas da cadeia de suprimentos e os cálculos reversos a partir da receita, o cenário base para 2027 é de 11,000–21,000 racks, ou 0.8–1.5 milhão de GPUs. Para o segundo semestre de 2026, estimam-se cerca de 3,500–7,000 racks.
Q: Quantos wafers são necessários para construir uma GPU? A: Cerca de 0.30 wafers entre três tipos: 0.037 de um wafer de lógica de 3nm, 0.143 de um wafer CoWoS e 0.118 de um wafer DRAM HBM4 — nossa própria estimativa sob as premissas divulgadas neste artigo (área do die, rendimentos, pegada do encapsulamento). Por rack, são cerca de 21.5 wafers.
Q: Qual é o verdadeiro gargalo na produção da Vera Rubin? A: A HBM4. O volume de 2026 está efetivamente comprometido, e as revisões de corte de embarques reportadas, somadas a uma perspectiva de preços de contrato para 2027 de forte alta, sustentam esse veredito. O CoWoS está apertado, mas em expansão; wafers de lógica de 3nm e montagem de racks dificilmente podem ser chamados de restrições.
Q: Quais empresas fornecem a HBM4, e em que proporções? A: Segundo a cobertura da alocação do fim de 2025, a SK hynix detém a faixa de meados de 50%, a Samsung a faixa de meados de 20% e a Micron cerca de 20%. A Samsung traz os primeiros embarques de produção em massa do setor (fevereiro de 2026) e as especificações mais rápidas, a SK hynix a maior alocação e o SOCAMM2, e a Micron embarques de alto volume desde o 1º trimestre de 2026 — e as alocações podem ser ajustadas trimestre a trimestre.
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.