 VLSI Korea
d-Matrix và mức định giá 2 tỷ USD: vì sao thị trường trả tiền cho tính toán trong bộ nhớ
d-Matrix chốt vòng Series C 275 triệu USD vào tháng 11 năm 2025 với định giá 2 tỷ USD. Bộ tăng tốc Corsair tính toán ngay trong SRAM ở 150 TB/s mỗi card. Bài phân tích mổ xẻ vật lý băng thông, kinh tế học SRAM, lộ trình 3DIMC của Raptor và điều kiện để mức định giá này đứng vững.


Tóm tắt trong 30 giây
d-Matrix được định giá 2 tỷ USD vì công ty bán đúng thứ mà kinh tế học suy luận đang thiếu: băng thông bộ nhớ không rời khỏi chip. Startup tại Santa Clara này đã chốt vòng Series C trị giá 275 triệu USD vào ngày 12 tháng 11 năm 2025 với mức định giá 2 tỷ USD, nâng tổng số vốn huy động lên 450 triệu USD. Bộ tăng tốc Corsair của hãng thực hiện tính toán ngay bên trong SRAM — Digital In-Memory Computing, hay DIMC — và công bố băng thông trên chip 150 TB/s mỗi card, tối đa 30.000 token mỗi giây trên Llama 70B ở mức 2 ms mỗi token, cùng hiệu quả năng lượng tốt hơn 3–5 lần so với các hệ thống dựa trên GPU. Corsair đã bước vào sản xuất hàng loạt vào tháng 6 năm 2026. Con số 2 tỷ USD không phải là khoản thanh toán cho doanh thu hôm nay. Đó là khoản thanh toán cho một quyền chọn: khi suy luận trở thành chi phí chiếm ưu thế của AI, kiến trúc chiến thắng sẽ là kiến trúc coi bộ nhớ, chứ không phải phép tính số học, là sản phẩm.
| Hạng mục | Chi tiết |
|---|---|
| Định giá | 2 tỷ USD (vòng C, 12/11/2025) |
| Tổng vốn huy động | 450 triệu USD |
| Sản phẩm | Corsair (DIMC, TSMC 6nm) |
| Hiệu năng | 2.400 TFLOPS (8-bit) |
| Bộ nhớ trên chip | 2 GB SRAM, 150 TB/s |
| Bộ nhớ ngoài | Tối đa 256 GB LPDDR5 |
| Thế hệ tiếp theo | Raptor / 3DIMC (mục tiêu tape-out cuối 2026) |
Background: Một công ty được xây cho hiệp hai của AI
d-Matrix được thành lập năm 2019 tại Santa Clara, California, bởi Sid Sheth (CEO) và Sudeep Bhoja (CTO). Cược nền tảng của hãng khi đó không hợp thời: huấn luyện sẽ không mãi là nút thắt của AI. Sau khi được huấn luyện, các mô hình phải trả lời câu hỏi liên tục, ở quy mô lớn, cho người dùng trả phí. Giai đoạn phục vụ đó — suy luận — sẽ trở thành chi phí lớn nhất của ngành. Công ty đã dành sáu năm xây dựng cho giai đoạn ấy, trước khi thị trường đồng tình với họ.
Lịch sử gọi vốn cho thấy luận điểm này dần có thêm người tin. Vòng gọi vốn 110 triệu USD năm 2023 đã đưa M12, quỹ đầu tư mạo hiểm của Microsoft, vào cuộc. Vòng Series C tháng 11 năm 2025 do BullhoundCapital, Triatomic Capital và Temasek đồng dẫn dắt, với sự tham gia mới của Qatar Investment Authority (QIA) và EDBI của Singapore, cùng vốn tiếp nối từ M12, Nautilus Venture Partners, Industry Ventures và Mirae Asset. Tổng vốn huy động đạt 450 triệu USD, và đội ngũ vượt 250 người tại Santa Clara, Toronto, Sydney, Bangalore và Belgrade.
Thời điểm cũng quan trọng. Đến cuối năm 2025, các hyperscaler công khai chuyển trọng tâm chi tiêu vốn từ cụm huấn luyện sang đội hình suy luận, và câu hỏi trung tâm của ngành chuyển từ "huấn luyện nhanh đến đâu" sang "mỗi token tốn bao nhiêu". d-Matrix là một trong số ít startup thiết kế silicon của mình ngay từ ngày đầu cho câu hỏi thứ hai. Mức định giá 2 tỷ USD dành cho một công ty chip chưa đạt quy mô phải được đọc trên nền bối cảnh đó.
Business Deep Dive
Sản phẩm: tính toán ngay nơi trọng số đang nằm
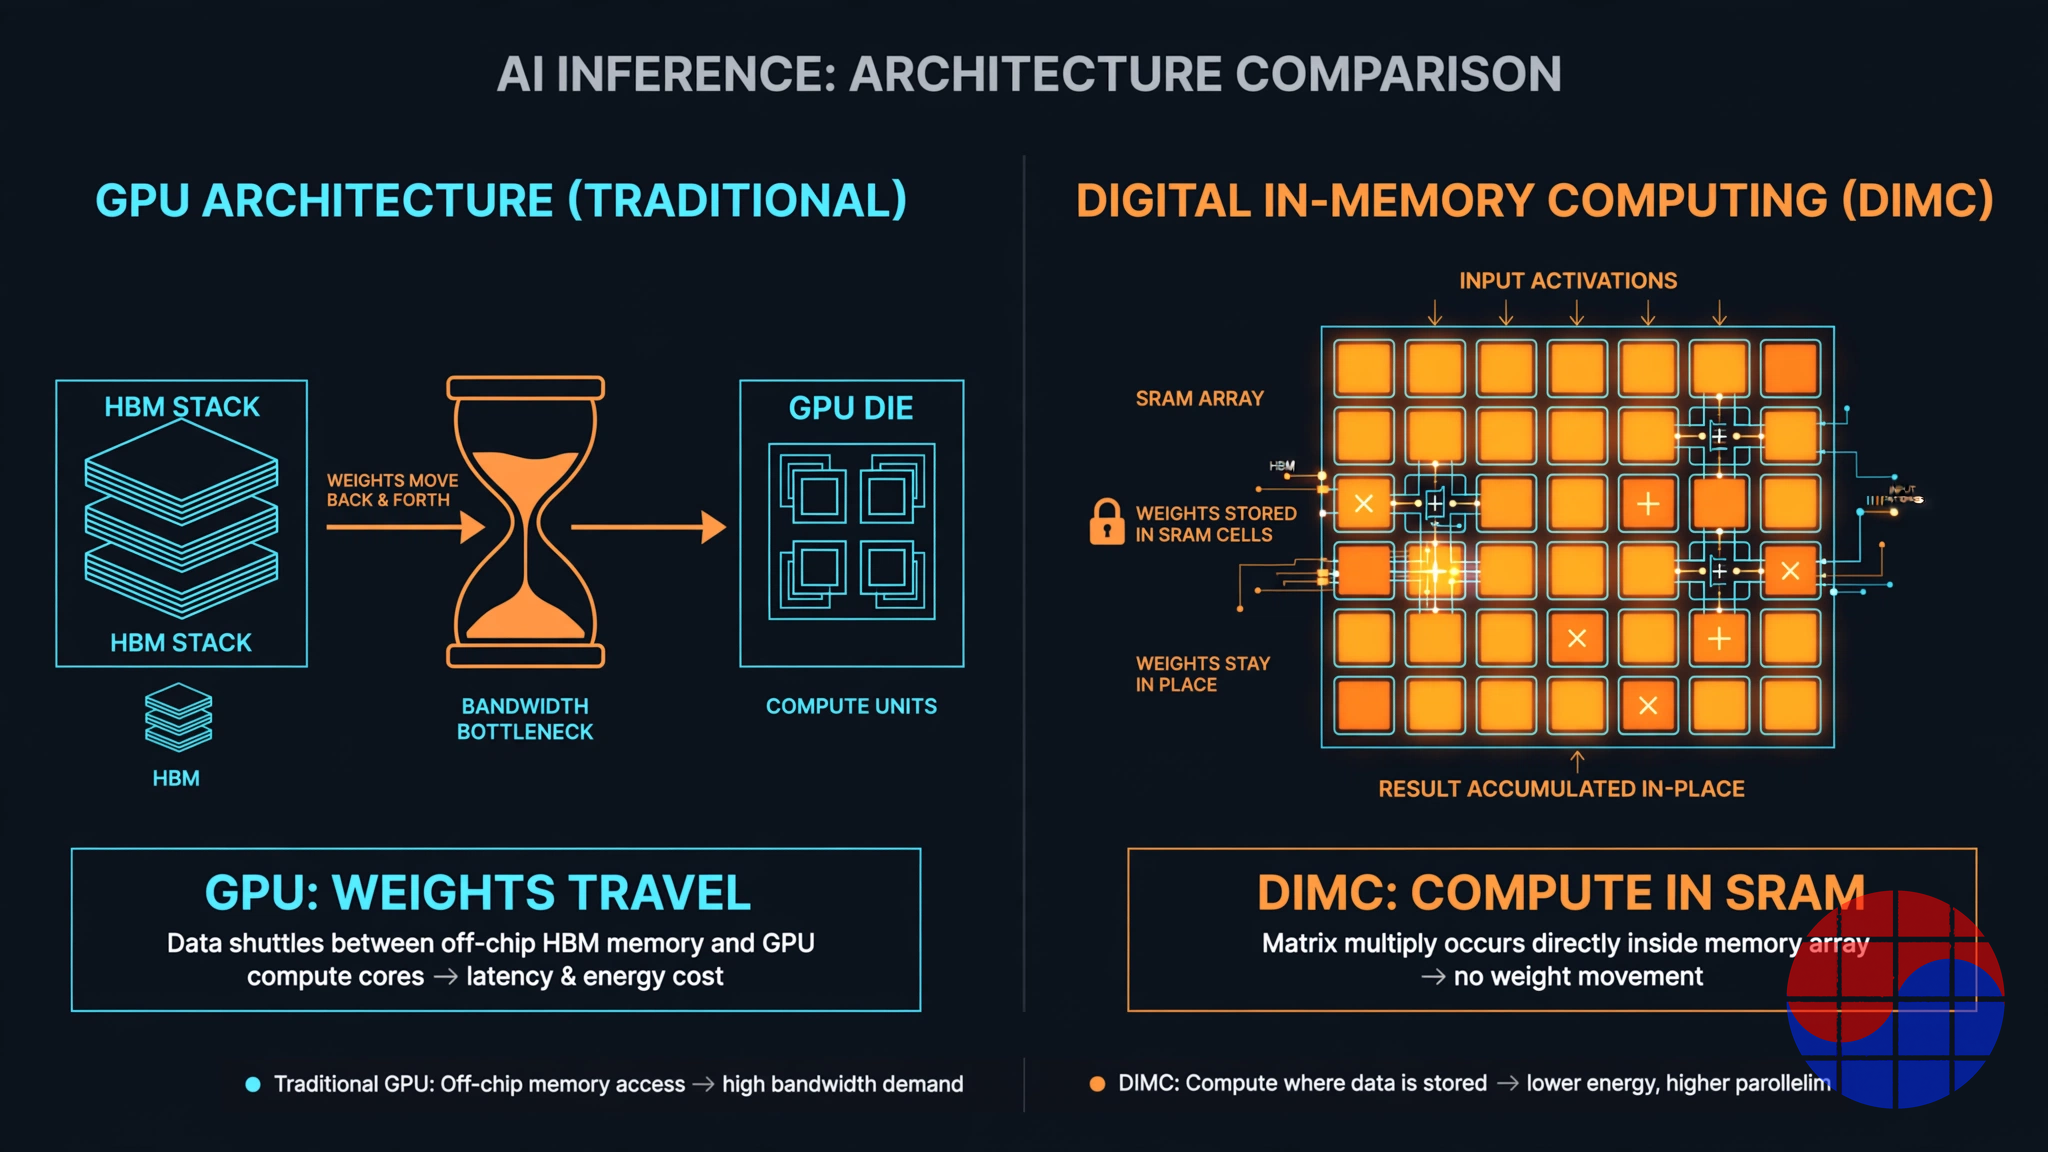
Suy luận ở giai đoạn giải mã bị giới hạn bởi bộ nhớ. Việc tạo mỗi token đều đòi hỏi đọc trọng số của mô hình, và GPU dành phần lớn thời gian cùng năng lượng để di chuyển những trọng số đó qua lại giữa các stack HBM và đơn vị tính toán. Corsair tấn công chính sự di chuyển đó. Các lõi DIMC của hãng thực thi phép toán ma trận bên trong mảng SRAM, nên trọng số không được vận chuyển tới nơi tính toán — chúng được tính ngay tại chỗ.
Các con số của card đang sản xuất định nghĩa sự đánh đổi. Mỗi card Corsair, chế tạo trên tiến trình 6 nm của TSMC theo chuẩn PCIe Gen5, cung cấp 2.400 TFLOPS tính toán đỉnh 8-bit, 2 GB Performance Memory trên chip (SRAM) chạy ở 150 TB/s, và tối đa 256 GB Capacity Memory LPDDR5 ngoài chip. So sánh băng thông với HBM: một stack HBM3e hàng đầu cho khoảng 1,2 TB/s mỗi stack, và cả gói GPU cộng lại cũng chỉ ở mức khoảng 8 TB/s. Con số 150 TB/s của Corsair là băng thông SRAM trên chip, không phải băng thông của gói — một đại lượng khác, và phép so sánh này có lợi cho d-Matrix. Nhưng hướng đi là có thật: với giải mã theo lô nhỏ, nhạy với độ trễ, việc giữ trọng số trong SRAM loại bỏ chuyến đi khứ hồi vốn chi phối độ trễ token của GPU.
Thứ mà tiền của Series C thực sự mua là nền tảng xung quanh con chip. NIC JetStream kết nối các card và rack với độ trễ thấp. Ngăn xếp phần mềm Aviator biên dịch các mô hình viết bằng PyTorch và Triton lên cấu trúc DIMC. SquadRack, kiến trúc rack tham chiếu được xây cùng Arista, Broadcom và Supermicro, đóng gói các card thành hệ thống có thể triển khai, và các cụm Squadron, được công bố phổ biến rộng rãi vào tháng 10 năm 2026, mở rộng tới 1.024 XPU Corsair trên 16 rack trong các trung tâm dữ liệu làm mát bằng không khí tiêu chuẩn. Corsair bước vào sản xuất hàng loạt vào tháng 6 năm 2026, với các lô hàng số lượng lớn hướng tới hyperscaler, neocloud và phòng lab AI tiên phong. Vào tháng 4 năm 2026, công ty cũng mua lại mảng trung tâm dữ liệu của GigaIO, bổ sung kết cấu bộ nhớ FabreX và các thiết kế hệ thống SuperNODE.
Trần của SRAM, và lý do Raptor tồn tại
Điểm mạnh của kiến trúc này cũng chính là trần của nó. SRAM nhanh nhưng đắt khủng khiếp tính theo bit. 2 GB Performance Memory của Corsair không thể chứa một mô hình 70B; phần còn lại nằm trong LPDDR5 Capacity Memory, và hiệu năng thực tế phụ thuộc vào việc Aviator chia việc khéo léo đến đâu giữa hai tầng. SRAM cũng không thu nhỏ như logic: ở các node tiên tiến, mật độ của nó cải thiện chậm, vì vậy một lộ trình thuần SRAM khiến chi phí cho mỗi đơn vị năng lực tạo token tăng qua từng thế hệ, chứ không giảm. Đây là câu hỏi kinh tế học tiến trình mà mọi startup điện toán trong bộ nhớ đều phải trả lời.
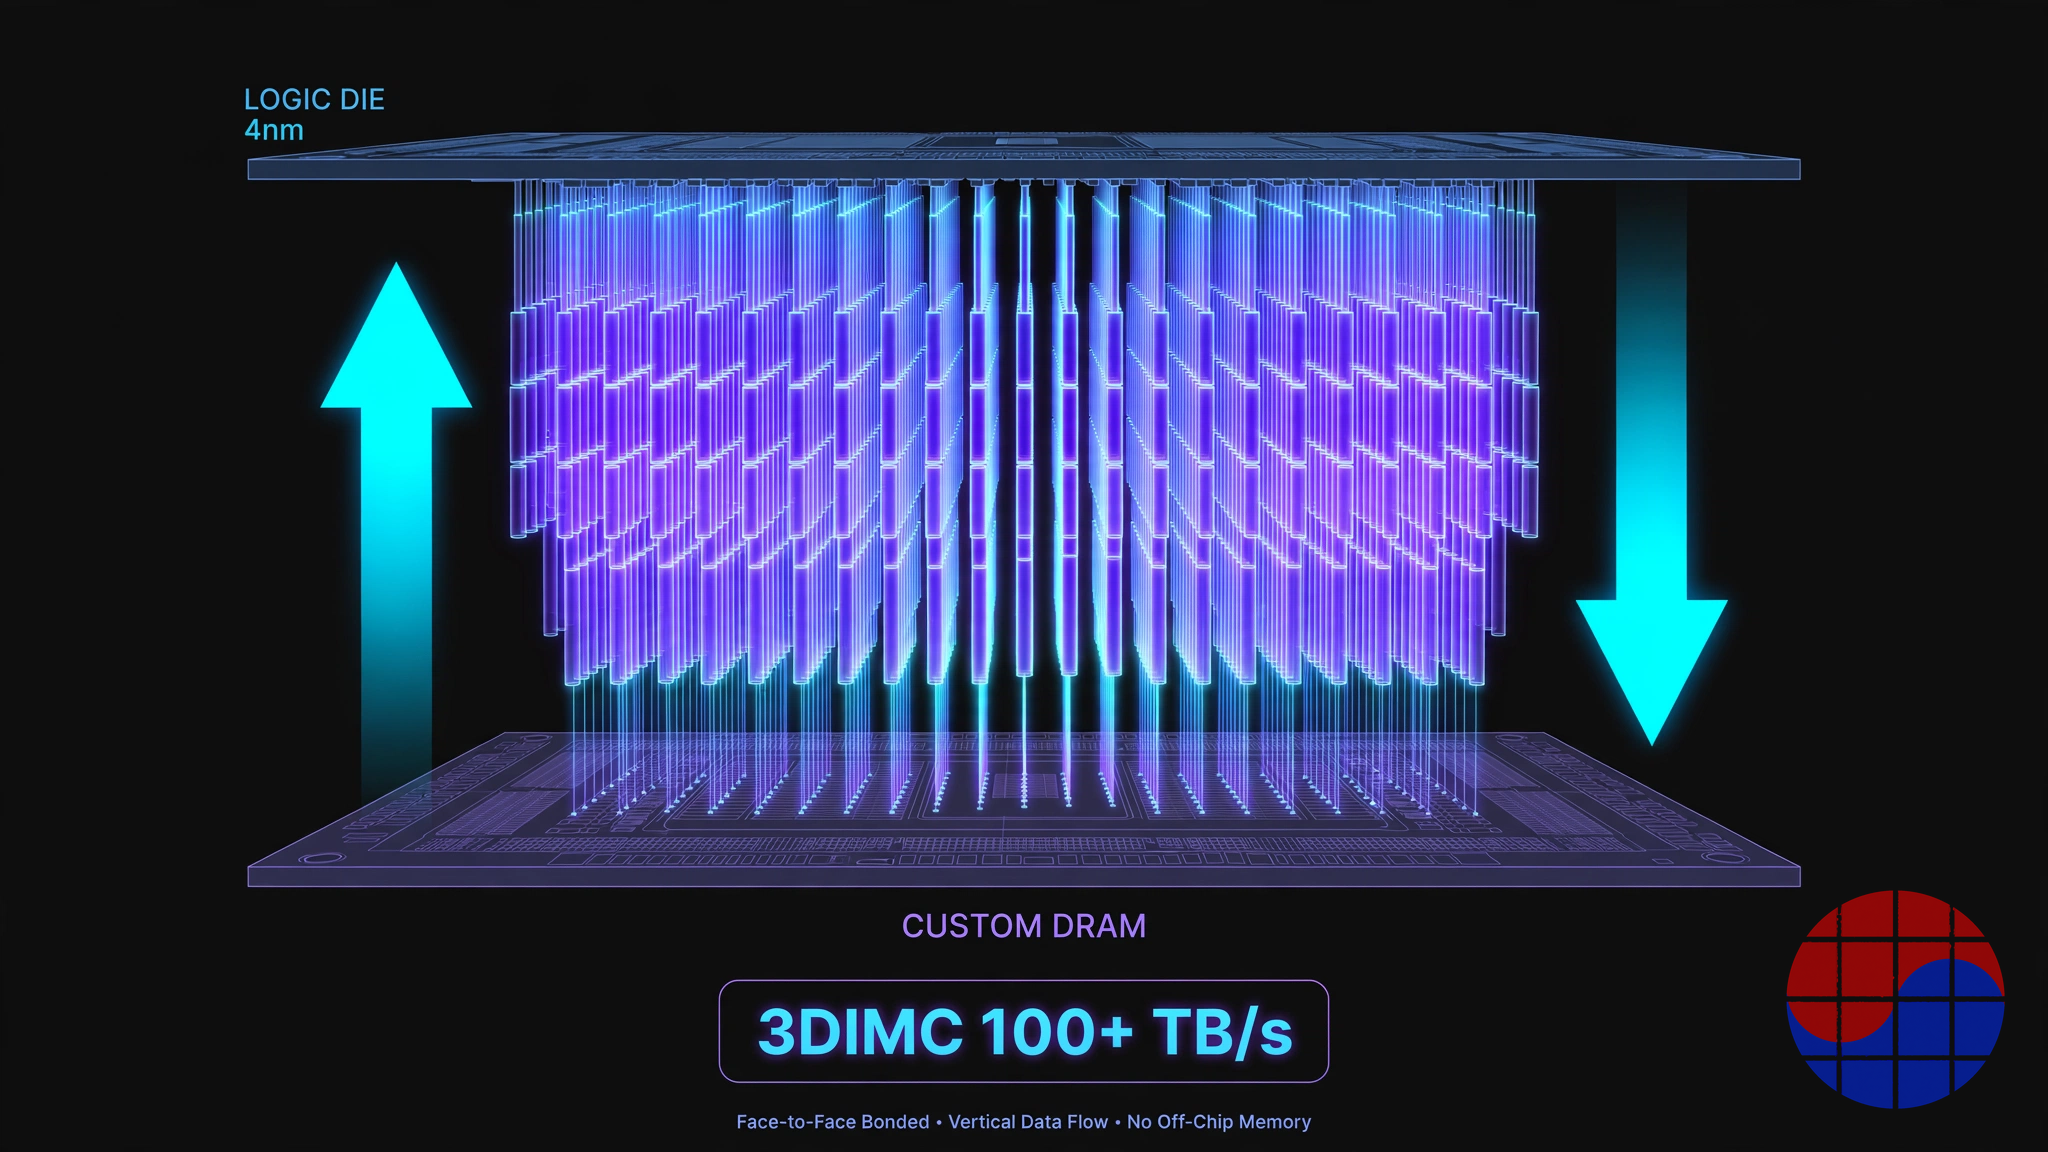
Câu trả lời của d-Matrix là 3DIMC, thể hiện trong nền tảng thế hệ tiếp theo Raptor. Được giới thiệu qua phương tiện thử nghiệm Pavehawk cùng Alchip vào tháng 11 năm 2025, Raptor gắn một die logic 4 nm của TSMC mặt-đối-mặt lên một die DRAM tùy chỉnh với bước 36 micron. Công ty dự phóng băng thông hơn 100 TB/s và 32 GB — 256 Gb — bộ nhớ xếp chồng mỗi bộ tăng tốc ở mức 0,37 pJ/bit, và các kết quả silicon ban đầu trình bày năm 2026 báo cáo thông lượng suy luận mỗi bộ tăng tốc cao hơn khoảng 4,7 lần so với cấu hình dựa trên HBM. Raptor đặt mục tiêu tape-out vào cuối năm 2026, với khả năng cung cấp rack vào quý 4 năm 2027. Vào tháng 9 năm 2026, d-Matrix gia nhập hệ sinh thái NVLink Fusion của NVIDIA, vì vậy các XPU Raptor được thiết kế để cắm vào rack MGX của NVIDIA bên cạnh GPU, thay vì đòi hỏi thay thế toàn bộ.
Điều gì phải đúng để con số 2 tỷ USD đứng vững
Lột câu chuyện xuống còn phép tính. Mức định giá 2 tỷ USD trên tổng vốn huy động 450 triệu USD, trước khi có doanh thu theo khối lượng, định giá d-Matrix như một doanh nghiệp nền tảng tương lai, chứ không phải nhà bán linh kiện. Ba điều phải đúng. Thứ nhất, chi tiêu cho suy luận phải tiếp tục tăng trưởng kép, đến mức một lớp giải mã chuyên dụng trở thành khoản ngân sách mà hyperscaler cấp vốn tách riêng khỏi GPU. Thứ hai, tính kinh tế mà Corsair công bố — tương tác nhanh hơn 10 lần, hiệu năng trên tổng chi phí sở hữu tốt hơn 3 lần, hiệu quả năng lượng tốt hơn 3–5 lần, tất cả là số liệu do công ty báo cáo — phải trụ vững khi tiếp xúc với khối lượng công việc sản xuất của khách hàng có tên tuổi, chứ không chỉ các benchmark Llama. Thứ ba, hào lũy phần mềm phải hình thành: Aviator phải đủ dính để khách hàng không coi phần cứng là hàng hóa có thể thay thế khi NVIDIA, AMD hay đội ASIC của chính hyperscaler tung ra một đáp án đủ tốt.
Bằng chứng về sức kéo đến nay là có thật nhưng chưa đầy đủ. Trạng thái sản xuất hàng loạt, dòng rack do Supermicro chế tạo, một thương vụ mua lại bổ sung kết cấu cấp hệ thống, và danh sách nhà đầu tư nặng ký các quỹ tài sản quốc gia (Temasek, QIA, EDBI) đều cho thấy những người mua tinh tường đang thẩm định và ở lại. Thứ còn thiếu là loại bằng chứng cuối cùng quyết định giá của các startup chip: các đợt triển khai sản xuất được công bố với hyperscaler có tên và đơn hàng lặp lại. Nỗ lực được đưa tin vào tháng 7 năm 2026 nhằm huy động thêm vốn ở mức định giá cao hơn, cùng sự quan tâm đầu tư được đưa tin của NVIDIA, vẫn chưa được xác nhận và nên được coi là thông tin dạng reported, chưa phải sự thật đã xác lập.
Mặt trái: HBM phản công, và phần mềm là một thứ thuế
Lập luận bi quan có hai nhánh. Nhánh thứ nhất là vật lý và lộ trình. HBM không đứng yên: HBM4 mở rộng giao diện lên 2.048 bit mỗi stack, và các nhà cung cấp GPU đang tích hợp SRAM lớn hơn, kết nối nhanh hơn và các SKU tối ưu cho suy luận. Mỗi thế hệ thu hẹp khoảng cách độ trễ vốn biện minh cho một bộ tăng tốc riêng, trong khi bên đương nhiệm GPU cung cấp một ngăn xếp phần mềm duy nhất cho cả huấn luyện và suy luận. Nhánh thứ hai là thuế áp dụng. Mọi nền tảng không phải CUDA đều yêu cầu khách hàng chuyển đổi mô hình, tin tưởng một trình biên dịch còn trẻ, và chấp nhận rủi ro nhà cung cấp trên bảng cân đối của một startup. d-Matrix giảm nhẹ điều này bằng định vị dị thể — Corsair đóng vai trò giảm tải giải mã bên cạnh GPU, được chính thức hóa bằng bước đi NVLink Fusion và màn trình diễn Attention-FFN Disaggregation (AFD), vốn chia attention cho GPU và các lớp feed-forward cho XPU Corsair, đạt 845 token mỗi giây mỗi người dùng với 64 người dùng đồng thời. Giảm nhẹ không phải xóa bỏ: thứ thuế đó phải trả trong mọi chu kỳ bán hàng.
Chase's Take
Hầu hết các startup chip AI bán một động cơ nhanh hơn. d-Matrix bán một đẳng thức kế toán khác: trong suy luận giải mã, số token mỗi giây xấp xỉ bằng băng thông chia cho kích thước mô hình, vì vậy công ty sở hữu băng thông sẽ sở hữu biên lợi nhuận. Việc chọn điện toán trong bộ nhớ dạng số thay vì tương tự là quyết định đúng một cách lặng lẽ — IMC tương tự trình diễn đẹp nhưng hiệu chuẩn tệ, còn DIMC giữ được tính xác định của SRAM và sống sót qua các lần chuyển tiến trình. Câu hỏi trung thực không phải là vật lý có hoạt động hay không; Pavehawk và các kết quả silicon năm 2026 nói rằng nó hoạt động. Câu hỏi là liệu kinh tế học SRAM cộng với một ngăn xếp phần mềm còn trẻ có thể giữ một lớp có thể phòng thủ trước một bên đương nhiệm có thể đóng gói đáp án của mình vào chính rack GPU mà khách hàng đã mua hay không. Quyết định NVLink Fusion cho tôi thấy ban lãnh đạo hiểu điều này: d-Matrix không cố đánh bại rack của NVIDIA, hãng cố trở thành một dòng mục bên trong rack đó. Ở mức 2 tỷ USD, nhà đầu tư không trả tiền cho kết quả ấy — họ trả tiền cho con đường có trọng số xác suất dẫn tới nó, với tiền mặt của Series C tài trợ đúng hai bằng chứng còn thiếu: quy mô sản xuất có tên tuổi và Raptor đúng lịch trình.
Implications
Với hyperscaler và neocloud: Các bộ tăng tốc đẳng cấp Corsair biến suy luận thành bài toán thiết kế dị thể. Câu hỏi mua sắm chuyển từ "GPU nào" sang "lớp nào chạy ở đâu", và việc tách rã kiểu AFD trở thành một kỷ luật hoạch định dung lượng, không còn là thử nghiệm.
Với ngành bộ nhớ: d-Matrix là một tín hiệu nhu cầu kèm cảnh báo. Sản phẩm hiện tại của hãng đi vòng qua HBM bằng SRAM và LPDDR5, và DRAM xếp chồng tùy chỉnh của Raptor cho thấy cuộc đấu dài hạn không phải là HBM đối đầu hư không — mà là HBM tiêu chuẩn đối đầu bộ nhớ được thiết kế xoay quanh một die tính toán cụ thể. Các nhà sản xuất bộ nhớ đồng thiết kế stack cùng startup bộ tăng tốc sẽ giành được một kênh mà thế độc quyền đôi GPU không kiểm soát.
Với nhà đầu tư: Cái giá 2 tỷ USD sẽ được định giá lại bởi hai sự kiện có thể quan sát: đợt triển khai hyperscale đầu tiên của Corsair có tên tuổi và lặp lại, và tape-out của Raptor vào cuối năm 2026. Cho đến lúc đó, mức định giá dựa vào các tuyên bố benchmark và chất lượng của nhà đầu tư — những tín hiệu mạnh, nhưng là tín hiệu, không phải dòng tiền.
FAQ
d-Matrix làm gì?
d-Matrix xây dựng các bộ tăng tốc trung tâm dữ liệu chuyên cho suy luận AI. Nền tảng Corsair của hãng sử dụng Digital In-Memory Computing (DIMC) — tính toán bên trong SRAM — cùng với mạng JetStream và ngăn xếp phần mềm Aviator, nhắm tới việc tạo token độ trễ thấp, hiệu quả năng lượng cao, thay vì huấn luyện mô hình.
Vì sao d-Matrix được định giá 2 tỷ USD?
Mức định giá 2 tỷ USD được ấn định bởi vòng Series C trị giá 275 triệu USD chốt vào ngày 12 tháng 11 năm 2025, do BullhoundCapital, Triatomic Capital và Temasek đồng dẫn dắt, với sự tham gia của QIA, EDBI và M12 của Microsoft. Nhà đầu tư định giá kỳ vọng rằng suy luận sẽ trở thành chi phí chiếm ưu thế của hạ tầng AI và một kiến trúc lấy bộ nhớ làm trung tâm sẽ chiếm được một phần bền vững của chi phí đó.
Corsair khác GPU ở điểm nào?
GPU đọc trọng số mô hình từ HBM cho mỗi token, với băng thông gói ở mức khoảng 8 TB/s. Corsair giữ các trọng số nóng trong SRAM trên chip và tính toán bên trong mảng bộ nhớ, đạt băng thông trên chip 150 TB/s mỗi card, nhắm tới các khối lượng công việc giải mã lô nhỏ, độ trễ thấp — nơi GPU kém hiệu quả nhất. Mỗi card mang 2 GB SRAM Performance Memory và tối đa 256 GB LPDDR5 Capacity Memory.
3DIMC và Raptor là gì?
3DIMC là bước tiến xếp chồng 3D của kiến trúc trong bộ nhớ của d-Matrix. Nền tảng Raptor gắn một die logic 4 nm mặt-đối-mặt lên một die DRAM tùy chỉnh, dự phóng băng thông hơn 100 TB/s và bộ nhớ 32 GB (256 Gb) mỗi bộ tăng tốc. Raptor đặt mục tiêu tape-out vào cuối năm 2026, với khả năng cung cấp rack dự kiến vào quý 4 năm 2027, bao gồm tích hợp vào rack NVLink Fusion của NVIDIA.
Lưu ý: Các con số hiệu năng và hiệu quả (tương tác 10 lần, hiệu năng trên TCO 3 lần, hiệu quả năng lượng 3–5 lần, 150 TB/s) là số liệu do công ty báo cáo tại các thời điểm được trích dẫn trong bài. Mức định giá 2 tỷ USD là con số post-money được báo cáo trong thông báo Series C tháng 11 năm 2025.
📩 Đăng ký bản tin VLSI Korea
Nhận phân tích bán dẫn chuyên sâu mỗi ngày qua email trước tiên. Đăng ký miễn phí.


