 VLSI Korea
HBM4E và cuộc chiến phân tầng bộ nhớ: SK Hynix vs Samsung định hình chuẩn hậu HBM
SK Hynix và Samsung cùng ra mắt HBM4E tại SEDEX 2026. Thông số ngang ngửa — cuộc chiến thực sự là ai định nghĩa hệ phân cấp bộ nhớ hậu HBM. DRAM xếp chồng 3D và HBF đối đầu HBM5, HBM tùy chỉnh, CXL và PIM.


Tóm tắt 30 giây
SK Hynix và Samsung đã cùng ra mắt HBM4E tại SEDEX 2026, Seoul, vào ngày 14 tháng 10 năm 2026. Cả hai thế hệ bộ nhớ mới đều hoạt động ở tốc độ 14–16 Gb/s mỗi chân: thực chất là cùng một đẳng cấp. Cuộc chiến thực sự không nằm ở bảng thông số HBM4E, mà ở việc ai sẽ định nghĩa hệ phân cấp bộ nhớ sau HBM. SK Hynix đặt cược vào "chiều cao" — các tầng mới như DRAM xếp chồng 3D và HBF (High Bandwidth Flash) — trong khi Samsung đặt cược vào "tốc độ cộng ngăn xếp đầy đủ": HBM5, HBM tùy chỉnh, CXL, PIM và SSD doanh nghiệp dung lượng lớn. Với hạ tầng AI được dự báo mở rộng khoảng 20 lần vào năm 2030 so với 2026 (SK Hynix, 14/10/2026), bên nào viết nên chuẩn hậu HBM sẽ nắm giữ kinh tế học bộ nhớ AI trong thập kỷ tới.
Bối cảnh: HBM4E đánh dấu sự kết thúc của cuộc chiến thông số
Ngày 14 tháng 10 năm 2026, ngày khai mạc SEDEX 2026 tại COEX Seoul, gian hàng của SK Hynix và Samsung cùng trưng một từ: HBM4E. HBM4E của SK Hynix chạy ở 16 Gb/s mỗi chân, tiêu thụ điện năng thấp hơn 20%+ so với HBM4, và các mẫu 12-high đã được xuất xưởng từ tháng 6 năm 2026. HBM4E của Samsung hoạt động ở 14–16 Gb/s mỗi chân, đạt băng thông tối đa 3,6 TB/s, kết hợp DRAM thế hệ 1c với base die 4nm.
| Hạng mục | SK Hynix HBM4E | Samsung HBM4E |
|---|---|---|
| Tốc độ mỗi chân | 16 Gb/s | 14–16 Gb/s |
| Băng thông đỉnh | ~2,0 TB/s (cơ sở 12-high)* | Tối đa 3,6 TB/s |
| Điện năng | Thấp hơn 20%+ so với HBM4 | Không công bố (nhấn mạnh thiết kế tiết kiệm điện) |
| Thế hệ DRAM | Không công bố | Thế hệ 1c |
| Base die | Không công bố | Logic 4nm |
| Mẫu 12-high | Xuất xưởng tháng 6/2026 | Công bố tại SEDEX 2026 |
| Ra mắt | SEDEX 2026 (14/10) | SEDEX 2026 (14/10) |
*SK Hynix không công bố băng thông đỉnh. 16 Gb/s mỗi chân × giao diện 1024-bit tương đương 2,0 TB/s.
HBM4E không còn là vũ khí khác biệt hóa công nghệ. Tốc độ mỗi chân, điện năng và chiều cao xếp chồng giờ đây hội tụ giữa hai hãng trong khoảng sáu tháng — cuộc chiến đã chuyển từ "ai thắng bảng thông số" sang "ai viết chuẩn tiếp theo". HBM4E cũng hầu như không nới lỏng nguồn cung trước 2027: nhiều die DRAM hơn mỗi ngăn xếp, base die ở nút logic tiên tiến nhất, và chu kỳ thẩm định mới theo từng khách hàng. Đó là nền tảng của dự báo giá hợp đồng HBM4 năm 2027 tăng 121% so với cùng kỳ (Korea Economic Daily, 2026, dẫn nguồn báo chí ngành).
Chủ tịch SK Hynix Ahn Hyun phát biểu trong keynote SEDEX cùng ngày: "HBM alone is not enough." Hạ tầng AI phải mở rộng khoảng 20 lần vào năm 2030 so với 2026, AI agentic làm bùng nổ mức sử dụng token, di chuyển dữ liệu KV-cache là nút thắt mới, và động cơ tăng trưởng là suy luận (inference) chứ không phải huấn luyện. Nói gọn: nút thắt đã chuyển từ băng thông HBM sang kiến trúc toàn bộ hệ phân cấp bộ nhớ.
Phân tích chuyên sâu kinh doanh: Giải phẫu một cuộc chiến chuẩn
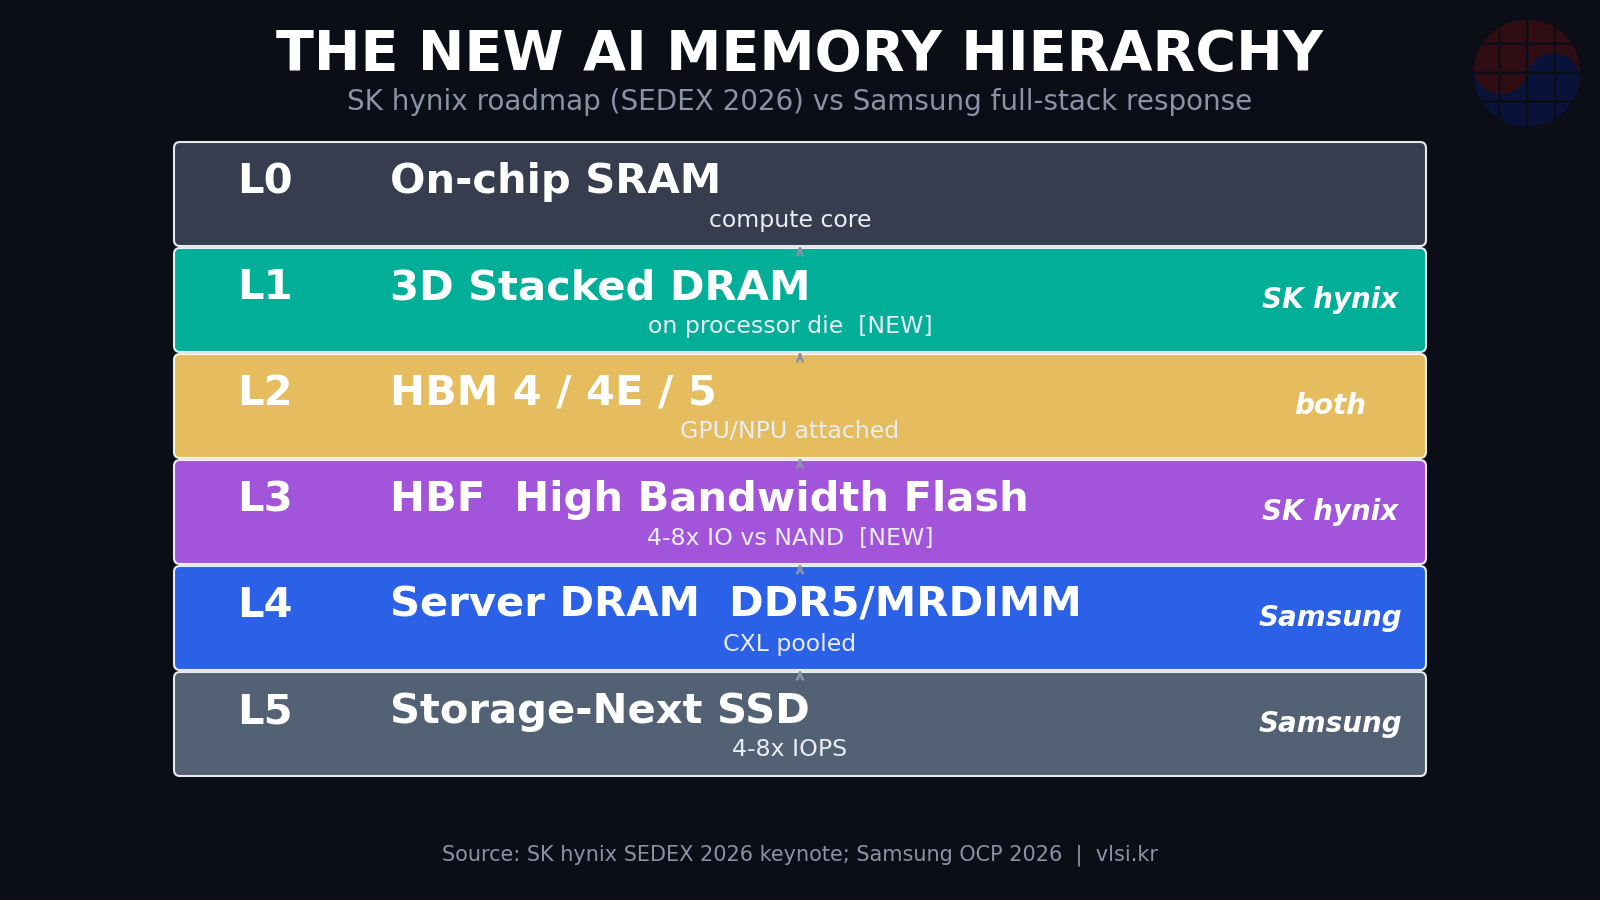
Hệ phân cấp bộ nhớ mới — Bản đồ của SK Hynix
Cốt lõi lộ trình của Ahn là bổ sung các tầng — thay cho bức tranh cũ đơn giản (SRAM trên chip → HBM → DRAM máy chủ → SSD):
| Tầng | Công nghệ | Vai trò | Ý nghĩa kinh doanh |
|---|---|---|---|
| L0 | SRAM trên chip | Cache gắn liền lõi tính toán | Lãnh địa của các hãng logic (không đổi) |
| L1 (mới) | DRAM xếp chồng 3D | Die DRAM xếp trực tiếp trên die xử lý | Mở rộng bí quyết xếp chồng TSV; xóa nhòa ranh giới logic–bộ nhớ |
| L2 | HBM (HBM4 / HBM4E / HBM5) | Bộ nhớ băng thông cao gắn GPU/NPU | Trung tâm cuộc chiến chuẩn; tùy chỉnh làm thay đổi cấu trúc biên lợi nhuận |
| L3 (mới) | HBF (High Bandwidth Flash) | IO gấp 4–8 lần NAND hiện tại | Đòn phản công của phe NAND vào trật tự bộ nhớ AI do DRAM dẫn dắt |
| L4 | DRAM máy chủ (DDR5 / MRDIMM) | Bộ nhớ chính dung lượng lớn | Pooling CXL thay đổi kinh tế học sử dụng |
| L5 | SSD doanh nghiệp Storage-Next | IOPS gấp 4–8 lần hiện tại | Ranh giới lưu trữ–bộ nhớ ngày càng mờ |
Nhà đầu tư nên chú ý L1 và L3. DRAM xếp chồng 3D đưa công nghệ TSV của HBM vào trong gói xử lý, tái sử dụng bí quyết xếp chồng và quản lý nhiệt mà SK Hynix đã tích lũy. HBF táo bạo hơn: nâng NAND từ "lưu trữ" thành thành viên đầy đủ của hệ phân cấp bộ nhớ — lối vào duy nhất của phe NAND tới trật tự bộ nhớ AI do DRAM thống trị, tức là tuyên bố đòn phản công đã bắt đầu.
Đáp trả của Samsung: Tốc độ cộng ngăn xếp đầy đủ
Samsung vẽ bức tranh khác tại OCP Global Summit 2026 ở San Jose (12–15/10), trình diễn cùng AMD khả năng mở rộng bộ nhớ CXL, với chiến lược ba trụ cột:
- Tốc độ (Speed): HBM5 và HBM tùy chỉnh nhúng logic riêng của khách hàng vào base die — kết hợp sức mạnh foundry (base die 4nm) với IDM bộ nhớ của Samsung.
- Mở rộng dung lượng (Capacity): pooling bộ nhớ CXL — chia sẻ DRAM máy chủ giữa các bộ tăng tốc để nâng mức sử dụng.
- Lưu trữ (Storage): SSD doanh nghiệp dung lượng lớn — đề xuất trọn gói từ bộ nhớ đến lưu trữ của một nhà cung cấp.
Bên trên là công nghệ PIM (processing-in-memory), đưa tính toán vào trong bộ nhớ để cắt giảm chính việc di chuyển dữ liệu.
| Trục | SK Hynix | Samsung |
|---|---|---|
| Cược cốt lõi | Chiều cao: tầng mới (DRAM 3D, HBF) | Tốc độ + ngăn xếp đầy đủ: HBM5, HBM tùy chỉnh, CXL, PIM, SSD |
| Nguồn khác biệt | Mở rộng bí quyết xếp chồng HBM; liên kết với công ty con NAND (Solidigm) | Foundry + IDM bộ nhớ; thiết kế logic base die |
| Tùy chỉnh | HBM tùy chỉnh (logic khách hàng trong base die) | HBM tùy chỉnh + đề xuất trọn gói gắn với foundry |
| Chiến lược NAND | HBF đưa NAND vào hệ phân cấp bộ nhớ | SSD lớn củng cố vị thế dẫn đầu lưu trữ |
| Điểm yếu | Thiết kế logic (base die) thua Samsung | Thị phần HBM thua SK Hynix |
Sự dịch chuyển cấu trúc biên lợi nhuận: HBM tùy chỉnh thay đổi điều gì
"HBM tùy chỉnh" — được cả hai hãng công bố — là biến số bị đánh giá thấp nhất. HBM thông thường gần như hàng hóa: thông số và giá cố định, cùng một sản phẩm bán cho nhiều khách hàng. HBM tùy chỉnh nhúng logic riêng của khách hàng (bộ điều khiển, bảo mật, tối ưu giao diện) vào base die — bước chuyển từ hàng hóa sang silicon riêng cho từng khách hàng.
Ba hàm ý đối với cấu trúc biên lợi nhuận:
Thứ nhất, quyền định giá mạnh hơn hàng chuẩn: thiết kế riêng theo khách hàng tạo chi phí chuyển đổi và làm sâu sắc vendor lock-in. Thứ hai, năng lực thiết kế logic base die trở thành năng lực cốt lõi — chiến trường có lợi cho Samsung với tài sản foundry và thiết kế logic; SK Hynix phải tìm năng lực này từ bên ngoài. Thứ ba, sự phân đôi chuẩn/tùy chỉnh làm phức tạp chuỗi cung ứng: base die khác nhau theo khách hàng ngay trong cùng thế hệ HBM4E khiến kế hoạch sản xuất và tồn kho khó khăn hơn, đẩy áp lực tăng giá lên — một động lực cấu trúc đằng sau dự báo giá hợp đồng HBM4 năm 2027 tăng 121% so với cùng kỳ.
Pooling CXL: Kinh tế học của mức sử dụng
Pooling bộ nhớ qua CXL mở ra kinh tế học mới về mức sử dụng: trong máy chủ AI, bộ nhớ cấp phát theo từng bộ tăng tốc nhưng mức sử dụng thực tế dao động mạnh — một GPU cạn bộ nhớ trong khi GPU bên cạnh nhàn rỗi. Pool dùng chung hấp thụ độ lệch này, cắt giảm tổng lượng mua bộ nhớ đồng thời nới lỏng nút thắt.
Với hyperscaler, đây là lá bài giảm TCO; với nhà sản xuất bộ nhớ, đây là con dao hai lưỡi: ngắn hạn hàm lượng bộ nhớ mỗi máy chủ có thể giảm, nhưng dài hạn mở ra thị trường mới — chính pool bộ nhớ — cùng nhu cầu linh kiện mới ở bộ điều khiển và switch CXL. Đó là lý do Samsung trình diễn cùng AMD tại OCP: không ai tự thiết lập chuẩn; chuẩn được trình diễn cùng bên nắm chìa khóa hệ sinh thái.
Bối cảnh thị trường: Bộ nhớ giờ đã vượt quá một nửa chất bán dẫn
Ước tính nghiên cứu ngành: bộ nhớ chiếm khoảng 54% tổng doanh thu chất bán dẫn năm 2026 — gần gấp đôi mức 27% của 2025 — nhờ hàm lượng đô-la HBM trong mỗi bộ tăng tốc AI phình to. Đó là lý do các nhà sản xuất bộ nhớ chạy đua trở thành người định nghĩa hệ phân cấp bộ nhớ AI: bên nào định nghĩa chuẩn sẽ đặt luật chơi về giá, thông số và thẩm định — và bên đặt luật chơi quyết định biên lợi nhuận.
Góc nhìn của Chase: Chiều cao vs ngăn xếp đầy đủ — Ai viết chuẩn
Cuộc chiến này không phải về công nghệ mà về quyền thiết lập chuẩn. Lịch sử cho thấy: JEDEC đặt chuẩn DRAM trên danh nghĩa, nhưng nhà sản xuất nào sản xuất hàng loạt và vượt thẩm định trước sẽ là tác giả thực chất. HBM cũng vậy — SK Hynix giao HBM3/HBM3E cho NVIDIA trước và thực chất đã viết chuẩn trong khi Samsung đuổi theo.
Lần này hình thế khác: SK Hynix vẽ trước lên trang giấy trắng "sau HBM". DRAM xếp chồng 3D và HBF là các tầng mới không có chỗ trong chuẩn JEDEC hiện hành — định nghĩa trước, lấy mẫu trước, liên minh với khách hàng trước, và đó trở thành chuẩn. Samsung ngược lại chiến đấu trên mặt trận đã kiểm chứng: tốc độ HBM5, HBM tùy chỉnh, hệ sinh thái CXL, PIM, SSD. Không hạng mục đơn lẻ nào chặn được đòn tấn công của SK Hynix, nhưng đóng gói thành ngăn xếp đầy đủ, chúng tạo thành đề xuất trọn gói cho hyperscaler: "hãy giao nỗi lo bộ nhớ cho chúng tôi."
Cả hai đều là nhà vô địch quốc gia Hàn Quốc: kỷ nguyên chicken game DRAM, mỗi lần một bên mở rộng công suất là giá sụp đổ cho cả hai; giờ đây hai bên soạn những bản thiết kế đối lập cho trật tự bộ nhớ AI thế giới — kỷ nguyên bộ đôi độc quyền bộ nhớ Hàn Quốc vẽ tài liệu thiết kế cho hạ tầng AI toàn cầu đã đến. Rủi ro là có thật: càng nhiều tầng, độ phức tạp hệ thống và gánh nặng thẩm định càng lớn; HBF có vượt qua giới hạn NAND (độ bền, độ trễ) trong workload thực hay không, ai giải bài toán nhiệt của DRAM xếp chồng 3D, vẫn chưa được chứng minh; PIM của Samsung nhiều năm nay vẫn "demo ấn tượng, chưa có sản lượng". Kẻ thắng hiếm khi là slide đẹp nhất — mà là bức tranh thực tế nhất được xuất xưởng trước.
Luận điểm phản biện: các bước tiến dần như HBM4E/HBM5 có thể đáp ứng nhu cầu suy luận, và nếu áp lực KV-cache nghiêm trọng, kiến trúc mô hình (tối ưu attention, lượng tử hóa) sẽ thích ứng trước. Có lý — nhưng với nhà sản xuất bộ nhớ, đó là chiến lược chờ đợi, và trong lúc chờ, quyền thiết lập chuẩn rơi vào tay kẻ khác. Đó là lý do cả hai cùng hành động.
Hàm ý đầu tư và quản trị
Với nhà đầu tư: - Khi bộ nhớ vượt quá một nửa doanh thu chất bán dẫn, nhà sản xuất nào định nghĩa các tầng hậu HBM sẽ hưởng mức premium cấu trúc. Hãy theo dõi năng lực thực thi lộ trình (thời điểm sản lượng DRAM 3D, HBF, CXL), chứ không phải giao dịch đầu cơ ngắn hạn quanh HBM4E. - HBM tùy chỉnh lan tỏa nâng biên lợi nhuận nhà sản xuất bộ nhớ, nhưng bên thiếu năng lực thiết kế logic base die có thêm hạng mục chi phí thiết kế thuê ngoài; bên hưởng lợi trong chuỗi giá trị lan sang thiết kế logic, bộ điều khiển CXL và đóng gói tiên tiến. - Giá hợp đồng HBM4 năm 2027 tăng 121% so với cùng kỳ vừa là lực đẩy kết quả kinh doanh nhà sản xuất bộ nhớ, vừa là cò súng thúc đẩy hyperscaler tiến tới pooling CXL để giảm áp lực TCO — cần giám sát điểm tăng giá bắt đầu phá hủy nhu cầu.
Với nhà quản trị: - Doanh nghiệp xây dựng/vận hành hạ tầng AI nên nâng chiến lược mua sắm từ "mua HBM" lên "thiết kế hệ phân cấp bộ nhớ": thời điểm pooling CXL, độ trưởng thành HBF và thời gian thẩm định HBM tùy chỉnh giờ là biến số của lộ trình mua sắm. - Với các hãng fabless và công ty hệ thống, năng lực tùy chỉnh base die là lá bài đàm phán mới. Mua HBM chuẩn so với đồng thiết kế HBM tùy chỉnh hàm ý quan hệ quyền lực khác nhau trong chuỗi cung ứng. - Với nhà sản xuất NAND, HBF là cơ hội phá vỡ chiếc hộp "thiết bị lưu trữ": gia nhập trật tự lấy DRAM làm trung tâm, hay đi con đường độc lập qua SSD tiên tiến. Ngã rẽ đã ở đây.
FAQ
Q1. HBM4E khác HBM4 ở điểm nào? HBM4E là thế hệ mở rộng (Extended) của HBM4, với tốc độ mỗi chân khoảng 16 Gb/s và hiệu suất năng lượng tốt hơn. SK Hynix công bố điện năng thấp hơn 20%+ so với HBM4; Samsung quảng bá băng thông tối đa 3,6 TB/s với base die 4nm. Chênh lệch thông số nhỏ, nên các lộ trình sau HBM4E — HBM5, HBM tùy chỉnh, tầng bộ nhớ mới — quan trọng hơn bản thân HBM4E.
Q2. HBF (High Bandwidth Flash) là gì? Tầng bộ nhớ mới do SK Hynix đề xuất tại SEDEX 2026, nhắm tới băng thông IO gấp 4–8 lần flash NAND hiện tại. Nằm giữa HBM và DRAM máy chủ, hướng tới các workload suy luận lớn như xử lý KV-cache. Nó nâng NAND từ "lưu trữ" lên hệ phân cấp bộ nhớ — thách thức của phe NAND đối với trật tự bộ nhớ AI do DRAM dẫn dắt.
Q3. Vì sao pooling bộ nhớ CXL quan trọng? Với CXL (Compute Express Link), nhiều bộ tăng tốc chia sẻ một pool bộ nhớ, hấp thụ độ lệch sử dụng theo từng bộ tăng tốc và giảm tổng lượng mua bộ nhớ. Đây là lá bài giảm TCO cho hyperscaler và mở ra thị trường mới — bộ điều khiển và switch CXL — cho nhà sản xuất bộ nhớ. Đó là bối cảnh của màn trình diễn chung giữa Samsung và AMD tại OCP 2026.
Q4. Điều gì quyết định bên thắng cuộc chiến chuẩn hậu HBM? Ba điều. Thứ nhất, thời điểm sản lượng — không phải demo, mà là bên nào vượt thẩm định khách hàng và xuất xưởng trước. Thứ hai, hệ sinh thái — bên nào cùng xây chuẩn với hyperscaler và hãng GPU. Thứ ba, kinh tế — các tầng mới có thực sự hạ TCO hay không. Silicon chạy được thắng roadmap đẹp.
Tuyên bố miễn trừ: Các số liệu và dự báo trong bài viết dựa trên tài liệu công khai và thông tin ngành tính đến ngày 17 tháng 10 năm 2026; thông số sản phẩm thực tế và thời gian sản lượng có thể thay đổi.


