 VLSI Korea
Startup Files #1:FuriosaAI — 拒绝 Meta 8 亿美元收购的韩国 AI 推理芯片
FuriosaAI 于 2025 年 3 月拒绝 Meta 的 8 亿美元收购要约,7 月累计融资 2.46 亿美元晋升独角兽,2026 年 1 月量产 TSMC 5nm 的 RNGD(FP8 512 TFLOPS、HBM3 48GB、TDP 180W),并拿下 LG、Samsung SDS 和 Equinix 客户。


先说结论。 FuriosaAI 是少数能用硅片证明自己有理由拒绝 8 亿美元收购要约的韩国 AI 芯片初创公司。 这家 2017 年在首尔成立的 fabless 公司,于 2025 年 7 月累计融资达到 2.46 亿美元,企业价值突破 1 万亿韩元,晋升独角兽,并自 2026 年 1 月起开始量产采用 TSMC 5nm 的第二代推理芯片 RNGD。 在 2025 年 3 月拒绝 Meta 的收购要约后,公司陆续拿下 LG AI Research、Samsung SDS 和 Equinix 等客户,正朝着 2027~2028 年 IPO 迈进。
Company in a Nutshell
FuriosaAI 是 2017 年成立、总部位于首尔的 fabless 半导体初创公司。 公司只设计 AI 推理(inference)专用 NPU,生产委托 TSMC 代工。 海外据点包括美国 Santa Clara 办公室,并于 2026 年 9 月设立新加坡子公司。
- 创始人兼 CEO June Paik — 曾在 AMD 设计 GPU,2013 年回到韩国后,在 Samsung Electronics 带领内存新产品开发的小型团队。 联合创始人兼 CTO Hanjoon Kim 同样出身 Samsung Electronics。
- CRO Jeehoon Kang — 由 KAIST 教授(主攻并行系统)担任研究负责人;VP of Hardware Youngjin Cho 则是前 Samsung Electronics Corporate VP 出身的 SoC 专家。
- 公司名称取自电影 Mad Max: Fury Road 中的角色 Furiosa。
- CEO June Paik 的持股比例为 17.6%(依据 2025 年年中公开申报文件)。
Core Technology
FuriosaAI 的核心是 TCP(Tensor Contraction Processor) 架构。 它不以矩阵乘法(matmul)为基本运算,而是把 tensor contraction 本身作为原生运算单元来处理。 这个想法也得到了学术验证,已公开两篇论文:“TCP: A Tensor Contraction Processor for AI Workloads”(ISCA 2024)与“FuriosaAI RNGD: A Tensor Contraction Processor for Sustainable AI Computing”(Hot Chips 2024)。
为什么是 tensor contraction?LLM 推理的解码阶段,瓶颈不在计算,而在内存带宽,属于 memory-bound 区间。 数据搬运得越少、越高效,每瓦能产出的 token 就越多。 TCP 正是直面这个瓶颈的设计。
Warboy(第一代,计算机视觉用)
Warboy 是采用 Samsung Foundry 14nm FinFET 工艺的数据中心计算机视觉推理加速器(基于 SEMIFIVE 的 AI Inference SoC Platform 设计)。 2021 年推出首颗硅片,2023 年 4 月进入量产,并创下 one-shot silicon success 的纪录。
- MLPerf Inference v1.1(2021) — 在 object detection 和 image classification 上约为 Nvidia T4 的 1.5 倍。 当时是唯一以硅片提交成绩的初创公司。
- MLPerf Inference Edge v2.0(2022) — 在同一颗硅片上仅靠编译器改进就把性能提升了 2 倍。 SSD-MobileNetV1 offline throughput 为 8,762,对比 Nvidia A2 的 4,856(约 1.8 倍)。
- 已实际部署于韩国主要云数据中心,Kakao Enterprise 也曾进行测试(2023 年报道)。
RNGD("Renegade",第二代,LLM 推理用)
这是 2024 年 8 月在 Hot Chips(Stanford)公开的第二代芯片。 与台湾 GUC(Global Unichip)联合开发,采用 TSMC 5nm、1.0GHz 运行,并在 CoWoS-S interposer 上集成 2 堆栈 HBM。 依据官方开发者文档(developer.furiosa.ai),核心规格如下。
| 项目 | RNGD |
|---|---|
| 工艺 / 运行频率 | TSMC 5nm / 1.0GHz |
| BF16 / FP8 | 256 TFLOPS / 512 TFLOPS |
| INT8 / INT4 | 512 TOPS / 1024 TOPS |
| 内存 | HBM3 48GB, 1.5TB/s(on-chip SRAM 256MB) |
| 互连 | PCIe Gen5 x16 |
| TDP | 180W |
| 外形规格 | PCIe dual-slot, full-height 3/4 length, passive cooling |
| 虚拟化与安全 | Multi-instance 8, SR-IOV 8 VF, ECC, secure boot |
产品形态有 RNGD PCIe 卡和 NXT RNGD 服务器(2025 年 9 月推出)两种。 NXT 服务器是搭载 8 张卡的 4U 服务器,FP8 基准达 4 petaflops,HBM3 总计 384GB、总带宽 12TB/s,每台服务器 3kW。 一个 15kW 机柜可放入 5 台,相比之下同一机柜只能放 1 台 Nvidia DGX H100(最高 10.2kW)。
软件栈由编译器、runtime、模型压缩器、profiler 和 serving framework 组成,与 PyTorch 2.x 集成,并支持 TensorFlow Lite 和 ONNX。 也支持 Kubernetes、容器和 SR-IOV 环境。
量产已于 2026 年 1 月开始。 公司收到来自 TSMC 的首批量产 4,000 颗,开始以封装和卡片形态向客户供货(TheElec,2026 年 4 月)。
第三代则由 2026 年 5 月宣布的 与 Broadcom 的联合开发合作负责。 这是一个 chiplet 架构的 rack-scale AI inference 平台,规划采用 2nm compute die 和 HBM4/4E(依据二手信源报道)。
Funding & Investors
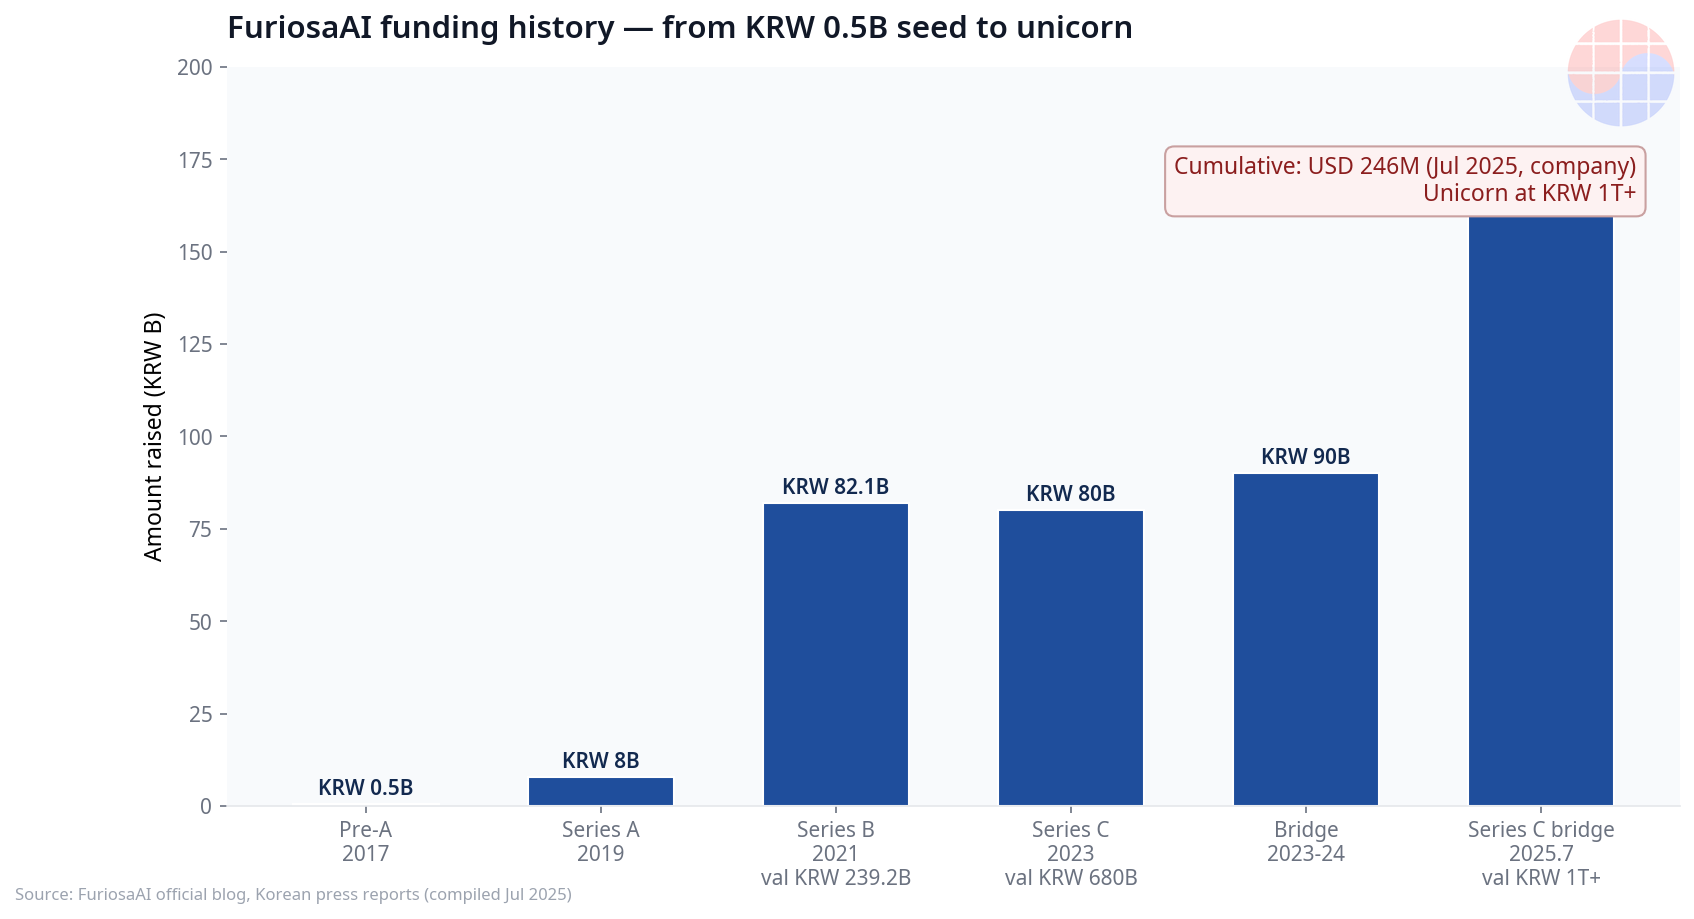
FuriosaAI 的融资历程,是历时 8 年、一步步扩大规模的教科书范例。 依据公司官方发布,截至 2025 年 7 月,累计融资为 2.46 亿美元($246M)。
| 轮次 | 时间 | 金额 | 主要投资方 | 企业价值 |
|---|---|---|---|---|
| Pre-A | 2017 | ₩0.5B | Naver D2SF | — |
| Series A | 2019 | ₩8B | Industrial Bank of Korea, DSC Investment | — |
| Series B | 2021 | ₩82.1B | DSC Investment, IMM Investment | ₩239.2B |
| Series C | 2023 | 约 ₩80B | Mubadala, Qatar Investment Authority | 约 ₩680B |
| Bridge | 2023–24 | 最高 ₩90B | Industrial Bank of Korea | — |
| Series C bridge | 2025.7 | ₩170B(约 $125M) | KDB(₩30B)、Keistone(₩20B)、PI Partners、Kakao Investment 等约 40 家投资方 | ₩1T+(独角兽) |
2025 年 7 月的 Series C bridge(₩170B,约 $125M — 是 1,700 亿韩元,不是“$170M”)让企业价值突破 1 万亿韩元,成为独角兽。 目前公司正在募集 3 亿至 5 亿美元规模的 pre-IPO/Series D(由 Morgan Stanley 和 Mirae Asset Securities 共同担任顾问,企业价值预计 ₩2T~₩3T,Bloomberg 2026 年 1 月报道)。 2026 年 5 月曾有 National Growth Fund 直接投资 ₩800B 的报道,但截至 2026 年 10 月,是否已完成交割尚未得到确认。
被拒绝的 8 亿美元
2025 年 2 月首次传出 Meta 的收购谈判消息,2025 年 3 月 24 日,FuriosaAI 最终拒绝了 8 亿美元(约 1.1 万亿韩元)的要约(Bloomberg 报道)。 谈判破裂的原因不是价格,而是对收购后业务方向和组织架构的分歧。 业界的解读是,Meta 看上的不只是进入 AI 半导体市场本身,更是为了自家 AI 服务的定制芯片开发,拿到经过验证的系统和人才。 拒绝要约 4 个月后,公司成为独角兽;6 个月后,开始量产。
Traction
FuriosaAI 在 2025~2026 年的客户名单,对一家推理芯片初创公司来说异常扎实。
- LG AI Research(2025 年 7 月) — 签下为 EXAONE LLM 供应 RNGD 的正式合同。 经过数月评估后获选,将应用于 EXAONE 3.5 模型和企业级 AI agent ChatExaone。 依据公司发布,与 GPU 方案相比,inference performance per watt 为 2.25 倍,在相同功耗的机柜下 token 产出量为 3.75 倍(company-reported)。
- Samsung SDS(2026 年 10 月) — 在 Samsung Cloud Platform 上提供 RNGD 的 NPU-as-a-Service(韩国首例)。 在东滩 IDC 部署 RNGD,以 1/2/4/8 卡为单位提供 on-demand 实例(自 2026 年 7 月起供货)。
- Equinix Lisbon(2026 年 7 月) — RNGD 在欧洲的首次商用部署。 在里斯本 LS2 数据中心建成了以 RNGD 为基础的 AI inference hub。
- 斯德哥尔摩 15MW 项目(2026 年 8 月) — 与 Velox、I/ONX HPC 共同打造 15MW 级 AI inference 数据中心。 第一阶段 2MW(2027 年初上线)将部署 1,800 颗 RNGD,全面扩充后将投入 8,800 颗以上。
- Kakao“AI for Everyone”联盟(2026 年 8 月) — 参与由 Kakao 主导、获科学技术信息通信部选定的项目联盟。
- Aramco — 正在测试和送样 RNGD(2024 年 12 月报道)。 这是进军中东市场的桥头堡。
公开的 benchmark 数据(company-reported,未经独立验证)如下:与 Nvidia H100 相比,inference performance per watt 最高达 3 倍;与 RTX Pro 6000 相比,在相同功耗下可同时服务的用户数为 7.4 倍(Renegade Summit 2026.3);数据中心 TCO 约降低 40%;以 Llama 3.1 8B 为基准,每张卡 2,000~3,000 TPS。
Moat Analysis — VLSI's View
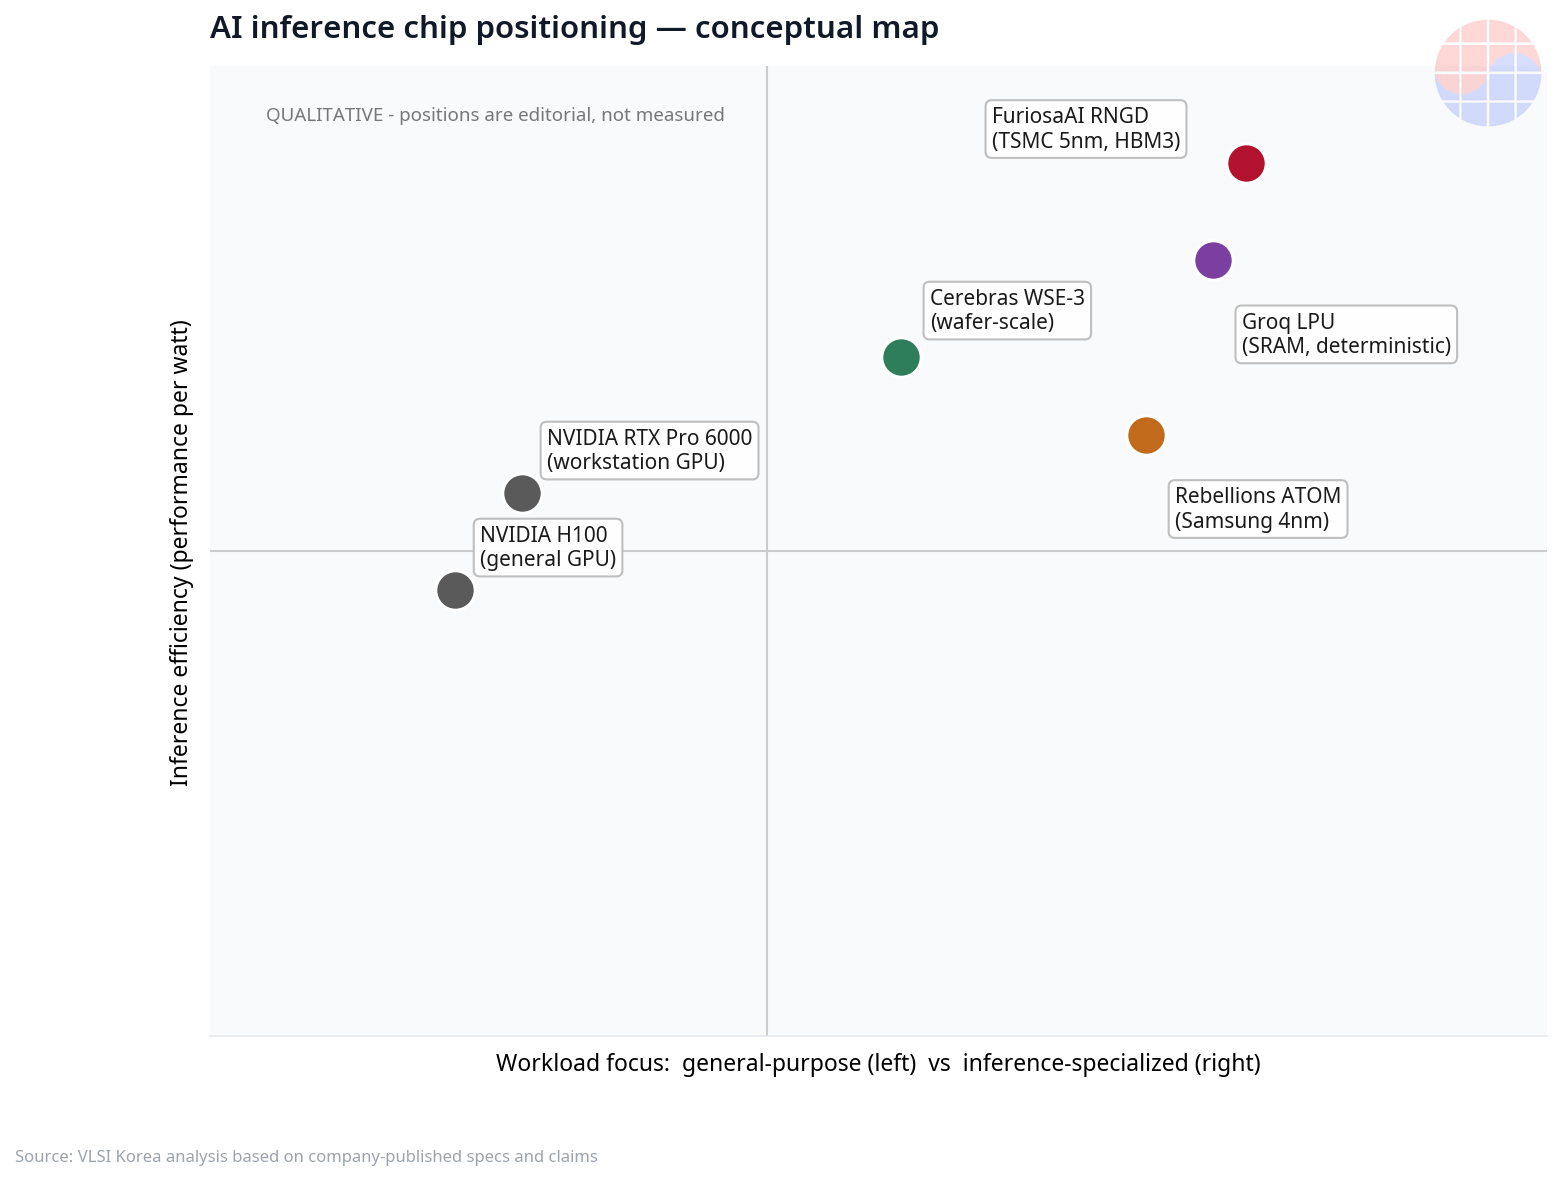
护城河 1 — 架构的学术根基。 TCP 不是营销口号,而是经 ISCA 2024 论文验证的架构。 设计的出发点,来自一个判断:推理市场的胜负不在训练,而在解码阶段的 memory-bound 区间。 与 Groq 选择以 SRAM 为中心的 deterministic 路线不同,FuriosaAI 选择了更务实的路线,用 HBM3 48GB 把 70B 级模型放上单张卡。 两条路线都成立,但 HBM 路线与现有数据中心的内存扩充蓝图方向一致。
护城河 2 — 由编译器证明的软件实力。 在 MLPerf 2022 中,公司用同一颗 Warboy 硅片、仅靠编译器改进就榨出了 2 倍性能。 推理是一场 software-defined 的竞赛,而这家公司用数字证明了,软件团队和硬件团队一样能打。 从 STA 和 timing 的角度补充一点:在 TSMC 5nm 1.0GHz 上,对 CoWoS-S interposer 和 HBM3 PHY(1.5TB/s)完成 timing closure,绝不是轻松的 tapeout。 Warboy 的 one-shot silicon success,以及与 GUC 联合开发 RNGD,都是执行力的证据。
护城河 3 — 每瓦 token 的经济学。 RNGD 的 TDP 是 180W,对比 H100 的 350W。 CEO June Paik 在 Renegade Summit(2026 年 3 月)上表示:“到 2030 年,全球 AI 数据中心将新增 100GW,其中 70% 将用于 inference。” 推理是每瓦 token 的游戏,在电力基础设施成为瓶颈的时代,一张 180W 的卡能改变机柜设计的自由度。
风险 — 营收必须跟上估值。 2024 年营收为 ₩3B,净亏损为 ₩152.2B(公开申报文件,Bloomberg 引用)。 ₩1T+ 的估值是对未来营收的押注。 Nvidia 的 CUDA 和供应链护城河依然存在,客户也集中在 LG、Samsung SDS 等少数几家。 3 亿至 5 亿美元的 pre-IPO 是否完成交割也尚未确认。 在韩国国内,与 Rebellions 的双强格局正在形成 — Rebellions 采用 Samsung 4nm,获得 Samsung 和 SK 的投资,目标在 2027 年上半年在 KOSPI 上市。 不过,推理市场更可能走向按 workload 分割的市场,而非赢家通吃。
Chase's Take。 我关注这家公司的原因,不是它拒绝 8 亿美元的胆量。 而是拒绝之后,4 个月内成为独角兽、6 个月内从 TSMC 拿到量产芯片的执行力。 许多 AI 芯片初创公司停在演示文稿阶段的那道关卡,FuriosaAI 用硅片闯了过去。 接下来要看的指标有三个:斯德哥尔摩的 8,800 颗订单能否转化为实际的重复性营收、pre-IPO 轮次是否完成交割,以及在 2027~2028 年 IPO 之前,季度营收能否步入正轨。 这三项若都成立,拒绝 8 亿美元将成为传奇;只要有一项落空,就会变成昂贵的学费。
Verdict
少数能用硅片证明自己有技术底气拒绝 Meta 8 亿美元的案例 — 现在缺的,是营收。
FAQ
FuriosaAI 是一家什么样的公司?
2017 年在首尔成立的 AI 推理专用 NPU fabless 公司。 由创始人兼 CEO June Paik(出身 AMD 和 Samsung Electronics)领军,核心架构是 Tensor Contraction Processor(TCP)。 2025 年 7 月累计融资 2.46 亿美元,晋升独角兽(企业价值 1 万亿韩元以上)。
RNGD 芯片的核心规格是什么?
这是采用 TSMC 5nm、1.0GHz 的第二代推理芯片,支持 FP8 512 TFLOPS、INT8 512 TOPS、INT4 1024 TOPS、HBM3 48GB(1.5TB/s)、TDP 180W 和 PCIe Gen5。 2024 年 8 月在 Hot Chips 公开,2026 年 1 月开始量产。
为什么拒绝 Meta 的 8 亿美元收购要约?
已于 2025 年 3 月 24 日最终拒绝(Bloomberg 报道)。 谈判破裂的原因不是价格,而是对收购后业务方向和组织架构的分歧。 此后公司走上独立成长路线,先后达成独角兽里程碑并开始量产。
融资现状和 IPO 计划如何?
截至 2025 年 7 月,累计已融资 2.46 亿美元,目前正在募集 3 亿至 5 亿美元规模的 pre-IPO/Series D(企业价值预计 ₩2T~₩3T)。 IPO 目标时间为 2027~2028 年。
证据限制:本文的 performance per watt、TCO 和同时用户比较数据,均以公司或客户(LG AI Research)发布为准(company-reported),尚未经独立验证。 2026 年的 pre-IPO 轮次和 National Growth Fund 投资案,截至 2026-10-18,是否完成交割尚未确认。
主要来源: FuriosaAI 官方博客(Series C bridge 发布) · FuriosaAI 开发者文档(RNGD 规格) · Pulse(独角兽报道) · Korea Herald(Renegade Summit) · Data Center Dynamics(Samsung SDS NPUaaS) · TheElec(量产数量)


