 VLSI Korea
Microsoft presenta Maia 300: un millón de chips propios que cambian el negocio de la IA
Microsoft presentó Maia 300, su chip de IA propio de tercera generación, y planea desplegar más de un millón en 2027. El mayor comprador de GPU del mundo se convierte en competidor: la economía del token, no los FLOPS, es el nuevo campo de batalla.


El anuncio de chips más importante de octubre de 2026 no trata de un acelerador más rápido, sino de quién tiene derecho a ser una empresa de chips. El 12 de octubre de 2026, Microsoft presentó Maia 300, la tercera generación de su silicio de IA propio, y dijo que planea desplegar potencialmente más de un millón de estos chips en 2027 como el sistema de inferencia principal de sus propios productos y servicios (Reuters, 16 de octubre de 2026). El mayor comprador mundial de GPU de IA se está convirtiendo, en el margen, en un competidor de las GPU — y cada consulta de inferencia que se traslade a Maia es gasto que ya no pasa por NVIDIA.
Las especificaciones ya son serias: un encapsulado chiplet con cómputo en silicio de clase 2 nanómetros de TSMC, ocho pilas de HBM4 con 288 GB y 18,0 TB/s de ancho de banda pico, en un envolvente de 950 vatios, ensamblados en racks de 96 aceleradores de unos 167 kilovatios (Microsoft, 12 de octubre de 2026). Microsoft afirma ~40 % más de tokens por megavatio que los principales sistemas basados en GPU, y hasta 7 veces el rendimiento por rack de su predecesor, Maia 200. Pero la historia estratégica es más grande que cualquier referencia de rendimiento: Microsoft está integrando verticalmente la capa más cara del stack de IA — la inferencia — y lo está haciendo a una escala que reescribe la economía de los foundry, los fabricantes de memoria y los proveedores de chips comerciales por igual.
Lo que Microsoft realmente anunció
El anuncio llegó en un blog de Scott Guthrie, vicepresidente ejecutivo de Cloud e IA, el lunes 12 de octubre de 2026. El CEO Satya Nadella la llamó la "apuesta más grande hasta la fecha por nuestro propio silicio": la compañía escalará la familia Maia a despliegues de múltiples gigavatios desde 2027, como el sistema de inferencia principal de sus propios productos y servicios (Microsoft, 12 de octubre de 2026).
Los compromisos clave, todos fechados y documentados:
- Maia 300 está orientado a la inferencia. Diseñado para las cargas que Microsoft realmente monetiza: asistencia de codificación, razonamiento de contexto largo, IA conversacional en tiempo real y tareas de agentes en varios pasos.
- Los despliegues de producción comienzan en 2027, con escalado a múltiples gigavatios. Reuters informó que la compañía podría desplegar más de un millón de chips Maia el próximo año.
- Maia 200 ya está en producción, ejecutando los modelos de IA propios de Microsoft y los modelos de OpenAI servidos en Azure, desplegado en Estados Unidos, Europa y Australia. Microsoft 365 Copilot funciona sobre él hoy; GitHub Copilot y Microsoft Foundry están programados para seguirlo antes de finales de 2026.
- La afirmación de eficiencia divulgada de Maia 200: hasta 1,7 veces más tokens por vatio que los sistemas alternativos basados en GPU — la base de referencia contra la que se mide la ganancia de 7 veces en rendimiento de tokens por rack de Maia 300.
Dos salvedades: la afirmación del 40 % más de tokens por megavatio se mide contra "principales sistemas basados en GPU" sin nombre — es una afirmación del proveedor, no un benchmark independiente. Y Microsoft sigue comprando GPU de NVIDIA a gran escala: el impacto a corto plazo es un cambio en la mezcla del gasto en inferencia, no un desplazamiento de la noche a la mañana.
El chip, en cifras
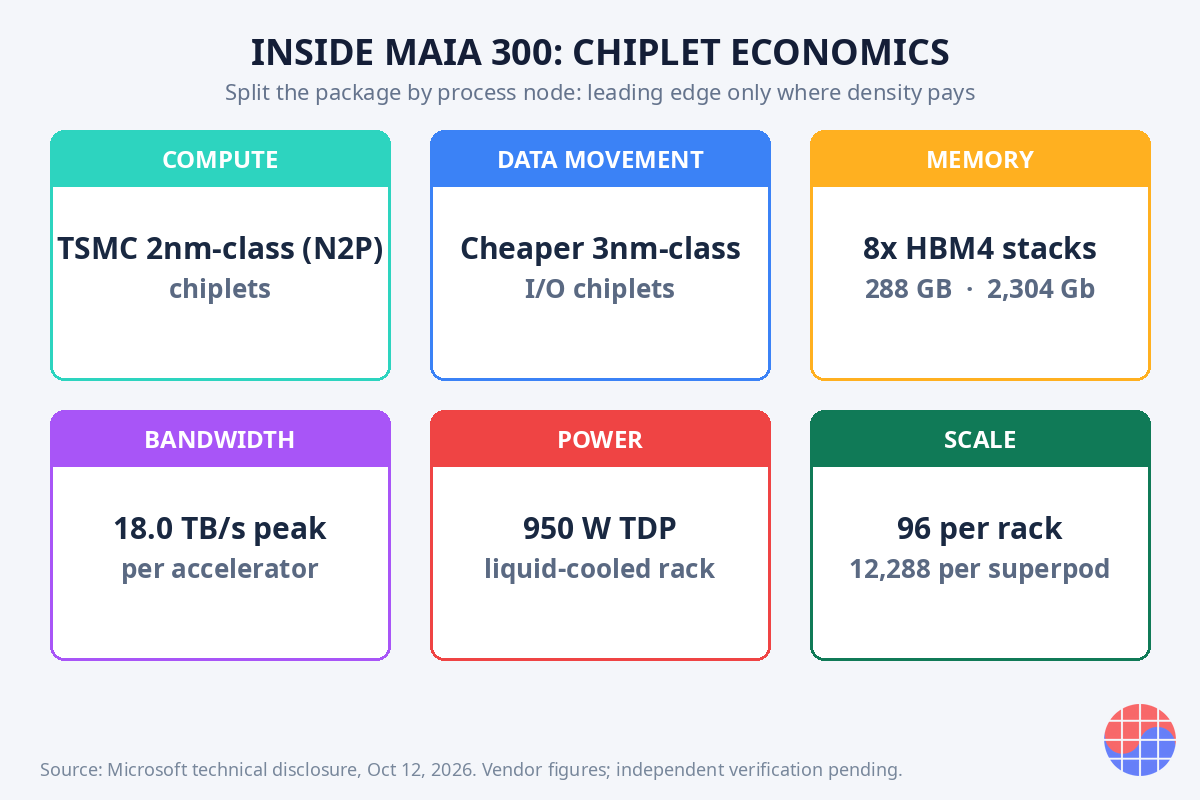
Según la divulgación técnica de Microsoft (12 de octubre de 2026), Maia 300 es un encapsulado multi-chiplet que divide el dado según la economía, no solo según la función:
| Bloque | Detalle |
|---|---|
| Chiplets de cómputo | Silicio clase 2 nm de TSMC (N2P) para funciones clave de cómputo |
| Chiplets de movimiento de datos | Silicio clase 3 nm más barato para mover datos fuera del procesador |
| Memoria | 8 pilas de HBM4, 288 GB (2.304 Gb) por acelerador |
| Ancho de banda de memoria | 18,0 TB/s pico |
| Energía | 950 W TDP por acelerador |
| Rack | 96 aceleradores, ~167 kW, 27,6 TB de HBM por rack |
| Ancho de banda del rack | ~1,7 PB/s de ancho de banda de memoria agregado |
| Escalado | Fabric Ethernet de dos niveles, hasta 128 racks = 12.288 aceleradores por superpod |
Tres cifras merecen una segunda mirada. 288 GB de HBM4 por chip son 2.304 Gb: con más de un millón de chips, eso señala una demanda de más de 8 millones de pilas de HBM4 — unos 288 petabytes — solo en el despliegue de 2027. 950 vatios por acelerador colocan a Maia 300 en la misma clase térmica que las GPU comerciales insignia, lo que significa las mismas cadenas de suministro de refrigeración líquida y entrega de energía. Y 96 aceleradores por rack a 167 kW duplican la densidad de aceleradores de Maia 200 — la unidad de competencia ya no es el chip, es el rack.
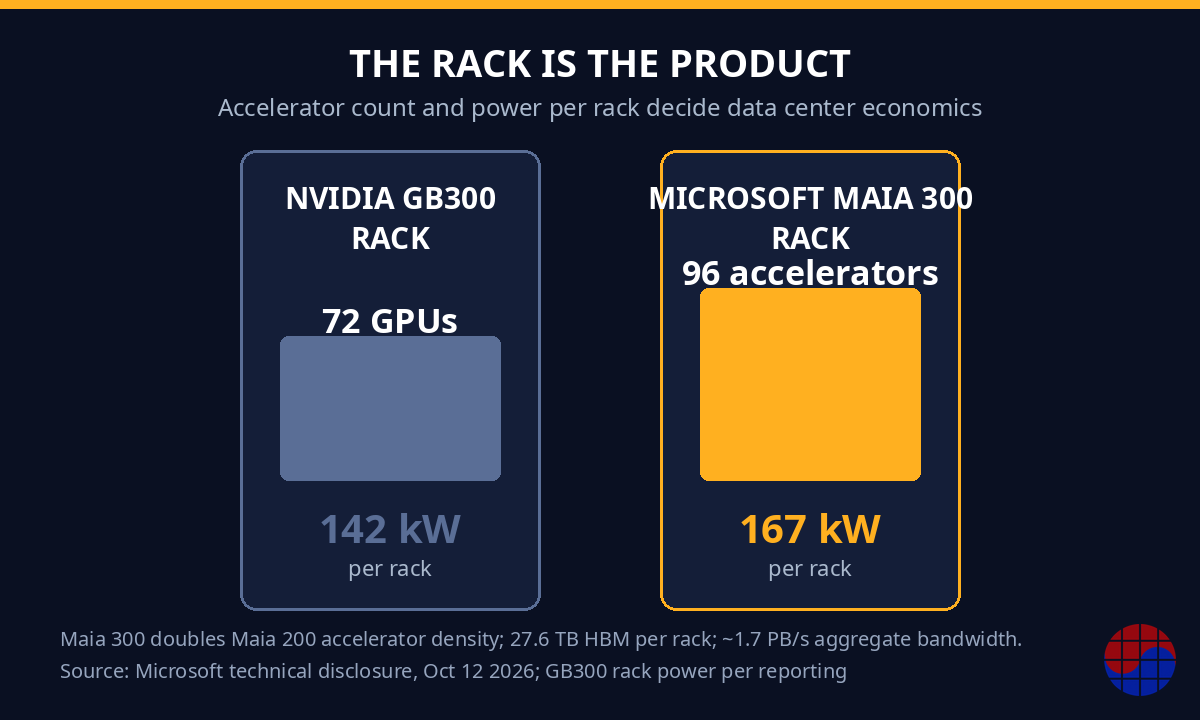
El fabric de escalado es la señal silenciosa. Maia 300 usa un fabric Ethernet de dos niveles — enlaces eléctricos dentro del rack, ópticos entre racks — que une hasta 128 racks en un superpod de 12.288 aceleradores, con ancho de banda reasignable por los programadores de trabajos y capacidad de respaldo en caliente de racks vecinos. Es una apuesta arquitectónica directa contra las interconexiones de escalado propietarias: Ethernet, el estándar commodity, frente a los jardines amurallados estilo NVLink. Para Broadcom, Marvell y el ecosistema Ethernet, la victoria de diseño más relevante del año.
Por qué inferencia y por qué ahora: la lógica de la economía de los tokens
El entrenamiento se lleva los titulares; la inferencia paga las cuentas. Cada consulta de Copilot, cada bucle de agente, cada sesión de razonamiento de contexto largo es inferencia facturada contra la propia estructura de costos de Microsoft. A medida que caen los costos de servir modelos — inteligencia más barata por token — el dinero se concentra en quien sirva tokens al menor costo a escala.
Eso es exactamente para lo que está optimizado Maia 300: un 40 % más de tokens por megavatio y nuevos formatos de datos sub-3-bit y MXFP4 mejorado que extraen más trabajo útil de cada vatio. Microsoft no está intentando superar a NVIDIA en FLOPS pico. Está intentando ganar la métrica que decide su propia cuenta de resultados: el costo por millón de tokens servidos, dentro de centros de datos que ya posee, en cargas de trabajo que ya controla.
La lógica MBA en una línea: cuando posees tanto la demanda (Copilot, Azure) como la oferta (silicio Maia, centros de datos), la integración vertical convierte un costo variable — comprar GPU ajenas con el margen de otro — en un activo de costo fijo que se amortiza. El plan del millón de chips es Microsoft amortizando la inferencia.
La lectura del ingeniero: los chiplets son una decisión de rendimiento
Sin el marketing, el encapsulado de Maia 300 es una lección de manual de economía de nodos avanzados: de las que se aprenden en el piso de tape-out, no en una presentación de estrategia.
Poner el cómputo en el N2P clase 2 nm de TSMC y las funciones de controlador de memoria y E/S en un nodo clase 3 nm más barato es, ante todo, una jugada de rendimiento (yield) y costo. En los nodos de vanguardia la densidad de defectos duele más y los precios de oblea muerden más fuerte: solo va allí la lógica que realmente necesita la densidad; el resto queda en un nodo maduro de alto rendimiento (yield). La economía de dados buenos conocidos (known-good-die) entonces decide el rendimiento del encapsulado, no un solo dado monolítico gigante.
Segundo, la interfaz HBM4 es el verdadero reto de signoff. Ocho pilas a 18,0 TB/s significa que la PHY, el ruteo del interposer y el trabajo de integridad de energía alrededor del subsistema de memoria dominan el esfuerzo de diseño físico — mucho más que el cierre de temporización de la lógica cruda. Cualquiera que haya hecho signoff de STA en un SoC grande conoce el patrón: el número titular es el ancho de banda, pero el riesgo del tape-out vive en las interfaces.
Tercero, el co-diseño a nivel de rack es el nuevo floorplan. Con refrigeración líquida absorbiendo la mayor parte de la carga térmica de un rack de 167 kW, encapsulados de 950 W y enlaces ópticos entre racks, la red de entrega de energía y la envolvente térmica condicionan la arquitectura antes que el RTL. El equipo de chips que no co-diseña con el de racks entrega una pieza que el centro de datos no puede alojar.
Qué significa para NVIDIA
El riesgo a corto plazo para NVIDIA es limitado: Microsoft sigue comprando sus GPU a gran escala, y el entrenamiento — el bastión de NVIDIA — no se ve afectado por un chip orientado a la inferencia. Pero la dirección es inconfundible. Cada consulta de Copilot que migre a Maia es ingreso de inferencia que ya no fluye a través del stack de NVIDIA: ni la GPU, ni la HBM acoplada a ella, ni las redes.
Más estructuralmente, Maia 300 legitima el escalado Ethernet a la mayor escala de la industria. Si el fabric de dos niveles rinde a escala de 12.288 aceleradores, debilita el argumento de que solo las interconexiones propietarias sostienen un clúster de frontera — y el bloqueo por interconexión es un pilar del foso de NVIDIA.
El efecto de tercer orden es el poder de precios. Una alternativa interna creíble cambia cada negociación de los grandes compradores con los proveedores comerciales. Microsoft no necesita que Maia supere a la mejor GPU comercial en cada carga de trabajo; necesita que Maia sea lo suficientemente buena en las cargas de trabajo de Microsoft para poner un techo a lo que paga por el resto.
Qué significa para memoria y foundry
Memoria: 8 pilas de HBM4 por chip con más de un millón de chips es una señal de demanda incremental de más de 8 millones de pilas para 2027 — para SK hynix, Samsung y Micron, todos compitiendo por calificar HBM4. La disciplina de unidades importa: 288 GB por acelerador son 2.304 Gb, y la aritmética a nivel de rack (27,6 TB por rack) es como compran los planificadores de centros de datos. La carrera de suministro de HBM4 acaba de conseguir su mayor ancla de demanda.
Foundry: los chiplets de cómputo en el N2P de TSMC hacen de Microsoft uno de los primeros clientes a gran escala de la familia N2, junto con los nombres habituales de móvil y HPC. La asignación temprana de N2P a este volumen es declaración tecnológica y negociación de capacidad a la vez — y profundiza el liderazgo de TSMC como el foundry de la era de la IA.
El club del silicio propio ya está lleno. Google tiene TPU, AWS tiene Trainium, Meta tiene MTIA y OpenAI persigue su propio chip. El plan de un millón de unidades de Maia 300 es el mayor compromiso de despliegue individual entre ellos: el silicio vertical pasó de experimento a estrategia de compras.
Qué seguir de cerca
- Benchmarks independientes. La afirmación del 40 % no nombra ninguna GPU de referencia: espere mediciones de terceros con límites de potencia definidos y cargas reales.
- Suministro de HBM4. Si Microsoft asegura más de 8 millones de pilas de HBM4 para 2027 con la memoria escasa — y cuál de los tres proveedores gana la calificación.
- Clientes externos. Microsoft dice que Maia es para sus propios productos y servicios. Si un cliente externo alguna vez obtiene acceso, Maia se convierte en un competidor comercial, no solo en una jugada de costos.
- La apuesta Ethernet. Si el fabric de escalado de dos niveles aguanta a escala de 12.288 aceleradores — el resultado resonará en la hoja de ruta de cada proveedor de redes.
La conclusión: Maia 300 no es un lanzamiento de chips. Es una estrategia de compras con foto de dado. Microsoft miró la partida más grande de su cuenta de resultados de IA — el cómputo de inferencia — y decidió fabricarla. Para la industria de semiconductores, el mensaje es que el cliente ahora también es el competidor, y la negociación ocurre en tokens por megavatio.
Preguntas frecuentes
¿Qué es Microsoft Maia 300?
Maia 300 es el acelerador de IA propio de tercera generación de Microsoft, anunciado el 12 de octubre de 2026 y diseñado para cargas de trabajo de inferencia como asistencia de codificación, razonamiento de contexto largo y tareas agénticas. Utiliza una arquitectura chiplet con dados de cómputo en silicio clase 2 nm de TSMC, ocho pilas de HBM4 (288 GB, 18,0 TB/s), en un envolvente de 950 W, desplegado en racks de 96 aceleradores.
¿Cuántos chips Maia 300 desplegará Microsoft?
Reuters informó (16 de octubre de 2026) que Microsoft planea desplegar potencialmente más de un millón de chips Maia en 2027, escalando la familia Maia a múltiples gigavatios como el sistema de inferencia principal de sus propios productos y servicios. La producción comienza en 2027.
¿Cómo se compara Maia 300 con las GPU de NVIDIA?
Microsoft afirma ~40 % más de tokens por megavatio que "principales sistemas basados en GPU" sin nombre, y hasta 7 veces el rendimiento por rack de su predecesor Maia 200 — ambas afirmaciones del proveedor a la espera de verificación independiente. Arquitectónicamente, apuesta por un fabric Ethernet de dos niveles frente a las interconexiones propietarias, y apunta a la eficiencia de costo de inferencia, no a FLOPS pico de entrenamiento.
¿Qué significa Maia 300 para los proveedores de HBM y foundry?
Con 8 pilas de HBM4 por chip y más de un millón de chips planeados, el despliegue de 2027 implica una demanda de más de 8 millones de pilas de HBM4 (~288 petabytes) — un ancla de demanda importante para las rampas de HBM4 de SK hynix, Samsung y Micron. Los chiplets de cómputo en el nodo N2P de TSMC también convierten a Microsoft en uno de los primeros clientes a gran escala de la capacidad clase 2 nm de TSMC.
Divulgación: este análisis se basa en el anuncio de Microsoft del 12 de octubre de 2026 y reportes posteriores (Reuters, 16 de octubre de 2026); las cifras de rendimiento son afirmaciones de Microsoft y no han sido verificadas de forma independiente. El autor no tiene posiciones en las compañías mencionadas. Las cifras reflejan lo divulgado al 17 de octubre de 2026.


