 VLSI Korea
d-Matrix dan Valuasi US$2 Miliar: Mengapa Pasar Membayar Komputasi di Dalam Memori
d-Matrix menutup Seri C US$275 juta pada November 2025 dengan valuasi US$2 miliar. Akselerator Corsair-nya melakukan komputasi di dalam SRAM pada 150 TB/s per kartu. Kami membedah fisikanya, ekonomi proses SRAM, peta jalan 3DIMC Raptor, dan apa yang harus benar agar valuasi ini bertahan.


Ringkasan 30 Detik
d-Matrix dihargai US$2 miliar karena ia menjual satu hal yang paling langka dalam ekonomi inferensi: bandwidth memori yang tidak pernah meninggalkan chip. Startup asal Santa Clara ini menutup pendanaan Seri C sebesar US$275 juta pada 12 November 2025 dengan valuasi US$2 miliar, sehingga total dana yang dihimpun mencapai US$450 juta. Akselerator andalannya, Corsair, melakukan komputasi di dalam SRAM — Digital In-Memory Computing, atau DIMC — dan mengklaim bandwidth on-chip 150 TB/s per kartu, hingga 30.000 token per detik pada Llama 70B dengan 2 ms per token, serta efisiensi energi 3–5 kali lebih baik daripada sistem berbasis GPU. Corsair memasuki produksi penuh pada Juni 2026. Angka US$2 miliar itu bukan pembayaran atas pendapatan hari ini. Itu adalah pembayaran atas sebuah opsi: bahwa ketika inferensi menjadi biaya dominan AI, arsitektur yang menang adalah arsitektur yang memperlakukan memori, bukan aritmetika, sebagai produknya.
| Item | Rincian |
|---|---|
| Valuasi | US$2 miliar (Seri C, 12 Nov 2025) |
| Total pendanaan | US$450 juta |
| Produk | Corsair (DIMC, TSMC 6nm) |
| Komputasi | 2.400 TFLOPS (8-bit) |
| Memori on-chip | 2 GB SRAM, 150 TB/s |
| Memori off-chip | Hingga 256 GB LPDDR5 |
| Generasi berikutnya | Raptor / 3DIMC (target tape-out akhir 2026) |
Background: Perusahaan yang Dibangun untuk Paruh Kedua AI
d-Matrix didirikan pada 2019 di Santa Clara, California, oleh Sid Sheth (CEO) dan Sudeep Bhoja (CTO). Taruhan awalnya tidak populer pada masanya: pelatihan (training) tidak akan selamanya menjadi kendala utama AI. Setelah dilatih, model harus menjawab pertanyaan secara terus-menerus, dalam skala besar, untuk pengguna yang membayar. Fase layanan itulah — inferensi — yang akan menjadi biaya terbesar industri. Perusahaan ini menghabiskan enam tahun membangun untuk fase tersebut sebelum pasar menyetujuinya.
Riwayat pendanaannya menunjukkan tesis itu semakin banyak dipercaya. Putaran US$110 juta pada 2023 membawa masuk M12, dana ventura Microsoft. Seri C pada November 2025 dipimpin bersama oleh BullhoundCapital, Triatomic Capital, dan Temasek, dengan partisipasi baru dari Qatar Investment Authority (QIA) dan EDBI Singapura, serta partisipasi lanjutan dari M12, Nautilus Venture Partners, Industry Ventures, dan Mirae Asset. Total dana yang dihimpun mencapai US$450 juta, dan jumlah karyawan melampaui 250 orang di Santa Clara, Toronto, Sydney, Bangalore, dan Beograd.
Waktunya penting. Pada akhir 2025, para hyperscaler secara terbuka menggeser belanja modal dari klaster pelatihan ke armada inferensi, dan pertanyaan utama industri berubah dari "seberapa cepat kita bisa melatih" menjadi "berapa biaya setiap token". d-Matrix adalah salah satu dari sedikit startup yang merancang silikonnya sejak hari pertama untuk pertanyaan kedua. Valuasi US$2 miliar untuk perusahaan chip yang belum berskala harus dibaca dengan latar belakang itu.
Business Deep Dive
Produk: komputasi di tempat bobot berada
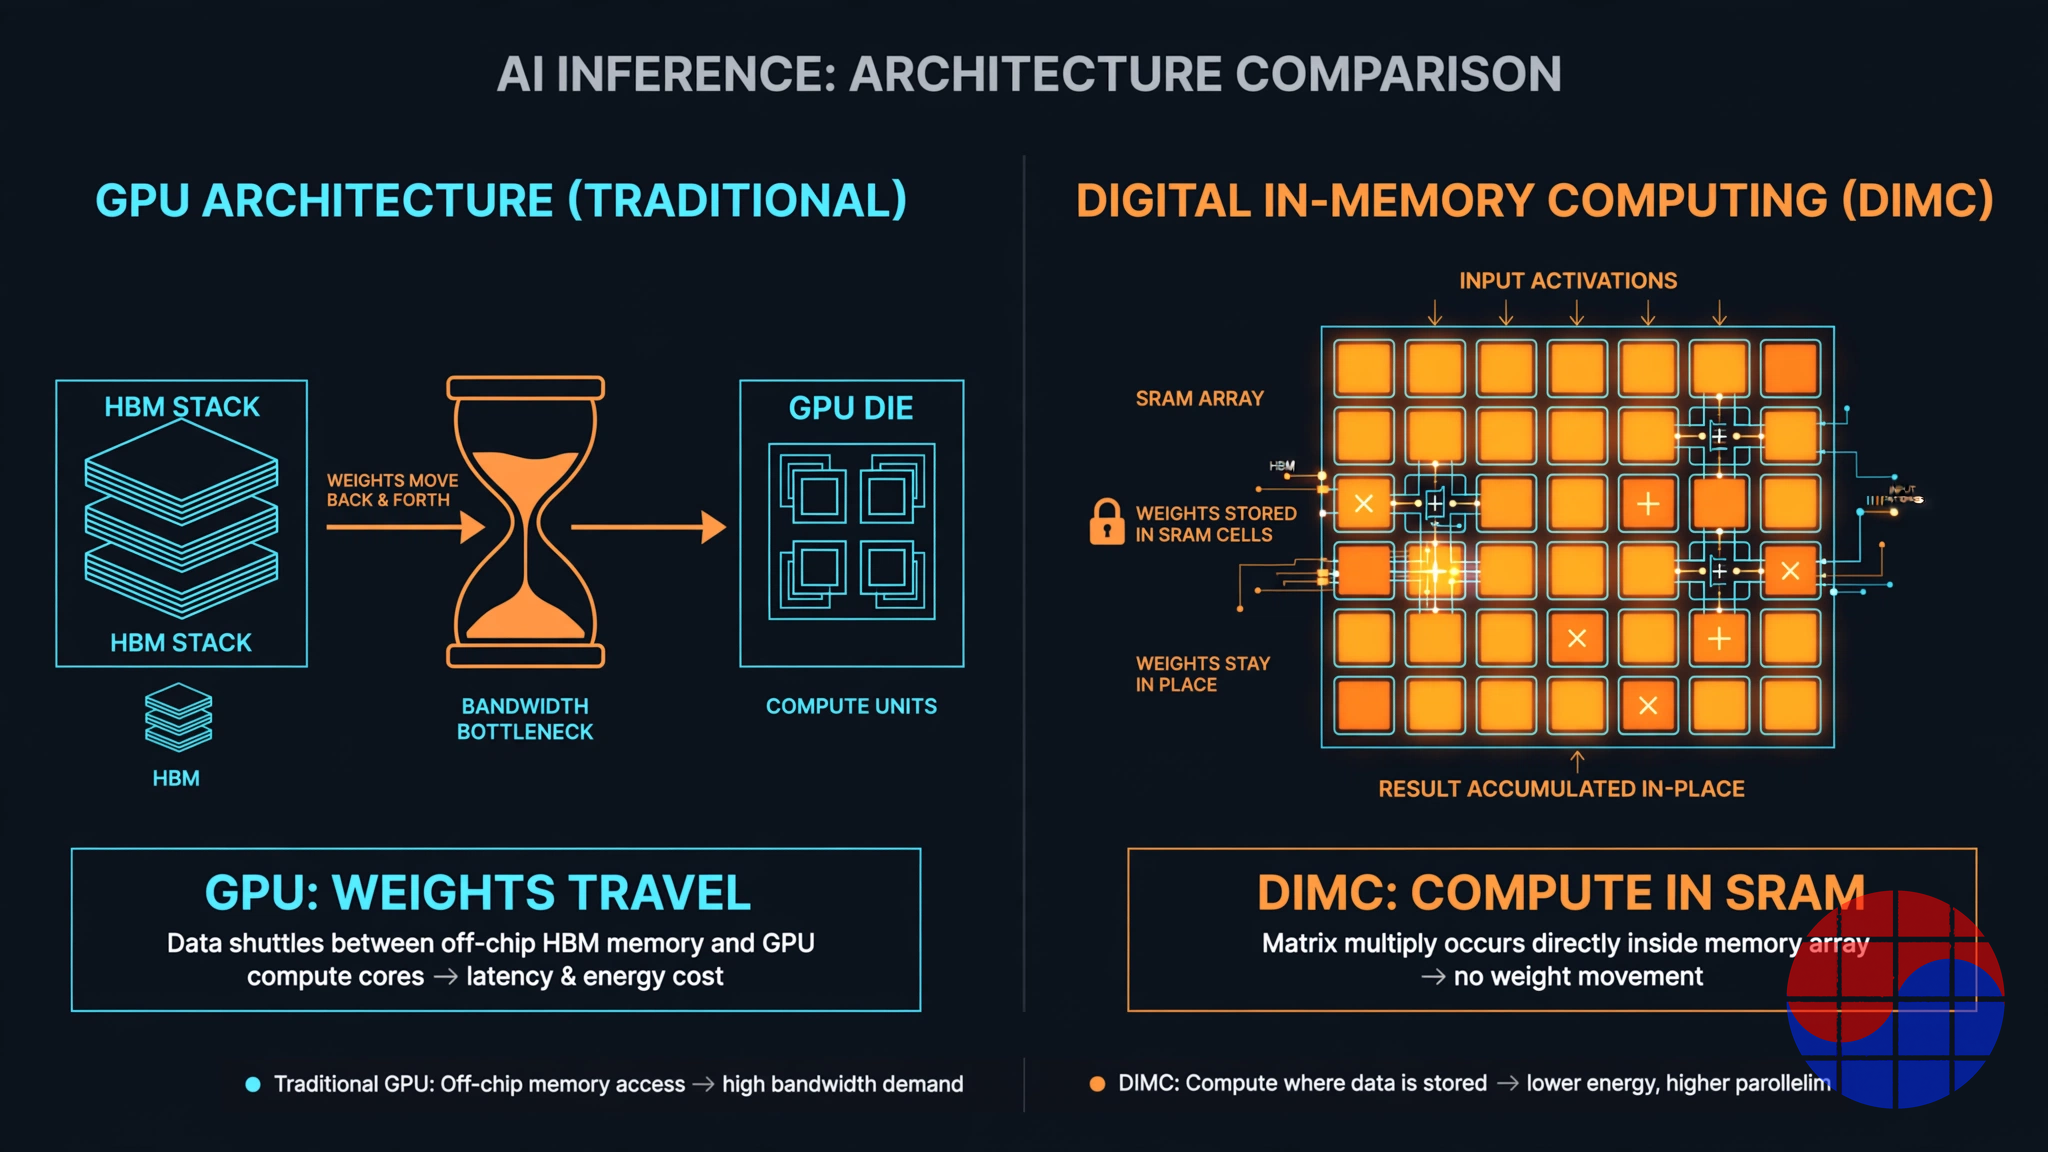
Inferensi pada fase decode terikat oleh memori. Menghasilkan setiap token mengharuskan pembacaan bobot model, dan GPU menghabiskan sebagian besar waktu dan energinya untuk memindahkan bobot itu antara tumpukan HBM dan unit komputasi. Corsair menyerang perpindahan itu sendiri. Inti DIMC-nya menjalankan operasi matriks di dalam larik SRAM, sehingga bobot tidak diangkut ke tempat komputasi berlangsung — bobot dihitung tepat di tempatnya berada.
Angka-angka kartu yang sudah diproduksi mendefinisikan pertukarannya. Setiap kartu Corsair, dibangun di atas proses 6 nm TSMC dalam faktor bentuk standar PCIe Gen5, memberikan komputasi puncak 8-bit sebesar 2.400 TFLOPS, Performance Memory on-chip (SRAM) sebesar 2 GB yang berjalan pada 150 TB/s, dan Capacity Memory LPDDR5 off-chip hingga 256 GB. Bandingkan bandwidth-nya dengan HBM: satu tumpukan HBM3e terdepan memberikan sekitar 1,2 TB/s per tumpukan, dan satu paket GPU penuh pun berjumlah sekitar 8 TB/s. Angka 150 TB/s Corsair adalah bandwidth SRAM on-chip, bukan bandwidth paket — besaran yang berbeda, dan perbandingan ini menguntungkan d-Matrix. Namun arahnya nyata: untuk decode batch kecil yang sensitif terhadap latensi, mempertahankan bobot di SRAM menghilangkan perjalanan pulang-pergi yang mendominasi latensi token GPU.
Yang sebenarnya dibeli oleh dana Seri C adalah platform di sekeliling chip. NIC JetStream menghubungkan kartu dan rak dengan latensi rendah. Tumpukan perangkat lunak Aviator mengompilasi model yang ditulis dalam PyTorch dan Triton ke atas fabric DIMC. SquadRack, arsitektur rak referensi yang dibangun bersama Arista, Broadcom, dan Supermicro, mengemas kartu menjadi sistem yang siap diterapkan, dan klaster Squadron, yang diumumkan tersedia secara umum pada Oktober 2026, dapat diskalakan hingga 1.024 XPU Corsair dalam 16 rak di pusat data standar berpendingin udara. Corsair memasuki produksi penuh pada Juni 2026, dengan pengiriman volume yang diarahkan ke hyperscaler, neocloud, dan laboratorium AI terdepan. Pada April 2026 perusahaan juga mengakuisisi bisnis pusat data GigaIO, menambah fabric memori FabreX dan desain sistem SuperNODE.
Langit-langit SRAM, dan mengapa Raptor ada
Kekuatan arsitektur ini sekaligus menjadi langit-langitnya. SRAM cepat dan harganya per bit sangat mahal. Performance Memory Corsair sebesar 2 GB tidak dapat menampung model 70B; sisanya berada di LPDDR5 Capacity Memory, dan kinerja nyata bergantung pada seberapa cerdas Aviator membagi pekerjaan di antara kedua tingkat itu. SRAM juga tidak menyusut seperti logika: pada node canggih densitasnya membaik secara lambat, sehingga peta jalan SRAM murni membuat biaya per kapasitas pembangkitan token naik setiap generasi, bukan turun. Inilah pertanyaan ekonomi proses yang harus dijawab setiap startup komputasi dalam memori.
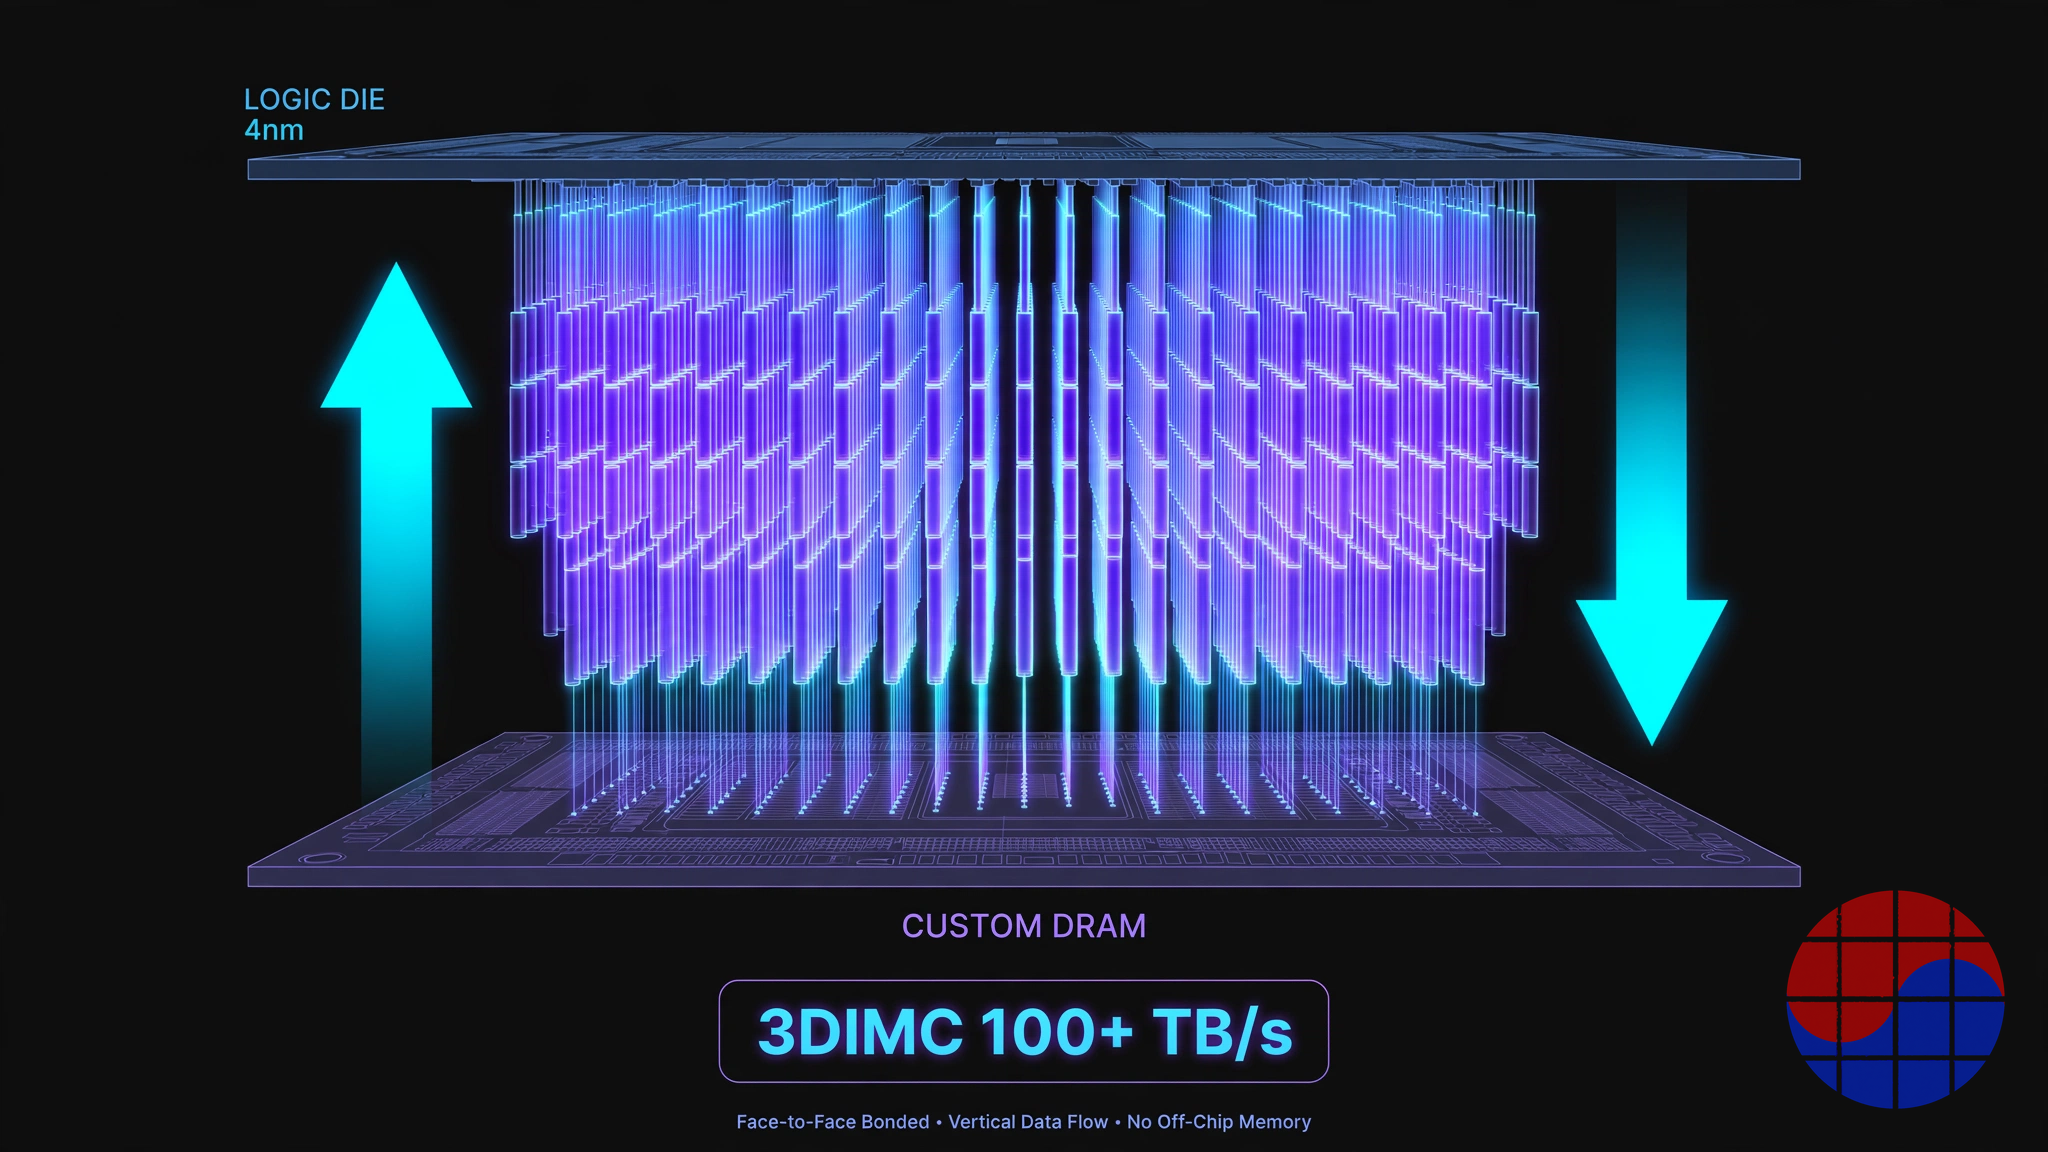
Jawaban d-Matrix adalah 3DIMC, yang diwujudkan dalam platform generasi berikutnya, Raptor. Diperkenalkan melalui wahana uji Pavehawk bersama Alchip pada November 2025, Raptor menempelkan die logika 4 nm TSMC secara face-to-face ke die DRAM kustom pada pitch 36 mikron. Perusahaan memproyeksikan bandwidth lebih dari 100 TB/s dan memori bertumpuk 32 GB — 256 Gb — per akselerator pada 0,37 pJ/bit, dan hasil silikon awal yang dipresentasikan pada 2026 melaporkan throughput inferensi per akselerator sekitar 4,7 kali lebih tinggi daripada konfigurasi berbasis HBM. Raptor ditargetkan tape-out pada akhir 2026, dengan ketersediaan rak pada kuartal keempat 2027. Pada September 2026, d-Matrix bergabung dengan ekosistem NVLink Fusion dari NVIDIA, sehingga XPU Raptor dirancang untuk dipasang ke rak MGX NVIDIA berdampingan dengan GPU, bukan menuntut penggantian total.
Apa yang harus benar agar US$2 miliar masuk akal
Kupas cerita ini hingga tersisa aritmetikanya. Valuasi US$2 miliar di atas total himpunan US$450 juta, sebelum pendapatan bervolume, memberi harga pada d-Matrix sebagai bisnis platform masa depan, bukan vendor komponen. Tiga hal harus terbukti. Pertama, belanja inferensi harus terus bertumbuh secara majemuk, sehingga lapisan decode khusus menjadi pos anggaran yang dibiayai hyperscaler secara terpisah dari GPU. Kedua, ekonomi yang diklaim Corsair — interaktivitas 10 kali, kinerja per total biaya kepemilikan 3 kali, efisiensi energi 3–5 kali, semuanya angka yang dilaporkan perusahaan — harus bertahan dalam beban kerja produksi pelanggan bernama, bukan hanya benchmark Llama. Ketiga, parit perangkat lunak harus terbentuk: Aviator harus cukup melekat sehingga pelanggan tidak memperlakukan perangkat keras sebagai komoditas yang dapat ditukar ketika NVIDIA, AMD, atau tim ASIC hyperscaler sendiri mengeluarkan jawaban yang cukup baik.
Bukti traksi sejauh ini nyata tetapi belum lengkap. Status produksi penuh, lini rak yang dibangun Supermicro, akuisisi yang menambah fabric tingkat sistem, dan jajaran investor berbobot dana kekayaan negara (Temasek, QIA, EDBI) semuanya menandakan pembeli canggih sedang melakukan uji tuntas dan tetap bertahan. Yang masih hilang adalah kelas bukti yang pada akhirnya menentukan harga startup chip: penerapan produksi yang diungkapkan dengan hyperscaler bernama dan pemesanan berulang. Upaya yang dilaporkan pada Juli 2026 untuk menghimpun modal tambahan pada valuasi lebih tinggi, serta minat investasi NVIDIA yang dilaporkan, masih belum terkonfirmasi dan harus diperlakukan sebagai laporan, bukan fakta yang mapan.
Sisi turun: HBM melawan balik, dan perangkat lunak adalah pajaknya
Kasus pesimisnya bercabang dua. Yang pertama adalah fisika dan peta jalan. HBM tidak diam: HBM4 memperlebar antarmuka menjadi 2.048 bit per tumpukan, dan vendor GPU mengintegrasikan SRAM yang lebih besar, interkoneksi yang lebih cepat, serta SKU yang dioptimalkan untuk inferensi. Setiap generasi mempersempit celah latensi yang membenarkan akselerator terpisah, sementara incumbent GPU menawarkan satu tumpukan perangkat lunak untuk pelatihan dan inferensi sekaligus. Cabang kedua adalah pajak adopsi. Setiap platform non-CUDA meminta pelanggan memindahkan model, mempercayai kompiler yang masih muda, dan menerima risiko vendor atas neraca sebuah startup. d-Matrix meredakannya dengan posisi heterogen — Corsair sebagai pelepas beban decode di samping GPU, yang diformalkan oleh langkah NVLink Fusion dan demonstrasi Attention-FFN Disaggregation (AFD), yang membagi attention ke GPU dan lapisan feed-forward ke XPU Corsair serta menunjukkan 845 token per detik per pengguna pada 64 pengguna bersamaan. Peredaan bukanlah penghapusan: pajak itu dibayar dalam setiap siklus penjualan.
Chase's Take
Sebagian besar startup chip AI menjual mesin yang lebih cepat. d-Matrix menjual identitas akuntansi yang berbeda: dalam inferensi decode, token per detik kira-kira sama dengan bandwidth dibagi ukuran model, jadi perusahaan yang memiliki bandwidth memiliki marginnya. Memilih komputasi dalam memori digital ketimbang analog adalah keputusan yang diam-diam tepat — IMC analog memukau dalam demo dan berantakan dalam kalibrasi, sedangkan DIMC mempertahankan determinisme SRAM dan bertahan terhadap migrasi proses. Pertanyaan jujurnya bukanlah apakah fisikanya bekerja; Pavehawk dan hasil silikon 2026 mengatakan ia bekerja. Pertanyaannya adalah apakah ekonomi SRAM ditambah tumpukan perangkat lunak yang muda dapat mempertahankan lapisan yang dapat dipertahankan di hadapan incumbent yang dapat membundel jawabannya ke dalam rak GPU yang sudah dibeli pelanggan. Keputusan NVLink Fusion memberi tahu saya bahwa manajemen memahami hal ini: d-Matrix tidak berusaha mengalahkan rak NVIDIA, ia berusaha menjadi satu pos di dalam rak itu. Pada US$2 miliar, investor tidak membayar hasil tersebut — mereka membayar jalur tertimbang probabilitas menuju hasil itu, dengan kas Seri C membiayai tepat dua bukti yang masih hilang: skala produksi bernama dan Raptor yang tepat jadwal.
Implications
Bagi hyperscaler dan neocloud: akselerator sekelas Corsair mengubah inferensi menjadi masalah desain heterogen. Pertanyaan pengadaan bergeser dari "GPU mana" menjadi "lapisan mana berjalan di mana", dan disagregasi bergaya AFD menjadi disiplin perencanaan kapasitas, bukan eksperimen.
Bagi industri memori: d-Matrix adalah sinyal permintaan yang disertai peringatan. Produknya saat ini memutar menghindari HBM dengan SRAM dan LPDDR5, dan DRAM bertumpuk kustom Raptor menunjukkan persaingan jangka panjangnya bukan HBM melawan ketiadaan — melainkan HBM standar melawan memori yang dirancang mengelilingi die komputasi tertentu. Pembuat memori yang merancang tumpukan bersama startup akselerator memperoleh saluran yang tidak dikendalikan duopoli GPU.
Bagi investor: harga US$2 miliar akan dihargai ulang oleh dua peristiwa yang dapat diamati: penerapan hyperscale Corsair pertama yang bernama dan berulang, dan tape-out Raptor pada akhir 2026. Sampai saat itu, valuasi bertumpu pada klaim benchmark dan kualitas investor — sinyal yang kuat, tetapi tetap sinyal, bukan arus kas.
FAQ
Apa yang dilakukan d-Matrix?
d-Matrix membangun akselerator pusat data yang khusus untuk inferensi AI. Platform Corsair-nya menggunakan Digital In-Memory Computing (DIMC) — komputasi di dalam SRAM — bersama jaringan JetStream dan tumpukan perangkat lunak Aviator, menargetkan pembangkitan token berlatensi rendah dan hemat energi, bukan pelatihan model.
Mengapa d-Matrix dihargai US$2 miliar?
Valuasi US$2 miliar ditetapkan oleh Seri C sebesar US$275 juta yang ditutup pada 12 November 2025, dipimpin bersama oleh BullhoundCapital, Triatomic Capital, dan Temasek, dengan partisipasi dari QIA, EDBI, dan M12 milik Microsoft. Investor memberi harga pada ekspektasi bahwa inferensi akan menjadi biaya dominan infrastruktur AI dan bahwa arsitektur yang berpusat pada memori akan menangkap bagian yang bertahan lama dari belanja tersebut.
Apa beda Corsair dengan GPU?
GPU membaca bobot model dari HBM untuk setiap token, dengan bandwidth paket sekitar 8 TB/s. Corsair mempertahankan bobot yang sering dipakai di SRAM on-chip dan melakukan komputasi di dalam larik memori, mencapai bandwidth on-chip 150 TB/s per kartu, menargetkan beban kerja decode batch kecil berlatensi rendah di mana GPU paling tidak efisien. Setiap kartu membawa Performance Memory SRAM 2 GB dan Capacity Memory LPDDR5 hingga 256 GB.
Apa itu 3DIMC dan Raptor?
3DIMC adalah evolusi bertumpuk 3D dari arsitektur dalam memori d-Matrix. Platform Raptor menempelkan die logika 4 nm secara face-to-face ke die DRAM kustom, memproyeksikan bandwidth lebih dari 100 TB/s dan memori 32 GB (256 Gb) per akselerator. Raptor ditargetkan tape-out pada akhir 2026, dengan ketersediaan rak direncanakan pada kuartal keempat 2027, termasuk integrasi ke rak NVLink Fusion dari NVIDIA.
Catatan: angka kinerja dan efisiensi (interaktivitas 10 kali, kinerja per TCO 3 kali, efisiensi energi 3–5 kali, 150 TB/s) adalah angka yang dilaporkan perusahaan pada tanggal yang dikutip dalam teks. Valuasi US$2 miliar adalah angka post-money yang dilaporkan dalam pengumuman Seri C November 2025.
📩 Berlangganan VLSI Korea
Dapatkan analisis semikonduktor harian kami lebih dulu di email Anda. Berlangganan gratis.


