 VLSI Korea
Analisis Mendalam CPU NVIDIA Vera: Mengapa Lebar Pita Memori 1,2 TB/s Lebih Penting daripada 88 Core
Vera menawarkan 1,5 TB LPDDR5X SOCAMM2 dan 1,2 TB/s per soket, sekitar 13,6 GB/s per core. Perbandingan lengkap dengan Grace dan EPYC Turin, batas klaim vendor, dan persaingan SOCAMM2.


Analisis Mendalam CPU NVIDIA Vera: Mengapa Lebar Pita Memori 1,2 TB/s Lebih Penting daripada 88 Core
TL;DR
- NVIDIA Vera adalah CPU pusat data dengan 88 core Olympus kustom yang kompatibel dengan Armv9.2-A, pertama kali diperkenalkan bersama platform Vera Rubin di GTC pada Maret 2025, dengan rincian arsitektur yang diungkapkan pada Juli 2026 (pengungkapan arsitektur NVIDIA, Juli 2026).
- Angka utamanya bukan jumlah core. Setiap soket Vera mendukung hingga 1,5 TB memori LPDDR5X SOCAMM2 dan hingga 1,2 TB/s lebar pita memori, sekitar 13,6 GB/s per core menurut pembagian sederhana (pengungkapan arsitektur NVIDIA, Juli 2026; perhitungan dari angka yang diungkapkan, 20 Oktober 2026).
- Lebar pita per core tersebut sekitar 1,8 kali angka CPU Grace sebelumnya dan sekitar 2,8 kali angka hasil perhitungan untuk flagship AMD EPYC Turin 128 core dengan DDR5-6400 12 kanal (perhitungan dari spesifikasi vendor, 20 Oktober 2026).
- NVIDIA mengklaim hingga 1,9 kali instruksi per siklus dibandingkan EPYC Turin pada beban kerja terkait AI, tetapi itu adalah klaim vendor, dan hasil benchmark mitra yang diterbitkan sejauh ini tidak mengungkapkan konfigurasi lengkap maupun pengaturan TDP (pengungkapan NVIDIA, Juli 2026).
- Pergeseran strategisnya adalah konten memori per soket: Vera membawa 3 kali kapasitas memori Grace per soket, yang mengubah soket CPU menjadi arena persaingan pasokan LPDDR5X antara Samsung Electronics, SK hynix, dan Micron (pengungkapan arsitektur NVIDIA, Juli 2026).
Background
Selama dua dekade, pemasaran CPU pusat data sebagian besar adalah perlombaan jumlah core. Lebih banyak core berarti lebih banyak mesin virtual, lebih banyak kontainer, dan lebih banyak thread per rak. Logika itu bekerja selama beban kerja serbaguna terutama dibatasi oleh throughput komputasi. Logika itu kurang bekerja di era AI agentik, di mana CPU dalam sistem AI bukan lagi host pasif untuk GPU. CPU mengatur panggilan tool, menyiapkan dan memindahkan data, menjalankan langkah retrieval dan ranking, menangani lalu lintas jaringan dan penyimpanan, serta memasok akselerator yang cepat terhenti ketika data terlambat tiba.
NVIDIA masuk ke pasar ini dengan Grace, CPU 72 core berbasis core Arm Neoverse V2, dengan hingga 480 GB LPDDR5X dan lebar pita memori 546 GB/s (spesifikasi NVIDIA Grace, diungkapkan sebelum pengungkapan Vera Juli 2026). Grace membuktikan bahwa CPU Arm dapat berada di pusat rak NVIDIA. Grace juga mengungkap kendala berikutnya: seiring sistem GPU menjadi lebih cepat, CPU host membutuhkan kapasitas memori lebih besar, lebar pita lebih besar per thread, dan tautan koheren yang lebih cepat ke GPU.
Vera adalah jawaban NVIDIA, diperkenalkan sebagai bagian dari platform Vera Rubin di GTC pada Maret 2025 dan dirinci dalam pengungkapan arsitektur pada Juli 2026 (GTC, Maret 2025; pengungkapan arsitektur NVIDIA, Juli 2026). Vera menggantikan desain Neoverse berlisensi dengan 88 core Olympus kustom. NVIDIA melaporkan Spatial Multithreading yang mengekspos 176 thread, die komputasi monolitik, cache L2 2 MB per core, cache L3 164 MB, dan Scalable Coherency Fabric generasi kedua (pengungkapan arsitektur NVIDIA, Juli 2026).
Angka platform di sekitar core sama pentingnya. Vera menyediakan NVLink-C2C 1,8 TB/s untuk komunikasi koheren CPU ke GPU, PCIe Gen6, dan CXL 3.1, dengan rentang TDP yang dapat dikonfigurasi 250 hingga 450 W (pengungkapan arsitektur NVIDIA, Juli 2026). Dua CPU Vera membentuk Superchip dengan 176 core, 352 thread, 16 modul SOCAMM2, lebar pita memori agregat 2,4 TB/s, dan kapasitas memori 3 TB. Desain referensi skala rak dengan 128 Superchip mencapai 22.528 core dan 384 TB memori (pengungkapan arsitektur NVIDIA, Juli 2026). Penjualan CPU mandiri dan pengiriman awal ke pelanggan dilaporkan selama 2026, sehingga klaim ketersediaan dalam artikel ini dinyatakan berdasarkan laporan, bukan sebagai konfirmasi pengiriman langsung dari NVIDIA (pelaporan industri, 2026).
Deep Dive 1: Sistem Memori — 1,5 TB dan 1,2 TB/s per Soket
Pilihan yang menentukan Vera adalah sistem memorinya. Setiap soket mendukung hingga 1,5 TB LPDDR5X SOCAMM2 pada kecepatan hingga 9.600 MT/s, memberikan hingga 1,2 TB/s lebar pita memori (pengungkapan arsitektur NVIDIA, Juli 2026). SOCAMM2 adalah standar modul LPDDR bersoket yang dipelopori NVIDIA. Berbeda dengan LPDDR yang disolder, modul bersoket dapat dikonfigurasi, diservis, dan diskalakan menurut desain sistem, sambil mempertahankan keunggulan efisiensi daya LPDDR5X dibandingkan memori server DDR5 konvensional.
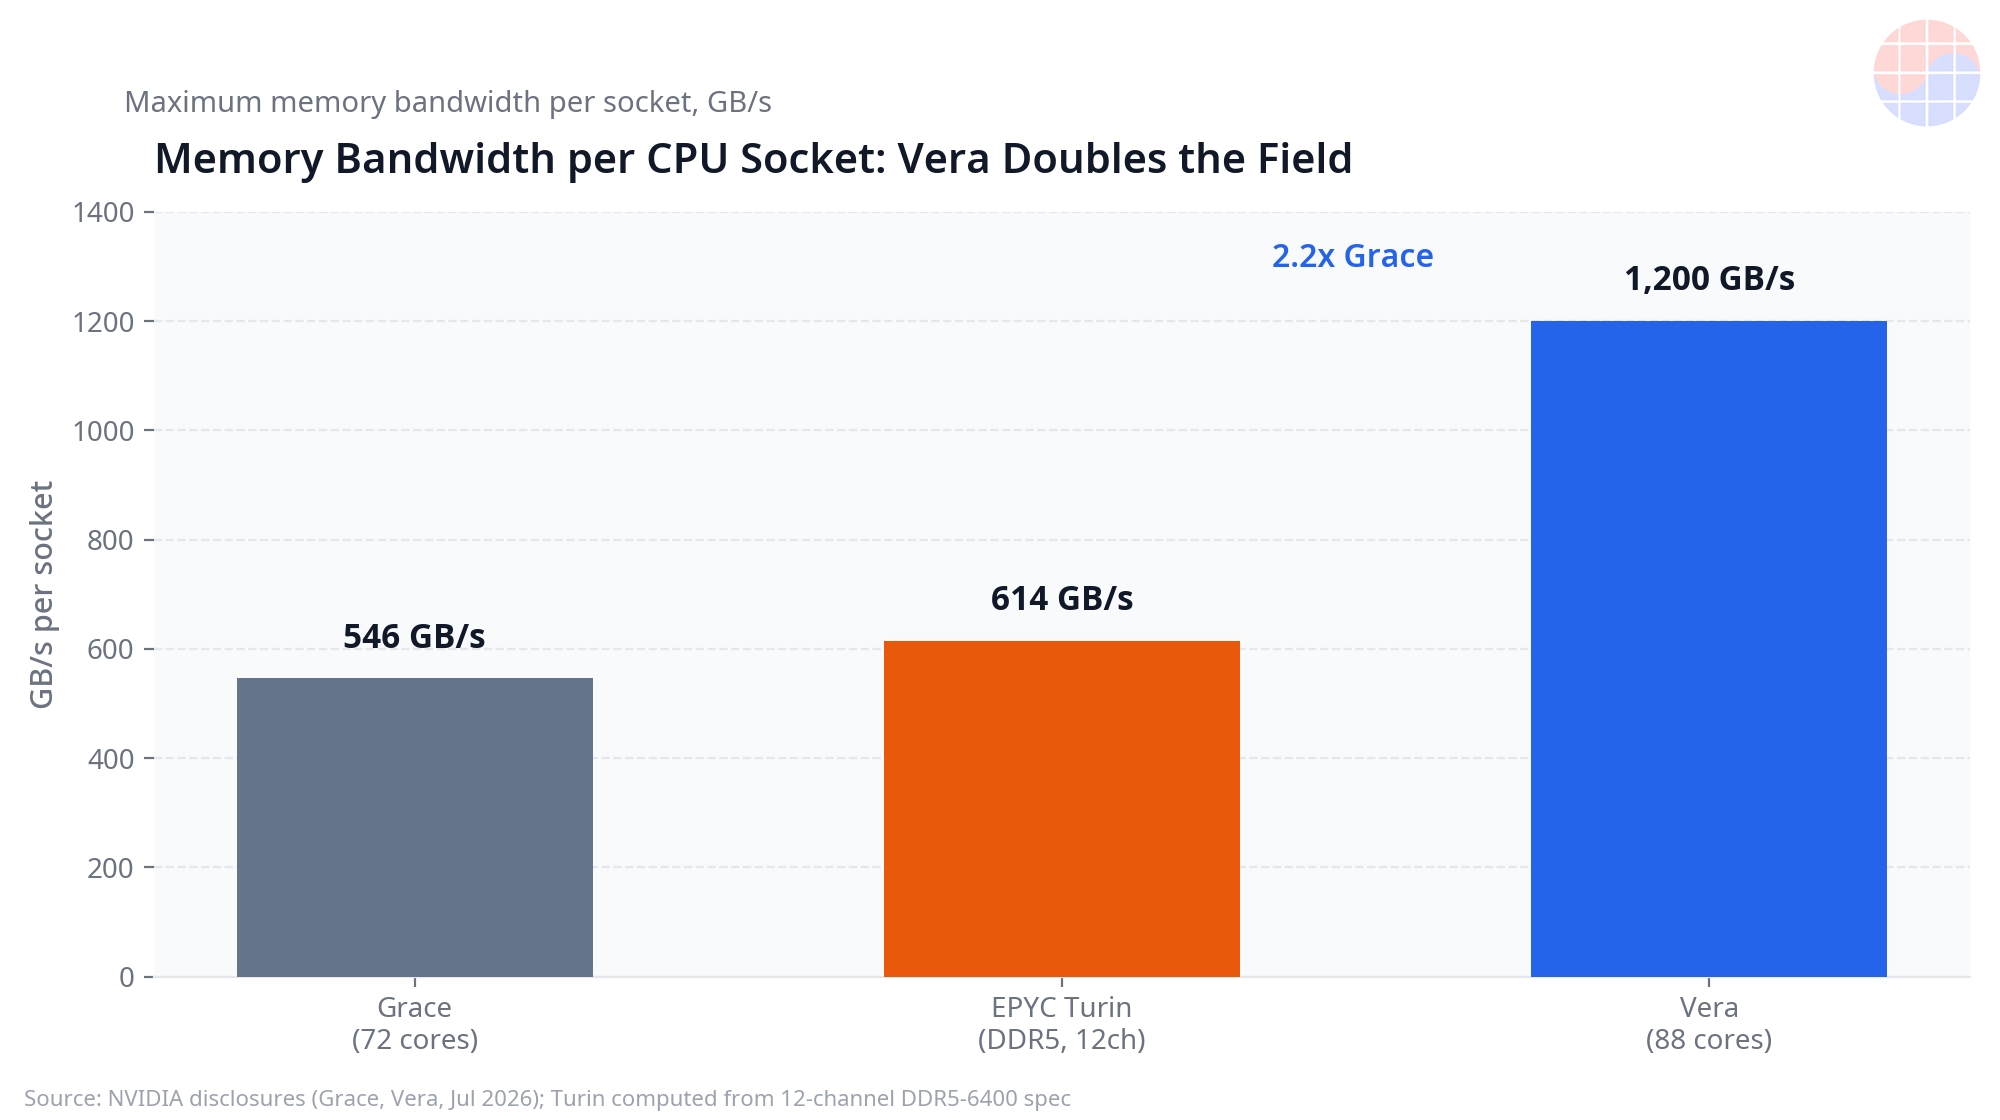
Perbandingan dengan Grace menunjukkan seberapa jauh desain ini bergerak dalam satu generasi. Grace menawarkan hingga 480 GB LPDDR5X dan lebar pita 546 GB/s per soket (spesifikasi NVIDIA Grace). Vera melipatgandakan kapasitas menjadi 1,5 TB dan menaikkan lebar pita menjadi 1.200 GB/s, kenaikan 2,2 kali (pengungkapan arsitektur NVIDIA, Juli 2026; perhitungan, 20 Oktober 2026). Dalam praktiknya, soket Vera dapat menyimpan working set yang lebih besar di memori lokal: cache key-value yang lebih besar, tabel embedding yang lebih besar, lebih banyak sesi agen bersamaan, dan lebih banyak data yang disiapkan untuk konsumsi GPU tanpa kembali ke penyimpanan yang lebih lambat atau memori jarak jauh.
Kapasitas dan lebar pita harus naik bersama. Kapasitas tanpa lebar pita membuat core menunggu di jalur memori yang padat. Lebar pita tanpa kapasitas memaksa eviction dan refetch yang sering. Titik desain Vera — 1,5 TB pada 1,2 TB/s — ditujukan untuk beban kerja di mana banyak thread menyentuh kumpulan data besar yang berubah-ubah pada saat yang sama. Profil itu menggambarkan pipeline retrieval, feature serving, prapemrosesan pencarian vektor, pemuatan data, dan logika kontrol di sekitar inferensi model besar jauh lebih baik daripada benchmark integer tradisional.
Ada juga konsekuensi rantai pasok. Standar modul LPDDR5X bersoket menciptakan unit konten memori yang terdefinisi dan dapat diganti yang dibeli pembuat sistem dalam volume besar. Ketika satu soket membawa 1,5 TB bukan 480 GB, setiap sistem Vera melipatgandakan konten LPDDR5X yang terkait dengan CPU, sebelum HBM apa pun yang terkait dengan GPU dihitung. Bagian 4 membahas apa artinya ini bagi Samsung Electronics, SK hynix, dan Micron.
Deep Dive 2: Lebar Pita per Core dan Perbandingan x86
Jumlah core menyesatkan ketika lebar pita memori tidak mengimbanginya. Membagi lebar pita soket dengan jumlah core memberikan ukuran kasar tetapi berguna tentang seberapa besar throughput memori yang dapat ditarik setiap core ketika semua core sibuk. Untuk Vera, 1.200 GB/s dibagi 88 core adalah sekitar 13,6 GB/s per core, yang dibulatkan NVIDIA menjadi sekitar 14 GB/s per core (pengungkapan arsitektur NVIDIA, Juli 2026; perhitungan, 20 Oktober 2026). Untuk Grace, 546 GB/s dibagi 72 core adalah sekitar 7,6 GB/s per core.
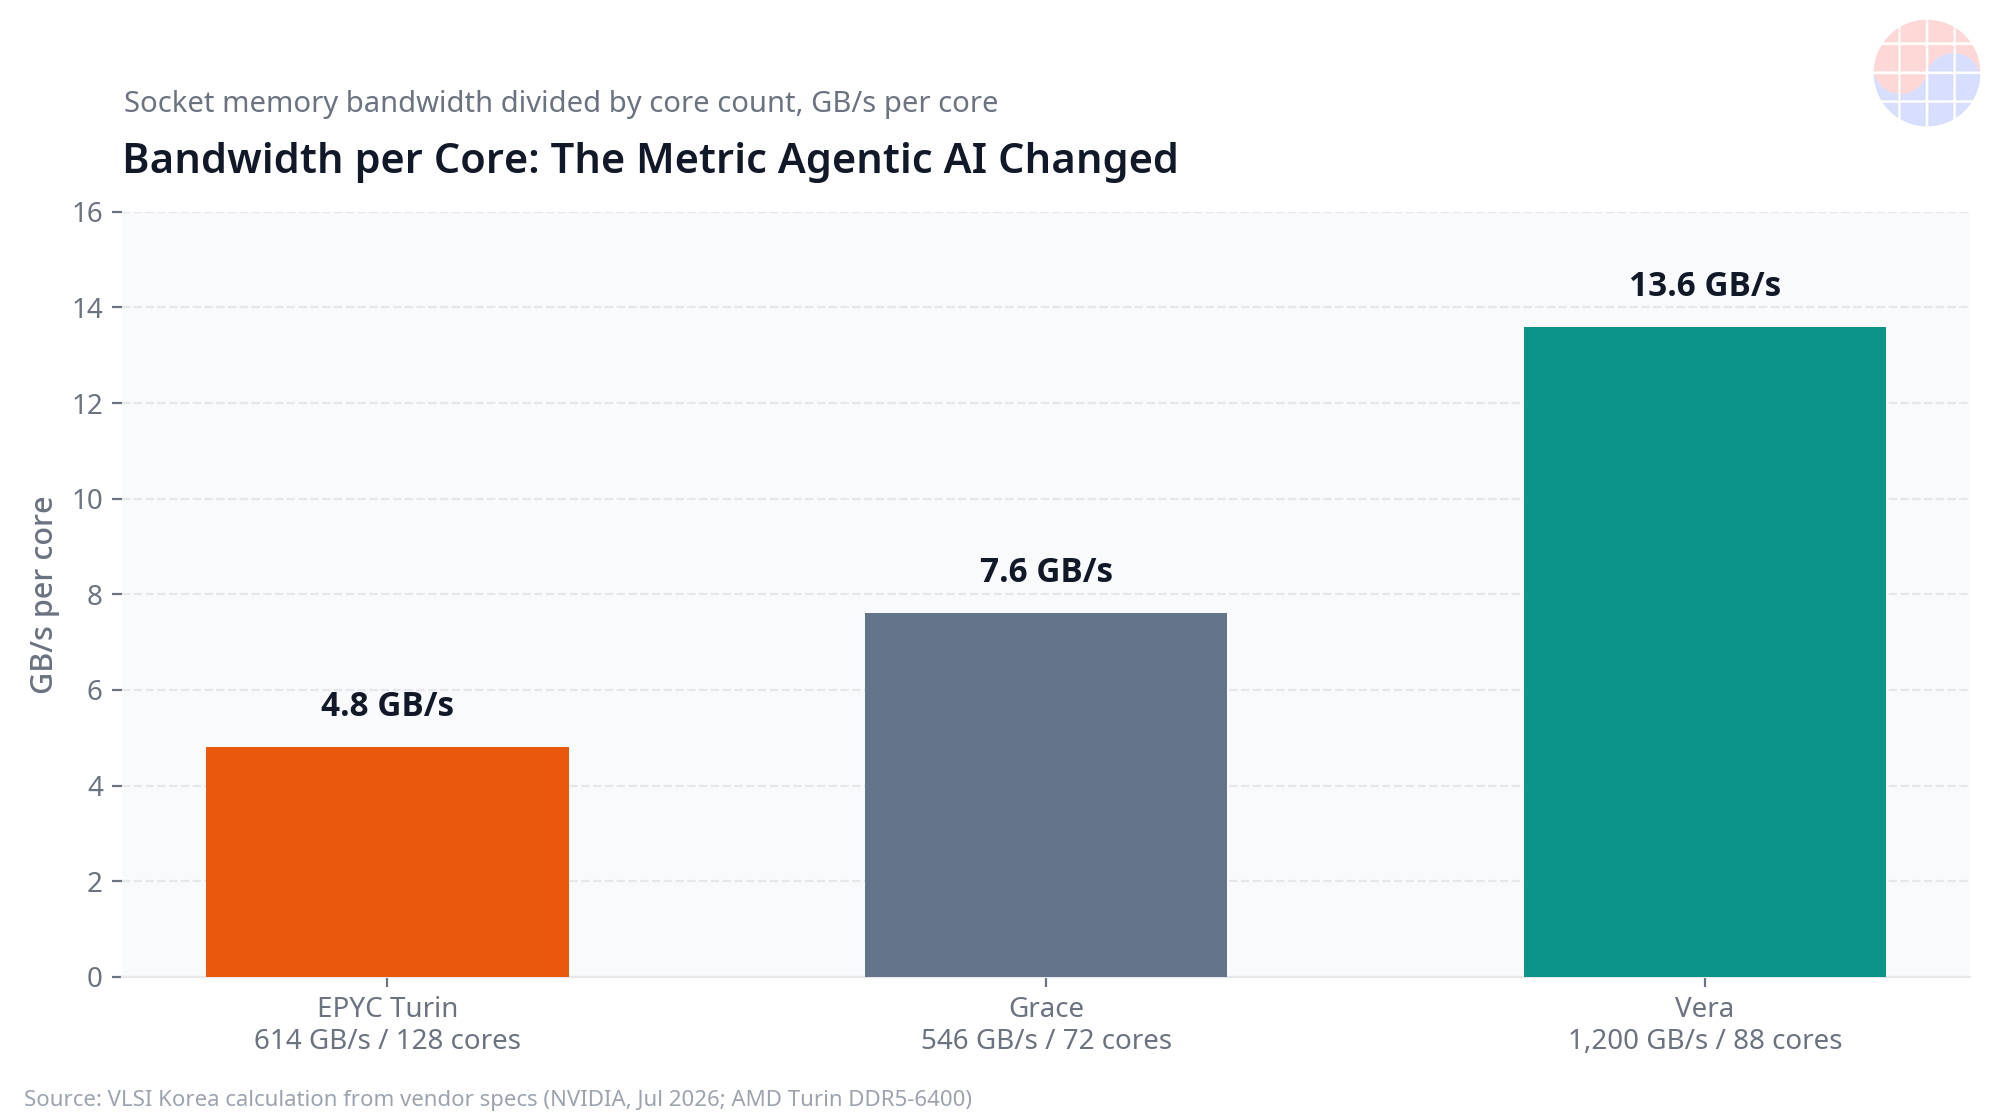
Perbandingan x86 memerlukan metode yang transparan. Sistem AMD EPYC Turin dengan 12 kanal DDR5-6400 memiliki puncak teoretis 614 GB/s, dihitung sebagai 12 kanal dikalikan 6.400 MT/s dikalikan 8 byte per transfer (perhitungan dari spesifikasi memori AMD EPYC Turin, 20 Oktober 2026). Tersebar di konfigurasi flagship 128 core, itu adalah sekitar 4,8 GB/s per core. Lebar pita berkelanjutan nyata lebih rendah daripada puncak teoretis untuk setiap platform dalam perbandingan ini, sehingga angka-angka tersebut harus dibaca sebagai rasio berbasis spesifikasi, bukan sebagai hasil aplikasi yang diukur.
Berdasarkan itu, Vera menawarkan sekitar 2,8 kali lebar pita per core dari konfigurasi Turin dan sekitar 1,8 kali dari Grace (perhitungan, 20 Oktober 2026). Ini adalah bagian terkuat dari argumen NVIDIA. Beban kerja agentik dan padat data sering menjalankan banyak thread yang masing-masing mengalirkan, menyaring, atau mengubah data. Ketika lebar pita per core rendah, menambah core berhenti membantu karena core berbagi pipa memori yang tetap. Ketika lebar pita per core tinggi, penskalaan thread bertahan lebih lama.
NVIDIA juga mengklaim hingga 1,9 kali instruksi per siklus dibandingkan EPYC Turin pada beban kerja terkait AI (klaim vendor, pengungkapan NVIDIA, Juli 2026). Klaim itu harus diperlakukan dengan hati-hati. Instruksi per siklus sangat bergantung pada beban kerja, kompiler, dan campuran instruksi, dan core Arm kustom serta core x86 tidak mengeksekusi aliran instruksi yang identik. Klaim itu menandakan maksud desain NVIDIA — core yang lebih lebar dan lebih efisien yang diberi lebar pita lebih besar — tetapi bukan pengukuran independen, dan pembeli harus menunggu benchmark yang dapat direproduksi dengan konfigurasi yang diungkapkan sebelum menggunakannya dalam keputusan pengadaan.
Deep Dive 3: Core Olympus, Koherensi, dan Superchip
88 core Olympus Vera adalah desain kustom yang kompatibel dengan Armv9.2-A, satu langkah melampaui core Neoverse V2 berlisensi milik Grace (pengungkapan arsitektur NVIDIA, Juli 2026). Memiliki desain core memungkinkan NVIDIA menyesuaikan throughput vektor, perilaku branch, dan hierarki cache untuk beban kerja yang benar-benar dijalankan sistem raknya. Setiap core membawa cache L2 2 MB, dan chip menyediakan cache L3 164 MB, angka yang penting karena cache besar mengurangi seberapa sering thread harus menunggu memori utama (pengungkapan arsitektur NVIDIA, Juli 2026).
Spatial Multithreading menggandakan jumlah thread yang diekspos menjadi 176 thread per soket (pengungkapan arsitektur NVIDIA, Juli 2026). Penggandaan thread hanya bermanfaat jika sistem memori dapat memasok thread tambahan, itulah sebabnya angka 1,2 TB/s dan jumlah thread harus dibaca sebagai satu keputusan desain, bukan dua spesifikasi terpisah.
Koherensi adalah pilar kedua. Scalable Coherency Fabric generasi kedua Vera dan NVLink-C2C 1,8 TB/s memungkinkan CPU dan GPU berbagi data secara koheren pada kecepatan jauh di atas tautan PCIe konvensional (pengungkapan arsitektur NVIDIA, Juli 2026). Vera juga mendukung PCIe Gen6 dan CXL 3.1, sehingga dapat memasang akselerator konvensional, adaptor jaringan, dan perangkat ekspansi memori (pengungkapan arsitektur NVIDIA, Juli 2026). Dalam rak AI, berbagi koheren mengurangi overhead penyalinan eksplisit: CPU dapat menyiapkan struktur data yang dikonsumsi GPU secara langsung, dan hasil antara dapat bergerak dengan lebih sedikit transfer yang dikelola perangkat lunak.
Konfigurasi Superchip menskalakan ide yang sama. Dua CPU Vera memberikan 176 core, 352 thread, lebar pita memori 2,4 TB/s, dan memori 3 TB di 16 modul SOCAMM2 (pengungkapan arsitektur NVIDIA, Juli 2026). Pada skala rak, total referensi 22.528 core dan 384 TB memori di 128 Superchip menunjukkan bahwa NVIDIA merancang lapisan CPU sebagai infrastruktur terpool untuk armada agen dan pipeline data, bukan sebagai pengasuh GPU minimal (pengungkapan arsitektur NVIDIA, Juli 2026).
Daya dapat dikonfigurasi antara TDP 250 W dan 450 W (pengungkapan arsitektur NVIDIA, Juli 2026). Rentang itu penting untuk menafsirkan benchmark apa pun: hasil pada 450 W dan hasil pada 250 W menggambarkan titik operasi yang berbeda, dan perbandingan yang tidak menyatakan pengaturannya tidak lengkap.
Deep Dive 4: Batas yang Jujur — Benchmark, Respons x86, dan Biaya Monolitik
Tiga batas layak mendapat perhatian langsung. Pertama, bukti benchmark publik tipis. Hasil mitra, termasuk hasil data streaming yang terkait dengan Redpanda, diterbitkan tanpa pengungkapan penuh konfigurasi dan pengaturan TDP (publikasi benchmark mitra, 2026). Tanpa jumlah core saat pengujian, populasi memori, firmware, dan pengaturan daya, pembaca luar tidak dapat mereproduksi angka atau menilai apakah perbandingannya adil. Klaim NVIDIA hingga 1,9 kali IPC memiliki status yang sama: itu adalah klaim vendor sampai pengujian independen dengan metode yang diungkapkan mengonfirmasinya (pengungkapan NVIDIA, Juli 2026).
Kedua, vendor x86 tidak tinggal diam. Platform server bergerak menuju DDR5 yang lebih cepat, memori MRDIMM yang menaikkan lebar pita efektif per kanal, dan generasi baru dengan lebih banyak kanal memori. MRDIMM dan platform x86 generasi berikutnya akan mempersempit kesenjangan lebar pita per core dari garis dasar spesifikasi 614 GB/s yang digunakan di atas, terutama dalam konfigurasi yang menukar jumlah core dengan lebar pita. Keunggulan Vera nyata pada spesifikasi yang diungkapkan per 20 Oktober 2026, tetapi itu adalah keunggulan pada satu titik waktu, bukan kesenjangan struktural permanen.
Ketiga, die komputasi monolitik Vera memiliki profil biaya. Die monolitik besar umumnya menghadapi ekonomi yield yang lebih sulit daripada desain chiplet yang dapat membuang hanya die kecil yang cacat dan menggunakan kembali die yang diketahui baik di berbagai produk (prinsip umum manufaktur semikonduktor, dinyatakan 20 Oktober 2026). NVIDIA belum mengungkapkan angka yield atau biaya unit Vera, sehingga tidak ada klaim biaya spesifik yang dibuat di sini. Poinnya bersifat arah: pilihan desain yang membantu latensi dan koherensi juga memusatkan risiko manufaktur, dan harga akan mencerminkan hal itu.
Terakhir, perangkat lunak menentukan seberapa besar keunggulan perangkat keras yang bertahan saat bersentuhan dengan produksi. Kematangan ekosistem Arm dalam tooling perusahaan, observabilitas, dan middleware warisan telah membaik, tetapi upaya migrasi tetap merupakan biaya nyata bagi operator dengan aset x86 besar. Lebar pita memenangkan benchmark; total biaya kepemilikan memenangkan pesanan pembelian.
Chase's Take
Pergeseran penting bukanlah bahwa NVIDIA membangun CPU dengan 88 core. Pergeseran penting adalah ke mana bottleneck berpindah. Dalam sistem AI agentik, CPU menangani orkestrasi: loop perencanaan, pemanggilan tool, retrieval, manajemen memori untuk konteks panjang, dan pergerakan data antara penyimpanan, jaringan, dan GPU. Tugas-tugas itu kaya thread dan haus memori. Sumber daya pembatasnya biasanya bukan throughput floating-point puncak. Melainkan seberapa banyak data yang dapat dijangkau setiap thread, seberapa cepat, tanpa mengantre di belakang setiap thread lain. Vera dirancang di sekitar kenyataan itu — lebar pita per core dan kapasitas memori per soket terlebih dahulu, jumlah core kedua.
Dari perspektif bisnis, SOCAMM2 mungkin lebih penting daripada core Olympus. Dengan menetapkan modul LPDDR5X bersoket untuk soket CPU, NVIDIA mengubah memori host menjadi slot konten terstandarisasi bervolume tinggi. Vera membawa 1,5 TB per soket dibandingkan 480 GB Grace, tiga kali konten memori per soket (pengungkapan arsitektur NVIDIA, Juli 2026). Setiap rak yang mengadopsi Vera karenanya menarik jauh lebih banyak LPDDR5X melalui rantai pasok.
Itu menjadikan soket CPU arena persaingan konten memori. Samsung Electronics, SK hynix, dan Micron semuanya bersaing dalam pasokan LPDDR5X, dan kualifikasi untuk platform NVIDIA bervolume tinggi bernilai lebih dari satu kemenangan desain: kualifikasi itu mengunci volume, kekuatan harga, dan posisi dalam revisi modul berikutnya. Pemasok Korea memiliki kepentingan khusus di sini, karena kepemimpinan LPDDR secara historis merupakan kekuatan Korea, dan SOCAMM2 memberikan kekuatan itu saluran server baru di luar ponsel pintar. Kisah Vera, dibaca dari Seoul, sebagian adalah kisah CPU dan sebagian kisah tentang siapa yang menjual memori yang mengelilingi CPU.
Penilaian saya: nilai Vera berdasarkan lebar pita per core yang diberikan dalam beban kerja agen produksi nyata, bukan berdasarkan judul 88 core dan bukan berdasarkan pengaturan benchmark yang tidak diungkapkan. Jika pengujian independen mengonfirmasi sebagian besar saja dari keunggulan spesifikasi, tekanan pada roadmap x86 — lebih banyak kanal, adopsi MRDIMM, jumlah core lebih rendah per tingkat lebar pita — akan menjadi tanda paling jelas bahwa Vera mengubah pasar.
Implications
- Untuk pembeli sistem AI: Nilai Vera berdasarkan lebar pita per core dan kapasitas memori per soket untuk beban kerja agen, retrieval, dan pemuatan data Anda sendiri, dan wajibkan TDP serta konfigurasi memori yang diungkapkan dalam setiap benchmark vendor (dasar: pengungkapan arsitektur NVIDIA, Juli 2026).
- Untuk perencanaan platform x86: Kesenjangan spesifikasi — sekitar 13,6 GB/s per core untuk Vera dibandingkan sekitar 4,8 GB/s per core untuk konfigurasi Turin 128 core dengan DDR5-6400 — menjadikan MRDIMM dan desain kanal lebih banyak sebagai prioritas roadmap, bukan pilihan (perhitungan, 20 Oktober 2026).
- Untuk pemasok memori: SOCAMM2 menaikkan konten LPDDR5X sisi CPU menjadi 1,5 TB per soket, tiga kali Grace, sehingga Samsung Electronics, SK hynix, dan Micron bersaing untuk soket yang lebih besar dan lebih strategis (pengungkapan arsitektur NVIDIA, Juli 2026).
- Untuk operator: Biaya migrasi, kesesuaian ekosistem perangkat lunak, dan harga die monolitik dapat mengimbangi sebagian keunggulan perangkat keras; pengujian total biaya kepemilikan lebih penting daripada klaim IPC utama.
- Untuk pasar CPU: Jika beban kerja agentik terus tumbuh, lebar pita per core menjadi kriteria pembelian tingkat pertama di samping jumlah core, dan pemasaran CPU yang mengedepankan core saja akan cepat usang.
Artikel ini didasarkan pada pengungkapan NVIDIA tertanggal Maret 2025 dan Juli 2026 serta perhitungan spesifikasi tertanggal 20 Oktober 2026; klaim kinerja vendor diberi label demikian dan belum diverifikasi secara independen.
FAQ
Q1. Apa itu CPU NVIDIA Vera dan kapan diungkapkan? Vera adalah CPU pusat data NVIDIA dengan 88 core Olympus kustom yang kompatibel dengan Armv9.2-A dan 176 thread melalui Spatial Multithreading. CPU ini diperkenalkan bersama platform Vera Rubin di GTC pada Maret 2025, dan NVIDIA menerbitkan pengungkapan arsitektur terperinci pada Juli 2026.
Q2. Berapa lebar pita dan kapasitas memori yang disediakan Vera per soket? Setiap soket Vera mendukung hingga 1,5 TB LPDDR5X SOCAMM2 hingga 9.600 MT/s dan hingga 1,2 TB/s lebar pita memori, yang setara sekitar 13,6 GB/s per core di 88 core (pengungkapan arsitektur NVIDIA, Juli 2026).
Q3. Bagaimana perbandingan Vera dengan Grace dan AMD EPYC Turin dalam lebar pita per core? Grace menyediakan 546 GB/s di 72 core, atau sekitar 7,6 GB/s per core. Konfigurasi EPYC Turin 128 core dengan DDR5-6400 12 kanal memiliki teoretis 614 GB/s, atau sekitar 4,8 GB/s per core. Sekitar 13,6 GB/s per core Vera adalah sekitar 1,8 kali Grace dan sekitar 2,8 kali konfigurasi Turin tersebut, berdasarkan spesifikasi (perhitungan, 20 Oktober 2026).
Q4. Apa batas utama dan pertanyaan terbuka untuk Vera? Klaim NVIDIA hingga 1,9 kali IPC dibandingkan Turin adalah klaim vendor, benchmark mitra seperti hasil Redpanda tidak mengungkapkan konfigurasi lengkap atau pengaturan TDP, platform x86 merespons dengan MRDIMM dan desain memori generasi berikutnya, dan die monolitik Vera mungkin memiliki biaya manufaktur lebih tinggi daripada alternatif chiplet. Benchmark independen dengan metode yang diungkapkan masih diperlukan (status per 20 Oktober 2026).
📩 Berlangganan VLSI Korea
Dapatkan analisis semikonduktor harian kami lebih dulu di email Anda. Berlangganan gratis.


