 VLSI Korea
Microsoft Maia 300発表:100万個の自社AIチップが変える半導体ビジネス
Microsoftが第3世代の自社AIチップ「Maia 300」を発表し、2027年に100万個以上の投入を計画。世界最大のGPU購入者がGPUの競合へと転じる。新たな主戦場はFLOPSではなくトークン経済だ。


2026年10月に最も重要なチップ発表は、より高速なアクセラレータの話ではない。誰がチップ会社になれるのか、という話だ。2026年10月12日、マイクロソフトは自社AIシリコンの第3世代「Maia 300」を発表し、2027年に100万個以上を投入して自社製品・サービスの主力推論システムにすると述べた(ロイター、2026年10月16日)。世界最大のAI GPUバイヤーは、事実上GPUの競合になりつつある——Maiaに移る推論クエリの一つ一つが、もはやNVIDIAを通らない売上になるのだ。
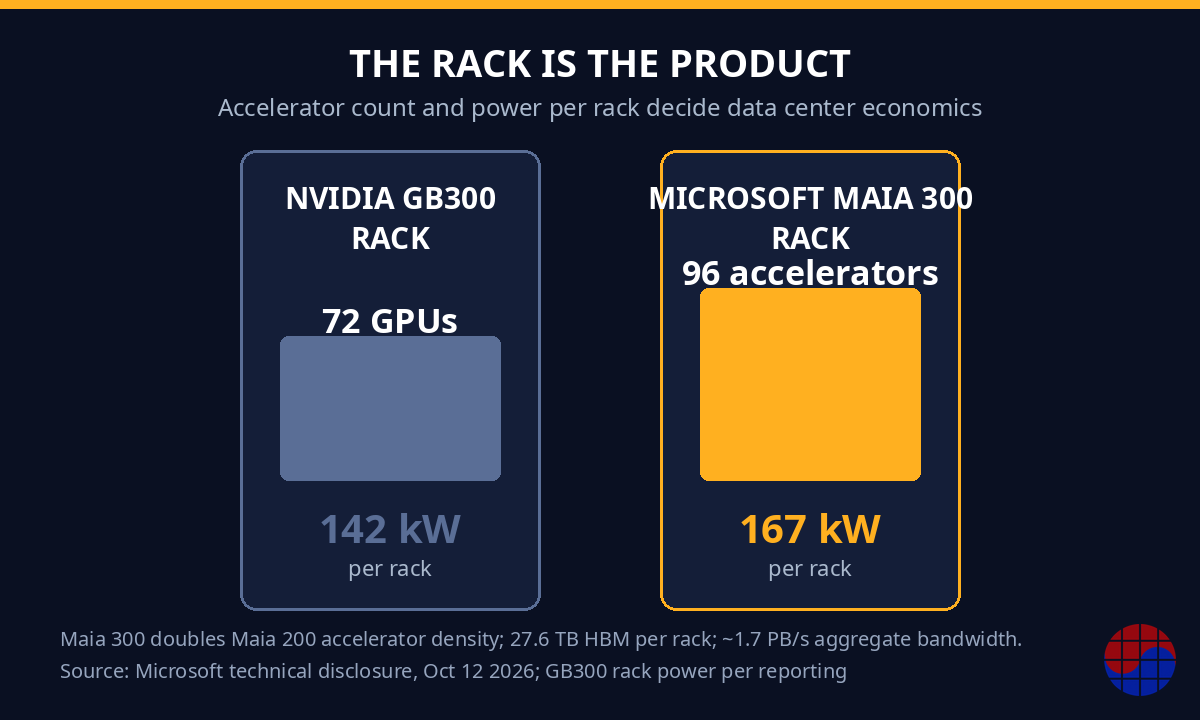
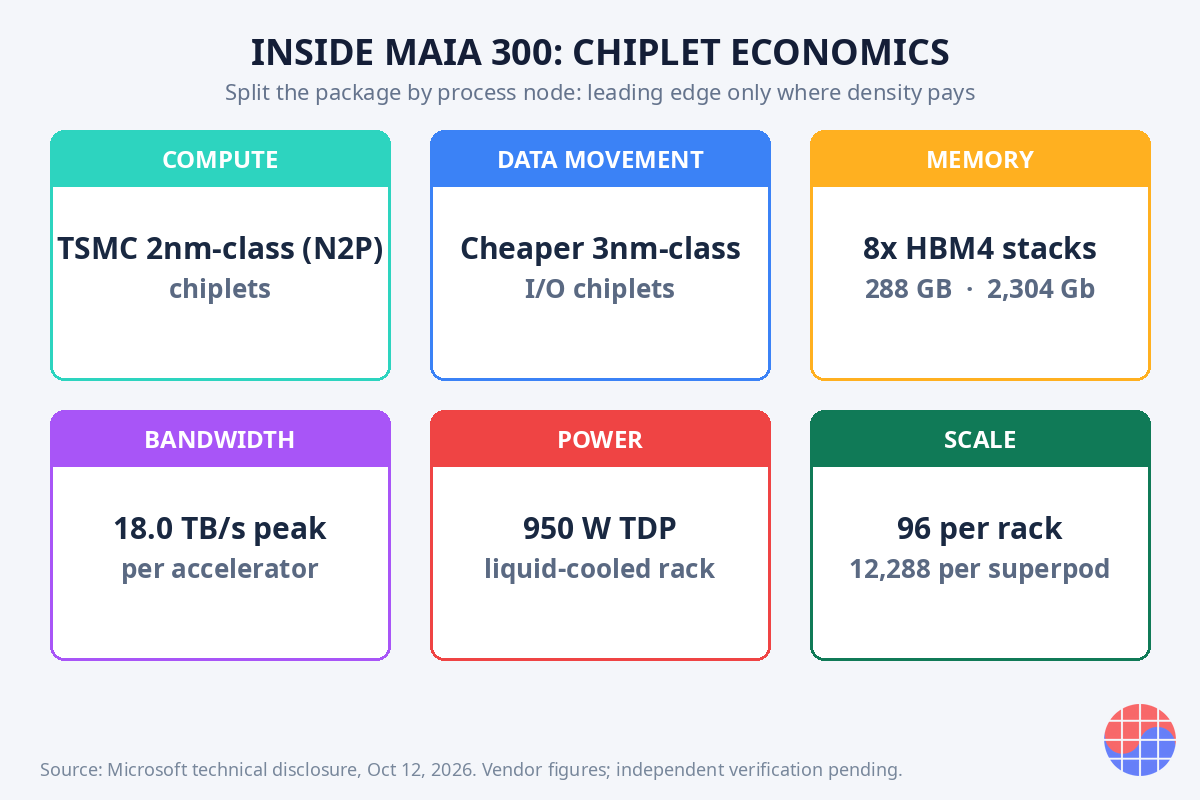
スペック自体も侮れない。TSMCの2ナノメートル級シリコン上のコンピュート・チップレット、8基のHBM4スタックによる288GBのメモリと18.0TB/sのピーク帯域幅、950Wのエンベロープに収め、96基のアクセラレータを約167kWのラックに組み上げる構成だ(マイクロソフト技術開示、2026年10月12日)。マイクロソフトは主要なGPUベースのシステムに比べてメガワット当たりのトークン数が約40%多く、ラック当たりのトークンスループットは前世代Maia 200の最大7倍だと主張する。しかしベンチマーク以上に大きなのは戦略の話だ。マイクロソフトはAIスタックで最もコストのかかる層——推論——を垂直統合し、その規模がファウンドリ、メモリメーカー、マーチャントチップベンダーすべての経済学を書き換えようとしている。
マイクロソフトが発表した内容
発表は2026年10月12日(月)、クラウド&AI担当エグゼクティブバイスプレジデントのスコット・ガスリー氏のブログ投稿を通じて行われた。サティア・ナデラCEOはこれをマイクロソフトの「自社シリコンに対するこれまでで最大の賭け」と呼び、2027年からMaiaファミリーをマルチギガワット規模に拡大し、自社製品・サービスの主力推論システムにすると述べた(マイクロソフト、2026年10月12日)。
記録に残る主要な約束は次の通りだ。
- Maia 300は推論特化。 学習用アクセラレータとは異なり、マイクロソフトが実際に収益を上げているワークロード向けに設計されている。コーディング支援、ロングコンテキスト推論、リアルタイムの対話型AI、マルチステップのエージェントタスクが対象だ。
- 2027年に本番導入開始、マルチギガワット規模へ拡大。ロイターは2027年に100万個以上のMaiaチップが投入される可能性があると報じた。
- Maia 200はすでに量産中。自社AIモデルとAzure上で提供されるOpenAIモデルを稼働させ、米国、欧州、オーストラリアに展開済みだ。Microsoft 365 Copilotは今日すでにその上で動いており、GitHub CopilotとMicrosoft Foundryは2026年末までに移行予定だ。
- Maia 200の公開済み効率指標:GPUベースの代替システム比でワット当たりトークン最大1.7倍——Maia 300のラックレベル7倍の主張はこのベースラインに対するものだ。
真面目な読者が押さえておくべき注意点が2つある。マイクロソフトの「メガワット当たりトークン40%改善」という主張は、比較対象の「主要なGPUベースのシステム」が明示されていないため、ベンダー主張であり独立したベンチマークではない。そしてマイクロソフトは今もNVIDIAのGPUを大規模に買い続けている——NVIDIAへの短期的影響は推論支出の構成の変化であり、一夜にしての置き換えではない。
数字で見るMaia 300
マイクロソフトの技術開示(2026年10月12日)によれば、Maia 300は機能ではなく経済学でダイを分割したマルチチップレット・パッケージだ。
| ブロック | 詳細 |
|---|---|
| コンピュート・チップレット | 主要な演算機能をTSMC 2nm世代(N2P)に |
| データ移動チップレット | プロセッサ外へのデータ移動用に安価な3nm世代シリコンを |
| メモリ | 8基のHBM4スタック、アクセラレータ当たり288GB(2,304Gb) |
| メモリ帯域幅 | ピーク18.0TB/s |
| 電力 | アクセラレータ当たり950W TDP |
| ラック | アクセラレータ96基、約167kW、ラック当たり27.6TBのHBM |
| ラック帯域幅 | 合計約1.7PB/sのメモリ帯域幅 |
| スケールアップ | 2層イーサネット・ファブリック、最大128ラック=スーパーポッド当たり12,288基のアクセラレータ |
3つの数字はもう一度見る価値がある。チップ当たり288GBのHBM4は2,304Gbだ——100万個以上の投入計画は、2027年の導入分だけで800万基以上のHBM4スタック、約288ペタバイトのHBM4需要のシグナルになる。アクセラレータ当たり950WはフラッグシップのマーチャントGPUと同じ熱クラスであり、同じ液冷・電源供給サプライチェーンを使うことを意味する。そしてラック当たり96基・167kWはMaia 200の2倍のアクセラレータ密度だ——競争の単位はもはやチップではなくラックなのだ。
スケールアップ・ファブリックこそ、静かに真実を物語る部分だ。Maia 300は2層イーサネット・ファブリックを使う——ラック内は電気リンク、ラック間は光リンクで、最大128ラックを束ねて12,288基のアクセラレータからなるスーパーポッドを構成し、帯域幅はジョブスケジューラが再配分し、ホットスペア容量は隣のラックから借り受ける。これはプロプライエタリなスケールアップ・インターコネクトに対する直接的なアーキテクチャの賭けだ。コモディティ標準のEthernetか、NVLink型の囲い込みか。Broadcom、マーベル、そしてEthernetエコシステムにとって、今年最も重要なdesign winである。
なぜ推論か、なぜ今か:トークン経済学
学習がヘッドラインをさらうが、稼ぐのは推論だ。Copilotのクエリ一つ、エージェントループの一周、ロングコンテキスト推論のセッション一つ一つが、マイクロソフト自身のコスト構造に請求される推論ワークロードだ。モデルサービングのコストが下がれば——トークン当たりの知能が安くなれば——、資金は大規模に最も安くトークンをサーブできる者に集まる。
Maia 300が最適化しているのはまさにその点だ。メガワット当たりトークン40%、そしてワット当たりの有効な仕事を増やすサブ3ビットと拡張MXFP4データフォーマット。マイクロソフトはピークFLOPSでNVIDIAに勝とうとしているのではない。自社のP&Lを決める指標——自社が所有するデータセンター内で、自社がコントロールするワークロードの——100万トークン当たりのサービングコストで勝とうとしている。
MBA的な論理を一行で言えばこうだ。需要(Copilot、Azure)と供給(Maiaシリコン、データセンター)の両方を握れば、垂直統合は変動費——他社のマージンが乗った他社のGPUを買うこと——を、減価償却する固定費資産に変える。100万個の計画は、推論を償却するという宣言なのだ。
エンジニアの読み:チップレットは歩留まりの問題だ
マーケティングを剥がせば、Maia 300のパッケージは先端ノード経済学の教科書的なレッスンだ——戦略資料ではなく、テープアウト現場で学ぶ種類の。
演算をTSMCの2nm世代N2Pに置き、メモリコントローラとI/O機能を安価な3nm世代ノードに残すのは、何よりも歩留まりとコストのプレーだ。最先端ノードは欠陥密度が最も痛く、ウェハー価格が最も刺さる場所だ。本当に密度が必要なロジックだけをそこに置き、残りは成熟した高歩留まりノードに置く。そしてパッケージの歩留まりを、巨大なモノリシックダイ一つに委ねるのではなく、known-good-die(KGD)の経済学で決める。それがチップレットの本質だ。
第二に、本当のサインオフの難所はHBM4インターフェースにある。18.0TB/sで8スタックなら、PHY、インターポーザ配線、メモリサブシステム周辺の電源インテグリティの作業が、ロジックのタイミングクロージャよりはるかに物理設計の工数を支配する。大規模SoCのSTAサインオフをやった者なら誰でも知っているパターンだ。ヘッドラインの数字は帯域幅だが、テープアウトのリスクはインターフェースに宿る。
第三に、ラックレベル・コデザインが新しいフロアプランだ。167kWラックの熱負荷の大半を担う液冷、950Wパッケージ、ラック間の光リンク——電源供給ネットワークと熱エンベロープが、RTLより先にアーキテクチャを制約する。ラックチームとコデザインしないチップチームは、データセンターに入らない部品を出荷することになる。
NVIDIAにとっての意味
NVIDIAへの短期的リスクは限定的だ。マイクロソフトは今もそのGPUを大規模に買い続けているし、学習——NVIDIAの牙城——は推論特化チップの射程外だ。だが方向性は紛れもない。Maiaに移行するCopilotクエリの一つ一つが、もはやNVIDIAのスタックを通らない推論売上だ。GPUも、それに付いたHBMも、ネットワーキングも通らない。
より構造的なのは、Maia 300が業界最大規模でEthernetスケールアップの道を正当化したことだ。12,288基規模で2層イーサネット・ファブリックが機能すれば、「フロンティア級クラスタはプロプライエタリなインターコネクトでしかまとめられない」という主張は弱まる——そしてインターコネクトのロックインはNVIDIAのプラットフォームの堀の柱の一つだ。
三つ目の効果は価格交渉力だ。まともな内製の選択肢があれば、すべての大口バイヤーのマーチャントベンダーとの交渉が変わる。マイクロソフトは、すべてのワークロードで最高のマーチャントGPUにMaiaで勝つ必要はない。自社のワークロードで「十分に良い」レベルに達すれば、残りの購入単価に上限をかけられるのだ。
メモリとファウンドリにとっての意味
メモリ: チップ当たり8基のHBM4スタック、100万個超のチップで、2027年には800万基超のHBM4スタックの増分需要シグナルだ——HBM4のクオリフィケーション獲得競争を繰り広げるSKハイニックス、サムスン、マイクロンのいずれにとっても。単位の規律にも注意したい。アクセラレータ当たり288GBは2,304Gbであり、ラックレベルの計算(ラック当たり27.6TB)こそデータセンターのプランナーが実際に買う単位だ。HBM4供給競争に最大の需要アンカーが打ち込まれた。
ファウンドリ: コンピュート・チップレットがTSMC N2Pということは、マイクロソフトがN2ファミリーの最初期の大規模顧客の一つになるということだ。携帯・HPCの常連と並んで。このボリュームでの早期N2P割り当ては、技術的な宣言であると同時にキャパシティ交渉でもあり、AI時代のファウンドリとしてのTSMCのリードをさらに深める。
内製シリコンのクラブは今や満員だ。 グーグルにはTPU、AWSにはTrainium、メタにはMTIAがあり、OpenAIも独自チップを進めている。Maia 300の100万個計画は、その中で最大の単一導入コミットメントだ——垂直シリコンが実験から調達戦略に移ったシグナルである。
今後の注目点
- 独立したベンチマーク。 マイクロソフトの「メガワット当たりトークン40%」の主張は比較対象のGPUベースラインを明示していない。電力境界を定義した実ワークロードでの第三者測定に注目だ。
- HBM4供給。 メモリが逼迫する中で2027年向けに800万基超のHBM4スタックを確保できるか——そして3社のうちどこがクオリフィケーションを勝ち取るか。
- 外部顧客。 マイクロソフトはMaiaが自社製品・サービス用だと言う。外部顧客がアクセスできるようになれば、Maiaはコスト削減策ではなくマーチャント競合になる。
- Ethernetの賭け。 12,288基規模で2層スケールアップ・ファブリックが持つか——その結果はすべてのネットワーキングベンダーのロードマップに響く。
結論はこうだ。Maia 300はチップのローンチではない。ダイの写真が付いた調達戦略だ。マイクロソフトはAIの損益計算書で最大の項目——推論コンピュート——を自ら作ることに決めた。半導体業界へのメッセージは、顧客は今や競合でもあり、交渉はメガワット当たりトークンで行われる、ということだ。
よくある質問
Maia 300とは何ですか?
Maia 300はマイクロソフトの第3世代自社AIアクセラレータで、2026年10月12日に発表されました。コーディング支援、ロングコンテキスト推論、エージェントタスクなどの推論ワークロード向けに設計されています。TSMC 2nm世代シリコン上のチップレット・アーキテクチャを採用し、8基のHBM4スタック(288GB、18.0TB/s)を950Wのエンベロープに収め、96基のアクセラレータを搭載したラックで展開されます。
マイクロソフトはMaia 300を何個導入するのですか?
ロイターの報道(2026年10月16日)によれば、マイクロソフトは2027年に100万個を超えるMaiaチップを導入する計画です。Maiaファミリーをマルチギガワット規模に拡大し、自社製品・サービスの主力推論システムにするというもので、本番導入は2027年に始まります。
NVIDIAのGPUと比べてどうですか?
マイクロソフトは、名前の明示されていない「主要なGPUベースのシステム」に比べてメガワット当たりトークン数が約40%多く、前世代Maia 200比でラック当たりのトークンスループットが最大7倍だと主張していますが、いずれも独立した検証を待つベンダー主張です。アーキテクチャ的には、プロプライエタリなインターコネクトではなく2層イーサネット・スケールアップ・ファブリックに賭け、ピーク学習FLOPSではなく推論のコスト効率を狙っています。
HBMやファウンドリのサプライヤーにとっての意味は?
チップ当たり8基のHBM4スタック、100万個超のチップで、2027年の導入は800万基超のHBM4スタック(約288ペタバイト)の需要を意味します——SKハイニックス、サムスン、マイクロンのHBM4立ち上げにとって大きな需要アンカーです。TSMCのN2Pノード上のコンピュート・チップレットは、マイクロソフトをTSMC 2nm世代キャパシティの最初期の大規模顧客にします。
開示:本分析は、マイクロソフトの2026年10月12日の発表およびその後の報道(ロイター、2026年10月16日)に基づいています。性能数値はマイクロソフトの主張であり、独立した検証を受けていません。筆者は言及した企業のポジションを保有していません。数値は2026年10月17日時点の公開情報に基づきます。


