VLSI Korea
DAC 2026 545편 주제 지도: AI 159편, 그리고 진짜 뜨거웠던 7개 주제
DAC 2026의 545편을 먼저 전체 지도부터 본다. AI 159, Design 126, EDA 125편과 7개 중복 핫 토픽의 의미를 분리했다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
먼저 읽을 결론
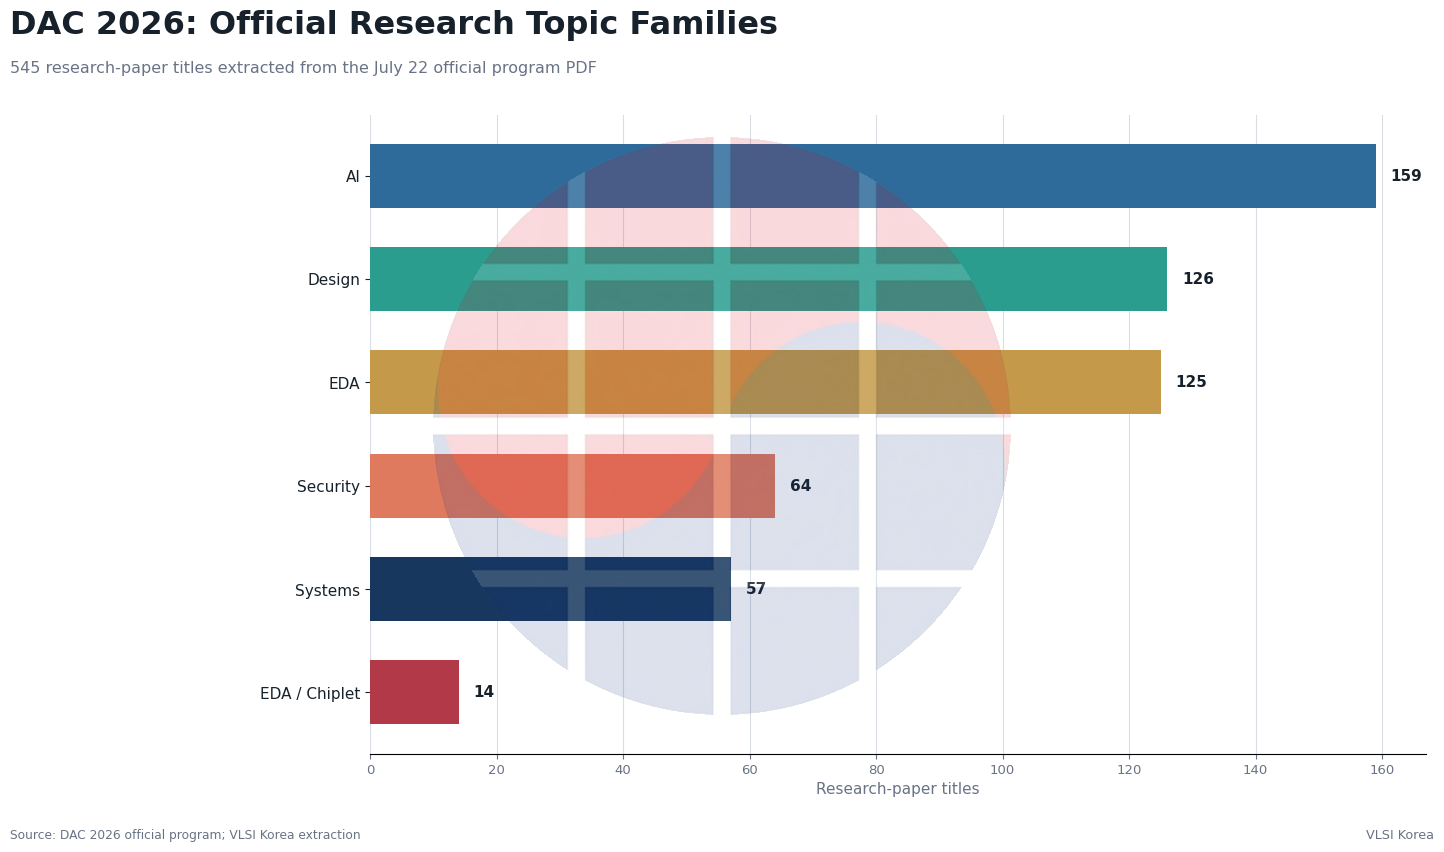
- 전체 지도: DAC 2026 공식 7월 22일 프로그램 PDF에서 research-paper title 545건을 추출했다. 공식 상위 분류는 AI 159, Design 126, EDA 125, Security 64, Systems 57, EDA/Chiplet 14건이다.
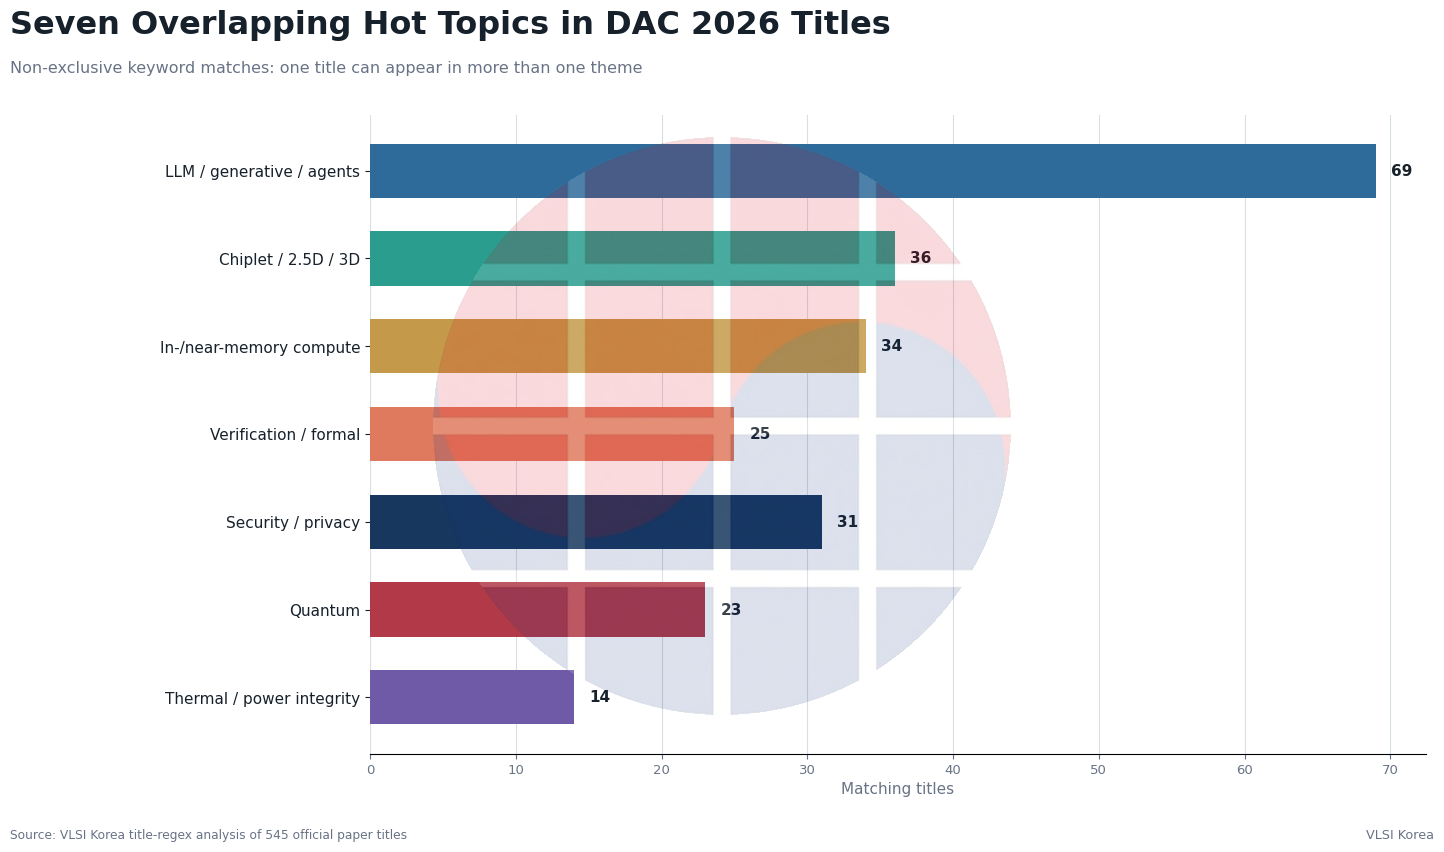
- 핫 토픽: 제목 검색식을 공개하고 중복을 허용하면 LLM·생성형 AI·agent 69, chiplet·2.5D·3D 36, in/near-memory 34, security/privacy 31, verification/formal 25, quantum 23, thermal/power integrity 14건이 잡힌다.
- 읽는 법: 공식 분류는 학회의 구성 비중, 중복 핫 토픽은 연구 관심의 방향을 보여준다. 둘을 섞어 하나의 점유율처럼 말하면 안 된다.
- 한국의 포인트: 메모리·패키징의 강점은 분명하지만, 실제 차별화는 data movement, thermal/SI/PI, KGD·repair·yield, 검증 가능한 자동화까지 함께 닫는 능력에서 나온다.
DAC 리뷰의 첫 질문은 “무슨 주장이 멋졌나”가 아니라 “무엇이 얼마나 많이 나왔나”여야 한다. 이번 글은 그래서 545개 논문 제목을 먼저 공식 topic family로 집계하고, 그 다음에만 VLSI Korea의 중복 허용 hot-topic 검색을 적용했다. 연구 논문, 기업 발표, booth demo는 서로 다른 증거다. 이 글은 그 층위를 합쳐서 과장하지 않는다.
1. 545편 전체에서 가장 큰 축은 AI, Design, EDA였다
공식 topic field를 한 편당 하나의 상위 family로 정규화하면 AI가 159편으로 가장 크다. Design 126편과 EDA 125편이 거의 같은 크기로 뒤를 잇는다. Security 64편과 Systems 57편도 독립적인 큰 축이며, “Chiplet, EDA, EDA1”로 표시된 14편은 EDA/Chiplet 교차군으로 보존했다. 합계는 정확히 545편이다.
이 숫자가 중요한 이유는 DAC 2026을 단순히 “AI 학회가 됐다”고 부르는 것을 막아주기 때문이다. AI는 최대 family지만 545편 전체의 29.2%다. Design과 EDA를 합치면 251편으로 더 크다. 즉 학회의 중심은 AI가 기존 설계 자동화를 대체한 것이 아니라, 아키텍처·설계·검증·물리 구현 위에 AI가 수평적으로 침투한 모습에 가깝다.
2. 세부 분류에서는 AI architecture, algorithm, system이 나란히 컸다
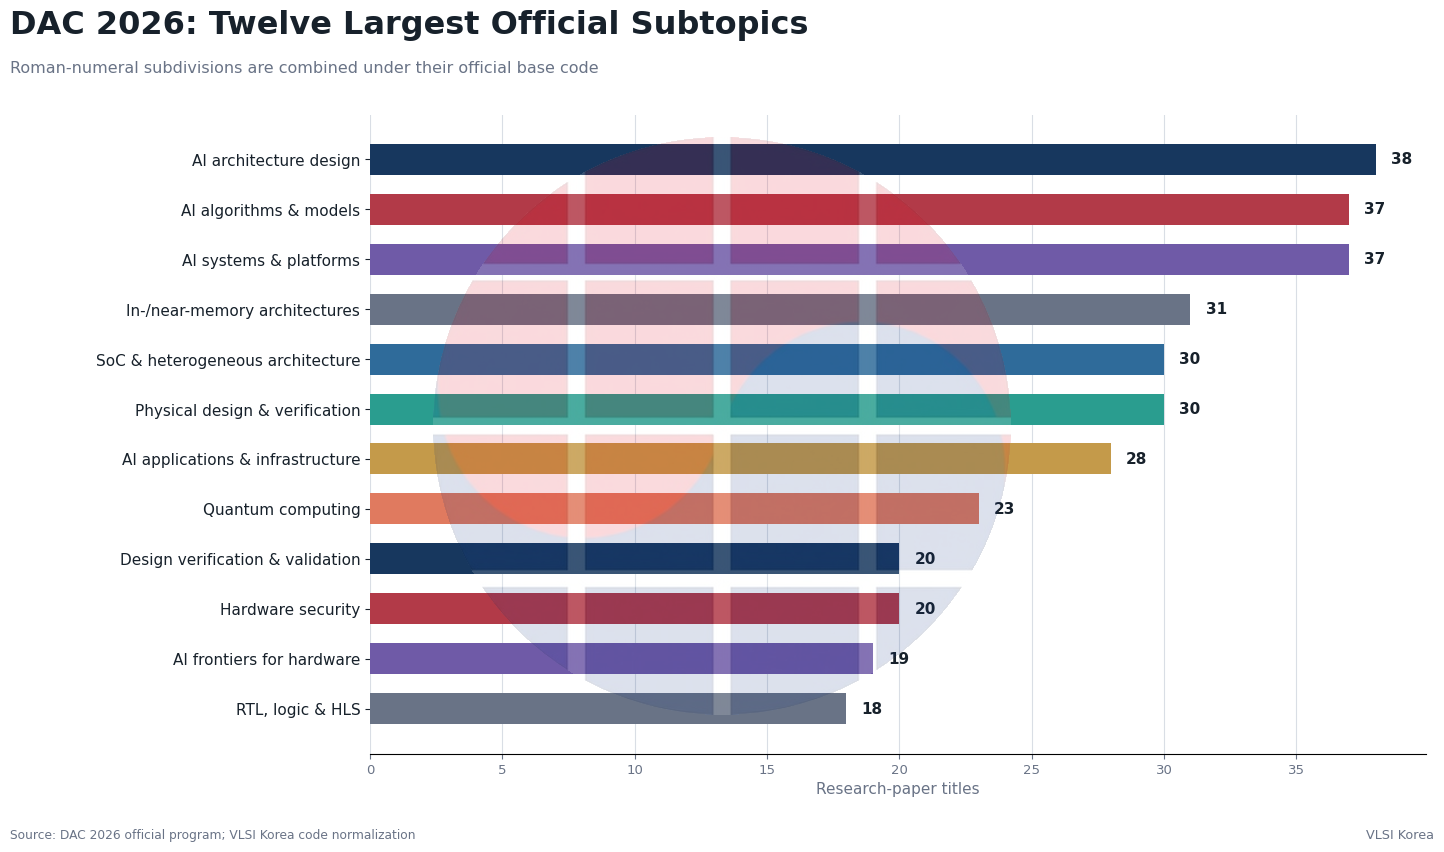
로마 숫자로 나뉜 동일 subtopic을 합치면 AI4 Architecture Design 38편, AI2 Algorithms and Models 37편, AI5 Systems and Platforms 37편이 상위 3개다. 바로 뒤에는 DES2B in/near-memory architecture 31편, DES1 SoC·heterogeneous·reconfigurable architecture 30편, EDA7 physical design and verification 30편이 있다. AI3 application and infrastructure는 28편, DES6 quantum computing은 23편이다.
이 분포는 “모델” 하나가 아니라 세 층이 동시에 움직인다는 뜻이다. 모델과 알고리즘, 이를 실행하는 가속기, 가속기를 시스템에 넣는 memory·package·network·runtime이 함께 연구 대상이 됐다. 반대로 verification 20편, RTL/HLS 18편, analog CAD 17편, DFM/reliability 14편이 유지되는 것은 실제 칩을 닫는 전통 EDA 문제가 사라지지 않았음을 보여준다.
3. 핫 토픽은 중복을 허용해야 제대로 보인다
한 논문은 동시에 LLM, verification, chiplet, thermal에 걸칠 수 있다. 따라서 hot-topic 집계는 배타적 sector가 아니라 제목 정규식의 중복 match로 만들었다. 545편 중 LLM·language model·generative·agentic 관련 표현은 69편, chiplet·2.5D·3D는 36편, in/near-memory·CIM·PIM은 34편이다. security/privacy 관련 제목은 31편, verification/formal은 25편, quantum은 23편, thermal/power-integrity는 14편이다.
이 수치는 “논문 품질 순위”도 “공식 DAC 통계”도 아니다. 제목에 어떤 문제의식이 반복됐는지를 보는 관심도 지표다. 표현이 제목에 없지만 본문에서 다루는 논문은 빠질 수 있고, 반대로 제목에 단어가 있어도 핵심 기여가 다를 수 있다. 그래서 다운로드 가능한 검색식과 match ledger를 함께 제공한다.
4. DAC의 AI는 AI-for-EDA, design-for-AI, infrastructure로 갈라서 봐야 한다
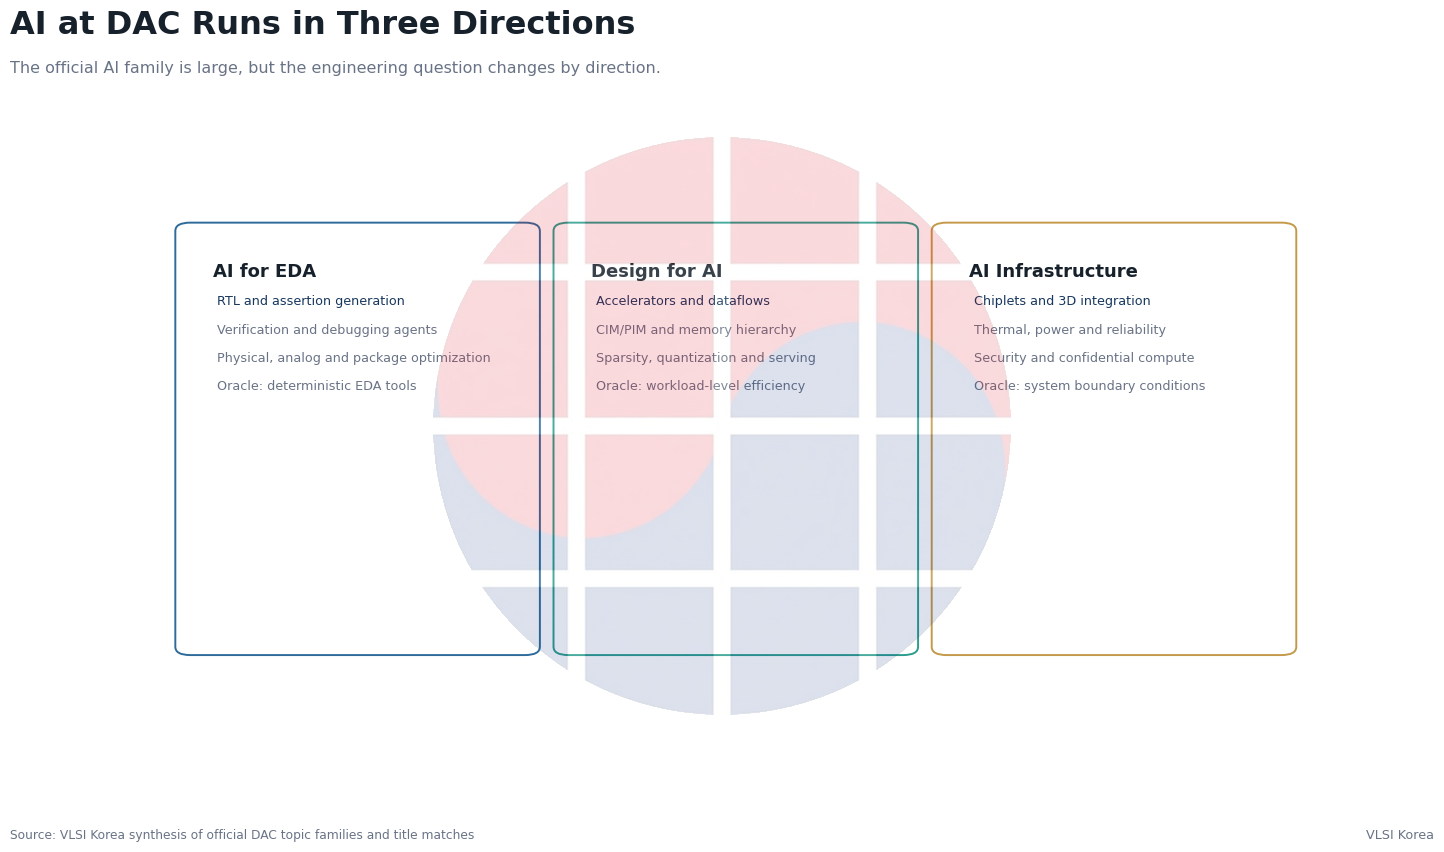
첫 방향은 AI-for-EDA다. Verilog·assertion 생성, UVM, debug, formal, physical design, analog sizing, package optimization에서 model이 다음 action을 제안한다. 이때 oracle은 언어 모델이 아니라 simulation, equivalence, formal, STA, extraction 같은 결정적 도구다. agent가 성공하려면 제약과 tool state를 보존하고 실패를 기록해야 한다.
둘째는 design-for-AI다. Fusedot, 여러 LLM inference accelerator, sparsity·quantization, CIM/PIM, serving system이 여기에 속한다. 셋째는 AI infrastructure다. chiplet·3D, thermal/PI, security, network와 package가 실제 usable throughput을 결정한다. peak TOPS만 비교하면 두 번째와 세 번째 층의 비용을 놓친다.
5. 대표 논문은 제목보다 ‘어떤 경계를 측정했는가’를 읽어야 한다
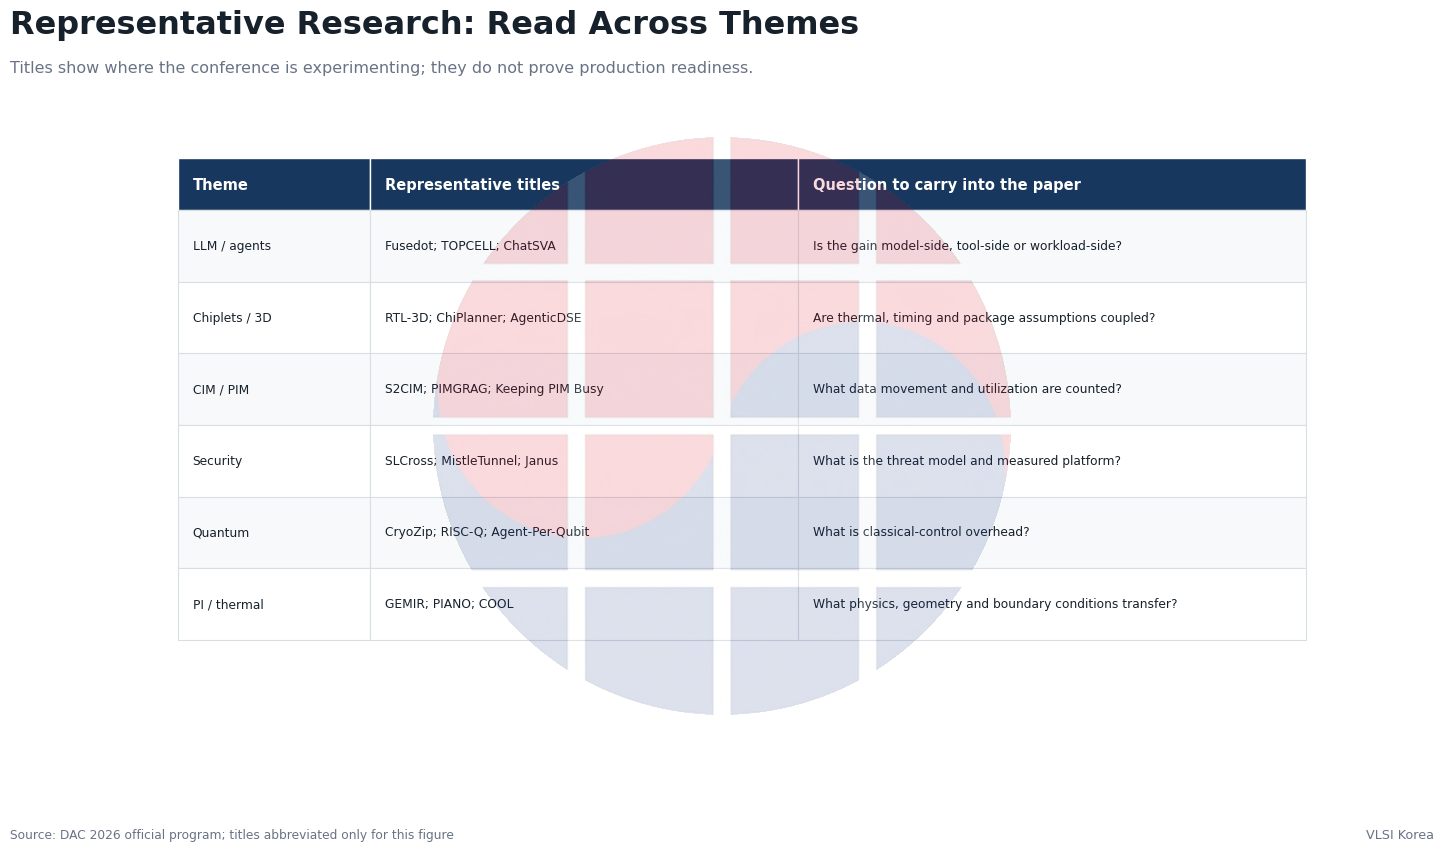
LLM 축에서는 Fusedot이 inference arithmetic을, TOPCELL이 standard-cell topology optimization을, ChatSVA와 UVMarvel이 verification artifact 생성을 다룬다. chiplet 축의 RTL-3D, ChiPlanner, AgenticDSE는 partition·placement·design-space exploration을 서로 다른 abstraction에서 접근한다. memory 축의 S2CIM, PIMGRAG, Keeping PIM Busy는 security, retrieval, execution overhead라는 서로 다른 병목을 잡는다.
Security에서는 SLCross와 MistleTunnel이 실제 Apple M-series의 cache/TLB 경계를 공격 대상으로 삼고, Janus는 compiler-based defense를 제시한다. Quantum에서는 CryoZip, RISC-Q, Agent-Per-Qubit이 오류 정정 data path, real-time control SoC, qubit placement를 연결한다. Thermal/PI에서는 GEMIR, PIANO, COOL이 빠른 surrogate와 physics-aware model의 정확도·전이 범위를 시험한다.
6. 공식 분류와 자체 핫 토픽을 한 표처럼 섞지 않았다
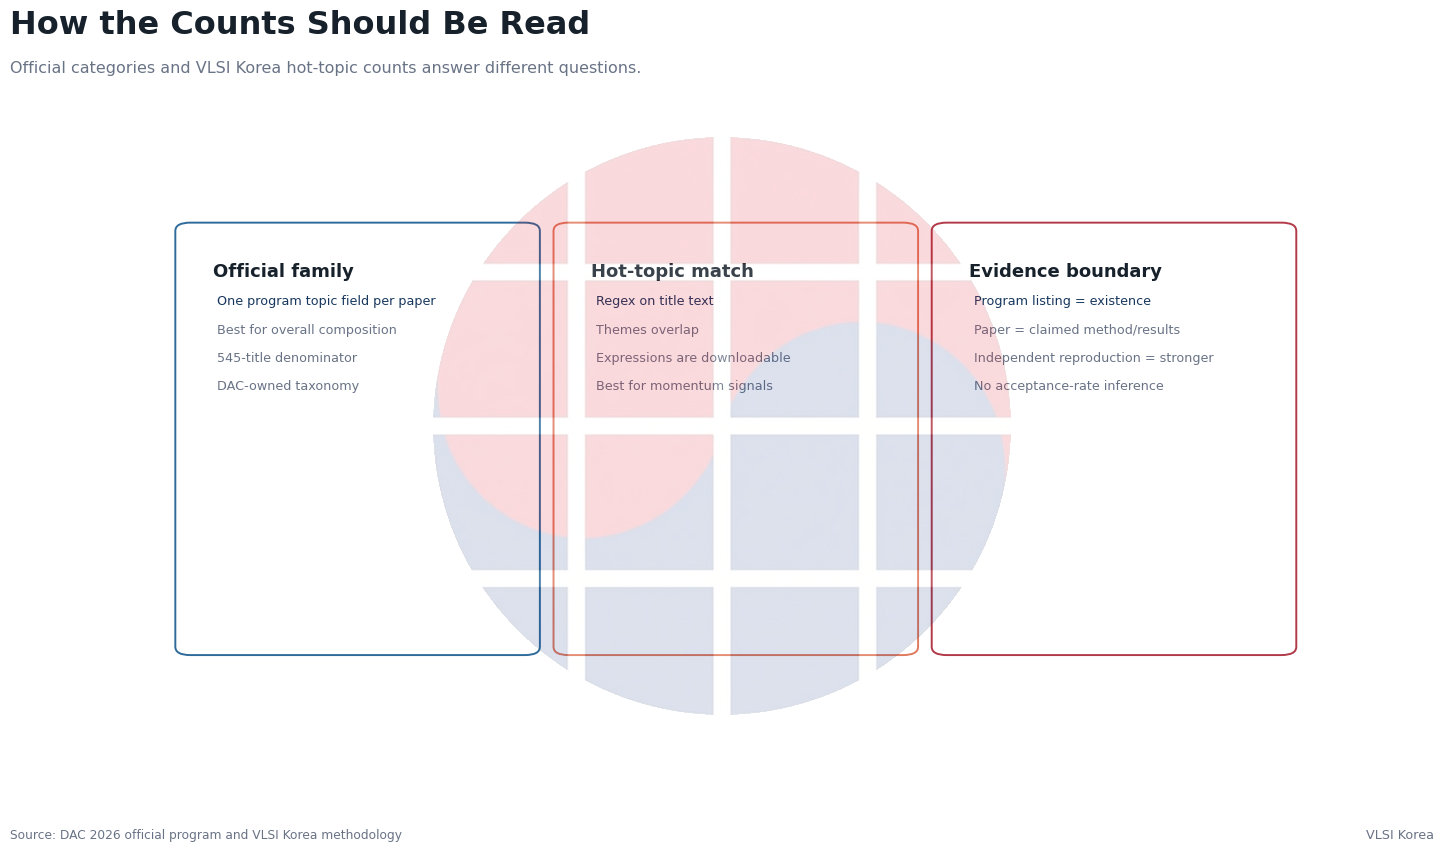
공식 family count는 프로그램이 부여한 topic field를 사용하고 각 논문을 한 번만 센다. hot-topic count는 제목에 정규식을 적용하며 중복을 허용한다. 대표 논문 선정은 각 theme의 mechanism 차이를 보여주는 예시다. 세 레이어의 목적과 분모가 다르다.
공식 accepted-paper ID 페이지에는 544개 ID가 있지만 7월 22일 프로그램 PDF에서 추출한 고유 research title은 545개다. 우리는 임의의 한 편을 삭제해 숫자를 맞추지 않았고, 이 차이로 acceptance rate를 계산하지 않았다. DAC 홈페이지가 쓰는 “AI & Design coverage” 문구도 날짜와 분류 정의가 다른 보도자료 수치와 직접 합치지 않았다.
7. 한국 기업과 엔지니어가 볼 것은 memory와 package만이 아니다
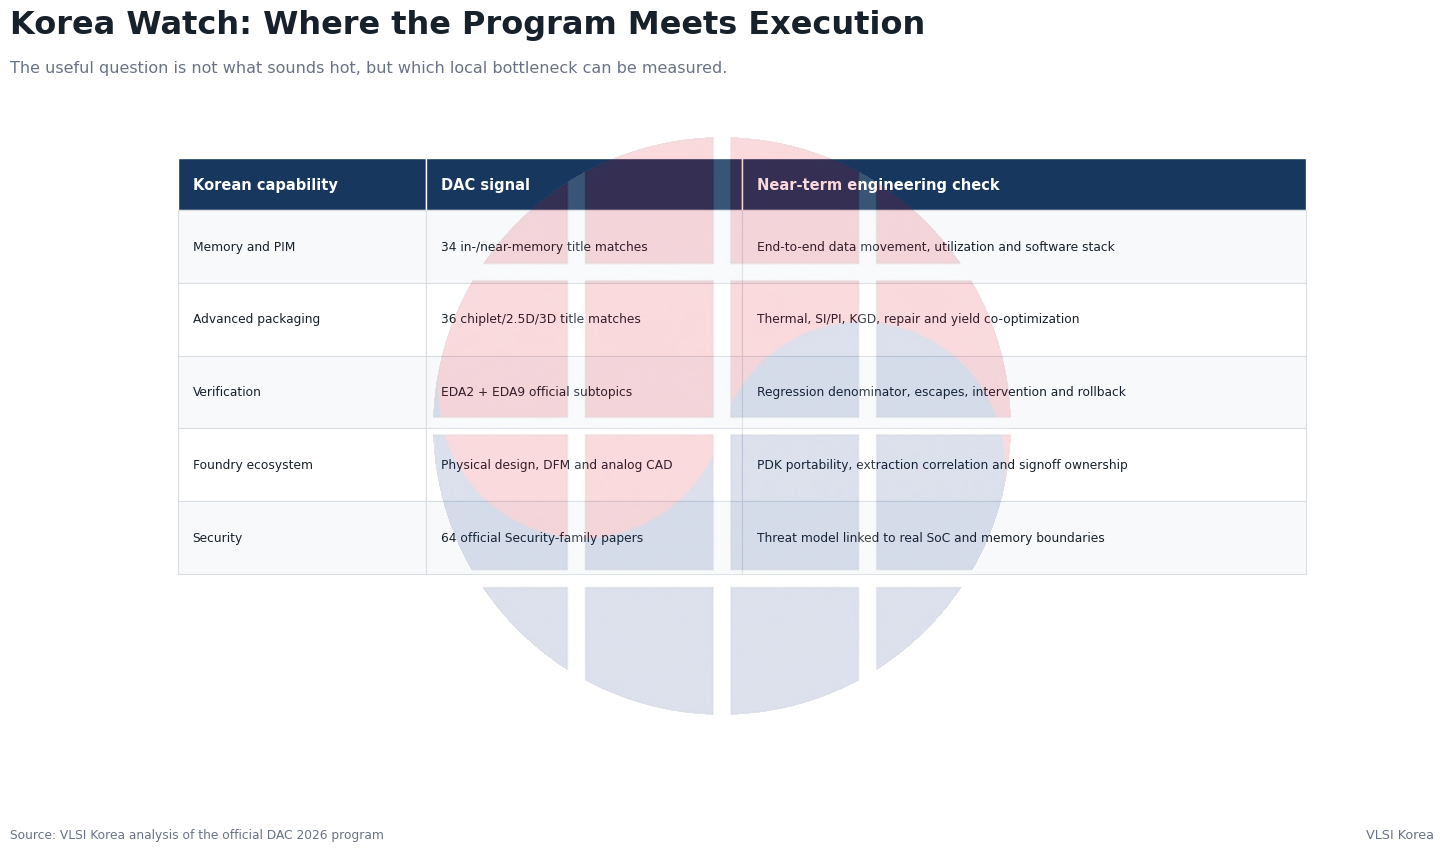
한국은 HBM, DRAM, foundry, OSAT, substrate, mobile/automotive system에서 직접적인 이해관계를 갖는다. 34개의 in/near-memory 제목은 PIM 아이디어가 많다는 뜻이지만, 승부는 compiler/runtime, memory consistency, utilization, total-system energy까지 포함한 end-to-end result에서 난다. 36개의 chiplet/3D 제목도 package layout만으로 끝나지 않는다. SI/PI, thermal, KGD, test access, repair와 yield를 동시에 닫아야 한다.
검증 자동화는 인력 부족을 보완할 수 있지만 false fix와 regression escape를 측정하지 않으면 위험을 뒤로 미룬다. foundry ecosystem은 PDK portability, extraction correlation, analog/mixed-signal closure를 봐야 한다. Security 64편은 AI와 chiplet이 커질수록 trusted boundary가 software, package, memory까지 이동한다는 경고다.
8. 다음 글은 주요 회사가 DAC에서 실제로 내놓은 자료를 분리해 본다
연구 분포만으로 산업 방향을 완성할 수 없다. 다음 편에서는 Synopsys, Cadence, Siemens EDA, NVIDIA, Intel, Microsoft, Keysight, Samsung, SK hynix, AMD/TSMC, IBM의 공식 DAC landing page, newsroom, session page와 program contribution을 자료별로 정리한다. “무엇을 공개했나”, “지금 증거 수준은 어디인가”, “독자가 무엇을 더 확인해야 하나”를 같은 표로 비교한다.
결론: DAC 2026에서 가장 큰 변화는 AI가 많아졌다는 사실 하나가 아니다. AI, Design, EDA가 거의 하나의 연속된 system problem으로 묶였고, memory·chiplet·verification·security·thermal이 그 연결부에 몰렸다. 앞으로의 리뷰도 이 전체 지도 이후에만 sector deep dive로 들어간다.
출처
- DAC 2026 official site
- DAC 2026 official program
- DAC 2026 research topics
- DAC 2026 accepted paper IDs
- DAC 2026 official July 22 program PDF
편집 노트: 공식 프로그램과 기업 원자료를 구조화하고 AI 보조로 초안을 만든 뒤 VLSI Korea의 근거·시각·발행 gate를 적용했다. 프로그램 등재는 성능이나 양산성을 입증하지 않는다. 오류 제보: [email protected]. 재현 가능한 자료: 545편 전체 ledger · 공식 category 집계 · hot-topic 검색식과 수 · 전체 match.
이해상충 및 투자 관련 고지
본 글은 정보 제공만을 목적으로 하며 특정 증권의 매수 또는 매도를 권유하지 않습니다. 공개 자료를 바탕으로 작성했으나 원자료 또는 작성 과정에 오류가 있을 수 있습니다. 필자는 Synopsys 직원이며, VLSI Korea는 고용주와 독립적으로 운영됩니다. 회사별 자료는 동일한 증거 기준으로 검토했고 고용 관계가 편집 순위나 결론을 결정하지 않았습니다. 모든 투자 결정과 결과는 독자의 책임입니다.