VLSI Korea
지상 데이터센터의 GPU를 우주에 그대로 가져갈 수 있을까
H100·Suncatcher·Space-1의 공개 근거로 칩·보드·위성의 변경 범위를 나누고, 같은 완료 작업량에 필요한 가속기 수와 전력을 계산한다.


지상용 GPU를 우주에서 쓰는 것은 가능하다. 다만 재사용할 수 있는 연산 칩과 다시 설계해야 하는 전원·냉각·복구 시스템을 나누어야 한다. 같은 소프트웨어가 실행된다는 사실은 같은 서버 구성이 임무 수명 동안 같은 처리량을 낸다는 뜻까지 보장하지 않는다.
2026-10-06 기준, Google은 2026-10-01에 Planet과 개발한 Suncatcher 시제품의 발사와 교신 확인을 발표했다. 이제 질문은 발사 가능성에서 실제 운용 데이터로 옮겨간다. Google의 발표는 앞으로 TPU의 방사선·열 환경 데이터를 수집한다고 설명한다.
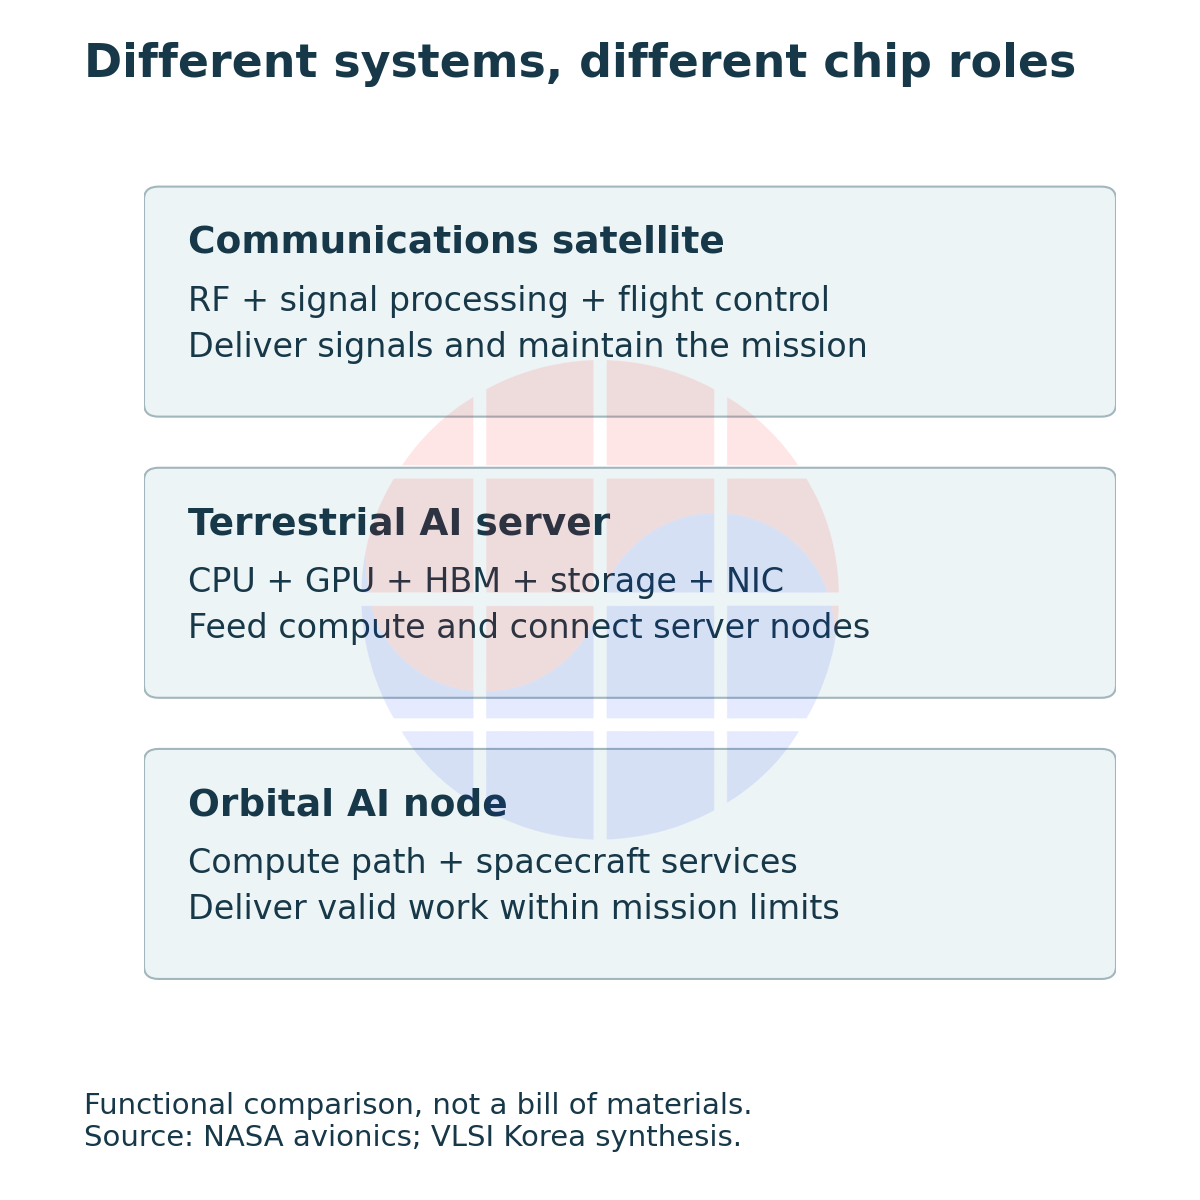
VLSI Korea view: 우주용 AI 반도체를 비교할 때는 칩 이름보다 재사용 경계를 먼저 그려야 한다. 구매할 수 있는 모듈, 위성에 통합할 수 있는 모듈, 유효한 계산을 계속 내놓는 시스템은 서로 다른 인수 대상이다.
이 글은 가속기 보드의 변경 범위를 정하는 엔지니어와 궤도 연산 제안서의 성능을 비교하는 독자를 위한 설명이다. 부품을 그대로 쓸지 바꿀지, 같은 완료 작업량을 얻으려면 얼마나 많은 전력과 자원을 배정할지를 판단하는 데 초점을 둔다.
1. 통신위성의 반도체와 AI 서버의 반도체는 맡은 일이 다르다
통신위성은 무선 신호를 받고 보내며, 통신 경로와 자세·전력을 관리한다. RF front end, 신호 처리 ASIC·FPGA, 제어용 MCU가 담당하는 일은 큰 행렬을 반복 계산하는 GPU·TPU의 역할과 다르다. 위성 내부에 AI 가속기가 추가되어도 통신과 비행 제어 기능이 사라지지는 않는다.
지상 AI 서버에서는 CPU가 프로그램과 데이터를 준비하고 GPU가 병렬 연산을 수행한다. HBM은 가속기 가까이에서 높은 대역폭을 제공하고, host DRAM과 SSD는 다른 용량·지연·지속성 요구를 맡는다. NIC와 스위치는 여러 서버 사이의 데이터 이동을 연결한다. 부품 목록보다 이 데이터 경로가 먼저다.
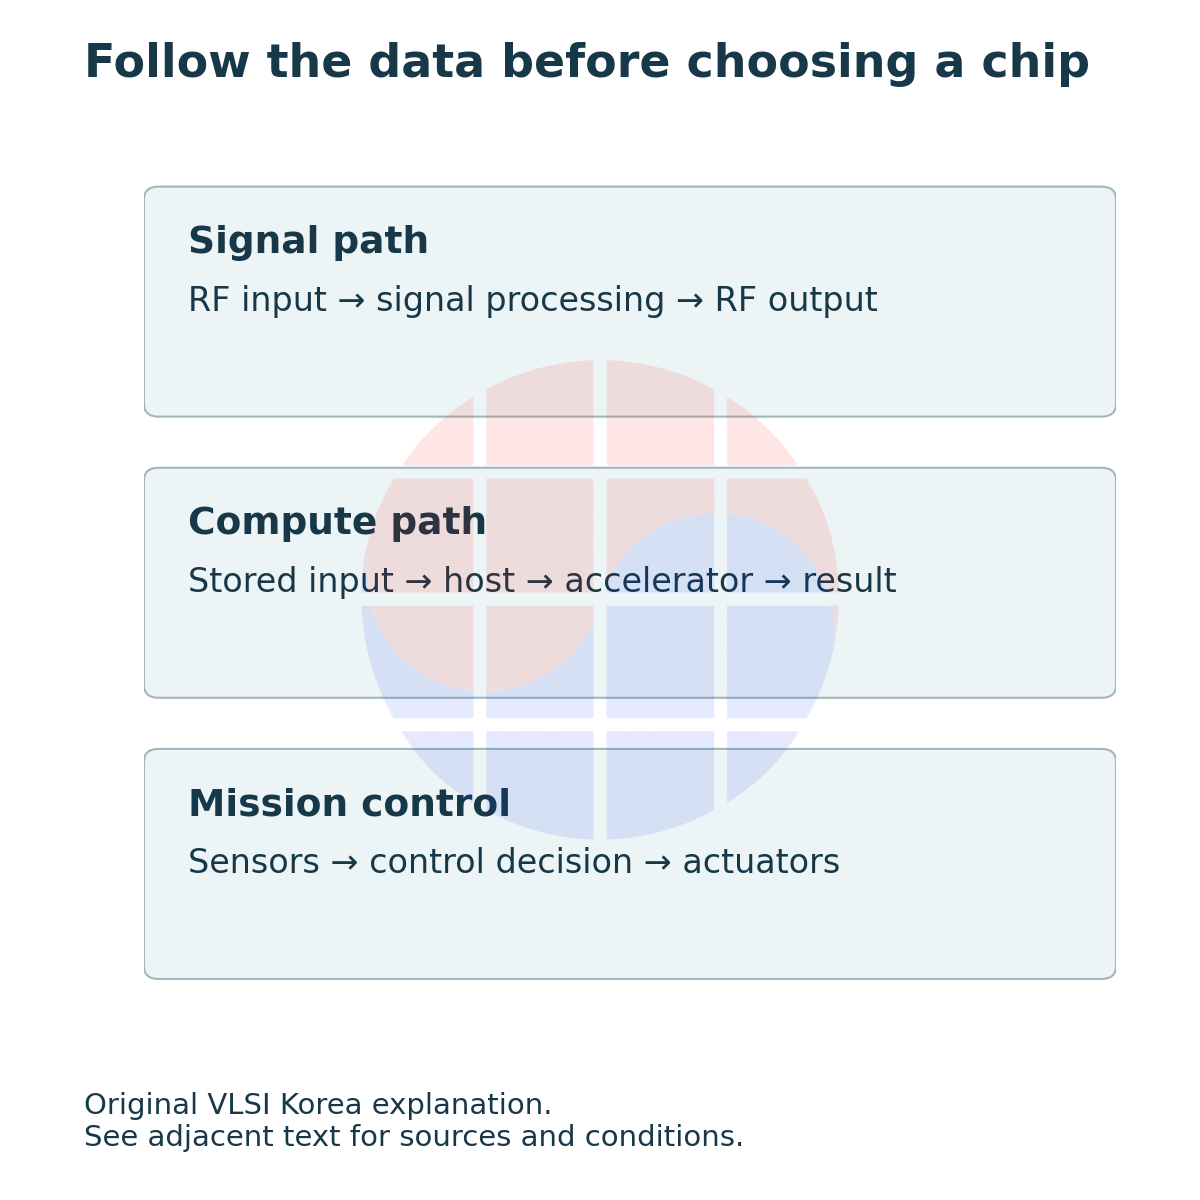
궤도 AI 노드는 이 연산 경로를 우주선의 다른 기능과 결합한다. 연산 결과를 늦게 보내도 되는 영상 분류와 자세 제어에 즉시 써야 하는 판단은 서로 다른 실패 조건을 갖는다. 같은 GPU를 사용해도 허용 지연, 출력 검증과 재시작 정책이 달라지는 이유다.
NASA의 소형 위성 항공전자 설명도 임무별 처리량·전력·실시간 요구에 따라 프로세서와 구조를 선택한다. 특정 CPU의 연산 성능만으로 위성 전체의 성숙도를 비교하기는 어렵다.
SpaceX라는 이름도 시스템별로 분리해야 한다. 2026-08-24 NVIDIA 발표는 SpaceXAI의 Starmind 계획에 최적화한 Vera Rubin NVL72를 명시한다. 이는 Starlink 통신위성의 부품명세가 아니며, 지상 랙을 수정 없이 발사했다는 발표도 아니다.
2. 칩을 유지해도 패키지부터 클러스터까지 인수 조건이 바뀐다
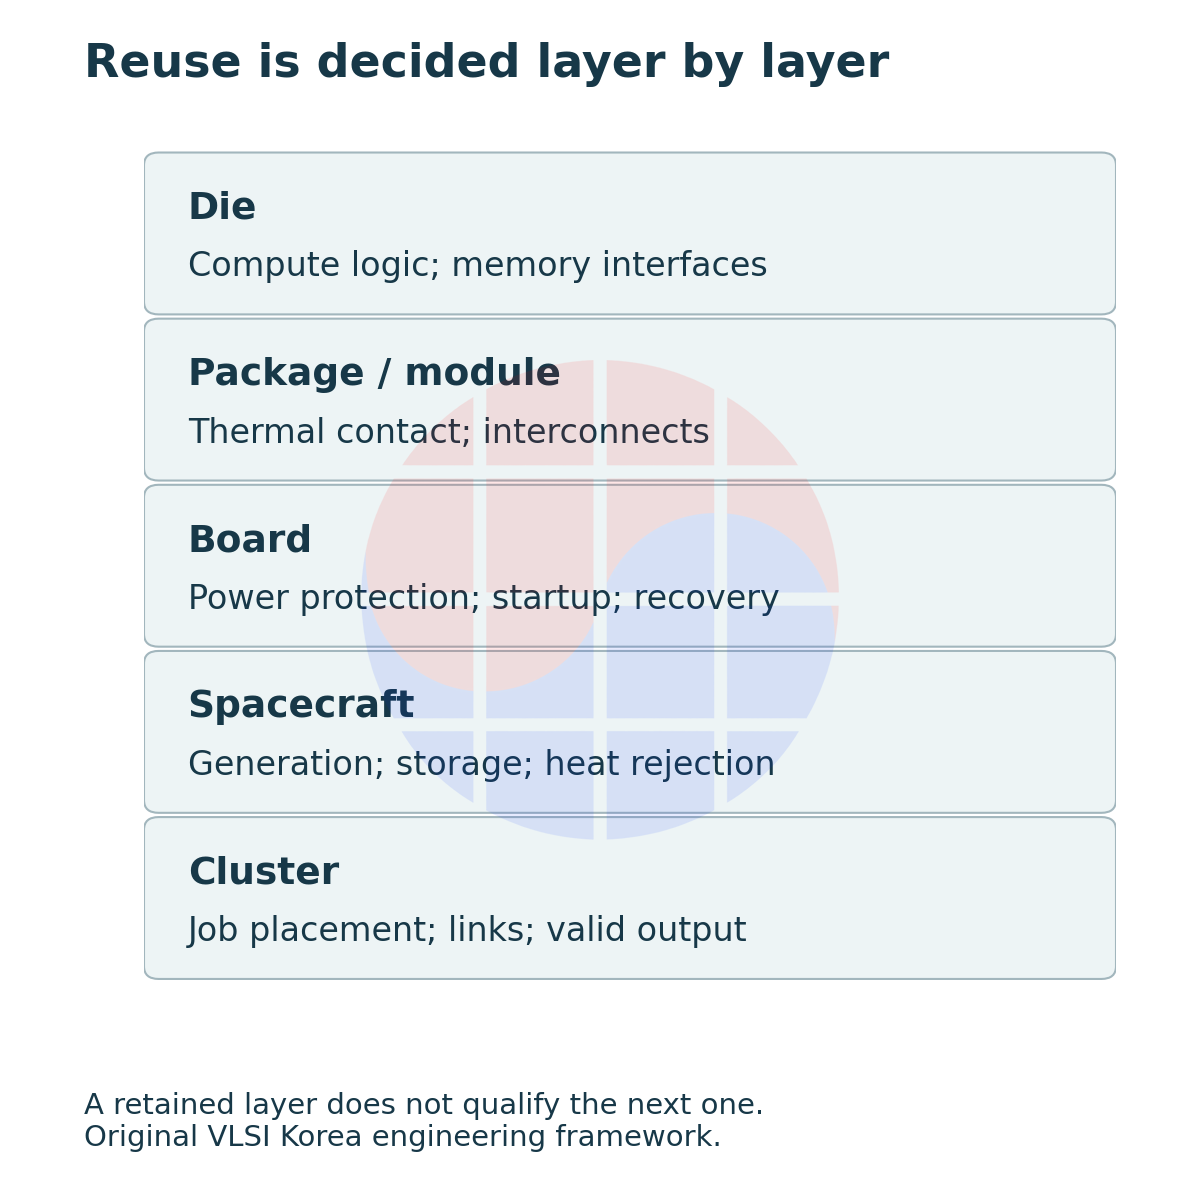
다이는 연산 논리와 메모리 인터페이스가 구현된 실리콘이다. 패키지는 다이를 외부 회로와 연결하고 열을 전달하며, 모듈·보드는 전원 변환과 커넥터, 관리 회로를 더한다. 우주선은 여기에 발전·저장·열 배출·자세 제어를 묶고, 클러스터는 여러 노드의 통신과 작업 배치를 조정한다.
한 계층의 변경이 없다고 다음 계층의 시험까지 생략할 수는 없다. 동일한 다이를 쓰더라도 방열 접촉면과 고정 구조가 달라지면 온도 분포와 기계 하중의 경로가 달라진다. 보드의 전류 제한 장치가 바뀌면 정상 기동과 고장 차단을 구분하는 설정도 다시 확인해야 한다.
예를 들어 NVIDIA의 H100 PCIe 제품 설명서 PB-11133-001_v02는 최대 350 W 구성과 80 GB HBM2e를 명시한다. 카드의 passive heatsink는 서버가 제공하는 공기 흐름을 전제로 한다. 반면 현재 H100 SXM 제품 표의 최대 전력은 구성에 따라 700 W다. 두 값을 ‘H100 한 개’라는 같은 조건으로 계산에 넣으면 출발점부터 달라진다. PCIe 설명서, SXM 제품 표
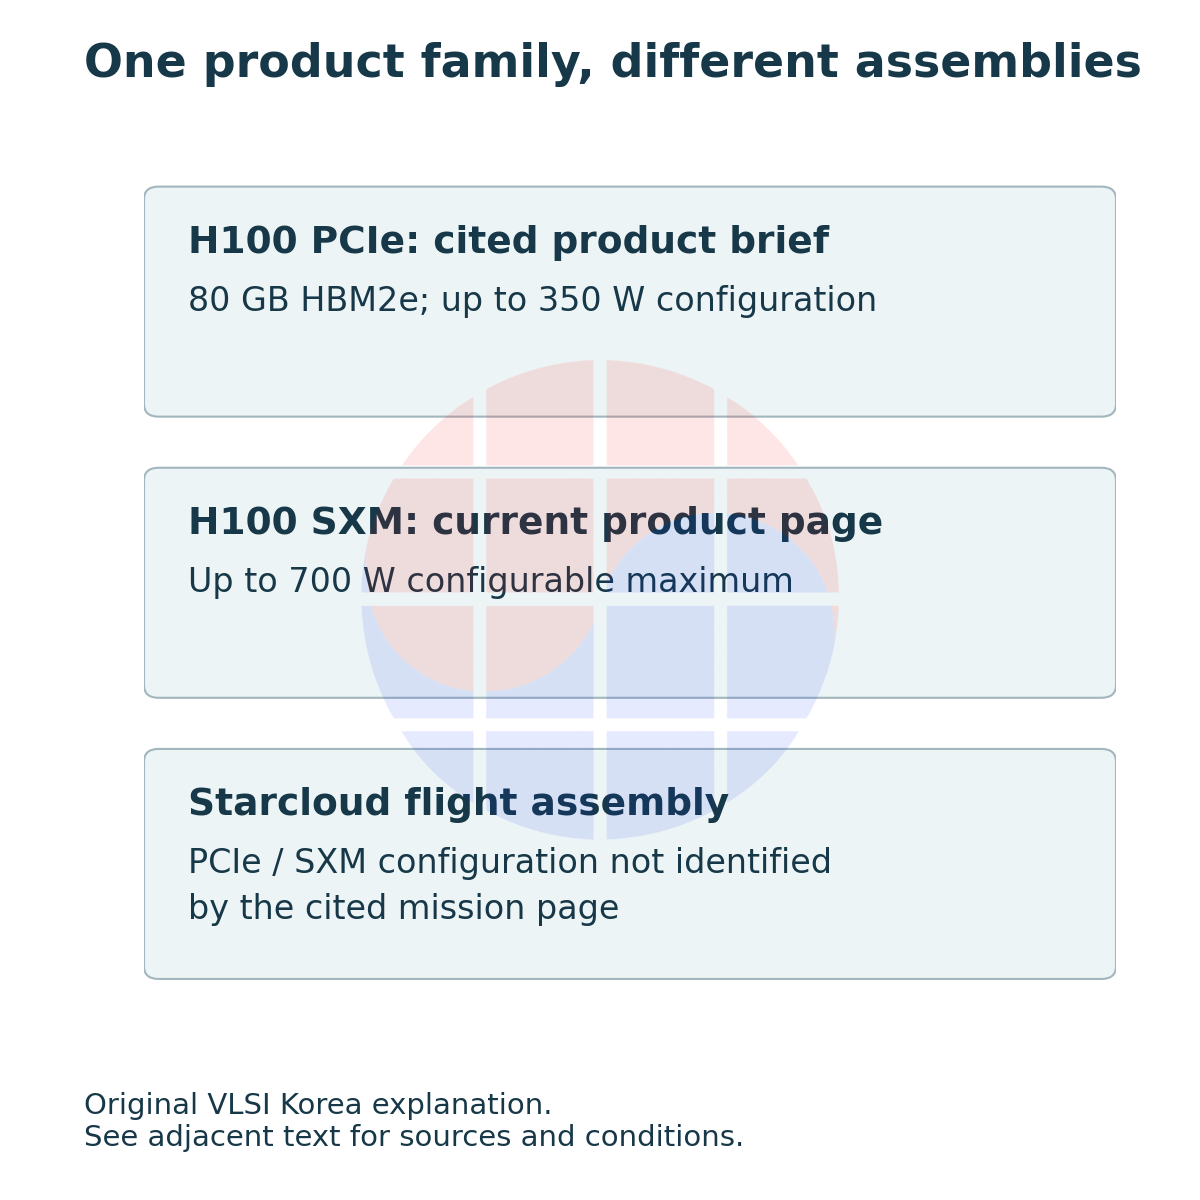
Starcloud의 임무 설명은 2025-11 H100 탑재 발사와 2025-12 nanoGPT 학습 실증을 소개한다. 이 페이지는 비행한 조립체의 PCIe·SXM 구성과 전체 부품명세를 밝히지 않는다. 따라서 이 글의 지상 PCIe 사진이나 제품 표를 해당 위성의 실제 보드로 대입하지 않는다.
설계자는 재사용할 부분과 새로 검증할 부분을 인터페이스 문서로 나눌 수 있다. 유지하는 드라이버·명령 집합, 변경하는 기구·전원·열 접점, 재시험할 부팅·복구 경로를 적으면 ‘COTS 채택’이 구체적인 작업 범위가 된다. COTS는 상용 기성품이라는 조달 분류이지 임무 적합성 판정이 아니다.
3. 궤도에서 켜졌다는 사실 다음에는 무엇을 확인해야 할까
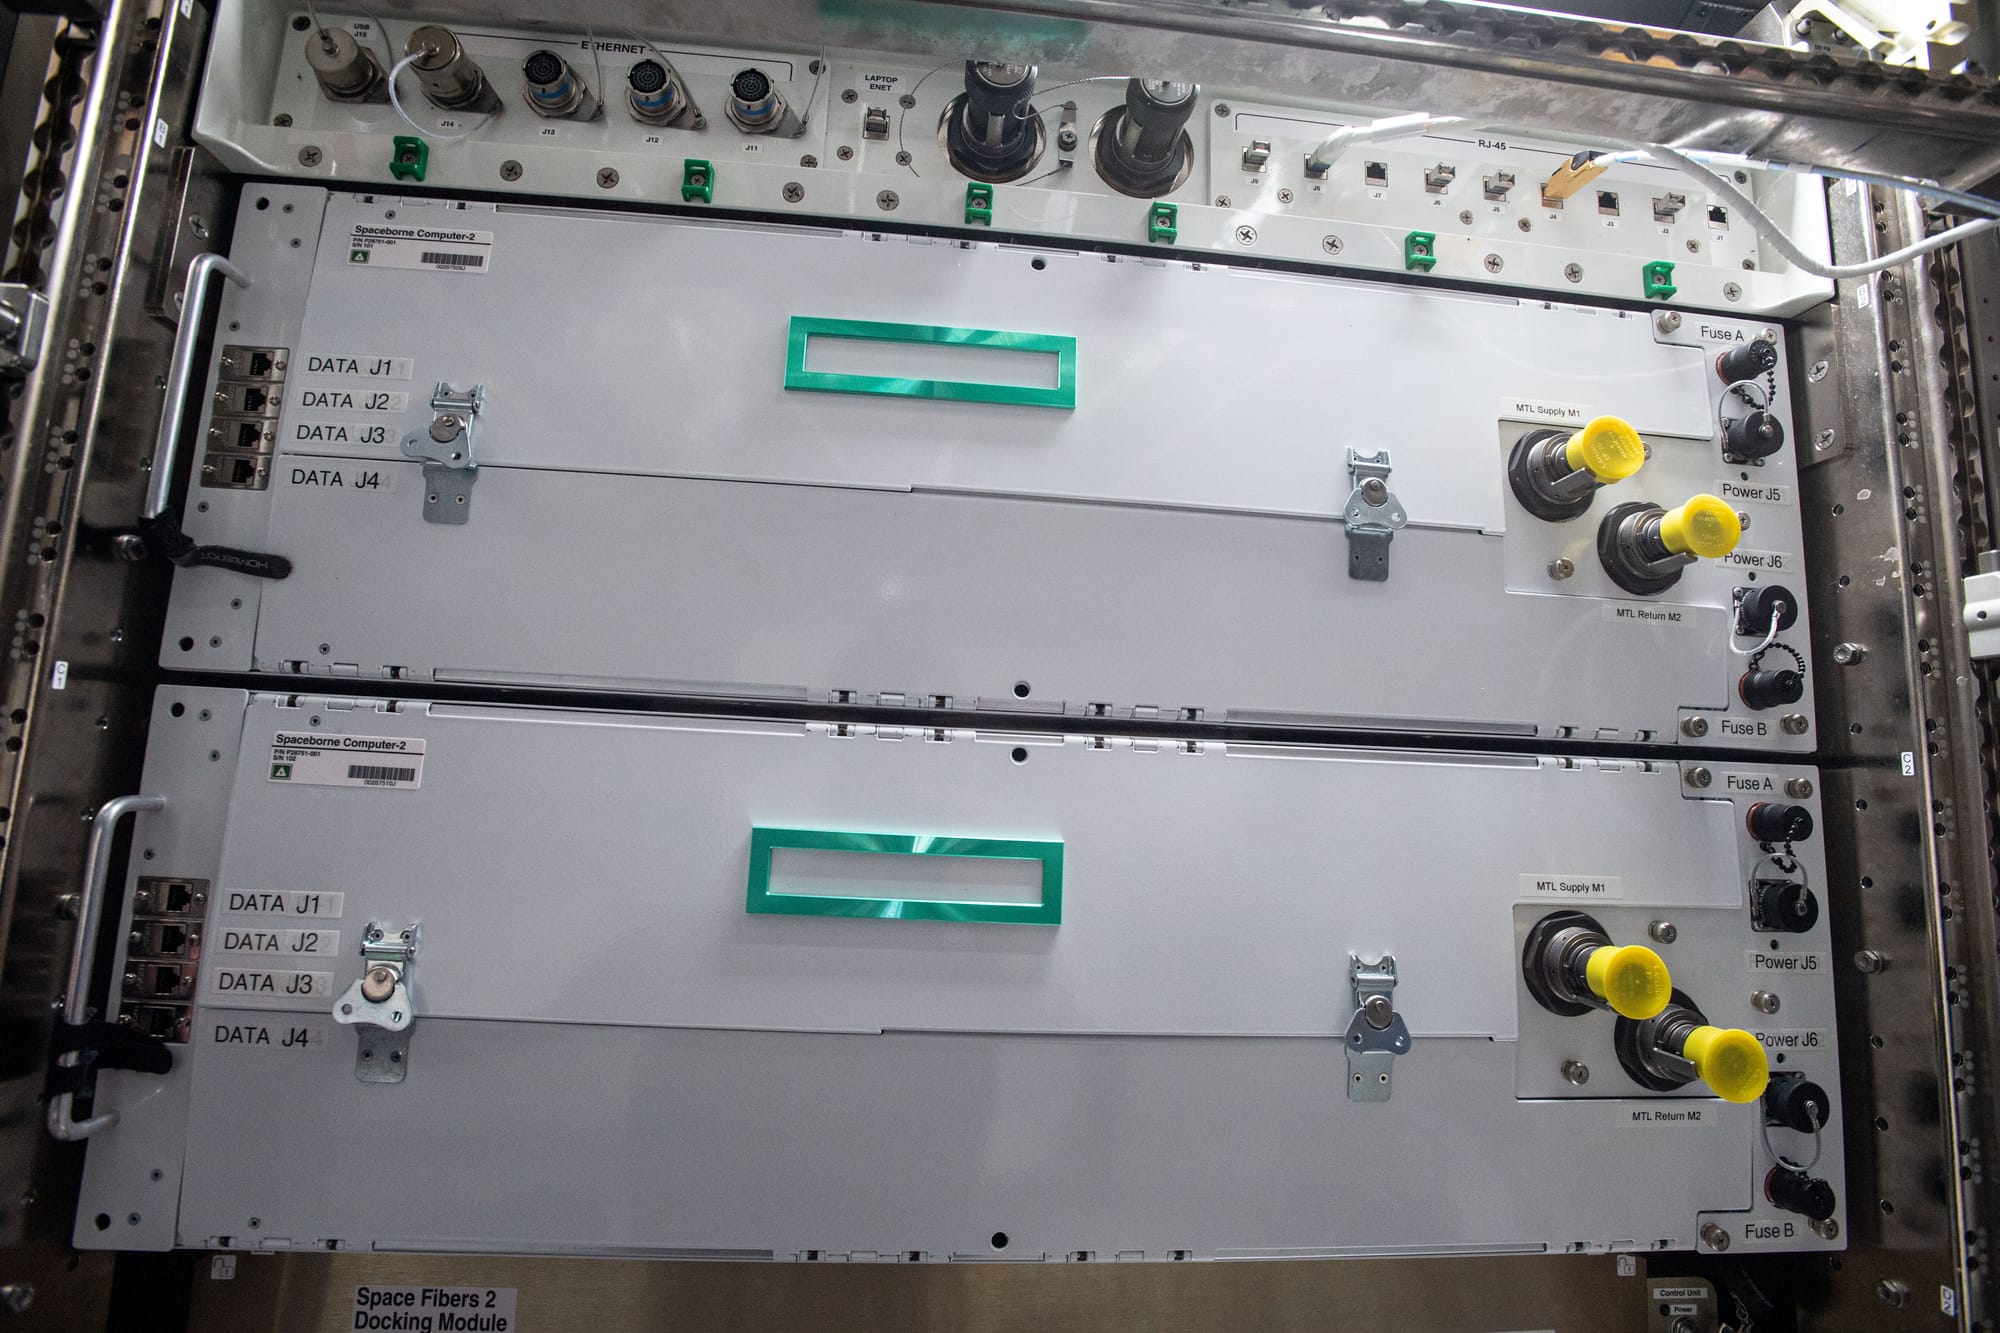
HPE는 2024-01-30에 상용 서버 기반 Spaceborne Computer의 새 구성을 ISS로 보냈다고 발표했다. 본문 사진은 그보다 앞선 2021-04-29의 Spaceborne Computer-2 실물이다. ISS 내부에서 연산한 사례는 유용하지만, 외부 진공에 놓인 독립 위성의 전원과 냉각까지 입증하는 사례로 읽을 수는 없다. HPE 발표
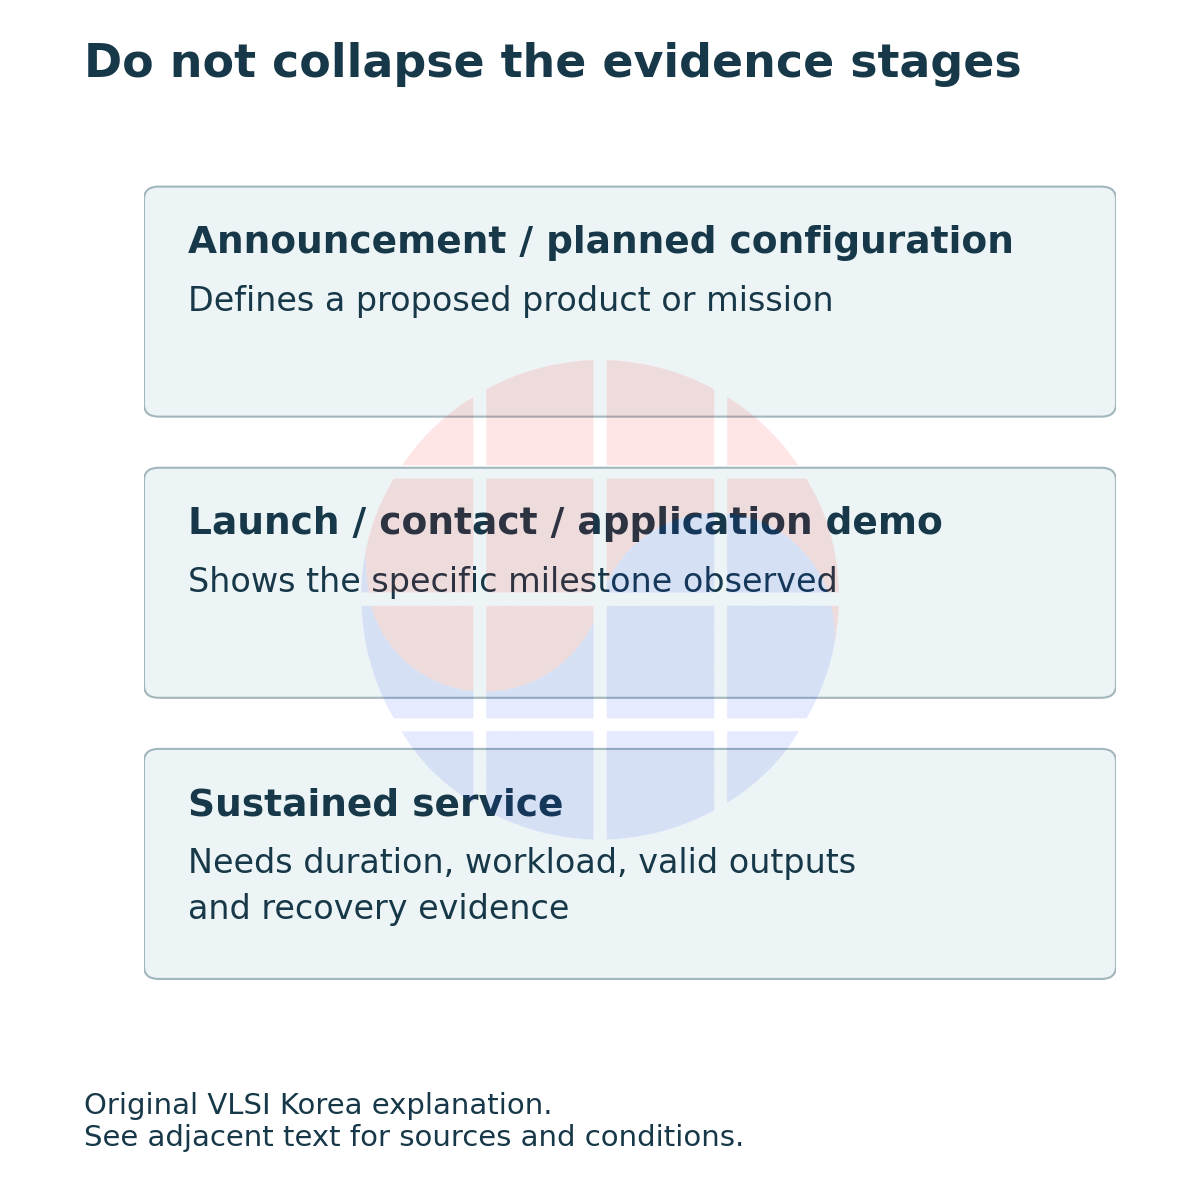
‘작동했다’는 말에는 시험 범위를 붙여야 한다. 정상 부팅, 일정 시간의 응용 실행, 고장 후 복구, 다수 노드의 안정된 서비스는 각각 다른 관측이다. 하나를 확인하면 다음 시험의 출발점을 얻지만, 관측하지 않은 항목의 성능 수치까지 생기는 것은 아니다.
Google의 공개 시험은 이 경계를 보여준다. 2025년 연구에서는 Trillium v6e를 67 MeV 양성자로 시험했고, HBM 시험의 이상이 누적 2 krad(Si) 이후 나타났다고 보고했다. 단일 칩의 최대 시험 선량인 15 krad(Si)까지 TID에 기인한 영구 고장은 없었다. Google Research
이 수치는 시험한 부품과 조건에 묶여 있다. 연구 원문 v1의 2.3절은 10 mm 알루미늄 등가 차폐를 예로 든 환경과 5년 누적 750 rad(Si) 기준을 설명한다. 해당 결과만으로 다른 가속기, 다른 차폐 또는 우주선 전체의 수명을 계산하지 않는다.
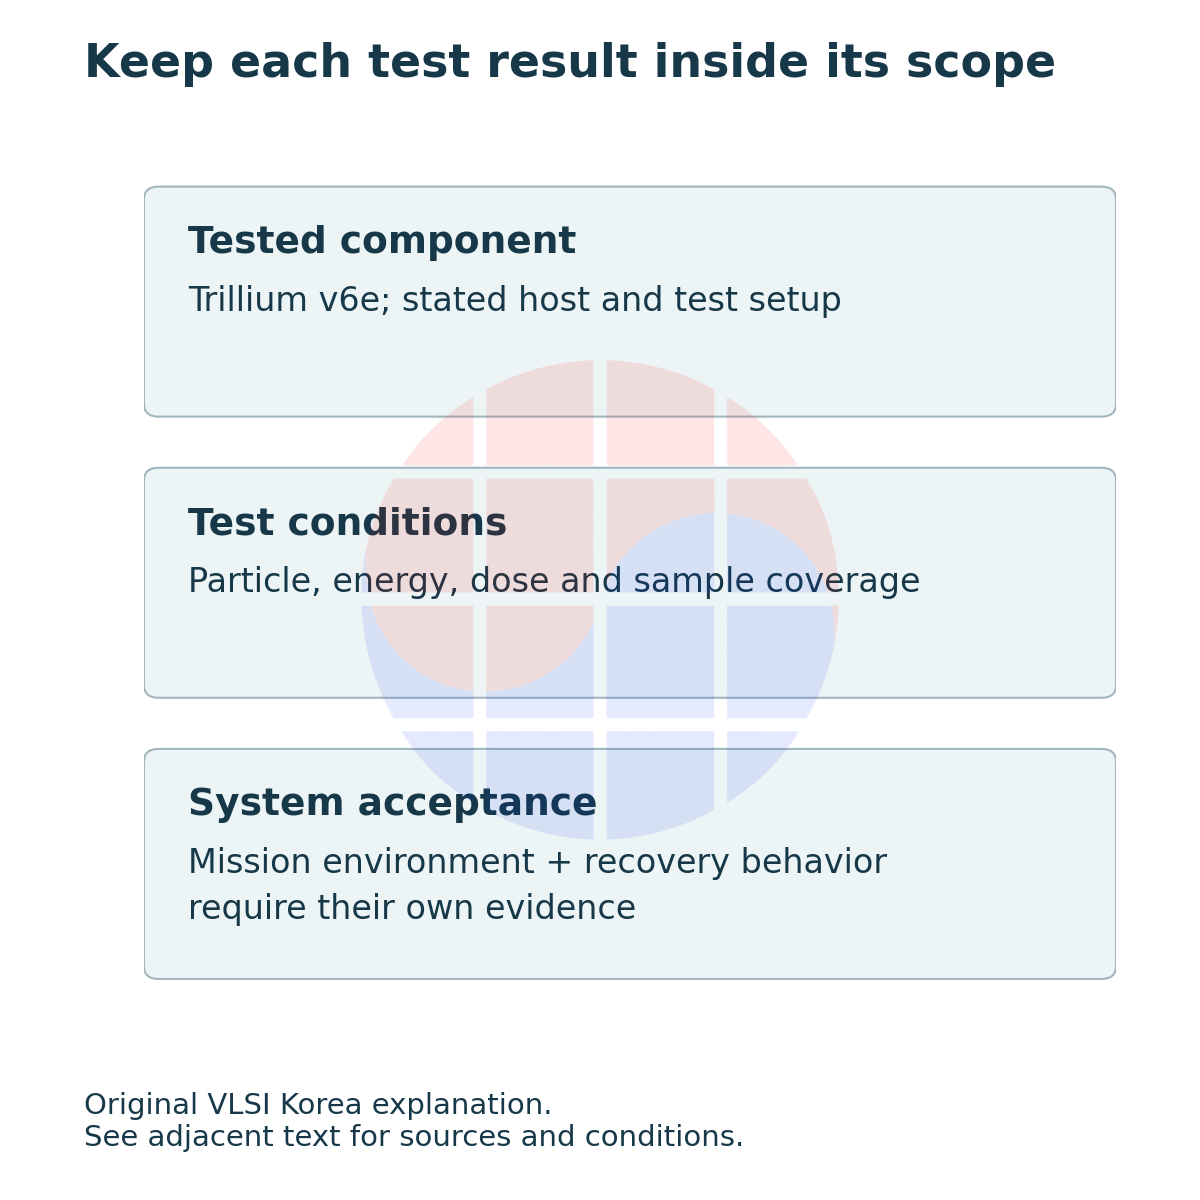
누적 이온화 선량인 TID, 결정 격자 손상을 일으키는 displacement damage, 한 입자가 순간적인 오류를 일으키는 single-event effects는 구분해야 한다. 논리 상태가 뒤집히는 오류와 전류가 비정상적으로 지속되는 latch-up에는 같은 복구 방법을 적용할 수 없다.
ECC는 정해진 오류 패턴을 검출·정정하는 수단이다. latch-up의 전류를 차단하지도, 모든 계산 오류를 알아내지도 않는다. 설계 검토에서는 ‘ECC 지원’이라는 항목 옆에 오류 검출 지점, 전원 차단 책임, 다시 믿을 수 있는 출력의 조건을 적어야 한다. 구체적인 scrub·checkpoint 설계는 기존 LEO 메모리 신뢰성 해설에서 이어 읽을 수 있다.
4. GPU가 소비한 전력은 어디를 거쳐 밖으로 나갈까
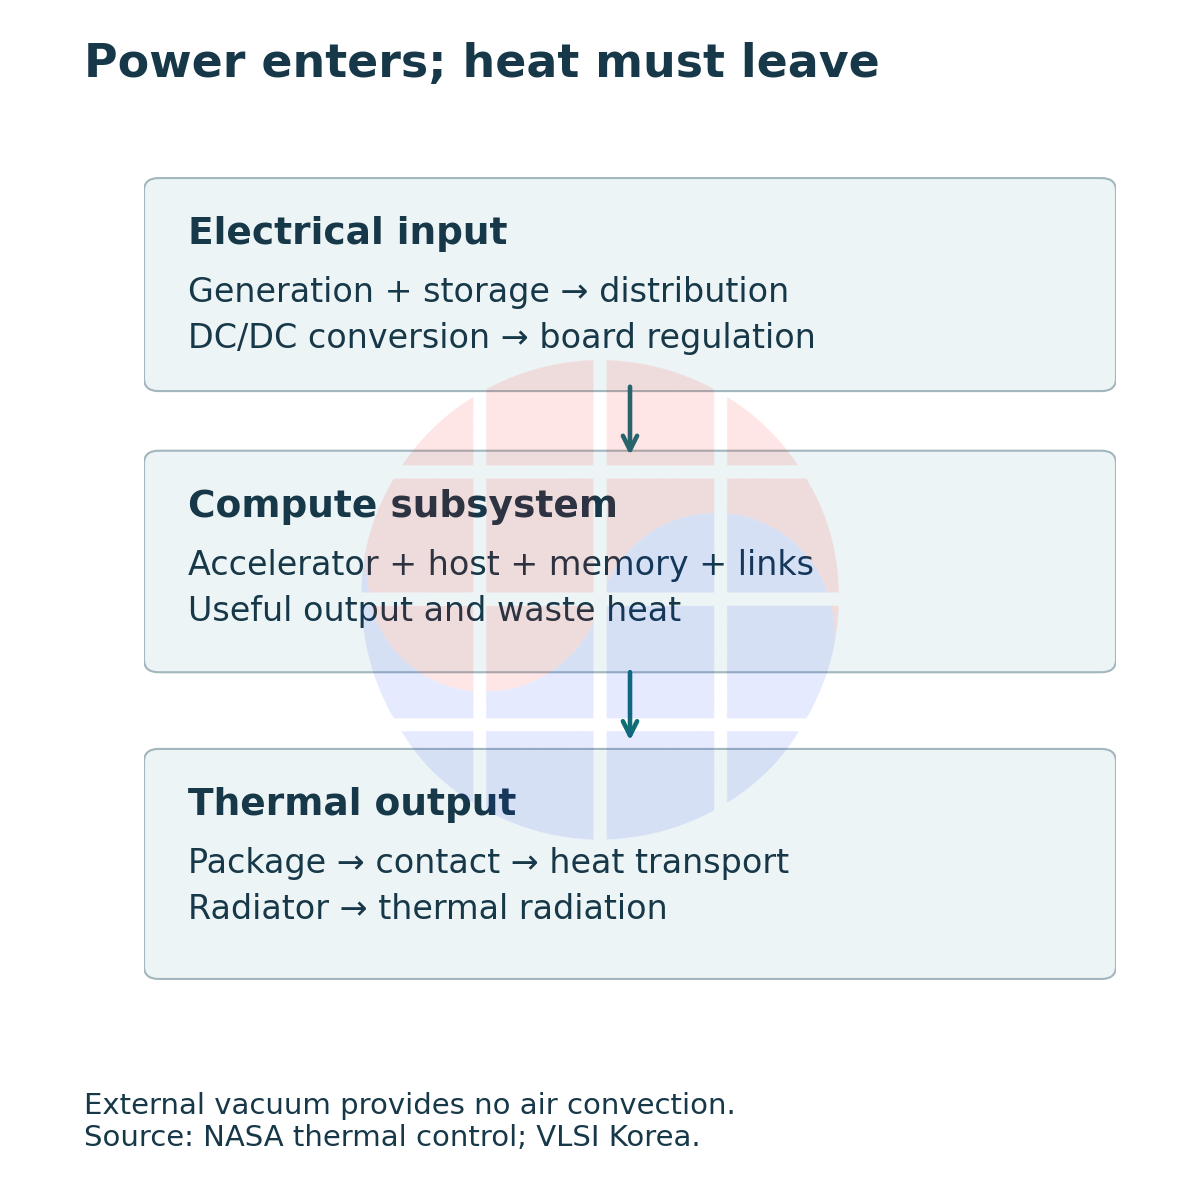
진공에서는 외부 공기로 열을 넘기는 대류 경로가 없다. 칩의 열을 패키지·접촉면·열수송 장치로 옮긴 뒤, 방열 표면에서 복사로 배출해야 한다. NASA의 열 제어 설명이 구분하는 내부 전도와 외부 복사 경로다. 우주 배경이 차갑다는 말만으로 GPU 접합 온도는 정해지지 않는다.
지상에서 검증한 cold plate도 우주선 안에서 동일한 조건을 자동으로 얻지는 못한다. 접촉 열저항, 배관과 펌프, 유체의 동작 범위, 최종 방열판과의 온도 차를 함께 설계해야 한다. 가속기만 낮은 온도로 유지하려 하면 열을 내보내는 쪽의 설계 여유와 질량이 달라질 수 있다.
전원 경로도 발전판에서 GPU로 곧장 이어지지 않는다. 저장장치, 배전, DC/DC 변환과 보드의 전압 조정 단계를 거치며 각 단계가 전력과 열 예산에 영향을 준다. 가속기를 켜는 순간의 부하 변화가 위성의 통신·제어 전원과 어떻게 분리되는지도 확인할 대상이다.
여기서 설계 판단은 ‘더 큰 방열판’ 하나로 끝나지 않는다. 지속 성능을 낮춰 열 부하를 제한할지, 일감을 나누어 동시에 켜는 가속기 수를 줄일지, 기구와 열 접점을 바꿀지 선택해야 한다. 이 선택은 명목 연산 성능보다 실제 작업 완료 시간을 바꾼다.
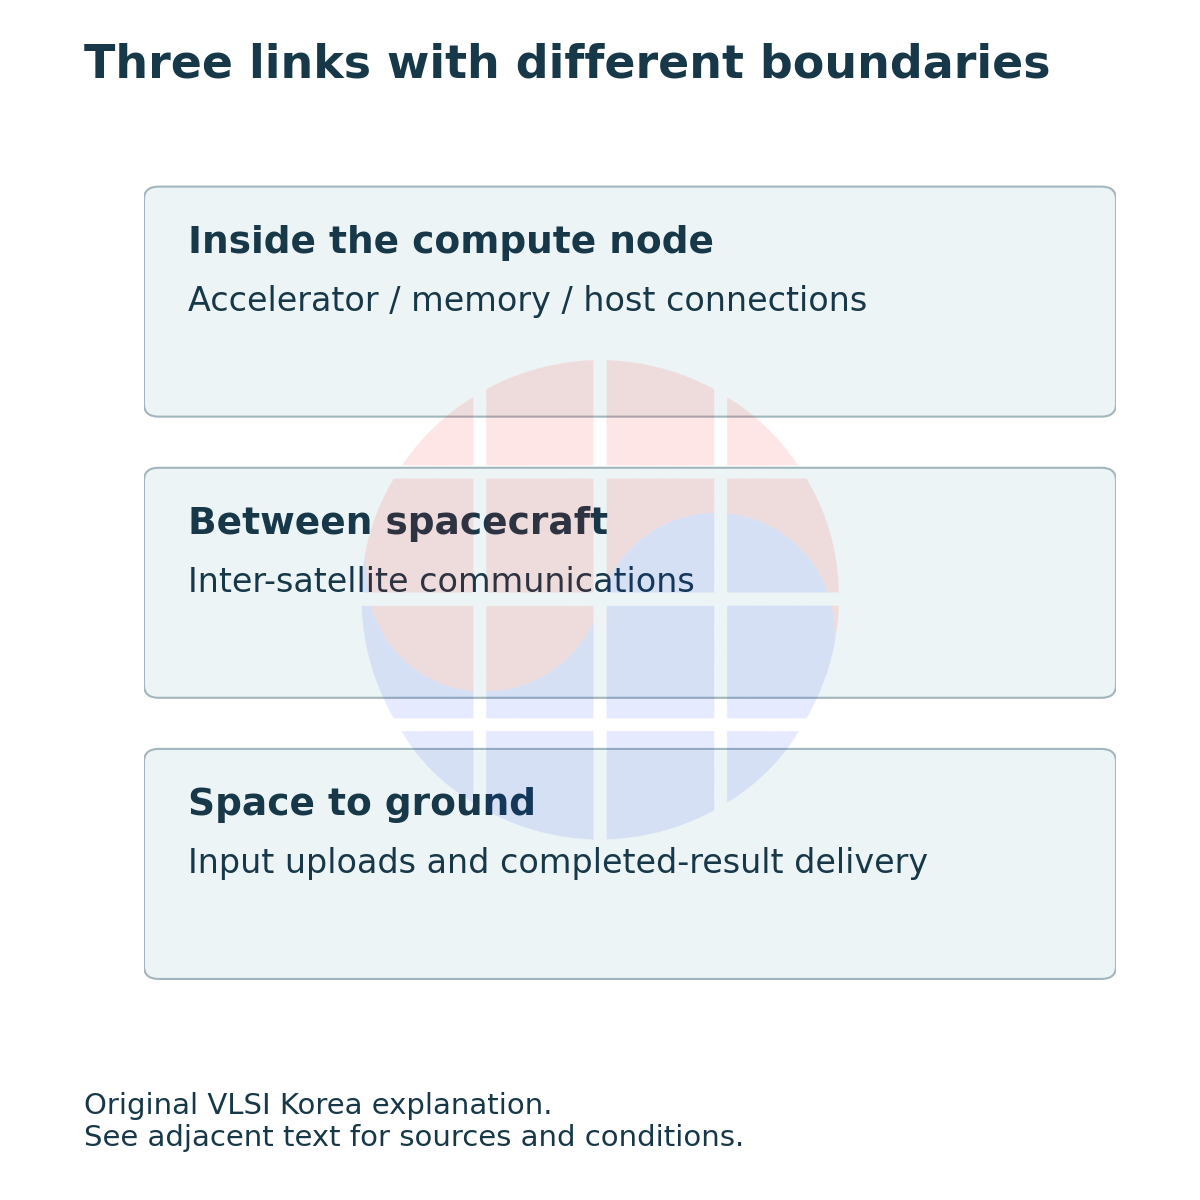
통신 역시 별도 계층이다. 가속기 사이의 짧은 전기 연결, 위성 사이의 광링크, 지상으로 결과를 보내는 링크는 지연·대역폭·가용 시간이 다르다. 지상 서버에서 잘 확장된 모델이 궤도에서도 같은 효율을 내려면, 작업이 기다리는 위치와 전송량을 먼저 측정해야 한다.
궤도에서 생성한 영상에서 필요한 결과만 추출하는 작업과 지상의 큰 학습 데이터를 올려 분산 학습하는 작업은 시작부터 데이터 이동 방향이 다르다. 연산 칩의 성능표가 같아도 어느 쪽에 이점이 있는지는 달라질 수 있다. 따라서 ‘우주용 GPU’의 단일 순위보다 임무별 처리 경로가 유용하다.
5. 같은 가속기 수 대신 같은 완료 작업량을 비교하자
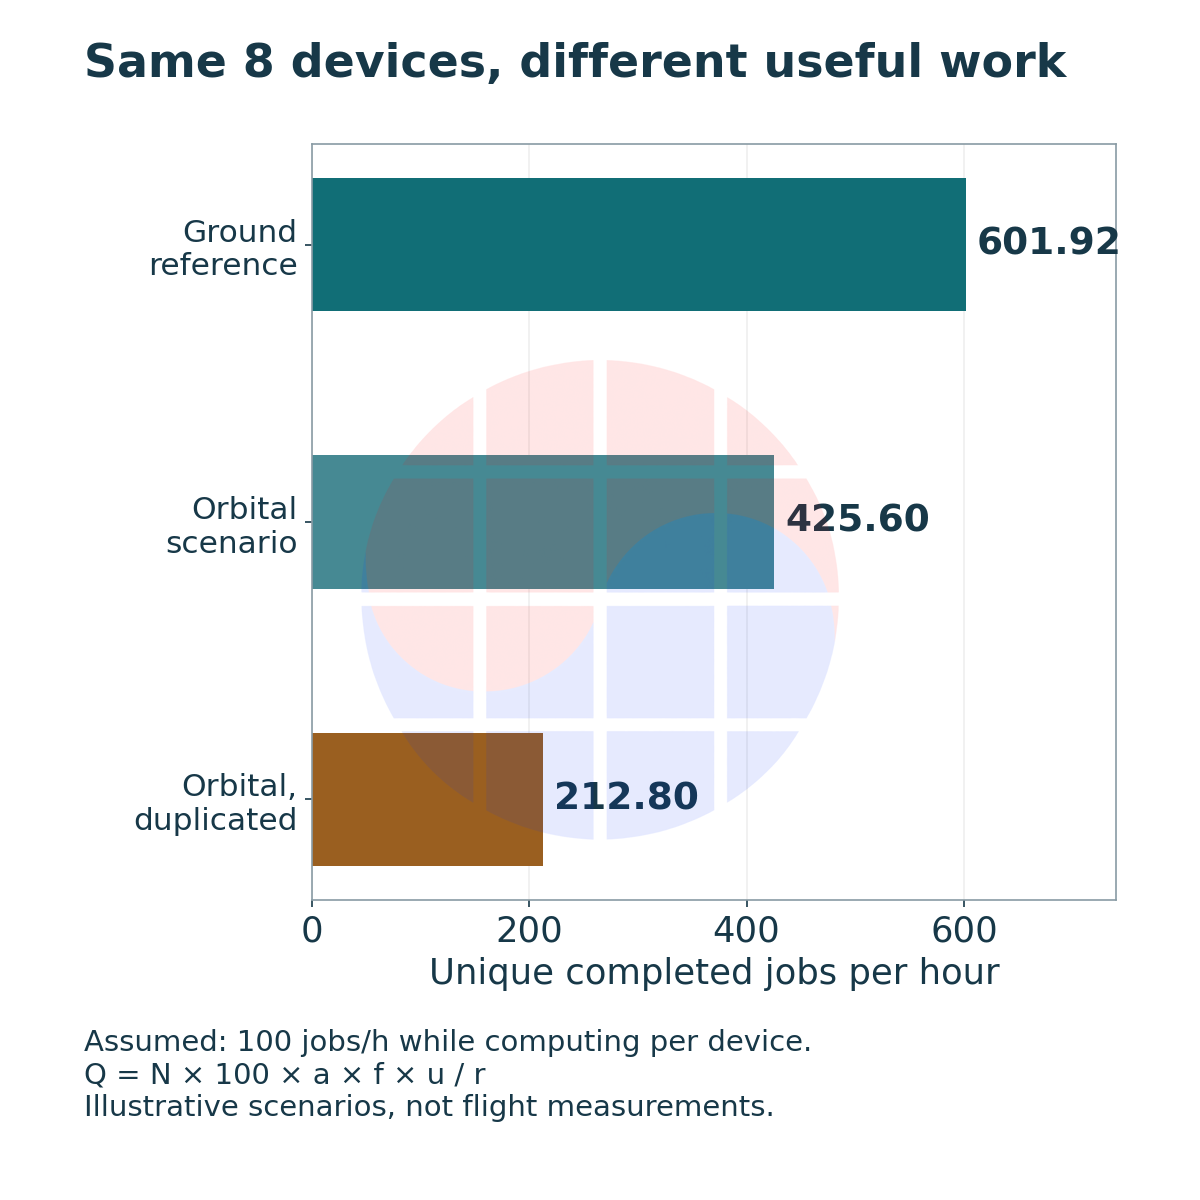
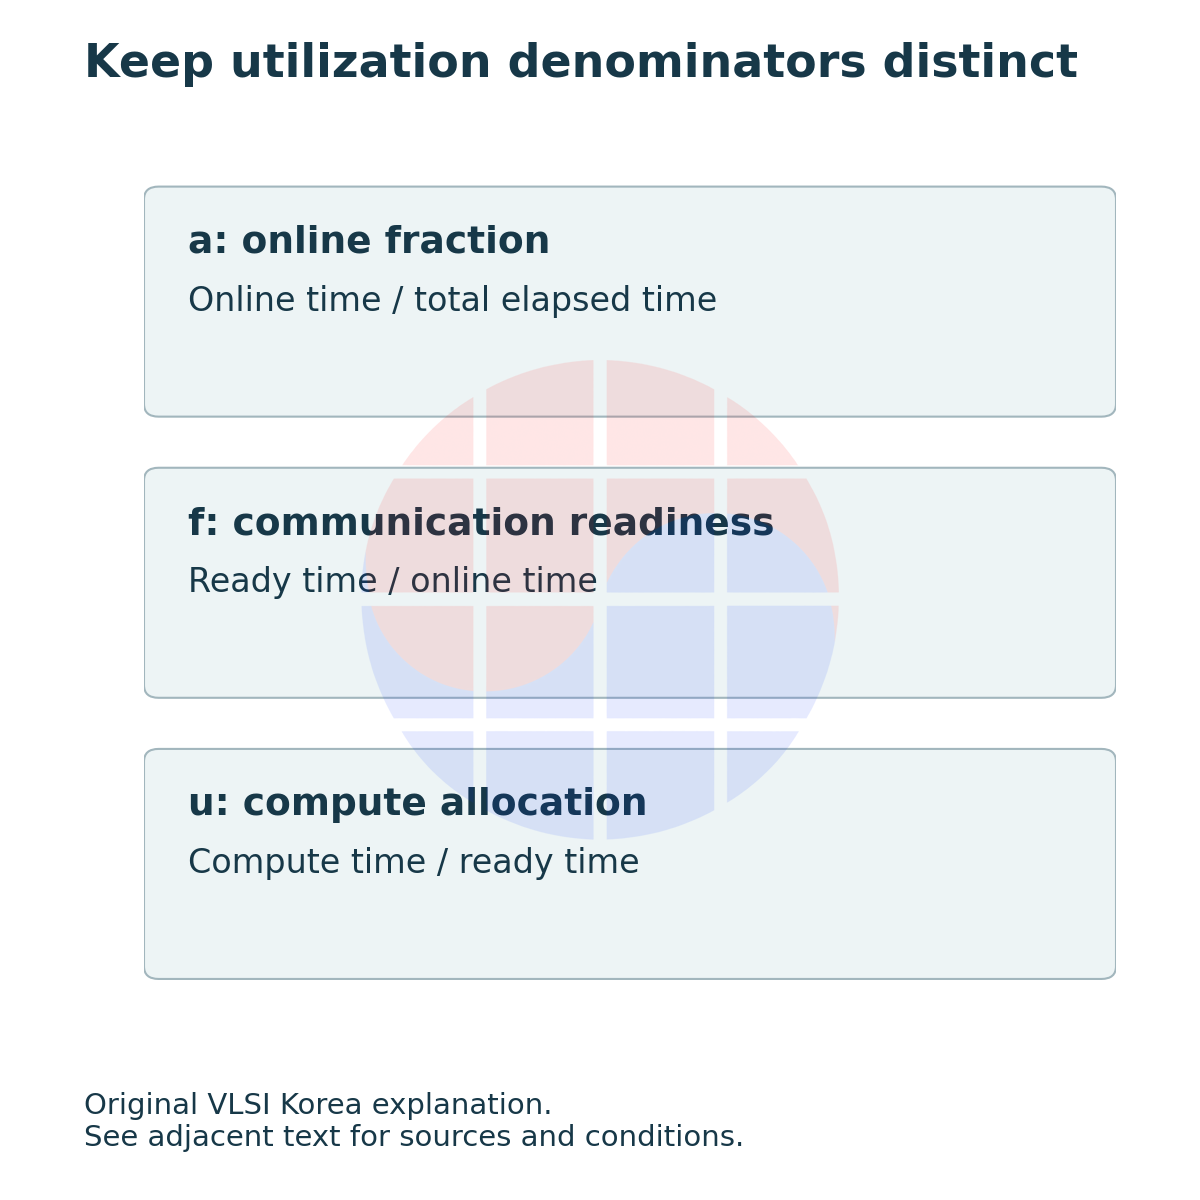
다음은 특정 제품이나 궤도의 측정값이 아닌 설계 예제다. 동일한 입력·정밀도·정답 조건을 가진 작업에서 가속기 1개가 연산 중 시간당 100건을 처리한다고 가정한다. 장착 수 N, 온라인 비율 a, 온라인 상태에서 통신 때문에 막히지 않는 비율 f, 그 시간 중 실제 연산 배정 비율 u를 분리한다.
동일 작업을 r개 장치에서 함께 수행해 결과를 비교한다면, 고유한 완료 작업량 Q는 N × 100 × a × f × u ÷ r로 계산한다. r은 활성 중복 실행의 수다. 꺼 둔 예비 장치나 모든 작업이 아닌 일부 검산에는 이 식을 그대로 적용하지 않는다.
r=2 시나리오에서 a·f·u는 개별 장치 비율이 아니라 두 장치가 함께 작업을 끝낼 수 있는 완전한 실행 그룹의 조건부 준비 비율이다. 독립 장치 가용성에서 중복 실행의 신뢰성을 계산한 값은 아니다.
세 비율을 곱하려면 분모가 겹치지 않아야 한다. 통신 대기가 이미 반영된 GPU utilization을 u로 넣고 f를 다시 곱하면 같은 손실을 두 번 뺀다. a는 장치가 온라인인 시간, f는 그 안에서의 통신 준비 상태, u는 남은 시간의 연산 배정이라는 조건부 정의를 유지한다.
지상 기준 예제는 a=0.99, f=0.95, u=0.80, r=1로 둔다. 궤도 시나리오는 a=0.95, f=0.80, u=0.70, r=1이다. 같은 8개를 장착하면 Q는 각각 601.92건/시간과 425.60건/시간이다. 이 차이는 우주 장비의 실제 열세가 아니라, 가정한 운용 조건의 차이가 만든 계산이다.
궤도 시나리오에서 모든 작업을 2개씩 중복 실행하면 r=2이고 Q는 212.80건/시간이 된다. 이 예제는 중복 실행으로 얻을 수 있는 신뢰성 향상을 계산하지 않는다. 두 결과의 불일치를 찾는 것과 올바른 결과를 선택하는 것, 공통 원인 고장을 피하는 것은 별도 설계다.
VLSI Korea view: 신뢰성 기능은 공짜 성능이 아니다. 같은 계산을 두 번 하는 비용과 오류를 발견했을 때 무엇을 할 수 있는지를 각각 설명해야 한다.
수치가 낮아지는 이유가 통신 대기라면 GPU를 더 빠르게 만드는 것만으로는 충분하지 않다. 독립적인 작업을 더 잘 배치하거나 데이터 전송과 계산을 겹칠 수 있는지 검토한다. 반대로 메모리 용량 부족으로 작업 자체가 올라가지 않는다면 같은 모델의 배정 비율을 높인다는 가정부터 성립하지 않는다.
6. 목표 처리량을 맞추면 보드 밖의 비용이 보인다
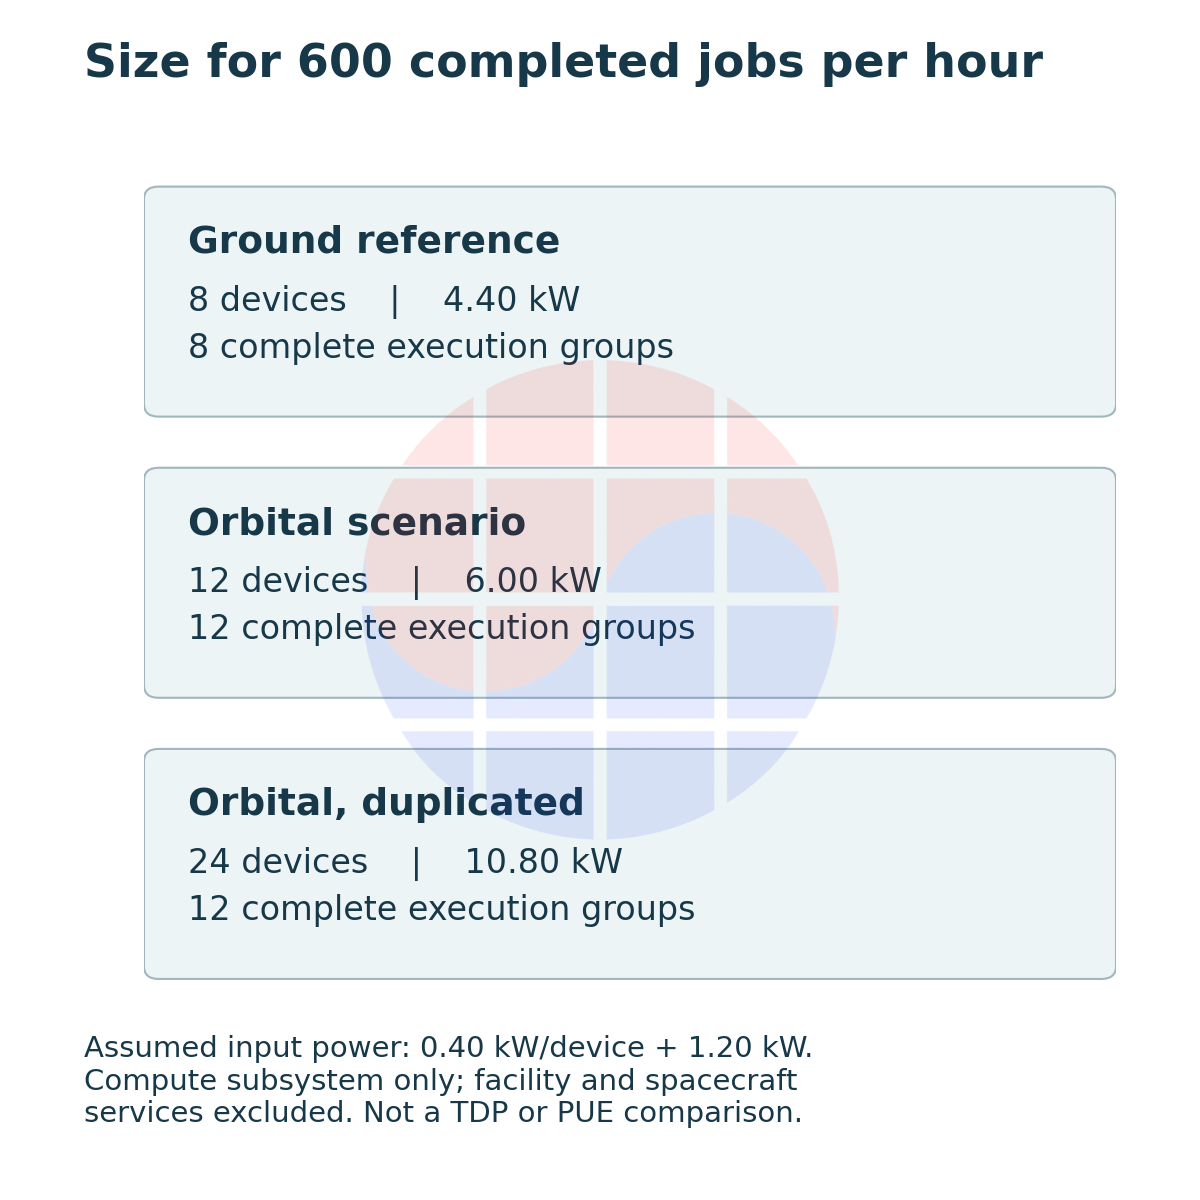
목표를 600건/시간으로 고정하면 지상 예제는 8개, 궤도 예제는 12개가 필요하다. 모든 작업을 2개씩 중복 실행하는 경우에는 12개 그룹, 즉 24개가 필요하다. 장치 수를 실수로 계산한 뒤 반올림하는 대신, 동시 실행 그룹이라는 배치 단위를 올림해야 한다.
전력도 같은 경계에서 계산한다. 이 예제에서는 장치당 평균 0.40 kW와 host·메모리·통신·변환 손실을 합친 고정 1.20 kW를 가정한다. 연산 서브시스템의 입력 전력은 순서대로 4.40 kW, 6.00 kW, 10.80 kW다. H100의 TDP를 대입한 측정 결과가 아니다.
이 경계에는 지상 시설 냉각과 위성의 자세 제어·추진·태양전지·저장장치 전체가 들어 있지 않다. 따라서 이 세 숫자는 비용 비교의 입력이지 지상과 우주의 전력비 또는 PUE 비교가 아니다. 부하와 함께 증가하는 host·네트워크 전력을 고정값으로 둔 단순화도 실제 설계에서는 풀어야 한다.
12개를 장착해도 보드가 공급할 수 있는 전류나 방열 경로가 8개 기준에 머물면 목표는 달성되지 않는다. 전력 제한으로 각 장치의 작업 속도가 낮아지면 처음 가정한 시간당 100건부터 다시 측정해야 한다. 장치 추가와 시스템 용량의 증가는 같은 사건이 아니다.
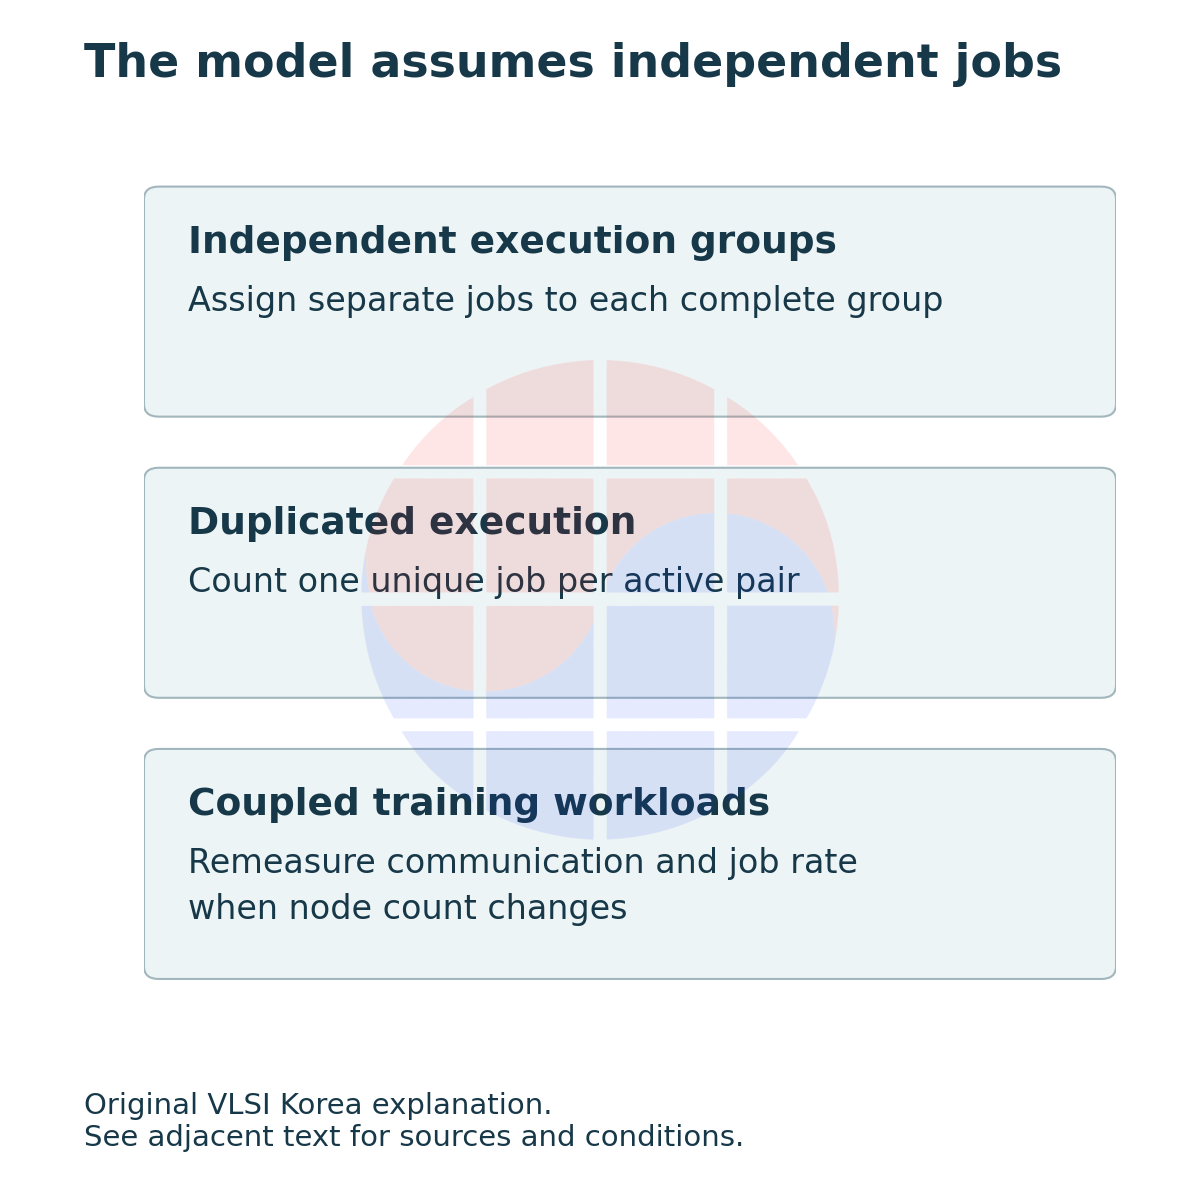
확장성에도 조건이 있다. 이 계산은 서로 독립적인 작업을 여러 그룹에 분배하는 경우다. 노드 사이에서 빈번히 결과를 모으는 학습 작업이라면 통신 준비 비율 f가 노드 수에 따라 바뀔 수 있다. 8개에서 얻은 값을 24개로 복사하면 확장 손실을 감춘다.
경제성 검토는 여기서 더 나아가야 한다. 임무 수명 동안 완료한 작업량에 발사·차폐·열수송·방열판·발전·저장장치·지상국·교체 비용을 연결해야 한다. 소프트웨어를 업데이트하는 것과 고장 난 보드를 교체하는 것은 다른 수명 관리 수단이다. 특정 출시 연도나 발사 단가 하나로 손익분기점을 고정할 수 없는 이유다.
7. 한국 공급망이 확인할 것은 제품명보다 통합 증거다
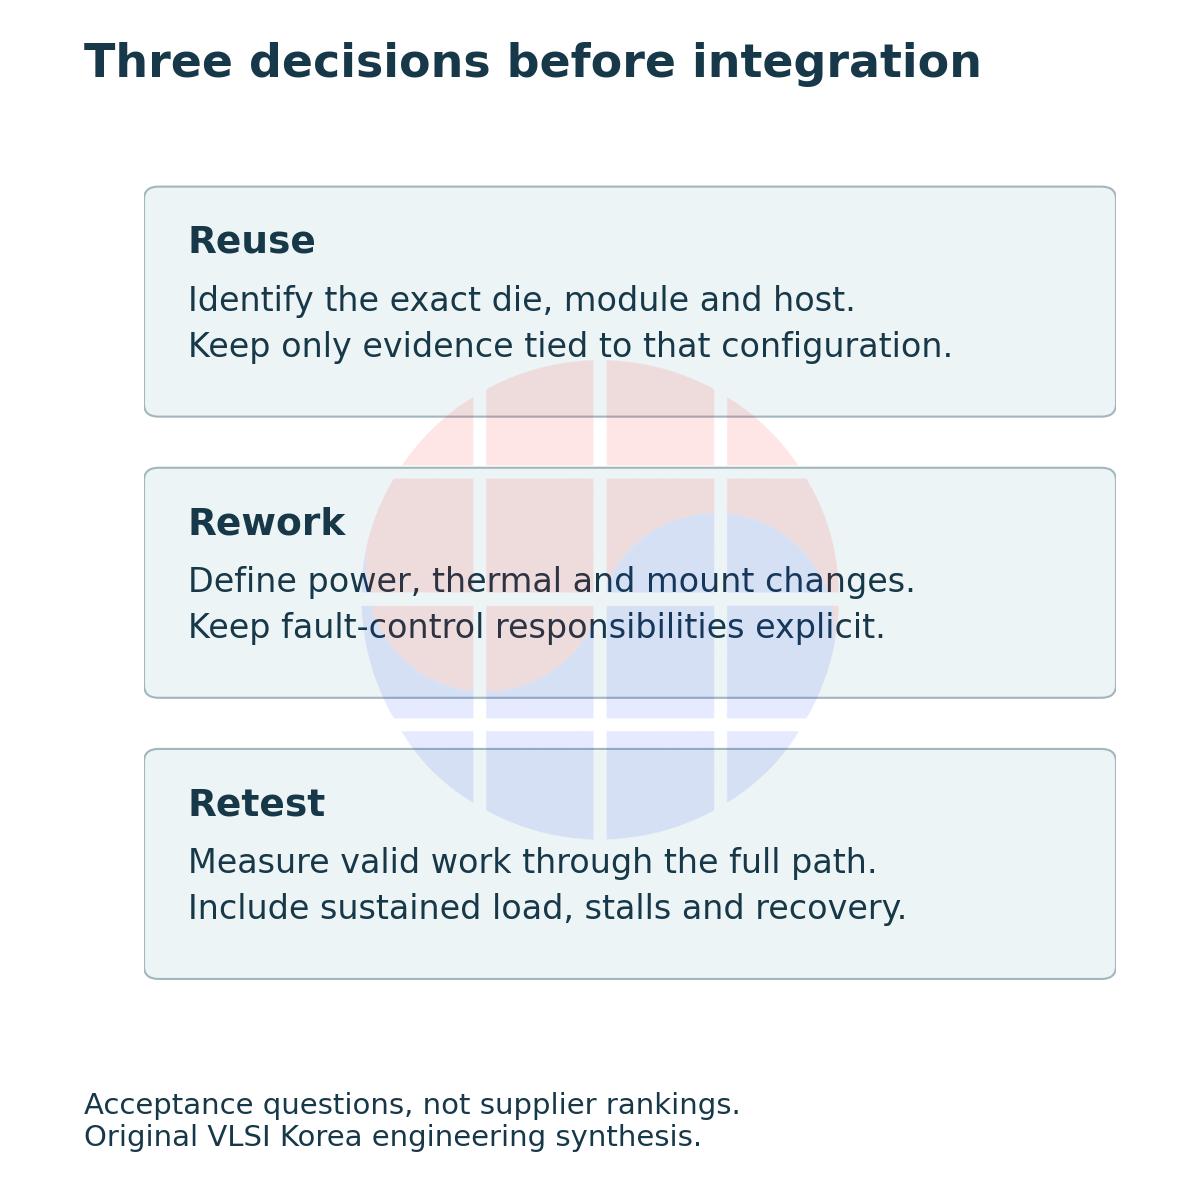
한국의 메모리·패키징·보드·전력 설계팀에는 각자의 인수 질문이 생긴다. 메모리는 특정 부품과 조건의 오류 관측, 패키지는 기계·열 접점의 내구성, 전원은 고장 격리와 재기동 순서를 설명해야 한다. 이것은 기술별 참여 조건이며 특정 기업의 납품이나 매출을 확인한 목록은 아니다.
구매 검토에서는 먼저 후보가 다이인지 모듈인지 완성 노드인지 확인한다. 그 다음 정상 성능표와 임무 시험 보고서가 동일한 구성인지 연결한다. HBM 종류, 전력 제한, firmware 또는 host가 달라지면 어떤 결과를 재사용할 수 있는지 공급자와 합의해야 한다.
NVIDIA의 2026-03-16 Space-1 발표는 우주 연산용 CPU·GPU 통합 모듈의 방향을 보여준다. 당시 가용성 문구는 추후 공급이었고, 공개된 최대 25배 AI 연산 주장은 공급자의 비교다. 이를 동일 정밀도·동일 소비전력의 궤도 실측 처리량으로 바꾸어 쓰지 않는다.
반대 관점도 명확하다. 임무가 짧고 작업이 독립적이며 필요한 열·전원·복구 여유가 확보된다면, 상용 칩을 유지하는 편이 새 다이를 개발하는 것보다 합리적일 수 있다. 반대로 복구가 불가능한 공통 고장이나 처리 기한 위반이 지배적이면 높은 peak 성능은 선택을 정당화하지 못한다.
앞으로 6-12개월에 볼 항목은 장치의 단순 발사 횟수가 아니다. Suncatcher의 실제 환경 데이터, 가속기와 메모리의 오류·복구 기록, 지속 부하에서의 전력과 온도, 링크가 막힐 때의 완료 작업량이다. VLSI Korea의 다음 검토 기준일은 2027-04-06과 2027-10-06이며 업체의 출시 약속을 뜻하지 않는다.
처음 질문으로 돌아가면, 지상용 GPU를 우주에 가져갈 수는 있다. 그러나 ‘그대로’의 범위는 계약과 시험으로 정해야 한다. 칩의 재사용을 출발점으로 두고, 유효 출력까지의 전원·열·통신·복구 경로를 같은 작업 조건에서 비교하는 것이 설계의 다음 단계다.
출처와 근거 범위
근거 기준일은 2026-10-06이다. 본문의 링크는 원제조사·임무 운영자·NASA·연구 원문으로 이어진다. 발사·교신과 실증은 발표 주체에 귀속했고, 공개되지 않은 비행 SKU와 장기 상용 가용성은 추정하지 않았다. 방사선 수치는 명시한 2025년 시험 범위이며 새 발사체 전체의 인증 수치가 아니다.
1편 SpaceX·Starlink의 공개된 칩을 구분하는 법은 채택 근거를, LEO 메모리 신뢰성은 오류 수리와 상태 복구를 더 깊게 다룬다. 이 글의 자체 도식과 계산은 시스템 변경 범위와 동일 작업량 비교를 위해 새로 구성했다.
AI가 공개 자료 조사, 초안과 자체 도식 제작을 보조했다. 모든 시나리오 입력은 설명용 가정이며 실제 제품·임무의 벤치마크가 아니다.
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.