 VLSI Korea
LEO 메모리 신뢰성: ECC·scrubbing·checkpoint를 함께 설계하는 법
ECC만으로 끝나지 않는 LEO 메모리 복구 설계. 가정 기반 계산과 원출처 도판으로 scrub deadline, 보호 map, checkpoint validity를 연결한다.


LEO 컴퓨터의 메모리 신뢰성은 ECC 유무보다, 오류를 고칠 시간과 믿고 돌아갈 상태를 함께 보장하는지에 달려 있다. ECC는 codeword를 보호하고 scrubbing은 누적 오류를 줄인다. Checkpoint는 계산을 되돌린다. 세 기능의 이름을 나란히 적었다고 하나의 복구 시스템이 되지는 않는다.
VLSI Korea view: 데이터 수리, 오류 확산 차단, 유효 상태 복구를 별도 budget으로 잡자. 평균 scrub 주기보다 최악의 재방문 시간과 복구 경로의 공통 고장점을 먼저 확인해야 한다.
이 글은 메모리 대역폭을 배분하는 설계자와 fault-injection 시험을 설계하는 검증 엔지니어를 위한 reference다. 실제 궤도의 오류율을 추정하지 않고, 가정한 입력으로 설계 선택이 어떻게 달라지는지 계산한다.
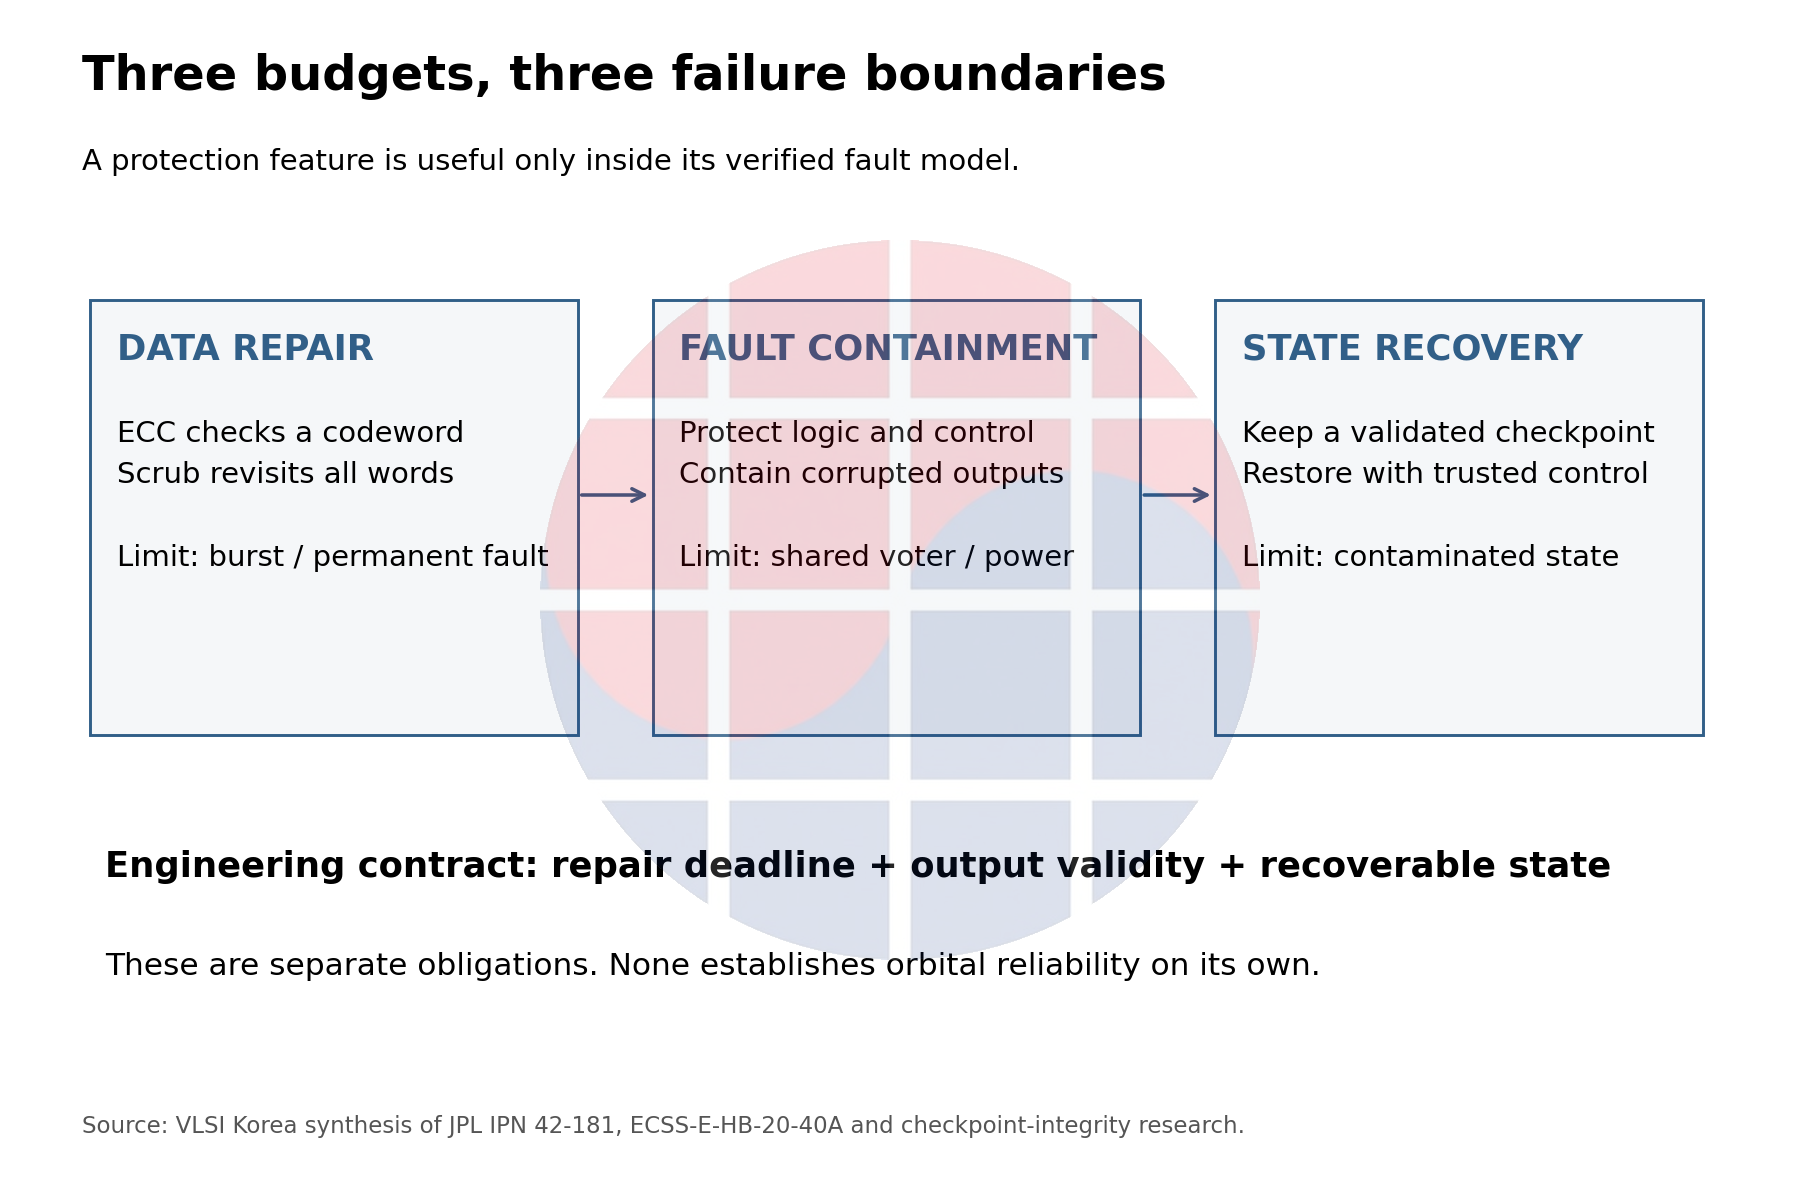
ECC를 붙인 뒤에도 남는 세 가지 책임
ECC는 저장한 데이터와 검사 비트 사이의 관계를 이용해 오류를 검출하거나 정정한다. 어느 오류까지 처리하는지는 선택한 code에 달렸다. SECDED라는 이름도 모든 다중 비트 오류를 안전하게 처리한다는 뜻은 아니다.
읽는 순간 값을 정정하는 것과 메모리 셀에 올바른 값을 다시 써 놓는 것도 다르다. 사용하지 않는 주소에 남은 오류는 다음 접근까지 계속 머물 수 있다. Scrubber는 주소를 순회하며 읽기·검사·필요한 재기록을 수행해 그 노출 시간을 제한한다.
JPL의 ECC 평가가 구분하듯, 영구적인 결함은 정정 가능한 soft error와 다르다. 반복 재기록으로 셀의 물리적 결함을 없앨 수는 없다. 반복 오류 주소를 어떻게 격리할지, spare와 retirement를 누가 관리할지는 별도 설계 결정이다.
또 다른 축은 제어 상태다. FPGA configuration memory가 틀리면 데이터만 바뀌는 것이 아니라 데이터가 지나가는 논리 자체가 바뀔 수 있다. RAM ECC가 정상이어도 주소 생성기, voter, reset 제어 또는 버스 상태가 틀리면 정정된 데이터가 엉뚱한 곳으로 갈 수 있다.
마지막 책임은 복구다. 오류를 발견했을 때 재시작할 수 있다는 말에는 부팅 코드, 상태 저장소, 복구를 지시하는 제어기와 전원이 살아 있다는 전제가 숨어 있다. 세 budget을 분리하는 이유는 담당 팀을 늘리려는 것이 아니다. 하나의 시험 결과로 서로 다른 책임까지 통과했다고 오해하지 않기 위해서다.
Scrub timer가 아니라 sweep 완료 시간을 계산하자
여기서는 payload 1 GiB, 데이터 64 bit에 ECC 8 bit를 붙인 72-bit codeword를 가정한다. Codeword 수 N은 134,217,728개다. 비트당 사건 발생률 λ는 1e-10 /s로 가정하며, 이는 특정 메모리나 궤도의 측정값이 아니다.
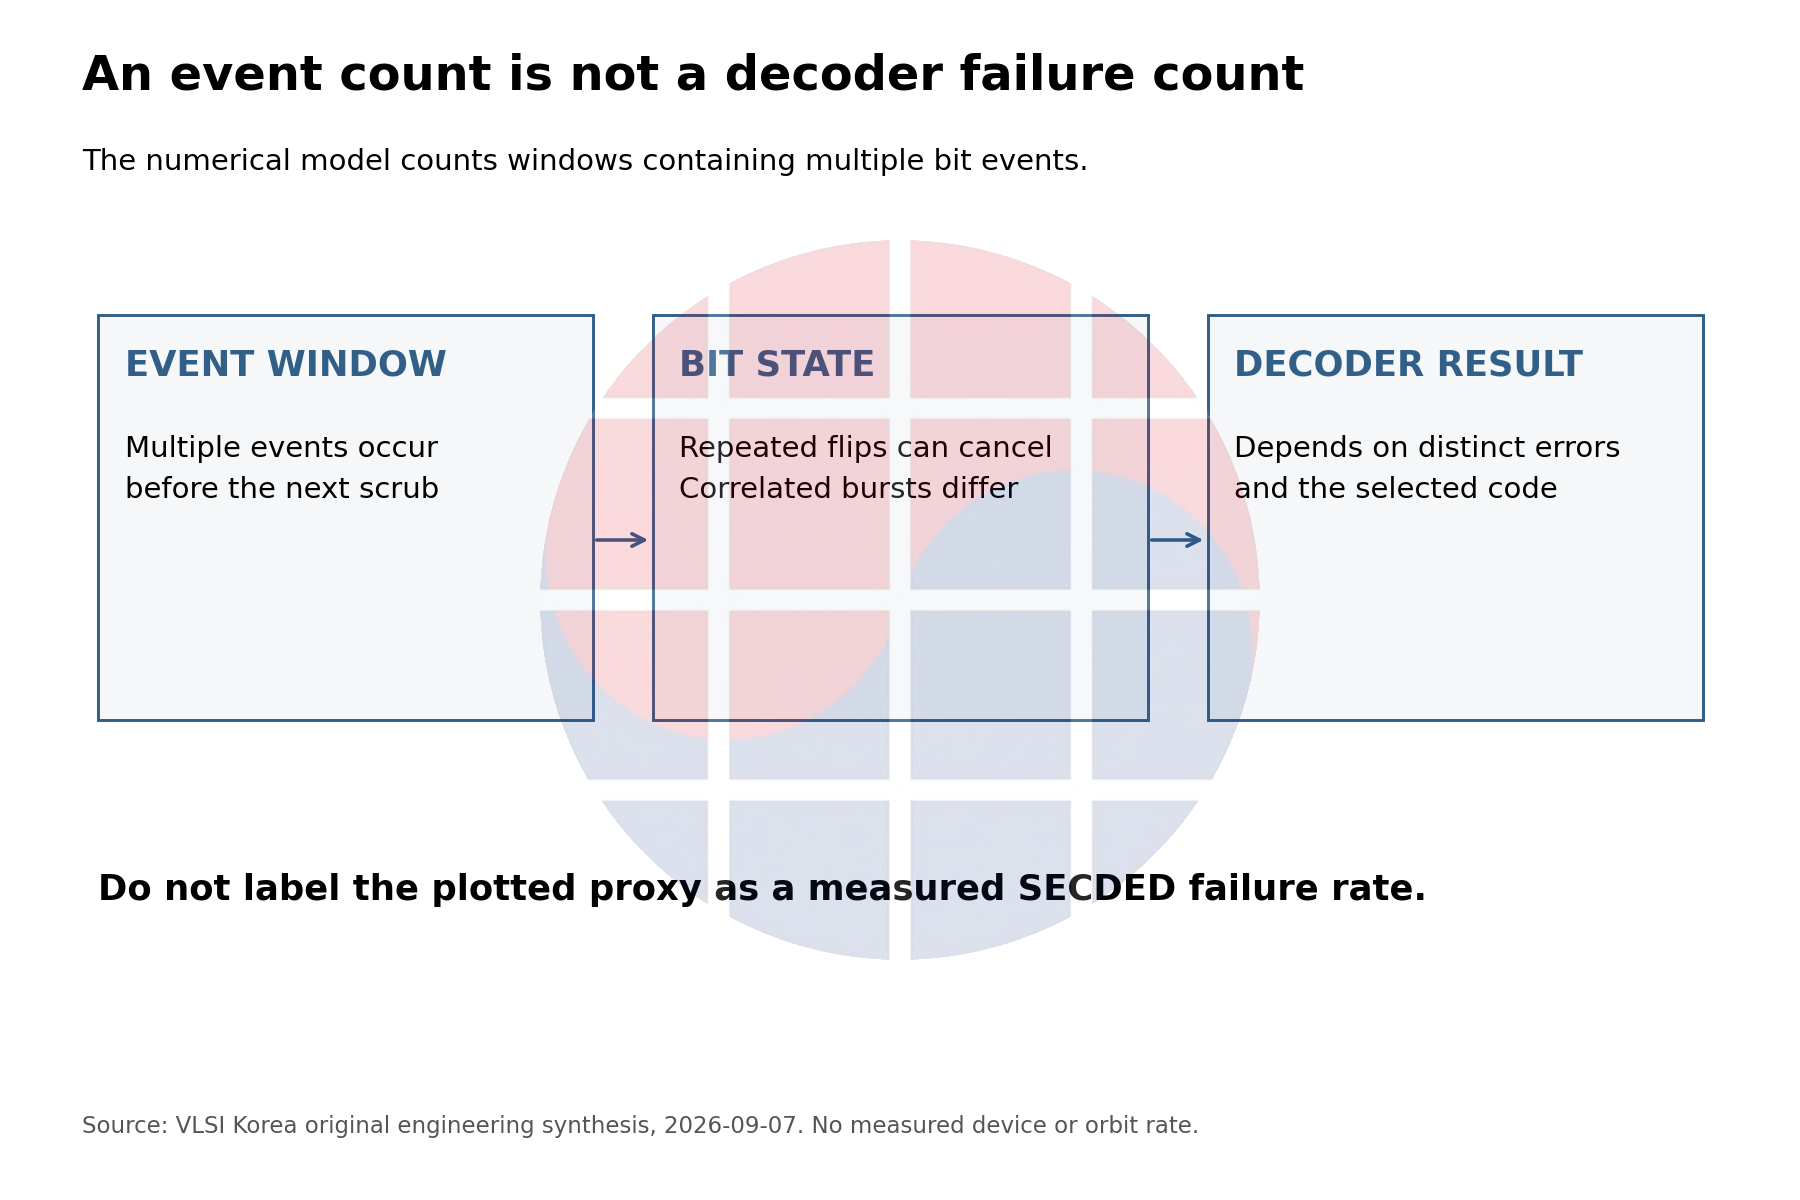
각 비트 사건이 독립인 Poisson 과정이고 모든 codeword가 정확히 T초마다 검사된다고 하자. 한 codeword의 구간당 기대 사건 수는 μ = 72 × λ × T다. 그 구간에서 사건이 두 번 이상 발생할 확률은 1 − exp(−μ) × (1 + μ)로 계산한다.
이 확률에 N × 86400 / T를 곱하면 하루의 다중 사건 노출 구간 기대값이 나온다. 이것을 SECDED failure rate라고 부르면 안 된다. 같은 비트가 다시 뒤집혀 취소되는 경우도 포함하기 때문이다. 상관된 burst나 영구 오류도 이 모델에 들어 있지 않다.
T를 60, 600, 3600초로 두면 기대 구간 수는 각각 하루 0.018, 0.180, 1.082다. 이 값은 사고가 그만큼 반드시 발생한다는 뜻이 아니라 가정한 확률 모형의 비교 지표다. 작은 μ 범위에서는 주기를 줄이면 누적 사건에 노출되는 창도 대체로 비례해 줄어든다.
대신 payload를 전부 읽는 데 필요한 최소 대역폭은 각각 17.067, 1.707, 0.284 MiB/s다. 실제 버스에서는 ECC 전송, command, turnaround와 오류 정정 writeback이 더해진다. 이 수치가 작아 보인다고 여유 대역폭에서 언제든 처리할 수 있다는 결론은 나오지 않는다.
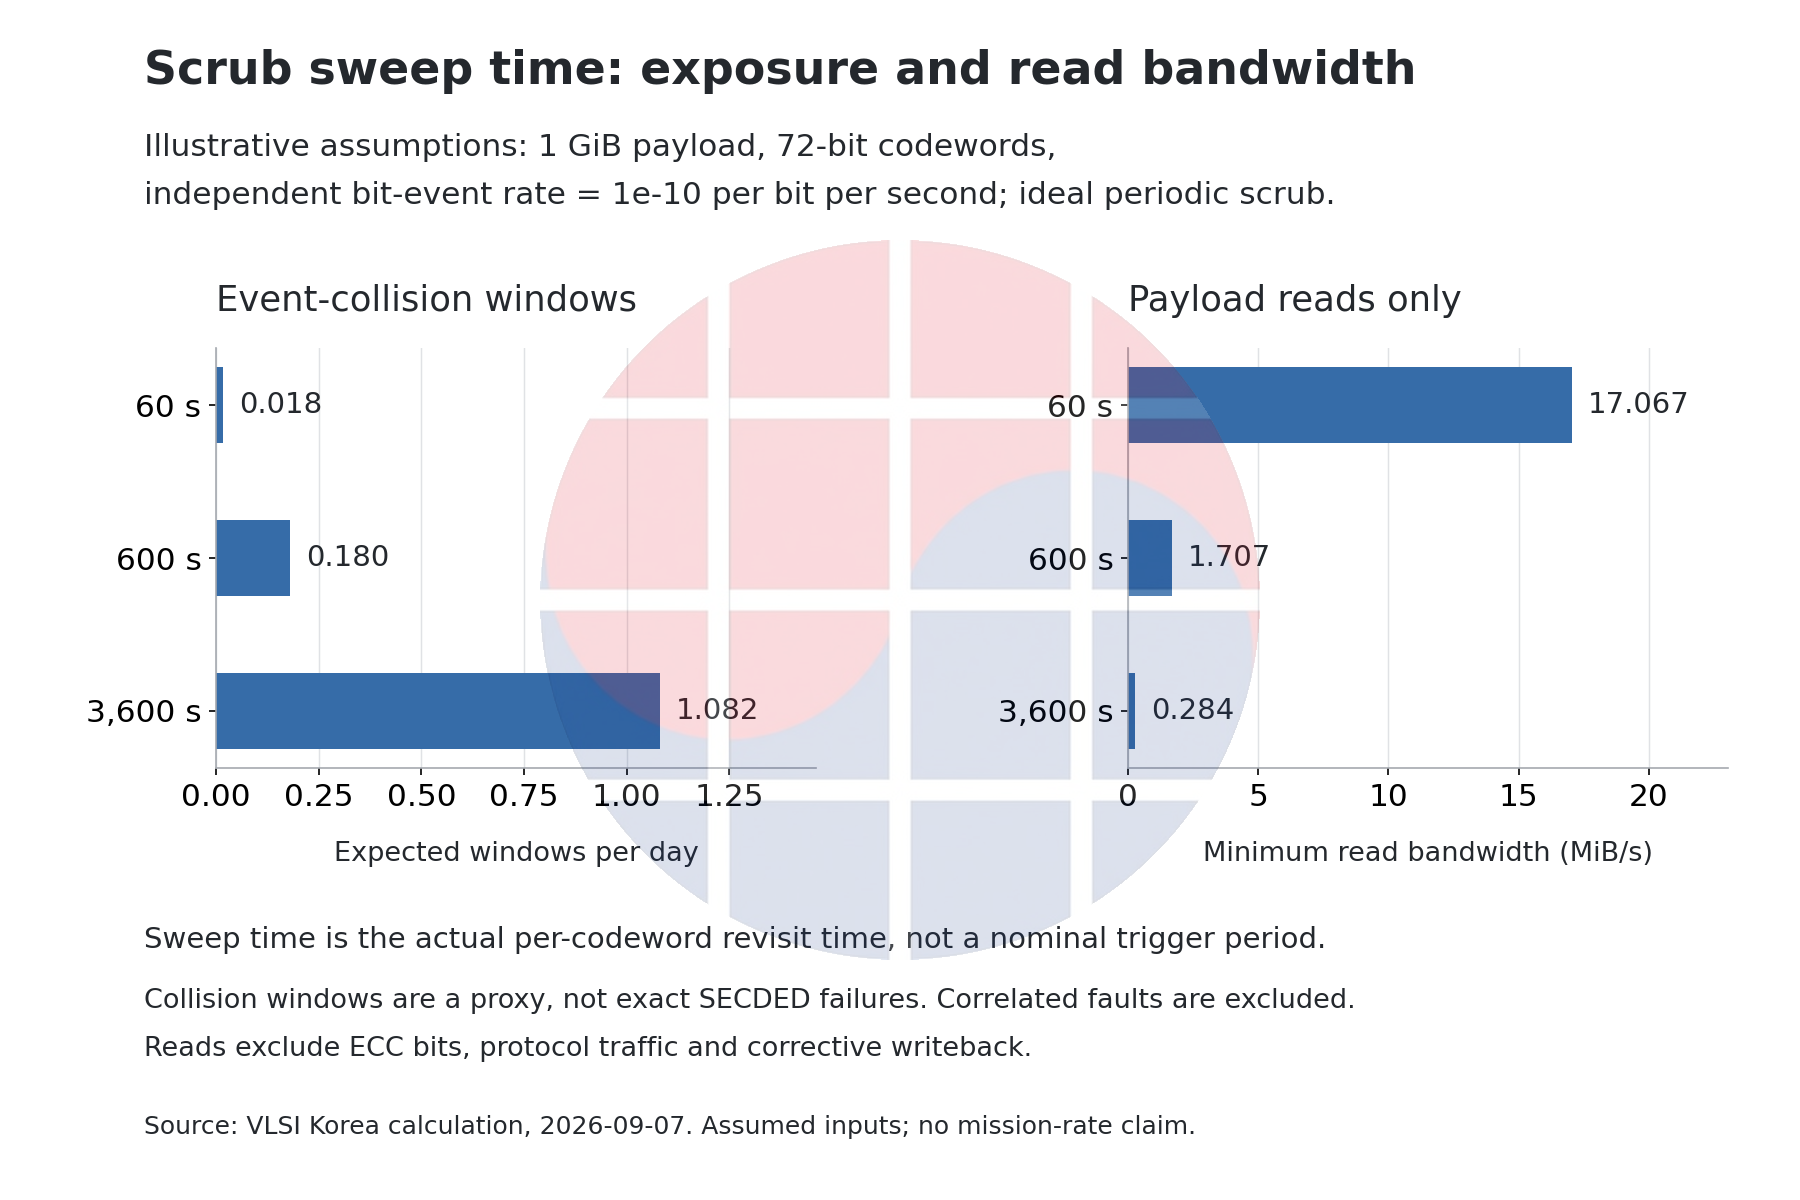
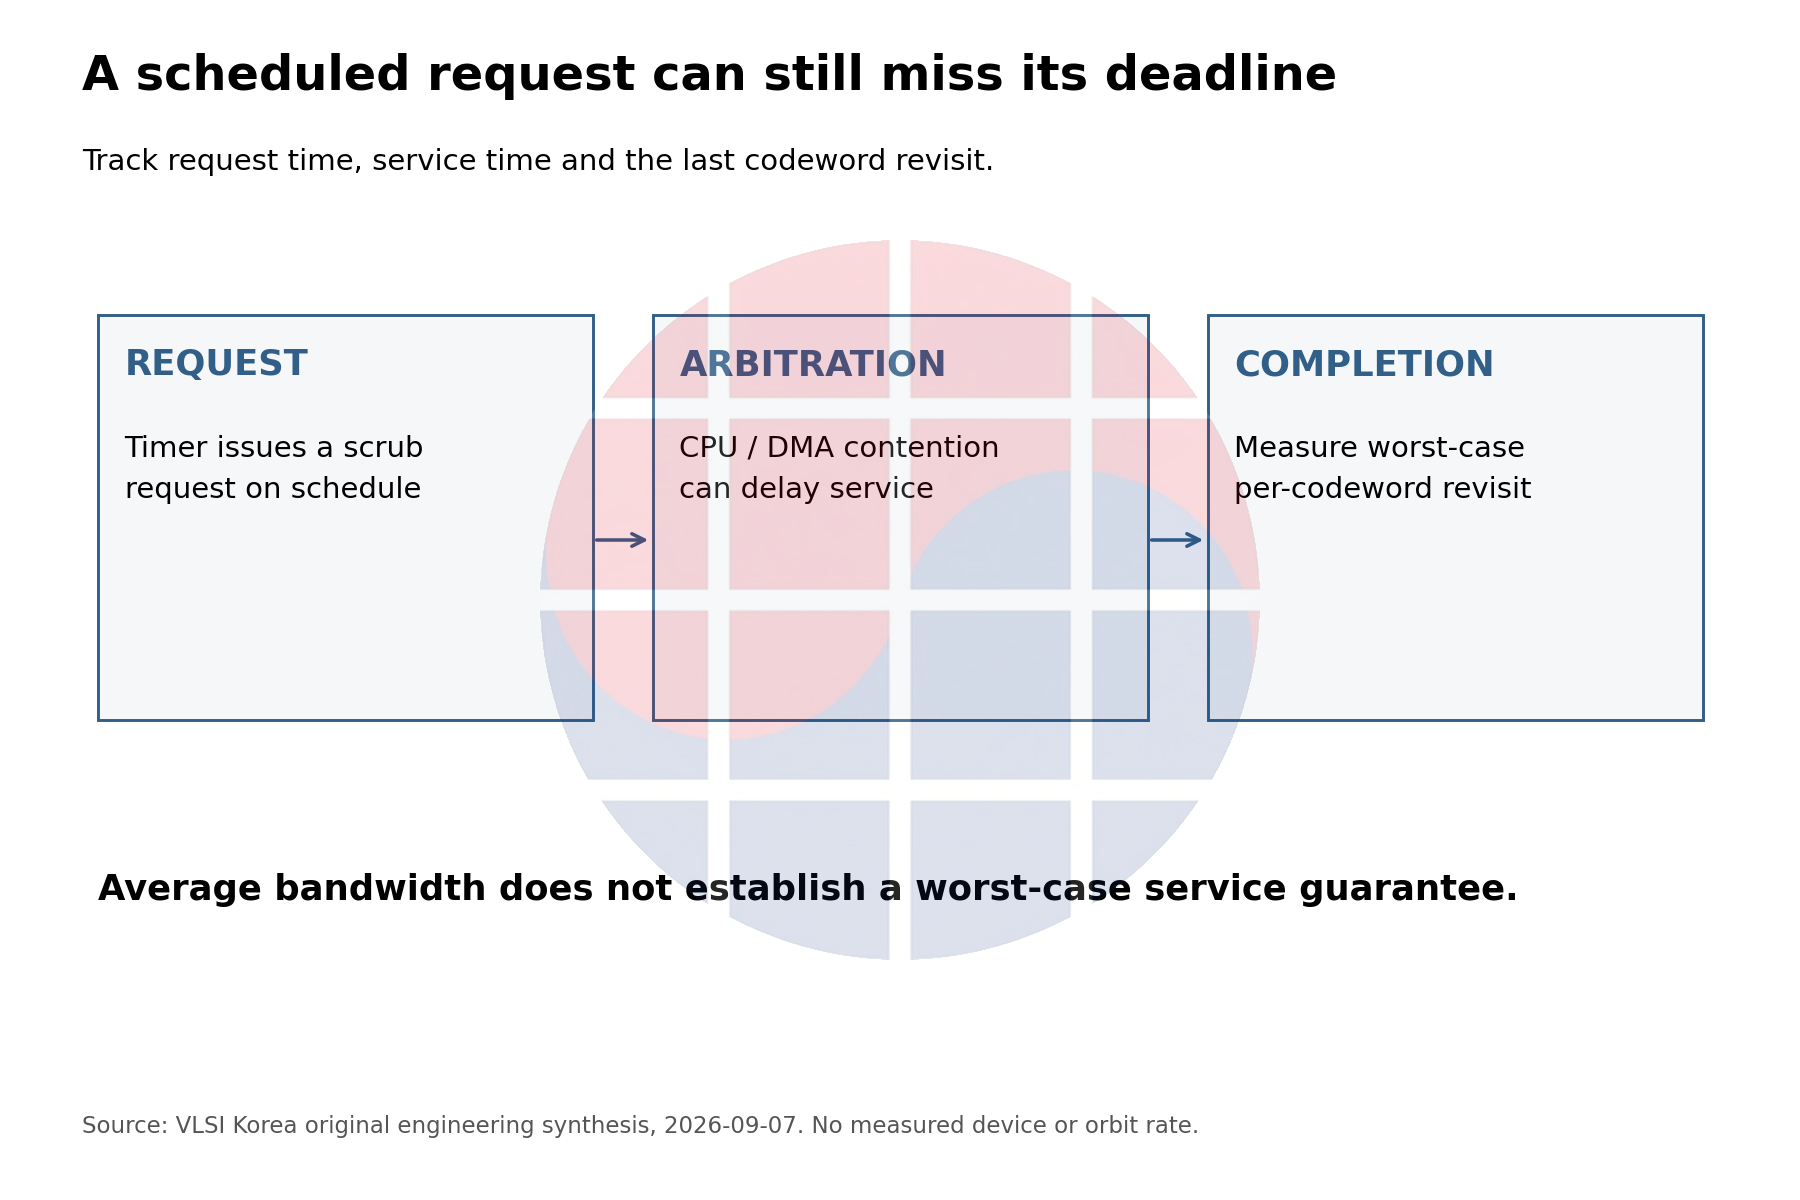
일감이 몰리는 순간이 문제다. Timer가 제때 요청을 넣어도 DMA와 CPU 접근에 계속 밀리면 주소 재방문은 늦어진다. 보고서에는 요청 주기, 전체 sweep 완료 시간, 가장 늦게 다시 검사한 codeword의 시간을 구분해 남겨야 한다. 평균을 하나만 남기면 가장 위험한 주소가 통계에서 사라진다.
또한 서로 다른 주소가 똑같은 T를 갖지 않는 구현에서는 위의 균일 주기 계산을 그대로 적용하지 않는다. 주소별 또는 region별 재방문 분포와 최댓값을 먼저 측정해야 한다. 긴 꼬리를 가진 arbitration 지연을 단순 평균으로 바꾸는 순간 보호 수준이 과장될 수 있다.
메모리 범위를 줄일 때는 수명도 함께 관리해야 한다
전체 RAM 대신 실제 쓰는 region을 집중적으로 순회하면 읽기 트래픽을 줄일 여지가 생긴다. DFT 2025의 application-profiled RAM scrubbing 연구는 응용의 메모리 사용 정보를 scrubber의 register 설정으로 연결한다. FPGA 합성과 simulation·fault injection 결과이며, 실제 LEO 방사선 시험 결과로 옮겨 읽을 수는 없다.
여기서 설계자가 추가로 물어야 할 것은 map의 유효 기간이다. 연구의 시작 시점 allocation 전제를 runtime의 자유로운 재할당까지 확장하면 안 된다. Heap이 늘고 stack이 깊어지거나 DMA buffer의 소유권이 바뀔 때도 보호 대상 주소가 빠짐없이 등록되는지 따로 검증해야 한다.
VLSI Korea가 제안하는 수명 계약은 단순하다. 새 live region은 사용 전에 보호 map에 들어가야 하고, 반환한 region을 빼는 시점은 아직 남아 있는 접근과 충돌하지 않아야 한다. 이 절차를 구현하지 못하면 workload를 고정하거나 전체 범위를 검사하는 대안을 택한다.
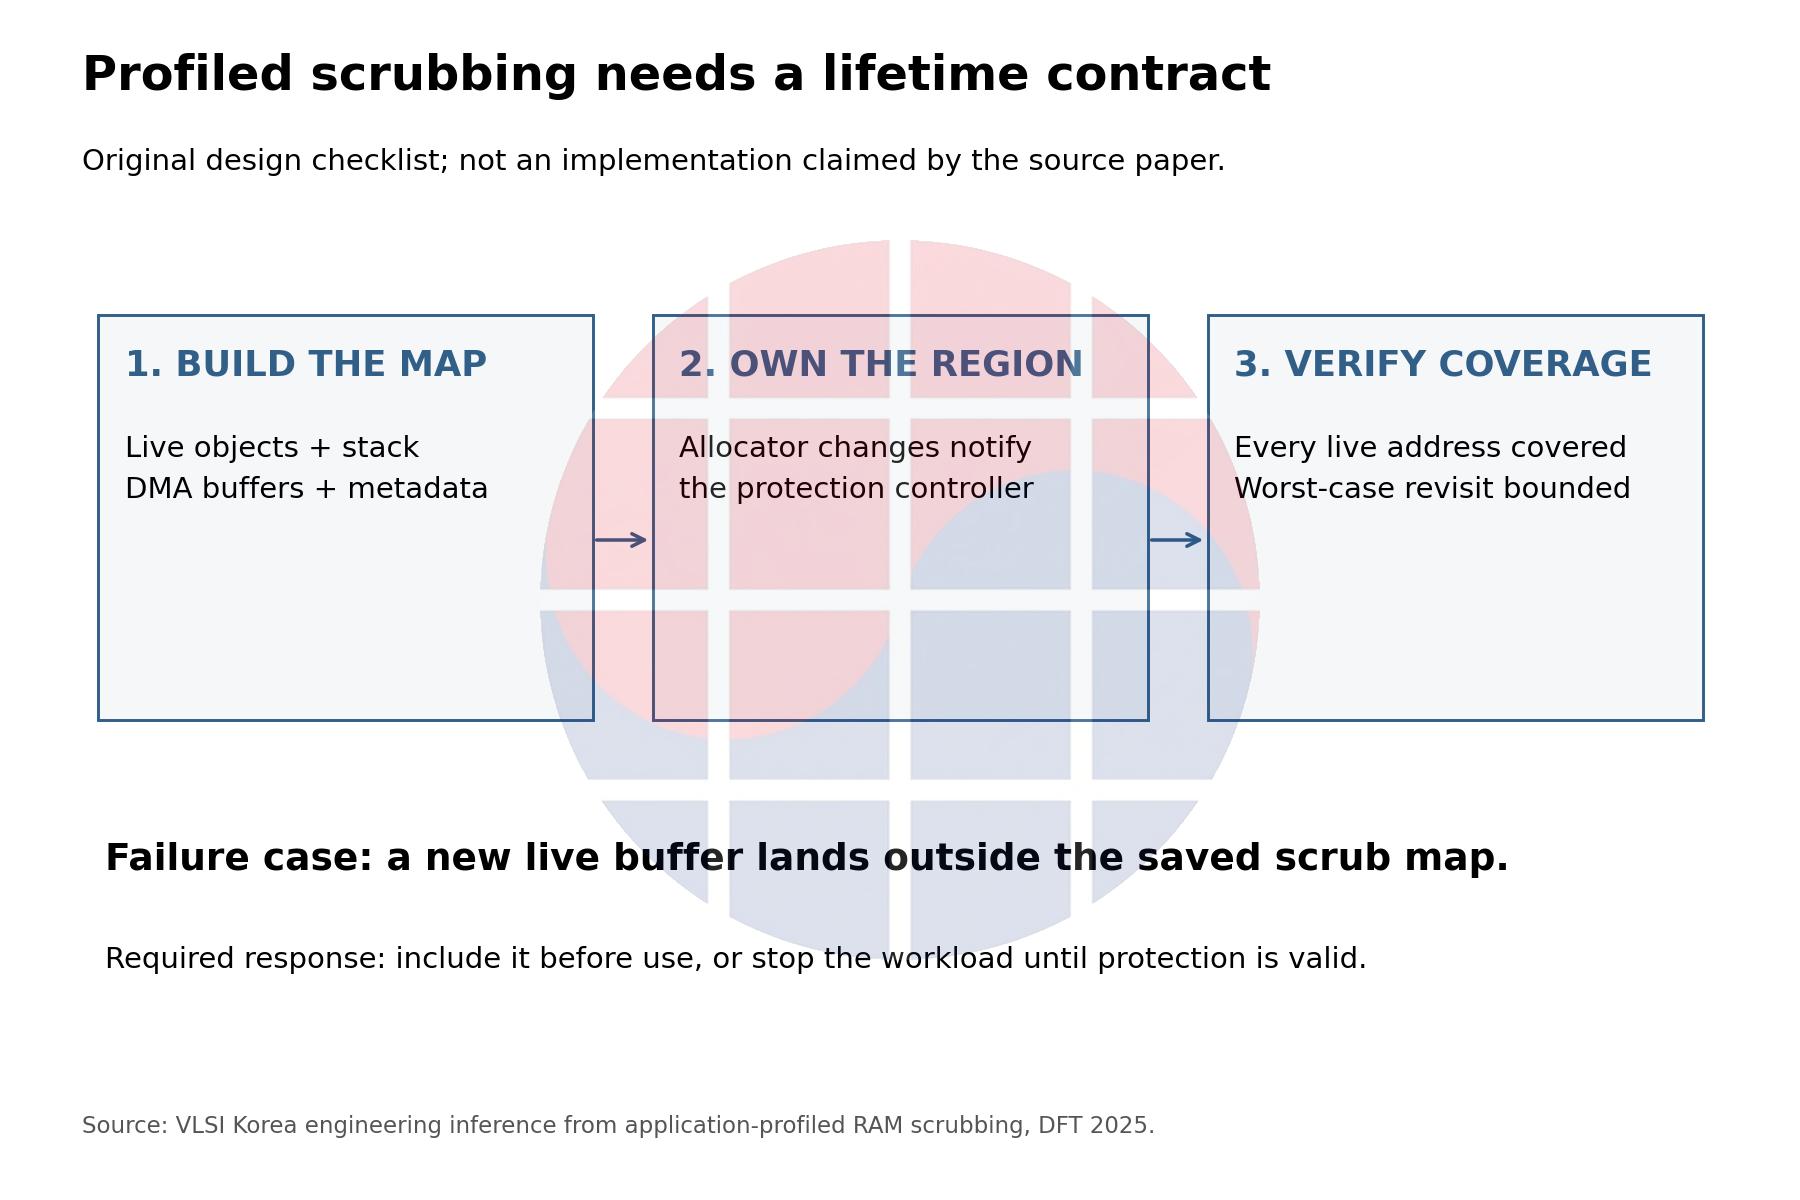
Stack과 allocator metadata는 사용량 표에서 작아 보일 수 있지만, 손상됐을 때의 영향도 작다는 뜻은 아니다. 보호 대상의 우선순위는 byte 수만이 아니라 오류가 제어 흐름으로 전달되는 경로까지 보고 정해야 한다. 이는 논문의 실험값이 아니라 설계 검토에 적용할 판단 기준이다.
시험도 정상 실행 trace를 한번 재생하는 것으로 끝나지 않는다. 최대 stack 경로, buffer 교체, 재시작 직후 초기화, workload 전환 중 map 갱신을 확인한다. 보호되지 않은 주소를 일부러 만들었을 때 이를 감지하는 시험이 없다면, 좋은 coverage 숫자는 map 밖의 공백을 보지 못한 결과일 수 있다.
Checkpoint 주기는 계산할 수 있지만, 유효성은 별도 증명이다
Checkpoint는 재개에 필요한 상태를 보존해 실패 후 잃는 계산량을 제한한다. 여기서는 작성 시간 C = 0.05초, 복원 시간 R = 2초, 복구 가능한 시스템 사건을 하루 1회로 가정한다. 이 사건률 r은 앞의 비트 사건률과 별개다. 비트 오류를 모두 시스템 재시작으로 세지 않는다.
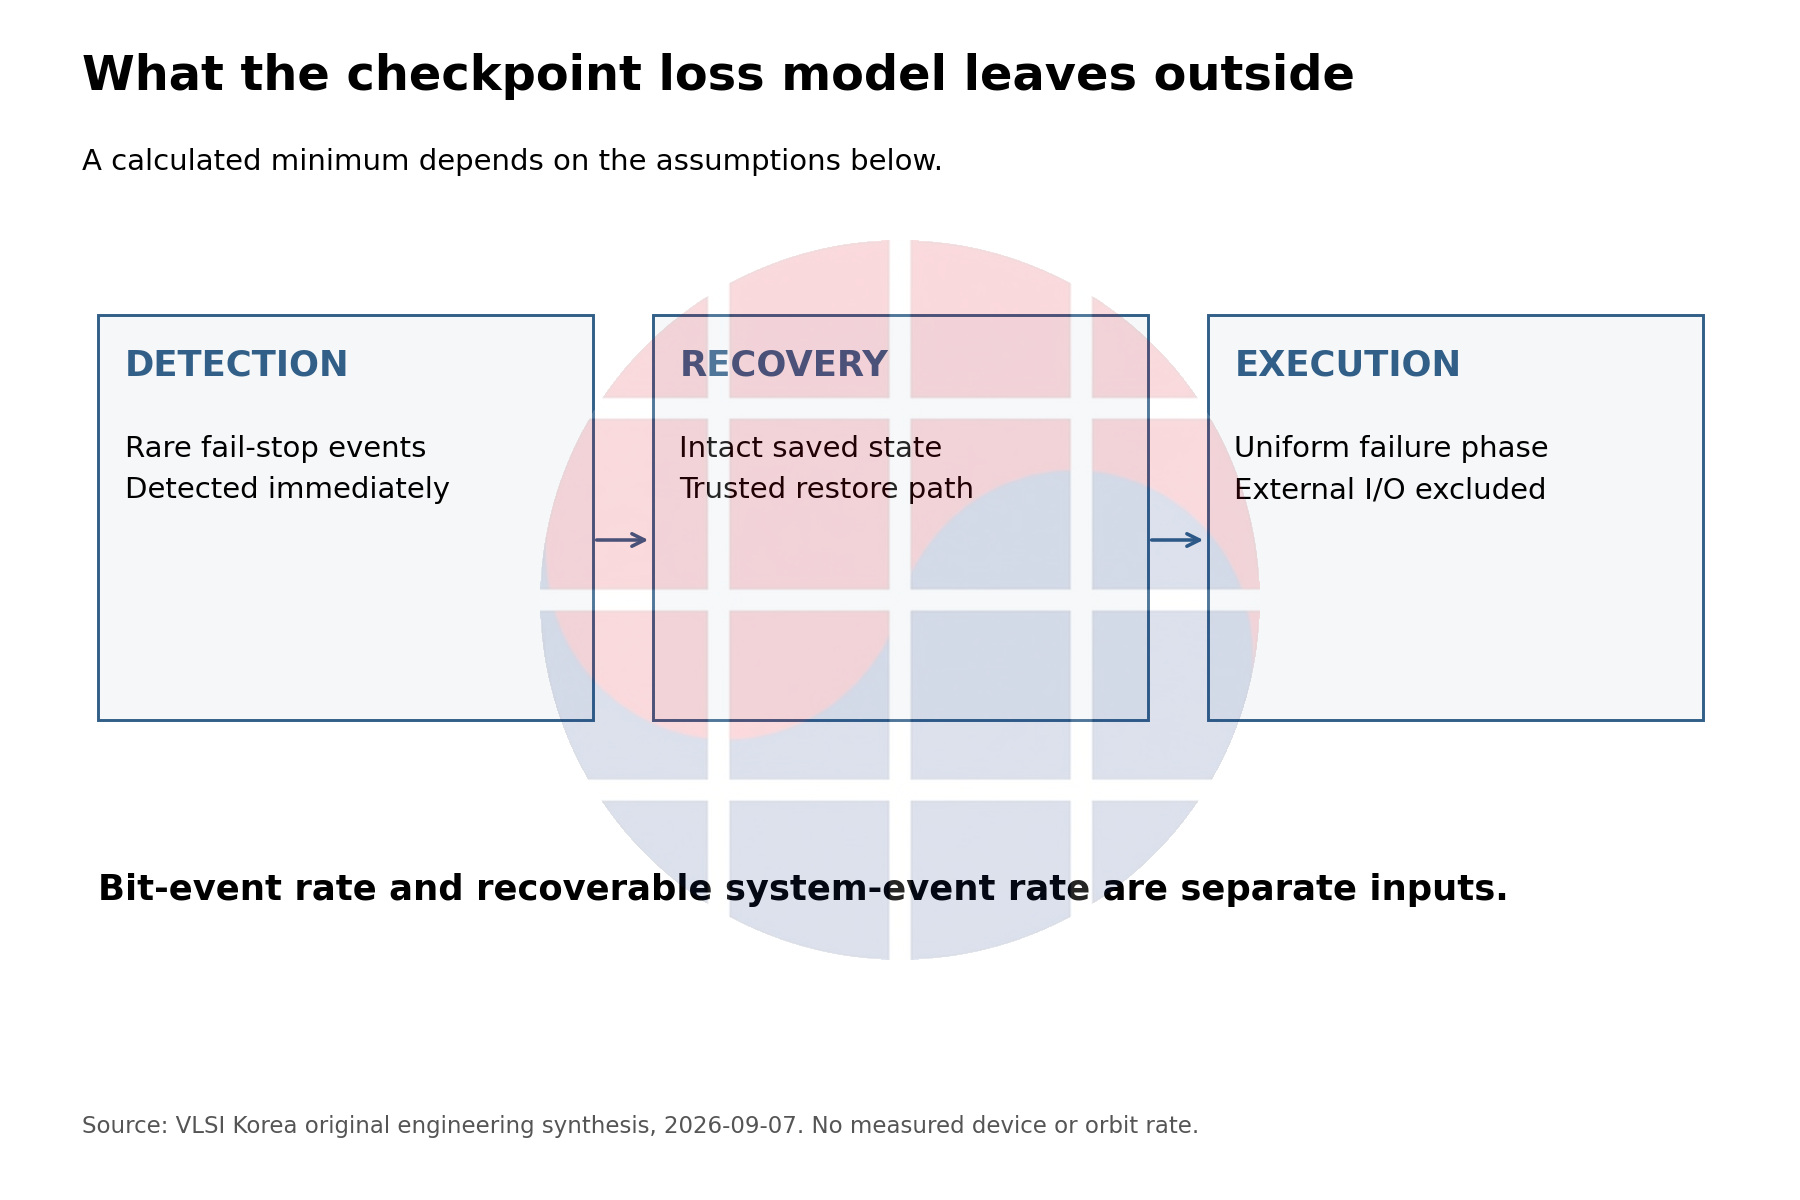
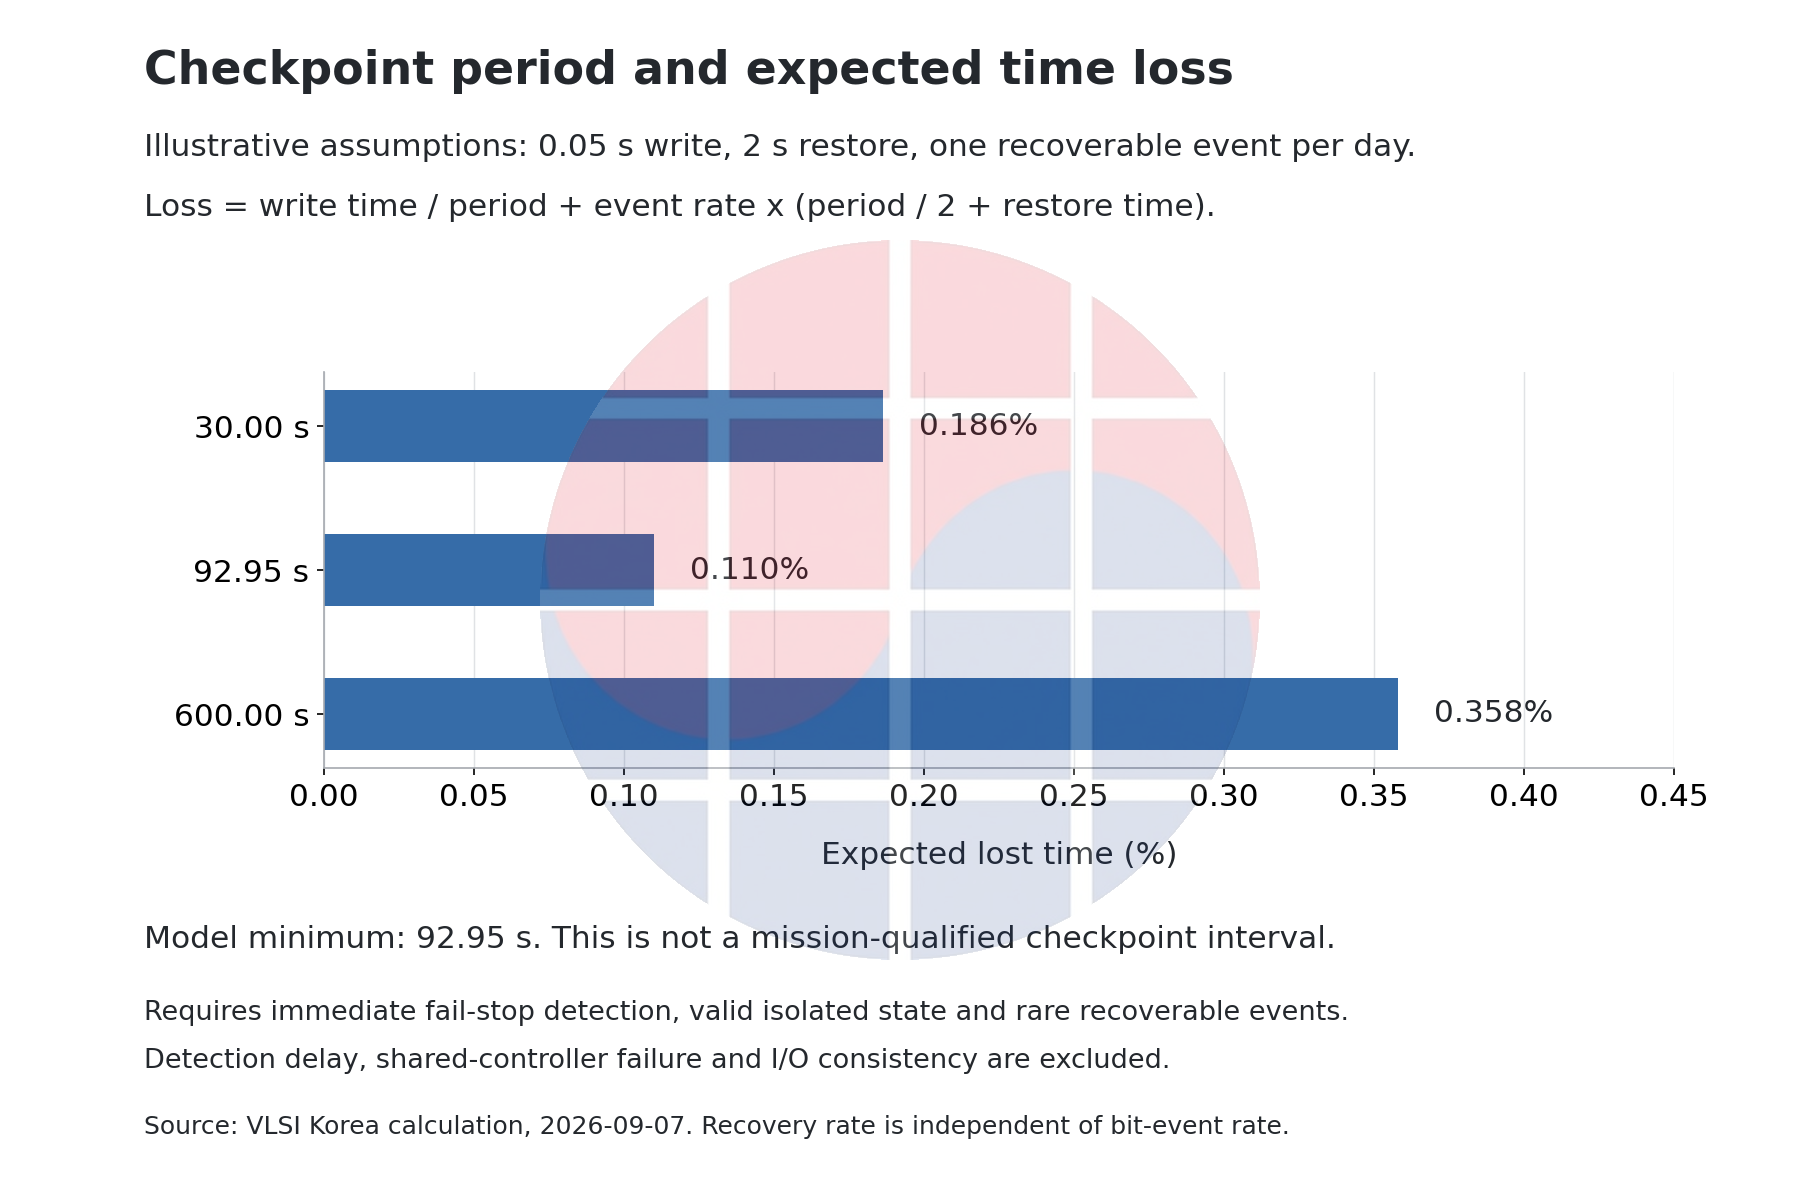
즉시 검출되는 드문 fail-stop 사건, 정상적인 복구 상태, 균일한 실패 시점을 가정하면 잃는 시간의 비율은 C/T + r × (T/2 + R)로 근사할 수 있다. 첫 항은 저장 비용, 뒤 항은 평균 재계산과 복원 비용이다. 미분해 얻는 내부 최솟값은 T = sqrt(2C/r)다.
가정한 숫자를 넣으면 92.95초가 나온다. T가 30, 92.95, 600초일 때 손실 비율은 각각 약 0.186%, 0.110%, 0.358%다. 최솟값을 곧바로 flight software 설정에 넣을 수는 없다. 지연 검출, checkpoint write 중단, 외부 I/O와 공통 제어기 실패가 빠진 계산이기 때문이다.
특히 오류가 발생한 뒤 한동안 발견되지 않는다면, 그 사이 저장한 최신 snapshot이 이미 오염됐을 수 있다. 가장 최근 상태를 고르는 정책은 가장 안전한 상태를 고르는 정책과 다르다. Checksum이 일치해도 잘못된 계산 결과를 정상적으로 저장했다면 의미상의 오류는 그대로 남는다.
On the Integrity of Lightweight Checkpoints의 Theorem 1은 보호된 안정 메모리와 제한된 오류 모델 아래에서 최소 locking interval이 최대 오류 검출 지연보다 엄격히 길어야 한다는 조건을 제시한다. 문서의 연도는 2008이다. 이 조건은 storage와 OS까지 함께 망가지는 상황의 일반 해법이 아니다.
VLSI Korea view: 먼저 “돌아갈 수 있는 상태가 무엇인가”를 정의하자. 그 답이 없는 92.95초는 최적 복구 주기가 아니라, 전제를 충족하지 못한 계산 결과다.
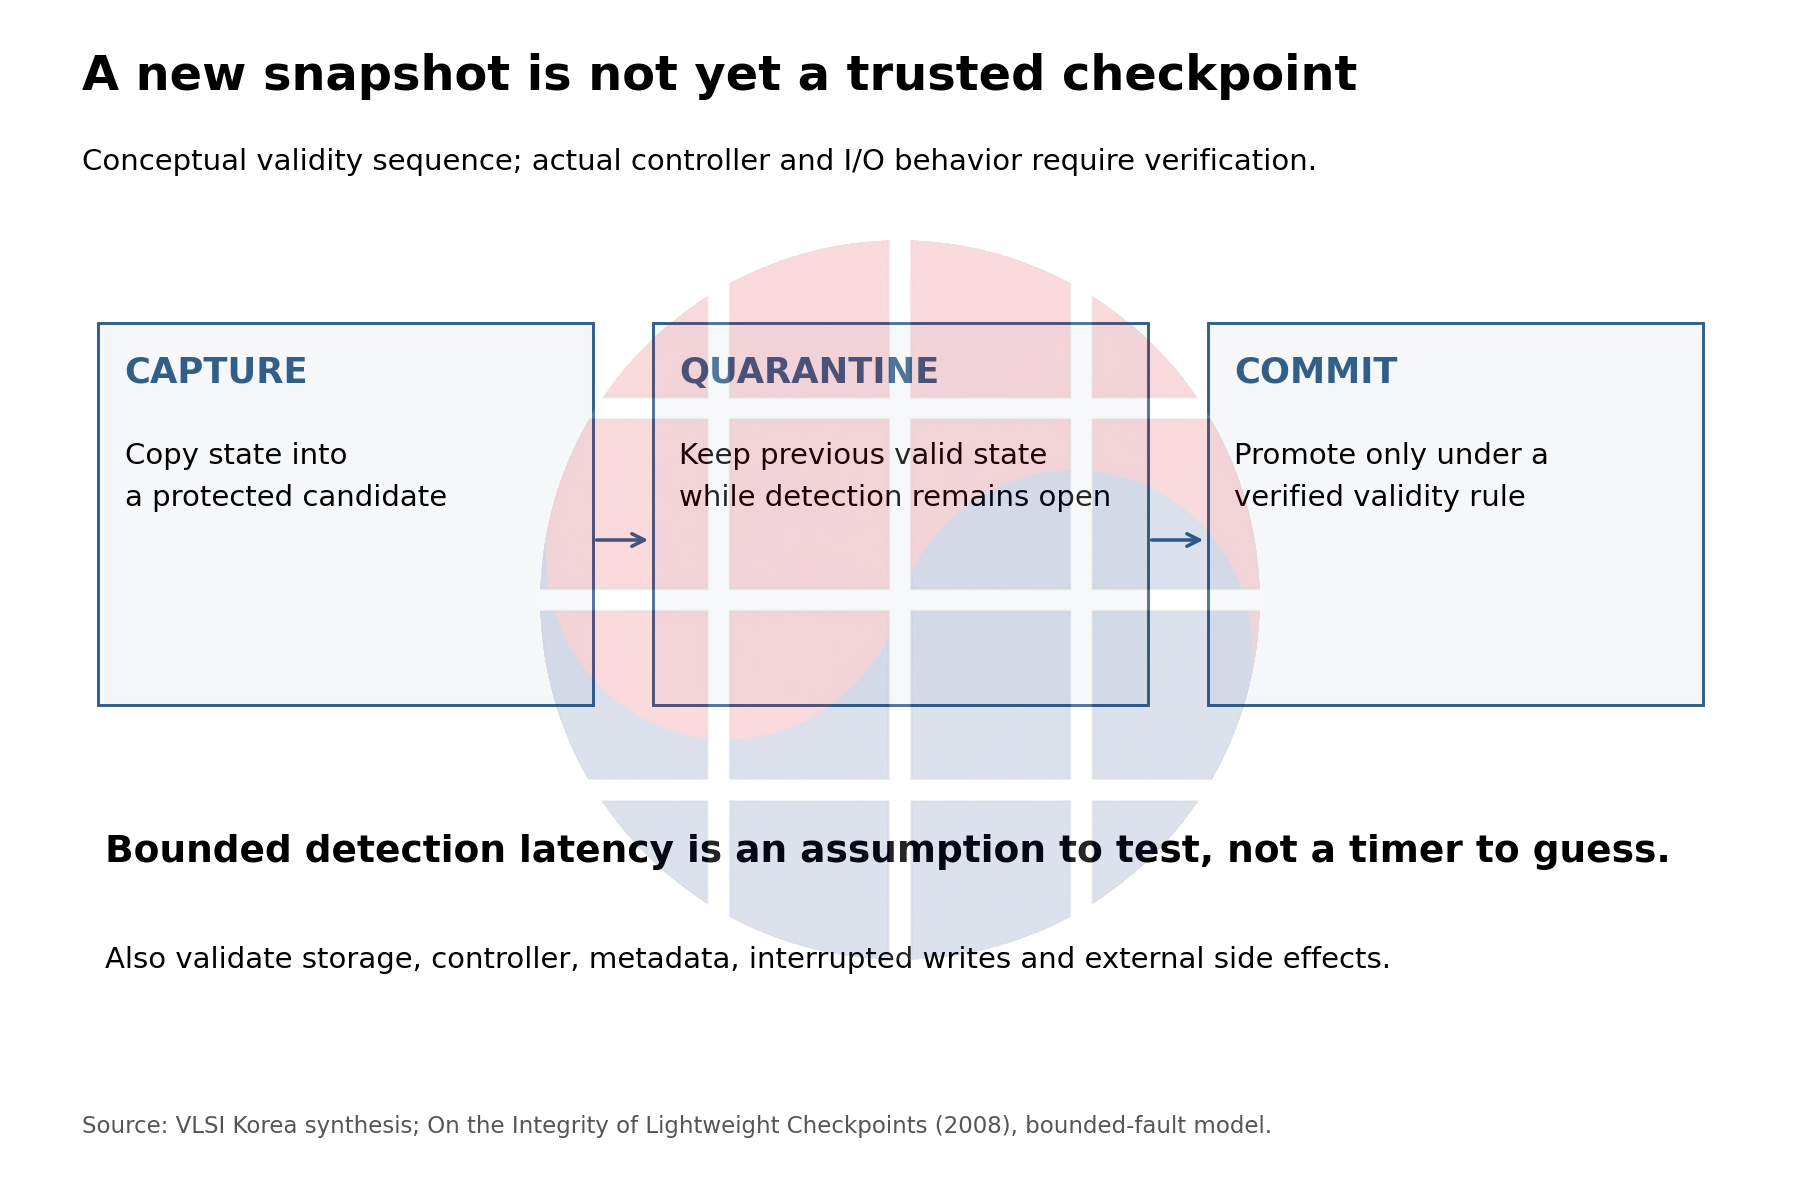
실무에서는 후보 snapshot 생성, 검증 대기, commit을 구분하는 상태 전이가 필요하다. 이전에 유효했던 상태를 언제까지 남길지, metadata update 도중 reset이 오면 무엇을 선택할지, 재실행이 외부 장치에 같은 명령을 두 번 보내도 되는지를 명시한다. 위 도식은 이 검토 항목을 설명하는 개념도이며 특정 논문의 구현을 재현한 것이 아니다.
제어기를 나눴다는 말도 경계조건이 있다
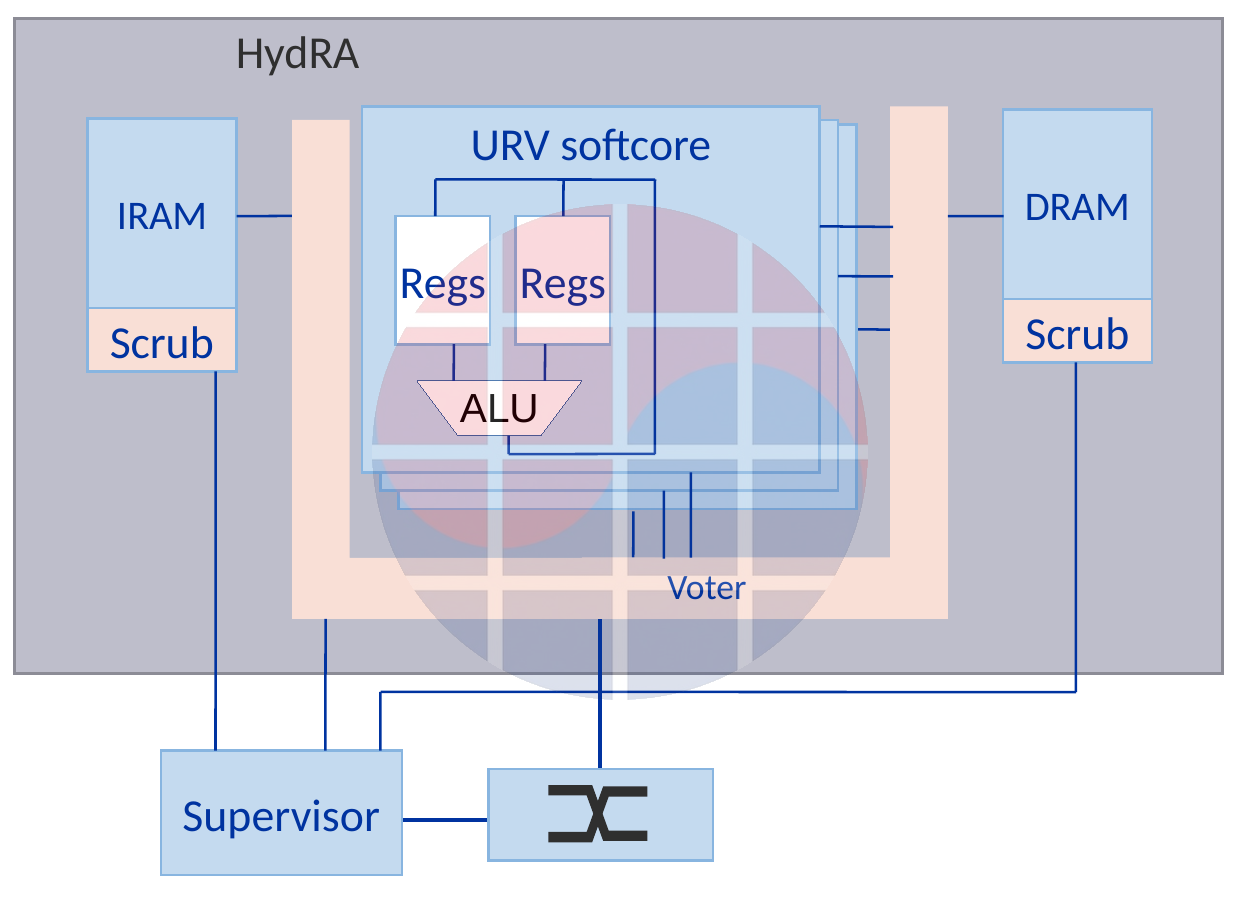
CERN·PSI의 HydRA 연구는 지상 가속기 환경의 구체적인 비교 사례다. 논문 도판에는 instruction RAM과 data RAM의 scrubber가 따로 보이고, management CPU와 application CPU가 분리돼 있다. 여기서 DRAM 표기는 data RAM을 뜻하며, dynamic DRAM 제품을 식별하는 표시로 읽지 않는다.
두 CPU는 같은 FPGA 안에 있고 shared memory로 연결된다. 논문은 각 CPU의 별도 restart와 실행 중 application code 변경 제한을 설명하지만, 이것이 물리적으로 독립된 복구 경로나 checkpoint commit의 증명은 아니다. 아래 그림에서 독자가 확인할 것은 역할 분리와 공통 자원의 공존이다.
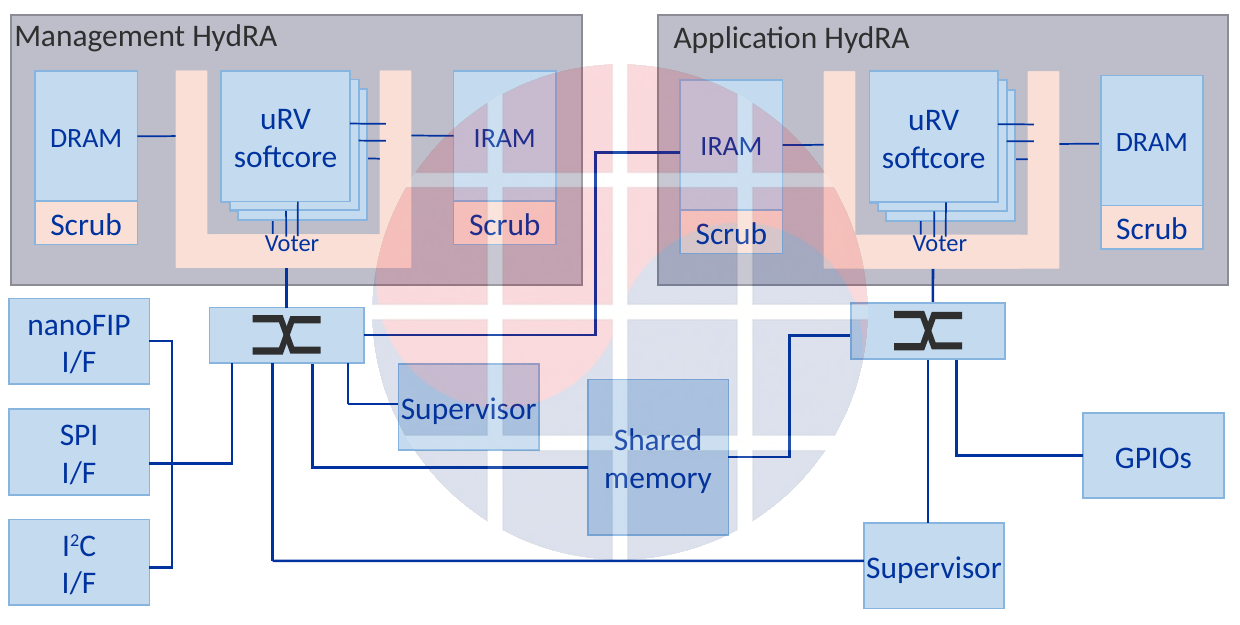
복구를 맡긴 제어기가 같은 clock, 전원, configuration 또는 metadata를 공유한다면 그 자원을 고장 주입 목록에 넣어야 한다. 서로 다른 RTL module 이름은 물리적 fault domain의 경계가 아니다. 독립성을 주장하려면 어떤 오류가 동시에 영향을 줄 수 없는지를 시험과 설계 근거로 보여줘야 한다.
2025년 configuration-memory 연구 역시 voter와 processor tile이 같은 configuration 오류의 영향을 받을 수 있음을 다룬다. 특정 fault-injection 조건을 실제 궤도 신뢰도로 환산하지 않고, 어떤 제어 기능까지 fault model에 포함할지 정하는 근거로 사용해야 한다.
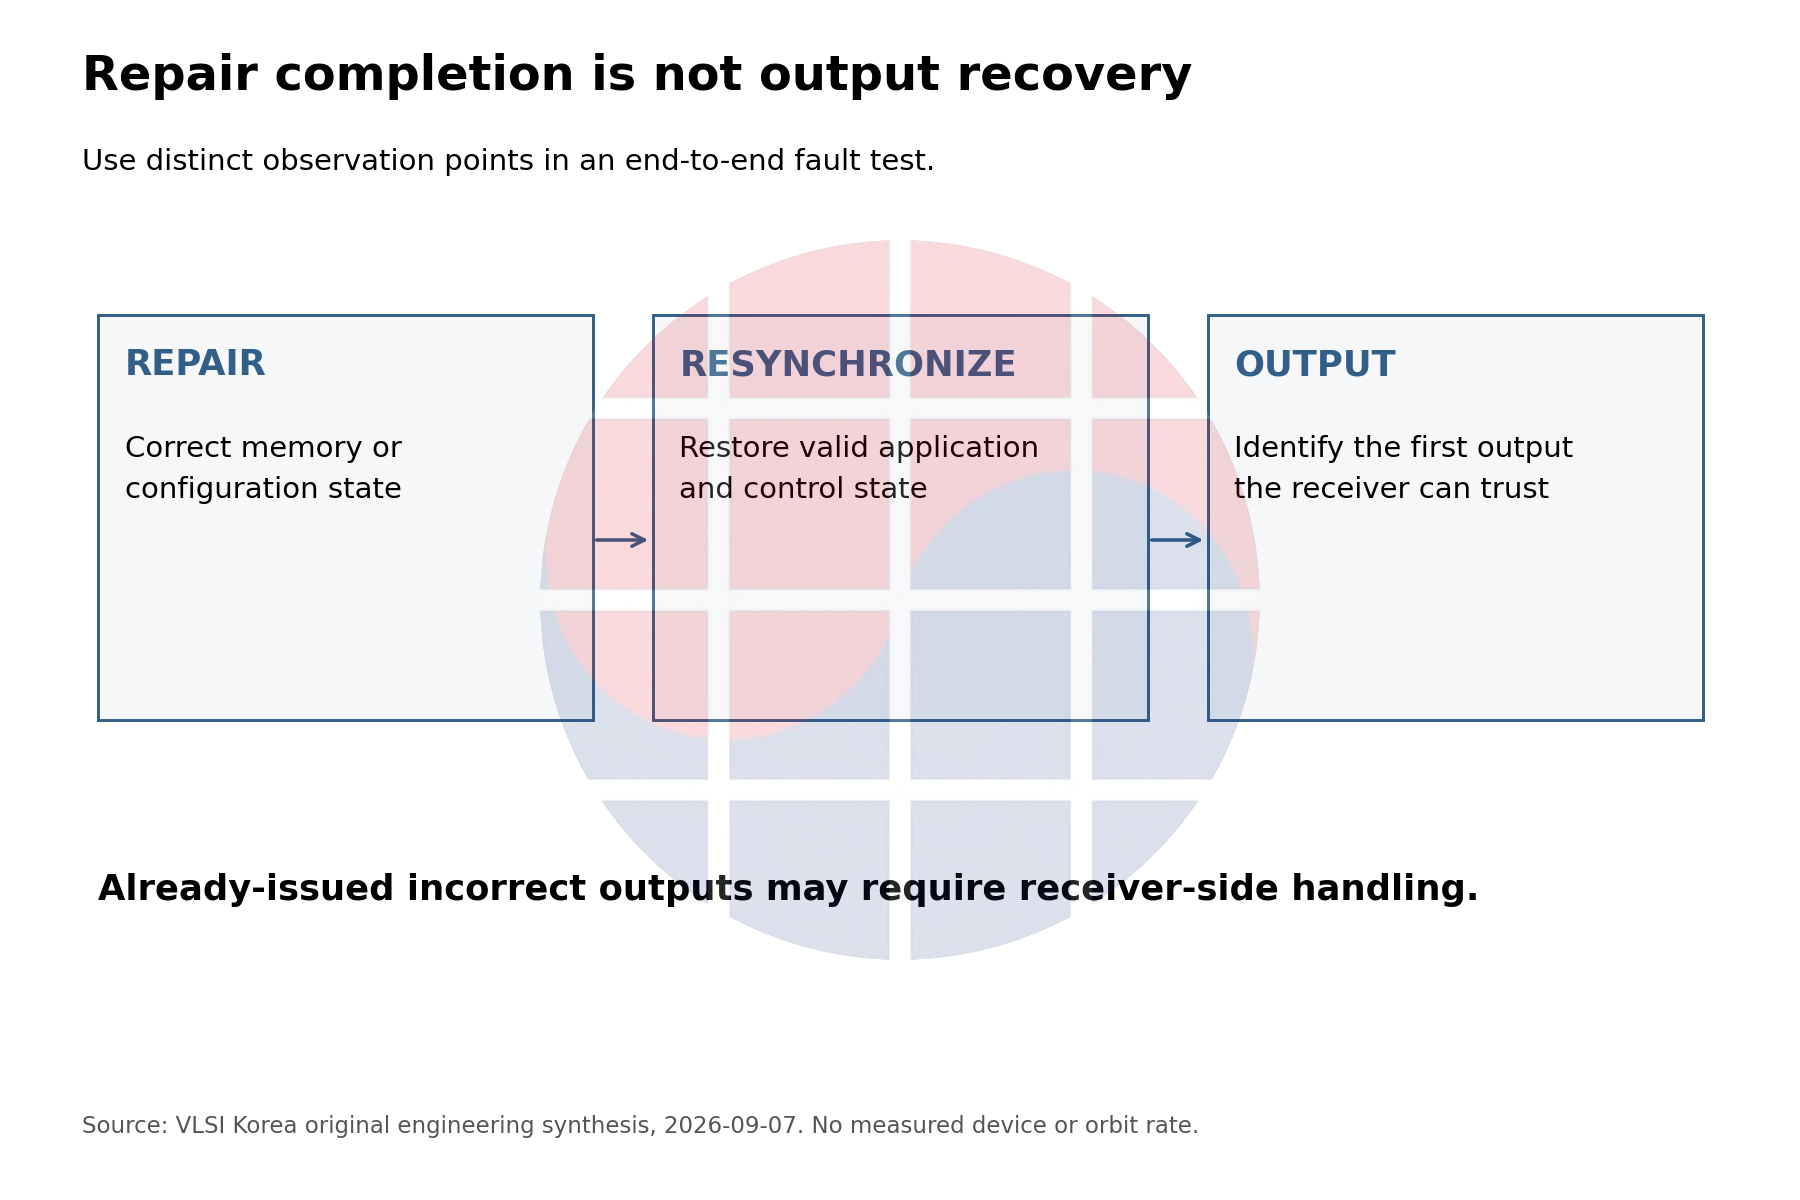
정정, reset, rollback의 관측 지점도 구분해야 한다. ECC counter 증가와 응용 출력 복구는 다른 사건이다. Scrubber가 configuration을 되돌려도 이미 외부로 내보낸 잘못된 출력은 취소되지 않을 수 있다. 출력 유효 신호, 재동기화, 오류 이후 수신 측 동작까지 end-to-end 시험에 포함하는 이유다.
한국 설계팀이 요구할 것은 하나의 FIT 숫자보다 복구 trace다
위성 탑재 컴퓨터를 설계하거나 메모리·FPGA·IP를 조합하는 팀이라면, 부품 제안서의 ECC 항목 옆에 workload별 최대 sweep 시간과 재시작 후 첫 유효 출력 시점을 요구할 수 있다. 이 글의 판단은 특정 한국 기업의 채택 계획이 아니라 설계와 검증 사이의 인수 조건이다.
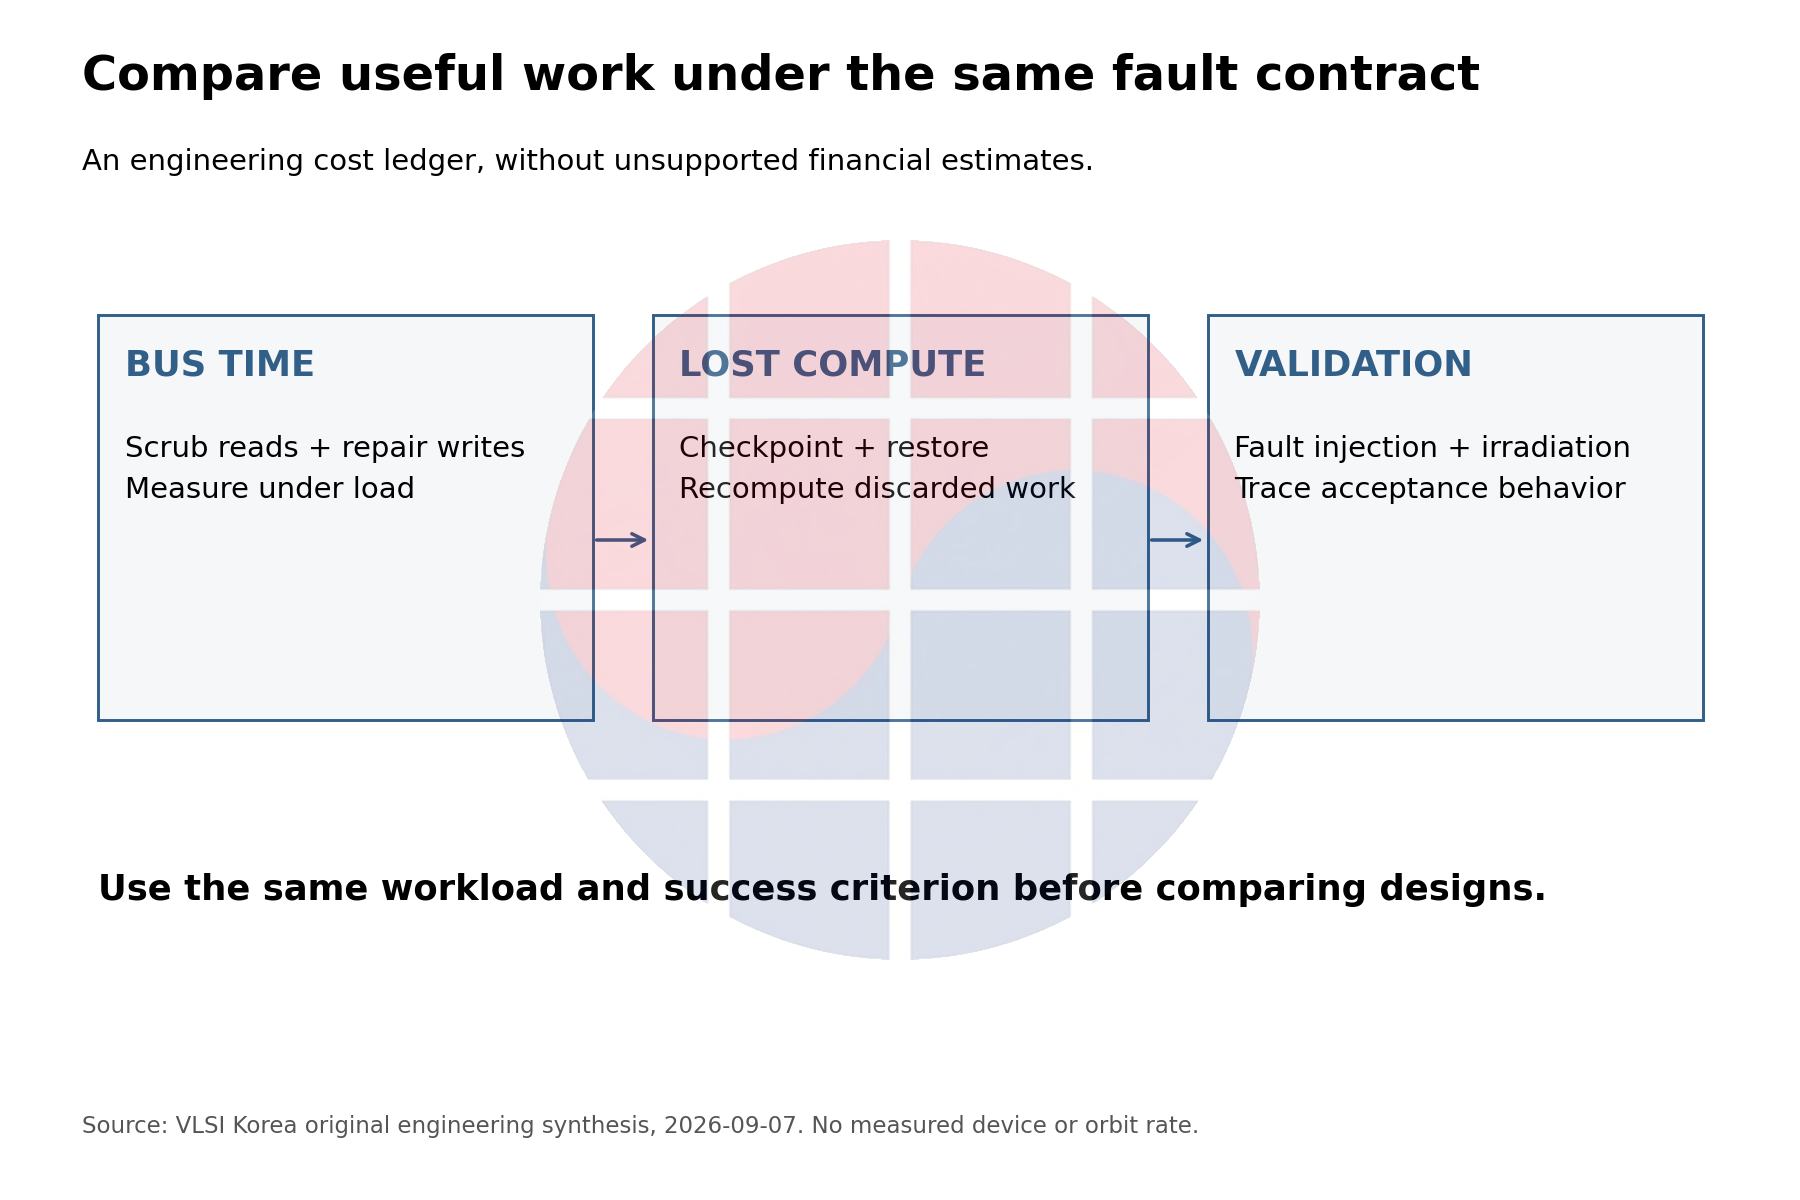
유효 처리량을 비교할 때도 nominal 연산 성능에서 끝내지 않는다. Scrub 읽기와 writeback이 차지하는 bus 시간, checkpoint 저장 정지, 복원과 재계산, fault-injection 및 방사선 시험에 필요한 개발 시간을 별도로 기록한다. 검증되지 않은 판매량이나 수익률을 붙이는 대신 같은 workload와 성공 기준으로 비교할 비용 항목을 정한다.
가장 강한 반론은 이 계산의 독립 사건 가정 자체가 실제 고장을 설명하지 못할 수 있다는 것이다. 다중 비트 burst나 영구 결함이 지배적이면 scrub을 빠르게 하는 것보다 code 선택, interleaving, region 격리 또는 부품 변경이 먼저일 수 있다. 복구 저장소가 공통 고장에 노출된다면 checkpoint 주기를 줄이는 것도 답이 아니다.
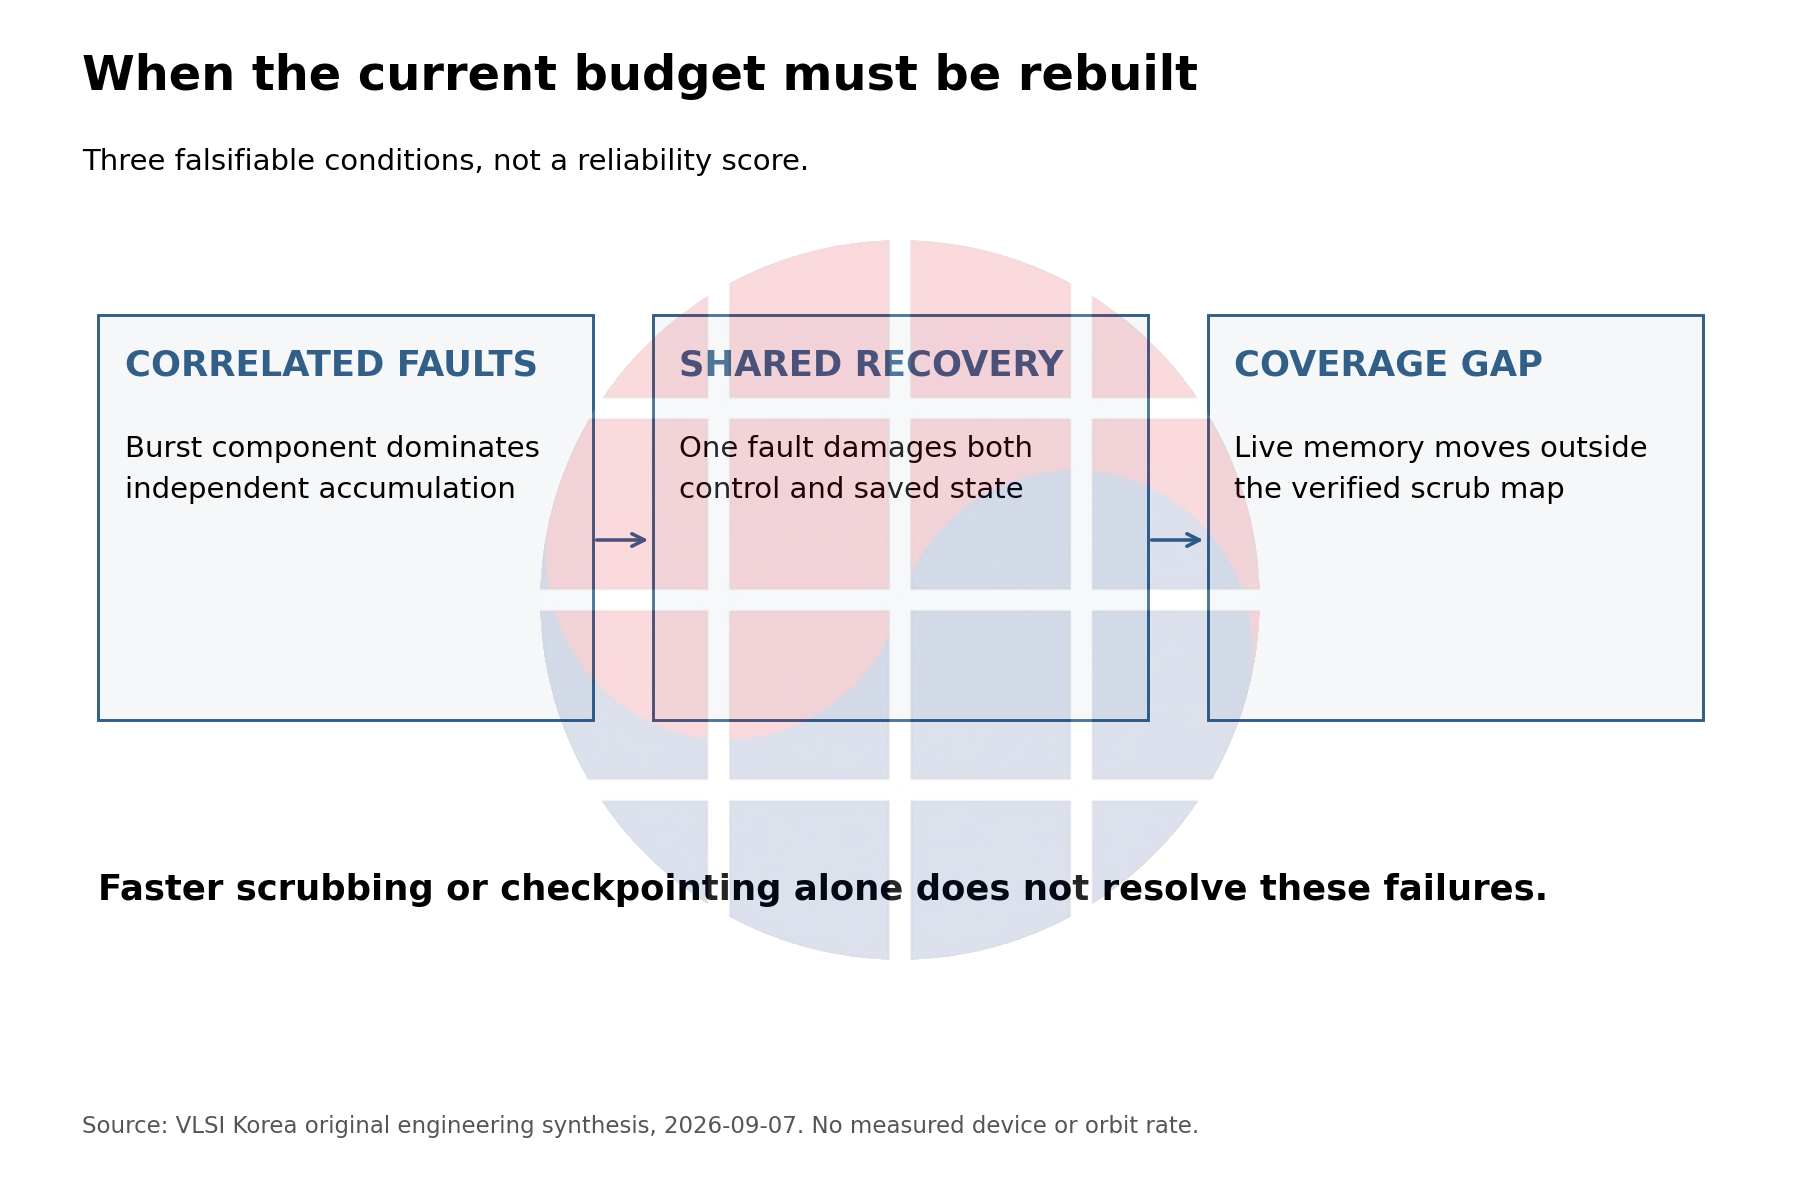
따라서 논지가 틀렸다고 판정할 조건도 명확하다. 측정된 상관 오류가 누적 독립 오류 항을 압도하거나, 단일 오류가 복구 제어와 저장 상태를 함께 훼손하거나, application 변경이 보호 map 밖의 live memory를 만들면 현재 budget을 다시 세워야 한다. 작은 overhead 숫자로 그 실패를 덮지 않는다.
검증 계획에는 세 날짜를 남길 수 있다. 2027-03-07에는 최대 부하에서의 sweep 상한, 2027-06-07에는 allocation 전환과 checkpoint 중단 시험, 2027-09-07에는 선택 부품의 방사선 데이터와 복구 trace를 재검토한다. 이는 VLSI Korea가 제안하는 관측 일정이며 업체가 발표한 milestone이 아니다.
최종 인수 질문은 “ECC가 있나”가 아니라 “어떤 오류가 들어왔을 때, 언제까지, 어느 상태로, 어떤 출력부터 다시 믿을 수 있나”다. 그 답을 trace로 재현할 수 있어야 대역폭과 전력, 메모리 용량의 tradeoff도 제대로 비교할 수 있다.
원출처와 관련 reference
근거 기준일은 2026-09-07이다. 오래된 자료는 현재 오류율의 근거가 아니라 여전히 필요한 ECC·scrubbing·checkpoint 경계조건을 설명하는 데 사용했다. ECSS-E-HB-20-40A, 2023-10-11의 memory mitigation 및 safe-context 지침도 함께 참조했다.
- Evaluation of Error-Correcting Codes for Radiation-Tolerant Memory (2010)
- ECSS-E-HB-20-40A (2023-10-11)
- Single-event upset simulation and detection in configuration memory (2025)
- Application-profiled RAM scrubbing, DFT 2025
- On the Integrity of Lightweight Checkpoints (2008)
- HydRA, JACoW ICALEPCS2023, DOI 10.18429/JACoW-ICALEPCS2023-MO4AO02
넓은 시스템 제약은 우주 데이터센터 기술 보고서, 다른 오류 유발 메커니즘은 Rowhammer reference와 이어 읽을 수 있다. 두 글의 환경과 위협 모델을 이 글의 독립 사건 가정과 혼용하지 않는다.
AI가 공개 원문 조사, 원고 구성과 자체 도식 제작을 보조했다. 계산은 저장된 입력과 코드로 재검산했고, 독립 사실 검토자가 두 언어의 원고와 시각자료를 확인했다. 모든 계산 예시는 가정에 기반하며 실제 임무 성능이나 장비 채택을 주장하지 않는다.





