 VLSI Korea
SambaNova 심층 분석: 데이터플로우 AI 칩과 110억 달러 밸류에이션의 조건
2026년 7월 Series F에서 post-money 110억 달러를 기록한 SambaNova. RDU 데이터플로우 아키텍처, 칩이 아닌 랙을 파는 SambaStack 모델, JPMorganChase·SoftBank 트랙션, 그리고 이 가격이 성립하려면 무엇이 참이어야 하는지를 해부한다.


30초 요약. SambaNova Systems는 Reconfigurable Dataflow Unit(RDU) 아키텍처를 앞세운 팔로알토의 AI 칩 기업으로, 2026년 7월 8일 Series F 1차 클로즈에서 10억 달러를 조달하며 post-money 밸류에이션 110억 달러(약 15.4조원, 1달러=1,400원 기준)를 기록했다. 불과 5개월 전 같은 회사는 약 22억 달러 수준의 밸류에이션으로 Series E를 마쳤고, 2025년 말에는 부채 포함 약 16억 달러 규모의 인수 협상이 보도된 바 있다. 110억 달러는 현재 매출(2025년 중반 기준 연 약 1억 달러로 보도)에 대한 가격이 아니다. 이 가격을 지탱하는 것은 세 가지다. agentic inference에 맞춰 설계된 3계층 메모리 시스템과 dataflow 아키텍처, 칩이 아니라 완성된 AI 인프라를 파는 턴키 랙 사업(SambaStack/SambaRack), 그리고 JPMorganChase·SoftBank·Intel과 중동 sovereign AI 수요로 이어지는 실명 고객 증거다. 이 가격이 유지되려면 2026년 하반기 SN50 출하가 회사가 한 번도 공개한 적 없는 규모의 매출로 전환돼야 한다.
Background: 세 번 다시 가격이 매겨진 회사
SambaNova는 2017년 11월 팔로알토에서 설립됐다. 창업자는 SPARC 프로세서 개발을 이끌었던 전 Oracle·Sun Microsystems 임원 Rodrigo Liang, 멀티코어 프로세서의 선구자로 꼽히는 스탠퍼드 교수 Kunle Olukotun, 스탠퍼드 컴퓨터과학 교수 Christopher Ré다. Walden International을 통해 초기부터 투자한 Lip-Bu Tan이 executive chairman을 맡고 있다. 창업 가설은 아키텍처에 있었다. GPU가 고정된 코어에서 명령어를 가져와 실행하는 동안, dataflow 머신은 모델의 연산 그래프를 실리콘에 직접 배선해 데이터가 처리 단계를 흘러가게 만든다는 것이다.
펀딩 궤적이 밸류에이션 스토리를 그대로 보여준다. 2018년 Series A 5,600만 달러, 2019년 Series B 1.5억 달러, 2020년 2월 Series C 2.5억 달러(post-money 25억 달러)를 조달했다. 2021년 4월에는 SoftBank Vision Fund 2가 주도한 Series D 6.76억 달러로 밸류에이션 51억 달러에 도달했다. LLM의 production inference 시장이 존재하기도 전의, 1차 AI 인프라 사이클 정점이었다.
이어진 것은 긴 겨울이었다. 회사는 2025년 내내 매각을 타진했고, 2025년 12월에는 Intel과 부채 포함 약 16억 달러 규모의 인수 협상이 진전됐다고 보도됐다. 협상은 결렬됐다. 주요 투자자 한 곳은 지분 가치를 약 17% 하향 평가해 회사 가치를 21~24억 달러 수준으로 implies 했다. 구원투수는 인수가 아니라 파트너십이었다. 2026년 2월 24일, SambaNova는 Vista Equity Partners와 Cambium Capital이 주도하고 Intel Capital이 참여한 3.5억 달러 이상의 Series E를 마감했다. 보도된 post-money 밸류에이션은 약 22억 달러 수준이다. Intel은 동시에 Xeon 인프라 기반 inference 솔루션을 공동 개발·판매하는 다년 전략 제휴를 체결했다. 그로부터 5개월 뒤인 2026년 7월 8일, General Atlantic이 주도한 Series F 1차 클로즈 10억 달러가 post-money 110억 달러에 성사됐다. Seligman Ventures, T. Rowe Price, Capital Group, BlackRock, Intel Capital, Vista Equity Partners, 카타르투자청(QIA) 등이 참여했다. 누적 조달액은 약 25억 달러에 이른다.
| 라운드 | 시기 | 금액 | Post-money 밸류에이션 | 리드 투자자 |
|---|---|---|---|---|
| Series A | 2018 | $56M | — | — |
| Series B | 2019 | $150M | — | — |
| Series C | 2020-02 | $250M | $2.5B | — |
| Series D | 2021-04 | $676M | $5.1B | SoftBank Vision Fund 2 |
| Series E | 2026-02-24 | $350M+ | ~$2.2B | Vista Equity Partners, Cambium Capital |
| Series F (first close) | 2026-07-08 | $1B | $11B | General Atlantic |
Business Deep Dive
칩: dataflow 5세대
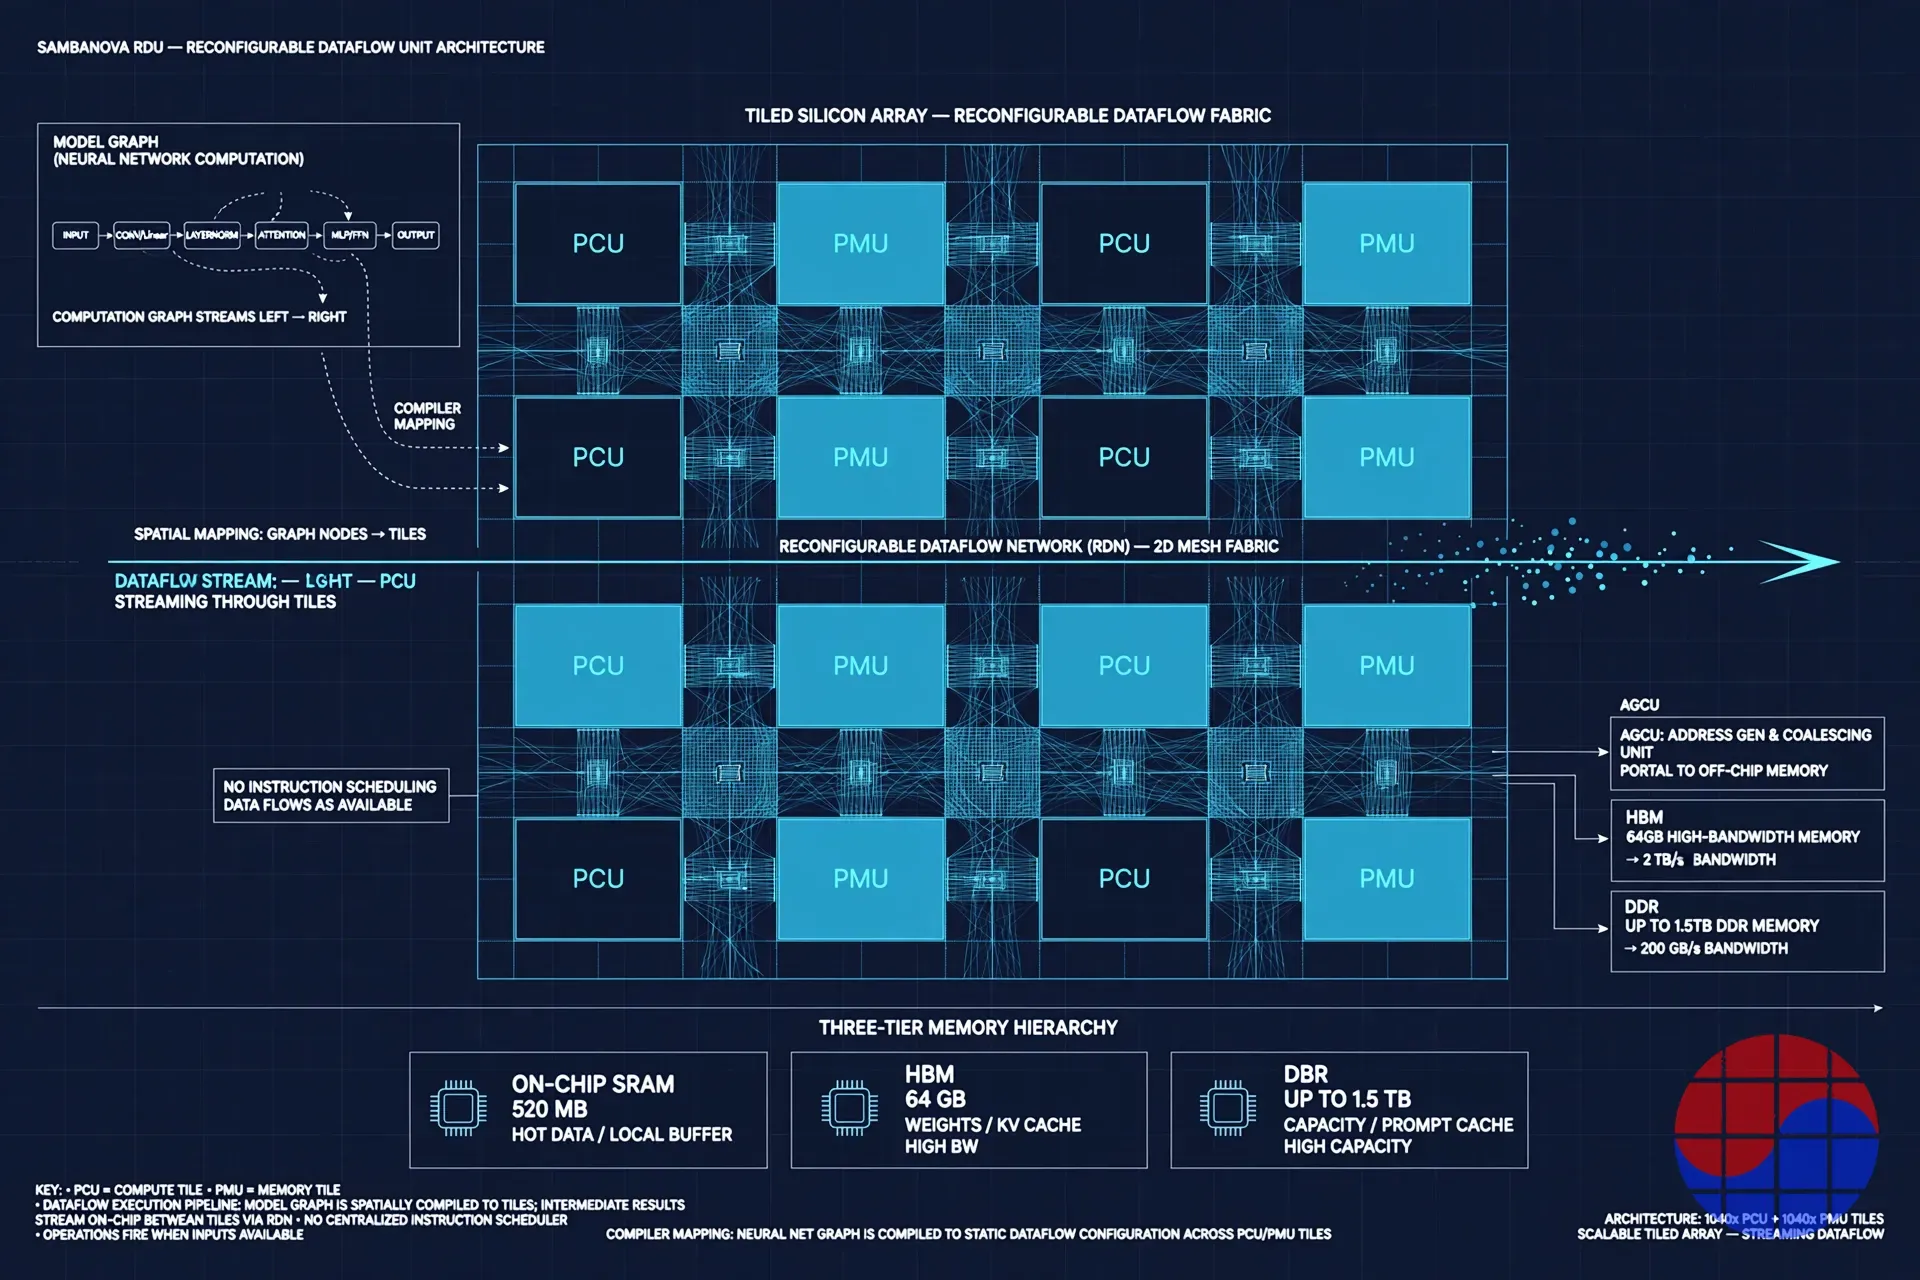
RDU는 Pattern Compute Unit(PCU)과 Pattern Memory Unit(PMU)을 재구성 가능한 패브릭으로 연결한 타일 배열이다. 컴파일러가 모델 그래프를 타일에 매핑하고 연산을 융합해, 중간 결과가 칩 밖으로 나가지 않는다. 상용 세대는 초기 SN10·SN20, 7nm SN30을 거쳐 2023년 SN40L에 이르렀다. SN40L은 TSMC 5nm 공정, 트랜지스터 1,020억 개, PCU·PMU 각 1,040개로 638 BF16 TFLOPS를 낸다. 5세대 SN50은 2026년 2월 공개됐다. 업계 보도 기준 TSMC 3nm 공정의 듀얼 칩렛 설계로, 연산 유닛을 약 2배로 늘려 BF16 1.6 PFLOPS, FP8 3.2 PFLOPS를 내고, 칩 간 인터커넥트는 2.2 TB/s, 최대 256개 가속기를 하나의 공유 메모리 inference 도메인으로 묶을 수 있다. 출하는 2026년 하반기 시작이다.
진짜 제품은 메모리 시스템이다
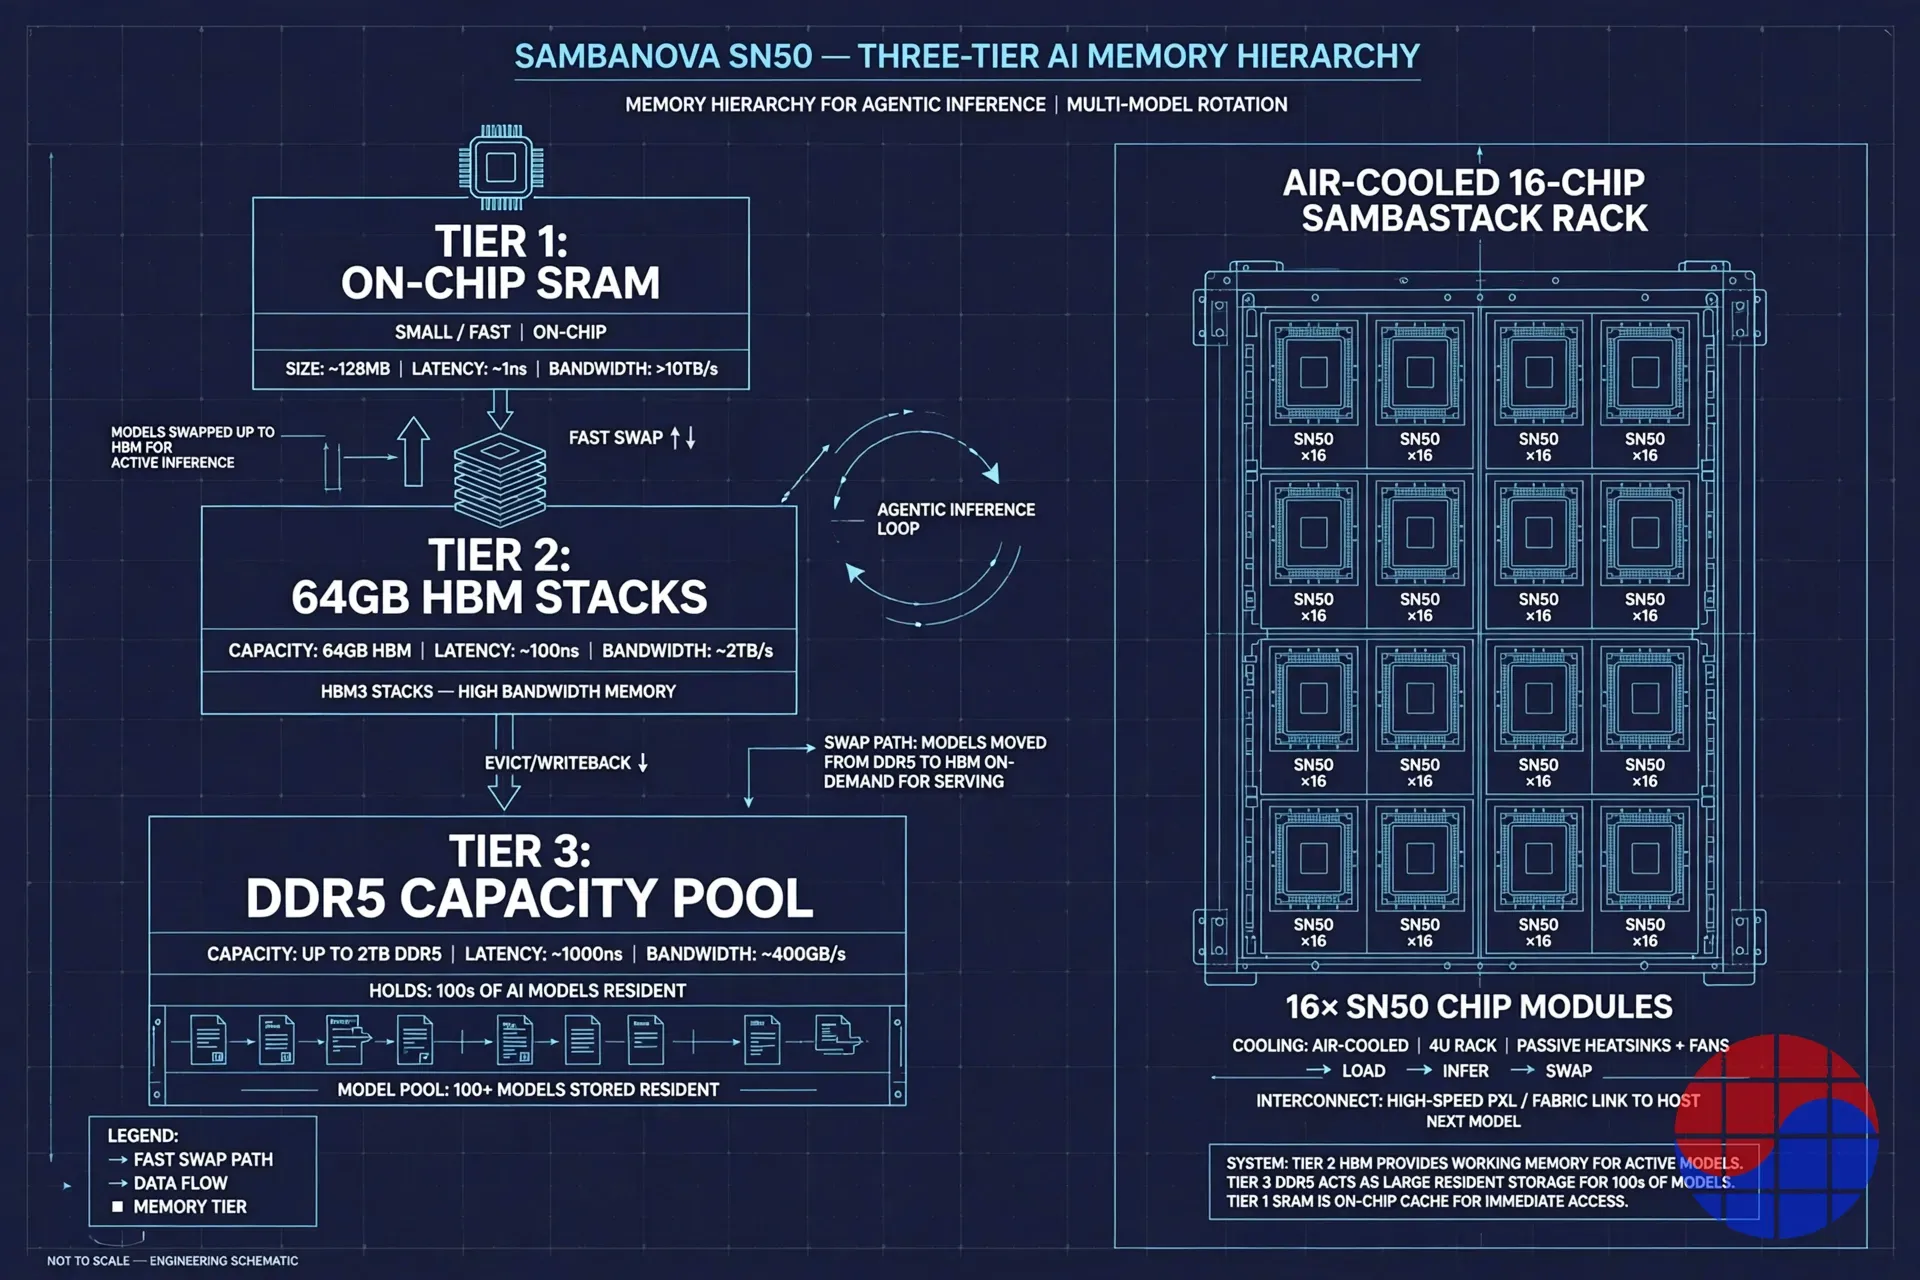
모든 RDU는 3계층 메모리 계층을 탑재하며, 회사의 핵심 논거는 raw FLOPS가 아니라 여기에 있다. SN40L은 온칩 SRAM 520 MB, HBM 64 GB, 직접 연결 DDR5 최대 1.5 TB를 결합한다. SN50은 HBM 64 GB를 유지하면서 DDR5를 칩당 최대 2 TB까지 확장한다. 모델은 DDR 계층에 상주하다가 1.6 TB/s 이상으로 HBM에 스왑 인되며, 회사 설명으로는 Llama 3.1 8B 전환이 0.01초 미만이다. 덕분에 단일 노드에 수백 개 모델을 상주시켜 순환 서빙할 수 있다. reasoning 모델, 코딩 모델, 음성 모델을 차례로 호출하는 agentic AI의 접근 패턴과 정확히 맞는다. 눈에 띄는 의도적 선택도 있다. SN50의 HBM은 최신 세대보다 한 세대 뒤진 HBM2E다. 경영진의 논리는 비용과 공급이다. 최신 HBM 스택을 두고 GPU 업체와 경쟁하지 않으면 BOM과 납기 일정을 스스로 통제할 수 있다. 여기서 HBM 수치는 회사가 공개한 GB 단위 용량이며, 아키텍처의 용량 계층은 HBM이 아니라 DDR이라는 점이 핵심이다.
SambaStack: 칩이 아닌 랙을 판다
SambaNova는 merchant silicon 업체처럼 가속기만 팔지 않는다. 거래 단위는 SambaRack이다. 칩 16개를 묶은 공랭식 랙(SN40L 세대 평균 약 10 kW, SN50 약 20 kW)에 오케스트레이션·모델 번들·기업 연동을 담은 소프트웨어 플랫폼 SambaStack을 얹는다. 구매 방식은 세 가지다. 온프레미스 또는 전용 클라우드로 설치하는 SambaStack, SambaNova가 운영하는 데이터센터에서 API로 inference를 제공하는 SambaCloud, 클라우드·데이터센터 사업자가 약 90일 만에 자체 inference 서비스를 열 수 있게 하는 턴키 서비스 SambaManaged다. 이 모델은 양쪽의 경제학을 바꾼다. 구매자는 bare GPU 클러스터가 요구하는 수개 분기의 통합 프로젝트를 건너뛴다. 기존 공랭 홀에 전력과 냉각은 있지만 CUDA 엔지니어링 조직은 없는 은행·정부·사업자에게 결정적이다. SambaNova는 칩 ASP가 아니라 실리콘·시스템·소프트웨어·서비스의 풀스택 마진을 가져가고, 고객을 자사 컴파일러와 오케스트레이션 계층에 묶는다.
트랙션: 이름은 실재하고, 숫자는 비공개다
고객 증거는 퍼널 상단에서 구체적이다. JPMorganChase는 Series F와 함께 SambaNova를 inference 인프라 파트너로 선정하고, 보안 온프레미스 inference를 위해 SN40L과 SN50 시스템을 도입한다. 규제 산업 은행 전체에 파급되는 레퍼런스다. SoftBank는 일본 AI 데이터센터에서 SN50의 첫 배치 파트너다. Intel은 투자자이자 인프라 파트너이자 공동 판매 채널이다. 유럽에서는 OVHcloud가 SambaRack으로 Premium AI Endpoints를 구축했다. sovereign 축도 구체적이다. 사우디아라비아에 약 1.4억 달러 투자를 발표했고 통신사 stc와 sovereign AI 클라우드를 추진 중이며, Saudi Aramco가 고객 명단에 있고, Series E에는 Saudi First Data가, Series F에는 QIA가 들어왔다. 반면 현재 매출은 공개된 바 없다. 마지막으로 보도된 수치인 2025년 중반 기준 연 약 1억 달러는 SN50 사이클 이전의 것이고, 2025년 말 "record bookings and revenue"라는 회사 발표에는 숫자가 없었다.
110억 달러가 성립하려면 무엇이 참이어야 하나
산수를 해보자. 보도된 연 매출 약 1억 달러를 기준으로 하면 110억 달러는 매출의 100배가 넘는다. 미래 물량으로만 정당화되는 가격이다. 조건은 네 가지다. 첫째, agentic 워크로드가 토큰 물량을 불리는 가운데 inference가 학습으로부터 예산 점유를 계속 가져와야 한다. 회사 포트폴리오 전체가 이 이동에 가격이 매겨져 있다. 둘째, SN50이 2026년 하반기에 일정대로 출하되고 램프업해야 한다. Series F 자금의 용도가 공급망 확보로 명시됐고, 경영진은 공급망을 향후 12개월 주문 이행의 병목이라고 지목했다. 셋째, sovereign·기업 랙 딜이 발표 단계에서 다랙·다년 매출로 전환돼야 한다. 등대 고객 몇 곳뿐인 턴키 모델은 플랫폼 사업이 아니라 프로젝트 사업이다. 넷째, 약 2년 안에 매출이 수억 달러 후반대에 도달해야 진입 가격이 성장 배수처럼 보이기 시작한다. CEO가 강하게 검토 중이라고 밝힌 IPO가 그 가격을 검증할 출구가 된다.
다운사이드
약세 논거도 똑같이 구체적이다. CUDA 소프트웨어 생태계는 여전히 기본값이고, SambaNova의 모든 수주는 고객이 production 워크로드에 독점 컴파일러를 거는 베팅을 요구한다. hyperscaler들은 자체 inference 실리콘을 내놓고 있고, 자금력 있는 inference 전문 스타트업들이 같은 sovereign·neocloud 예산을 두고 경쟁한다. 스펙 시트만 놓고 보면 SN50의 peak FLOPS와 HBM 대역폭은 최신 플래그십 GPU보다 낮다. 회사의 답은 활용률과 메모리 용량이지만, 이를 가를 독립적이고 동등 조건의 production 벤치마크는 아직 드물다. 모델 자체도 자본 집약적이다. 누적 조달 25억 달러, 하드웨어 원가 구조, 매출이 들어오기 전에 선투입해야 하는 공급망이 있다. 마지막으로 이 자산은 5년 사이 51억 달러, 약 22억 달러, 110억 달러로 평가가 오갔다. 변동성 자체가 정보다. 이 가격은 이야기에 대한 협상된 private mark이지 시장 청산 가격이 아니다.
Chase's Take
110억 달러를 읽는 정직한 방법은, inference가 학습보다 오래 남는 돈이라는 데 시장이 합의한 순간에 체결된 'post-GPU inference 스택에 대한 옵션 가격'으로 보는 것이다. 제가 진짜 차별점으로 보는 것은 2017년부터 해온 dataflow 아키텍처 피치가 아니다. challenger에게 좀처럼 한 몸에 존재하지 않는 세 자산의 정렬이다. 멀티모델 agentic 서빙에 맞춘 메모리 계층, 은행이나 정부 부처가 실제로 구매할 수 있는 턴키 랙, 그리고 유통 채널을 겸하는 주주 명부(General Atlantic, Vista, Intel, QIA, 고객으로서의 SoftBank)다. 반대쪽 무게추도 분명하다. SambaNova는 이미 한 번의 하이프 사이클과 16억 달러 근접 매각을 겪었다. 워크로드가 발밑에서 바뀌면 반도체 기업에게 두 번째 기회가 오기는 하고, agentic inference는 실제 워크로드 변화다. 그러나 입증 책임은 칩에서 손익계산서로 넘어갔다. 2027년에 의미 있는 데이터는 SN50 매출 하나뿐이다.
Implications
- AI 칩 시장: Series F는 후기 자본이 inference 전문 기업을 부품 업체가 아니라 인프라 플랫폼으로 가격 매긴다는 것을 확인했다. 풀스택 범위가 입장권이다.
- Sovereign AI 구매자: 데이터를 온프레미스에 두는 공랭식 10~20 kW 턴키 랙이 구매 가능한 카테고리가 됐다. 사우디와 일본 배치가 레퍼런스 케이스다.
- 기업: JPMorganChase 배치는 규제 산업에 non-GPU 온프레미스 inference의 동종업계 선례를 제공해 'GPU를 사면 문책당하지 않는다'는 기본값을 약화시킨다.
- 투자자: 2027년까지 SN50 출하의 매출 전환과 매출 공개 여부를 지켜볼 것. 그때까지 110억 달러에는 공개 재무 앵커가 없다.
주: SambaNova는 비상장 기업이다. 밸류에이션은 회사가 발표한 펀딩 기준 post-money 수치(Series F 1차 클로즈, 2026년 7월 8일)이며, 매출은 감사된 공시가 아닌 보도 수치다. 벤더 성능 비교는 독립 벤치마크가 아닌 경우 회사 주장이다.
FAQ
SambaNova의 밸류에이션이 왜 110억 달러인가?
110억 달러는 Series F 펀딩의 post-money 밸류에이션이다(General Atlantic 주도 10억 달러 1차 클로즈, 2026년 7월 8일 발표). 현재 보도 매출인 연 약 1억 달러가 아니라, SN50 칩과 턴키 SambaStack 랙, JPMorganChase·SoftBank 같은 고객을 근거로 한 미래 inference 인프라 매출에 매겨진 가격이다.
SambaNova의 RDU는 GPU와 무엇이 다른가?
GPU는 고정된 코어에서 스케줄링된 명령어 방식으로 모델 연산을 실행한다. SambaNova의 RDU는 모델 그래프를 연산·메모리 유닛의 공간 배열에 컴파일하고, SRAM·HBM·DDR 3계층 메모리로 수백 개 모델을 단일 노드에 상주시켜 밀리초 단위로 전환한다. 멀티모델 agentic inference를 겨냥한 설계다.
SambaStack이란 무엇인가?
SambaStack은 SambaNova의 턴키 AI 플랫폼이다. SambaRack 시스템(RDU 칩 16개, 공랭)과 오케스트레이션·모델 서빙 소프트웨어 전체를 묶는다. 온프레미스·전용 클라우드 형태의 SambaStack, API inference인 SambaCloud, 사업자용 관리형 서비스 SambaManaged로 판매되며, 고객은 bare 칩이 아니라 완성된 inference 용량을 산다.
SambaNova는 상장사인가? 주요 리스크는?
아니다. 비상장이며 CEO는 IPO를 강하게 검토 중이라고 밝혔다. 주요 리스크는 CUDA 생태계 lock-in, hyperscaler 자체 실리콘 및 다른 inference 칩 스타트업과의 경쟁, 약 25억 달러를 조달한 하드웨어 사업의 자본 집약성, 그리고 51억 달러(2021년)에서 약 22억 달러(2026년 초), 110억 달러(2026년 7월)로 움직인 밸류에이션이다. 이 가격이 검증되려면 SN50 매출의 빠른 성장이 필요하다.
📩 VLSI Korea 뉴스레터 구독하기
매일 발행되는 반도체 심층 분석을 이메일로 가장 먼저 받아보세요. 구독은 무료입니다.


