VLSI Korea
추론은 SRAM, 학습은 HBM: 5가지 사실 (Groq 3 LPX·Trainium3)
AI 추론이 갈라진다. 디코딩은 HBM 없는 SRAM 칩 Groq 3 LPX로, 학습은 칩당 HBM3e 144GB인 Trainium3로. 대역폭 57배와 용량 162배의 비대칭, 그리고 양쪽에 선 Samsung까지 5가지 사실로 정리했다. (2026년 10월 24일 기준)


추론은 SRAM, 학습은 HBM: 5가지 사실 (Groq 3 LPX·Trainium3)
AI 추론은 두 갈래로 갈라지고 있다. 지연시간이 중요한 디코딩은 HBM 없는 SRAM 칩으로 이동하고, 학습과 프리필은 HBM 용량 위에 그대로 남는다. (2026년 10월 24일 기준)
30초 요약
- NVIDIA Groq 3 LPX는 양산 단계에 들어갔다. LP30 칩은 HBM 없이 칩당 SRAM 500MB와 150 TB/s 대역폭을 제공한다 (NVIDIA 발표, Hot Chips 2026, 2026년 8월 24-25일).
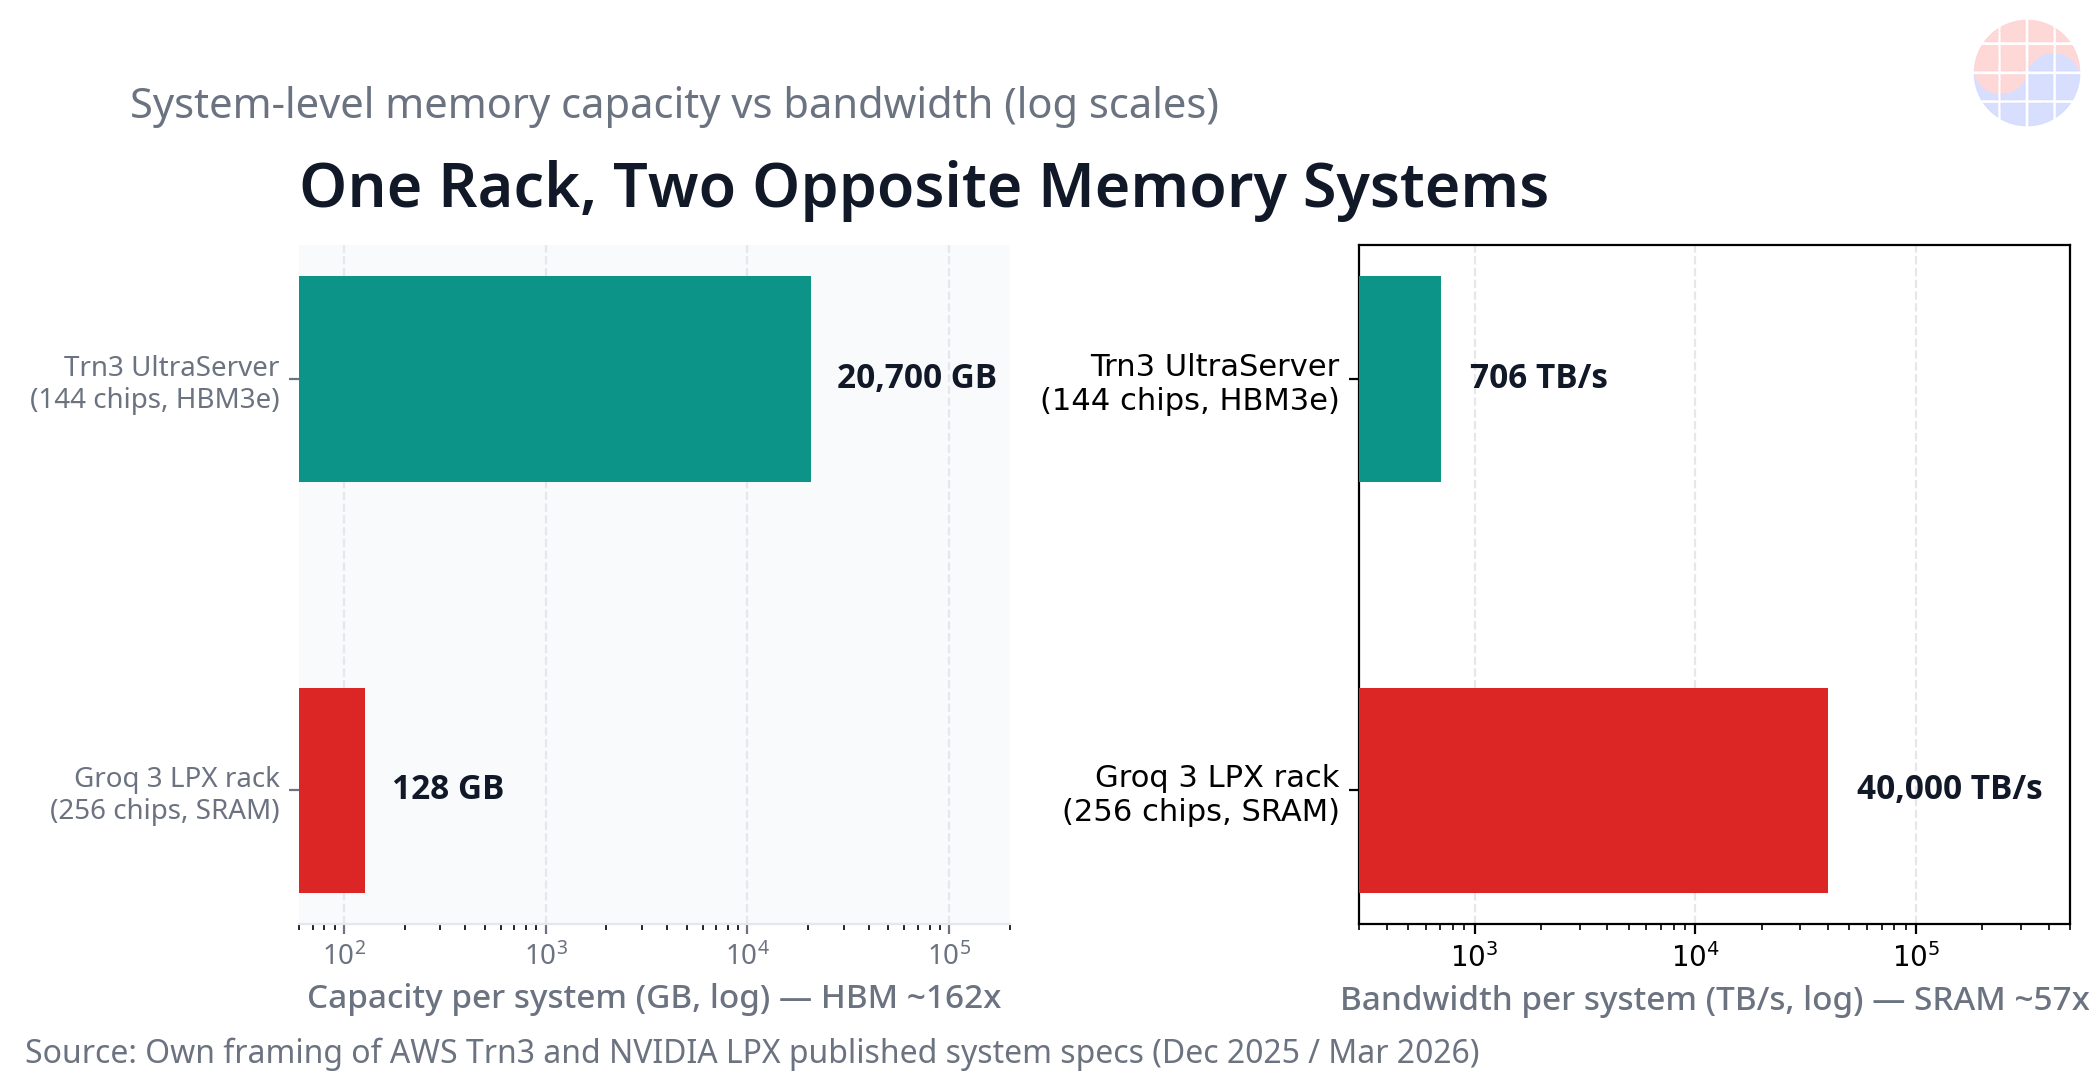
- 자체 계산으로, 랙 기준 메모리 대역폭은 SRAM 쪽이 약 57배 크고, 메모리 용량은 HBM 쪽이 약 162배 크다. 이 비대칭이 분리의 본질이다.
- 학습 진영은 HBM 용량으로 굳어지고 있다. AWS Trainium3는 칩당 HBM3e 144GB를 달았고, 2026년 10월 19일 발표된 TorchNeuron이 PyTorch 포팅 장벽을 낮췄다 (AWS 발표).
- Samsung은 분리의 양쪽에 서 있다. HBM 공급을 노리면서, HBM이 없는 LP30의 단독 파운드리이기도 하다.
- SK hynix는 순수하게 HBM 쪽에 노출돼 있지만, 단기 HBM 수요는 학습이 지탱한다. SRAM이 제한하는 것은 추론 가운데 지연 프리미엄 디코딩 조각뿐이다.
배경
추론은 성격이 다른 두 단계로 나뉜다. 프리필은 긴 입력 컨텍스트를 한 번에 읽어 들이는 단계로 연산량과 메모리 용량이 중요하다. 디코딩은 토큰을 하나씩 뱉는 단계로, 토큰이 생성될 때마다 모델 가중치 전체를 다시 읽어야 한다. 그래서 디코딩의 속도는 사실상 메모리 대역폭과 지연시간이 정한다.
지금까지는 GPU와 HBM 조합이 두 단계를 모두 맡아 왔다. HBM은 용량이 크지만 칩 밖에 있는 메모리라 대역폭과 지연시간에 물리적 한계가 있다. 반대로 SRAM은 칩 안에 있어 대역폭이 압도적으로 빠르지만, 용량이 작고 다이 면적을 많이 차지한다. 이 트레이드오프는 오래전부터 알려져 있었다. 1세대 GroqChip은 SRAM 230MB와 최대 80 TB/s 온다이 대역폭을 내세웠고 (Groq 2022년 제품 브리프, 벤더 사양), Cerebras WSE-3는 온칩 SRAM 44GB와 21 PB/s 대역폭으로 같은 철학을 웨이퍼 스케일 끝까지 밀어붙인 사례다 (Cerebras 2024년 공개 사양).
구도가 바뀐 계기는 라이선스 거래였다. Groq는 2025년 12월 24일 NVIDIA와 비독점 라이선스 계약을 발표했고, 창업자 Jonathan Ross와 사장 Sunny Madra를 비롯한 핵심 팀이 NVIDIA에 합류했다. Groq 자체는 독립 회사로 남고 Simon Edwards가 CEO를 맡으며, GroqCloud는 거래 대상에 포함되지 않았다 (Groq 발표, 2025년 12월 24일). 거래 규모가 약 200억 달러라는 수치는 보도된 내용이며, NVIDIA가 공식 공개한 금액은 아니다.
딥다이브: 5가지 사실
- LPX는 양산 단계에 들어갔고, 칩에 HBM이 없다. NVIDIA는 GTC 2026년 3월에 Groq 3 LPX를 공개했고, Hot Chips 2026 (2026년 8월 24-25일)에서 전면 양산을 발표했다. LP30 칩은 칩당 SRAM 500MB, SRAM 대역폭 150 TB/s, 칩 간 링크 96개에 각 112 Gbps, 칩당 스케일업 대역폭 2.5 TB/s, 칩 간 지연시간 350ns를 제공한다 (NVIDIA 제품 및 기술 자료). 랙 단위로는 트레이 32개에 칩 256개를 묶어 SRAM 합계 128GB, 합산 SRAM 대역폭 40 PB/s, 스케일업 대역폭 640 TB/s, FP8 추론 연산 315 PFLOPS를 낸다. 플랫폼 설계상 Rubin GPU가 긴 컨텍스트 프리필과 디코딩 어텐션을 맡고, LPU가 디코딩에서 지연시간에 민감한 피드포워드와 MoE 연산을 맡는 이종 구성이다 (NVIDIA 설계). 벤더 주장으로, NVIDIA는 LPX를 Vera Rubin NVL72와 결합하면 조 단위 파라미터 모델에서 메가와트당 추론 처리량이 최대 35배까지 오른다고 밝혔다. 제3자 벤치마크에서는 사전 출시된 Gemma 4 31B 엔드포인트 (Google Cloud, 컨텍스트 100k 토큰, 동시성 1, 순차 요청 50회 중앙값) 기준 초당 출력 토큰 3,400개로, 해당 테스트에서 가장 가까운 대안 플랫폼의 약 4배를 기록했다 (Artificial Analysis 측정, NVIDIA가 인용한 결과). 이 수치는 단일 사용자 지연시간 테스트 결과이며 배치 처리량 테스트가 아니라는 점을 분명히 해 둘 필요가 있다. 첫 고객은 Nebius이고, 클라우드 공급은 AWS, Google Cloud, Microsoft Azure, Oracle을 통해 2026년 하반기에 시작된다고 NVIDIA는 밝혔다. 제조는 Samsung Foundry 4nm가 단독으로 맡는다. Jensen Huang은 GTC 2026년 3월 무대에서 Samsung이 Groq 3 LPU 칩을 제조하고 있으며 출하는 하반기, 대략 3분기에 시작될 것이라고 말했고, Samsung은 2026년 6월에 LP30을 생산 중이라고 확인했다. 2026년 10월 13일 보도에 따르면 Samsung은 OCP 2026에서 Groq LPU 웨이퍼를 전시했고, 칩은 평택에서 양산되고 있다.
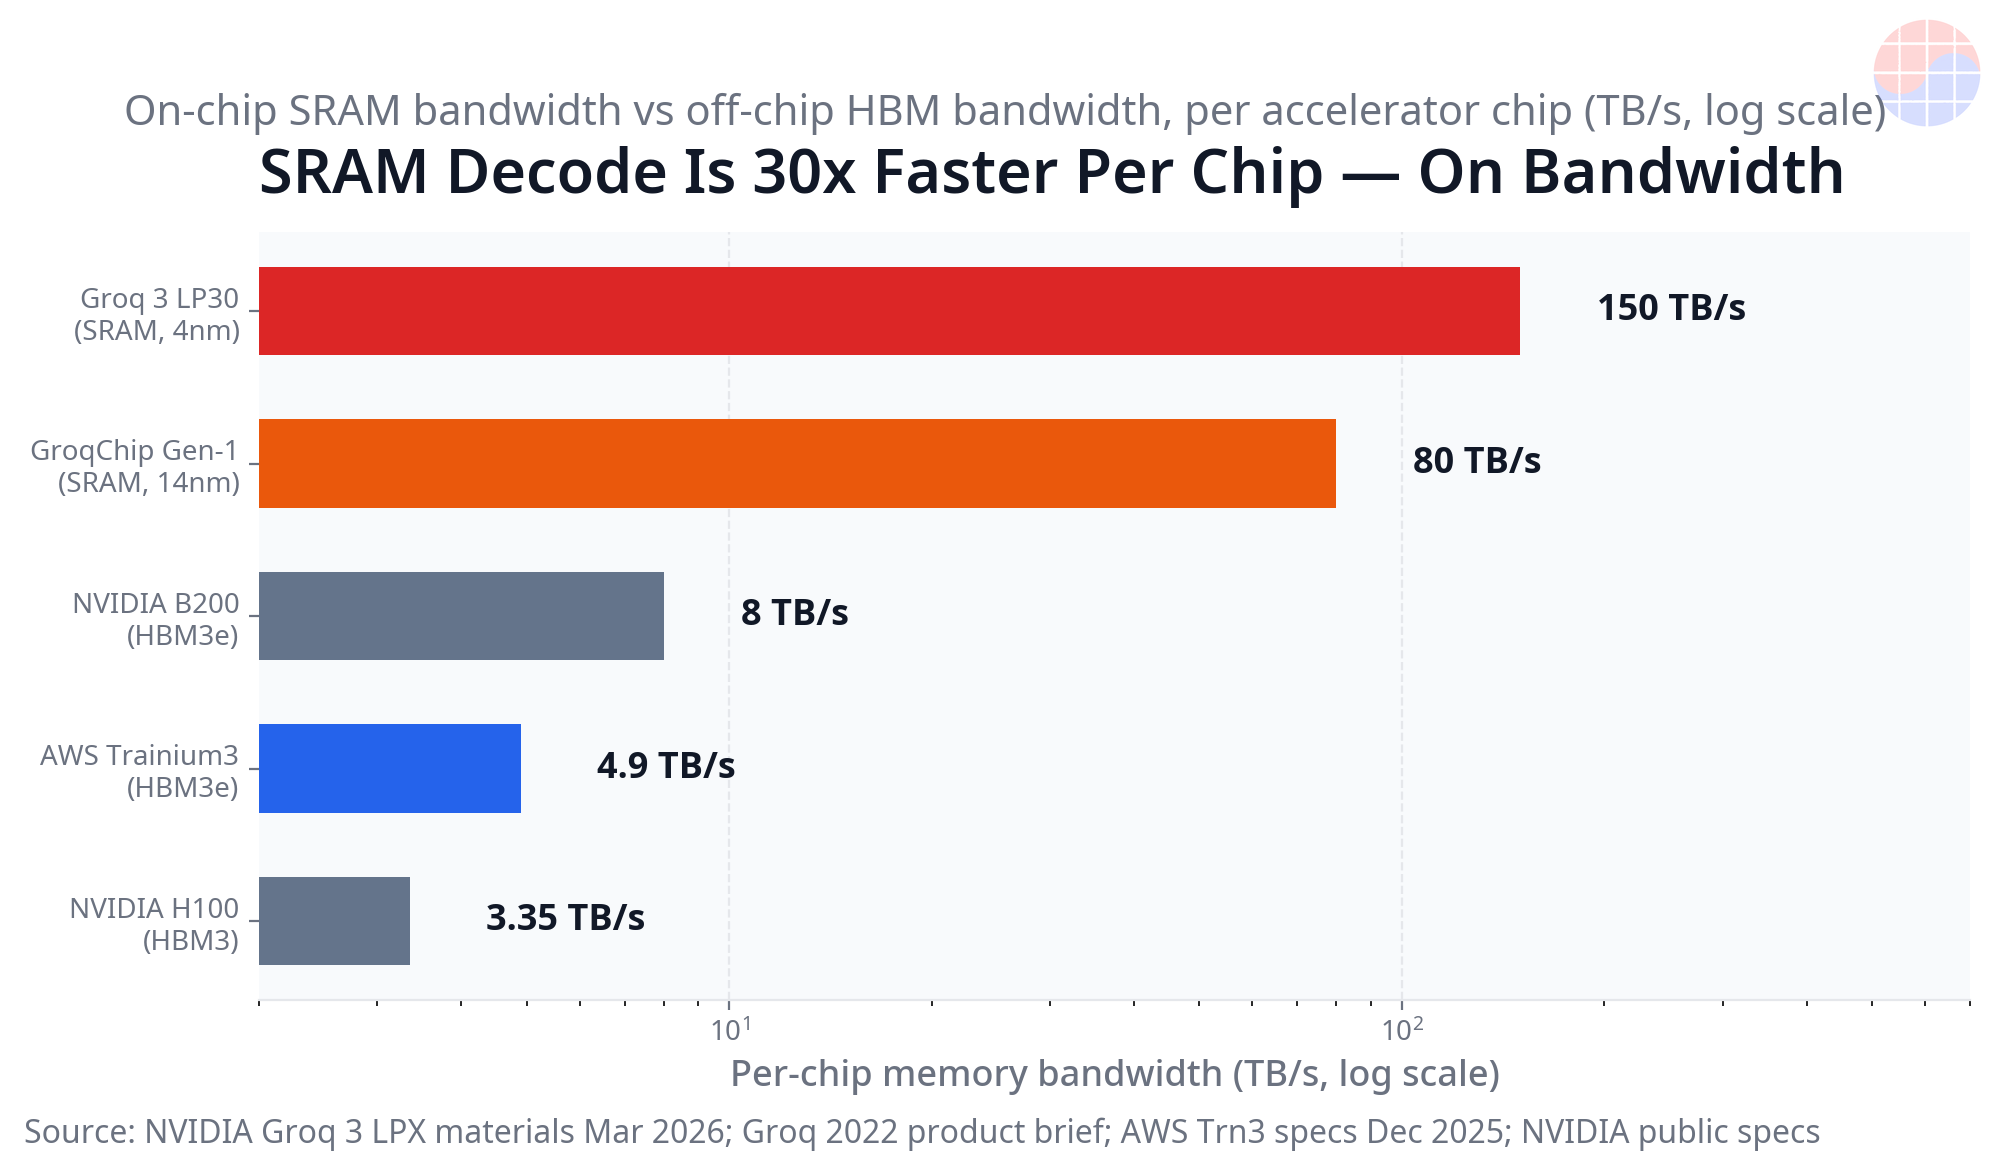
- 대역폭과 용량의 비대칭이 이 분리의 본질이다 (자체 계산). 칩 단위로 비교하면 LP30의 SRAM 대역폭 150 TB/s는 Trainium3의 HBM3e 대역폭 4.9 TB/s의 약 31배, H100의 3.35 TB/s의 약 45배다. 랙 단위로 넓히면 LPX의 40 PB/s, 즉 40,000 TB/s는 Trn3 UltraServer의 합산 대역폭 706 TB/s의 약 57배에 이른다. 그런데 용량에서는 그림이 정확히 뒤집힌다. Trn3 UltraServer의 HBM 20.7 TB는 LPX 랙의 SRAM 128GB의 약 162배다. 가중치만 놓고 본 적합 계산 (FP8 기준 파라미터당 1바이트, KV 캐시 제외)에서도 이 비대칭은 그대로 드러난다. 70B 모델의 가중치는 70GB라 LPX 랙 1대에 들어가지만, 405B 모델은 405GB라 최소 4대, 1조 파라미터 모델은 1,000GB라 최소 8대가 필요하다. 반면 세 모델 모두 Trn3 UltraServer 1대에 큰 여유를 남기고 들어간다. 1세대 GroqChip (SRAM 230MB)으로는 70B 모델의 가중치만으로도 약 305개 칩이 필요했다는 점과 비교하면, LP30의 500MB도 여전히 용량의 벽 앞에서 작다. 요컨대 SRAM은 대역폭에서 이기고 HBM은 용량에서 이기며, 어느 한쪽이 다른 쪽을 대체하는 관계가 아니다 (2026년 10월 24일 기준 자체 계산).
- 학습 진영은 HBM 용량으로 굳어지고 있고, 소프트웨어 장벽이 낮아졌다. AWS는 re:Invent에서 2025년 12월 2일 Trainium3를 정식 출시했다. TSMC 3nm 공정, 칩당 FP8 연산 2.52 PFLOPS, HBM3e 144GB, 대역폭 4.9 TB/s가 공식 사양이다 (AWS Trn3 공식 페이지). 칩 144개를 묶은 Trn3 UltraServer는 FP8 362 PFLOPS, HBM3e 20.7 TB, 합산 대역폭 706 TB/s를 제공한다. AWS는 Trainium2 대비 연산 4.4배, 메모리 대역폭 약 4배 향상을 주장하는데, 이는 벤더 주장이다. 물량 측면에서는 AWS와 Anthropic의 Project Rainier가 2025년 후반에 가동을 시작해 Trainium2 약 50만 개로 Claude를 학습시키고 있고, 약 100만 개 규모로 확장 중이다. 2026년 10월 보도에 따르면 Anthropic은 10년간 1,000억 달러가 넘는 AWS 용량 약정을 맺었고, OpenAI의 380억 달러 규모 AWS 계약에는 Trainium 용량 약 2GW가 포함됐다고 보도됐다. 두 수치 모두 보도된 내용이다. 여기에 소프트웨어 변화가 겹쳤다. Amazon은 2026년 10월 19일 TorchNeuron을 발표했고, 2026년 10월 20일 PyTorch Conference North America에서 공개 베타를 시작했다. Apache 2.0 오픈소스인 TorchNeuron은 기존 XLA 경로를 버리고 PyTorch 네이티브 디바이스 백엔드를 쓰며, eager 모드와 torch.compile, FSDP와 DTensor를 지원한다. AWS는 이를 Trainium 학습으로 넘어올 때의 소프트웨어 포팅 장벽을 제거하는 수단으로 내세우고 있다.
- Samsung은 분리의 양쪽에 서 있고, SK hynix는 HBM 쪽에 서 있다. Samsung은 NVIDIA GPU 플랫폼에서 HBM 점유율 회복을 노리는 동시에, HBM이 아예 없는 LP30의 단독 파운드리다. 그래서 디코딩의 SRAM 이동은 Samsung에게 단순한 손실이 아니다. HBM 쪽 리스크 일부가 평택의 4nm 파운드리 물량으로 전환되는 구조이기 때문이다. 물량 감각을 잡기 위한 예시 계산 (자체 계산, 예시)으로, LPX 랙 1대는 Samsung이 만든 4nm LPU 256개로 구성되고, 랙 1,000대면 LPU 256,000개가 된다. 반대로 SK hynix는 순수하게 HBM 쪽에 노출된 구조다. 다만 이것이 곧바로 HBM 수요 감소를 뜻하지는 않는다. 학습과 프리필은 계속 HBM을 먹는다. Rainier가 약 50만 개에서 약 100만 개 칩으로 확장되고, 차세대 Trainium3 칩마다 HBM3e 144GB가 실리는 한, 가까운 시기의 HBM 수요가 SRAM 디코딩 때문에 꺾일 이유는 약하다. SRAM이 제한하는 것은 HBM 성장 서사 가운데 추론 구간, 그중에서도 지연시간에 프리미엄을 지불하는 디코딩 조각뿐이라는 것이 2026년 10월 24일 기준의 해석이다.
- 이 분리를 반증할 조건도 이미 보인다. 첫째, NVIDIA의 설계 자체가 디코딩 어텐션을 Rubin GPU, 즉 HBM 쪽에 남겨 둔다. 분리는 랙 안에서 일어나는 일이지 승자독식이 아니다. 둘째, 용량 계산이 조 단위 모델에서는 SRAM 쪽에 불리하게 작동한다. 1조 파라미터 모델은 FP8 가중치만으로 LPX 랙 최소 8대가 필요하고, 긴 컨텍스트에서 불어나는 KV 캐시까지 더하면 필요 대수는 더 늘어난다. 컨텍스트가 길어질수록 용량의 벽이 다시 커지는 셈이다. 셋째, 중국 변수다. SRAM 디코딩 경로는 이론상 고급 HBM이 필요 없어 HBM 수출통제의 병목을 우회할 수 있지만, 2026년 10월 24일 기준 양산이 공개된 중국산 SRAM 디코딩 가속기는 없다. 이유는 구조적이다. SRAM 위주의 다이는 면적을 많이 차지하고 (LP30은 4nm에서 칩당 SRAM 500MB), 그 첨단 로직 공정 자체가 제약 대상이며, 진짜 해자는 메모리 셀이 아니라 결정적 실행을 가능하게 하는 컴파일러에 있기 때문이다. 이 문단의 중국 관련 평가는 해석이다.
Chase의 시각
디코딩은 지연시간 사업이고, 학습은 용량 사업이다. 하나의 메모리 월이라고 부르던 것이 사실은 두 개의 벽으로 갈라졌다. 디코딩을 막는 대역폭의 벽과, 학습과 프리필, 긴 컨텍스트를 막는 용량의 벽이다. 각 벽마다 이기는 실리콘이 다르다.
실무자 관점에서 흥미로운 지점은 따로 있다. 컴파일러가 실행 순서를 미리 정하는 결정적 칩은, 어려운 문제를 런타임 하드웨어 중재에서 컴파일 시점 스케줄링으로 옮겨 놓는다. 칩 256개가 350ns 링크로 묶인 랙은 전체가 하나의 거대한 static timing 문제와 다름없다. 결국 컴파일러를 가진 쪽이 아키텍처를 가진다.
앞으로 확인할 것은 네 가지다. 첫째, 2026년 4분기 실적 발표에서 LPX 랙 출하 대수가 숫자로 등장하는지. 둘째, 독립 회사로 남은 Groq가 NVIDIA 내부의 자사 라이선스 설계와 경쟁하면서도 클라우드 추론 점유율을 지켜내는지. 셋째, TorchNeuron 이후 Anthropic과 OpenAI의 약정에 이어 두 번째 프론티어 랩이 Trainium 학습에 붙는지. 넷째, 다음 Rubin 세대에서 GPU 쪽 디코딩 비중이 커지는지 작아지는지다.
시사점
메모리 수급을 보는 질문 자체가 바뀐다. 얼마나 빠른 HBM인가가 아니라, 어느 구간에 붙는 메모리인가를 나눠 봐야 한다. 학습과 프리필용 HBM 수요 곡선과, 디코딩용 SRAM 및 파운드리 수요 곡선은 서로 다른 속도로 움직인다.
파운드리 관점에서는 평택 사례가 보여주듯, 최첨단이 아닌 4nm급 라인도 AI 물량의 중심에 설 수 있다. 디코딩 칩은 최신 공정보다 SRAM 밀도와 수율, 그리고 컴파일러와의 공동 최적화가 경쟁력을 가른다.
모델 서빙 사업자에게는 하이브리드 구성이 원가 구조를 바꾼다. 지연시간에 프리미엄이 붙는 구간만 SRAM으로 떼어 내고 나머지는 GPU에 남기는 방식이다. 다만 조 단위 모델에서 랙 최소 8대라는 계산이 말해주듯, 소규모 서빙에서는 GPU 기본값이 쉽게 무너지지 않는다.
한국 공급망으로 좁히면, Samsung은 양면 헤지를 갖춘 쪽이고 SK hynix는 학습 사이클에 노출된 쪽이다. 같은 메모리 분기점에서도 두 회사의 리스크 프로파일은 서로 다르게 움직인다는 것이 2026년 10월 24일 기준의 해석이다.
자주 묻는 질문
Q. SRAM 디코딩이 확산되면 HBM 수요가 줄어드나요? A. 단기적으로는 줄지 않습니다. 2026년 10월 24일 기준 학습과 프리필, 그리고 디코딩 어텐션은 HBM에 남아 있고, SRAM이 맡는 구간은 지연시간에 민감한 디코딩의 일부입니다. AWS Project Rainier는 Trainium2 약 50만 개에서 약 100만 개로 확장 중이고, Trainium3는 칩당 144GB의 HBM3e를 답니다. SRAM이 제한하는 것은 HBM 성장 서사 가운데 추론, 그중에서도 지연 프리미엄 디코딩 조각뿐입니다.
Q. Groq 3 LPX 랙 하나로 1조 파라미터 모델을 돌릴 수 있나요? A. 가중치만으로는 안 됩니다. 자체 계산으로, FP8 기준 1조 파라미터 가중치는 1,000GB라서 SRAM 128GB 랙이 최소 8대 필요합니다. 70B 모델은 70GB라 랙 1대에 들어가고, 405B 모델은 최소 4대가 필요합니다. 반대로 HBM 20.7 TB를 단 AWS Trn3 UltraServer는 세 모델 모두 1대에 여유 있게 들어갑니다.
Q. Samsung은 이 분리에서 손해인가요, 이득인가요? A. 양쪽에 서 있기 때문에 단순한 손해가 아닙니다. Samsung은 NVIDIA GPU 플랫폼에서 HBM 점유율 회복을 노리는 동시에, HBM이 없는 Groq 3 LP30의 단독 파운드리입니다. 디코딩이 SRAM으로 이동하면 HBM 리스크 일부가 평택 4nm 파운드리 물량으로 전환됩니다. 자체 계산으로 LPX 랙 1대는 Samsung이 만든 LPU 256개이고, 1,000대면 256,000개입니다.
Q. 중국이 SRAM 디코딩으로 HBM 수출통제를 우회할 수 있나요? A. 이론상으로는 가능한 경로지만, 2026년 10월 24일 기준 양산이 공개된 중국산 SRAM 디코딩 가속기는 없습니다. SRAM 위주 다이는 면적을 많이 차지하고, 그 자체로 제약이 있는 첨단 로직 공정이 필요하며, 진짜 해자는 메모리 셀이 아니라 컴파일러 스케줄링에 있기 때문입니다. 이 문단의 평가는 해석입니다.
본 글은 2026년 10월 24일 기준 공개 발표와 보도에 근거한 분석이며 투자 권유가 아닙니다. 벤더 수치는 각 사 발표 기준이고, 보도된 거래 규모와 약정 규모는 공식 확인된 수치가 아닙니다.
📩 오늘 놓친 분석, 내일 아침엔 메일함에서
매일 10:30 Daily Silicon과 실적·IB 리포트 핵심 해설을 가장 먼저 보내드립니다. 삼성전자·SK하이닉스·TSMC·HBM 수급까지, 현직 엔지니어 관점으로 정리합니다. 이미 300명 이상이 받고 있습니다.
무료로 구독하기 →
무료 · 스팸 없음 · 언제든 해지 가능