 VLSI Korea
Tensordyne 딥다이브: 곱셈을 덧셈으로 바꾸는 LNS 추론 칩, 약 10억 달러 가격의 실체
LNS로 곱셈을 덧셈으로 바꾸는 Tensordyne의 Napier 칩과 약 10억 달러 밸류에이션을 검증한다. 조달 1억 7,600만 달러는 확인되지만 밸류에이션은 2차시장 추정과 회사 자체 추정이 근거이며, 성능 수치는 전부 시뮬레이션이다.


30초 요약
Tensordyne은 로그 수 체계(LNS, Logarithmic Number System)로 곱셈을 덧셈으로 바꿔 AI 추론 비용을 낮추겠다는 미국·독일 기반 AI 칩 스타트업이다. 2017년 Recogni로 창업해 차량용 비전 칩을 만들다가 2025년 9월 Tensordyne으로 사명을 바꾸고 데이터센터 추론으로 피벗했다. 2026년 6월 15일 발표한 첫 데이터센터 칩 Napier(TDN)는 TSMC 3nm 공정에서 테이프아웃을 마치고 웨이퍼 생산에 들어갔다. 회사는 자사 시뮬레이션 기준으로 Nvidia GB300 NVL72 랙 대비 13배의 처리량(tokens per second)과 17배의 전력 효율(tokens per watt)을 주장한다. 누적 조달액은 약 1억 7,600만 달러(약 2,464억 원, 환율 1달러=1,400원 기준)로 복수 매체에서 교차 확인된다. 반면 약 10억 달러(약 1조 4,000억 원)라는 밸류에이션은 1차 발행 라운드에서 공시된 post-money 가치가 아니다. 2차 거래 플랫폼이 제시한 추정가(약 9억 9,200만 달러)와 회사가 제시하는 자체 추정이 맞물린 숫자로, 독립 검증이 되지 않았다. 이 글의 중심 질문은 하나다. 검증 정보가 이토록 적은 회사의 가격을 어떻게 읽어야 하는가.
Background — 차량용 비전 칩에서 데이터센터 추론으로
Tensordyne의 출발점은 2017년 9월, Recogni라는 이름이었다. 공동창업자는 R.K. Anand(Chief Product Officer)와 Gilles Backhus(Head of AI)이며, Emily Stuart도 공동창업자로 이름을 올린다. Anand는 Sun Microsystems와 Juniper Networks에서 경력을 쌓은 신호처리·네트워킹 전문가이고, Backhus는 뮌헨공대 출신으로 스탠퍼드에서 풀듀플렉스 무선 연구를 했다. 두 사람의 공통분모는 반도체 자체보다 신호처리와 통신에 가깝다. 이 배경은 뒤에 나오는 cell-based 네트워크온칩(NoC)과 저지연 패브릭 설계에서 다시 등장한다.
초기 Recogni는 자율주행용 비전 추론 칩을 노렸다. 2020년 12월에는 1 PFLOP급 비전 추론 제품 Scorpio를 공개했고, 25W 이하 전력과 10ms 이하 지연을 내세웠다. 그러나 차량용 반도체는 설계에서 매출까지의 사이클이 길고 물량이 데이터센터와 비교가 되지 않는다. 2022년 7월, 전 ZF Group 임원 Marc Bolitho가 CEO로 합류한 시점과 맞물려 회사는 생성형 AI 추론 쪽으로 무게중심을 옮기기 시작했다.
조달 이력은 비교적 명확하게 확인된다. 2019년 Series A 2,500만 달러, 2021년 Series B 4,890만 달러를 거쳐, 2024년 2월 20일 Series C 1억 200만 달러를 Celesta Capital과 GreatPoint Ventures 공동 리드로 마감했다. 기존 투자자 Mayfield, DNS Capital, BMW i Ventures와 신규 투자자 Pledge Ventures, 사우디 국부펀드(PIF) 산하 Tasaru Mobility Investments가 참여했고 HSBC Innovation Banking이 부채를 제공했다. Series C 당시 회사는 밸류에이션을 공개하지 않았다. 이후 비공개 후속 라운드(Series C 확장)가 데이터베이스에 기록돼 있으나 금액은 공개되지 않았다. 2025년 9월 사명을 Tensordyne으로 바꾸며 피벗을 공식화했고, 2026년 6월 Napier를 발표하면서 Series D를 준비 중이라고 밝혔다. 본사는 캘리포니아 Sunnyvale(초기에는 San Jose로 표기)와 독일 뮌헨에 있으며, 직원 수는 약 120~150명 수준으로 보도된다.
가격 이야기를 하기 전에 한 가지를 분명히 해둘 필요가 있다. 이 회사에 대해 공개된 정보의 대부분은 회사 발표, 회사 백서, 회사 임원 인터뷰에서 나온다. 독립 벤치마크, 고객사 명의의 도입 사례, 감사받은 매출 수치는 2026년 10월 현재 공개된 것이 없다. 이 글에서 다루는 모든 성능 수치는 그 전제 위에서 읽어야 한다.
Business Deep Dive — LNS라는 수치체계 베팅의 실체
핵심 아이디어: 곱셈을 덧셈으로
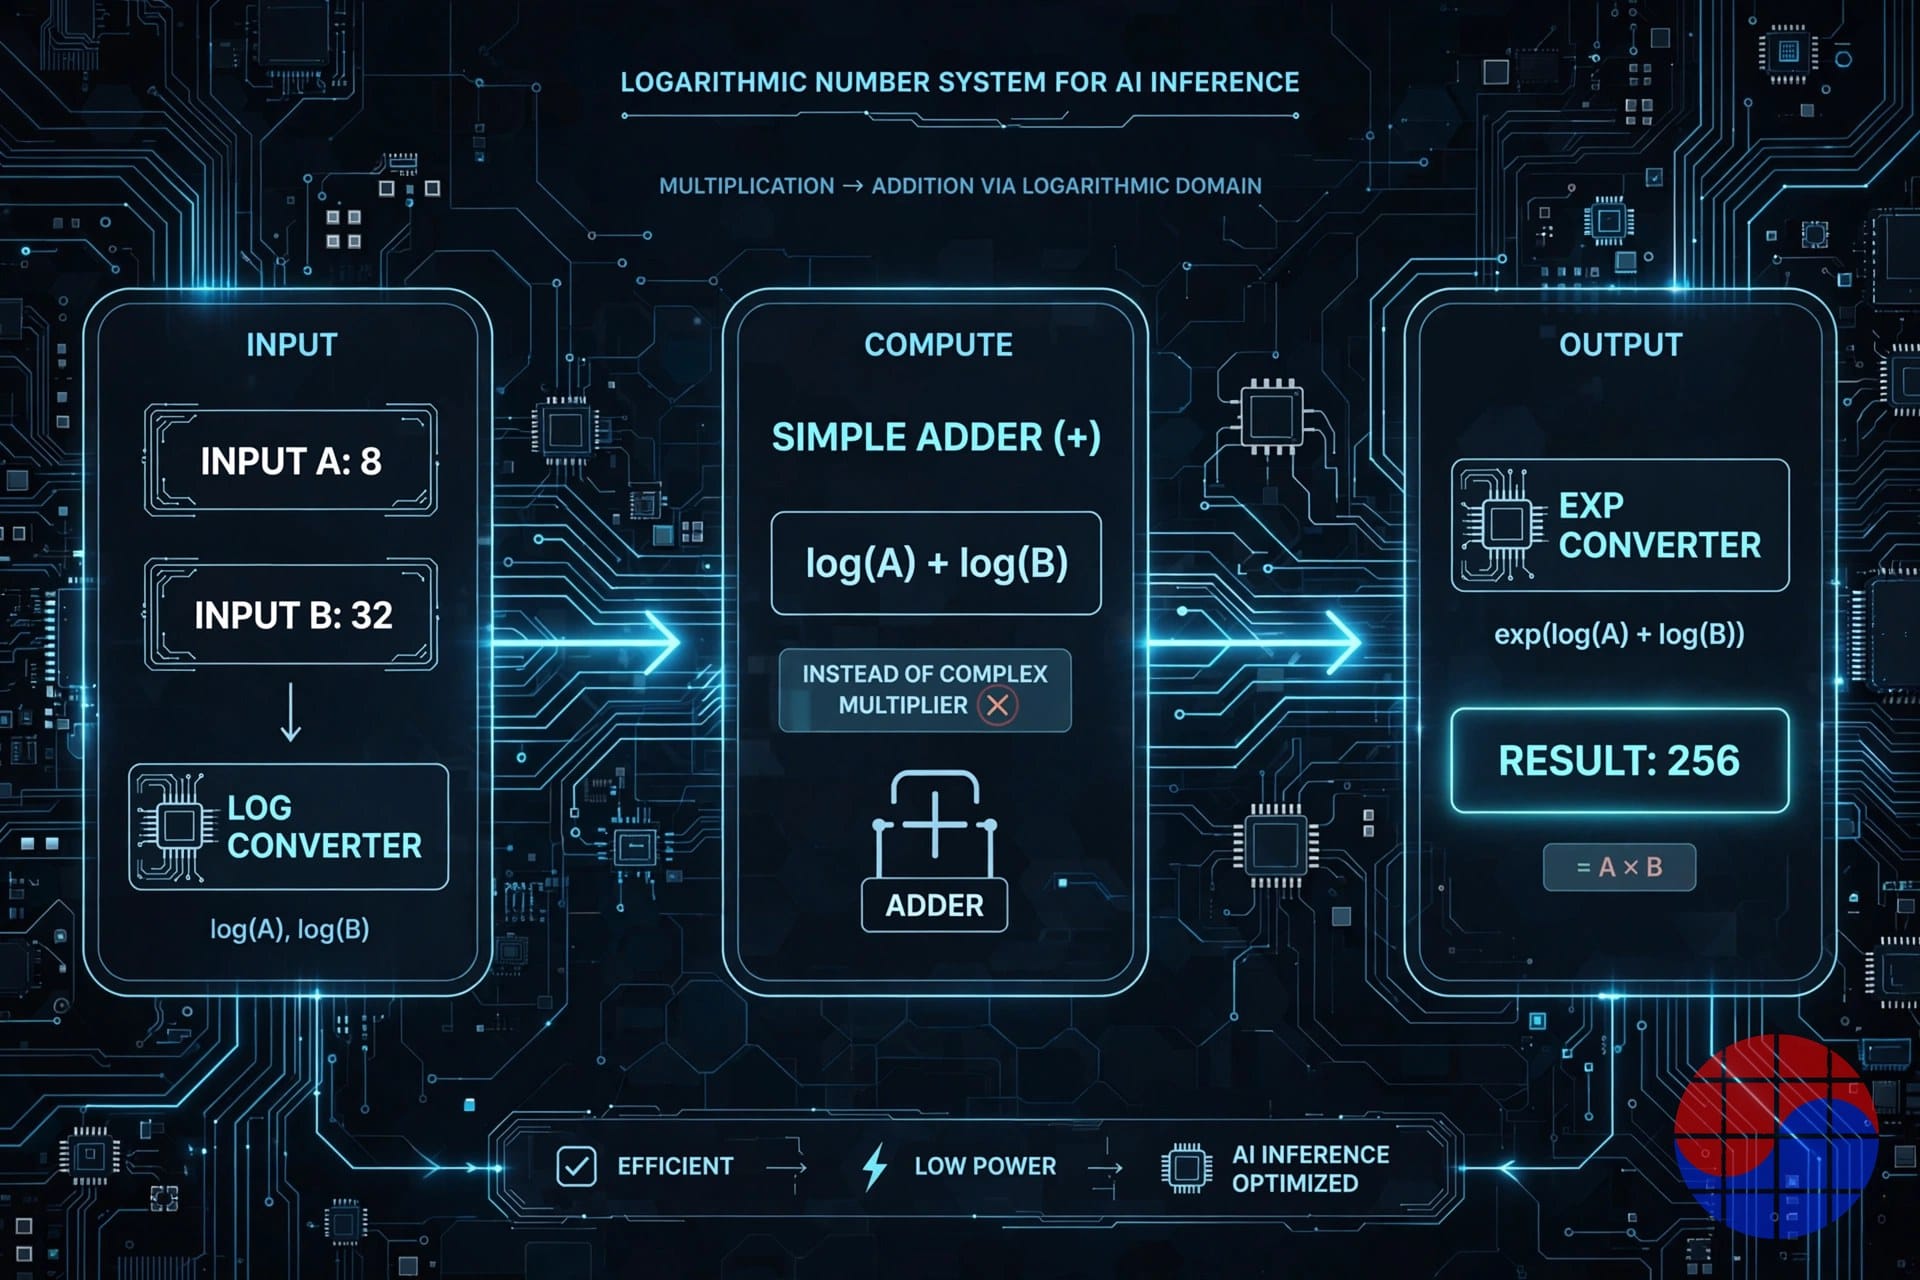
신경망 추론의 연산은 대부분 행렬 곱셈, 즉 곱셈과 누적 덧셈(multiply-accumulate)의 반복이다. 부동소수점 곱셈기는 가산기보다 실리콘 면적도, 에너지도 훨씬 많이 쓴다. LNS는 이 곱셈을 우회한다. log(A×B) = log(A) + log(B)이므로, 숫자를 로그 영역으로 한 번 변환해 두면 곱셈이 덧셈으로 바뀐다. 1614년 John Napier가 천문학 계산을 쉽게 하려고 로그표를 만든 것과 같은 원리이며, 칩 이름 Napier도 여기서 왔다. 회사는 이를 모든 설계 결정 아래에 깔리는 이득이라는 뜻에서 "zeroth scaling law"라고 부른다.
회사가 제시하는 회로 수준 수치는 이렇다. 동일 공정에서 16-bit 부동소수점 곱셈이 약 1.1 pJ와 1,640 µm²를 쓰는 반면, 로그 방식은 약 0.05 pJ와 67 µm²로 같은 일을 한다는 것이다. 에너지 약 22배, 면적 약 25배 차이다. 다만 시스템 수준으로 올라가면 이득은 줄어든다. 회사 백서 요약 기준으로 연산 면적 약 3배, 연산 전력 약 5배 개선이 시스템 주장에 가깝다. 회로 수치와 시스템 수치 사이의 간격 자체가 이 베팅을 읽는 첫 번째 단서다. 병목이 곱셈기에만 있는 것이 아니기 때문이다.
왜 LNS는 40년 넘게 주류가 되지 못했나
LNS는 새로운 아이디어가 아니다. 학계에서 수십 년간 연구됐지만 전용 하드웨어로 제품화된 적은 사실상 없었다. 이유는 세 가지다. 첫째, 로그 영역에서의 덧셈이 어렵다. 곱셈은 덧셈으로 바뀌지만, 곱셈 결과를 다시 더하는 누적 연산은 로그 영역에서 값비싼 근사 함수(Gaussian logarithm)를 필요로 한다. 둘째, 선형 영역과 로그 영역 사이의 변환 오버헤드와 정밀도 손실, 특히 0에 가까운 값과 작은 값들의 누적에서 생기는 오차가 문제다. 셋째, 추론 워크로드 상당수는 연산이 아니라 메모리 대역폭에 묶여 있다(memory-bound). 곱셈을 싸게 만들어도 HBM에서 데이터를 가져오는 병목은 그대로 남는다.
Tensordyne의 지적재산(IP) 주장은 정확히 첫 번째 지점에 있다. 독자 수치체계인 Pareto(TDN Math)의 핵심은 로그 영역 덧셈을 효율적으로 근사하는 방식과 그 하드웨어 구현이라는 것이다. 회사는 재학습이나 캘리브레이션 없이 기존 모델을 그대로 올릴 수 있고, bit-accurate 에뮬레이션으로 언어·MoE·이미지·오디오·비디오 모델 전반에서 정확도를 검증했다고 말한다. 소프트웨어 스택이 변환을 숨겨 주고 PyTorch와 Triton을 지원한다는 설명이다. 이 주장이 맞다면 역사적 장벽 중 가장 큰 하나를 넘은 것이 된다. 그러나 검증 방식이 회사 내부 에뮬레이션이라는 점, 그리고 실리콘 실측 결과가 아직 없다는 점은 분리해서 봐야 한다.
Napier 칩과 TDN72 시스템
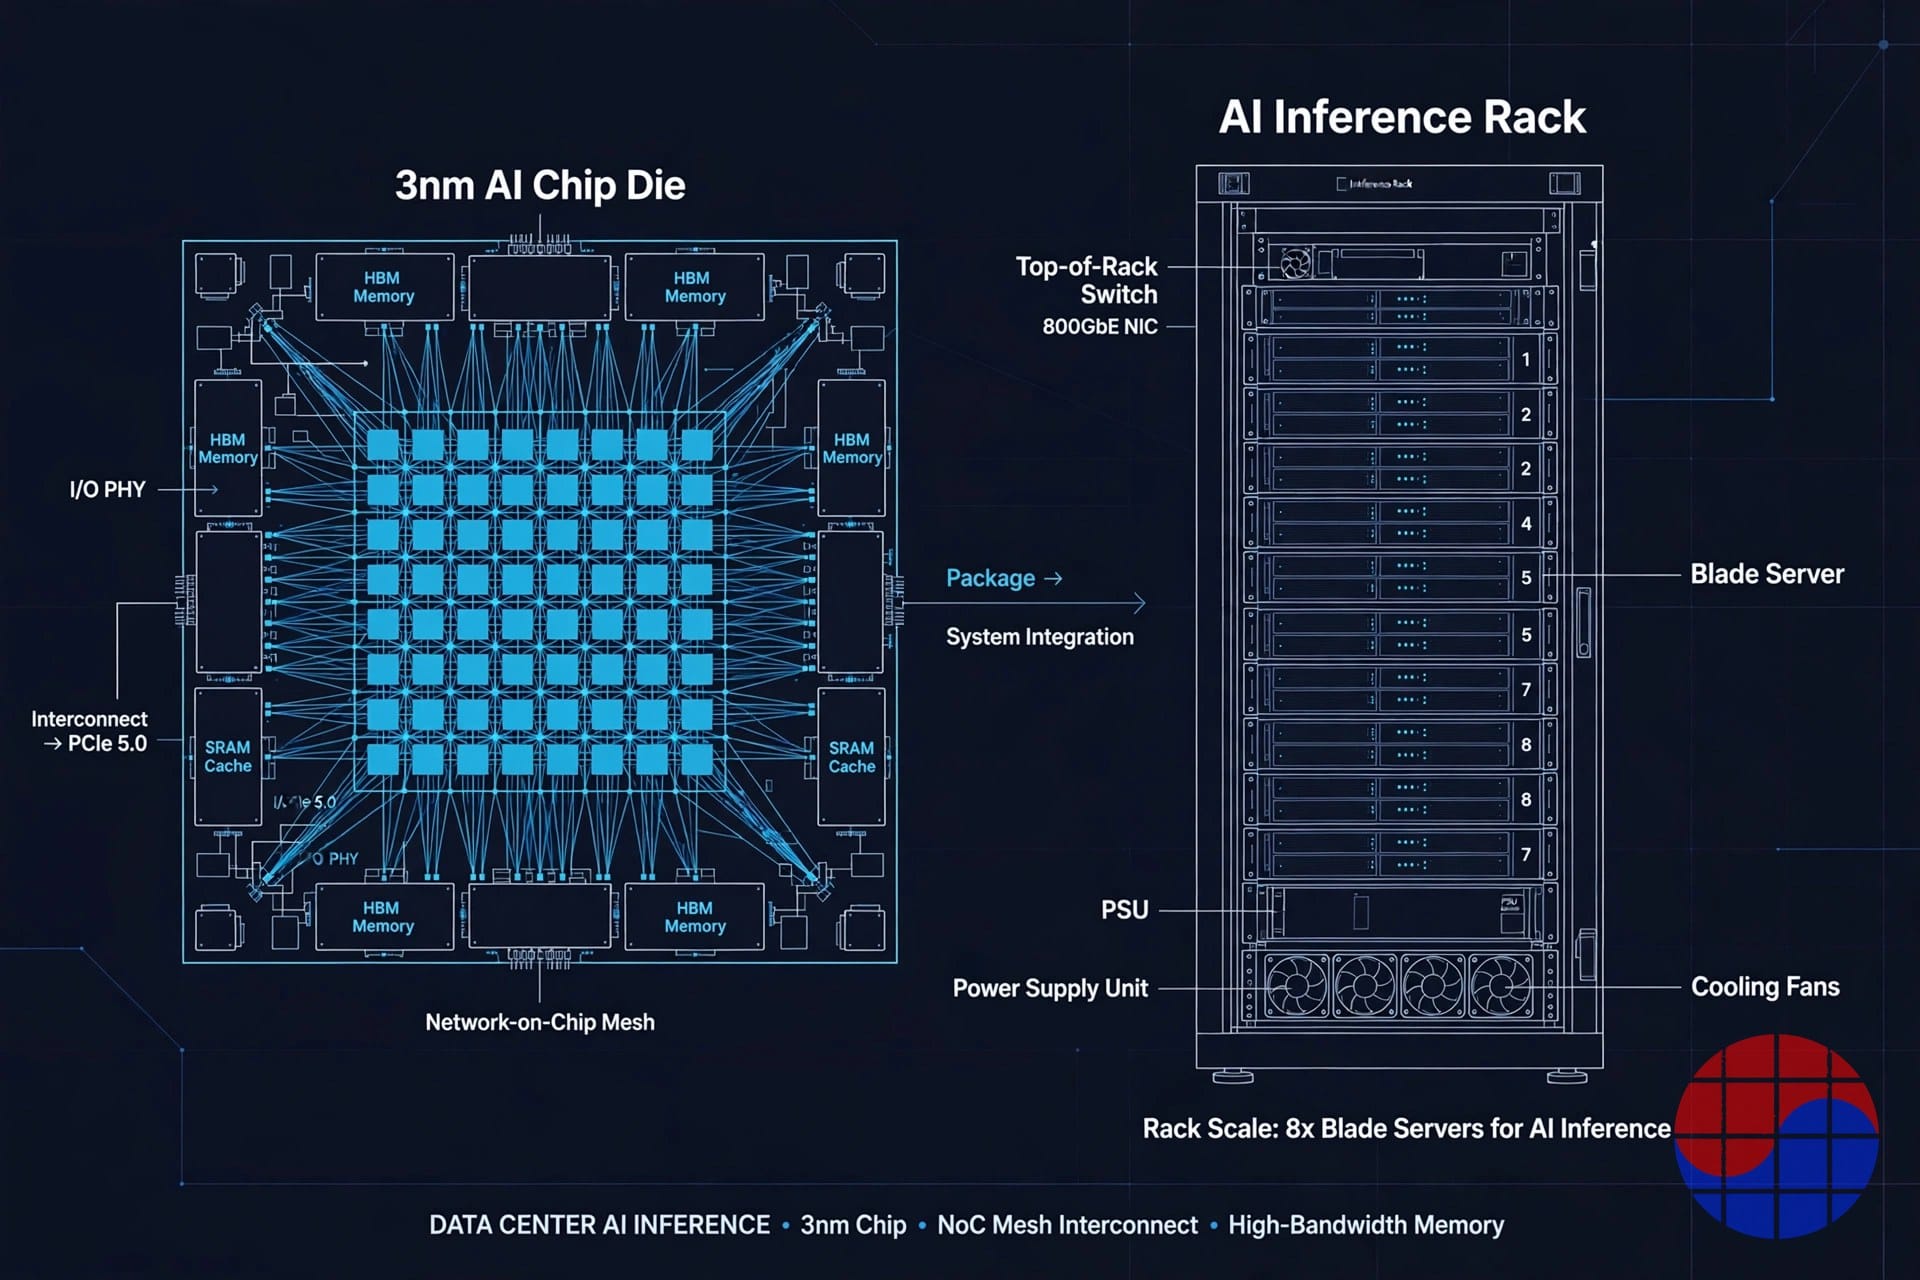
확인 가능한 하드웨어 스펙은 다음과 같다. Napier(TDN AIP)는 TSMC 3nm, 138B(1,380억 개) 트랜지스터, 패키지당 300W, dense FP8 기준 2.11 PFLOPS, 256MB SRAM, 144GB HBM3e를 탑재한다. 연산 코어는 48개이며 RISC-V 코어가 MoE 라우팅 같은 토큰 루프 내 작업을 맡는다. 칩 간 scale-up 패브릭 TDN LINK는 단일 홉 지연 1µs 미만을 내세우고, 72개 칩을 하나의 pod로 묶는다.
| 항목 | Napier 칩 (회사 발표) |
|---|---|
| 공정 | TSMC 3nm, 테이프아웃 완료·웨이퍼 생산 중 |
| 연산 | 2.11 PFLOPS dense FP8, 300W |
| 메모리 | 144GB HBM3e, 256MB SRAM |
| TDN72 pod (72칩) | 30kW, 공랭, 10.4TB HBM |
| 풀 랙 (4 pods, 288칩) | 608 PFLOPS FP8, 42TB HBM, 120kW, 공랭 |
파트너 구성은 이 회사의 몇 안 되는 강한 신호다. 실리콘 공동설계는 Broadcom, 제조는 TSMC, scale-up 섀시와 패브릭은 HPE Juniper가 맡는다. Juniper는 투자자이기도 하다. 3nm 테이프아웃과 양산에는 수천만 달러 단위의 비용이 들고 Broadcom 같은 ASIC 파트너의 실사를 통과해야 하므로, 최소한 "실리콘을 만들 능력과 자금"에 대한 간접 증거로는 읽을 수 있다.
성능 주장과 그 성격
회사의 대표 주장은 DeepSeek-R1 워크로드 기준 랙당 363,000 tokens/sec 대 Nvidia GB300 NVL72 랙의 27,400 tokens/sec, 즉 13배다. 전력당으로는 1MW당 300만 tokens/sec 대 18만 3,000으로 17배를 제시한다. 2조 파라미터 MoE 모델에서는 자사 랙 1개가 경쟁 조합 9개 랙의 일을 하며, 사용자당 1,300 tokens/sec를 100만 토큰당 약 11달러에 제공하는데 경쟁 조합은 약 150달러라는 비교도 내놓았다. 이 수치들은 전부 회사 모델링과 시뮬레이션이다. 비교 기준의 일부는 공개 벤치마크 수치를 가져왔지만, Tensordyne 쪽 실측은 존재하지 않는다. 실리콘은 이제 막 팹에서 나오고 있고, 개발 클라우드는 2026년 말, 베타 시스템은 2027년 1분기, 양산 출하는 2027년 하반기(일부 보도는 2분기)로 예고돼 있다.
고객 신호: LOI는 매출이 아니다
상업적 신호는 "1,200만 달러가 아니라 2억 달러 이상의 예상 수요(forecasted demand)"라는 표현으로 요약된다. 회사는 12곳 이상의 기업이 베타 평가를 위한 의향서(LOI)를 냈다고 밝혔고, 인프라 사업자 2곳의 이름이 거론된 바 있다. 그러나 LOI는 구속력 있는 구매계약이 아니며, 유료 양산 고객과 매출은 공개되지 않았다. AI 칩 스타트업에서 LOI가 실제 매출로 전환되는 비율은 역사적으로 낮다. 이 신호는 "관심"으로는 읽을 수 있어도 "수요 확정"으로는 읽을 수 없다.
Chase's Take — 시장은 왜 이 가격을 붙이는가
여기서 본론으로 들어간다. 약 10억 달러라는 숫자는 어디서 왔는가. 확인 결과, 이 밸류에이션은 신규 투자 라운드가 정한 가격이 아니다. 가장 최근의 대형 라운드인 2024년 Series C에서 회사는 밸류에이션을 공개하지 않았다. 10억 달러에 가장 가까운 공개 수치는 2차 거래 플랫폼이 산출한 추정가 약 9억 9,200만 달러(2026년 10월 기준)다. 2차시장 추정가는 실제 거래 몇 건과 호가를 바탕으로 한 참고 가격이지, 기관 투자자가 실사 후 서명한 가격이 아니다. 여기에 회사가 다음 라운드(Series D)를 앞두고 제시하는 자체 추정까지 얹히면 "약 1B"라는 숫자가 만들어진다. 성격이 완전히 다른 두 숫자를 구분하는 것이 이 회사를 읽는 출발점이다.
원화로 환산하면 약 1조 4,000억 원(1달러=1,400원)이다. 누적 조달액 약 2,464억 원의 5.7배에 해당한다. 매출이 공개되지 않은 pre-revenue에 가까운 회사가 이 가격을 받으려면, 시장은 사실상 세 가지에 동시에 베팅하고 있는 셈이다. 첫째, LNS의 정확도 장벽을 실제로 넘었다는 것. 둘째, 시뮬레이션 수치의 절반만 실측으로 나와도 추론 원가 구조가 바뀐다는 것. 셋째, 2027년 출하 시점에 추론 시장이 지금보다 훨씬 커져 있고 전력 병목이 구매 기준의 중심에 서 있을 것이라는 점이다. 셋 중 하나라도 어긋나면 가격은 빠르게 재조정된다.
공정하게 보면, 이 베팅이 무근거한 것은 아니다. 추론 비용에서 전력과 냉각이 차지하는 비중은 실제로 커지고 있고, 공랭으로 120kW 랙을 돌릴 수 있다는 점은 액체냉각 전환 부담이 큰 기존 데이터센터에 실질적인 매력이다. Broadcom·TSMC·HPE Juniper라는 파트너 조합도 종이 위의 회사와는 거리가 있다. 반대로 다운사이드도 명확하다. 실측이 없는 성능, 매출이 없는 상업 단계, 그리고 비교 대상인 Nvidia 역시 가만히 있지 않다는 점이다. Napier가 출하되는 2027년 하반기에는 경쟁 랙도 다음 세대로 넘어가 있다. 13배라는 격차는 오늘의 랙과 내일의 랙을 비교한 숫자가 아니라, 내일의 자사 랙과 오늘의 경쟁 랙을 비교한 수치에 가깝다.
내 판단은 이렇다. Tensordyne은 "수치체계를 바꾸면 추론 원가의 기울기 자체가 달라진다"는, 검증되면 산업 구조를 바꾸는 베팅이다. 그러나 2026년 10월 현재 그 베팅의 증거는 실리콘이 아니라 시뮬레이션이다. 그래서 이 회사의 가격은 기술 가격이 아니라 옵션 가격으로 읽어야 한다. 실측 데이터가 나오는 순간 가치가 계단식으로 오르거나 내리는, 이진(binary)에 가까운 자산이다. 약 10억 달러라는 숫자를 액면 그대로 믿을 필요도, 사기라고 단정할 필요도 없다. 그것은 Series D에서 기관이 실제로 얼마를 서명하는지, 그리고 개발 클라우드가 열리는 2026년 말에 제3자가 어떤 숫자를 내놓는지를 기다리며 읽는 참고 가격이다.
Implications — 무엇을 지켜봐야 하는가
투자 관점: 확인 지점은 세 가지다. (1) Series D의 실제 post-money 밸류에이션과 리드 투자자가 누구인지, (2) 2026년 말 개발 클라우드에서 나오는 독립 측정치, 특히 tokens per watt와 모델 정확도 유지 여부, (3) LOI가 유료 베타와 양산 계약으로 전환되는지 여부다. 이 셋이 확인되기 전까지 10억 달러는 검증된 가치가 아니라 시장이 매긴 기대값이다.
산업 관점: Tensordyne의 성패와 무관하게, 이 회사가 던진 질문은 남는다. 부동소수점 곱셈이라는 40년 관행을 수치체계 수준에서 흔드는 시도가 대형 파트너와 3nm 테이프아웃까지 왔다는 사실 자체가, 추론 시대의 경쟁 축이 "더 큰 GPU"에서 "더 싼 토큰"으로 이동하고 있음을 보여준다. LNS가 아니더라도, 수치체계와 양자화를 둘러싼 경쟁은 계속될 것이다.
한국 반도체 관점: Napier 1개 칩에는 144GB의 HBM3e가 들어간다. 풀 랙 기준으로는 42TB다. 이런 추론 전용 ASIC들이 실제로 물량을 만들기 시작하면 HBM 수요의 축이 GPU 한 곳에서 다수의 ASIC으로 넓어진다. 한국 메모리 업계에는 고객 다변화라는 기회이지만, 동시에 ASIC마다 요구하는 메모리 사양과 인증 절차가 달라지는 부담이기도 하다.
자료 한계에 대한 각주: 이 글의 회사 정보는 2026년 10월 19일까지 공개된 회사 발표·백서 요약·언론 인터뷰와 거래 데이터베이스를 교차 확인한 것이다. 성능 수치는 전부 회사 주장이며 독립 검증되지 않았고, 밸류에이션은 1차 라운드 공시값이 아니다. 확인되지 않은 매출·고객·수주 수치는 본문에 싣지 않았다.
FAQ
Tensordyne의 밸류에이션 10억 달러는 확정된 수치인가?
아니다. 2024년 Series C를 포함해 회사는 어떤 라운드에서도 밸류에이션을 공시하지 않았다. 약 10억 달러는 2차 거래 플랫폼의 추정가(약 9억 9,200만 달러, 2026년 10월)와 회사의 자체 추정이 근거인 참고 가격이며, 기관 실사를 거친 1차 라운드 post-money 가치와는 성격이 다르다. 확정 여부는 Series D 공시로 판단해야 한다.
LNS(로그 수 체계)는 왜 이제야 칩으로 나오는가?
원리 자체는 오래됐지만 로그 영역에서의 덧셈 근사와 변환 정밀도가 장벽이었다. 곱셈은 덧셈으로 싸게 바뀌는 반면, 곱한 결과를 다시 더하는 누적 연산과 0 근처 값의 처리가 비싸고 부정확했다. Tensordyne은 독자 수치체계 Pareto의 근사 방식이 이 장벽을 넘었다고 주장하지만, 근거는 회사 내부 에뮬레이션이며 실리콘 실측은 아직 공개되지 않았다.
Napier의 13배·17배 성능 주장은 믿을 수 있는가?
현재로서는 회사 시뮬레이션 수치로만 취급해야 한다. 13배 처리량과 17배 전력 효율은 DeepSeek-R1 기준 회사 모델링 결과이며, 칩이 팹에서 생산 중인 단계라 독립 측정값이 없다. 개발 클라우드가 예고된 2026년 말 이후 제3자 측정치가 나오는지가 첫 번째 검증 지점이다.
Tensordyne의 제품은 언제 살 수 있는가?
회사 일정 기준 개발 클라우드는 2026년 말, 베타 시스템은 2027년 1분기, 양산 출하는 2027년 하반기다. 현재 확보한 상업 신호는 12곳 이상의 평가 의향서(LOI)와 2억 달러 이상의 예상 수요라는 회사 발표뿐이며, 구속력 있는 양산 계약과 매출은 공개되지 않았다.
📩 VLSI Korea 뉴스레터 구독하기
매일 발행되는 반도체 심층 분석을 이메일로 가장 먼저 받아보세요. 구독은 무료입니다.


