 VLSI Korea
d-Matrix e os US$ 2 bilhões: por que o mercado paga para computar dentro da memória
A d-Matrix fechou em novembro de 2025 uma Série C de US$ 275 milhões com valuation de US$ 2 bilhões. Seu acelerador Corsair computa dentro da SRAM a 150 TB/s por placa. Dissecamos a física, a economia da SRAM, o roteiro 3DIMC do Raptor e o que precisa ser verdade para o valuation se sustentar.


🆓 Artigo gratuito · Qualquer pessoa pode ler gratuitamente
Resumo em 30 segundos
A d-Matrix vale US$ 2 bilhões porque vende justamente o que falta na economia da inferência: largura de banda de memória que não sai do chip. A startup de Santa Clara fechou em 12 de novembro de 2025 uma rodada Série C de US$ 275 milhões com valuation de US$ 2 bilhões, elevando o total captado para US$ 450 milhões. Seu acelerador Corsair computa dentro da SRAM — Digital In-Memory Computing, ou DIMC — e declara 150 TB/s de largura de banda no chip por placa, até 30.000 tokens por segundo no Llama 70B a 2 ms por token, e eficiência energética de 3 a 5 vezes maior que a de sistemas baseados em GPU. O Corsair entrou em produção plena em junho de 2026. Os US$ 2 bilhões não pagam a receita de hoje: pagam uma opção — a de que, quando a inferência for o custo dominante da IA, a arquitetura vencedora será a que tratar a memória, e não a aritmética, como o produto.
| Item | Detalhe |
|---|---|
| Avaliação | US$ 2 bilhões (Série C, 12 nov 2025) |
| Captação total | US$ 450 milhões |
| Produto | Corsair (DIMC, TSMC 6 nm) |
| Computação | 2.400 TFLOPS (8 bits) |
| Memória no chip | 2 GB SRAM, 150 TB/s |
| Memória externa | Até 256 GB LPDDR5 |
| Próxima geração | Raptor / 3DIMC (tape-out previsto para o fim de 2026) |
Background: uma empresa fundada para o segundo tempo da IA
A d-Matrix foi fundada em 2019 em Santa Clara, na Califórnia, por Sid Sheth (CEO) e Sudeep Bhoja (CTO). A aposta fundadora não estava na moda: o treinamento não continuaria sendo o gargalo da IA. Depois de treinados, os modelos precisam responder perguntas de forma contínua, em escala e para usuários pagantes. Essa fase de atendimento, a inferência, se tornaria o maior custo do setor. A empresa passou seis anos construindo para essa fase antes de o mercado concordar com ela.
O histórico de captação mostra a tese ganhando adeptos. Uma rodada de US$ 110 milhões em 2023 trouxe a M12, o fundo de venture da Microsoft. A Série C de novembro de 2025 foi coliderada por BullhoundCapital, Triatomic Capital e Temasek, com nova participação da Qatar Investment Authority (QIA) e da EDBI de Singapura, e capital de acompanhamento de M12, Nautilus Venture Partners, Industry Ventures e Mirae Asset. O total captado chegou a US$ 450 milhões, e o quadro passou de 250 pessoas entre Santa Clara, Toronto, Sydney, Bangalore e Belgrado.
O momento importa. No fim de 2025, os hiperescaladores estavam deslocando publicamente o capex de clusters de treinamento para frotas de inferência, e a pergunta central do setor mudou de "quão rápido conseguimos treinar?" para "quanto custa cada token?". A d-Matrix é uma das poucas startups que desenharam seu silício desde o primeiro dia para a segunda pergunta. O valuation de US$ 2 bilhões de uma empresa de chips ainda sem escala precisa ser lido sobre esse pano de fundo.
Business Deep Dive
O produto: computar onde os pesos vivem
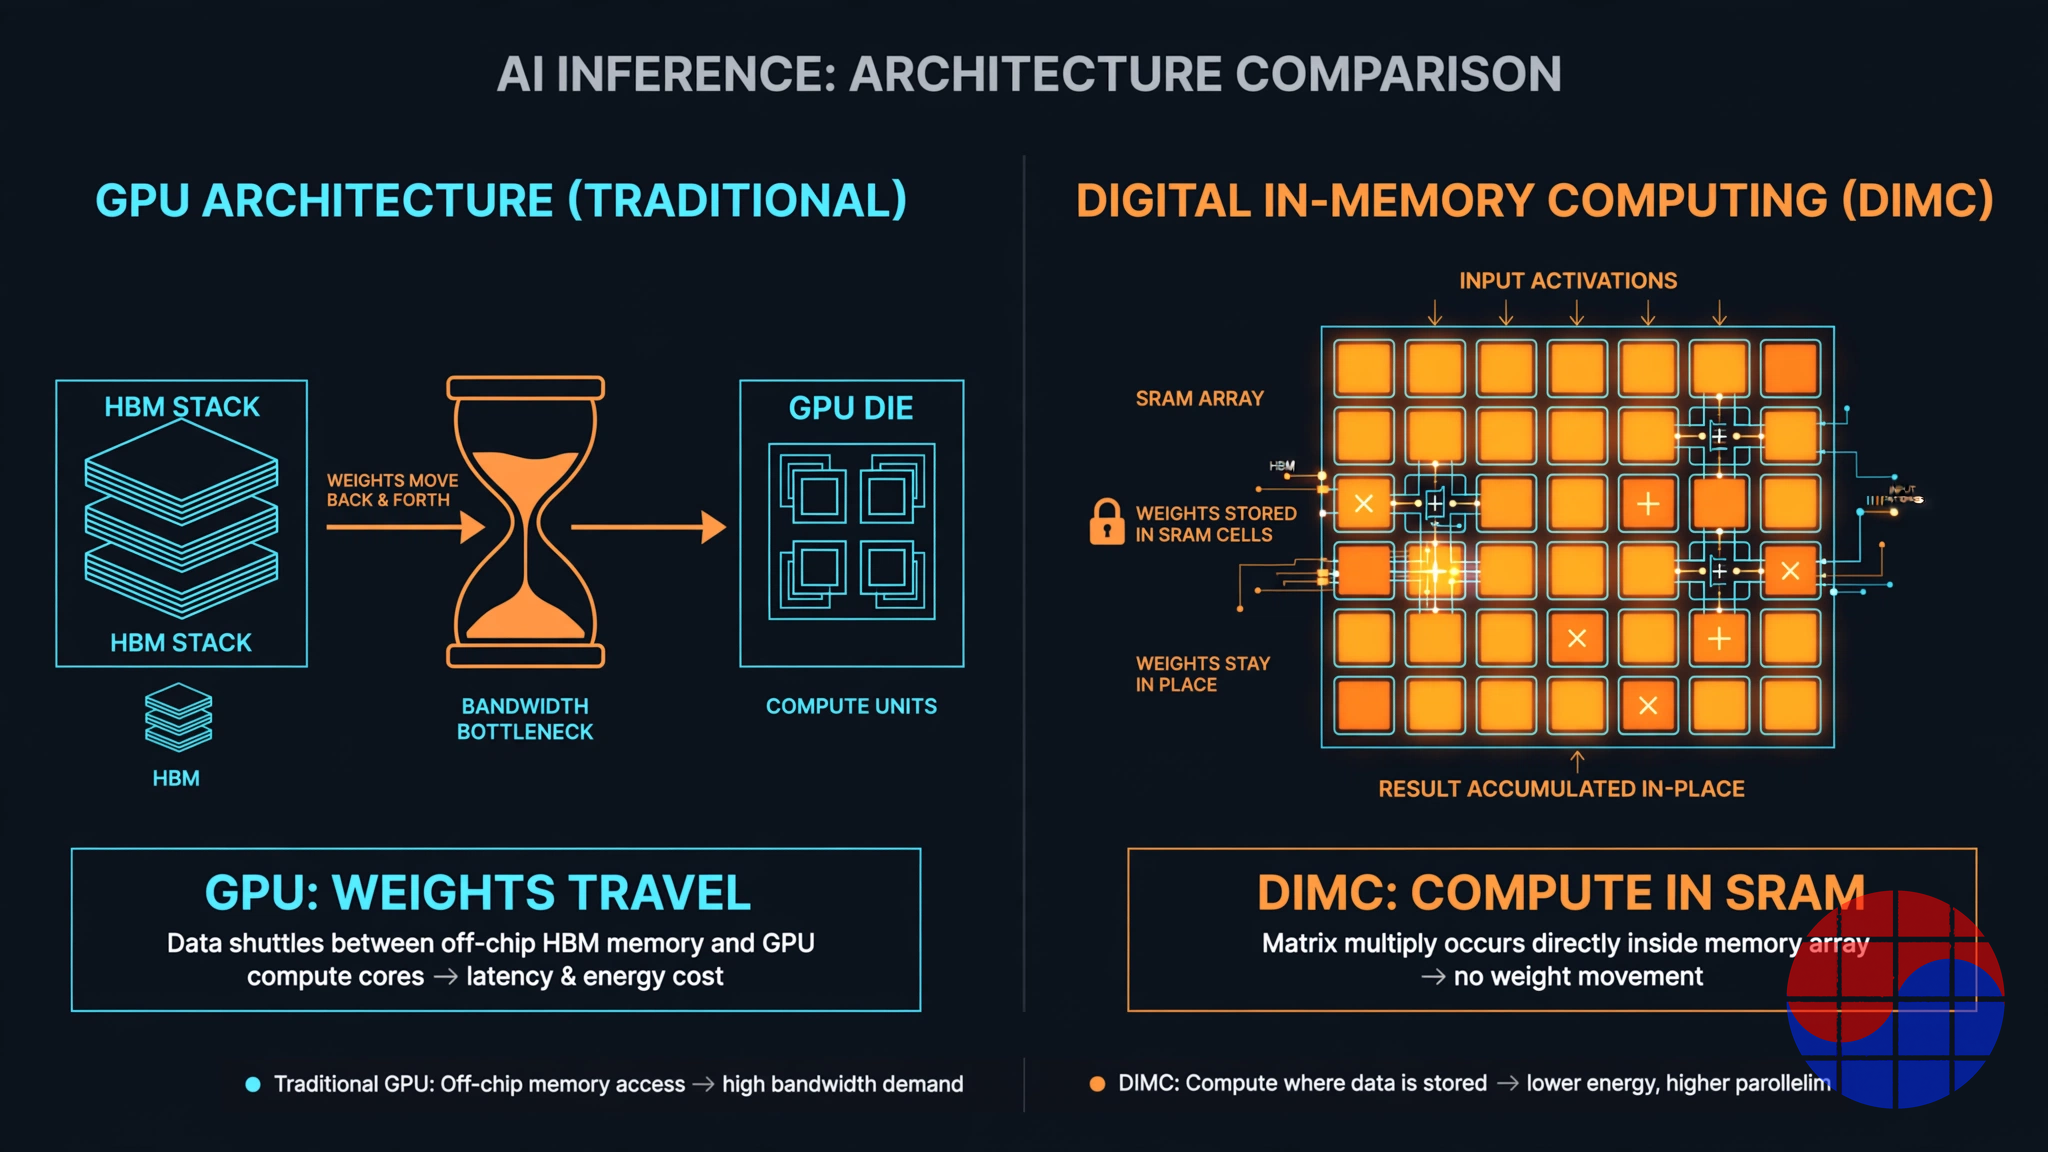
A inferência na fase de decodificação é limitada pela memória. Gerar cada token exige ler os pesos do modelo, e uma GPU gasta boa parte do tempo e da energia movendo esses pesos entre as pilhas HBM e as unidades de computação. O Corsair ataca o movimento em si. Seus núcleos DIMC executam as operações matriciais dentro das matrizes SRAM: os pesos não viajam até onde se computa; eles são computados onde estão.
Os números da placa em produção definem a troca. Cada placa Corsair, fabricada no processo de 6 nm da TSMC em formato padrão PCIe Gen5, entrega 2.400 TFLOPS de computação de pico de 8 bits, 2 GB de Performance Memory no chip (SRAM) a 150 TB/s e até 256 GB de Capacity Memory LPDDR5 fora do chip. Comparando a largura de banda com a HBM: uma pilha HBM3e de ponta entrega cerca de 1,2 TB/s por pilha, e um pacote de GPU completo soma da ordem de 8 TB/s. Os 150 TB/s do Corsair são largura de banda de SRAM dentro do chip, não do pacote — uma grandeza diferente, e a comparação favorece a d-Matrix. Mas a direção é real: na decodificação de lotes pequenos e sensível à latência, manter os pesos em SRAM elimina a viagem de ida e volta que domina a latência de token de uma GPU.
O que o dinheiro da Série C compra de fato é a plataforma ao redor do chip. As NICs JetStream conectam placas e racks com baixa latência. A pilha de software Aviator compila modelos escritos em PyTorch e Triton para o tecido DIMC. O SquadRack, uma arquitetura de rack de referência construída com Arista, Broadcom e Supermicro, transforma as placas em sistemas implantáveis, e os clusters Squadron, anunciados como disponíveis em geral em outubro de 2026, escalam até 1.024 XPUs Corsair em 16 racks em data centers padrão com refrigeração a ar. O Corsair entrou em produção plena em junho de 2026, com remessas em volume voltadas a hiperescaladores, neoclouds e laboratórios de IA de fronteira. Em abril de 2026, a empresa também adquiriu o negócio de data center da GigaIO, somando o tecido de memória FabreX e os projetos de sistema SuperNODE.
O teto da SRAM, e por que o Raptor existe
A força da arquitetura é também o seu teto. A SRAM é rápida e ruinosamente cara por bit. Os 2 GB de Performance Memory do Corsair não comportam um modelo de 70B; o restante vive na LPDDR5 Capacity Memory, e o desempenho real depende de quão bem o Aviator divide o trabalho entre os dois níveis. A SRAM também não encolhe como a lógica: em nós avançados sua densidade melhora devagar, de modo que um roteiro de SRAM pura encarece a cada geração o custo por capacidade de geração de tokens. É a pergunta de economia de processo que toda startup de computação em memória precisa responder.
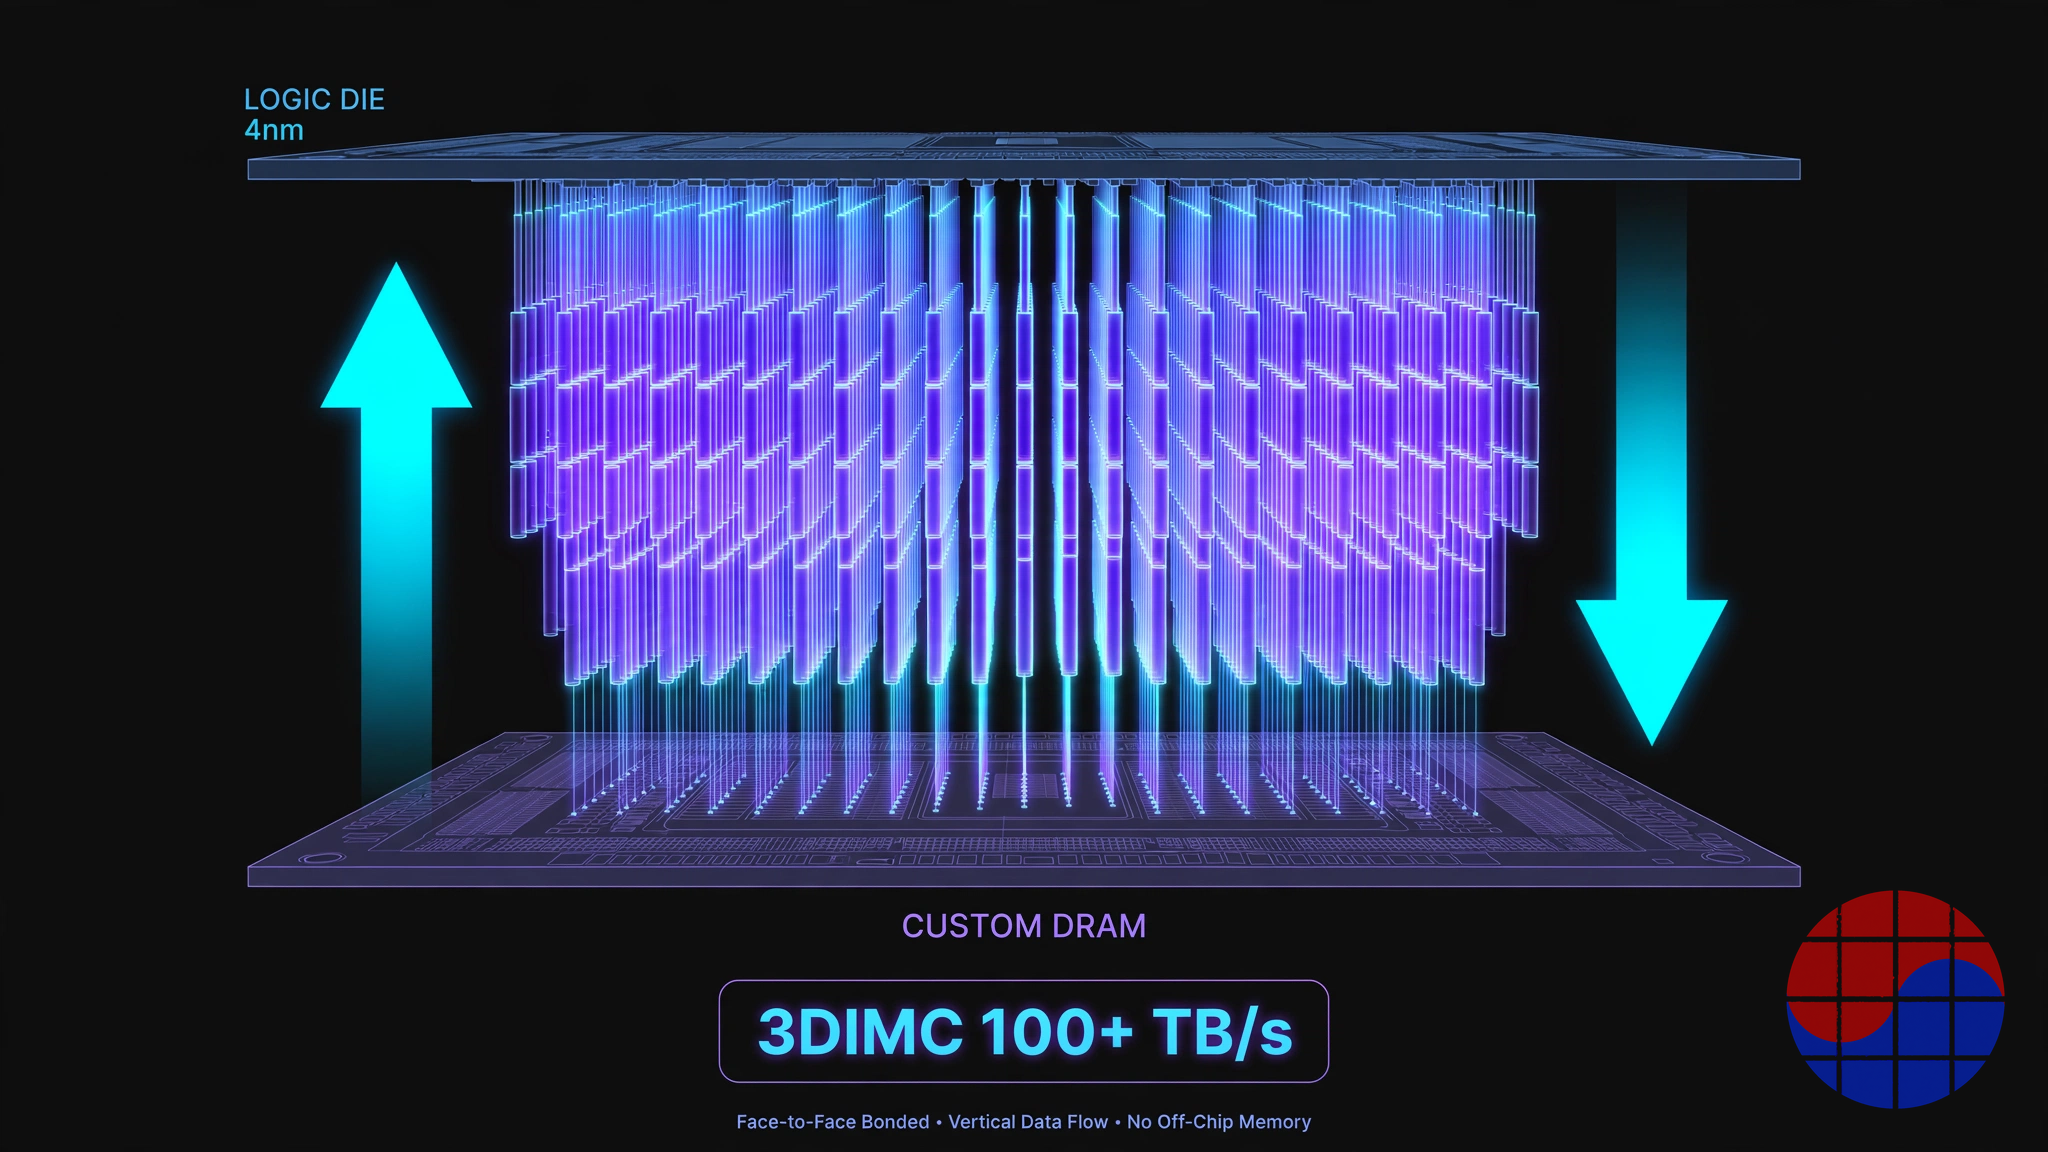
A resposta da d-Matrix é o 3DIMC, incorporado na próxima plataforma Raptor. Apresentado pelo veículo de teste Pavehawk junto à Alchip em novembro de 2025, o Raptor une face a face um die lógico de 4 nm da TSMC a um die DRAM personalizado com passo de 36 mícrons. A empresa projeta mais de 100 TB/s de largura de banda e 32 GB — 256 Gb — de memória empilhada por acelerador a 0,37 pJ/bit, e os primeiros resultados de silício apresentados em 2026 relataram throughput de inferência por acelerador cerca de 4,7 vezes maior que o de uma configuração baseada em HBM. O Raptor deve concluir o tape-out até o fim de 2026, com disponibilidade em rack no quarto trimestre de 2027. Em setembro de 2026, a d-Matrix entrou para o ecossistema NVLink Fusion da NVIDIA, de modo que as XPUs Raptor são projetadas para encaixar em racks MGX da NVIDIA ao lado de GPUs, em vez de exigir uma substituição completa.
O que precisa ser verdade para valer US$ 2 bilhões
Despida até a aritmética, a história é esta: um valuation de US$ 2 bilhões sobre US$ 450 milhões captados, antes de receita em volume, precifica a d-Matrix como um futuro negócio de plataforma, não como vendedora de componentes. Três coisas precisam se confirmar. Primeira: o gasto com inferência precisa continuar crescendo de forma composta, até que uma camada de decodificação especializada vire uma linha orçamentária que os hiperescaladores financiem separadamente das GPUs. Segunda: a economia declarada pelo Corsair — 10 vezes mais interatividade, 3 vezes melhor desempenho por custo total de propriedade, 3 a 5 vezes mais eficiência energética, tudo números reportados pela empresa — precisa sobreviver ao contato com cargas de trabalho de produção de clientes nomeados, e não apenas com benchmarks do Llama. Terceira: o fosso de software precisa se formar; o Aviator tem de se tornar aderente o bastante para que os clientes não tratem o hardware como mercadoria trocável quando NVIDIA, AMD ou a equipe de ASIC de um hiperescalador lançar uma resposta boa o suficiente.
A evidência de tração até aqui é real, mas incompleta. O status de produção plena, uma linha de racks fabricada pela Supermicro, uma aquisição que adiciona tecido em nível de sistema e uma base de investidores com peso de fundos soberanos (Temasek, QIA, EDBI) indicam que compradores sofisticados estão fazendo due diligence e permanecendo. O que ainda falta é a classe de evidência que, no fim, precifica startups de chips: implantações de produção divulgadas com hiperescaladores nomeados e pedidos repetidos. Um esforço reportado em julho de 2026 para captar capital adicional a um valuation maior, e o interesse reportado da NVIDIA em investir, permanecem não confirmados e devem ser tratados como reportados, não estabelecidos.
O lado negativo: a HBM contra-ataca, e o software é um imposto
O caso pessimista tem duas frentes. A primeira é a física e os roteiros. A HBM não está parada: a HBM4 amplia a interface para 2.048 bits por pilha, e os fornecedores de GPU integram SRAMs maiores, interconexões mais rápidas e SKUs otimizados para inferência. A cada geração, a distância de latência que justifica um acelerador separado diminui, enquanto o incumbente de GPU oferece uma única pilha de software para treinamento e inferência. A segunda frente é o imposto de adoção. Toda plataforma que não é CUDA pede aos clientes que portem modelos, confiem em um compilador jovem e aceitem o risco de fornecedor sobre o balanço de uma startup. A d-Matrix mitiga isso com posicionamento heterogêneo: o Corsair como descarga de decodificação ao lado das GPUs, formalizado pelo movimento NVLink Fusion e pela demonstração de Attention-FFN Disaggregation (AFD), que dividiu a atenção para as GPUs e as camadas feed-forward para as XPUs Corsair e mostrou 845 tokens por segundo por usuário com 64 usuários simultâneos. Mitigar não é eliminar: o imposto é pago em cada ciclo de vendas.
Chase's Take
A maioria das startups de chips de IA vende um motor mais rápido. A d-Matrix vende outra identidade contábil: na decodificação, tokens por segundo são aproximadamente a largura de banda dividida pelo tamanho do modelo, então quem detém a largura de banda detém a margem. Escolher computação em memória digital em vez de analógica foi a decisão silenciosamente correta: a IMC analógica deslumbra em demonstrações e descalibra em produção, enquanto o DIMC preserva o determinismo da SRAM e sobrevive às migrações de processo. A pergunta honesta não é se a física funciona; o Pavehawk e os resultados de silício de 2026 dizem que sim. A pergunta é se a economia da SRAM mais uma pilha de software jovem conseguem sustentar uma camada defensável diante de um incumbente que pode empacotar sua resposta dentro do rack de GPU que o cliente já comprou. A decisão do NVLink Fusion me diz que a gestão entende isso: a d-Matrix não tenta vencer o rack da NVIDIA, tenta virar uma linha dentro dele. A US$ 2 bilhões, os investidores não pagam por esse resultado: pagam pelo caminho ponderado por probabilidade até ele, com o caixa da Série C financiando exatamente as duas provas que ainda faltam — escala de produção nomeada e o Raptor no prazo.
Implications
Para hiperescaladores e neoclouds: aceleradores da classe do Corsair transformam a inferência em um problema de design heterogêneo. A pergunta de compra muda de "qual GPU?" para "quais camadas rodam onde?", e a desagregação no estilo AFD vira disciplina de planejamento de capacidade, não experimento.
Para a indústria de memória: a d-Matrix é um sinal de demanda com um aviso. Seu produto atual contorna a HBM com SRAM e LPDDR5, e a DRAM empilhada personalizada do Raptor sugere que a disputa de longo prazo não é HBM contra nada, e sim HBM padrão contra memória desenhada em torno de um die de computação específico. Fabricantes de memória que codesenvolverem pilhas com startups de aceleradores ganham um canal que o duopólio de GPUs não controla.
Para investidores: o preço de US$ 2 bilhões será reprecificado por dois eventos observáveis: a primeira implantação hiperescala do Corsair com nome e repetição, e o tape-out do Raptor até o fim de 2026. Até lá, o valuation repousa sobre alegações de benchmark e sobre a qualidade dos investidores — sinais fortes, mas sinais, não fluxo de caixa.
FAQ
O que a d-Matrix faz?
A d-Matrix constrói aceleradores de data center especializados em inferência de IA. Sua plataforma Corsair usa Digital In-Memory Computing (DIMC) — computar dentro da SRAM — junto com a rede JetStream e a pilha de software Aviator, voltada à geração de tokens de baixa latência e alta eficiência energética, e não ao treinamento de modelos.
Por que a d-Matrix vale US$ 2 bilhões?
O valuation de US$ 2 bilhões foi definido por sua Série C de US$ 275 milhões fechada em 12 de novembro de 2025, coliderada por BullhoundCapital, Triatomic Capital e Temasek, com participação de QIA, EDBI e da M12 da Microsoft. Os investidores precificam a expectativa de que a inferência se torne o custo dominante da infraestrutura de IA e de que uma arquitetura centrada em memória capture uma fatia duradoura desse gasto.
Como o Corsair difere de uma GPU?
Uma GPU lê os pesos do modelo da HBM a cada token, com largura de banda de pacote da ordem de 8 TB/s. O Corsair mantém os pesos quentes em SRAM no chip e computa dentro da matriz de memória, alcançando 150 TB/s de largura de banda no chip por placa, mirando as cargas de decodificação de lote pequeno e baixa latência em que as GPUs são menos eficientes. Cada placa traz 2 GB de Performance Memory SRAM e até 256 GB de Capacity Memory LPDDR5.
O que são 3DIMC e Raptor?
O 3DIMC é a evolução com empilhamento 3D da arquitetura em memória da d-Matrix. A plataforma Raptor une face a face um die lógico de 4 nm a um die DRAM personalizado, projetando mais de 100 TB/s de largura de banda e 32 GB (256 Gb) de memória por acelerador. O Raptor deve concluir o tape-out até o fim de 2026, com disponibilidade em rack prevista para o quarto trimestre de 2027, incluindo integração a racks NVLink Fusion da NVIDIA.
Nota: os números de desempenho e eficiência (10 vezes de interatividade, 3 vezes de desempenho por TCO, 3 a 5 vezes de eficiência energética, 150 TB/s) são os reportados pela empresa nas datas citadas no texto. O valuation de US$ 2 bilhões é o valor post-money reportado no anúncio da Série C de novembro de 2025.
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.


