 VLSI Korea
Groq em profundidade: de US$ 6,9 bi a US$ 3,5 bi — o preço do que restou após o acordo de US$ 20 bi da Nvidia
A Groq fechou em agosto de 2026 uma rodada de US$ 350 milhões com valuation reportado de US$ 3,5 bilhões, cerca de metade dos US$ 6,9 bilhões de 2025. Depois do acordo de US$ 20 bilhões da Nvidia, o que sustenta o preço da nuvem restante?


Resumo em 30 segundos
A Groq é uma empresa americana de inferência de IA fundada em 2016 por Jonathan Ross, um dos criadores do TPU do Google. Sua LPU (Language Processing Unit) serve tokens de LLM com execução deterministic e de baixa latência, e o GroqCloud vende essa velocidade como API.
Em agosto de 2026, a Groq fechou uma rodada de US$ 350 milhões liderada pela Disruptive, com valuation reportado de cerca de US$ 3,5 bilhões (cerca de 4,9 trilhões de wones, a 1.400 wones por dólar), com participação planejada da Nvidia. É aproximadamente metade dos US$ 6,9 bilhões da rodada de US$ 750 milhões de setembro de 2025.
O reset tem uma causa específica. Em dezembro de 2025, a Nvidia firmou uma licença non-exclusive sobre a tecnologia de inferência da Groq — reportada em cerca de US$ 20 bilhões — e contratou Ross, o presidente Sunny Madra e grande parte da equipe sênior de engenharia. O futuro da LPU agora é entregue dentro da plataforma Vera Rubin da Nvidia, como Groq 3 LPX.
O que restou é outra empresa: uma neocloud de inferência com 13 data centers, cerca de seis milhões de desenvolvedores reportados e um plano para crescer de 54 MW de capacidade para mais de 200 MW em 2027. O preço de US$ 3,5 bilhões é uma aposta nessa nuvem, não no chip.
Tabela resumo: Groq em números
| Item | Detalhe |
|---|---|
| Fundação | 2016, Mountain View — Jonathan Ross |
| Produto principal | LPU (Language Processing Unit) / GroqCloud |
| Memória do LPU | ~230 MB de SRAM no chip, ~80 TB/s de largura de banda no die |
| Processo de 1ª geração | GlobalFoundries 14 nm |
| Rodada de ago. de 2024 | US$ 640 milhões, valuation de US$ 2,8 bilhões |
| Rodada de set. de 2025 | US$ 750 milhões, US$ 6,9 bilhões |
| Acordo com a Nvidia (dez. de 2025) | Licença não exclusiva, ~US$ 20 bilhões segundo a imprensa |
| Rodada de jun. de 2026 | US$ 650 milhões, valuation não divulgado |
| Rodada de ago. de 2026 | US$ 350 milhões, US$ 3,5 bilhões |
| Data centers / capacidade | 13 data centers, 54 MW → mais de 200 MW em 2027 |
Background: o chip que programava tudo com antecedência
A Groq foi fundada em Mountain View, Califórnia, em 2016. Ross havia liderado a equipe que construiu o primeiro TPU do Google e saiu com uma convicção específica: o treinamento fica com as manchetes, mas a inferência — executar modelos treinados, token a token, para usuários reais — se tornaria o negócio maior e mais sensível à latência. Uma GPU é projetada para ser flexível. A aposta da Groq foi que a inferência não precisa de flexibilidade; precisa de previsibilidade.
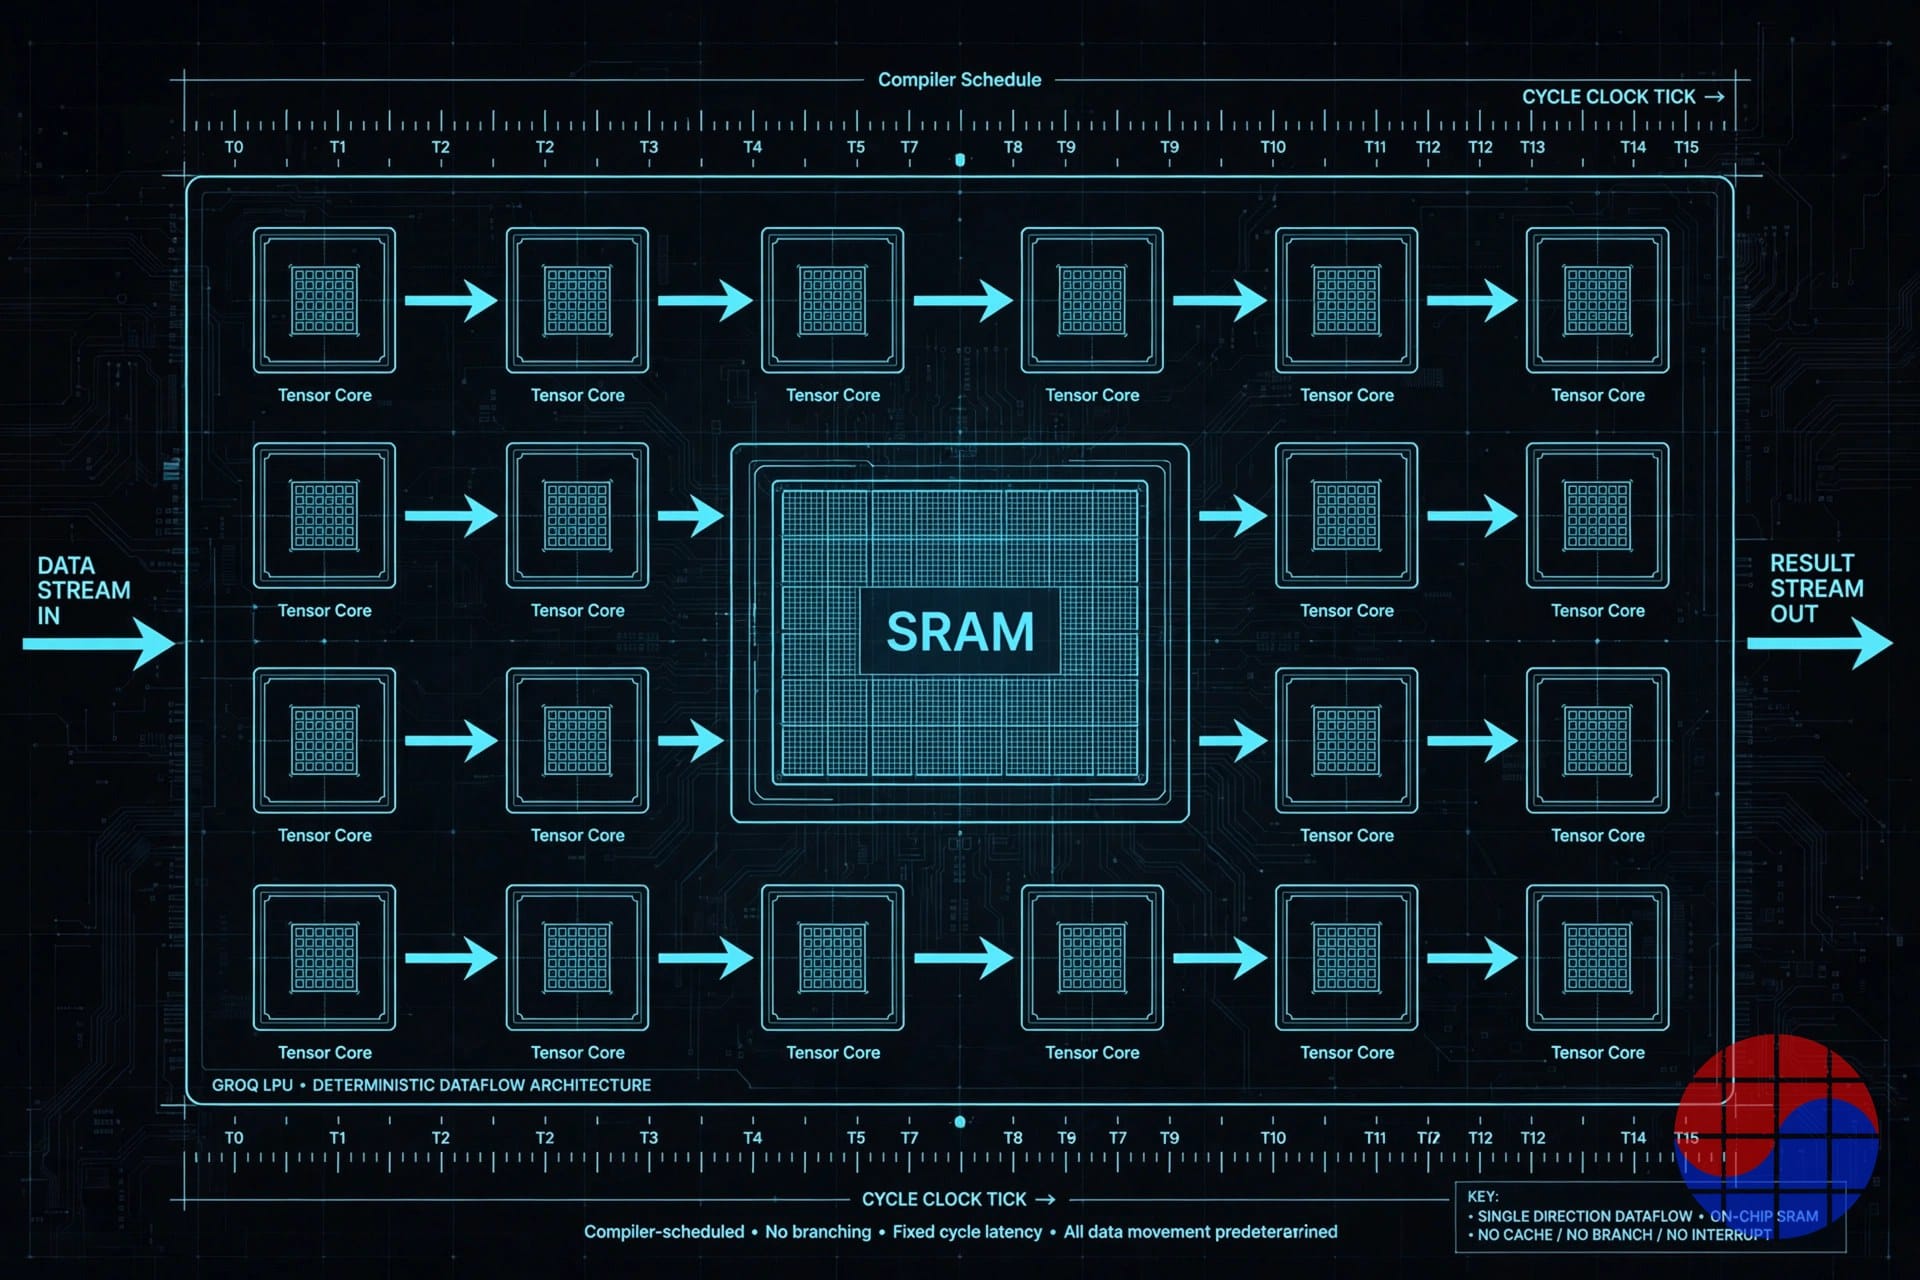
A LPU é um tensor streaming processor com um design deliberadamente incomum. A execução é programada pelo compiler em tempo de compilação, não arbitrada pelo hardware em tempo de execução. Não há dynamic scheduling nem hierarquia de cache tentando adivinhar o que vem a seguir. Cada ciclo é planejado, de modo que a latência não é apenas baixa em média — é deterministic, com jitter mínimo. Para chat, agentes de voz e loops agentic que encadeiam milhares de chamadas sequenciais ao modelo, essa previsibilidade é o produto.
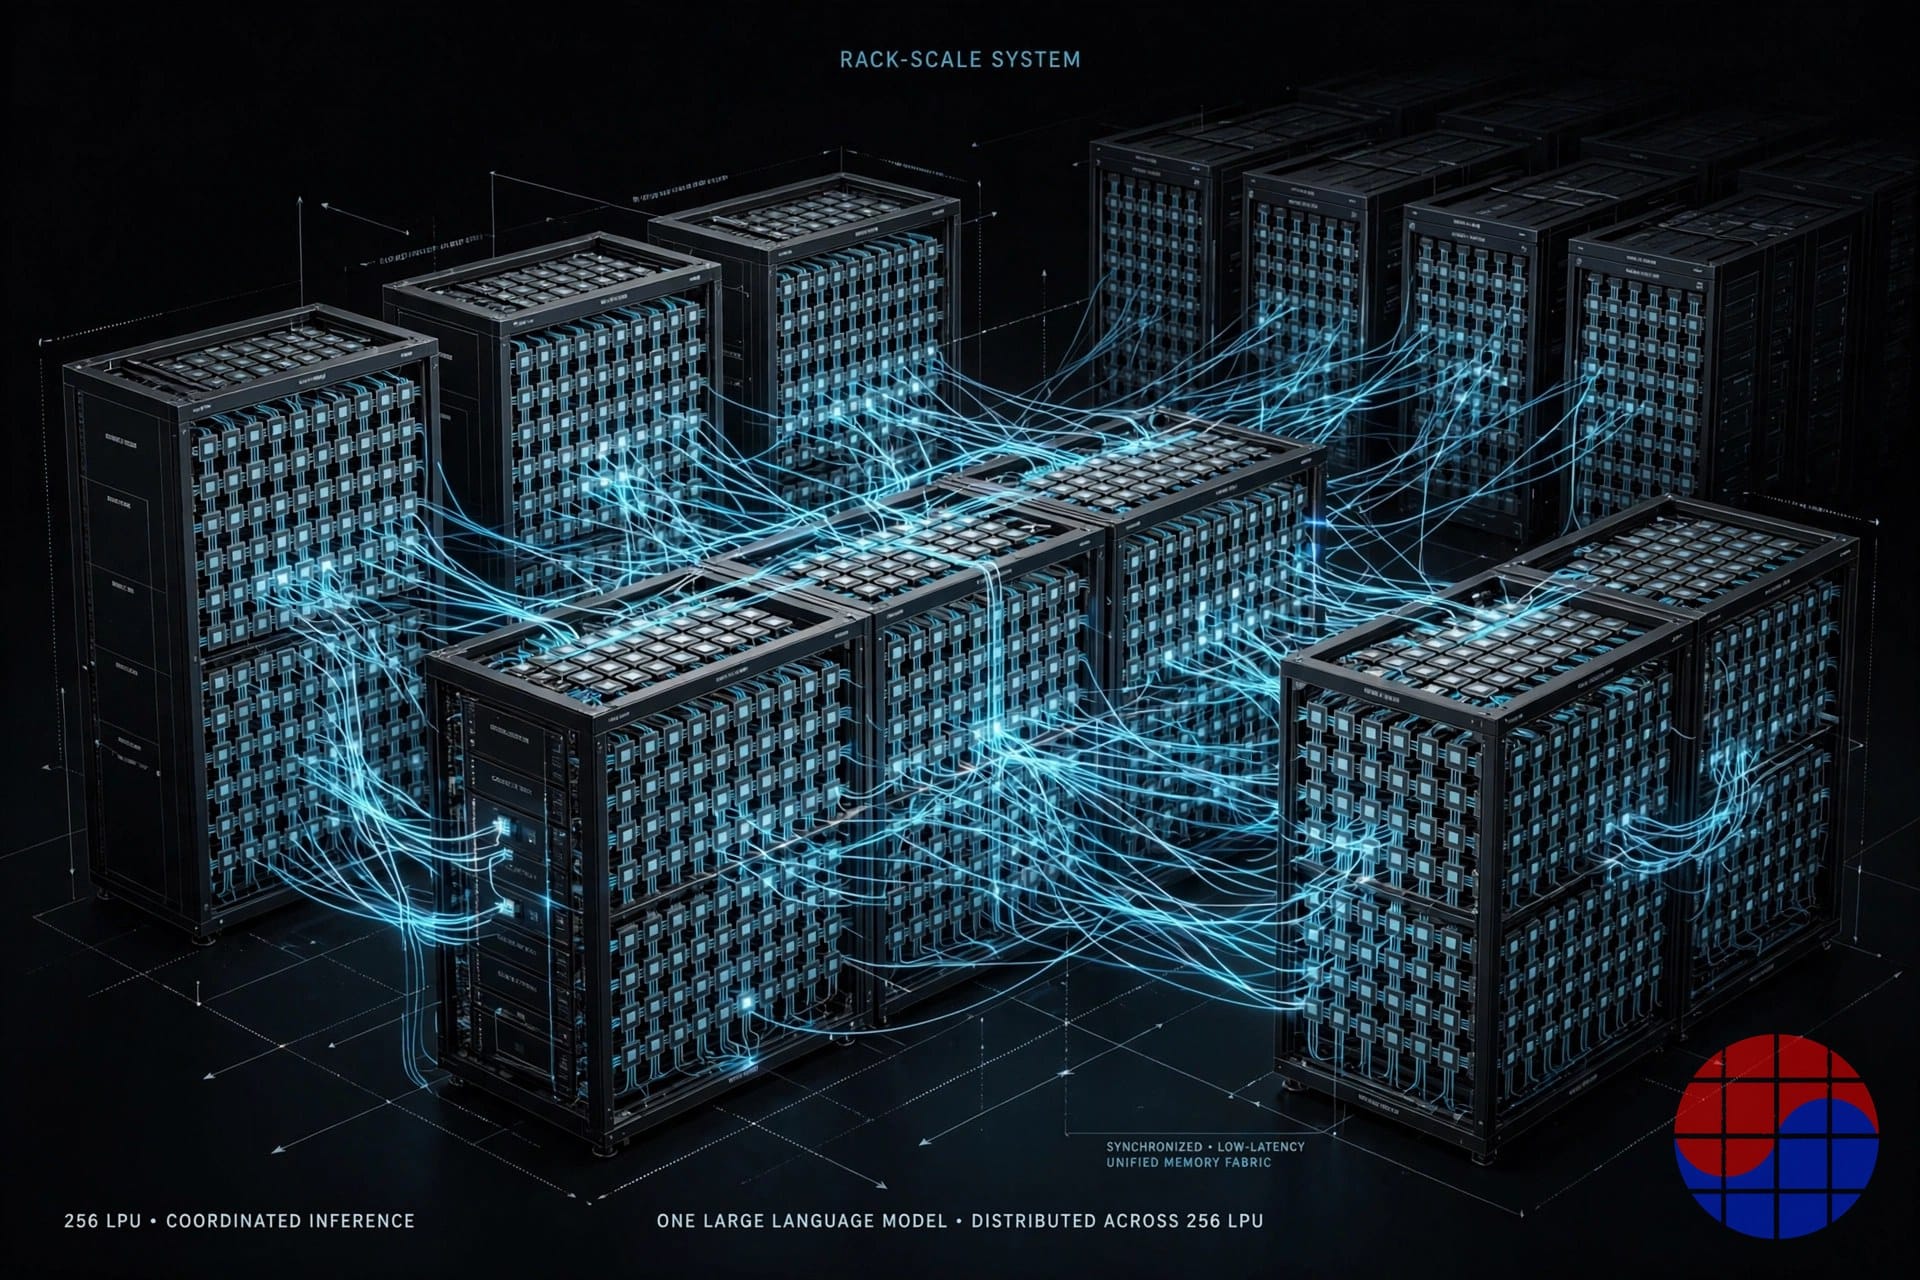
O design de memória faz a mesma troca. Em vez de HBM externa, a LPU de primeira geração carrega cerca de 230 MB de SRAM on-chip como memória principal, com cerca de 80 TB/s de largura de banda on-die — uma ordem de magnitude acima da largura de banda off-chip de uma GPU topo de linha. O custo dessa escolha é a capacidade: 230 MB não comportam um modelo de produção, então centenas de LPUs precisam operar como uma única máquina coordenada. Servir um modelo de 70B parâmetros significou historicamente um sistema em escala de rack com várias centenas de chips. O computador não é o chip; o computador é o rack.
A LPU de primeira geração foi fabricada pela GlobalFoundries em processo de 14 nm — um nó maduro, escolhido porque a arquitetura vence no movimento de dados, não na densidade de transistores. O GroqCloud, serviço de inferência hospedado da empresa, expôs o hardware por meio de uma API compatível com a OpenAI, servindo modelos open-weight como Llama, Qwen, Gemma e Whisper. A adoção por desenvolvedores cresceu de forma composta: cerca de 360 mil em agosto de 2024, mais de 1,4 milhão em abril de 2025, quando a Meta escolheu a Groq para servir a API oficial do Llama, e cerca de seis milhões reportados em 2026.
A geografia seguiu a demanda por IA soberana. Em setembro de 2024, a Groq firmou parceria com a Aramco Digital na Arábia Saudita, colocou no ar em oito dias o maior cluster de inferência da região, em Dammam, em dezembro de 2024, e em fevereiro de 2025 garantiu um compromisso de US$ 1,5 bilhão do Reino para expandir a infraestrutura LPU. Seguiu-se um primeiro data center europeu em Helsinque, com a Equinix, além de uma fábrica de IA soberana com a Bell Canada. No fim de 2025, a Groq operava 13 data centers na América do Norte, Europa, Oriente Médio e Ásia-Pacífico.
Business Deep Dive: anatomia de um reset de US$ 3,5 bilhões
A linha do tempo de financiamento conta a história. Em agosto de 2024, a Groq levantou US$ 640 milhões com valuation de US$ 2,8 bilhões. Em setembro de 2025, levantou US$ 750 milhões a US$ 6,9 bilhões, liderada pela Disruptive, com BlackRock, Samsung e Cisco entre os apoiadores. Três meses depois veio a transação com a Nvidia. Em seguida, em junho de 2026, a Groq levantou US$ 650 milhões para financiar sua virada — com valuation não divulgado — e em agosto de 2026 fechou mais US$ 350 milhões, apresentados como Series A, a US$ 3,5 bilhões. US$ 1 bilhão de capital novo em cerca de dois meses, pela metade do preço de manchete anterior.
Leia o acordo com a Nvidia com atenção, porque ele define o que foi vendido e o que não foi. Anunciada em 24 de dezembro de 2025, a transação foi estruturada como uma licença non-exclusive sobre a tecnologia de inferência da Groq, não como uma aquisição. A Groq permaneceu independente e o GroqCloud continuou sob o novo CEO, Simon Edwards. Petições em um processo posterior de acionistas descrevem os reportados US$ 20 bilhões como cerca de US$ 17 bilhões de taxa de licenciamento divididos entre os apoiadores, mais um pool de cerca de US$ 3 bilhões em ações da Nvidia para os engenheiros que se transferiram — cerca de 200 pessoas, pela estimativa dos autores. São alegações em litígio, não decisões judiciais, e a Groq chamou o processo de infundado. O que não está em disputa: a tecnologia e a equipe que a criou agora trabalham na Nvidia, onde a Groq 3 LPU entrou em produção plena em agosto de 2026 como o acelerador LPX dentro da plataforma Vera Rubin — 256 LPUs e 128 GB de SRAM por rack refrigerado a líquido, com a Nebius como primeira cliente de implantação.
Então, o que a Groq restante realmente possui? Três ativos. Primeiro, uma nuvem de inferência em operação: 13 data centers, cerca de 54 MW de capacidade, milhares de clientes empresariais e uma base reportada de seis milhões de desenvolvedores, processando trilhões de tokens por semana. Segundo, distribuição e confiança: o GroqCloud foi um endpoint precoce, rápido e compatível com a OpenAI que os desenvolvedores já conhecem, e em agosto de 2026 a Groq foi certificada como NVIDIA Cloud Partner — agora pode implantar sistemas Nvidia ao lado de sua frota existente. Terceiro, posições soberanas e regionais, sobretudo na Arábia Saudita, onde governos querem capacidade de inferência dentro de suas fronteiras e estão dispostos a financiá-la.
O histórico de receita é mais fino que o de valuation. Estimativas de terceiros colocam a receita de 2024 em cerca de US$ 90 milhões. Para 2025, a Groq orientou investidores para mais de US$ 500 milhões — revisado para baixo de uma projeção anterior acima de US$ 2 bilhões, com a diferença atribuída a restrições de capacidade de data centers que empurraram receita para 2026. Documentos de investidores reportados na época mostravam o negócio de nuvem operando com prejuízo, com receita de nuvem acima de US$ 40 milhões contra despesas de nuvem acima de US$ 64 milhões no período coberto. Em outras palavras: a demanda nunca foi o problema. Capacidade, capital e economia unitária foram.
Agora, a matemática do valuation. Contra a orientação de receita de 2025 de US$ 500 milhões — uma meta, não um resultado reportado —, US$ 3,5 bilhões equivalem a 7 vezes as vendas futuras. Contra os estimados US$ 90 milhões de 2024, são cerca de 39 vezes as vendas passadas. Nenhum múltiplo é absurdo para infraestrutura de IA em 2026, e nenhum é confortável para uma nuvem intensiva em capital que precisa comprar seus próximos megawatts. As rodadas de junho e agosto injetaram juntas US$ 1 bilhão — perto de 29% do próprio valor de manchete post-money da empresa —, o que mostra quanto da história dos US$ 3,5 bilhões é capacidade ainda por construir, e não capacidade já gerando receita.
O que precisa ser verdade para US$ 3,5 bilhões funcionar? Quatro coisas. (1) A expansão de 54 MW para mais de 200 MW em 2027 precisa chegar no prazo — e chegar utilizada, não ociosa. (2) Os preços por token precisam cair mais devagar que o custo por token da Groq — todo o modelo neocloud é um spread entre o custo de energia mais hardware e o preço de mercado da inferência, e esse spread comprime a cada ano. (3) A Groq precisa manter a demanda âncora — programas soberanos, criadores de modelos e clientes empresariais — agora que sua diferenciação é operacional, e não de silício. Sua antiga vantagem em chips é entregue literalmente dentro da plataforma de seu maior parceiro, disponível para nuvens rivais. (4) A Nvidia precisa permanecer parceira, e não um aperto: a Nvidia é ao mesmo tempo licenciadora, fornecedora de GPUs e acionista prospectiva, o que hoje alinha incentivos e amanhã concentra o risco.
O cenário de baixa é concreto, não hipotético. A inferência em GPU fica mais barata por token a cada geração da Nvidia e da AMD, e os hyperscalers executam inferência em seu próprio silício — o TPU do Google, o Trainium da Amazon — a preços internos que nenhuma nuvem independente iguala em cargas comoditizadas. A defesa da Groq é o nível sensível à latência: voz em tempo real, agentes e código interativo, onde a velocidade deterministic comanda um prêmio e a capacidade esgota, em vez de ser descontada. Se esse nível continuar escasso, US$ 3,5 bilhões parece conservador ao lado de uma licença de US$ 20 bilhões. Se a inferência se comoditizar de forma uniforme, a empresa restante é uma nuvem de médio porte com capital caro — e o reset não será o último. O risco regulatório também persiste: a transação atraiu escrutínio antitruste e litígio de acionistas que podem remodelar a relação da qual a nova Groq depende.
Chase's Take
O número mais mal lido desta história é o de US$ 20 bilhões. Não foi um valuation da Groq como empresa; foi o preço de remover a Groq como ameaça enquanto absorvia a Groq como tecnologia — e de fazer isso em uma estrutura que evitava uma revisão de fusão. A Nvidia pagou cerca de três vezes o valuation privado de pico da Groq por uma licença e uma equipe. Isso mostra que a arquitetura LPU valia mais dentro da plataforma da Nvidia do que toda a empresa independente construída em torno dela. Adquirentes pagam por distribuição e controle do roadmap, não por elegância.
O segundo número mal lido é o «down round» de US$ 3,5 bilhões. Compará-lo com US$ 6,9 bilhões é o erro de maçãs com laranjas que as manchetes repetem. O preço de setembro de 2025 avaliava uma empresa de chips verticalmente integrada, com silício proprietário, equipe fundadora e um pipeline soberano de hardware. O preço de agosto de 2026 avalia uma operadora de nuvem que licencia sua diferenciação da — e compra GPUs da — mesma contraparte. Metade do preço por uma reivindicação fundamentalmente menor sobre o pool de lucros do setor não é obviamente uma pechincha, nem obviamente um colapso. É a reprecificação de um ativo diferente.
Como engenheiro de infraestrutura, acho a lição técnica mais duradoura que a financeira. A Groq provou que a execução deterministic e o design SRAM-first são genuinamente superiores para inferência centrada em decode — tão superiores que a fornecedora dominante de GPUs pagou uma soma recorde para ser dona da ideia e agora a constrói em processo avançado como parte de primeira classe de sua plataforma principal. A arquitetura venceu. A empresa que a inventou ainda assim precisou se tornar uma operadora de nuvem para sobreviver. Em semicondutores, inventar o chip melhor é apenas a primeira barreira; possuir a relação com o cliente e o balanço para implantá-lo em escala é a segunda, e foi essa que foi reprecificada.
Meu veredito: US$ 3,5 bilhões é um preço justo a cheio para a Groq restante, defensável apenas se a expansão para 200 MW se converter em capacidade de inferência contratada e utilizada até 2027. Observe três sinais: clientes âncora divulgados para a nova capacidade, se a participação acionária da Nvidia realmente fecha, e os preços por token no nível em tempo real. Se os três se mantiverem, o reset foi o fundo. Se a capacidade chegar antes da demanda, esta Series A será lembrada como um ponto de passagem, não como um piso.
Implications
Para a Nvidia: a linha LPX transforma a arquitetura de uma antiga rival em um recurso de plataforma, permitindo vender decode deterministic ao lado das GPUs Rubin, em vez de perder cargas sensíveis à latência para nuvens independentes. O ônus regulatório e de litígio reportado é o custo desse atalho.
Para provedores independentes de inferência: o arco da Groq redefine expectativas. Silício proprietário sozinho não garante mais um desfecho independente; os finais viáveis são tornar-se uma nuvem com demanda contratada, ser absorvido por uma plataforma ou possuir um nicho que as plataformas não conseguem atender. Espere que os pares enfatizem contratos de capacidade assinados, em vez de gráficos de benchmark, ao levantar capital.
Para hyperscalers e compradores soberanos: a sobrevivência da Groq como NVIDIA Cloud Partner mostra o mercado se bifurcando — as plataformas detêm o roadmap de silício, enquanto operadores regionais e soberanos detêm licenças, energia e confiança local. O compromisso saudita de US$ 1,5 bilhão comprou exatamente essa camada.
Para a Coreia: a Samsung participou da rodada de setembro de 2025 da Groq, e a Groq 3 LPU dentro do LPX da Nvidia é fabricada, segundo relatos, pela Samsung Electronics — um lembrete de que fornecedores coreanos de fundição e memória monetizam todos os lados da disputa de silício de IA, vença quem vencer a guerra de arquiteturas. Startups coreanas de inferência devem ler o reset de US$ 3,5 bilhões como o preço atual de mercado para uma virada para a nuvem sem silício proprietário.
*Nota sobre fontes e limites: a Groq é uma empresa privada. Os números de receita são estimativas de terceiros ou orientações da empresa conforme reportadas na época; o valor da transação com a Nvidia é um número reportado — o anúncio da Groq descreveu uma licença non-exclusive sem divulgar preço; as caracterizações do litígio são alegações dos autores. Taxa de câmbio usada: 1 dólar americano = 1.400 wones coreanos.*
FAQ
Qual é o valuation mais recente da Groq e quando foi definido?
O valuation reportado mais recente da Groq é de US$ 3,5 bilhões (cerca de 4,9 trilhões de wones), definido por uma rodada de US$ 350 milhões liderada pela Disruptive, fechada em 17 de agosto de 2026, com participação planejada da Nvidia. Ela sucede uma captação de US$ 650 milhões em junho de 2026, com valuation não divulgado, e é cerca de metade dos US$ 6,9 bilhões de setembro de 2025 — um reset que reflete a transformação da empresa após o acordo de licenciamento com a Nvidia, e não um markdown equivalente do mesmo negócio.
Por que a Nvidia pagou reportados US$ 20 bilhões se a Groq valia US$ 6,9 bilhões?
A transação de 24 de dezembro de 2025 foi uma licença non-exclusive sobre a tecnologia de inferência da Groq, mais a contratação do fundador Jonathan Ross, do presidente Sunny Madra e de grande parte da equipe sênior — não uma aquisição da empresa. Os reportados US$ 20 bilhões compraram para a Nvidia a arquitetura LPU para sua plataforma Vera Rubin (agora entregue como Groq 3 LPX) e removeram sua rival independente de inferência mais crível, em uma estrutura que não exigia aprovação de fusão. A Groq permaneceu independente e manteve o GroqCloud operando.
O que é uma LPU e por que ela é mais rápida que uma GPU em inferência?
A LPU (Language Processing Unit) é o processador da Groq dedicado apenas à inferência. Ela programa toda a execução no compiler com antecedência — execução deterministic, sem surpresas de escalonamento em tempo de execução — e usa cerca de 230 MB de SRAM on-chip, com cerca de 80 TB/s de largura de banda, como memória principal, em vez de HBM externa. Isso torna a geração de tokens extremamente rápida e previsível. A troca é a capacidade: uma única LPU não comporta um modelo grande, então centenas de chips precisam trabalhar juntos como um único sistema.
O que a Groq vende agora, após o acordo com a Nvidia?
A Groq agora opera como uma nuvem de inferência de IA (uma «neocloud»). O GroqCloud serve modelos open-weight por meio de uma API compatível com a OpenAI a partir de 13 data centers, com cerca de seis milhões de desenvolvedores reportados e trilhões de tokens processados por semana. Certificada como NVIDIA Cloud Partner em agosto de 2026, ela está expandindo de cerca de 54 MW para mais de 200 MW de capacidade em 2027, implantando cada vez mais hardware da Nvidia ao lado de sua frota LPU existente, além de implantações soberanas como seu programa de infraestrutura na Arábia Saudita.
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.


