 VLSI Korea
HBM4E e a guerra pela hierarquia de memória: SK Hynix vs Samsung pelo padrão pós-HBM
SK Hynix e Samsung apresentaram a HBM4E lado a lado na SEDEX 2026. As especificações estão empatadas: a verdadeira batalha é quem define a hierarquia de memória pós-HBM. DRAM empilhada em 3D e HBF contra HBM5, HBM personalizada, CXL e PIM.


Resumo em 30 segundos
SK Hynix e Samsung apresentaram a HBM4E lado a lado na SEDEX 2026, em Seul, em 14 de outubro de 2026. As duas memórias de nova geração operam a 14–16 Gb/s por pino: na prática, a mesma classe. A verdadeira batalha não está na folha de especificações da HBM4E, mas em quem define a hierarquia de memória que vem depois da HBM. A SK Hynix aposta na "altura" — novos níveis como DRAM empilhada em 3D e HBF (High Bandwidth Flash) — enquanto a Samsung aposta em "velocidade mais pilha completa": HBM5, HBM personalizada, CXL, PIM e SSDs corporativos de grande capacidade. Com a infraestrutura de IA projetada para se expandir cerca de 20 vezes até 2030 em relação a 2026 (SK Hynix, 14 de outubro de 2026), quem escrever o padrão pós-HBM capturará a economia da memória de IA na próxima década.
Contexto: HBM4E marca o fim da guerra de especificações
Em 14 de outubro de 2026, dia de abertura da SEDEX 2026 no COEX Seul, os estandes da SK Hynix e da Samsung exibiam a mesma palavra: HBM4E. A HBM4E da SK Hynix roda a 16 Gb/s por pino, consome mais de 20% menos energia que a HBM4, e as amostras de 12 níveis (12-high) já haviam sido enviadas em junho de 2026. A HBM4E da Samsung opera entre 14 e 16 Gb/s por pino, alcança até 3,6 TB/s de largura de banda e combina DRAM de classe 1c com um dado base (base die) de 4 nm.
| Item | SK Hynix HBM4E | Samsung HBM4E |
|---|---|---|
| Velocidade por pino | 16 Gb/s | 14–16 Gb/s |
| Largura de banda máxima | ~2,0 TB/s (base 12-high)* | Até 3,6 TB/s |
| Energia | Mais de 20% menos que a HBM4 | Não divulgada (design de baixo consumo destacado) |
| Geração DRAM | Não divulgada | Classe 1c |
| Dado base | Não divulgado | Lógica de 4 nm |
| Amostras 12-high | Enviadas em junho de 2026 | Apresentadas na SEDEX 2026 |
| Apresentação | SEDEX 2026 (14 out) | SEDEX 2026 (14 out) |
*A SK Hynix não divulgou a largura de banda máxima. 16 Gb/s por pino × interface de 1024 bits equivale a 2,0 TB/s.
A conclusão é simples: a HBM4E já não é uma arma de diferenciação técnica. Velocidade por pino, energia e altura de empilhamento convergem entre os dois fabricantes numa janela de seis meses: a batalha passou de "quem vence a folha de especificações" para "quem escreve o próximo padrão". Além disso, a HBM4E quase não aliviará a oferta antes de 2027 —mais dados DRAM por pilha, dados base em nós lógicos de ponta e novos ciclos de qualificação por cliente alongam os prazos. Essa rigidez estrutural está por trás das projeções de +121% ano a ano nos preços de contrato da HBM4 para 2027 (Korea Economic Daily, 2026, citando a imprensa do setor).
Em sua keynote na SEDEX no mesmo dia, o presidente da SK Hynix, Ahn Hyun, foi direto: "HBM alone is not enough." A infraestrutura de IA precisa escalar cerca de 20 vezes até 2030 a partir dos níveis de 2026, a IA agêntica está disparando o uso de tokens, a movimentação de dados do KV-cache é o novo gargalo e o motor do crescimento é a inferência, não o treinamento. Numa frase: o gargalo mudou da largura de banda da HBM para a arquitetura de toda a hierarquia de memória.
Análise de negócios: anatomia de uma guerra de padrões
A nova hierarquia de memória: o mapa da SK Hynix
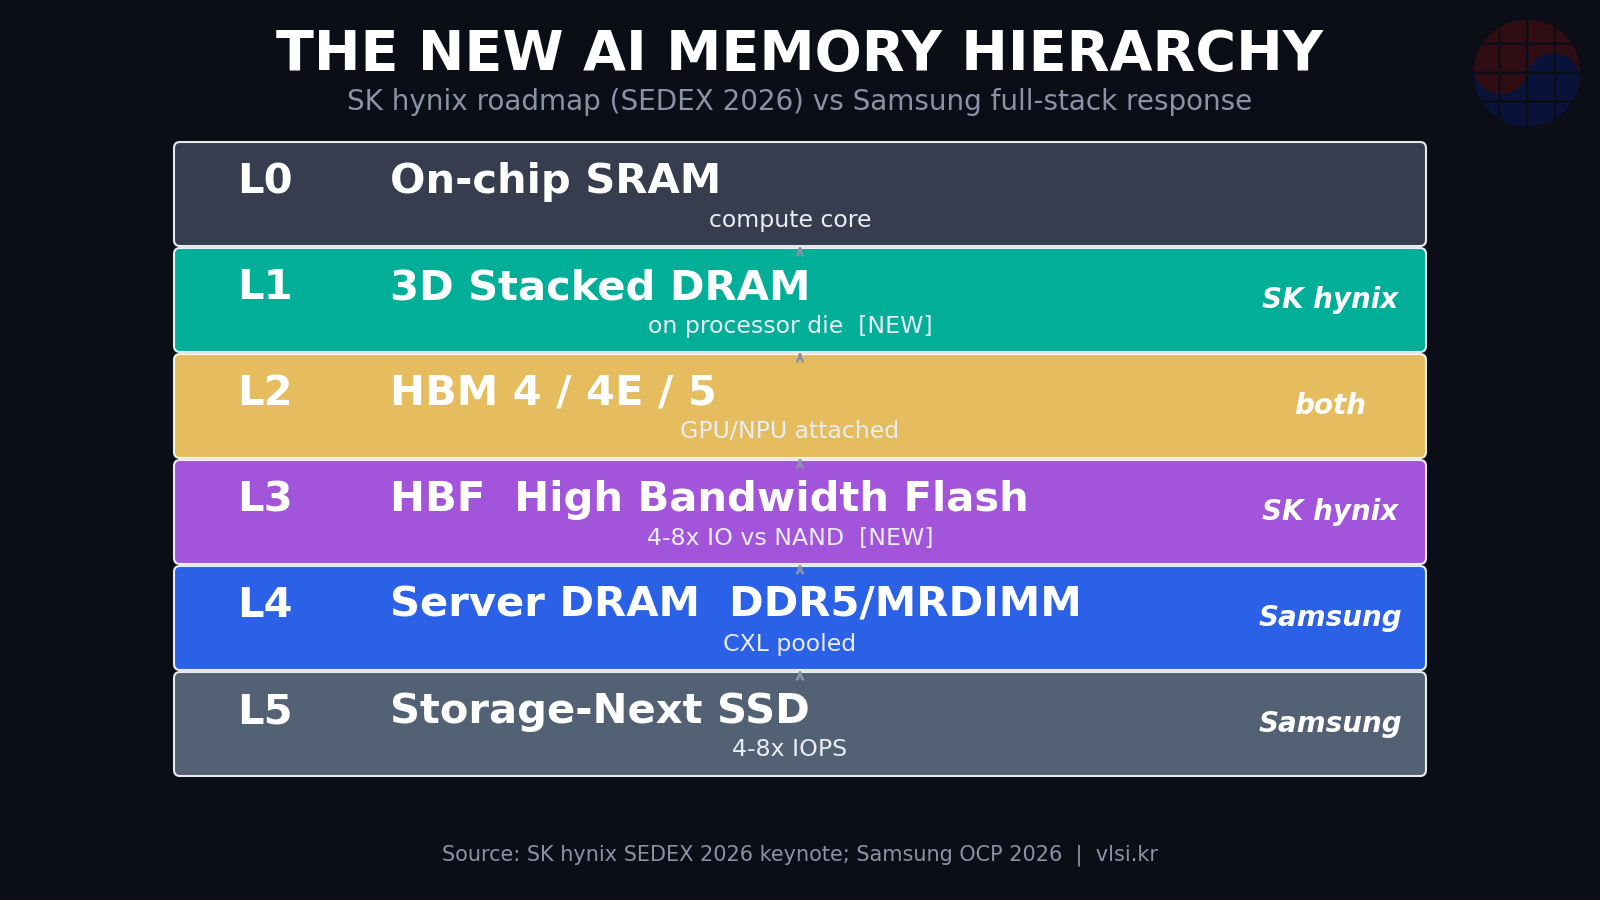
O núcleo do roteiro de Ahn é adicionar níveis. A imagem anterior era relativamente simples: SRAM no chip → HBM → DRAM de servidor → SSD. A hierarquia proposta pela SK Hynix é esta:
| Nível | Tecnologia | Papel | Significado de negócio |
|---|---|---|---|
| L0 | SRAM no chip | Cache junto aos núcleos de computação | Domínio dos fabricantes lógicos (sem mudanças) |
| L1 (novo) | DRAM empilhada em 3D | Dados DRAM empilhados diretamente sobre dados de processador | Estende o know-how de empilhamento TSV; apaga a fronteira lógica–memória |
| L2 | HBM (HBM4 / HBM4E / HBM5) | Memória de alta largura de banda junto a GPU/NPU | Centro da guerra de padrões; a personalização muda a estrutura de margens |
| L3 (novo) | HBF (High Bandwidth Flash) | 4–8x IO ante a NAND atual | O contra-ataque do campo NAND contra a ordem de memória de IA liderada por DRAM |
| L4 | DRAM de servidor (DDR5 / MRDIMM) | Memória principal de grande capacidade | O pooling CXL muda a economia da utilização |
| L5 | SSD corporativo Storage-Next | 4–8x IOPS ante o atual | A fronteira armazenamento–memória se difumina |
Investidores devem prestar atenção às linhas L1 e L3. A DRAM empilhada em 3D leva a tecnologia de empilhamento TSV da HBM para dentro do encapsulamento do processador, reutilizando diretamente a experiência em empilhamento e gestão térmica que a SK Hynix construiu com a HBM. A HBF é ainda mais ousada: promove a NAND de "armazenamento" a membro pleno da hierarquia de memória. Para os fabricantes de NAND, é a única rampa de acesso à ordem de memória de IA dominada por DRAM: leia-se como a declaração de que o contra-ataque do campo NAND começou.
A resposta da Samsung: velocidade mais pilha completa
A Samsung desenhou outro quadro no OCP Global Summit 2026 em San José (12–15 de outubro), onde demonstrou com a AMD a expansão de memória CXL. Sua estratégia apoia-se em três pilares:
- Velocidade (Speed): HBM5, mais HBM personalizada com lógica específica do cliente integrada no dado base: uma carta que combina a força de fundição da Samsung (dados base de classe 4 nm) com seu IDM de memória.
- Expansão de capacidade (Capacity): pooling de memória baseado em CXL, compartilhando DRAM de servidor entre aceleradores para elevar a utilização.
- Armazenamento (Storage): SSDs corporativos de grande capacidade: uma proposta integral cobrindo de memória a armazenamento com um único fornecedor.
Por cima, a tecnologia PIM (processing-in-memory), que leva a computação para dentro da memória para reduzir a própria movimentação de dados.
| Eixo | SK Hynix | Samsung |
|---|---|---|
| Aposta central | Altura: novos níveis (DRAM 3D, HBF) | Velocidade + pilha completa: HBM5, HBM personalizada, CXL, PIM, SSD |
| Fonte de diferenciação | Extensão do know-how de empilhamento HBM; vínculo com a subsidiária NAND (Solidigm) | Fundição + IDM de memória; design lógico do dado base |
| Personalização | HBM personalizada (lógica do cliente no dado base) | HBM personalizada + oferta integral ligada à fundição |
| Estratégia NAND | HBF incorpora a NAND à hierarquia de memória | SSDs de grande capacidade reforçam a liderança em armazenamento |
| Fraqueza | Design lógico (dado base) atrás da Samsung | Participação de mercado em HBM atrás da SK Hynix |
A mudança na estrutura de margens: o que a HBM personalizada muda
A "HBM personalizada" —anunciada por ambas— é a variável mais subestimada desta guerra de padrões. A HBM convencional é quase uma commodity: especificações fixas, preços fixos, o mesmo produto vendido a muitos clientes. A HBM personalizada integra lógica específica do cliente (controladores, segurança, otimização de interface) no dado base. É a passagem de commodity a silício específico do cliente.
Três implicações para a estrutura de margens:
Primeiro, o poder de precificação se fortalece ante as peças padrão. O design específico por cliente cria custos de troca e aprofunda o vendor lock-in. Segundo, a capacidade de design lógico do dado base torna-se uma competência central para os fabricantes de memória: um campo de batalha que favorece a Samsung, com seus ativos de fundição e design lógico. A SK Hynix precisa buscar essa capacidade externamente. Terceiro, a bifurcação entre HBM padrão e personalizada complica a cadeia de suprimentos. Se o dado base difere por cliente mesmo dentro da mesma geração HBM4E, o planejamento de produção e a gestão de estoques endurecem — o que retroalimenta a pressão de alta sobre os preços. Por trás da projeção de +121% ano a ano nos preços de contrato da HBM4 para 2027 há motores estruturais como este.
Pooling CXL: a economia da utilização
O pooling de memória baseado em CXL abre uma nova economia da utilização de memória. Nos servidores de IA, a memória é alocada por acelerador, mas a utilização real oscila enormemente: uma GPU fica sem memória enquanto a vizinha permanece ociosa. Compartilhar um pool de memória via CXL absorve essa variância, reduzindo as compras totais de memória e aliviando gargalos.
Para os hiperescaladores, é uma carta de redução do TCO (custo total de propriedade). Para os fabricantes de memória, uma arma de dois gumes: no curto prazo, o conteúdo de memória por servidor pode cair, mas no longo prazo abre-se um mercado novo —o próprio pool de memória— mais demanda fresca em controladores e switches CXL. Por isso a Samsung demonstrou com a AMD na OCP: ninguém fixa um padrão sozinho; demonstra-se com quem detém as chaves do ecossistema.
Contexto de mercado: a memória já supera metade dos semicondutores
Estimativas de pesquisa do setor colocam a memória em torno de 54% da receita total de semicondutores em 2026 —quase o dobro dos 27% de 2025— impulsionada pelo crescente conteúdo em dólares de HBM dentro de cada acelerador de IA. É por isso que os fabricantes de memória competem para se tornar os definidores da hierarquia de memória de IA. Quem define o padrão fixa as regras de preço, especificação e qualificação; e quem fixa as regras fixa as margens.
A visão de Chase: altura vs pilha completa — quem escreve o padrão
Esta luta não é sobre tecnologia; é sobre poder de definição de padrões (standard-setting power). Olhemos a história: o JEDEC fixou formalmente os padrões DRAM, mas na prática o fabricante que produziu em massa primeiro e qualificou primeiro tornou-se o autor de fato do padrão. Com a HBM foi igual: a SK Hynix entregou HBM3 e HBM3E à NVIDIA primeiro e escreveu o padrão de fato enquanto a Samsung perseguia.
Desta vez a forma difere. A SK Hynix desenhou primeiro na página em branco intitulada "depois da HBM". A DRAM empilhada em 3D e a HBF são níveis novos sem lugar nos padrões JEDEC existentes. Defina primeiro, amostre primeiro, alie-se a clientes primeiro —e isso vira o padrão. A Samsung, ao contrário, luta em terreno provado: a velocidade da HBM5, a flexibilidade da HBM personalizada, o ecossistema CXL, PIM, SSDs. Nenhum sozinho detém a ofensiva de novos níveis da SK Hynix, mas empacotados como pilha completa formam uma proposta integral para os clientes —especialmente hiperescaladores: "deixem suas preocupações de memória conosco".
De uma perspectiva coreana, a ironia é rica. Ambas são campeãs nacionais coreanas. Na era do chicken game de DRAM, as expansões de capacidade de cada uma significavam colapso de preços para ambas. Agora as duas redigem plantas opostas para a ordem mundial de memória de IA. Chegou a era em que o duopólio coreano de memória desenha os documentos de projeto da infraestrutura global de IA. Os riscos são reais, porém. Mais níveis implicam mais complexidade de sistema e carga de qualificação. Se a HBF pode superar os limites da NAND (resistência, latência) em cargas reais, e quem resolve o problema térmico da DRAM empilhada em 3D, segue sem prova. O PIM da Samsung é há anos "grande demo, ainda sem volume". O vencedor de uma guerra de padrões raramente é o slide mais bonito: é o quadro mais realista que embarca primeiro.
O contra-argumento merece espaço: alguns sustentam que passos incrementais como HBM4E e HBM5 podem absorver a demanda de inferência, e que se a pressão do KV-cache se agravar, as arquiteturas de modelo (otimização de atenção, quantização) se adaptarão primeiro. Ponto válido. Mas para os fabricantes de memória essa é uma estratégia de espera —e enquanto se espera, o poder de fixar padrões passa a outras mãos. Por isso SK Hynix e Samsung se moveram ao mesmo tempo.
Implicações de investimento e gestão
Para investidores: - Com a memória acima da metade da receita de semicondutores, o fabricante que definir os níveis pós-HBM ganha um prêmio estrutural. Acompanhe a execução do roteiro (prazos de volume de DRAM 3D, HBF, CXL), não o trading especulativo de curto prazo sobre a HBM4E. - A difusão da HBM personalizada eleva as margens dos fabricantes de memória, mas os fabricantes sem capacidade de design lógico do dado base ganham uma nova linha de custo em design terceirizado. Os beneficiários na cadeia de valor estendem-se a design lógico, controladores CXL e encapsulamento avançado (OSAT/equipamentos). - A projeção de +121% ano a ano nos preços de contrato da HBM4 para 2027 é vento de cauda para os resultados dos fabricantes de memória —e ao mesmo tempo o gatilho que empurra os hiperescaladores ao pooling CXL e à otimização arquitetônica para aliviar a pressão do TCO. Observe o ponto em que as altas de preço começam a destruir demanda.
Para gestores: - Toda empresa que construa ou opere infraestrutura de IA deveria elevar sua estratégia de compra de memória de "comprar HBM" para "desenhar a hierarquia de memória". O momento de adoção do pooling CXL, a maturidade da HBF e os prazos de qualificação da HBM personalizada são agora variáveis do roteiro de compras. - Para fabless e empresas de sistemas, a capacidade de personalização do dado base é uma nova carta de negociação. Comprar HBM padrão versus co-projetar HBM personalizada implica uma relação de poder distinta na cadeia de suprimentos. - Para os fabricantes de NAND, a HBF é uma chance de romper a caixa de "dispositivo de armazenamento": juntar-se à ordem centrada em DRAM ou seguir rota independente via SSDs avançados. A bifurcação já está aqui.
Perguntas frequentes
P1. O que diferencia a HBM4E da HBM4? A HBM4E é a geração estendida da HBM4, com velocidades por pino em torno de 16 Gb/s e melhor eficiência energética. A SK Hynix anuncia mais de 20% menos energia que a HBM4; a Samsung divulga até 3,6 TB/s de largura de banda com dado base de 4 nm. A diferença de especificações é pequena, então os roteiros além da HBM4E —HBM5, HBM personalizada, novos níveis de memória— importam mais que a HBM4E em si.
P2. O que é HBF (High Bandwidth Flash)? Um novo nível de memória proposto pela SK Hynix na SEDEX 2026, mirando 4–8x a largura de banda IO da flash NAND atual. Situa-se entre a HBM e a DRAM de servidor, voltado a grandes cargas de inferência como o manejo de KV-cache. Promove a NAND de "armazenamento" à hierarquia de memória: o desafio do campo NAND à ordem de memória de IA liderada por DRAM.
P3. Por que o pooling de memória CXL importa? Com CXL (Compute Express Link), vários aceleradores compartilham um pool de memória, absorvendo a variância de utilização por acelerador e reduzindo as compras totais de memória. É uma carta de redução do TCO para hiperescaladores e abre um mercado novo —controladores e switches CXL— para os fabricantes de memória. Esse é o pano de fundo da demo conjunta da Samsung com a AMD na OCP 2026.
P4. O que decide o vencedor da guerra de padrões pós-HBM? Três coisas. Primeiro, o momento do volume: não demos, mas quem passa na qualificação do cliente e envia volume primeiro. Segundo, o ecossistema: quem consegue construir o padrão junto a hiperescaladores e fabricantes de GPU. Terceiro, a economia: se os novos níveis realmente baixam o TCO. O silício que funciona vence o roteiro bonito.
Aviso: os números e projeções deste artigo baseiam-se em materiais públicos e informações do setor em 17 de outubro de 2026; as especificações reais de produto e os prazos de volume estão sujeitos a alterações.


