 VLSI Korea
Análise aprofundada da CPU NVIDIA Vera: por que 1,2 TB/s de largura de banda de memória importa mais do que 88 núcleos
A Vera oferece 1,5 TB de LPDDR5X SOCAMM2 e 1,2 TB/s por soquete, cerca de 13,6 GB/s por núcleo. Comparação completa com Grace e EPYC Turin, limites das afirmações do fornecedor e a disputa SOCAMM2.


Análise aprofundada da CPU NVIDIA Vera: por que 1,2 TB/s de largura de banda de memória importa mais do que 88 núcleos
TL;DR
- A NVIDIA Vera é uma CPU para centro de dados com 88 núcleos Olympus personalizados compatíveis com Armv9.2-A, apresentada com a plataforma Vera Rubin na GTC em março de 2025, com detalhes de arquitetura divulgados em julho de 2026 (divulgação de arquitetura da NVIDIA, julho de 2026).
- O número principal não é a contagem de núcleos. Cada soquete Vera suporta até 1,5 TB de memória LPDDR5X SOCAMM2 e até 1,2 TB/s de largura de banda de memória, cerca de 13,6 GB/s por núcleo em uma divisão simples (divulgação de arquitetura da NVIDIA, julho de 2026; cálculo a partir de valores divulgados, 20 de outubro de 2026).
- Essa largura de banda por núcleo é cerca de 1,8 vez o valor da CPU Grace anterior e cerca de 2,8 vezes um valor calculado para um modelo topo de linha AMD EPYC Turin de 128 núcleos com DDR5-6400 de 12 canais (cálculo a partir de especificações do fornecedor, 20 de outubro de 2026).
- A NVIDIA afirma até 1,9 vez mais instruções por ciclo do que o EPYC Turin em cargas de trabalho relacionadas a IA, mas trata-se de uma afirmação do fornecedor, e os resultados de benchmarks de parceiros publicados até agora não divulgam a configuração completa nem as definições de TDP (divulgação da NVIDIA, julho de 2026).
- A mudança estratégica é o conteúdo de memória por soquete: a Vera carrega 3 vezes a capacidade de memória da Grace por soquete, o que transforma o soquete da CPU em um campo de disputa pelo fornecimento de LPDDR5X entre Samsung Electronics, SK hynix e Micron (divulgação de arquitetura da NVIDIA, julho de 2026).
Background
Por duas décadas, o marketing de CPU para centro de dados foi em grande parte uma corrida por contagem de núcleos. Mais núcleos significavam mais máquinas virtuais, mais contêineres e mais threads por rack. Essa lógica funcionava enquanto cargas de trabalho de uso geral eram limitadas sobretudo pelo desempenho de computação. Funciona menos na era da IA com agentes, em que a CPU de um sistema de IA não é mais um host passivo para GPUs. Ela orquestra chamadas de ferramentas, prepara e move dados, executa etapas de recuperação e classificação, lida com tráfego de rede e armazenamento e alimenta aceleradores que param rapidamente quando os dados chegam atrasados.
A NVIDIA entrou nesse mercado com a Grace, uma CPU de 72 núcleos baseada em núcleos Arm Neoverse V2, com até 480 GB de LPDDR5X e 546 GB/s de largura de banda de memória (especificações da NVIDIA Grace, divulgadas antes da divulgação da Vera em julho de 2026). A Grace provou que uma CPU Arm podia ficar no centro de um rack NVIDIA. Também expôs a próxima restrição: à medida que os sistemas GPU ficavam mais rápidos, a CPU host precisava de mais capacidade de memória, mais largura de banda por thread e um link coerente mais rápido com a GPU.
A Vera é a resposta da NVIDIA, apresentada como parte da plataforma Vera Rubin na GTC em março de 2025 e detalhada em divulgações de arquitetura em julho de 2026 (GTC, março de 2025; divulgação de arquitetura da NVIDIA, julho de 2026). A Vera substitui o projeto Neoverse licenciado por 88 núcleos Olympus personalizados. A NVIDIA relata Spatial Multithreading que expõe 176 threads, um die de computação monolítico, 2 MB de cache L2 por núcleo, 164 MB de cache L3 e uma Scalable Coherency Fabric de segunda geração (divulgação de arquitetura da NVIDIA, julho de 2026).
Os números da plataforma ao redor do núcleo são igualmente importantes. A Vera oferece NVLink-C2C a 1,8 TB/s para comunicação coerente CPU-GPU, PCIe Gen6 e CXL 3.1, com faixa de TDP configurável de 250 a 450 W (divulgação de arquitetura da NVIDIA, julho de 2026). Duas CPUs Vera formam um Superchip com 176 núcleos, 352 threads, 16 módulos SOCAMM2, 2,4 TB/s de largura de banda de memória agregada e 3 TB de capacidade de memória. Um projeto de referência em escala de rack com 128 Superchips alcança 22.528 núcleos e 384 TB de memória (divulgação de arquitetura da NVIDIA, julho de 2026). Vendas de CPU avulsa e primeiros envios a clientes foram relatados durante 2026, portanto afirmações de disponibilidade neste artigo são apresentadas como relatadas, não como confirmação direta de envios da NVIDIA (reportagens do setor, 2026).
Deep Dive 1: O sistema de memória — 1,5 TB e 1,2 TB/s por soquete
A escolha que define a Vera é o seu sistema de memória. Cada soquete suporta até 1,5 TB de LPDDR5X SOCAMM2 a velocidades de até 9.600 MT/s, entregando até 1,2 TB/s de largura de banda de memória (divulgação de arquitetura da NVIDIA, julho de 2026). SOCAMM2 é um padrão de módulo LPDDR com soquete impulsionado pela NVIDIA. Ao contrário da LPDDR soldada, um módulo com soquete pode ser configurado, mantido e escalado conforme o projeto do sistema, mantendo as vantagens de eficiência energética da LPDDR5X sobre a memória de servidor DDR5 convencional.
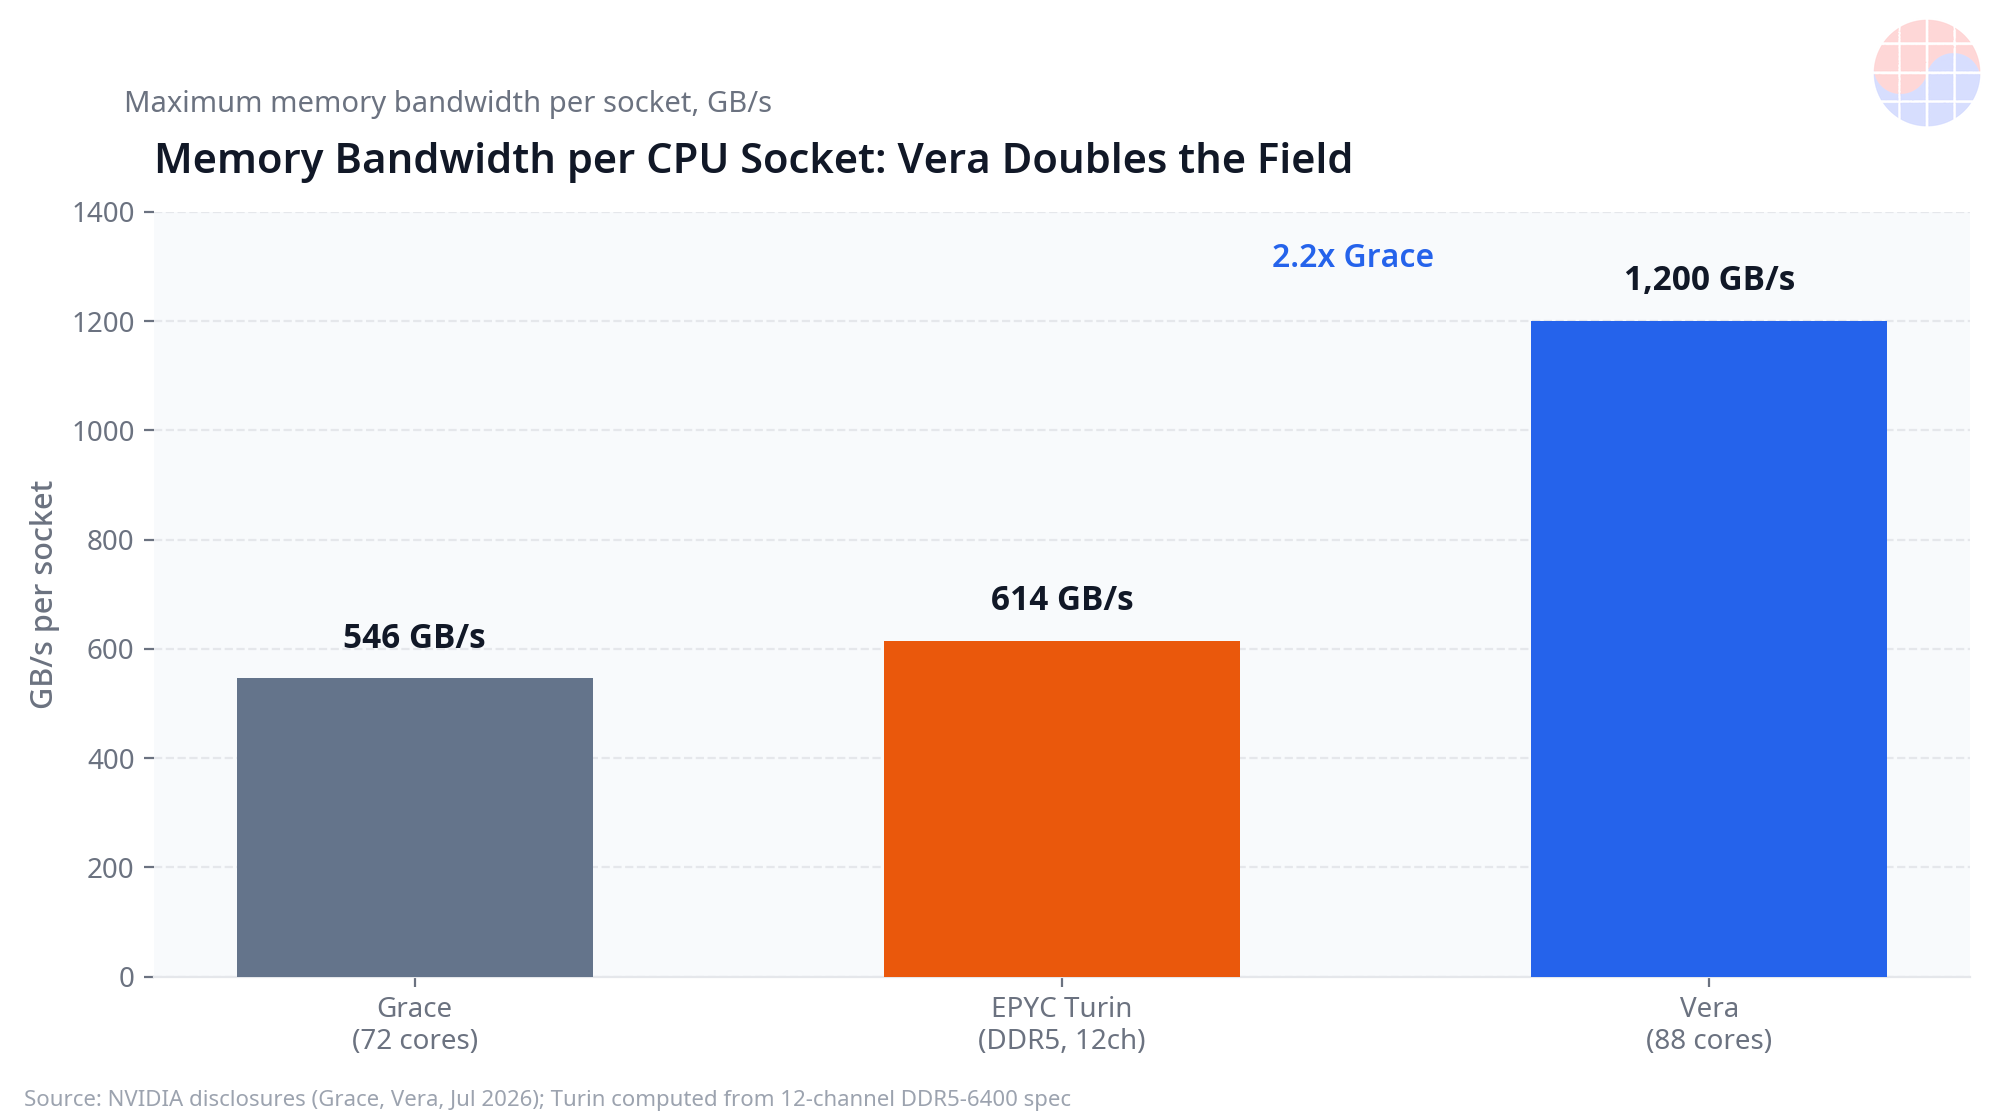
A comparação com a Grace mostra o quanto o projeto avançou em uma geração. A Grace oferecia até 480 GB de LPDDR5X e 546 GB/s de largura de banda por soquete (especificações da NVIDIA Grace). A Vera triplica a capacidade para 1,5 TB e eleva a largura de banda para 1.200 GB/s, um aumento de 2,2 vezes (divulgação de arquitetura da NVIDIA, julho de 2026; cálculo, 20 de outubro de 2026). Em termos práticos, um soquete Vera pode manter conjuntos de trabalho maiores na memória local: caches chave-valor maiores, tabelas de embeddings maiores, mais sessões de agentes simultâneas e mais dados preparados para consumo da GPU sem recorrer a armazenamento mais lento ou memória remota.
Capacidade e largura de banda precisam crescer juntas. Capacidade sem largura de banda deixa os núcleos esperando em um caminho de memória congestionado. Largura de banda sem capacidade força expulsões e recargas frequentes. O ponto de projeto da Vera — 1,5 TB a 1,2 TB/s — mira cargas de trabalho em que muitos threads tocam conjuntos de dados grandes e mutáveis ao mesmo tempo. Esse perfil descreve pipelines de recuperação, serviço de características, pré-processamento de busca vetorial, carregamento de dados e a lógica de controle em torno da inferência de modelos grandes muito melhor do que um benchmark inteiro tradicional.
Há também uma consequência na cadeia de suprimentos. Um padrão de módulo LPDDR5X com soquete cria uma unidade definida e substituível de conteúdo de memória que os montadores de sistemas compram em volume. Quando um soquete carrega 1,5 TB em vez de 480 GB, cada sistema Vera multiplica o conteúdo LPDDR5X associado à CPU, antes de contar qualquer HBM associada à GPU. A seção 4 retoma o que isso significa para Samsung Electronics, SK hynix e Micron.
Deep Dive 2: Largura de banda por núcleo e a comparação com x86
Contagens de núcleos enganam quando a largura de banda de memória não acompanha. Dividir a largura de banda do soquete pela contagem de núcleos dá uma medida aproximada, mas útil, de quanta vazão de memória cada núcleo pode usar quando todos estão ocupados. Para a Vera, 1.200 GB/s divididos por 88 núcleos são cerca de 13,6 GB/s por núcleo, que a NVIDIA arredonda para cerca de 14 GB/s por núcleo (divulgação de arquitetura da NVIDIA, julho de 2026; cálculo, 20 de outubro de 2026). Para a Grace, 546 GB/s divididos por 72 núcleos são cerca de 7,6 GB/s por núcleo.
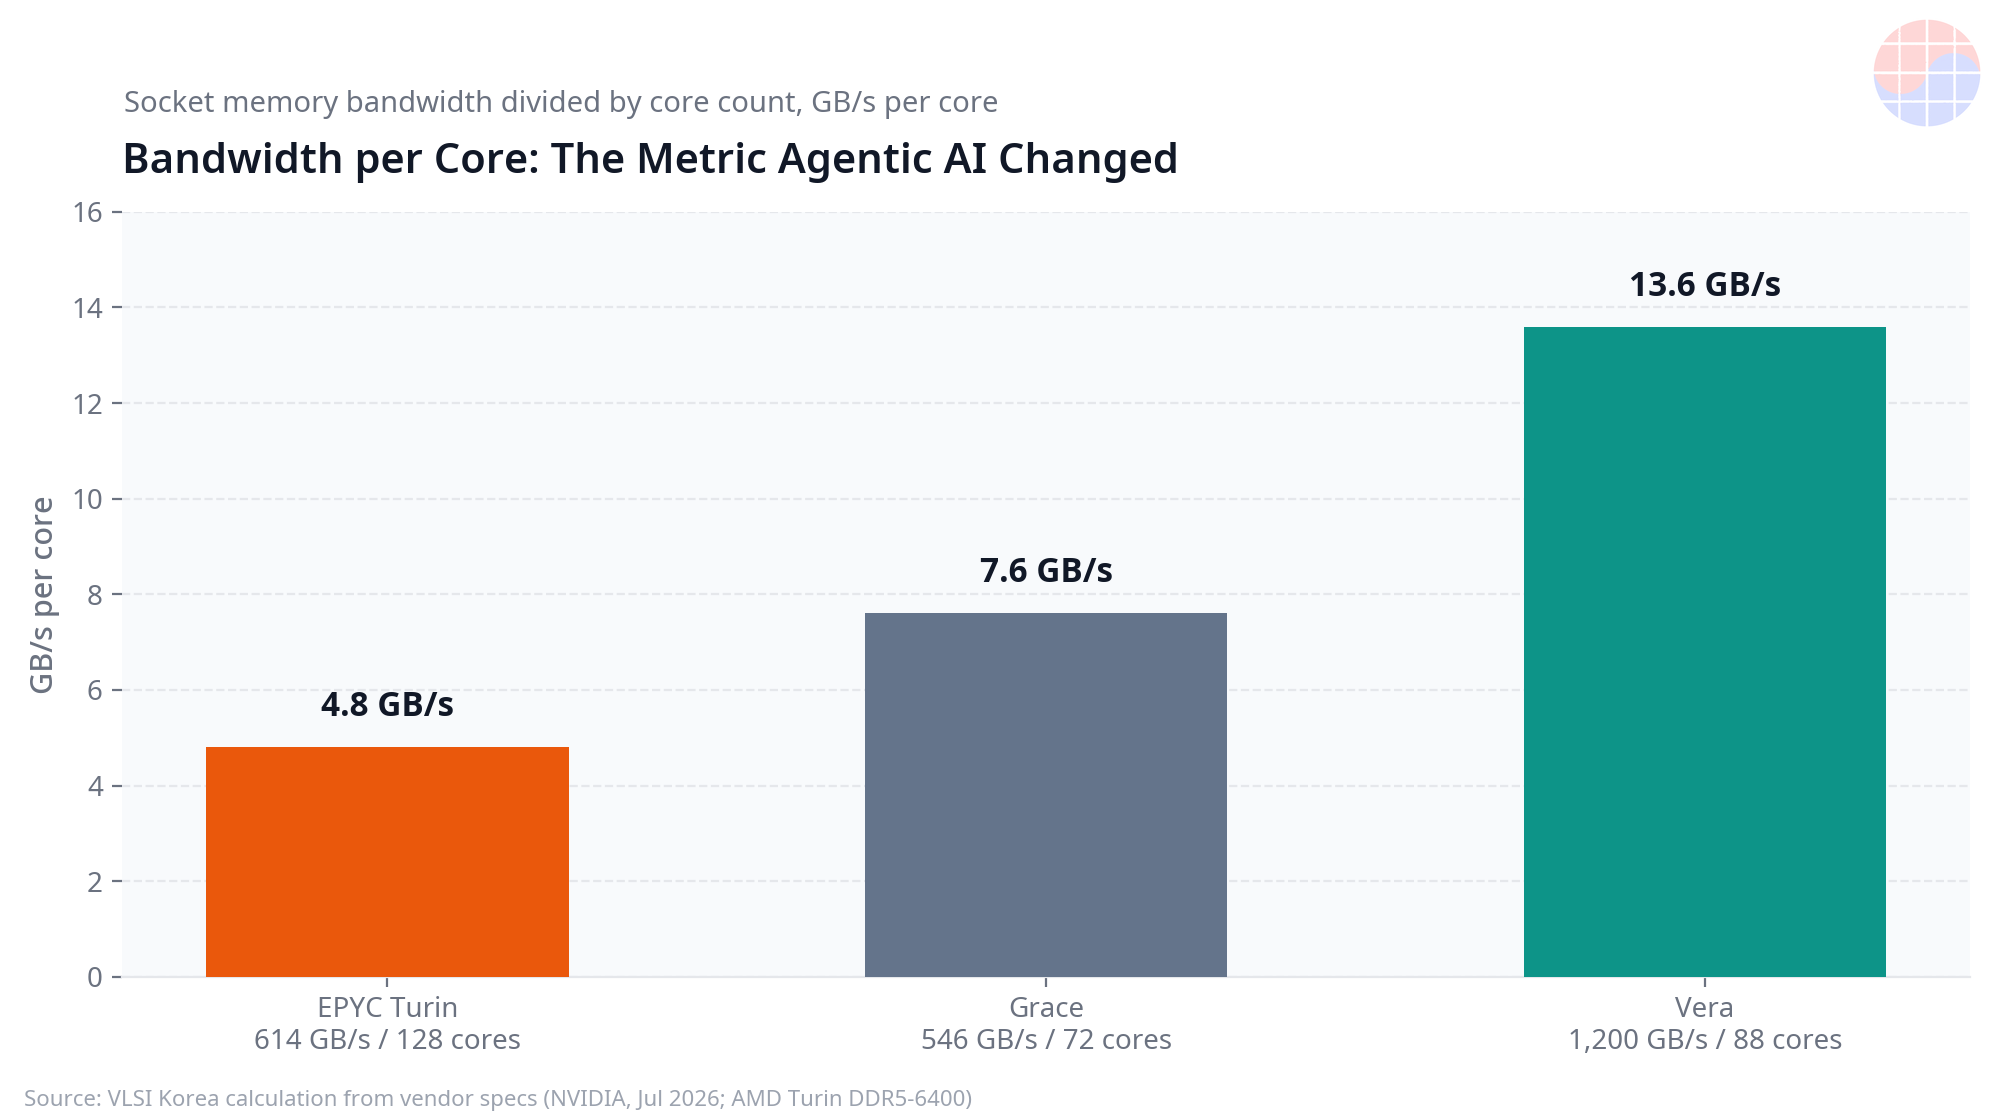
A comparação com x86 exige um método transparente. Um sistema AMD EPYC Turin com 12 canais de DDR5-6400 tem um pico teórico de 614 GB/s, calculado como 12 canais multiplicados por 6.400 MT/s multiplicados por 8 bytes por transferência (cálculo a partir de especificações de memória do AMD EPYC Turin, 20 de outubro de 2026). Distribuído em uma configuração topo de linha de 128 núcleos, são cerca de 4,8 GB/s por núcleo. A largura de banda sustentada real é menor que o pico teórico em todas as plataformas desta comparação, portanto os valores devem ser lidos como razões baseadas em especificações, não como resultados medidos de aplicações.
Nessa base, a Vera oferece cerca de 2,8 vezes a largura de banda por núcleo da configuração Turin e cerca de 1,8 vez a da Grace (cálculo, 20 de outubro de 2026). Essa é a parte mais forte do argumento da NVIDIA. Cargas de trabalho com agentes e intensivas em dados costumam executar muitos threads que transmitem, filtram ou transformam dados. Quando a largura de banda por núcleo é baixa, adicionar núcleos para de ajudar porque os núcleos compartilham um tubo de memória fixo. Quando a largura de banda por núcleo é alta, o escalonamento de threads dura mais.
A NVIDIA também afirma até 1,9 vez mais instruções por ciclo do que o EPYC Turin em cargas de trabalho relacionadas a IA (afirmação do fornecedor, divulgação da NVIDIA, julho de 2026). Essa afirmação deve ser tratada com cuidado. Instruções por ciclo dependem muito da carga de trabalho, do compilador e da mistura de instruções, e um núcleo Arm personalizado e um núcleo x86 não executam fluxos de instruções idênticos. A afirmação sinaliza a intenção de projeto da NVIDIA — núcleos mais largos e eficientes alimentados com mais largura de banda — mas não é uma medição independente, e compradores devem aguardar benchmarks reproduzíveis com configurações divulgadas antes de usá-la em decisões de compra.
Deep Dive 3: Núcleos Olympus, coerência e o Superchip
Os 88 núcleos Olympus da Vera são projetos personalizados compatíveis com Armv9.2-A, um passo além dos núcleos Neoverse V2 licenciados da Grace (divulgação de arquitetura da NVIDIA, julho de 2026). Possuir o projeto do núcleo permite à NVIDIA ajustar vazão vetorial, comportamento de desvio e hierarquia de cache para as cargas de trabalho que seus sistemas de rack realmente executam. Cada núcleo carrega 2 MB de cache L2, e o chip oferece 164 MB de cache L3, valores importantes porque caches grandes reduzem a frequência com que threads precisam esperar pela memória principal (divulgação de arquitetura da NVIDIA, julho de 2026).
O Spatial Multithreading dobra o número de threads expostas para 176 threads por soquete (divulgação de arquitetura da NVIDIA, julho de 2026). Dobrar threads só compensa se o sistema de memória puder alimentar os threads extras, por isso o valor de 1,2 TB/s e a contagem de threads devem ser lidos como uma única decisão de projeto, não como duas especificações separadas.
A coerência é o segundo pilar. A Scalable Coherency Fabric de segunda geração da Vera e o NVLink-C2C a 1,8 TB/s permitem que CPU e GPU compartilhem dados de forma coerente a velocidades muito acima de um link PCIe convencional (divulgação de arquitetura da NVIDIA, julho de 2026). A Vera também suporta PCIe Gen6 e CXL 3.1, podendo conectar aceleradores convencionais, adaptadores de rede e dispositivos de expansão de memória (divulgação de arquitetura da NVIDIA, julho de 2026). Em um rack de IA, o compartilhamento coerente reduz a sobrecarga de cópias explícitas: a CPU pode preparar estruturas de dados que a GPU consome diretamente, e resultados intermediários podem se mover com menos transferências gerenciadas por software.
A configuração Superchip escala a mesma ideia. Duas CPUs Vera entregam 176 núcleos, 352 threads, 2,4 TB/s de largura de banda de memória e 3 TB de memória em 16 módulos SOCAMM2 (divulgação de arquitetura da NVIDIA, julho de 2026). Em escala de rack, o total de referência de 22.528 núcleos e 384 TB de memória em 128 Superchips mostra que a NVIDIA projeta a camada de CPU como infraestrutura agrupada para frotas de agentes e pipelines de dados, não como um cuidador mínimo de GPU (divulgação de arquitetura da NVIDIA, julho de 2026).
A potência é configurável entre 250 W e 450 W de TDP (divulgação de arquitetura da NVIDIA, julho de 2026). Essa faixa importa para interpretar qualquer benchmark: um resultado a 450 W e um resultado a 250 W descrevem pontos de operação diferentes, e comparações que não indicam a definição estão incompletas.
Deep Dive 4: Os limites honestos — benchmarks, resposta x86 e custo monolítico
Três limites merecem atenção direta. Primeiro, a evidência pública de benchmarks é escassa. Resultados de parceiros, incluindo resultados de dados em streaming associados à Redpanda, foram publicados sem divulgação completa de configuração e definições de TDP (publicações de benchmarks de parceiros, 2026). Sem contagem de núcleos no momento do teste, população de memória, firmware e definições de potência, leitores externos não podem reproduzir os números nem julgar se a comparação foi justa. A afirmação da NVIDIA de até 1,9 vez mais IPC tem o mesmo status: é uma afirmação do fornecedor até que testes independentes com métodos divulgados a confirmem (divulgação da NVIDIA, julho de 2026).
Segundo, os fornecedores x86 não estão parados. Plataformas de servidor avançam para DDR5 mais rápida, memória MRDIMM que eleva a largura de banda efetiva por canal e novas gerações com mais canais de memória. MRDIMM e plataformas x86 de próxima geração reduzirão a diferença de largura de banda por núcleo a partir da linha de base de especificações de 614 GB/s usada acima, especialmente em configurações que trocam contagem de núcleos por largura de banda. A vantagem da Vera é real nas especificações divulgadas em 20 de outubro de 2026, mas é uma vantagem em um ponto no tempo, não uma diferença estrutural permanente.
Terceiro, o die de computação monolítico da Vera tem um perfil de custo. Um die monolítico grande geralmente enfrenta uma economia de rendimento (yield) mais difícil do que um projeto chiplet que pode descartar apenas um die pequeno defeituoso e reutilizar dies bons conhecidos em vários produtos (princípio geral de fabricação de semicondutores, declarado em 20 de outubro de 2026). A NVIDIA não divulgou valores de rendimento (yield) nem de custo unitário da Vera, portanto nenhuma afirmação específica de custo é feita aqui. O ponto é direcional: a escolha de projeto que ajuda latência e coerência também concentra o risco de fabricação, e o preço refletirá isso.
Por fim, o software decide quanta vantagem de hardware sobrevive ao contato com a produção. A maturidade do ecossistema Arm em ferramentas empresariais, observabilidade e middleware legado melhorou, mas o esforço de migração ainda é um custo real para operadores com grandes instalações x86. Largura de banda vence benchmarks; custo total de propriedade vence pedidos de compra.
Chase's Take
A mudança importante não é que a NVIDIA tenha construído uma CPU com 88 núcleos. A mudança importante é para onde o gargalo se moveu. Em sistemas de IA com agentes, a CPU cuida da orquestração: loops de planejamento, invocação de ferramentas, recuperação, gestão de memória para contextos longos e movimento de dados entre armazenamento, rede e GPU. Essas tarefas são ricas em threads e famintas por memória. Seu recurso limitante geralmente não é o pico de desempenho em ponto flutuante. É quantos dados cada thread pode alcançar, com que rapidez, sem ficar na fila atrás de todas as outras threads. A Vera foi projetada em torno dessa realidade — largura de banda por núcleo e capacidade de memória por soquete primeiro, contagem de núcleos depois.
De uma perspectiva de negócios, a SOCAMM2 pode importar ainda mais do que o núcleo Olympus. Ao definir um módulo LPDDR5X com soquete para o soquete da CPU, a NVIDIA transformou a memória host em um slot de conteúdo padronizado e de alto volume. A Vera carrega 1,5 TB por soquete contra 480 GB da Grace, três vezes o conteúdo de memória por soquete (divulgação de arquitetura da NVIDIA, julho de 2026). Cada rack que adota a Vera puxa, portanto, muito mais LPDDR5X pela cadeia de suprimentos.
Isso transforma o soquete da CPU em um campo de batalha por conteúdo de memória. Samsung Electronics, SK hynix e Micron competem no fornecimento de LPDDR5X, e a qualificação para uma plataforma NVIDIA de alto volume vale mais do que uma única vitória de projeto: ela ancora volume, poder de preços e uma posição na próxima revisão do módulo. Fornecedores coreanos têm um interesse particular aqui, porque a liderança em LPDDR historicamente foi uma fortaleza coreana, e a SOCAMM2 dá a essa fortaleza uma nova saída em servidores além dos smartphones. A história da Vera, lida a partir de Seul, é em parte uma história de CPU e em parte uma história sobre quem vende a memória que cerca a CPU.
Meu julgamento: avalie a Vera pela largura de banda por núcleo entregue em cargas de trabalho reais de agentes em produção, não pela manchete de 88 núcleos nem por definições de benchmark não divulgadas. Se testes independentes confirmarem mesmo a maior parte da vantagem de especificações, a pressão sobre os roteiros x86 — mais canais, adoção de MRDIMM, menos núcleos por nível de largura de banda — será o sinal mais claro de que a Vera mudou o mercado.
Implications
- Para compradores de sistemas de IA: Avaliem a Vera por largura de banda por núcleo e capacidade de memória por soquete para suas próprias cargas de trabalho de agentes, recuperação e carregamento de dados, e exijam TDP e configuração de memória divulgados em cada benchmark do fornecedor (base: divulgação de arquitetura da NVIDIA, julho de 2026).
- Para o planejamento de plataformas x86: A diferença de especificações — cerca de 13,6 GB/s por núcleo para a Vera frente a cerca de 4,8 GB/s por núcleo para uma configuração Turin de 128 núcleos com DDR5-6400 — torna MRDIMM e projetos com mais canais uma prioridade de roteiro, não uma opção (cálculo, 20 de outubro de 2026).
- Para fornecedores de memória: A SOCAMM2 eleva o conteúdo LPDDR5X do lado da CPU para 1,5 TB por soquete, três vezes a Grace, portanto Samsung Electronics, SK hynix e Micron competem por um soquete maior e mais estratégico (divulgação de arquitetura da NVIDIA, julho de 2026).
- Para operadores: Custo de migração, ajuste do ecossistema de software e preço de die monolítico podem compensar parte da vantagem de hardware; testes de custo total de propriedade importam mais do que afirmações de manchete sobre IPC.
- Para o mercado de CPU: Se as cargas de trabalho com agentes continuarem crescendo, a largura de banda por núcleo se torna um critério de compra de primeira ordem junto à contagem de núcleos, e o marketing de CPU liderado apenas por núcleos envelhecerá mal.
Este artigo baseia-se em divulgações da NVIDIA de março de 2025 e julho de 2026 e em cálculos de especificações datados de 20 de outubro de 2026; afirmações de desempenho do fornecedor estão rotuladas como tais e não foram verificadas de forma independente.
FAQ
Q1. O que é a CPU NVIDIA Vera e quando foi divulgada? A Vera é a CPU para centro de dados da NVIDIA com 88 núcleos Olympus personalizados compatíveis com Armv9.2-A e 176 threads via Spatial Multithreading. Foi apresentada com a plataforma Vera Rubin na GTC em março de 2025, e a NVIDIA publicou divulgações detalhadas de arquitetura em julho de 2026.
Q2. Quanta largura de banda e capacidade de memória a Vera oferece por soquete? Cada soquete Vera suporta até 1,5 TB de LPDDR5X SOCAMM2 a até 9.600 MT/s e até 1,2 TB/s de largura de banda de memória, o que equivale a cerca de 13,6 GB/s por núcleo em 88 núcleos (divulgação de arquitetura da NVIDIA, julho de 2026).
Q3. Como a Vera se compara com Grace e AMD EPYC Turin em largura de banda por núcleo? A Grace oferece 546 GB/s em 72 núcleos, ou cerca de 7,6 GB/s por núcleo. Uma configuração EPYC Turin de 128 núcleos com DDR5-6400 de 12 canais tem um teórico de 614 GB/s, ou cerca de 4,8 GB/s por núcleo. Os cerca de 13,6 GB/s por núcleo da Vera são cerca de 1,8 vez a Grace e cerca de 2,8 vezes essa configuração Turin, em base de especificações (cálculo, 20 de outubro de 2026).
Q4. Quais são os principais limites e questões abertas da Vera? A afirmação da NVIDIA de até 1,9 vez mais IPC frente ao Turin é uma afirmação do fornecedor, benchmarks de parceiros como os resultados da Redpanda não divulgam configuração completa nem definições de TDP, plataformas x86 respondem com MRDIMM e projetos de memória de próxima geração, e o die monolítico da Vera pode ter custo de fabricação maior do que alternativas chiplet. Benchmarks independentes com métodos divulgados ainda são necessários (estado em 20 de outubro de 2026).
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.


