 VLSI Korea
Positron AI em profundidade: a avaliação de US$ 5 bilhões e o chip de inferência memory-first
Por que a Positron AI vale US$ 5 bilhões? A Series C de US$ 875 milhões de setembro de 2026, os mais de 50 racks Atlas na Oracle e o projeto Asimov com LPDDR5X em vez de HBM.


Resumo em 30 segundos
A Positron AI vale US$ 5 bilhões porque os investidores compram uma afirmação específica: a inferência de IA é limitada pela memória, não pelo cómputo, e um chip desenhado em torno de memória LPDDR5X barata pode servir modelos grandes com custo por token e consumo menores do que uma GPU construída em torno da escassa HBM. A avaliação não é um rumor. A Positron anunciou em 10 de setembro de 2026 um financiamento Series C e Series C-1 de US$ 875 milhões, com avaliação post-money de US$ 5 bilhões. É cerca de 4,7 vezes a avaliação post-money de US$ 1,06 bilhão da sua Series B de US$ 230 milhões em fevereiro de 2026, apenas sete meses antes.
A empresa já envia um produto. Mais de 50 racks do Atlas, o seu sistema de inferência de primeira geração, estão implantados na Oracle Cloud Infrastructure, onde o parceiro Parasail opera um serviço de inferência sobre essa capacidade. Entre os clientes de produção do Atlas estão também Jump Trading e i3d.net. No entanto, o produto que deve justificar a maior parte dos US$ 5 bilhões ainda não é enviado. O Asimov, um ASIC personalizado no processo N3P da TSMC, tem como meta o tape-out no final de 2026 e a produção na segunda metade de 2027. Os seus principais números de eficiência vêm de simulação cycle-accurate, não de silício de produção.
Essa distância é toda a história. O Atlas prova que a Positron consegue construir, implantar e operar hardware de inferência num centro de dados real. O Asimov é a aposta de que a mesma equipe pode transformar uma arquitetura memory-first — de 288GB a 2.304GB de LPDDR5X por chip, mais de 90% de largura de banda de memória realizável como meta de projeto, cerca de 400W por chip e nenhuma dependência de HBM ou CoWoS — num negócio capaz de sustentar uma avaliação privada de US$ 5 bilhões. Se o Asimov chegar a tempo e a vantagem simulada em tokens por dólar sobreviver às cargas reais, o preço pode parecer antecipado. Se o tape-out, o rendimento (yield), a qualificação ou a adoção de software atrasarem, sob esse preço há muito pouca receita atual: a Positron não publicou receita nem run rate anualizado.
| Item | Detalhe |
|---|---|
| Fundação | 2023 — sede em Reno, Nevada (EUA) |
| Rodada mais recente | Series C e C-1, 10 de setembro de 2026 — US$ 875 milhões, com avaliação post-money de US$ 5 bilhões |
| Rodada anterior | Series B, fevereiro de 2026 — US$ 230 milhões, com avaliação post-money de US$ 1,06 bilhão |
| Financiamento total divulgado | Cerca de US$ 1,18 bilhão |
| Produto em envio | Atlas, sistema de inferência baseado em FPGA — mais de 50 racks implantados na Oracle Cloud Infrastructure |
| Próximo chip | Asimov, ASIC personalizado em TSMC N3P — tape-out previsto para o fim de 2026 e produção no segundo semestre de 2027 |
| Metas de design do Asimov | 288GB–2.304GB de LPDDR5X por chip, 2,76 TB/s de largura de banda de memória realizável e cerca de 400W por chip |
Background: uma empresa de três anos construída só para inferência
A Positron AI foi fundada em 2023 e tem sede em Reno, Nevada. Foi cofundada por Thomas Sohmers, seu diretor de tecnologia, e Edward Kmett, seu cientista-chefe, ambos vindos de outra startup de inferência, a Groq. Mitesh Agrawal, antes diretor de operações e responsável pela nuvem na Lambda, entrou como diretor executivo para escalar as operações comerciais. A equipe técnica fundadora vinha da inferência, não do projeto de GPU de uso geral, e o diretor executivo vinha de vender e operar cómputo de IA, não de um laboratório.
A Positron não tenta treinar modelos frontier. O treinamento é uma competição de densidade de cómputo dominada por grandes clusters de GPU e uma pilha de software madura. A inferência — executar um modelo treinado para utilizadores, agentes, copilotos, pesquisa, trading e geração de mídia — é um problema operacional diferente. Funciona continuamente, é paga por token e a sua economia é definida por três restrições que apertam ao mesmo tempo: capacidade de memória, largura de banda de memória e potência. A capacidade decide que modelos cabem e quanto contexto e KV cache cabe; a largura de banda decide a velocidade de tokens; e a potência decide quanta capacidade um centro de dados pode ligar: uma instalação ganha com os tokens entregues dentro do seu limite de potência, não com FLOPS de pico que não consegue alimentar.
O Atlas foi desenhado para chegar ao mercado antes de a Positron gastar anos e centenas de milhões num ASIC personalizado. O Atlas é um sistema de inferência baseado em FPGA, fabricado nos Estados Unidos e entregue como um appliance que os clientes podem implantar sem reconstruir o seu fluxo de software. A Positron levou o Atlas ao mercado em cerca de 18 meses e apresenta-o como refrigerado a ar e adequado a envelopes de potência de rack convencionais. O Atlas deu à Positron implantações pagas, dados operacionais e feedback de clientes antes de existir o seu silício personalizado.
O histórico de financiamento mostra a rapidez com que o mercado reavaliou essa evidência. A Positron levantou US$ 23,5 milhões em seed, depois uma Series A de US$ 51,6 milhões em julho de 2025, depois a Series B de US$ 230 milhões em fevereiro de 2026 com avaliação post-money acima de US$ 1 bilhão, e depois os US$ 875 milhões de Series C e C-1 em setembro de 2026 a US$ 5 bilhões post-money. O financiamento total divulgado é de cerca de US$ 1,18 bilhão. A ronda de setembro dividiu-se numa Series C de US$ 375 milhões com avaliação pre-money de US$ 3,5 bilhões e numa Series C-1 de até US$ 500 milhões. Foi coliderada por NEA, Atreides Management, Valor Equity Partners, Andra Capital, SemiAnalysis Capital e Jim Clark, com Qatar Investment Authority, Cisco Investments e Naver Ventures entre os restantes participantes.
Business Deep Dive: o que a Positron realmente vende
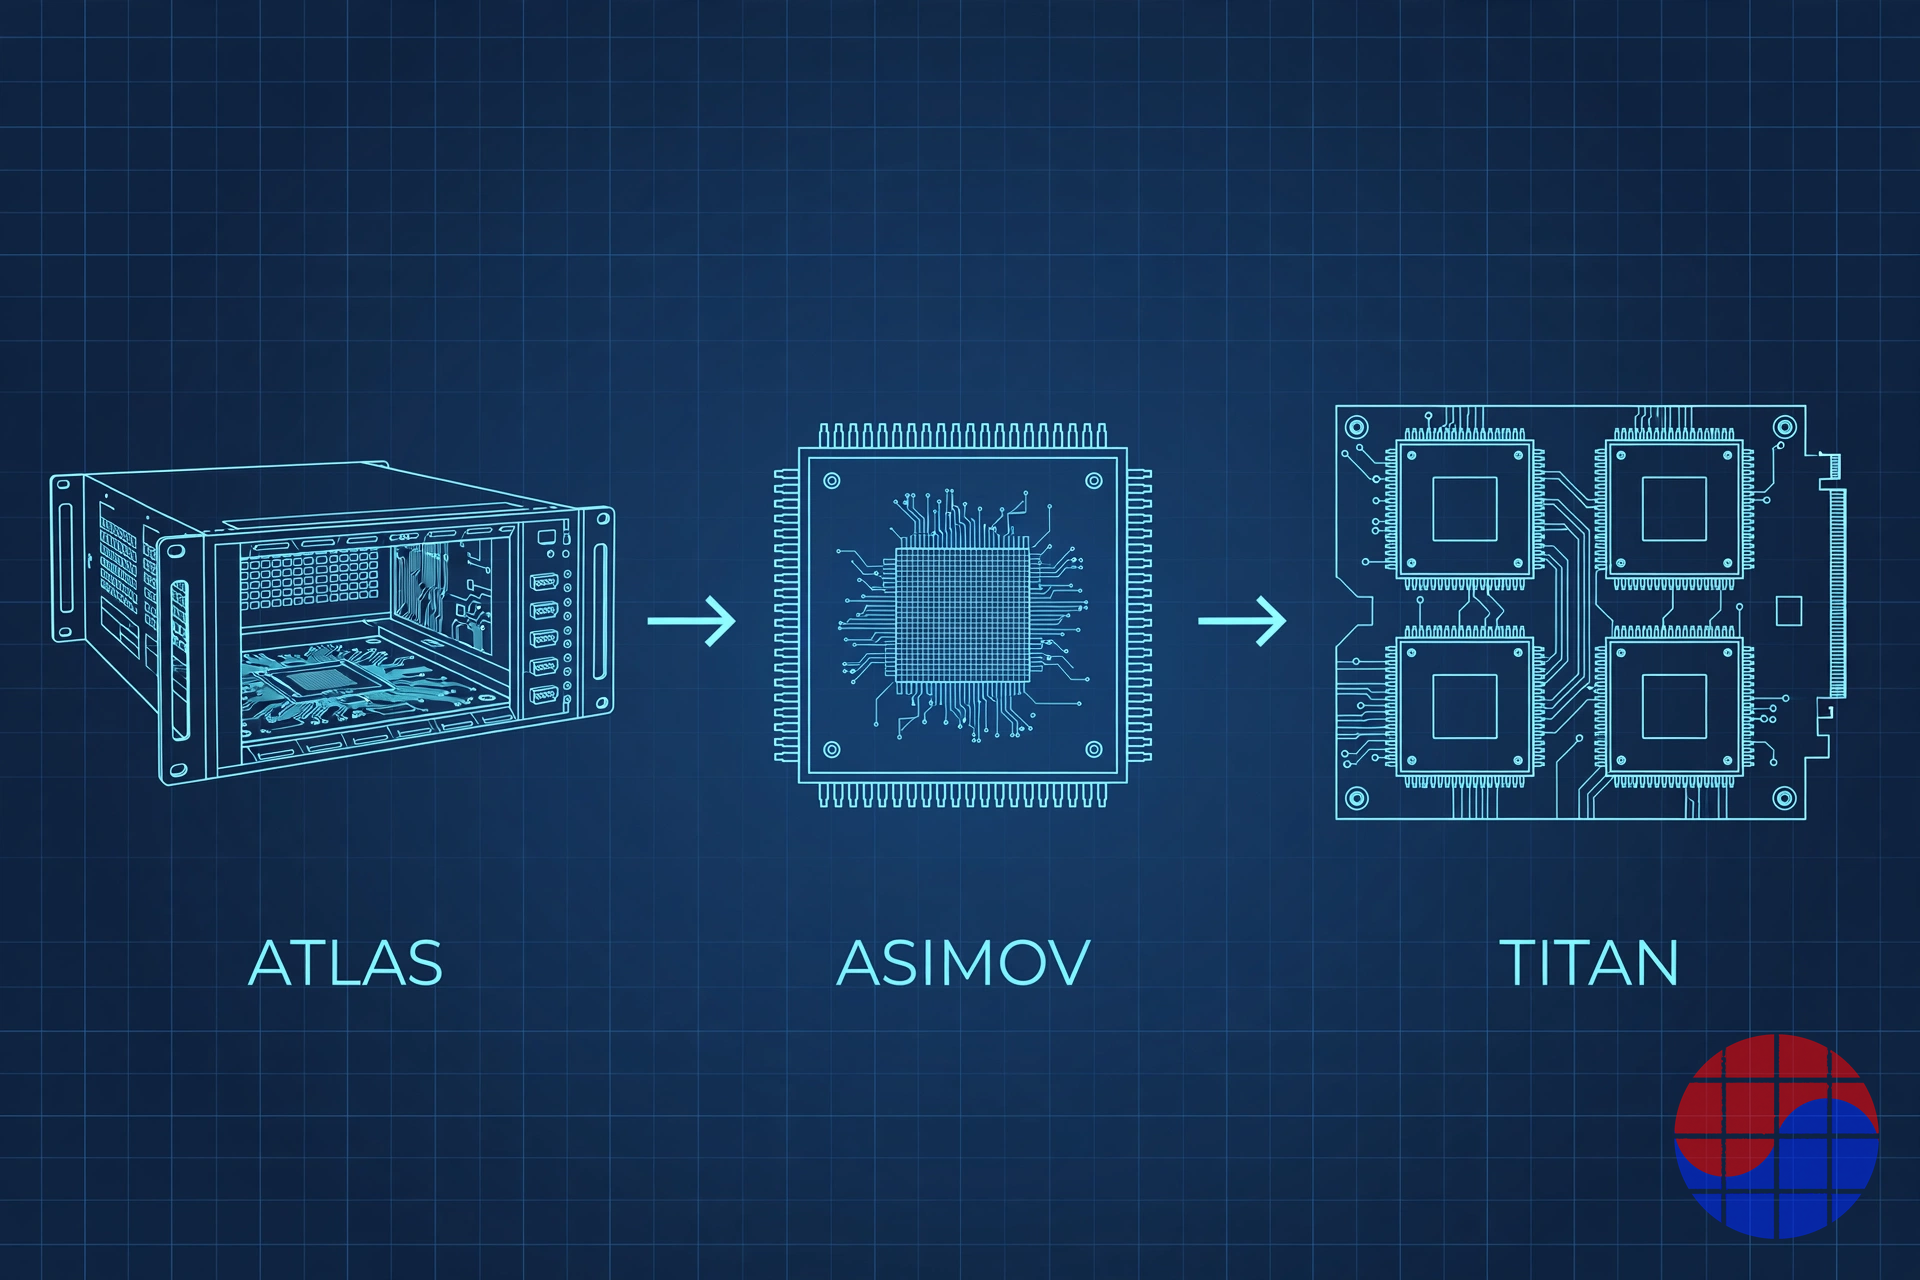
A escada de produtos: Atlas hoje, Asimov e Titan a seguir
A Positron vende sistemas de inferência, não um roteiro de chips. O Atlas é a primeira geração em envio. O Asimov é o ASIC personalizado da próxima geração. O Titan é o sistema construído em torno do Asimov, com quatro a oito chips Asimov por nó. A Positron afirma que o Titan foi desenhado para modelos com mais de 16 trilhões de parâmetros e janelas de contexto acima de 10 milhões de tokens num único nó. São metas de projeto para cargas muito grandes, de contexto longo e agênticas, não a afirmação de que todos os clientes precisem hoje dessa escala.
O modelo de negócio segue o hardware. A Positron fornece capacidade de inferência completa — sistemas que um fornecedor de nuvem, uma neocloud, uma empresa de trading ou um operador de hosting pode pôr em produção — em vez de pedir aos clientes que integrem um componente e construam o resto. A implantação na Oracle ilustra o modelo: os racks Atlas estão dentro da Oracle Cloud Infrastructure e a Parasail usa essa capacidade para o seu serviço de inferência. A Jump Trading é instrutiva de outra forma: primeiro usou o Atlas como cliente e depois coliderou a Series B. Um cliente tornar-se investidor não prova uma grande base de receita, mas é um sinal mais forte do que um logótipo numa apresentação.
A arquitetura memory-first, em termos de engenharia
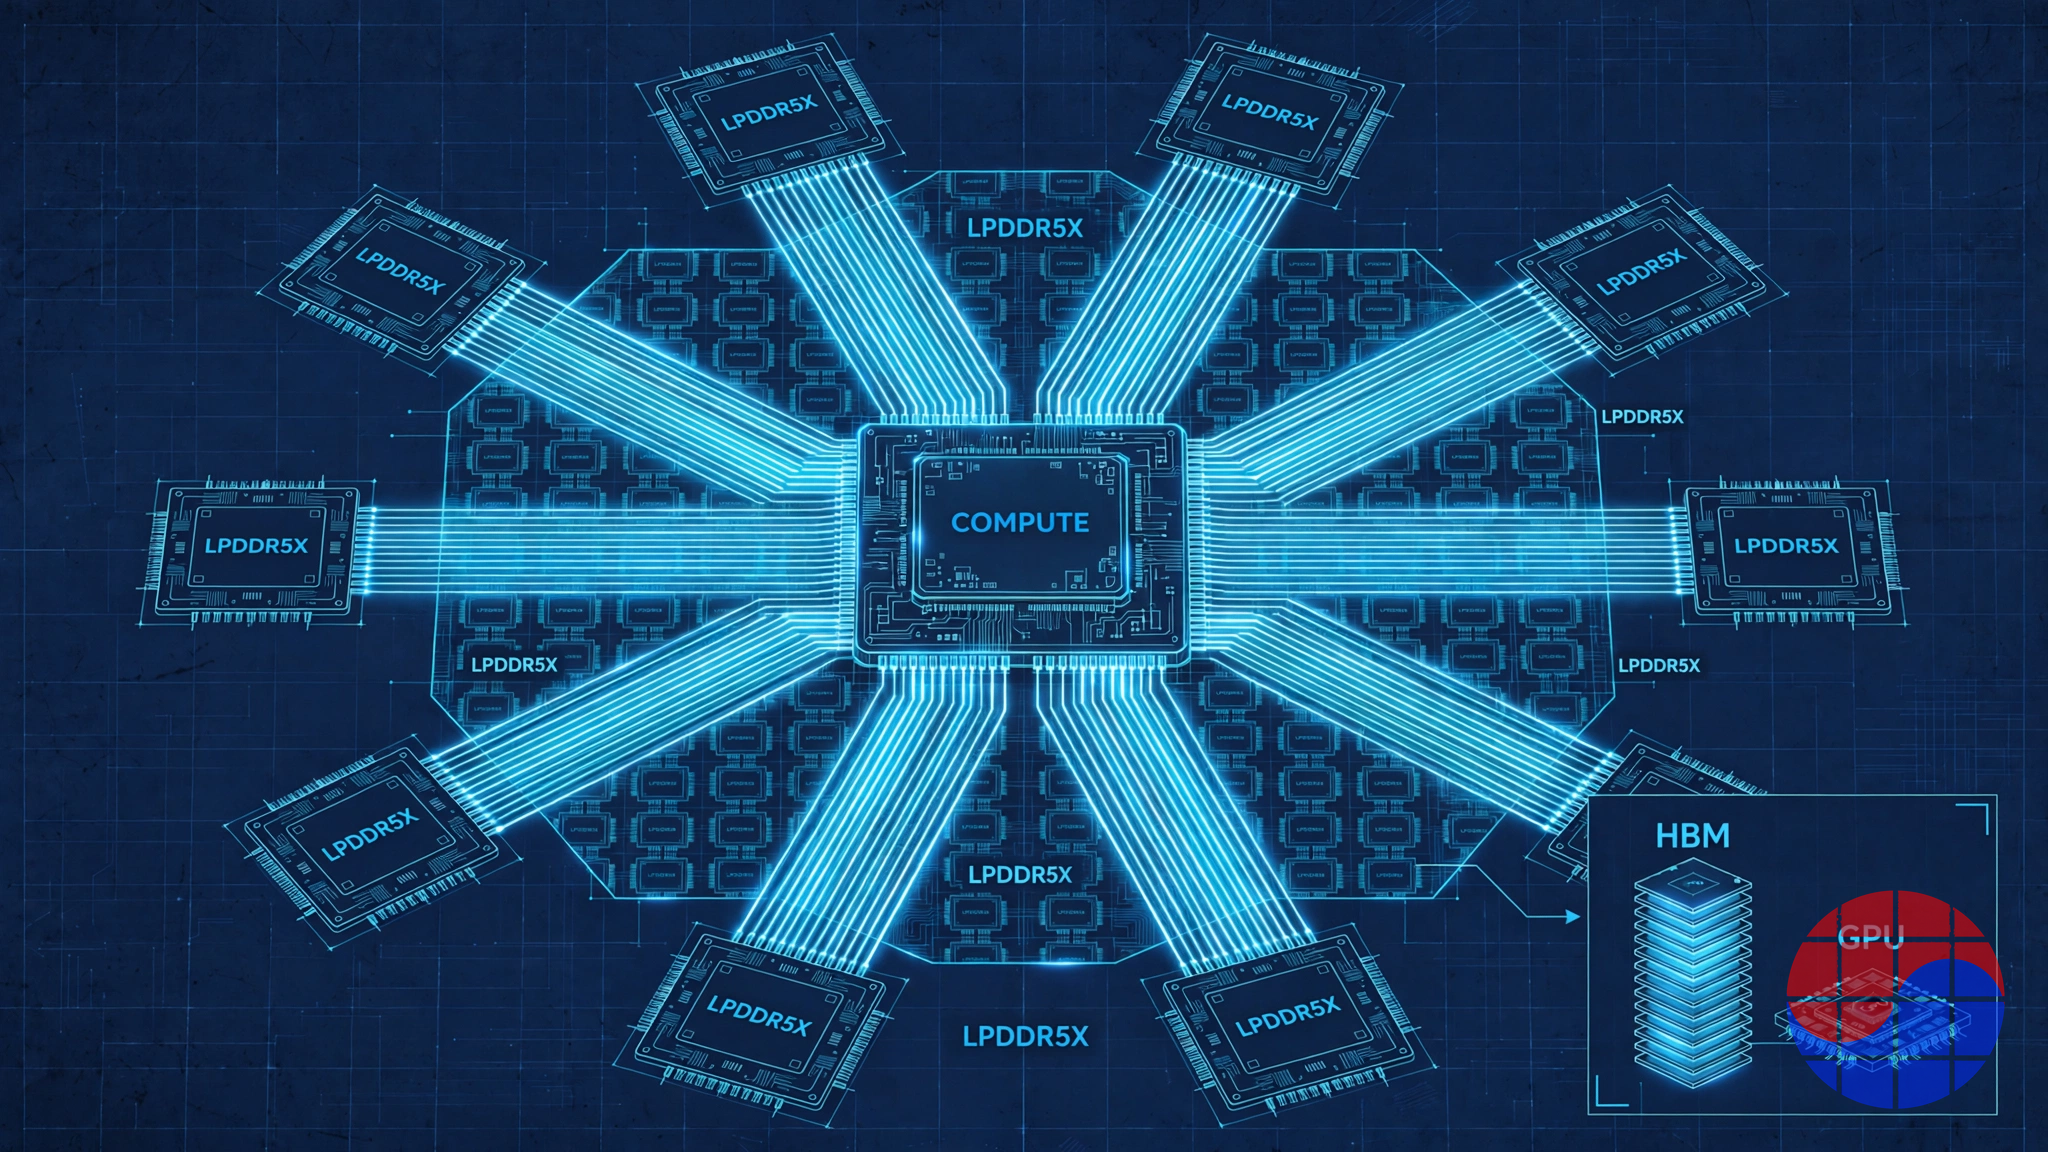
A maioria dos aceleradores de IA parte do cómputo e acopla-lhe a memória mais rápida disponível. Essa memória é a HBM, DRAM empilhada junto ao processador e entregue através de encapsulamento avançado como CoWoS. A HBM oferece largura de banda de pico muito alta, mas é cara, limitada em capacidade por pacote e exposta a uma cadeia de suprimentos concentrada. A Positron inverte a ordem do projeto. Parte da observação de que a inferência com transformers é muitas vezes limitada pela memória: o sistema passa grande parte do tempo a mover pesos, ativações e KV cache, não a calcular à velocidade de pico.
Por isso o Asimov usa memória commodity LPDDR5X — a classe de memória dos telemóveis e portáteis — em vez de HBM. O compromisso é explícito. A LPDDR5X tem muito menos largura de banda por pino do que a HBM, por isso a Positron tem de agregar muitos canais e mantê-los ocupados. Em troca, pode acoplar muito mais capacidade por chip, evitar os gargalos de HBM e CoWoS e apoiar-se numa base de fornecimento de memória mais profunda e barata. As metas publicadas do Asimov incluem de 288GB a 2.304GB de memória por chip, 2,76 TB/s de largura de banda de memória realizável, suporte a PCIe Gen6 e CXL, e um envelope de potência de cerca de 400W com suporte a refrigeração a ar. Para ligar tanta LPDDR, a Positron usa uma abordagem de fan-out de memória baseada em chiplets, incluindo o chiplet Weaver desenvolvido com a Credo.
A afirmação técnica central é a utilização. A Positron afirma que os seus sistemas memory-first podem realizar mais de 90% da largura de banda de memória disponível, e o Atlas foi descrito com até 93% de utilização. As cargas de inferência em GPU, pelo contrário, são geralmente descritas como realizando apenas uma fração muito menor da largura de banda de pico da HBM em condições reais de serviço. É por isso que uma simples comparação de largura de banda de pico engana. Uma GPU pode anunciar um pico muito maior e mesmo assim entregar menos largura de banda útil num dado modelo se os padrões de acesso, o batching e o comportamento da cache tornarem esse pico inalcançável. O argumento da Positron não é que a LPDDR seja mais rápida do que a HBM. É que uma arquitetura equilibrada pode extrair mais de um fundo de largura de banda menor e mais barato, guardando ao mesmo tempo muito mais modelo e contexto em memória.
Potência: a afirmação e o seu nível de evidência
A Positron afirma que o Atlas entrega cerca de três vezes mais cómputo por watt do que uma Nvidia H100 e, em algumas descrições, mais de 70% mais desempenho de tokens com cerca de dois terços menos potência do que sistemas Hopper comparáveis. Para o Asimov, a empresa afirmou cinco vezes mais tokens por watt do que a próxima GPU Rubin da Nvidia nas suas cargas centrais, e as comparações do Titan baseadas em simulação foram apresentadas até 26 vezes mais tokens por dólar do que um sistema GB300 NVL72 a uma taxa de tokens por utilizador especificada. Estes números devem ser lidos em dois níveis de evidência. O Atlas está em envio, mas as suas comparações continuam a ser dados reportados pela empresa e não foram encerradas por um único benchmark independente aceite em toda a indústria. O Asimov ainda não fez tape-out, por isso os seus números são metas de projeto derivadas de simulação. Nenhuma das categorias deve ser escrita como um facto medido.
O argumento da potência continua comercialmente coerente mesmo após esse desconto. Os centros de dados existentes contêm muita capacidade refrigerada a ar construída para densidades de rack menores. Um sistema implantável sem reconstruir a refrigeração líquida amplia a base instalada alcançável. Também muda a unidade de competição para os tokens entregues por megawatt já disponível, a métrica que um operador limitado pela potência realmente compra.
O que uma avaliação de US$ 5 bilhões tem de supor
Uma avaliação post-money de US$ 5 bilhões após levantar US$ 875 milhões significa que os novos investidores pagaram por receita futura de sistemas, não por caixa no balanço. Em aritmética simples, os US$ 875 milhões são 17,5% dos US$ 5 bilhões post-money, embora a estrutura em duas tranches e os termos dos valores façam com que essa percentagem não seja um cálculo exato de participação. O valor restante tem de vir de o Asimov e o Titan se converterem em vendas de sistemas repetíveis e de alto volume.
Para isso funcionar, pelo menos cinco condições têm de se cumprir ao mesmo tempo. Primeiro, o Asimov tem de fazer tape-out no final de 2026 sem um re-spin importante. Segundo, a produção na segunda metade de 2027 tem de alcançar um yield utilizável e a qualificação do sistema no N3P da TSMC. Terceiro, a utilização da largura de banda e a vantagem em tokens por watt simuladas têm de aparecer em modelos de clientes, com tamanhos de batch de produção e metas de latência, não apenas em cargas selecionadas. Quarto, os clientes têm de conseguir executar os seus modelos sem uma migração de software dolorosa; os compradores de inferência pagam por tokens entregues, não por elegância arquitetónica. Quinto, a Positron tem de fabricar e suportar sistemas em escala enquanto o preço e o fornecimento de LPDDR se mantiverem favoráveis o suficiente para preservar o seu argumento de custo face aos sistemas com HBM.
A divulgação de receita é a variável em falta. A Positron disse que espera um forte crescimento de receita e o seu diretor executivo descreveu acordos do Atlas na ordem das dezenas de milhões de dólares, mas a empresa não publicou um número de receita nem uma taxa que permita calcular um múltiplo preço-vendas. Qualquer múltiplo citado hoje para a Positron seria, portanto, inventado. A afirmação honesta sobre a avaliação é mais estreita e mais útil: US$ 5 bilhões é o preço negociado dos valores de setembro de 2026, sustentado por um negócio Atlas em envio e uma expectativa muito grande para o Asimov.
Chase's Take
O meu juízo é que a tese memory-first é real, e a avaliação continua à frente da evidência. As duas afirmações não se contradizem. A economia da inferência desloca-se do cómputo bruto para a capacidade de memória, a largura de banda realizada e a potência, sobretudo à medida que crescem as janelas de contexto, os traços de raciocínio e as KV caches. Usar LPDDR5X para escapar à fila da HBM e do CoWoS é uma ideia genuína de arquitetura e de cadeia de suprimentos, não uma mudança de rótulo comercial. Construir o Atlas primeiro sobre FPGA também foi a sequência certa: a Positron aprendeu com racks em produção antes de comprometer o seu balanço num ASIC N3P.
O que os US$ 5 bilhões compram, porém, não é o negócio Atlas tal como existe em outubro de 2026. Compram um lançamento bem-sucedido do Asimov em 2027, uma rampa do Titan depois, e mudança suficiente de clientes num mercado onde o ecossistema de software do incumbente é a opção por defeito. O calendário já merece atenção: em fevereiro de 2026 a produção era discutida para o início de 2027; no financiamento de setembro, a meta era a segunda metade de 2027. Pode ser um plano mais preciso e não um atraso, mas para um chip antes do tape-out, o tempo é risco. Cada trimestre de deslizamento dá aos roteiros de GPU, aos ASIC de inferência rivais e ao silício personalizado dos hyperscalers outro trimestre para fechar a diferença de eficiência.
O teste que eu vigiaria não é outro gráfico simulado de tokens por dólar. São três factos operacionais em sequência: o tape-out do Asimov anunciado a tempo, medições independentes ou publicadas por clientes sobre silício de produção, e encomendas repetidas do Titan por um cliente que primeiro pagou pelo Atlas. Se esses três chegarem, US$ 5 bilhões parecerá o preço de entrada. Se o primeiro atrasar, a discussão sobre a avaliação muda imediatamente, porque não há uma base de receita divulgada para absorver a desilusão.
Implications
Para os operadores de centros de dados, a Positron é um lembrete de que as compras de inferência devem ser avaliadas por tokens realizados por dólar e por watt, com os seus próprios comprimentos de contexto e metas de latência, não por FLOPS de pico nem largura de banda de pico. A capacidade de memória por nó também se torna uma variável de compra à medida que crescem as cargas de contexto longo e agênticas.
Para a indústria da memória, o Asimov é um sinal de procura fora da rota HBM. Uma plataforma de inferência baseada em LPDDR5X bem-sucedida em escala ampliaria o mercado de DRAM commodity em centros de dados e criaria um novo centro de projeto em torno de chiplets de fan-out de memória e expansão CXL. Não substituiria a HBM no treinamento, mas provaria que o nível de inferência pode ser segmentado por economia de memória.
Para os investidores, a ronda de setembro marca onde o capital do final de 2026 se concentra: não noutro cluster de treinamento, mas no custo de servir modelos já treinados. Também fixa um padrão claro de diligência: perguntar se um número veio de silício em envio ou de simulação, se o cliente pagou e repetiu a encomenda, e se a avaliação continua a funcionar se a produção se mover dois trimestres.
FAQ
Qual é a última avaliação da Positron AI e quando foi fixada?
A Positron AI anunciou em 10 de setembro de 2026 um financiamento Series C e Series C-1 de US$ 875 milhões, com avaliação post-money de US$ 5 bilhões. A ronda seguiu-se a uma Series B de US$ 230 milhões em fevereiro de 2026, com avaliação post-money de US$ 1,06 bilhão.
O que vende a Positron AI hoje?
A Positron vende o Atlas, um sistema de inferência de IA de primeira geração baseado em FPGA, já implantado em mais de 50 racks na Oracle Cloud Infrastructure. Entre os clientes de produção nomeados estão Jump Trading e i3d.net, e o parceiro Parasail opera um serviço de inferência sobre a capacidade da Oracle.
Em que difere o Asimov de uma GPU que usa HBM?
O Asimov é um ASIC memory-first que usa LPDDR5X commodity em vez de HBM, com metas de 288GB a 2.304GB de memória por chip, mais de 90% de largura de banda de memória realizável como meta de projeto, cerca de 400W por chip e nenhuma dependência do fornecimento de HBM ou CoWoS. O seu tape-out está previsto para o final de 2026 no N3P da TSMC, com produção na segunda metade de 2027.
As afirmações de eficiência da Positron estão verificadas de forma independente?
Nenhum benchmark independente publicado encerra as principais afirmações da Positron. As comparações do Atlas, como cerca de três vezes mais cómputo por watt do que uma H100, são dados reportados pela empresa. Os números do Asimov, incluindo cinco vezes mais tokens por watt do que a Rubin em cargas centrais, baseiam-se em simulação anterior ao tape-out e devem ser tratados como metas de projeto.
Nota: os números de avaliação e financiamento são os termos anunciados pela empresa em 10 de setembro de 2026; as comparações de desempenho são afirmações da empresa ou metas de simulação, conforme identificado no texto, e a Positron não publicou um número de receita.
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.


