 VLSI Korea
Por que a Samsung usará o 3nm da TSMC: base dies NVHBM e o fim da HBM turnkey pura
A Samsung fabricaria os base dies da NVHBM em TSMC 3nm. Mas a exigência vale para os três fabricantes e o turnkey sobrevive na HBM padrão. A mudança real é quem detém o padrão.


Resumo em 30 segundos
- A Samsung fabricará, segundo relatos, o base die da HBM personalizada da Nvidia (NVHBM) no processo de 3nm da TSMC — a primeira cooperação Samsung–TSMC dentro da fabricação de HBM, relatada em 18 de outubro de 2026. Fonte: Seoul Economic Daily / Channel News Asia (Reuters)
- A Nvidia pediu o mesmo aos três fabricantes de memória — Samsung, SK hynix e Micron: base die TSMC 3nm mais core die DRAM 1c (sexta geração). Não é uma concessão apenas da Samsung.
- A NVHBM, apresentada em agosto de 2026, move o controlador de memória da Nvidia para o base die. A Nvidia declara até +30% de largura de banda de memória, até −15% de consumo de energia da HBM e até +25% mais área de die de computação XPU frente à HBM4E padrão.
- O modelo turnkey não morreu. A HBM4/HBM4E padrão e os programas personalizados para outros clientes mantêm o modelo interno da Samsung: base die Samsung Foundry 4nm mais core die 1c.
- A mudança real é quem define o padrão. Quando o controlador de memória vive no base die, o base die é um chip lógico, não de memória — e quem define a validação define todo o stack.
Contexto
O que faz um base die
Um stack de HBM é uma torre de core dies DRAM sobre um único base die (ou die lógico). Os core dies armazenam os dados. O base die cuida da interface: comunica-se com a GPU ou XPU vizinha, gerencia os milhares de TSV que atravessam o stack e absorve cada vez mais funções lógicas que antes ficavam em outro lugar.
Até a HBM3E, o base die era relativamente simples, e os fabricantes de memória o produziam em processos próprios próximos à DRAM. A HBM4 mudou isso: o base die tornou-se um produto lógico de verdade, e a Samsung usou o processo de 4nm da Samsung Foundry no seu base die de HBM4, mantendo todo o stack — base die mais core die 1c — dentro do seu fluxo turnkey. A SK hynix tomou outro caminho antes, em parceria com a TSMC para o seu base die de HBM4. Essa divergência é o pano de fundo da decisão da Nvidia.
O que a NVHBM muda
A NVHBM, programa de HBM personalizada da Nvidia apresentado em agosto de 2026, vai um passo além: o próprio controlador de memória da Nvidia se move para dentro do base die. O primeiro parceiro nomeado é a Amazon Annapurna Labs, a partir do Trainium4.
Essa única decisão de projeto reescreve a divisão do trabalho. O base die deixa de ser uma interface passiva de propriedade do fabricante de memória: carrega a IP do controlador do cliente, o seu comportamento de temporização e as suas expectativas de validação. Quando a lógica mais valiosa do stack pertence ao cliente, o cliente decide onde essa lógica é fabricada — e a resposta da Nvidia, segundo a reportagem de 18 de outubro, é TSMC 3nm, para todos.
Por que padronizar, por que agora
A lógica da Nvidia é operacional, não política. Se três fornecedores constroem base dies de três maneiras diferentes, a Nvidia obtém três distribuições de desempenho e três programas de validação separados para o que deveria ser um componente intercambiável. Um processo comum de base die (TSMC 3nm) mais uma geração comum de core die (1c) comprime essa variância: um padrão de validação, uma faixa de desempenho, três fornecedores intercambiáveis.
Análise de negócios em profundidade
Os números declarados pela Nvidia
| Métrica | HBM4E padrão | NVHBM | Diferença |
|---|---|---|---|
| Largura de banda de memória | Base (=100) | Até 130 | Até +30% |
| Consumo de energia da HBM | Base (=100) | Até 85 | Até −15% |
| Área de die de computação XPU | Base (=100) | Até 125 | Até +25% |
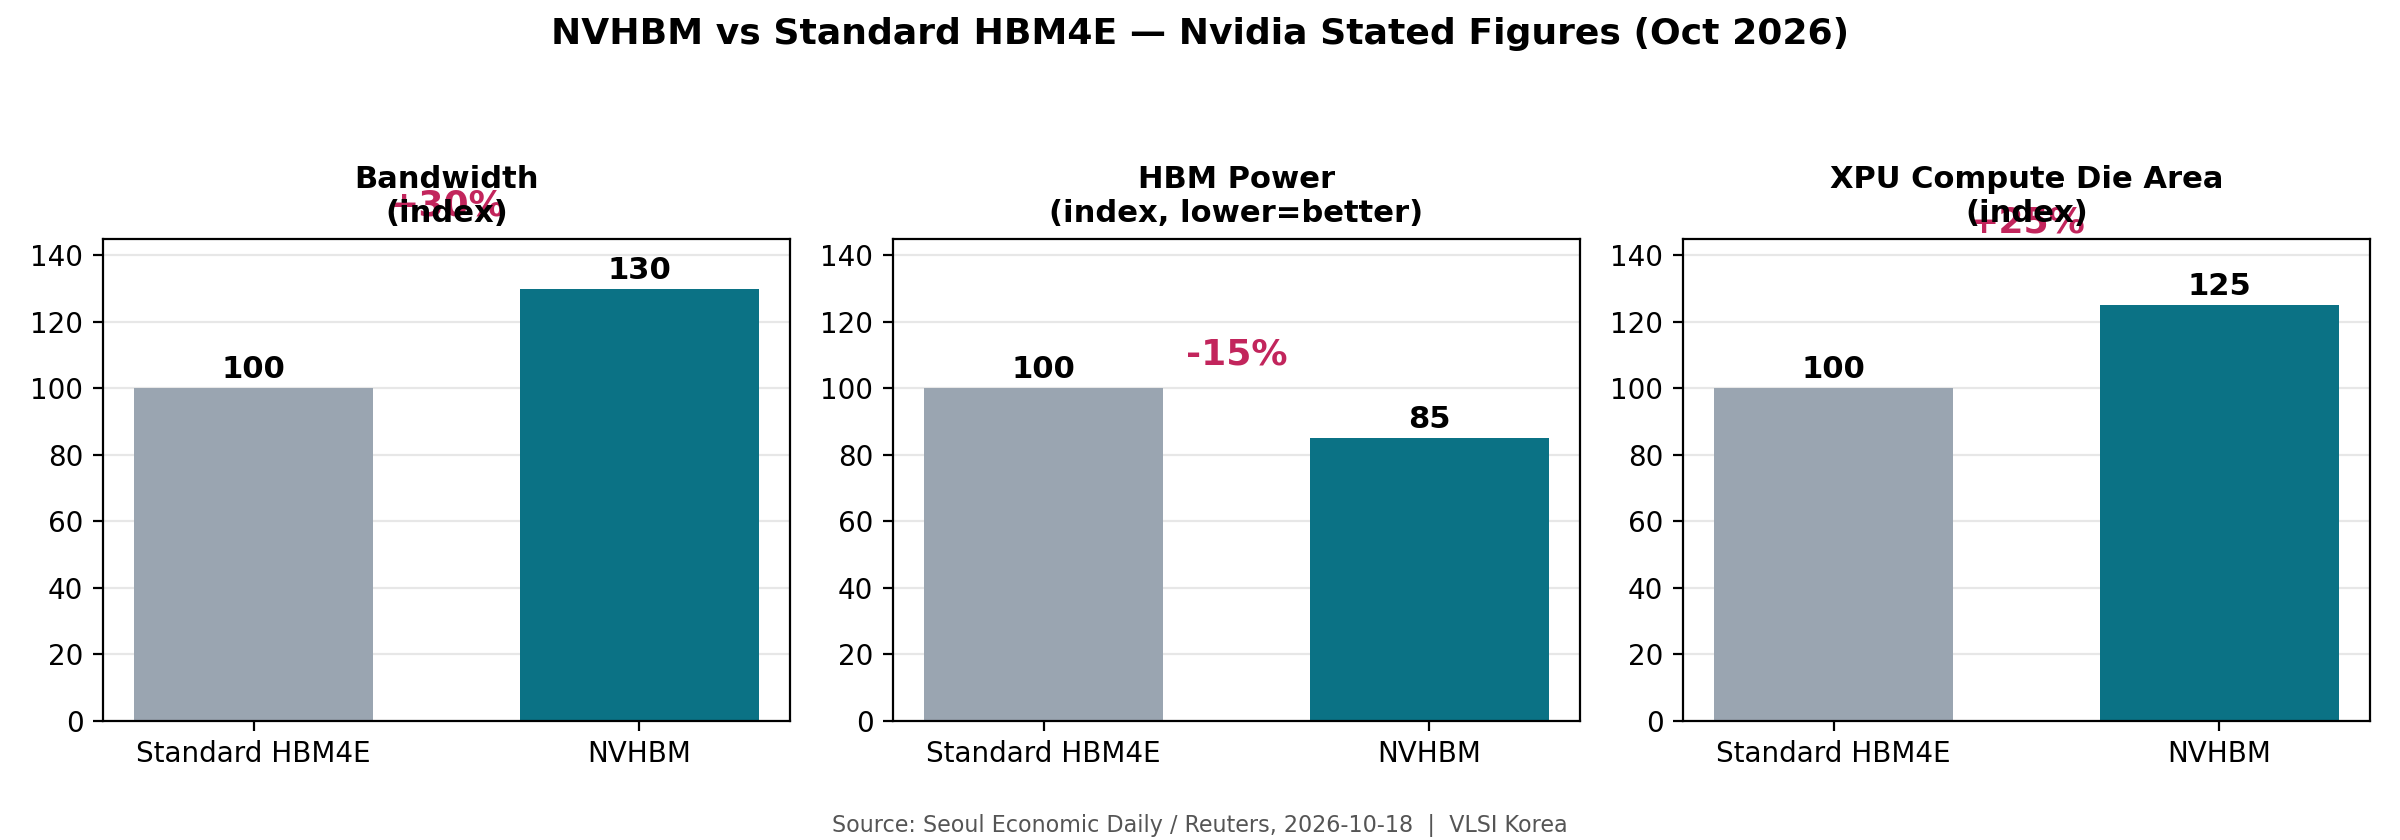
Números declarados pela Nvidia para a NVHBM frente à HBM4E padrão, reportados em outubro de 2026. Fonte: Seoul Economic Daily, 2026-10-18
A terceira linha é a mais importante comercialmente. Mover o controlador de memória da XPU para o base die libera até 25% mais área no die de computação — área que a Nvidia pode gastar em mais computação, mais cache ou melhor rendimento (yield) com o mesmo tamanho de die. O prêmio estrutural é essa transferência de área: o valor migra do die acelerador para o stack de memória, e quem controla o base die controla onde esse valor é fabricado.
Dois modelos, lado a lado
| Elemento | Turnkey da Samsung (HBM4/HBM4E padrão) | Modelo padronizado NVHBM |
|---|---|---|
| Processo do base die | Samsung Foundry 4nm | TSMC 3nm |
| Core die | DRAM 1c (sexta geração) | DRAM 1c (sexta geração) |
| Controlador de memória | Projeto do fornecedor | Projeto da Nvidia, no base die |
| Validação | Por fornecedor | Um padrão comum |
| Escopo | HBM padrão; personalizada para AMD e outros | Apenas NVHBM da Nvidia |
| Status | HBM4 em produção; HBM4E em validação de produção | Relatado em 18-10-2026; sem comentário oficial dos três fornecedores |
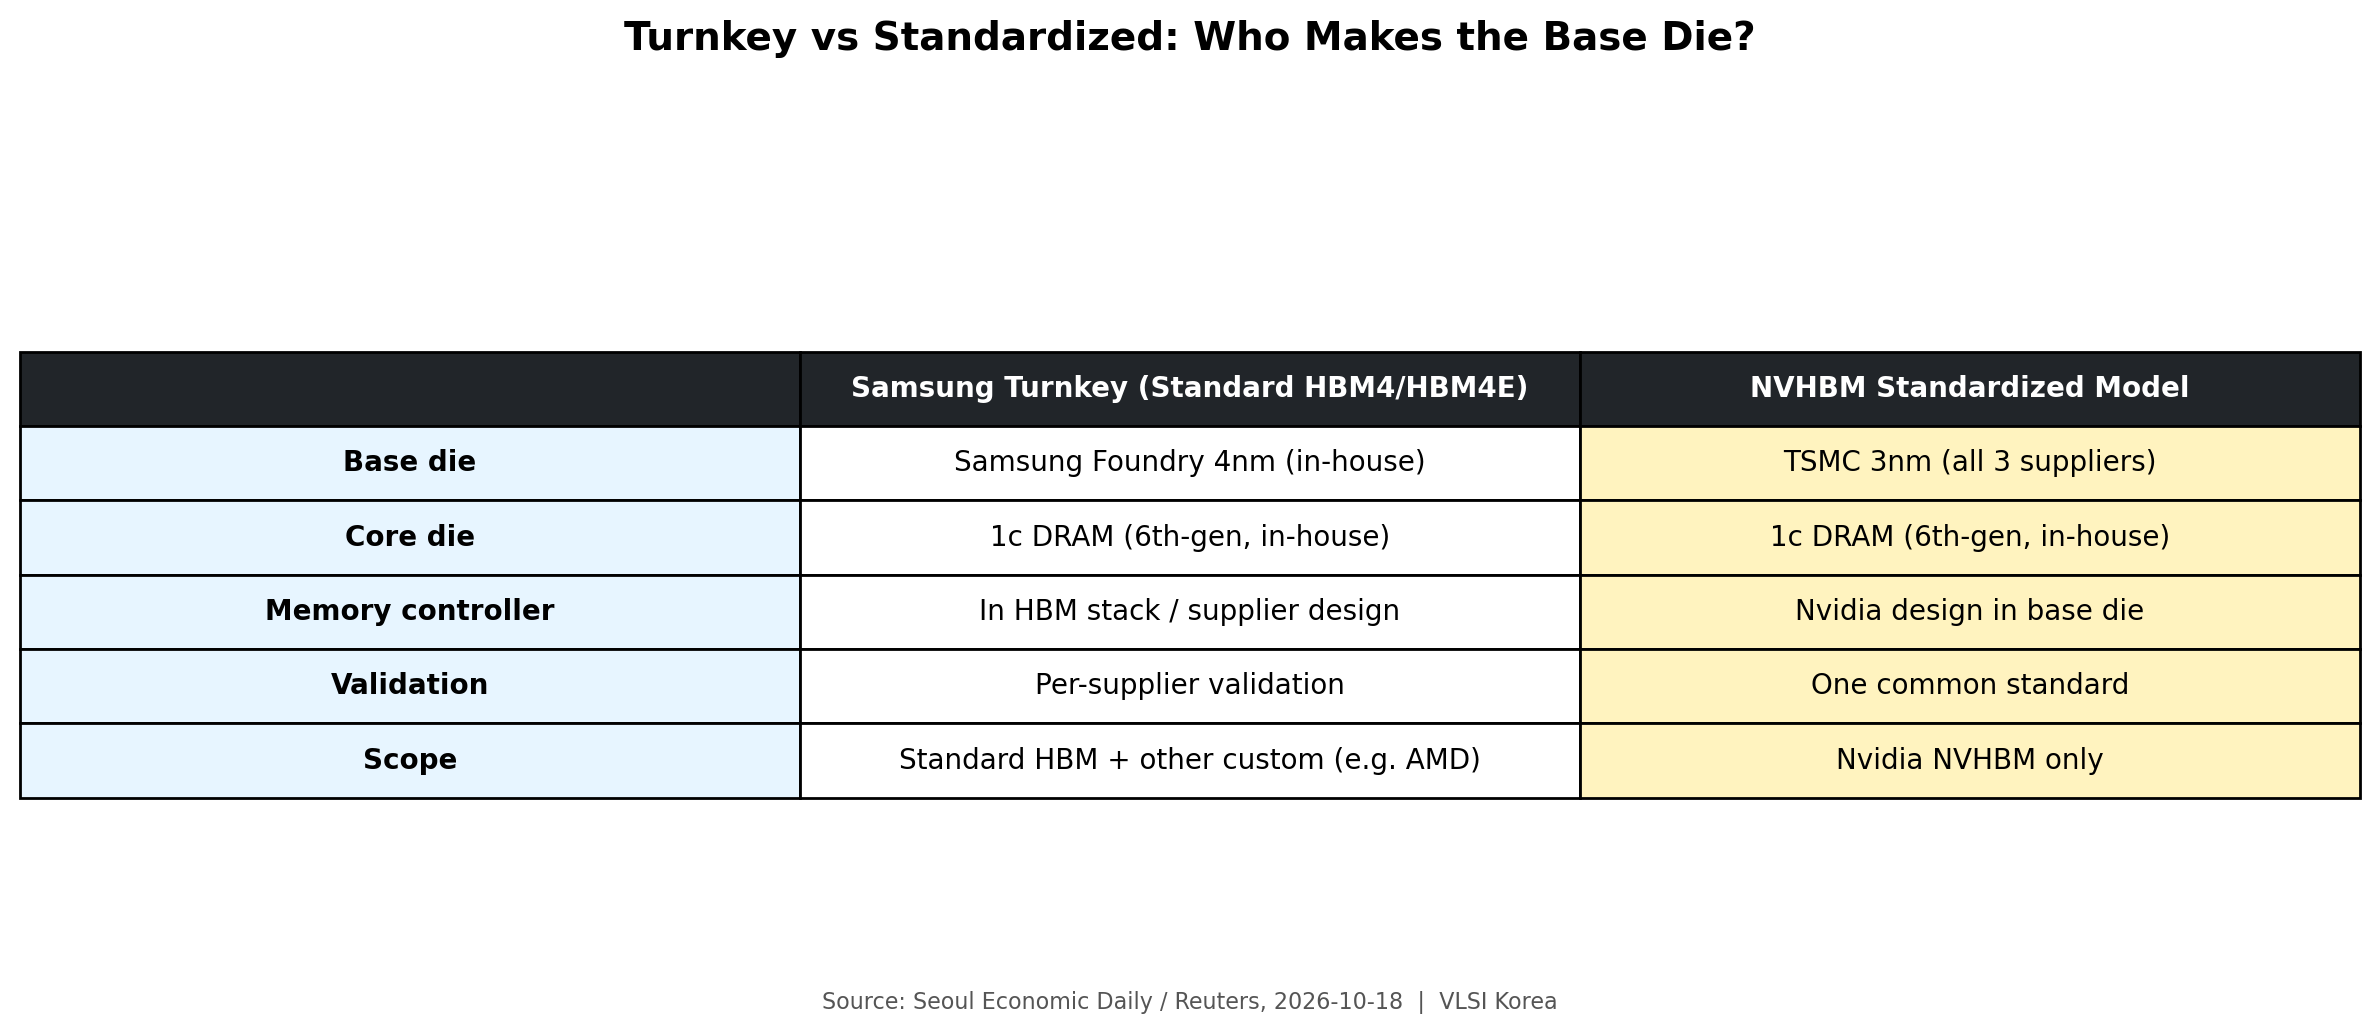
A economia da padronização
A padronização costuma ser contada como a história do lado fraco que cede. Esse enquadramento falha aqui por três razões.
Primeiro, a exigência é simétrica. SK hynix e Micron receberam o mesmo pedido. A SK hynix já trabalhava com a TSMC em base dies, então o custo de ajuste recai de forma desigual — mas a regra em si é política de plataforma, não um veredito sobre o 4nm da Samsung.
Segundo, o que a Samsung cede é mais estreito do que parece. O base die é um único die num stack de 12 ou mais core dies. O core die — a DRAM de verdade, onde vivem a tecnologia de processo, o aprendizado de yield e a capacidade da Samsung — permanece interno, em 1c. O que vai para a TSMC é apenas um pedido de wafers lógicos para a camada base do produto personalizado da Nvidia.
Terceiro, o que a Samsung compra é participação. A NVHBM é o roteiro de HBM personalizada da Nvidia. Estar dentro — mesmo em termos padronizados — supera ser o fornecedor que se agarrou à pureza turnkey e foi excluído do projeto. Nos mercados de plataforma, o padrão é o mercado.
Make-versus-buy, invertido
A clássica pergunta make-versus-buy é feita pelo fabricante. Aqui, quem a faz é o cliente. A Nvidia está desagregando o stack de HBM: padroniza a camada onde vive a sua própria IP (o base die) e comoditiza a interface entre fornecedores, enquanto mantém competitiva a camada onde os fornecedores realmente se diferenciam (yield e custo do core die DRAM).
Isso é governança da cadeia de suprimentos, não compras. A Nvidia reduz o seu próprio custo de validação, comprime a variância de desempenho entre fornecedores e aumenta o seu poder de troca. Os fornecedores, em troca, ganham um mercado de HBM personalizada maior e mais previsível, e um padrão compartilhado para planejar capacidade.
A opção de fonte reserva da Samsung
A reportagem acrescenta um detalhe: a Samsung avalia a sua própria foundry como fonte reserva caso a capacidade da TSMC fique escassa. Não é desafio — é linguagem de seguro, e funciona nos dois sentidos: diz à Nvidia que o fornecimento está protegido, e mantém a Samsung Foundry na conversa para a próxima geração — que é onde está a verdadeira pergunta da Samsung: não se a TSMC fabrica este base die, mas se a Samsung pode recuperar a liderança de projeto do base die na geração seguinte.
A visão de Chase
A manchete se escreve sozinha como «Samsung perde para a TSMC». Essa é a história errada.
No momento em que o controlador de memória se moveu para o base die, o base die deixou de ser um componente de memória e tornou-se um produto lógico projetado pelo cliente. Produtos lógicos são fabricados onde o ecossistema de projeto, a maturidade do PDK e o fluxo de verificação do cliente são mais fortes. A Nvidia nunca executaria três fluxos lógicos diferentes para um único projeto de controlador. A padronização estava sobredeterminada desde o dia em que a NVHBM foi anunciada, em agosto.
Portanto, o modelo turnkey não está rachar: está sendo delimitado. O turnkey sobrevive exatamente onde o fornecedor continua dono do projeto — HBM4 e HBM4E padrão, e programas personalizados para clientes como a AMD, que não impõem um base die comum. Termina onde a IP do cliente assume o stack. Esse limite — não um pedido específico de wafers — é o fato duradouro desta história.
Para a Samsung, a pergunta estratégica é geracional. Nesta rodada, o base die é TSMC 3nm e o projeto é da Nvidia. Na próxima, a Samsung Foundry pode oferecer um pacote de base die — processo, suporte à integração do controlador, codesign de HBM — atraente o suficiente para que um cliente o escolha voluntariamente? É uma disputa de liderança de projeto, não de capacidade.
E uma nota sobre simetria: como SK hynix e Micron enfrentam a mesma exigência, «só a Samsung cedeu» é factualmente incorreto. Os três fabricantes de memória acabam de aprender a mesma lição: na era da HBM personalizada, o cliente é dono do padrão.
Implicações
- Para a Nvidia: um padrão de validação para três fornecedores reduz o custo de qualificação e a variância, e aumenta o poder de troca. Os números declarados da NVHBM (+30% de largura de banda, −15% de energia, +25% de área XPU) tornam-se a linha de base da plataforma.
- Para a Samsung: uma saída modesta de wafers lógicos num programa personalizado, em troca de permanecer no roteiro de HBM personalizada da Nvidia com o seu core die 1c, empilhamento e capacidade intactos.
- Para SK hynix e Micron: aplica-se o mesmo padrão. O trabalho anterior da SK hynix com a TSMC em base dies reduz o seu custo de ajuste; a Micron deve alinhar o seu fornecimento de base die ao mesmo padrão de 3nm.
- Para a TSMC: o base die do produto de memória mais estratégico da era da IA torna-se um pedido lógico de 3nm — wafers pequenos, posição estratégica desproporcional.
- Para investidores: o sinal a acompanhar não é este pedido, mas o próximo: se algum cliente especificar voluntariamente um base die fabricado pela Samsung na geração seguinte, e se os volumes da NVHBM escalarem como declarado. Nenhum dos três fabricantes comentou oficialmente; a reportagem de 18 de outubro deve ser tratada como relatada, não confirmada.
Fontes: Seoul Economic Daily, 2026-10-18; Channel News Asia / Reuters, 2026-10. Este artigo é uma análise, não aconselhamento de investimento. Os números atribuídos à Nvidia são os declarados pela empresa; os três fabricantes de memória não haviam comentado oficialmente até a publicação.
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.


