 VLSI Korea
Tensordyne em profundidade: o chip de inferência LNS que transforma multiplicação em adição e o que é, na realidade, o preço de $1.000 milhões
O chip Napier da Tensordyne aposta na matemática LNS para refazer o custo da inferência. Os $176M captados confirmam-se, mas a avaliação de ~$1.000M assenta numa estimativa secundária e no próprio número da empresa.


Resumo em 30 segundos
A Tensordyne é uma startup de chips de IA com sede nos Estados Unidos e na Alemanha que aposta num sistema numérico logarítmico (LNS, Logarithmic Number System) — transformar multiplicação em adição — para reduzir o custo da inferência de IA. Fundada em 2017 como Recogni para produzir chips de visão para o setor automóvel, mudou o nome para Tensordyne em setembro de 2025 e pivotou para a inferência em data centers. O seu primeiro chip para data centers, Napier (TDN), anunciado a 15 de junho de 2026, concluiu o tape-out no processo de 3 nm da TSMC e está em fabricação de wafers. Nas suas próprias simulações, a empresa afirma 13 vezes mais débito (tokens per second) e 17 vezes mais eficiência energética (tokens per watt) do que um rack Nvidia GB300 NVL72. O financiamento acumulado, de cerca de 176 milhões de dólares (cerca de 246,4 mil milhões de wones, a 1.400 wones por dólar), está confirmado por várias fontes. A avaliação de cerca de 1.000 milhões de dólares é outra questão: não é um valor post-money divulgado em nenhuma ronda primária. Assenta numa estimativa de uma plataforma de mercado secundário (cerca de 992 milhões de dólares) combinada com a própria estimativa da empresa, e não foi verificada de forma independente. A pergunta central deste artigo é uma só: como se deve ler o preço de uma empresa com tão pouca informação verificada?
Background — Da visão automóvel à inferência em data centers
A Tensordyne nasceu em setembro de 2017 como Recogni. Os seus cofundadores são R.K. Anand (Chief Product Officer) e Gilles Backhus (Head of AI), com Emily Stuart também registada como cofundadora. Anand construiu a carreira na Sun Microsystems e na Juniper Networks; Backhus, formado pela Universidade Técnica de Munique, investigou comunicações sem fios full-duplex em Stanford. O denominador comum de ambos é o processamento de sinais e as comunicações — um fio que reaparece no desenho da sua rede em chip baseada em células (NoC) e no tecido de baixa latência.
A Recogni original visava chips de inferência de visão para veículos autónomos. Em dezembro de 2020 apresentou o Scorpio, um produto de inferência de visão da classe 1 PFLOP, com menos de 25 W e menos de 10 ms de latência. Mas o silício automóvel tem ciclos longos de desenho até à receita e volumes incomparáveis aos dos data centers. Coincidindo com a chegada do CEO Marc Bolitho, antigo executivo da ZF Group que entrou em julho de 2022, a empresa começou a deslocar o seu centro de gravidade para a inferência de IA generativa.
O histórico de financiamento está comparativamente bem documentado. Depois de uma Série A de 25 milhões de dólares em 2019 e de uma Série B de 48,9 milhões em 2021, a 20 de fevereiro de 2024 fechou uma Série C de 102 milhões, coliderada pela Celesta Capital e pela GreatPoint Ventures, com os investidores existentes Mayfield, DNS Capital e BMW i Ventures, os novos Pledge Ventures e Tasaru Mobility Investments — filial do fundo soberano saudita PIF — e dívida do HSBC Innovation Banking. A empresa não divulgou avaliação na Série C. Nas bases de dados constam rondas de extensão posteriores sem valores divulgados. Em setembro de 2025 passou a chamar-se Tensordyne, em junho de 2026 apresentou o Napier e diz estar a preparar uma Série D. A sede fica em Sunnyvale, Califórnia (antes indicada como San Jose), com escritório em Munique, e o quadro de pessoal é estimado em cerca de 120 a 150 pessoas.
Um aviso enquadra tudo o que se segue. Quase tudo o que é público sobre esta empresa vem de anúncios da própria companhia, de um whitepaper próprio e de entrevistas com os seus executivos. Em outubro de 2026, não existe no registo público nenhum benchmark independente, nenhum caso de cliente em produção com nome nem qualquer valor de receita auditado. Todos os números de desempenho deste artigo devem ser lidos sob essa premissa.
Business Deep Dive — A substância da aposta LNS
A ideia central: a multiplicação torna-se adição
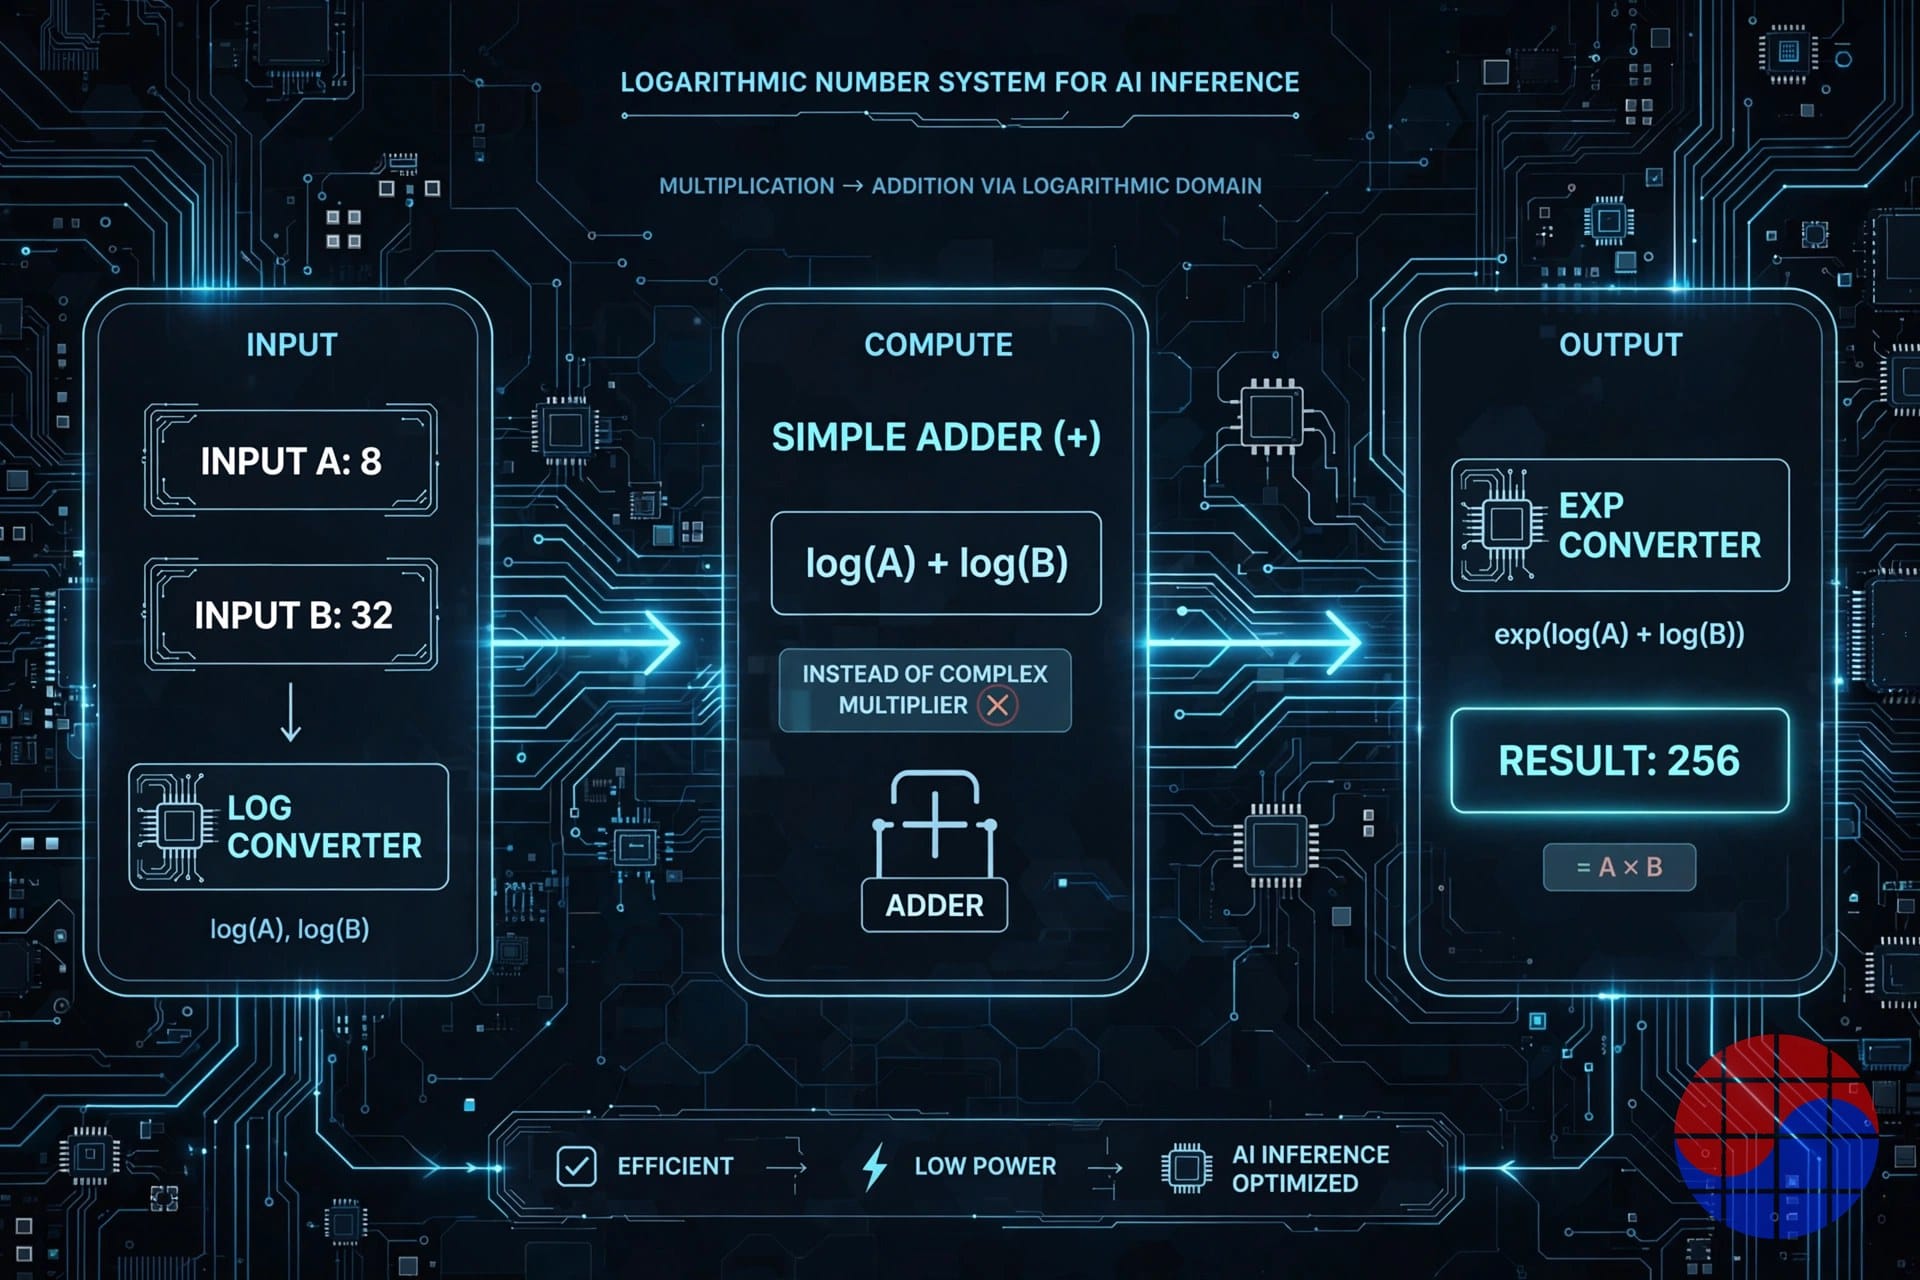
A inferência de redes neuronais é dominada pela multiplicação de matrizes, ou seja, operações multiply-accumulate sem fim. Um multiplicador de vírgula flutuante custa muito mais área de silício e energia do que um somador. O LNS contorna isso: como log(A×B) = log(A) + log(B), basta converter os números uma vez para o domínio logarítmico para a multiplicação se transformar em adição. É o mesmo princípio das tábuas de logaritmos que John Napier publicou em 1614 para facilitar os cálculos astronómicos, e o nome do chip homenageia-o. A Tensordyne chama a este ganho a «zeroth scaling law», um benefício que fica por baixo de qualquer outra decisão de desenho.
Os números ao nível do circuito apresentados pela empresa são impressionantes: onde uma multiplicação convencional em vírgula flutuante de 16 bits custa cerca de 1,1 pJ e 1.640 µm², a sua versão logarítmica faria o mesmo trabalho com cerca de 0,05 pJ e 67 µm² — cerca de 22 vezes menos energia e 25 vezes menos área. Ao nível do sistema, porém, os ganhos alegados encolhem para cerca de 3 vezes em área de computação e 5 vezes em potência de computação, segundo o próprio resumo do seu whitepaper. Essa distância entre a matemática do circuito e a do sistema é a primeira pista para ler esta aposta: o multiplicador não é o único estrangulamento.
Porque é que o LNS não se impôs em quatro décadas
O LNS não é novo. Foi estudado durante décadas sem nunca ser produzido em hardware dedicado, por três razões. Primeiro, a adição no domínio logarítmico é difícil: acumular os resultados das multiplicações exige uma função de aproximação dispendiosa (o logaritmo gaussiano). Segundo, a conversão entre os domínios linear e logarítmico custa tempo e precisão, sobretudo perto de zero e ao acumular muitos valores pequenos. Terceiro, grande parte da inferência está limitada pela memória (memory-bound) e não pela computação: baratear a multiplicação não resolve o custo de ir buscar dados à HBM.
A alegação de propriedade intelectual da Tensordyne situa-se exatamente no primeiro ponto. O seu sistema numérico proprietário, Pareto (TDN Math), basear-se-ia numa aproximação eficiente da adição em domínio logarítmico e na sua implementação em hardware. A empresa diz que os modelos correm sem novo treino nem calibração, e que validou a precisão através de emulação bit-accurate em modelos de linguagem, mixture-of-experts, imagem, áudio e vídeo, com uma pilha de software que esconde a conversão e suporta PyTorch e Triton. Se for verdade, a maior barreira histórica terá sido ultrapassada. Mas a evidência até agora é emulação interna, não silício medido.
O chip Napier e o sistema TDN72
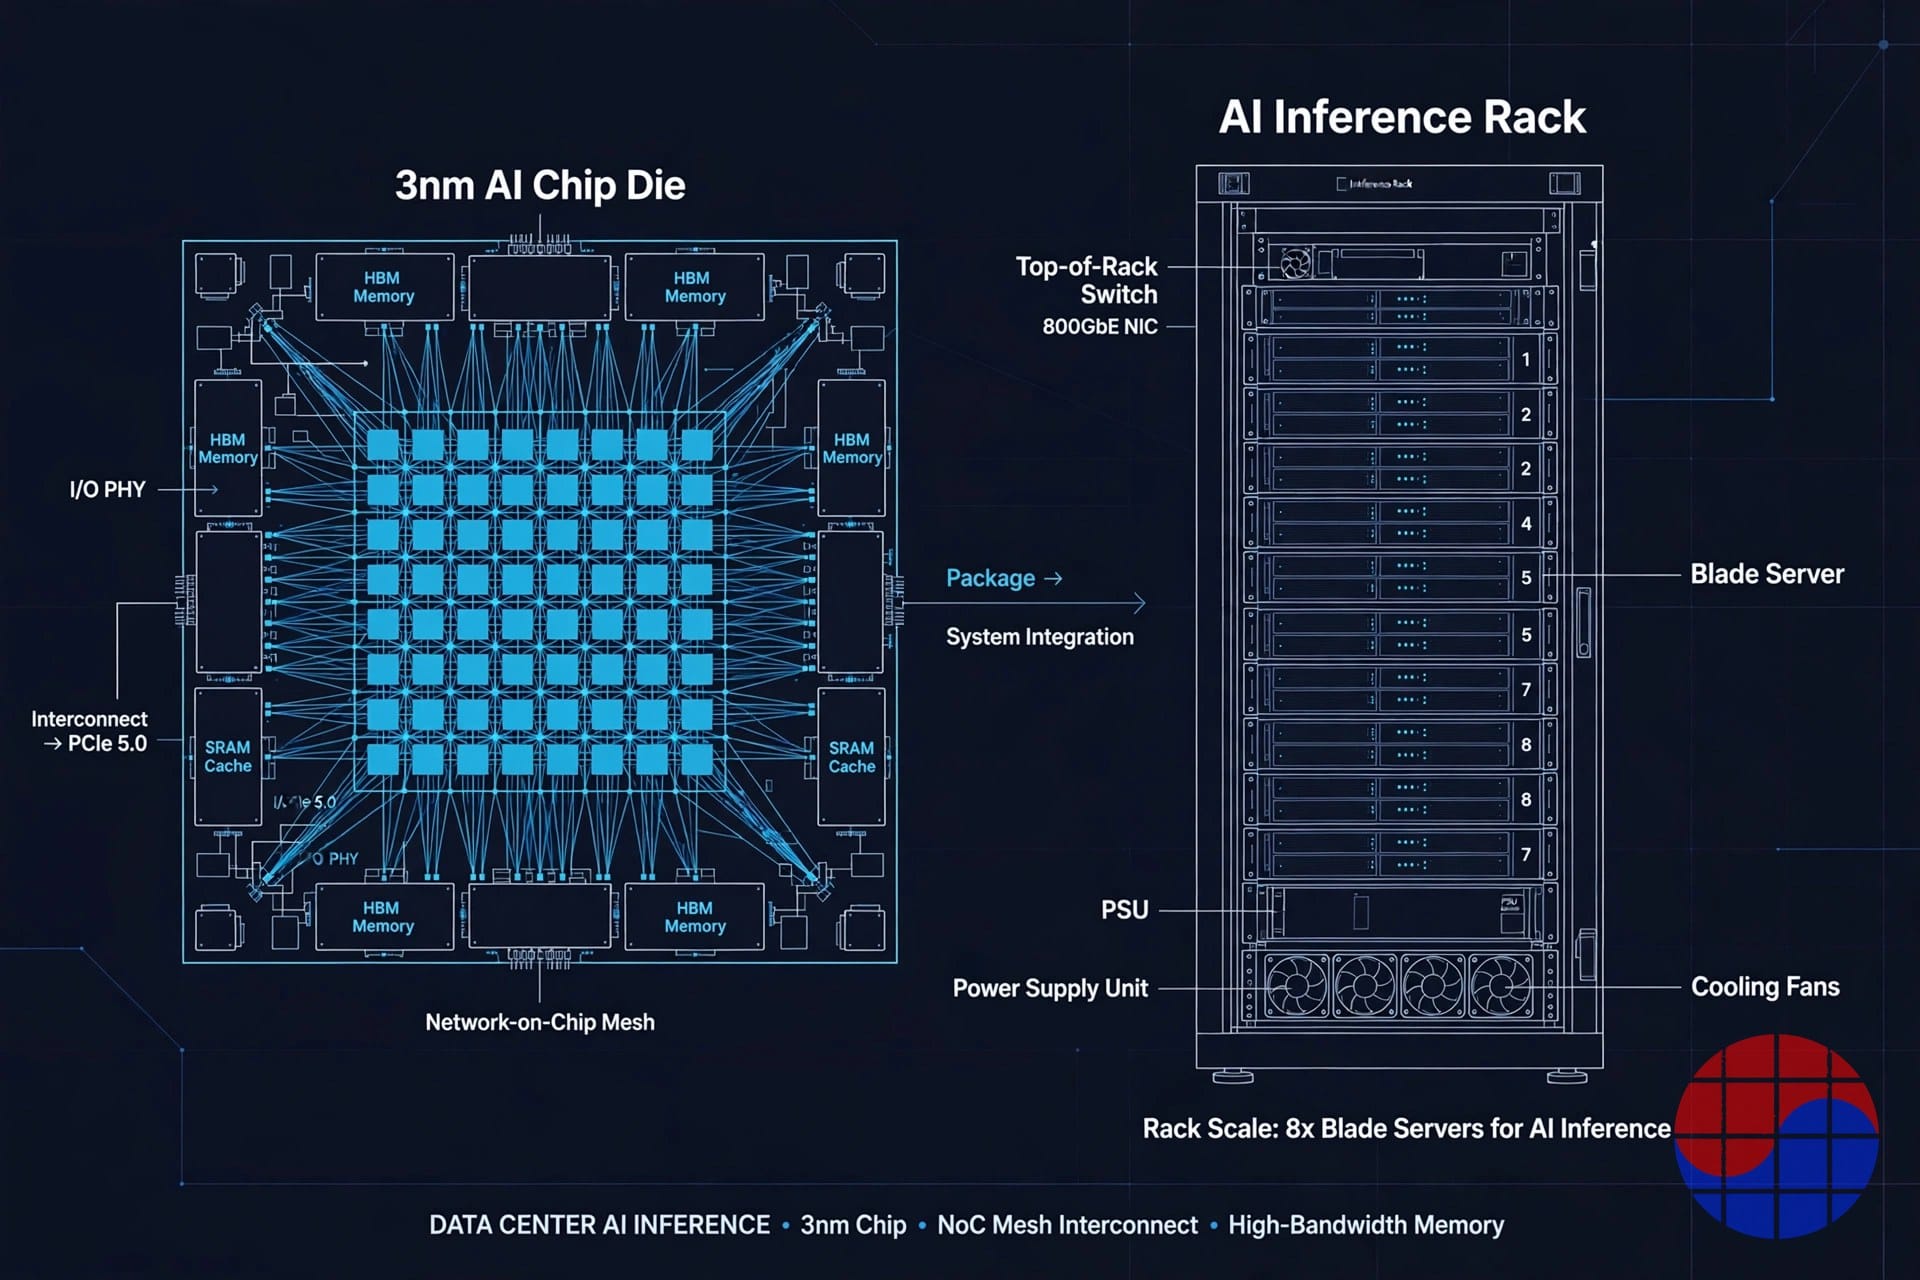
As especificações de hardware verificáveis são as seguintes. O processador Napier (TDN AIP) é fabricado em 3 nm da TSMC, com 138 mil milhões de transístores, 300 W por pacote, 2,11 PFLOPS de computação densa FP8, 256 MB de SRAM e 144 GB de HBM3e. Tem 48 núcleos de computação, com núcleos RISC-V a tratar de tarefas dentro do ciclo, como o encaminhamento MoE. O tecido de expansão TDN LINK afirma latência de um único salto inferior a 1 µs e agrupa 72 chips num pod.
| Item | Napier (valores da empresa) |
|---|---|
| Processo | TSMC 3 nm, tape-out concluído, em fabricação |
| Computação | 2,11 PFLOPS FP8 denso, 300 W |
| Memória | 144 GB HBM3e, 256 MB SRAM |
| Pod TDN72 (72 chips) | 30 kW, arrefecimento a ar, 10,4 TB HBM |
| Rack completo (4 pods, 288 chips) | 608 PFLOPS FP8, 42 TB HBM, 120 kW, arrefecimento a ar |
A lista de parceiros é um dos poucos sinais duros da empresa. A Broadcom codesenhou o silício, a TSMC fabrica-o e a HPE Juniper fornece o chassis de expansão e o tecido; a Juniper é também investidora. Um tape-out em 3 nm custa dezenas de milhões de dólares e exige passar a diligência de um parceiro ASIC como a Broadcom: uma evidência indireta, mas real, da capacidade e do financiamento para construir silício a sério.
As alegações de desempenho, e o que elas são
A alegação principal, numa carga DeepSeek-R1, é de 363.000 tokens por segundo por rack contra 27.400 de um rack Nvidia GB300 NVL72: 13 vezes mais. Por megawatt, a empresa cita 3 milhões de tokens por segundo contra 183.000: 17 vezes mais. Num modelo MoE de 2 biliões de parâmetros, diz que um dos seus racks faz o trabalho de uma combinação concorrente de nove racks, entregando 1.300 tokens por segundo por utilizador a cerca de 11 dólares por milhão de tokens, contra cerca de 150. Todos estes números vêm de modelação e simulação da empresa. Parte das referências foi retirada de dados públicos de benchmark, mas não existe qualquer resultado medido do silício da Tensordyne. Os chips mal saíram da fábrica: promete-se uma nuvem de desenvolvimento para o final de 2026, sistemas beta para o primeiro trimestre de 2027 e envios de produção para a segunda metade de 2027 (algumas fontes dizem o segundo trimestre).
Sinais de clientes: uma LOI não é receita
O sinal comercial resume-se a «mais de 200 milhões de dólares de procura prevista». A empresa afirma que mais de uma dúzia de empresas assinaram cartas de intenção (LOI) para avaliar sistemas beta, e dois fornecedores de infraestrutura foram nomeados como interessados. Contudo, uma LOI não é uma ordem de compra vinculativa, e não foi divulgado qualquer cliente de produção pagante nem valor de receita. Historicamente, a conversão de LOI em receita nas startups de chips de IA é baixa. Este sinal deve ler-se como interesse, não como procura confirmada.
Chase's Take — Porque é que o mercado lhe põe este preço?
De onde vem, então, «cerca de 1.000 milhões de dólares»? A verificação cruzada mostra que não é um preço fixado por uma nova ronda de investimento. A empresa não divulgou avaliação nem mesmo na sua grande Série C de fevereiro de 2024. O número público mais próximo é a avaliação implícita de uma plataforma de negociação secundária, de cerca de 992 milhões de dólares em outubro de 2026. Uma estimativa de mercado secundário é um preço de referência derivado de poucas transações e cotações — não um preço que um investidor institucional tenha assinado após diligência. Somando a própria estimativa da empresa, divulgada antes de uma Série D, obtém-se «about $1B». Distinguir estes dois tipos de números tão diferentes é o ponto de partida para ler esta companhia.
Em wones, são cerca de 1,4 biliões de wones (a 1.400 wones por dólar), cerca de 5,7 vezes os aproximadamente 246,4 mil milhões de wones captados. Para uma empresa em fase pré-receita ou próxima dela sustentar esse preço, o mercado está de facto a apostar em três coisas ao mesmo tempo: que a barreira de precisão do LNS foi mesmo ultrapassada; que mesmo metade da vantagem simulada, se medida, muda a estrutura de custos da inferência; e que, à data de envio de 2027, o mercado de inferência será muito maior, com a energia como critério central de compra. Se qualquer uma das três falhar, o preço será reajustado depressa.
Para ser justo, a aposta não é desprovida de base. A energia e o arrefecimento representam de facto uma fatia crescente do custo de inferência, e um rack de 120 kW arrefecido a ar é um atrativo real para data centers existentes que enfrentam adaptações dispendiosas para arrefecimento líquido. A combinação Broadcom–TSMC–HPE Juniper não é o que uma empresa de papel monta. O lado fraco é igualmente claro: desempenho por medir, uma fase comercial sem receita e um incumbente que não fica parado. Quando o Napier for enviado no final de 2027, o rack concorrente também terá avançado uma geração. O fosso de 13 vezes é menos «o rack de amanhã contra o de hoje» do que «o nosso rack futuro contra o seu rack atual».
A minha leitura: a Tensordyne aposta que mudar o sistema numérico muda a inclinação do próprio custo de inferência — uma aposta que, se verificada, reconfigura a estrutura da indústria. Mas, em outubro de 2026, a evidência dessa aposta é simulação, não silício. Por isso, o seu preço deve ler-se como preço de opção, não como preço de tecnologia: um ativo próximo do binário, cujo valor subirá ou descerá em degrau assim que chegarem dados medidos. Não há razão para tomar os 1.000 milhões pelo valor facial, nem base para os descartar como invenção. É um preço de referência a manter enquanto se esperam duas coisas: quanto é que as instituições assinam de facto na Série D e o que é que terceiros medem quando a nuvem de desenvolvimento abrir no final de 2026.
Implications — O que vigiar
Para investidores: três pontos de controlo. (1) A avaliação post-money real da Série D e quem a lidera. (2) Medições independentes da nuvem de desenvolvimento do final de 2026, sobretudo tokens per watt e se a precisão dos modelos se mantém. (3) Se as LOI se convertem em betas pagos e contratos de produção. Até isso acontecer, os 1.000 milhões são uma expetativa que o mercado pôs em preço, não um valor verificado.
Para a indústria: seja qual for o destino da Tensordyne, a pergunta que levanta sobrevive. O facto de uma tentativa de abalar uma convenção de vírgula flutuante com 40 anos ao nível do sistema numérico ter chegado a um tape-out em 3 nm com parceiros de topo mostra que o eixo da concorrência na inferência se desloca de «uma GPU maior» para «um token mais barato». A disputa pelos formatos numéricos e pela quantização continuará com ou sem LNS.
Para os semicondutores coreanos: cada chip Napier leva 144 GB de HBM3e; um rack completo, 42 TB. Se ASIC só de inferência como este começarem a ser enviados em volume, a procura de HBM alargar-se-á de uma única base de clientes GPU para muitos fornecedores de ASIC — uma oportunidade de diversificação de clientes e, ao mesmo tempo, um encargo, porque cada ASIC traz a sua própria especificação de memória e o seu processo de qualificação.
Nota sobre os limites das fontes: a informação da empresa neste artigo foi cruzada com anúncios públicos da companhia, resumos do seu whitepaper, entrevistas na imprensa e bases de dados de transações disponíveis a 19 de outubro de 2026. Todos os valores de desempenho são alegações da empresa e não foram verificados de forma independente; a avaliação não é um valor divulgado de uma ronda primária. Valores de receita, clientes e encomendas que não puderam ser confirmados foram omitidos.
FAQ
A avaliação de 1.000 milhões de dólares da Tensordyne é um valor confirmado?
Não. A empresa nunca divulgou uma avaliação em nenhuma ronda, incluindo a Série C de 2024. Os cerca de 1.000 milhões assentam na estimativa de uma plataforma de negociação secundária (cerca de 992 milhões de dólares, outubro de 2026) e na própria estimativa da empresa. É um tipo de número diferente de uma avaliação post-money fixada por investidores institucionais numa ronda primária. A divulgação da Série D é o evento que a pode confirmar ou reajustar.
Porque é que o LNS só agora chega ao silício?
O princípio é antigo, mas a adição em domínio logarítmico e a precisão de conversão eram as barreiras. A multiplicação torna-se adição barata, mas acumular os produtos e lidar com valores próximos de zero continuou caro e impreciso. A Tensordyne afirma que a aproximação do seu sistema numérico Pareto ultrapassa essa barreira — mas a evidência é emulação interna e os resultados medidos em silício ainda não foram publicados.
As alegações de desempenho de 13 e 17 vezes são fiáveis?
Por agora devem ser tratadas estritamente como resultados de simulação da empresa. Ambas as cifras vêm de modelação própria sobre uma carga DeepSeek-R1 e, com os chips ainda em fabricação, não existe medição independente. Os dados de terceiros da nuvem de desenvolvimento prometida para o final de 2026 são o primeiro ponto de controlo real.
Quando poderão comprar-se os sistemas da Tensordyne?
No calendário da empresa: nuvem de desenvolvimento no final de 2026, sistemas beta no primeiro trimestre de 2027 e envios de produção na segunda metade de 2027. A evidência comercial até agora limita-se às declarações da empresa de mais de 12 LOI de avaliação e mais de 200 milhões de dólares de procura prevista; nenhum contrato de produção vinculativo nem receita foram divulgados.
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.


