 VLSI Korea
Unconventional AI em profundidade: como uma startup sem chip atingiu avaliação de US$ 4,5 bilhões
Dois meses após a fundação, sem chip e sem receita, a Unconventional AI captou US$ 475 milhões com avaliação reportada de US$ 4,5 bilhões. Os investidores precificaram um fundador, uma equipe e uma opção sobre a computação baseada em física — não um produto. Desmontamos esse preço.


Resumo em 30 segundos
- A Unconventional AI anunciou em 8 de dezembro de 2025 que havia fechado uma rodada seed de US$ 475 milhões com uma avaliação reportada de US$ 4,5 bilhões — cerca de dois meses após a fundação da empresa, sem chip, sem produto e sem receita. A 1.400 wons por dólar, US$ 4,5 bilhões são cerca de 6,3 trilhões de wons, e a rodada de US$ 475 milhões, cerca de 665 bilhões de wons.
- A rodada foi coliderada por Andreessen Horowitz e Lightspeed Venture Partners, com participação de Lux Capital, DCVC, Databricks e Jeff Bezos. O CEO Naveen Rao investiu US$ 10 milhões do próprio dinheiro nos mesmos termos. Os US$ 475 milhões são a primeira parte de uma captação planejada de até US$ 1 bilhão.
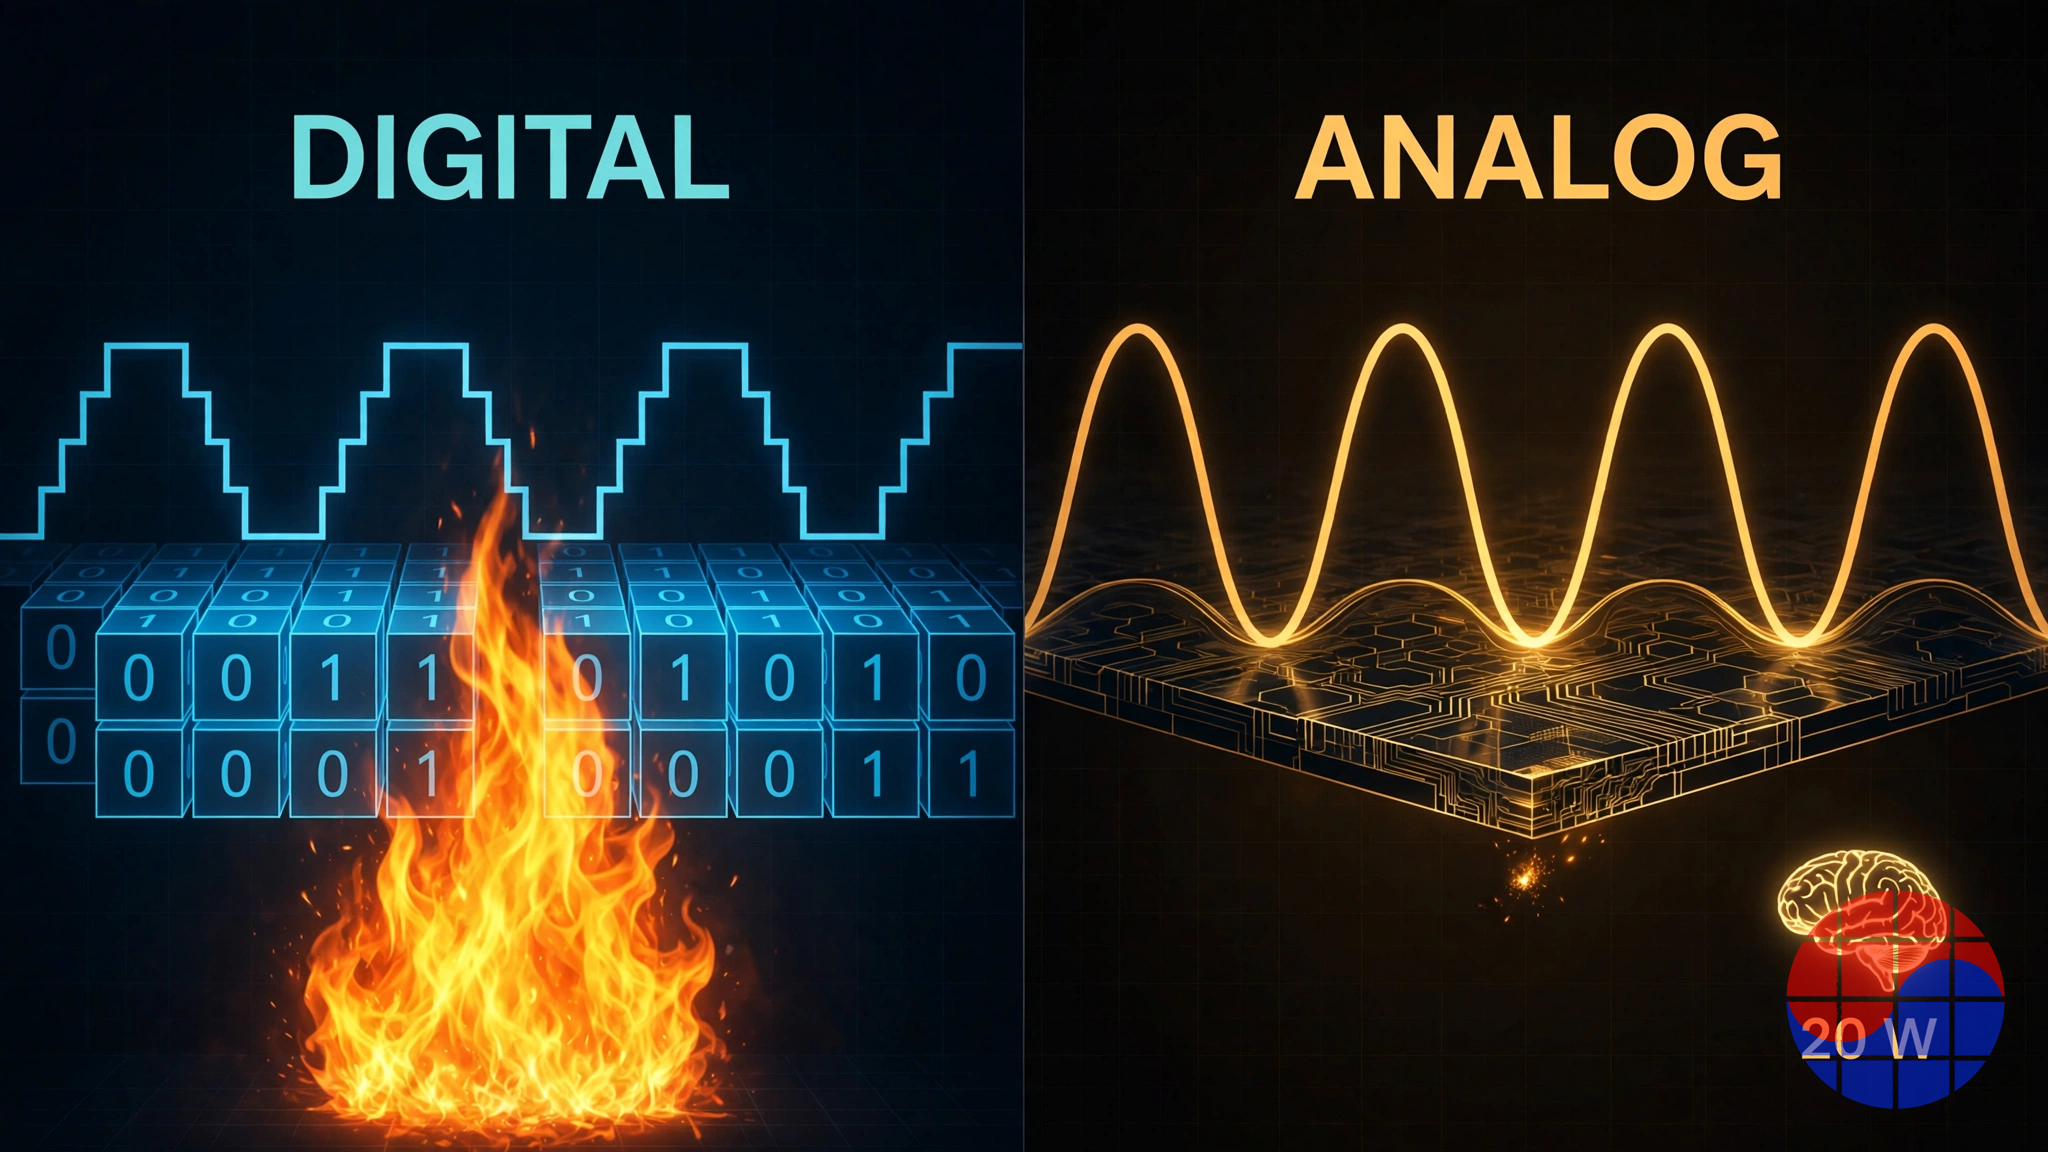
- A empresa constrói um computador analógico, baseado em física, para IA: em vez de simular redes neurais em chips digitais, quer que a física do silício — um tecido de osciladores acoplados (coupled oscillators) — faça a computação diretamente, mirando cerca de 1.000 vezes menos energia do que o hardware atual. O ponto de referência é o cérebro humano, que funciona com cerca de 20 watts.
- O que existe hoje é uma simulação, não silício. Seu primeiro modelo, Un-0 (junho de 2026), gera imagens com um sistema simulado de osciladores acoplados e alcança FID de 6,74 no ImageNet 64x64, comparável aos primeiros geradores convencionais. Mas ele foi treinado e executado em GPUs B200 convencionais. Nenhum chip físico foi mostrado.
- O preço de US$ 4,5 bilhões, portanto, não é o preço de um produto. É o preço de um fundador com duas saídas (Nervana para a Intel, MosaicML para a Databricks por US$ 1,3 bilhão), uma equipe fundadora de quatro pessoas que reúne MIT, Stanford e design analógico em produção, e uma opção sobre a possibilidade de que a parede de energia da computação digital force um novo substrato (substrate). Este deep dive desmonta esse preço.
Background: uma rodada seed sem nada para entregar
Rodadas seed normalmente compram um protótipo. A da Unconventional AI comprou um programa de pesquisa — e o avaliou como uma empresa em estágio tardio.
A empresa veio à tona em setembro de 2025, quando Naveen Rao sugeriu no X que estava cofundando uma empresa para construir um computador com "eficiência em escala cerebral". Dois meses depois, em 8 de dezembro de 2025, Rao e seus três cofundadores publicaram o post de lançamento: US$ 475 milhões captados com avaliação de US$ 4,5 bilhões, e a tese de que a indústria de IA está batendo em uma parede de energia que não consegue superar apenas com engenharia sobre chips digitais.
Os quatro fundadores são a primeira linha da avaliação. Rao é o raro fundador que esteve dos dois lados do problema. Formou-se em engenharia elétrica na Duke, trabalhou como arquiteto de computadores na Sun Microsystems e depois deixou a engenharia para fazer um PhD em neurociência computacional na Brown, estudando como o cérebro transforma entrada sensorial em ação com um orçamento de cerca de 20 watts. Trabalhou com computação neuromórfica na Qualcomm e cofundou a Nervana Systems em 2014 para construir hardware de deep learning desenhado em torno da carga de trabalho, e não adaptado de gráficos. A Intel a adquiriu em 2016 por um preço reportado de cerca de US$ 400 milhões, e Rao passou a liderar o grupo de produtos de IA da Intel. Em 2021, cofundou a MosaicML, que barateou o treinamento de modelos grandes; a Databricks a adquiriu em 2023 por US$ 1,3 bilhão, e Rao virou VP de IA da Databricks. Duas saídas, cerca de US$ 1,7 bilhão em valor reportado combinado, ambos construídos sobre a mesma obsessão: o custo da IA é um problema de hardware.
Ao lado dele: Michael Carbin, professor associado do MIT cujo trabalho abrange sistemas de programação e os fundamentos da computação em novos substratos — e, notavelmente, cofundador da MosaicML. Sara Achour, professora assistente de Stanford que trabalha com compiladores e computação de base física. E MeeLan Lee, designer de circuitos analógicos vinda de Google, Qualcomm e Intel — a pessoa da equipe que de fato construiu silício analógico em ambientes de produção. A composição é deliberada: um CEO com saídas repetidas, dois teóricos que trabalham em como software se mapeia para a dinâmica física e uma praticante que sabe onde os designs analógicos morrem.
A formulação do problema é simples e, até agora, empiricamente verdadeira. A capacidade da IA escalou com o cómputo, e o cómputo escalou com a energia. Data centers hoje são planejados em torno da disponibilidade de energia — capacidade de geração, conexões à rede, refrigeração — e não em torno dos chips. Nas palavras de Rao: "A IA está intrinsecamente ligada ao hardware, e o hardware está intrinsecamente ligado à energia. Não podemos escalar além de certo número de inferências por unidade de tempo por causa do problema de energia. Não conseguimos produzir tanta energia adicional nos próximos 10 anos." A empresa afirma que o crescimento da demanda alcançará o crescimento linear da oferta de energia em três a quatro anos. Exato ou não esse calendário, a direção não é controversa: energia por inferência é agora um custo de primeira ordem e uma restrição de primeira ordem.
Sobre esse pano de fundo, a empresa propõe abandonar a abstração que dominou a computação por 80 anos. Computadores digitais representam tudo como números e simulam a dinâmica passo a passo, a um enorme custo de energia. Sistemas naturais de aprendizagem nunca fizeram isso. "Sistemas naturais de aprendizagem nunca usaram numérica", diz Rao. "Eles não simularam a dinâmica da aprendizagem. Eles usam a física intrínseca do substrato em que estão para construir um sistema de aprendizagem. Acreditamos que podemos recapitular esse comportamento em silício."
Business Deep Dive
1. A aritmética do acordo: o que dizem US$ 475 milhões a US$ 4,5 bilhões
Comece pela aritmética, porque a aritmética é a história. Uma rodada primária de US$ 475 milhões com avaliação pós-money de US$ 4,5 bilhões significa que os novos investidores compraram aproximadamente 10,6% da empresa, e que a avaliação pré-money — o preço da ideia, da equipe e de nada mais — foi de cerca de US$ 4,03 bilhões. Para comparar, esse pré-money é aproximadamente o triplo do que a Databricks pagou em 2023 pela MosaicML, uma empresa com produto, clientes e receita.
A estrutura importa tanto quanto o tamanho. Os US$ 475 milhões são, segundo a própria empresa, a primeira parte de uma captação que pode chegar a US$ 1 bilhão — reportagens anteriores diziam que a empresa mirava uma avaliação de US$ 5 bilhões para aquela rodada maior. Uma captação em tranches desse tipo é uma máquina de marcos: o primeiro fechamento precifica a visão, e o segundo fechará o preço sobre o que a visão tiver produzido até lá. Os US$ 10 milhões do próprio Rao, investidos nos mesmos termos das instituições, são pequenos frente a US$ 475 milhões (cerca de 2%), mas simbolicamente estruturais: transformam "o fundador acredita" de frase de pitch em fato de balanço.
O que os investidores realmente subscreveram? Não um fluxo de caixa descontado — não há fluxos de caixa. O que foi subscrito é uma opção ponderada por probabilidade: uma pequena probabilidade de que essa equipe funde o substrato pós-GPU, multiplicada pelo valor de possuir uma fatia significativa do cómputo de IA se conseguir, mais um valor de piso vindo da capacidade demonstrada da equipe de ser adquirida. A seção 6 torna essa opção explícita.
2. A ciência: deixar a física fazer a computação
A aposta técnica tem três camadas.
Camada um: analógico em vez de digital. Um circuito analógico representa quantidades como tensões e correntes contínuas, e não como bits. Para as operações que a IA de fato executa — vastas quantidades de multiply-accumulate, dinâmica e amostragem de distribuições —, um sistema físico muitas vezes pode ser a computação em vez de simulá-la. O exemplo do próprio Rao é o túnel de vento: engenheiros ainda constroem túneis de vento porque um modelo físico do fluxo de ar calcula coisas que a dinâmica de fluidos digital aproxima a alto custo. A afirmação é que uma rede neural está mais perto de um túnel de vento do que de uma planilha: é um sistema dinâmico estocástico e distribuído, e forçá-lo sobre um substrato numérico determinístico e preciso desperdiça a maior parte do orçamento de energia em uma abstração que a carga de trabalho nunca pediu.
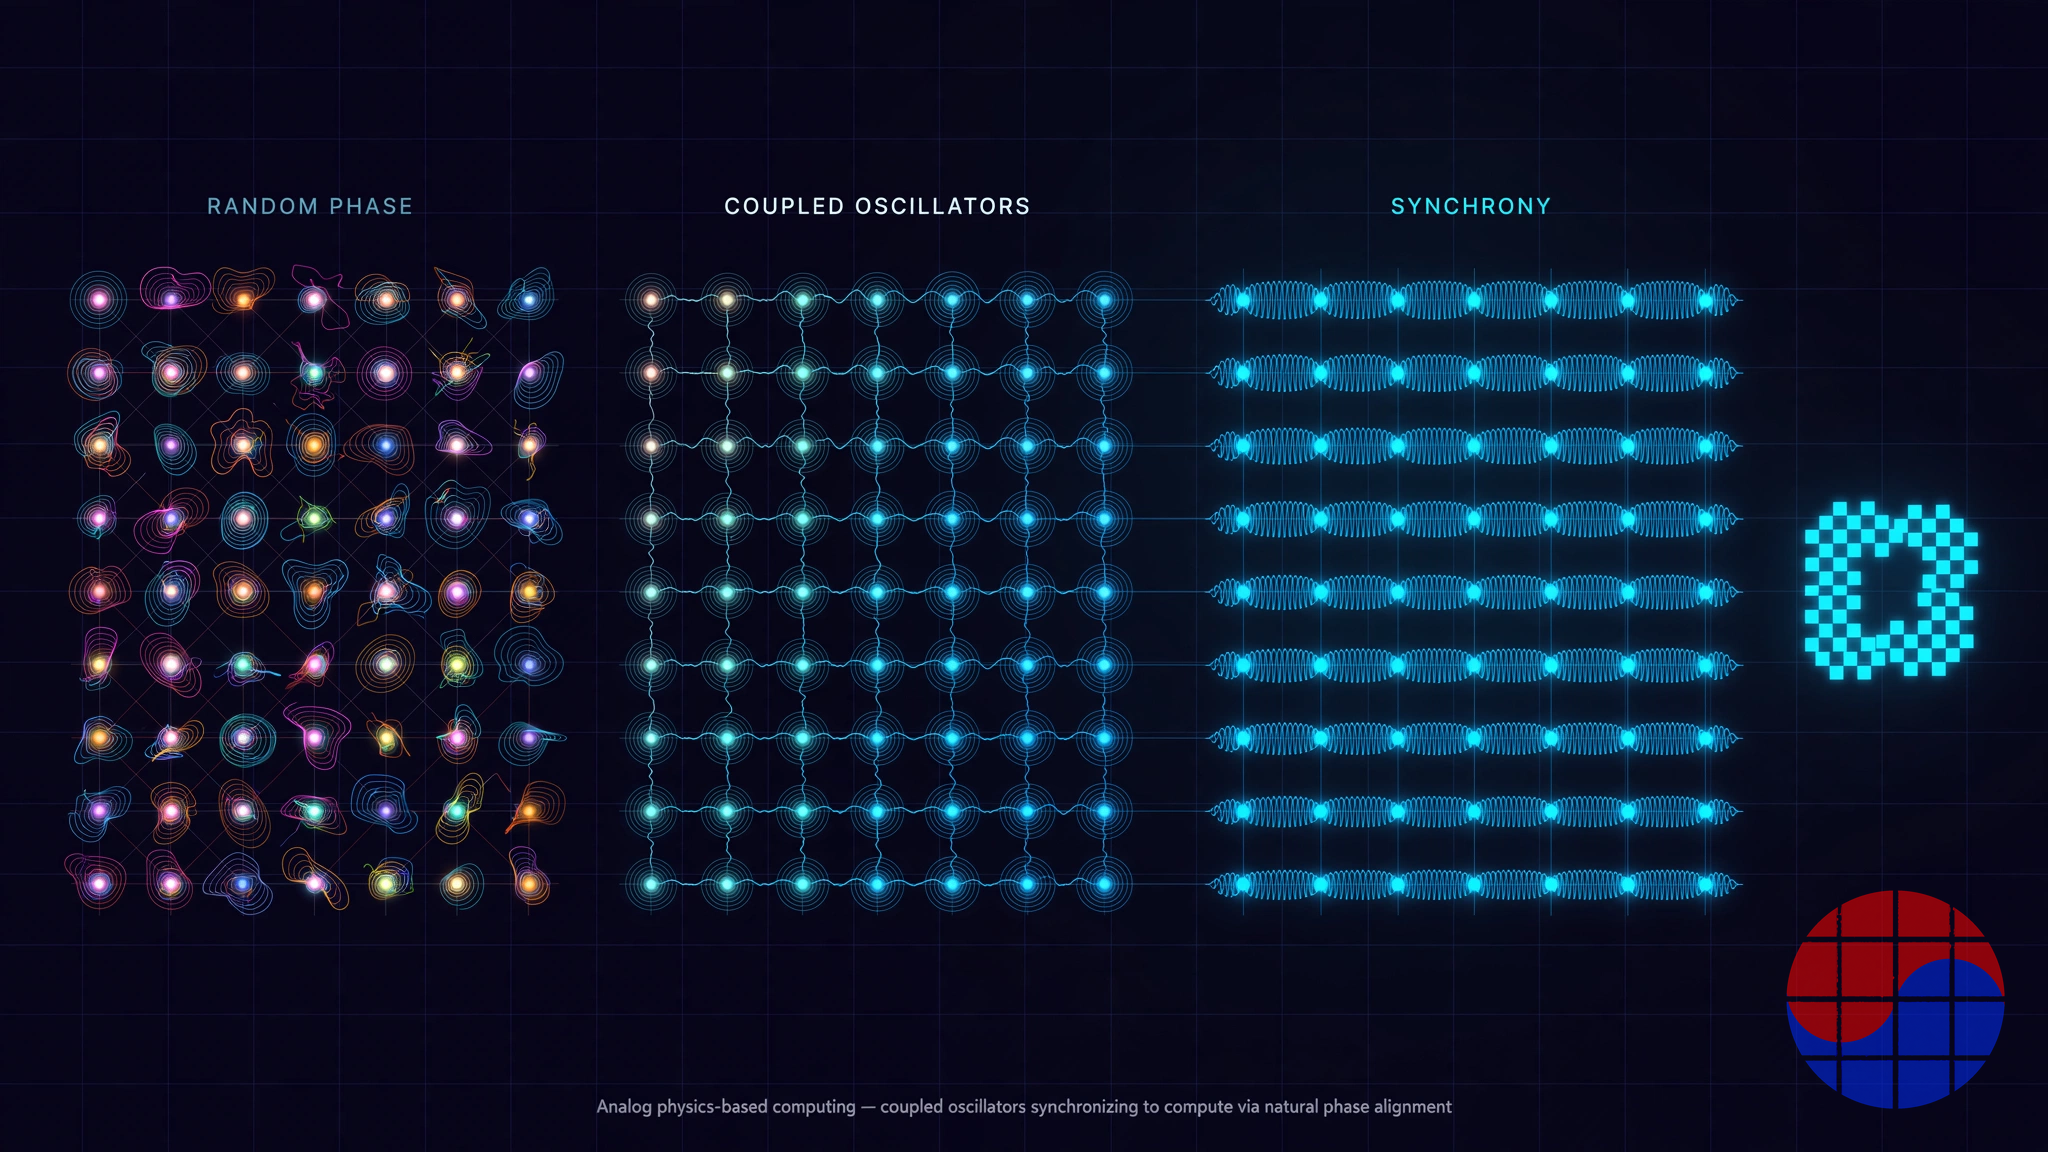
Camada dois: osciladores acoplados como primitiva. O primeiro artefato público da empresa, o Un-0, torna concreta a afirmação abstrata. O Un-0 é um gerador de imagens cujo motor de computação é uma grande população de osciladores acoplados, modelada pelo modelo de Kuramoto — a matemática de como unidades rítmicas (metrônomos sobre uma mesa compartilhada, vaga-lumes, células marca-passo) se puxam mutuamente para a sincronia. Cada oscilador tem uma fase; os parâmetros aprendíveis são as forças de acoplamento entre cada par de osciladores e a frequência natural de cada um. Para gerar uma imagem, o sistema parte de fases aleatórias, um pequeno grupo de osciladores de condicionamento inclina a população para a classe pedida, deixa-se a física evoluir e o padrão final de fases é lido e decodificado em pixels. Aprender significa aprender os acoplamentos — o decodificador responde por menos de 13% dos parâmetros do modelo, e as ablações da empresa indicam que os próprios osciladores fazem computação útil, em vez de decorar um gerador convencional.
Camada três: codesign, ou "coevolução neural". A empresa argumenta que o modelo e o hardware devem ser desenhados juntos: manter a memória fisicamente perto da computação, reutilizar o estado físico ao longo do tempo em vez de recarregar bilhões de parâmetros para cada token, e tratar as imperfeições do hardware como algo que o modelo aprende, em vez de algo que a engenharia deve eliminar. O ruído é o exemplo mais claro. No design digital, o ruído é um inimigo que se paga energia para suprimir. Nesta arquitetura, a IA generativa começa de qualquer forma da aleatoriedade, e uma rede treinada em um substrato específico pode aprender as variações daquele substrato. A energia que chips digitais gastam forçando uniformidade perfeita, nesta narrativa, simplesmente não é gasta.
A meta de eficiência vem da termodinâmica, não de um benchmark: a empresa argumenta que a distância entre onde o hardware digital de IA opera e o que é fisicamente possível é de aproximadamente três ordens de magnitude, daí o número de ~1.000x. É importante ser preciso sobre o status desse número. É uma estimativa de uma lacuna teórica, não uma medição. Não foi demonstrado em hardware, e os resultados do Un-0 — FID de 6,74 no ImageNet 64x64 com 16.384 osciladores e 322 milhões de parâmetros, na faixa dos primeiros geradores convencionais quando surgiram — validam a afirmação da aprendizagem (um sistema dinâmico físico pode ser treinado para fazer uma tarefa generativa real em escala moderada), não a da eficiência, porque o próprio Un-0 rodou em GPUs B200.
3. O que existe hoje: uma simulação, um rastro de papel e um relógio de cinco anos
No marco público mais recente da empresa, o inventário é curto. Há um post de lançamento e um blog técnico com os pesos, o código de treinamento e o código de ablação do Un-0 abertos — um artefato de pesquisa genuinamente aberto, mais do que muitas startups de hardware em modo stealth publicam. Não há chip. Não há data de tape-out publicada. Rao disse que os próximos anos serão para "experimentar uma série de ideias e protótipos e descobrir o paradigma exato" que escala, descreveu um horizonte de cerca de cinco anos para construir o chip, disse que a empresa fará parceria com a TSMC e chamou o primeiro protótipo de "provavelmente um dos maiores chips analógicos, talvez o maior, já construídos". A empresa posiciona seu produto final como uma jogada de sistemas — silício mais a pilha completa de inferência, competindo em última instância como provedora de cómputo — e não como venda de componente.
Entre aqui e lá está o problema mais antigo da computação analógica, que o próprio Rao nomeia: computadores analógicos estão entre os primeiros computadores, são inerentemente eficientes e perderam para o digital por causa da variabilidade de fabricação — não conseguiam escalar. Cada dispositivo difere ligeiramente; mudanças de temperatura e variação de processo introduzem erros que se acumulam. O digital venceu precisamente porque é indiferente a essa bagunça. Toda a aposta científica da Unconventional AI é que esse veredito de 80 anos pode ser revertido no caso específico das cargas de trabalho neurais, porque redes neurais toleram — e podem ser treinadas em torno de — exatamente as variações que tornaram o analógico inutilizável para tabelas de artilharia e contabilidade.
4. O caso do cético
O contra-argumento honesto tem quatro partes, nenhuma trivial.
Precisão e overhead de conversão. A computação analógica é ruidosa, e o ruído se acumula em computações grandes. Historicamente, aceleradores analógicos parecem melhores na operação matricial central e piores no nível do sistema, porque converter sinais entre os domínios analógico e digital — ADCs e DACs em cada fronteira — pode consumir grande parte da energia que o núcleo analógico economizou. Qualquer afirmação de eficiência que não seja medida na tomada, de ponta a ponta, sobre uma carga de trabalho real, deve ser descontada. O 1.000x da Unconventional é hoje uma projeção sobre um substrato que não existe.
Programabilidade. O fosso da GPU não é só desempenho; é que o mesmo silício treina um modelo na segunda e serve outro na terça. Sistemas analógicos tendem a embutir a computação na estrutura física, o que os torna rígidos. A resposta da empresa — uma interface de software para a física, mais compiladores de dois fundadores especializados exatamente nisso — é plausível no papel e não comprovada na prática. A história do hardware de IA está cheia de chips mais rápidos que perderam para a flexibilidade do CUDA.
Escala. Uma população simulada de 16.384 osciladores gerando imagens de 64x64 é um resultado de pesquisa. Um substrato de inferência em produção precisa da dinâmica equivalente na escala dos modelos de linguagem modernos, fabricada com variação que o treinamento possa absorver, com rendimentos (yield) que uma foundry assine. Cada passo — da simulação ao protótipo, do protótipo ao produto, da geração de imagens à inferência de LLM — já matou empresas analógicas antes. O campo também não está vazio: a computação analógica em memória é perseguida há anos por outros (a Mythic já enviou processadores analógicos para inferência de borda), e uma equipe da Universidade de Pequim relatou no fim de 2025 um sistema analógico de computação matricial baseado em RRAM com grandes ganhos de eficiência reivindicados sobre GPUs — evidência tanto de que a direção está cientificamente viva quanto de que a Unconventional não é dona dela.
A linha de base que se move. A eficiência digital não é estática. O próprio Rao, na Databricks, observou que o custo da IA por unidade de capacidade caía cerca de 4x por ano — dez vezes mais rápido que a lei de Moore — por meio de modelos melhores, quantização e trabalho de sistemas. Um substrato analógico que chegue em cinco anos não compete com a GPU de hoje; compete com cinco anos de eficiência digital composta, em custo por token, com um ecossistema de software maduro. A meta de 1.000x é, em parte, um reconhecimento exatamente disso.
5. O que precisa ser verdade para US$ 4,5 bilhões
Reduza o preço às suas premissas estruturais. Para que uma avaliação seed de US$ 4,5 bilhões pareça razoável em retrospecto, aproximadamente estas coisas precisam se sustentar:
| # | Premissa | Status hoje |
|---|---|---|
| 1 | A energia se torna a restrição vinculante do crescimento da IA dentro da década | Direção amplamente aceita; o calendário de 3-4 anos é afirmação da empresa |
| 2 | Um substrato de osciladores acoplados / analógico pode ser treinado para cargas reais de IA | Demonstrado em simulação na escala de geração de imagens (Un-0, FID 6,74) |
| 3 | A abordagem escala de 16 mil osciladores e imagens para inferência em escala de LLM | Não comprovado — o risco científico central |
| 4 | A variabilidade analógica pode ser absorvida por treinamento na escala de fabricação (TSMC) | Não comprovado — o risco de engenharia central |
| 5 | A eficiência de ponta a ponta (incluindo conversão) vence o digital por um múltiplo grande | ~1.000x teórico reivindicado; 0x demonstrado em hardware |
| 6 | Uma pilha de software torna o substrato programável o bastante para clientes | A experiência dos fundadores combina; nada entregue |
| 7 | Hyperscalers qualificam um substrato não digital para inferência em produção | Nenhum cliente ou design win divulgado |
Leia a tabela como um funil. As premissas 1 e 2 são as que os investidores puderam subscrever em dezembro de 2025 com confiança razoável. As premissas 3 a 5 são onde os US$ 4,5 bilhões realmente moram — são binárias, correlacionadas (as três são facetas de "a física escala?") e levarão anos para se resolver. A premissa 7 é o risco de negócio empilhado sobre o risco científico: mesmo um substrato que funcione precisa deslocar a cadeia de suprimentos mais entrincheirada da tecnologia.
Agora, a aritmética de retorno que faz investidores sofisticados assinarem mesmo assim. Retornos de venture seguem lei de potência: um fundo não precisa que a Unconventional seja provável; precisa que o pagamento no ramo de sucesso seja enorme e que a participação de entrada seja significativa. Se um novo substrato de cómputo capturar mesmo uma porcentagem baixa de um dígito do gasto com inferência de IA a margens de software, a empresa vale dezenas a centenas de bilhões — o incumbente que ela deslocaria parcialmente é avaliado em trilhões. Contra esse pagamento, um cheque de US$ 475 milhões por ~10,6% é uma opção precificada, e o preço de exercício é o tempo: a opção expira se a física não escalar antes que o dinheiro, ou a paciência da indústria, acabe. A segunda tranche planejada rumo a US$ 1 bilhão é a data de renovação da opção — será precificada com qualquer evidência de protótipo que exista até lá, e é o dado futuro mais informativo sobre esta empresa.
6. O downside: do que o piso é feito
A análise de downside de uma empresa sem produto costuma ser uma palavra — zero —, mas aqui o piso tem alguma estrutura. Primeiro, o piso da equipe: as duas empresas anteriores de Rao foram adquiridas por cerca de US$ 400 milhões reportados e US$ 1,3 bilhão, e uma equipe que combina a rede de ex-alunos da MosaicML com grupos de pesquisa do MIT e de Stanford ainda seria adquirível em um cenário de fracasso — ainda que a avaliações pós-seed muito abaixo de US$ 4,5 bilhões, o que é frio consolo para a aritmética de retorno dos investidores seed, mesmo suavizando a perda absoluta. Segundo, o piso de IP: o trabalho de modelos publicado em aberto constrói reputação e gravidade de contratação mais do que IP defensável; a camada defensável, se houver, será o hardware e a pilha de compiladores, que ainda não existem. Terceiro, o piso de caixa: US$ 475 milhões são anos de pista para uma empresa em estágio de pesquisa, o que corta dos dois lados — remove o risco de financiamento da fase de exploração e remove a disciplina que esse risco impõe. O mau resultado realista não é um colapso repentino; é um lento — protótipos que funcionam em pequena escala, eficiência que encolhe no nível do sistema e um mundo nos anos 2030 em que a empresa é um respeitado laboratório de pesquisa com uma tabela de capitalização cara.
Chase's Take
Deixe a física de lado por um momento e olhe a transação. Um seed de US$ 475 milhões a US$ 4,5 bilhões, dois meses após a fundação, não é realmente uma avaliação da Unconventional AI. É a avaliação de uma afirmação de categoria: a de que o reinado de 80 anos da abstração digital está terminando porque a energia, e não os transistores, é agora o recurso escasso. Os investidores não estavam comprando um chip. Estavam comprando o direito de chegar cedo se o substrato da computação mudar — e pagaram um prêmio de fundador à única pessoa cuja biografia se lê como preparação para exatamente esta aposta: o engenheiro que virou neurocientista, construiu hardware específico para a carga de trabalho antes de virar moda, vendeu, e depois vendeu também a camada de software de eficiência.
Minha leitura é que o preço se decompõe em três partes, em ordem decrescente de tamanho. A maior é a opção sobre uma troca de substrato, precificada pelo tamanho da inferência de IA, e não por qualquer coisa que a empresa tenha construído. A segunda é a equipe — genuinamente escassa: há pouquíssimos grupos que combinem design analógico em produção, teoria de compiladores para sistemas físicos e um CEO com duas saídas em eficiência de IA. A terceira, e menor, é a ciência até aqui: o Un-0 é um marco de pesquisa crível — osciladores treinados fazendo trabalho generativo real, publicado abertamente — e também está, medido contra a afirmação, a três ordens de magnitude de simulação da evidência. Um FID de 6,74 em imagens de 64x64 diz que o aprendizado funciona. Ainda não diz nada sobre se a física pode ser entregue como produto.
O detalhe ao qual continuo voltando é a tranche. Rao não pegou US$ 1 bilhão de uma vez; os primeiros US$ 475 milhões são explicitamente uma primeira parte. Isso é ou confiança ("valeremos mais quando o segundo fechamento precificar"), ou disciplina ("prove o paradigma antes de precificar a empresa") — e, vindo de um fundador que vendeu duas empresas, eu leio as duas coisas, e como a pista de como acompanhar esta empresa. Não olhe as manchetes de avaliação. Olhe três coisas: se a segunda tranche fecha, a que preço e respaldada por qual artefato; se o programa de osciladores escapa da geração de imagens para uma demonstração em escala de modelo de linguagem, mesmo em simulação; e se um protótipo físico aparece com números de eficiência na tomada. Até que a terceira aconteça, cada número de eficiência desta empresa — incluindo o 1.000x — é uma afirmação sobre termodinâmica, não sobre um produto.
Para a indústria de semicondutores, o sinal mais profundo é para onde o gargalo se moveu. Uma década atrás, o escasso era FLOPS. Depois foi a largura de banda de memória — a era da HBM. A Unconventional AI é um argumento de US$ 475 milhões de que o próximo escasso são os joules, e de que, quando os joules apertarem o bastante, a indústria tolerará reabrir perguntas que fechou nos anos 1940: computação não numérica, física como algoritmo, hardware que é treinado em vez de programado. Mesmo que esta empresa específica fracasse, esse argumento agora foi financiado em uma escala que garante imitadores, papers e protótipos. Preços como este são como uma indústria anuncia que uma direção de pesquisa virou estratégia.
Uma última calibração. O prior correto para "US$ 4,5 bilhões, sem chip" não é "bolha" nem "visão". É "risco deliberadamente sem preço". Os investidores sabem exatamente quantas das sete premissas da tabela acima estão não comprovadas — assinaram o term sheet mesmo assim, porque o único cenário em que todas se sustentam vale mais do que os outros seis cenários custam. O resto de nós pode assistir a um experimento limpo: o teste mais bem capitalizado já feito sobre se o modo de computar do cérebro pode ser reconstruído em silício. Esse experimento vale ser acompanhado com precisão — marco a marco, em público, com os números anexados.
Implications
Para investidores. Trate a posição como uma opção binária com data de renovação visível. Os dados que reprecificam esta empresa são, em ordem: (1) a segunda tranche rumo a US$ 1 bilhão — seu preço e seu momento são a estimativa de probabilidade atualizada do mercado; (2) uma demonstração da abordagem de osciladores em escala de modelo de linguagem, mesmo simulada; (3) o primeiro silício com dados de eficiência de ponta a ponta (na tomada); (4) qualquer avaliação divulgada de um hyperscaler. Na ausência disso, marque a tese, não a avaliação da manchete. O risco comparável não são outras startups de chips de IA com produtos e ordens de compra; são apostas de substrato em estágio de pesquisa, em que os calendários deslizam em anos, não em trimestres.
Para estrategistas de semicondutores. A composição da equipe fundadora é o sinal estratégico: compiladores e sistemas de programação sentam ao lado de circuitos analógicos porque o assassino histórico dos substratos alternativos foi a interface de software, não a física do dispositivo. Se você compete em silício de IA, o item de monitoramento não são as pontuações FID da Unconventional — é se sua abordagem de interface de software para a física atrai os teóricos e engenheiros de compiladores que tornariam um substrato não digital programável. O fluxo de talentos mostrará a credibilidade do paradigma antes dos benchmarks.
Para planejadores de data center e energia. Não coloque um fator de eficiência de 1.000x em nenhum plano de capacidade. O próprio calendário da empresa é de anos de prototipagem, e a eficiência digital continua se compondo enquanto isso. O que a rodada valida — no nível da alocação de capital, não da engenharia — é que a energia por inferência agora é precificada como restrição estratégica pelos maiores investidores em IA. Planos que assumem que a demanda de inferência pode crescer sem uma resposta de energia são exatamente os planos contra os quais esses US$ 475 milhões foram captados para apostar.
Para pesquisadores. O lançamento aberto do Un-0 — pesos, código de treinamento, ablações — torna a abordagem de osciladores falseável em público, que é exatamente como uma afirmação de substrato deve ser testada. As perguntas abertas são específicas e verificáveis: o comportamento de escala da qualidade versus número de osciladores frente à fronteira convencional, a robustez dos acoplamentos aprendidos à variação de dispositivos e o tamanho do overhead de conversão em qualquer implementação física. O progresso nessas três, nessa ordem, é o placar científico.
FAQ
A Unconventional AI tem um chip? Não. Em seu marco público mais recente (Un-0, junho de 2026), o sistema demonstrado pela empresa é uma simulação de software de osciladores acoplados executada em GPUs convencionais. Um chip analógico físico está em desenvolvimento, com um programa de prototipagem de vários anos e uma parceria com a TSMC descritos pela empresa, mas nenhum silício foi mostrado e nenhuma data de tape-out foi publicada.
Por que uma empresa sem produto vale US$ 4,5 bilhões? Os US$ 4,5 bilhões reportados são uma avaliação pós-money de estágio seed de dezembro de 2025, não um preço de mercado de um produto. Eles precificam três coisas: uma equipe fundadora com duas saídas anteriores (Nervana, cerca de US$ 400 milhões reportados para a Intel; MosaicML, US$ 1,3 bilhão para a Databricks), uma experiência combinada escassa em design analógico e teoria de compiladores, e uma opção sobre um novo substrato de computação se a restrição de energia da IA forçar um. Os investidores compraram aproximadamente 10,6% da empresa por US$ 475 milhões.
O que é a abordagem de osciladores acoplados, em termos simples? Em vez de computar com interruptores digitais que simulam uma rede neural passo a passo, a empresa quer que redes de osciladores físicos — circuitos que ciclam ritmicamente, como metrônomos — realizem a computação por meio de sua sincronização mútua. Os parâmetros aprendíveis são as forças de acoplamento entre os osciladores. A física se assentando em um padrão sincronizado é a inferência, e é por isso que a empresa acredita que pode usar muito menos energia do que simular a mesma dinâmica numericamente.
O que devemos observar a seguir? Três marcos, em ordem de valor informativo: o fechamento e o preço da segunda tranche planejada rumo a uma captação total de US$ 1 bilhão; uma demonstração da abordagem em uma tarefa em escala de modelo de linguagem (o Un-0 cobre geração de imagens); e o primeiro silício físico com medições de eficiência de ponta a ponta. Até o último deles, o número de eficiência de ~1.000x permanece uma estimativa teórica, não um resultado demonstrado.
Nota sobre fontes e status: avaliação, tamanho da rodada e composição de investidores são os reportados no anúncio de 8 de dezembro de 2025 e indicados como números reportados; a empresa é privada e seus termos não são auditados de forma independente. Os resultados técnicos (Un-0) são os números publicados pela própria empresa em seu lançamento de junho de 2026. A conversão cambial usa 1 USD = 1.400 KRW em todo o texto.
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.


