 VLSI Korea
d-Matrix 20 億美元估值拆解 — 在 SRAM 裡運算的 Corsair 與 3DIMC 賭注
d-Matrix 於 2025 年 11 月以 20 億美元估值完成 2.75 億美元 C 輪募資。其 Corsair 加速器在 SRAM 內部運算,每張卡 150 TB/s。本文拆解頻寬的物理、SRAM 製程經濟學、Raptor 3DIMC 路線圖,以及 20 億美元成立必須為真的條件。


30 秒摘要
d-Matrix 的 20 億美元估值,買的是推論經濟學最缺的一樣東西:不離開晶片的記憶體頻寬。這家位於聖塔克拉拉的新創公司於 2025 年 11 月 12 日以 20 億美元估值完成 2.75 億美元 C 輪募資,累計募資達 4.5 億美元。主力加速器 Corsair 採用在 SRAM 內部運算的 Digital In-Memory Computing(DIMC),宣稱每張卡 150 TB/s 的晶片內頻寬、Llama 70B 每秒 30,000 個 token、每 token 2 毫秒,以及比 GPU 系統高 3–5 倍的能源效率。Corsair 已於 2026 年 6 月進入量產。20 億美元買的不是今天的營收,而是一個選擇權:當推論成為 AI 的主要成本時,勝出的架構會是把記憶體、而非算術,當成產品的那一個。
| 項目 | 內容 |
|---|---|
| 估值 | $2B(Series C,2025年11月12日) |
| 累計募資 | $450M |
| 產品 | Corsair(DIMC、TSMC 6nm) |
| 算力 | 2,400 TFLOPS(8-bit) |
| 晶片內記憶體 | 2GB SRAM,150 TB/s |
| 晶片外記憶體 | 最大 256GB LPDDR5 |
| 下一代 | Raptor / 3DIMC(目標 2026 年底 tape-out) |
Background:為 AI 下半場而成立的公司
d-Matrix 於 2019 年在美國加州聖塔克拉拉由 Sid Sheth(執行長)與 Sudeep Bhoja(技術長)創立。創立時的押注在當時並非主流:訓練不會一直是 AI 的瓶頸。模型訓練完成後,必須持續、大規模地為付費用戶回答問題;這個服務階段,也就是推論,將成為整個產業最大的成本。d-Matrix 在市場認同這個判斷的六年前,就已開始為這個階段打造矽晶片。
募資歷史正是這個假設逐步獲得認同的軌跡。2023 年的 1.1 億美元募資引入了 Microsoft 的創投基金 M12。2025 年 11 月的 C 輪由 BullhoundCapital、Triatomic Capital 與 Temasek 共同領投,卡達投資局(QIA)與新加坡 EDBI 新加入,M12、Nautilus Venture Partners、Industry Ventures 與 Mirae Asset 跟投。累計募資 4.5 億美元,員工超過 250 人,分布於聖塔克拉拉、多倫多、雪梨、班加羅爾與貝爾格勒。
時機同樣重要。到 2025 年底,超大規模業者已公開把資本支出重心從訓練叢集移向推論機隊,產業的核心問題從「能多快訓練」轉為「每個 token 的成本是多少」。d-Matrix 是少數從第一天就為第二個問題設計的新創公司之一。一家尚未規模量產的晶片公司獲得 20 億美元估值,必須放在這個背景下解讀。
Business Deep Dive
產品:在權重所在之處運算
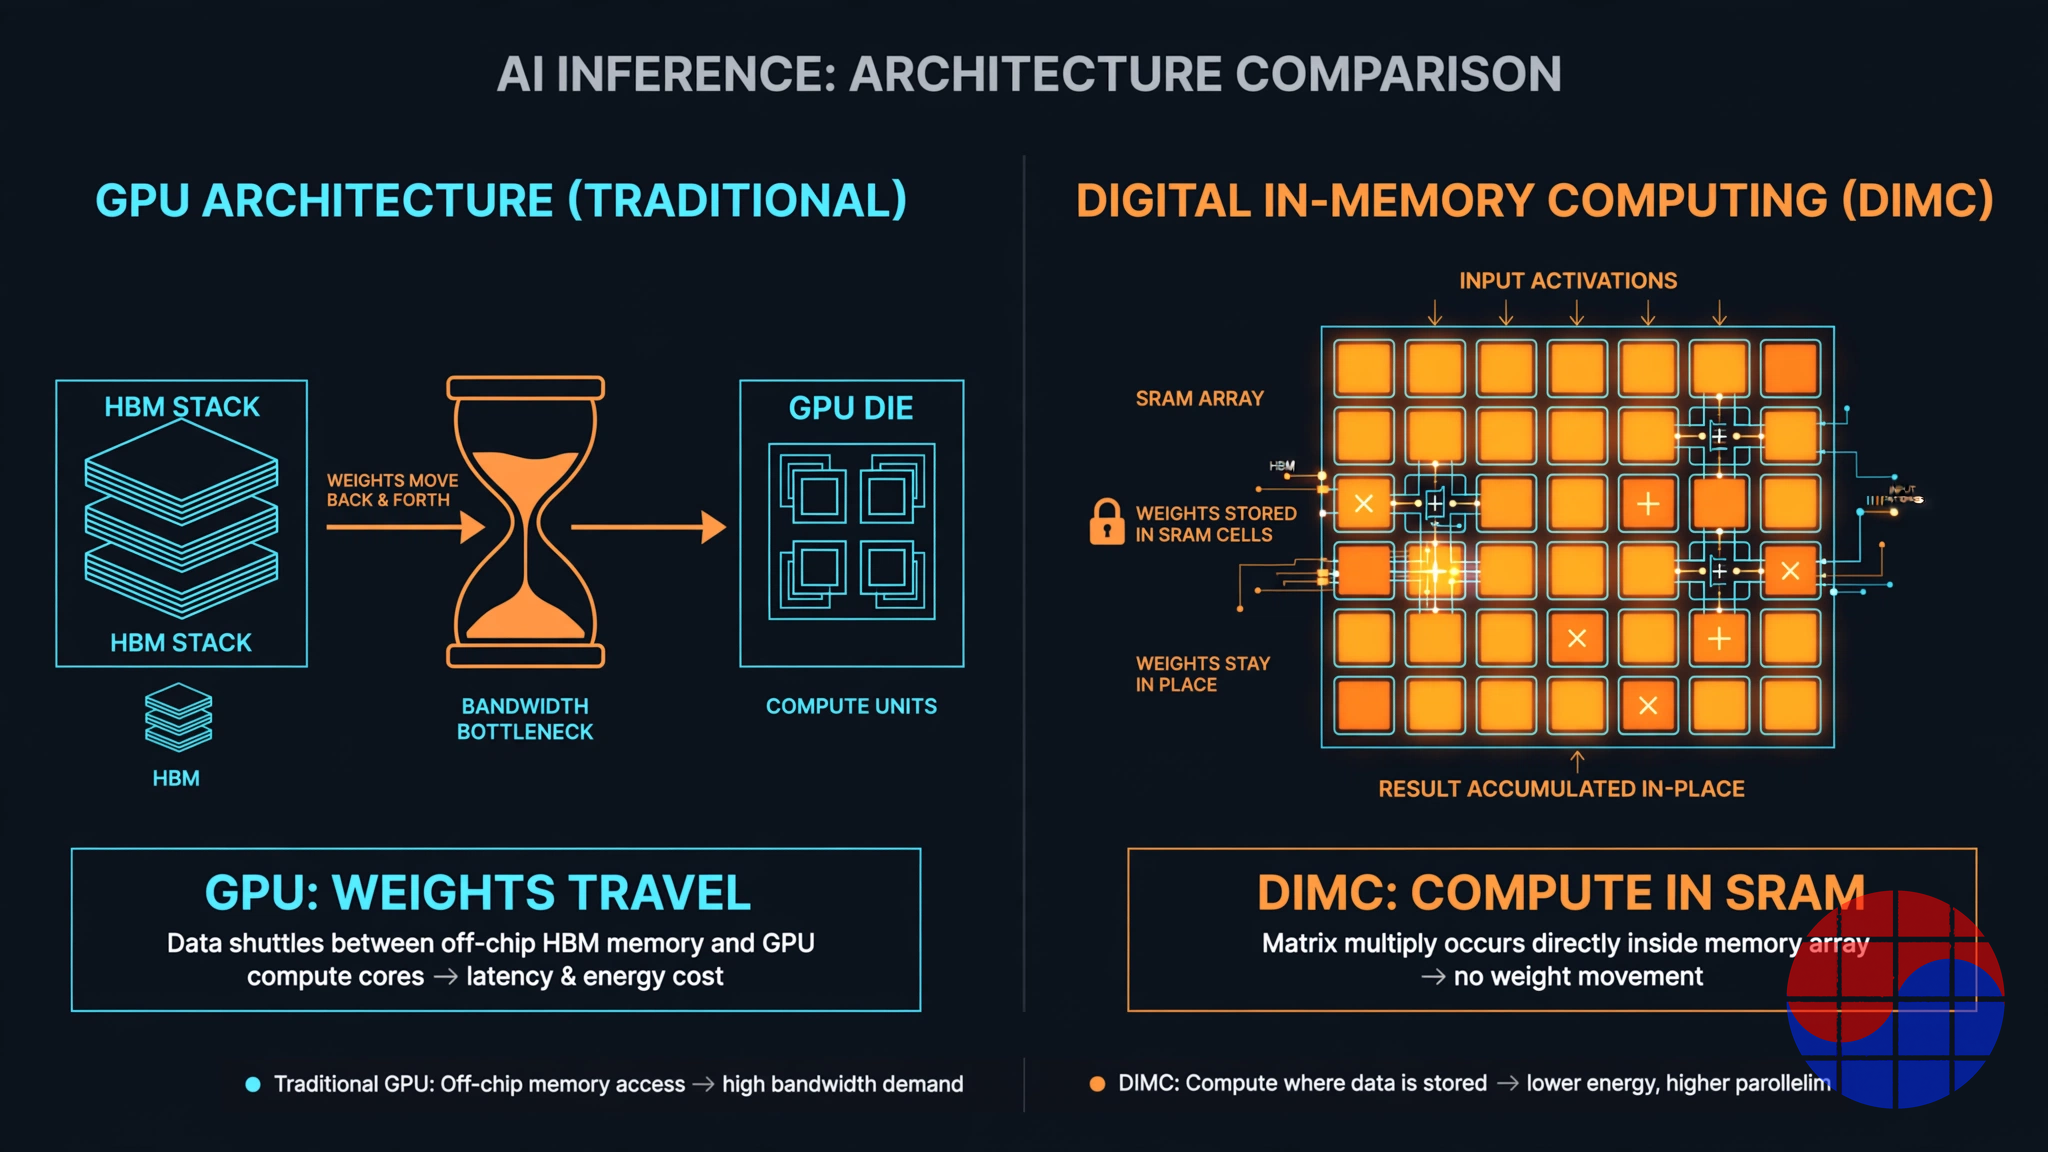
解碼階段的推論受限於記憶體。每產生一個 token,就必須讀取一次模型權重,而 GPU 的大量時間與電力,花在把權重在 HBM 堆疊與運算單元之間來回搬運。Corsair 攻擊的正是搬運本身。它的 DIMC 核心在 SRAM 陣列內部執行矩陣運算:權重不是被搬去計算,而是在原地被計算。
量產卡的規格定義了這筆交易。採用台積電 6 奈米製程、標準 PCIe Gen5 規格的 Corsair 卡,提供 2,400 TFLOPS 的 8 位元峰值算力、以 150 TB/s 運作的 2 GB 晶片內 Performance Memory(SRAM),以及最高 256 GB 的晶片外 LPDDR5 Capacity Memory。把頻寬與 HBM 比較:最新 HBM3e 每堆疊約 1.2 TB/s,整個 GPU 封裝合計也約 8 TB/s。Corsair 的 150 TB/s 是晶片內 SRAM 頻寬而非封裝頻寬,性質不同,這個比較對 d-Matrix 有利。但方向是真實的:對小批次、低延遲的解碼而言,把權重留在 SRAM,就能消除主導 GPU token 延遲的那趟來回。
C 輪資金真正買的是晶片周邊的平台。JetStream 網路卡以低延遲連接加速卡與機櫃。Aviator 軟體堆疊把以 PyTorch 與 Triton 撰寫的模型編譯到 DIMC 架構上。與 Arista、Broadcom、Supermicro 共同打造的參考機櫃架構 SquadRack,讓加速卡成為可部署的系統;2026 年 10 月宣布正式上市的 Squadron 叢集,可在標準氣冷資料中心擴展到 16 個機櫃、最多 1,024 顆 Corsair XPU。Corsair 已於 2026 年 6 月進入量產,出貨優先供應超大規模業者、新興雲端業者與前沿 AI 實驗室。2026 年 4 月,公司還收購了 GigaIO 的資料中心業務,取得 FabreX 記憶體互連與 SuperNODE 系統設計。
SRAM 的天花板,以及 Raptor 存在的原因
這個架構的強項正是它的天花板。SRAM 速度快,但每位元成本極高。Corsair 的 2 GB Performance Memory 裝不下 70B 模型,其餘權重放在 LPDDR5 Capacity Memory,實際效能取決於 Aviator 能否在兩個層級之間聰明地切分工作。SRAM 也不像邏輯電路那樣隨製程微縮:在先進節點其密度改善緩慢,純 SRAM 路線圖意味著每單位 token 產能的成本隨世代上升,而非下降。這是每一家記憶體內運算新創都必須回答的製程經濟學問題。
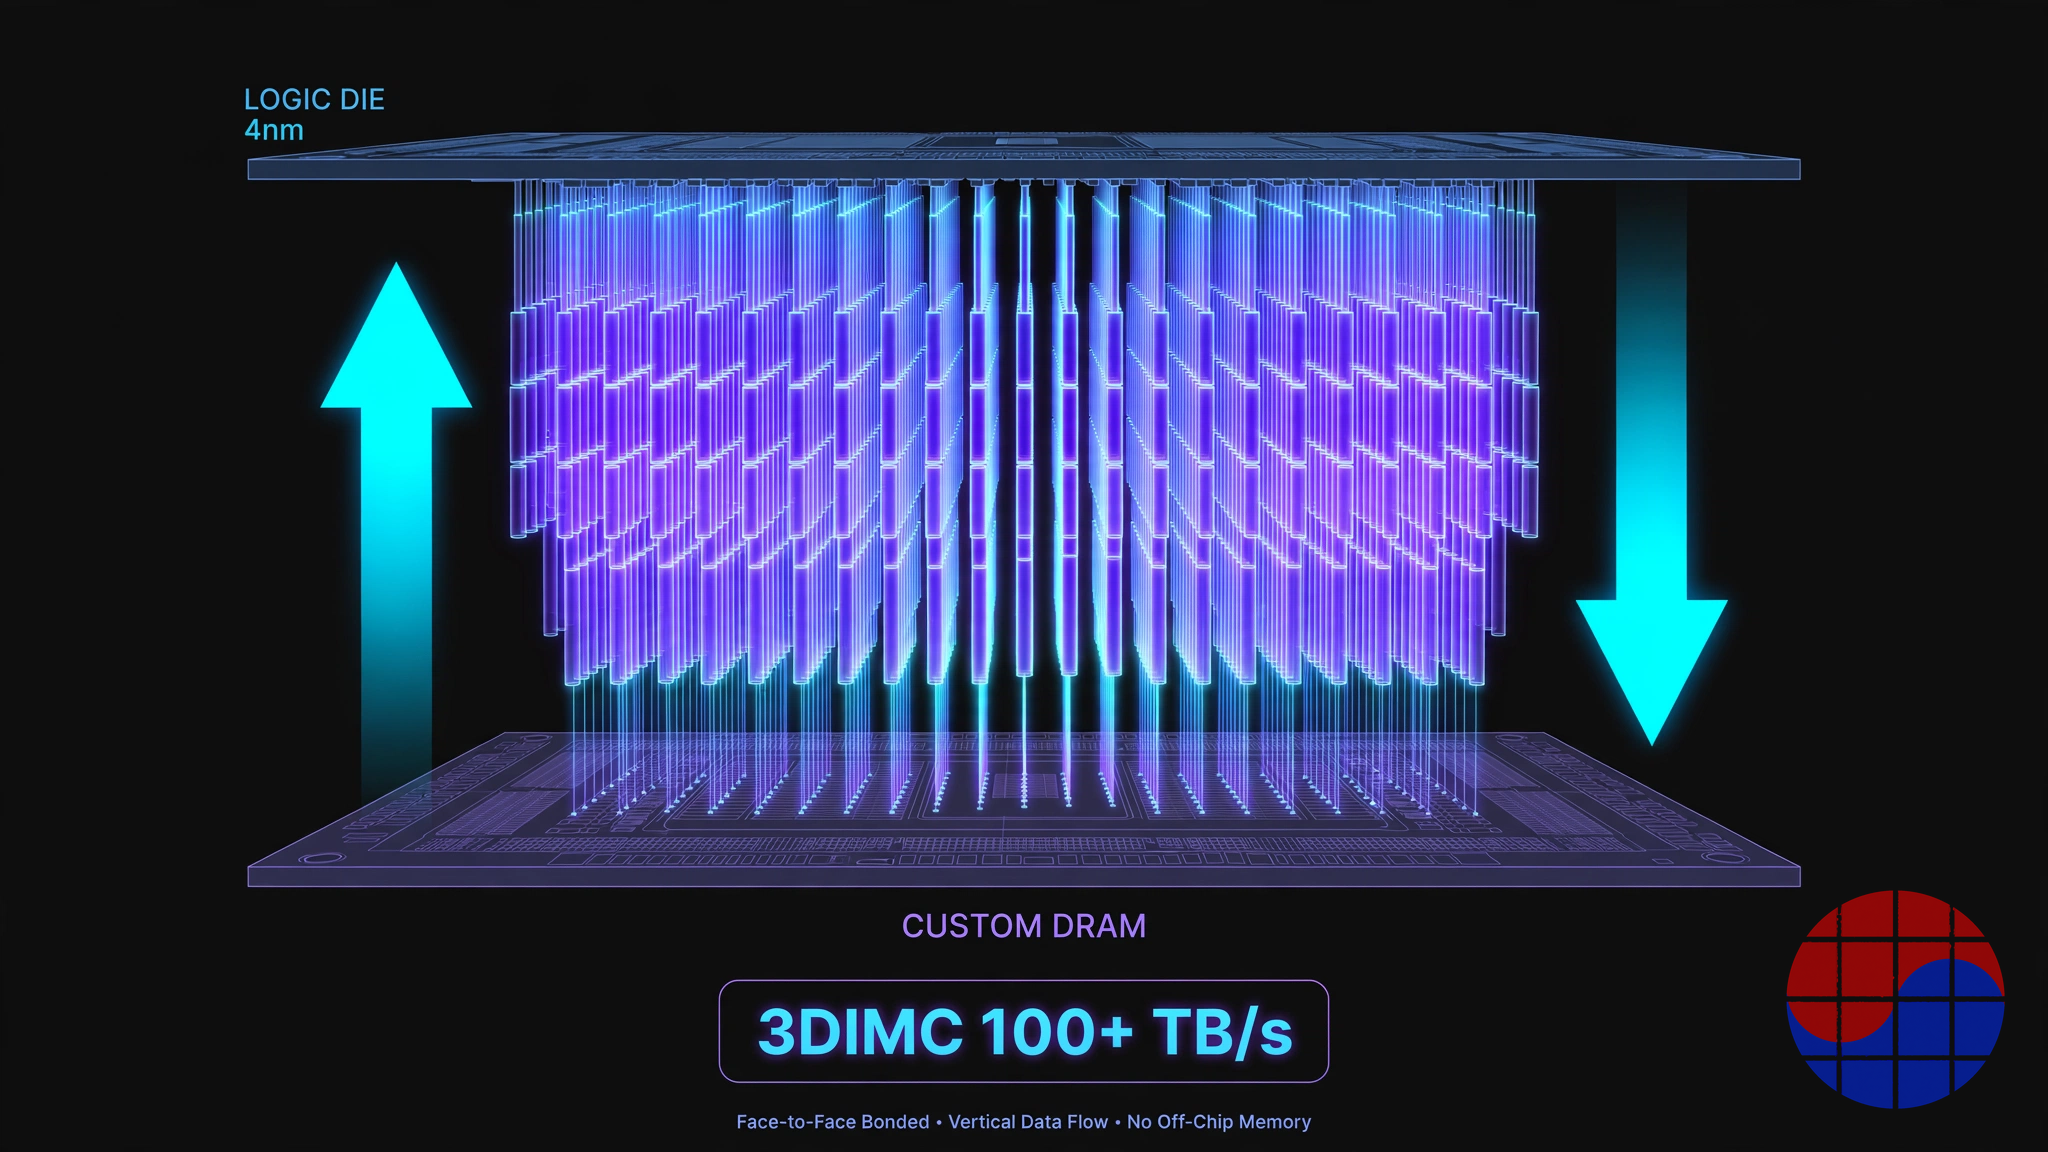
d-Matrix 的答案是 3DIMC,也就是次世代 Raptor 平台。Raptor 於 2025 年 11 月透過與 Alchip 合作的 Pavehawk 測試載具公開,將台積電 4 奈米邏輯晶粒以 36 微米間距正面接合到客製 DRAM 晶粒上。公司預估每顆加速器可達 100 TB/s 以上頻寬與 32 GB(256 Gb)堆疊記憶體,能效為 0.37 pJ/bit;2026 年公布的早期矽晶片結果顯示,其每顆加速器的推論吞吐量約為 HBM 方案的 4.7 倍。Raptor 目標在 2026 年底完成流片,2027 年第四季供應機櫃。2026 年 9 月,d-Matrix 加入 NVIDIA 的 NVLink Fusion 生態系,讓 Raptor XPU 設計為插入 NVIDIA MGX 機櫃、與 GPU 並存,而不是要求客戶整櫃汰換。
20 億美元成立,必須為真的三件事
把故事剝到只剩算術。在營收規模化之前、累計募資 4.5 億美元之上,20 億美元估值把 d-Matrix 定價為未來的平台事業,而不是零組件供應商。三件事必須成立。第一,推論支出必須持續複合成長,使專用解碼層成為與 GPU 分開編列的預算項目。第二,Corsair 宣稱的經濟性——互動速度 10 倍、每單位總持有成本效能 3 倍、能源效率 3–5 倍,全為公司公布數字——必須在具名客戶的生產工作負載中成立,而不只是 Llama 基準測試。第三,軟體護城河必須形成:當 NVIDIA、AMD 或超大規模業者自研 ASIC 團隊推出「夠好」的方案時,Aviator 必須黏著到讓客戶不把硬體視為可隨意替換的商品。
目前的牽引證據真實但不完整。進入量產、由 Supermicro 製造的機櫃產品線、補上系統級互連的收購案,以及以 Temasek、QIA、EDBI 等主權基金為主的投資人組合,都顯示成熟買家已完成盡職調查並選擇留下。仍然缺少的,是最終決定晶片新創價格的那類證據:具名超大規模業者的生產部署揭露與重複訂單。2026 年 7 月傳出以更高估值進行新一輪募資、以及 NVIDIA 考慮投資的消息,目前仍屬未經證實的 reported 等級,應如此看待。
下行風險:HBM 陣營的反擊,以及軟體這道稅
看空論點有兩個分支。第一是物理與路線圖。HBM 並未停滯:HBM4 把每堆疊介面拓寬到 2,048 位元,GPU 業者也正把更大的 SRAM、更快的互連與推論最佳化產品整合進自家產品線。每一代都縮小了支撐獨立加速器存在的延遲差距,而 GPU 陣營同時提供訓練與推論共用的單一軟體堆疊。第二是導入稅。每個非 CUDA 平台都要求客戶移植模型、信任年輕的編譯器,並承擔新創公司資產負債表的供應商風險。d-Matrix 以異質運算定位緩解這一點:加入 NVLink Fusion,以及 Attention-FFN Disaggregation(AFD)展示——把 attention 放在 GPU、feed-forward 層放在 Corsair XPU,在 64 位同時使用者下達到每位使用者每秒 845 個 token。緩解不等於消除:這道稅在每一個銷售週期都要繳。
Chase's Take
大多數 AI 晶片新創賣的是更快的引擎。d-Matrix 賣的是另一條會計恆等式:在解碼推論中,每秒 token 數大約等於頻寬除以模型大小。擁有頻寬的公司,就擁有毛利。把記憶體內運算做成數位而非類比,是個安靜而正確的決定:類比 IMC 在展示時很漂亮,校準時卻會崩壞;DIMC 保留了 SRAM 的確定性,也能承受製程遷移。誠實的問題不是物理是否行得通——Pavehawk 與 2026 年的矽晶片結果已經說行得通。問題是:SRAM 經濟學加上一套年輕的軟體堆疊,能否在「能把答案綁進客戶已買下的 GPU 機櫃」的在位者面前,守住一個可防禦的層級。加入 NVLink Fusion 的決定顯示管理層理解這一點:d-Matrix 不是要打敗 NVIDIA 的機櫃,而是要成為那個機櫃裡的一個品項。在 20 億美元的價位上,投資人買的不是這個結果,而是通往結果的機率加權路徑——用 C 輪資金去買還缺的兩項證明:具名的生產規模,以及 Raptor 如期流片。
Implications
對超大規模業者與新興雲端業者:Corsair 等級的加速器把推論變成異質設計問題。採購問題從「選哪顆 GPU」轉為「哪一層在哪裡執行」,AFD 式的解耦將成為容量規劃的常規,而非實驗。
對記憶體產業:d-Matrix 是一個附帶警告的需求訊號。其現行產品以 SRAM 與 LPDDR5 繞開 HBM,而 Raptor 的客製堆疊 DRAM 顯示,長期競局不是「HBM 對上空白」,而是「標準 HBM 對上為特定運算晶粒設計的記憶體」。與加速器新創共同設計堆疊的記憶體廠,將獲得一個不受 GPU 雙頭壟斷控制的通路。
對投資人:20 億美元這個價格,將由兩個可觀察事件重新定價:Corsair 第一個具名且重複下單的超大規模部署,以及 Raptor 在 2026 年底流片。在那之前,這個估值靠的是基準測試主張與投資人品質——是強訊號,但訊號不是現金流。
FAQ
d-Matrix 是做什麼的?
d-Matrix 打造專為 AI 推論設計的資料中心加速器。其 Corsair 平台採用在 SRAM 內部運算的 Digital In-Memory Computing(DIMC),結合 JetStream 網路與 Aviator 軟體堆疊,目標是低延遲、高效率的 token 產生,而非模型訓練。
為什麼 d-Matrix 估值 20 億美元?
20 億美元估值由 2025 年 11 月 12 日完成的 2.75 億美元 C 輪募資所定,由 BullhoundCapital、Triatomic Capital 與 Temasek 共同領投,QIA、EDBI 與 Microsoft 的 M12 參與。投資人定價的是這樣的預期:推論將成為 AI 基礎設施最大的成本,而以記憶體為中心的架構能取得其中可持續的一塊。
Corsair 與 GPU 有何不同?
GPU 每產生一個 token 都要從 HBM 讀取模型權重,封裝頻寬約 8 TB/s。Corsair 把熱權重留在晶片內 SRAM,並在記憶體陣列內部運算,達到每張卡 150 TB/s 的晶片內頻寬,瞄準 GPU 效率最差的小批次、低延遲解碼工作負載。每張卡配備 2 GB SRAM Performance Memory 與最高 256 GB LPDDR5 Capacity Memory。
什麼是 3DIMC 與 Raptor?
3DIMC 是 d-Matrix 記憶體內架構的 3D 堆疊演進。Raptor 平台將 4 奈米邏輯晶粒正面接合到客製 DRAM 晶粒上,預估每顆加速器可達 100 TB/s 以上頻寬與 32 GB(256 Gb)記憶體。Raptor 目標 2026 年底流片,2027 年第四季供應機櫃,並包含與 NVIDIA NVLink Fusion 機櫃的整合。
註:效能與效率數字(互動速度 10 倍、每單位 TCO 效能 3 倍、能源效率 3–5 倍、150 TB/s)為本文所載日期當時之公司公布數字。20 億美元估值為 2025 年 11 月 C 輪公告中所報導的投後估值。
📩 訂閱 VLSI Korea 電子報
每日半導體深度分析,第一時間寄到您的信箱。免費訂閱。


