 VLSI Korea
瑞典資料中心選中韓國AI晶片——FuriosaAI RNGD 7,000顆部署的意義
瑞典斯德哥爾摩15MW資料中心選用韓國FuriosaAI RNGD,第1期1,800顆、累計擴充至8,800顆以上,與GPU混合部署。180W的電力經濟性是其在歐洲勝出的關鍵。



30秒摘要
- 2026年8月,韓國無晶圓廠新創FuriosaAI、美國基礎設施公司I/ONX HPC與資料中心開發商Velox宣布,將在瑞典斯德哥爾摩興建一座15MW的AI資料中心,以FuriosaAI的RNGD推論加速器為核心。
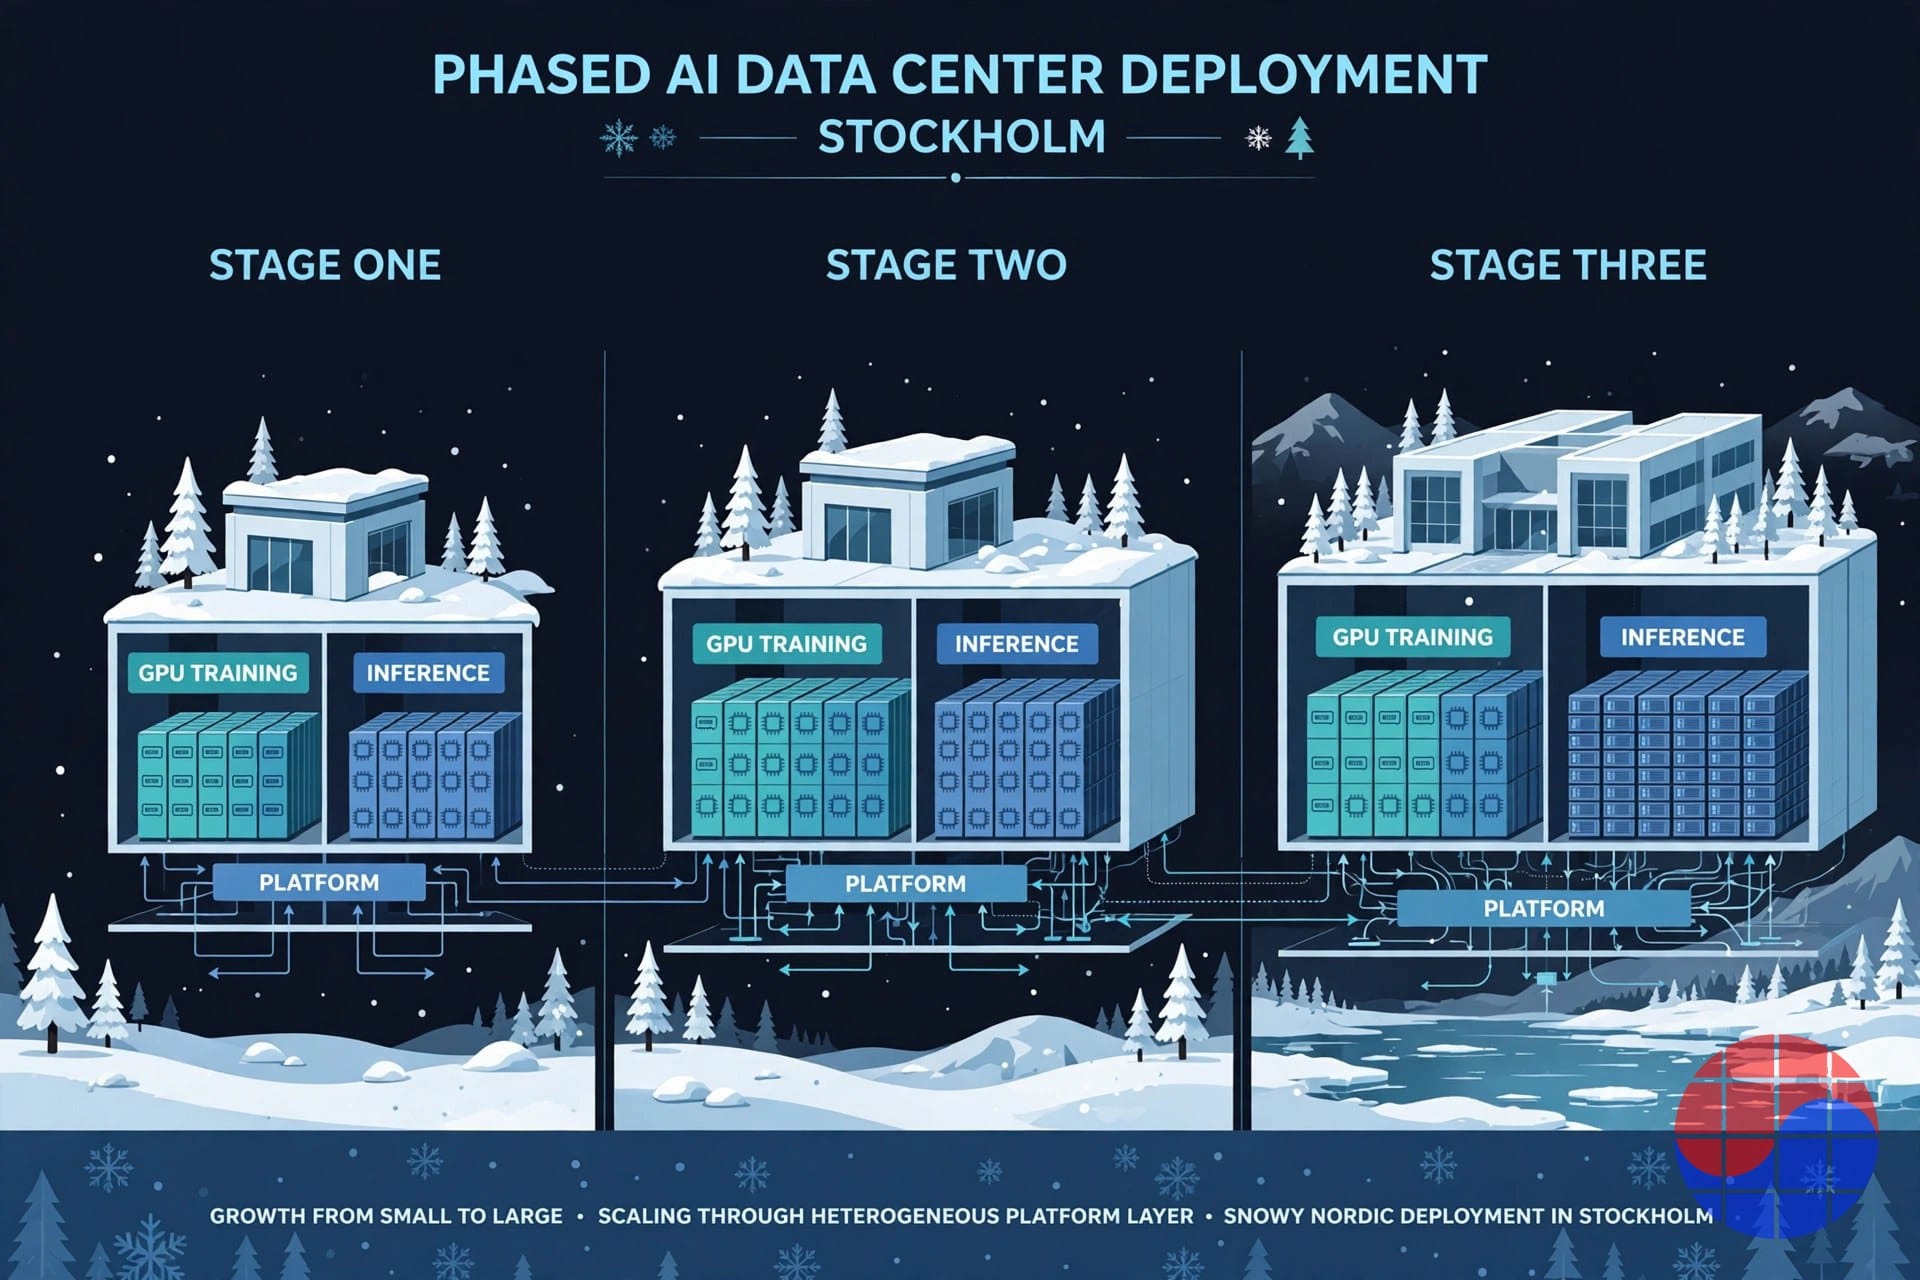
- 部署分階段進行:第1期導入1,800顆RNGD,於2027年初上線首批2MW容量;其後在擴充階段再增加7,000顆以上,全數建成時累計規劃超過8,800顆加速器。
- RNGD機隊不會取代GPU。它將在I/ONX的Symphony SixtyFour平台中,與約7,000顆輝達與超微的GPU並存:GPU負責訓練,RNGD負責LLM與代理式AI推論。
- 選用的邏輯在於電力經濟性。RNGD是一張180W的氣冷PCIe卡,經獨立測量,其每瓦效能比GPU方案高出2.25倍——在電價為美國與中國2至3倍、且多數設施採氣冷的歐洲,這是決定性的特質。
- 對FuriosaAI而言,斯德哥爾摩是把國內驗證轉化為出口業務的規模化參考案例,且正值該公司推動據報導達3億至5億美元的上市前募資輪之際。
背景
2026年8月4日宣布的斯德哥爾摩計畫由三方共同興建。Velox DCI Europe是2025年2月成立、總部位於德州的模組化資料中心公司的歐洲部門,負責開發、管理與營運實體設施,並以基礎設施即服務(Infrastructure-as-a-Service)模式銷售容量。I/ONX HPC是2020年成立、總部位於拉斯維加斯的異質AI基礎設施公司,擔任系統整合商與平台夥伴。FuriosaAI提供RNGD加速器、驅動程式、軟體堆疊與架構支援。合作夥伴表示,未來數月將用於技術驗證、軟體整合與供應規劃,為第一個部署階段做準備。
| 階段 | 設施容量 | RNGD加速器 | 時程 |
|---|---|---|---|
| 第1期 | 2MW | 1,800顆 | 2027年初 |
| 擴充 | +8MW(累計10MW) | 再增加7,000顆以上 | 2027年稍晚 |
| 全數建成 | 15MW | 合計8,800顆以上 | 後續階段 |
工作負載的分工明確。RNGD加速器負責大型語言模型與代理式AI推論;GPU機隊負責模型訓練與通用運算。晶片安裝於I/ONX的Symphony SixtyFour高密度伺服器中,單一節點最多可整合64顆加速器。終端客戶是購買推論容量、而非硬體的歐洲企業與雲端服務供應商。
斯德哥爾摩並非FuriosaAI在歐洲的第一步。2026年7月,RNGD伺服器已部署於葡萄牙里斯本的一座Equinix資料中心——一個單一據點的灘頭堡。在韓國,三星SDS已推出以RNGD為基礎的NPU即服務,LG AI Research也在RNGD基礎設施上運行其EXAONE模型。瑞典帶來的改變是規模:由業務成敗取決於硬體表現的第三方營運、數千顆規模、多階段的承諾。
業務深度解析
1. 歐洲正在購買主權——而主權有一張電費帳單
這筆交易的需求面具有結構性。歐盟透過InvestAI倡議,目標動員2,000億歐元的AI投資。2026年7月,歐盟執委會以100億歐元公共資金支持7座AI超級工廠,期望再帶動200億歐元的民間資本;每座設施至少要容納10萬顆先進AI晶片,獲選聯盟預計於2027年初公布。執委會負責技術主權的執行副主席Henna Virkkunen稱,取得原始運算能力是「歐洲的戰略必需」。
有兩項限制形塑歐洲實際能買到什麼。第一,歐盟執委會自身的分析指出,歐盟電價是美國與中國的2至3倍。在歐洲,每瓦效能不是最佳化目標,而是能否新增容量的可行性條件。第二,主權需求意味著供應來源要超越單一占主導地位的美國GPU供應商而多元化——然而在最頂端,預設選項依然主導:輝達、超微與高通已簽署供應超級工廠計畫的意向書。挑戰者晶片首先在市場的獨立邊緣勝出——正是像斯德哥爾摩這樣由商業驅動的IaaS設施,在那裡決定晶片的是營運商自身的利潤,而不是補助委員會。
2. 補充而非取代:真正有效的楔子
每一家挑戰GPU既有業者的廠商都面臨同一道採用高牆:沒有營運商願意拆掉運作中的GPU資產,把業務押在未經證實的堆疊上。FuriosaAI的斯德哥爾摩設計不是攀爬這道牆,而是繞過它。約7,000顆GPU仍留在建築內。RNGD只要求推論層——也就是詞元被供應、使用率持續、每瓦效能直接轉化為營運商毛利的那一層。
另外兩個封裝上的選擇進一步降低採用門檻。異質整合的風險由I/ONX的Symphony SixtyFour平台吸收,該平台宣稱透過單一節點最多整合64顆加速器,可使機櫃規模的總持有成本降低50%以上;客戶無需自行管理混合機隊。而且由於Velox銷售的是基礎設施即服務,歐洲企業租用的是推論成果,而不是自行評估一家韓國新創的晶片。晶片決策變成單一營運商的總持有成本計算——這比數千次個別設計導入要容易銷售得多。
3. 180W的經濟學
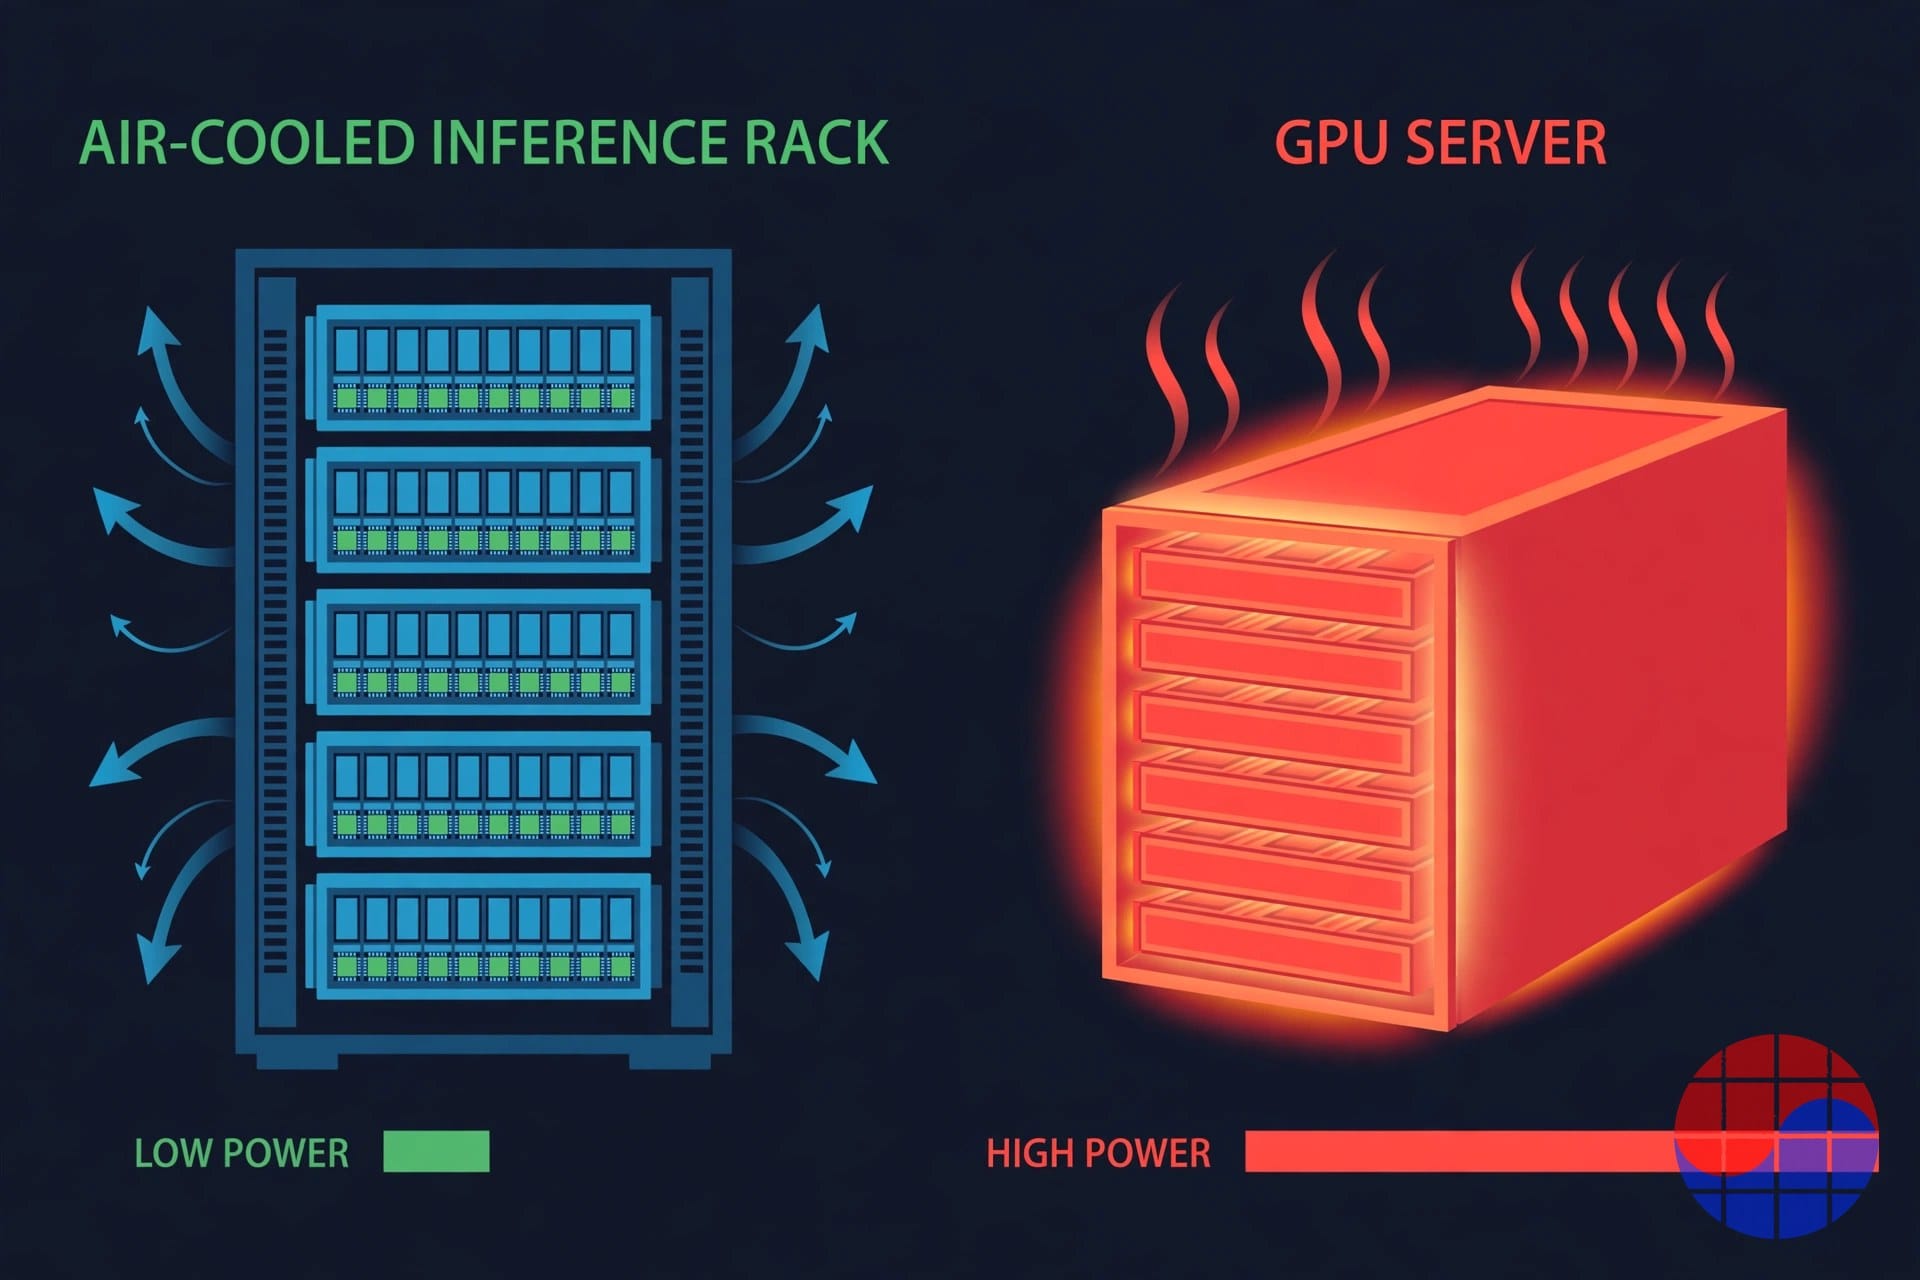
RNGD採用台積電5奈米製程,圍繞FuriosaAI的Tensor Contraction Processor架構打造。每張PCIe卡在卡片層級熱設計功耗180W、被動散熱下,提供512 TFLOPS的FP8運算與48GB的HBM3記憶體。該公司的NXT RNGD伺服器把8張卡裝入標準氣冷4U機箱,提供4 petaflops的FP8與384GB的HBM3,每台伺服器約3kW,相較輝達DGX H100伺服器最高達10.2kW。因此,一個標準15kW的氣冷機櫃最多可容納5台NXT RNGD伺服器,而DGX只能放1台。FuriosaAI指出,超過80%的資料中心仍以每機櫃8kW或以下的氣冷方式運行——這是高密度GPU改造在不重建設施的情況下無法服務的既有基礎。
效率主張有第三方份量支持。LG AI Research在其RNGD基礎設施上運行EXAONE大型語言模型,測得每瓦推論效能比GPU方案高出2.25倍,且在相同電力預算限制的機櫃中多產出3.75倍的詞元。機隊的算術同樣簡單:8,800張180W的卡在全數建成時約消耗1.6MW的加速器電力——約為斯德哥爾摩設施15MW額度的十分之一,在歐洲電網連接實際允許的電力預算內,為GPU機隊、網路與冷卻留下餘裕。
4. 參考部署的價值
AI晶片新創很少死於晶片品質;它們死於參考階段,當沒有營運商願意率先大規模採用時。FuriosaAI如今已依序堆疊參考案例——LG AI Research用於模型層級驗證、三星SDS用於韓國的服務封裝、Equinix里斯本作為歐洲灘頭堡,以及斯德哥爾摩在第三方營運下達到數千顆規模。每一步都消除一類不同的買方顧慮。
時機也很重要。FuriosaAI於2025年7月完成由韓國政策與策略投資人領投的1.25億美元C輪過橋募資,並於2026年1月據報導在預期上市前尋求3億至5億美元。這也是那家拒絕Meta 8億美元收購出價、選擇獨立的公司。一個歐洲旗艦參考案例——真實的數量、具名的設施、有日期的上線——正是支撐上市前募資中獨立敘事的資產。同時,該公司2026年5月與博通就第三代、以小晶片為基礎的機櫃規模平台建立的夥伴關係,意味著斯德哥爾摩在下一代打造之際,為現行世代降低風險。
Chase's Take
這筆交易富啟發性之處,不在於一顆韓國晶片在歐洲勝出,而在於它如何勝出:藉由拒絕爭奪訓練層。訓練是一個擁有根深蒂固軟體護城河的聲望市場;推論是一個由買方試算表決定的成本市場。一張提供2.25倍每瓦效能的180W氣冷卡,不需要被喜愛——它只需要在營運商已擁有的設施內,每個詞元更便宜。那是商業論點,不是基準測試論點,也是挑戰者晶片一貫唯一有效的楔子。
三項風險同樣值得並列。第一,執行:這是一個進入技術驗證的已宣布計畫,第1期必須在2027年初如期落地,擴充階段才可信。第二,既有業者回應:GPU領導者每一代都改善推論效率,並擁有軟體生態系;效率差距是一個移動的目標。第三,集中:一個設施與一個整合商承載歐洲故事,因此任何延誤都高度可見。這些都不抹除結構性論點——主權需求加上電力限制加上補充定位,是一套可重複的打法,而FuriosaAI剛以韓國AI晶片新創前所未達的規模執行了它。
影響
- 對韓國無晶圓廠生態系: 斯德哥爾摩是出口證明,顯示國內AI晶片可以在外國商業設施中以總持有成本勝出,而不只是在韓國企業錨點之內。可以預期主權AI定位將成為韓國加速器新創標準的市場進入打法。
- 對歐洲營運商: 本計畫是從氣冷、電力受限設施中榨出AI容量的可複製範本。2027年初的超級工廠授標將顯示,挑戰者晶片是否也能滲透受補助的建設,如同商業建設一樣。
- 對投資人: 重要的里程碑是第1期於2027年初如期上線、上市前募資輪完成,以及博通第三代計畫的進展訊號。
- 對既有業者觀察者: 同一棟建築內有約7,000顆GPU,這筆交易擴大整體加速器市場的程度,目前大於縮減既有業者市占的程度。策略問題是,推論層一旦被讓出,是否會一直被讓出。
FAQ
斯德哥爾摩將部署多少顆FuriosaAI RNGD加速器? 根據各公司2026年8月的宣布,第1期1,800顆,擴充階段再增加7,000顆以上,全數建成時合計超過8,800顆。
為什麼瑞典資料中心選擇韓國推論晶片,而不是更多GPU? 因為電力與總持有成本。RNGD以氣冷PCIe外形、每卡180W提供512 TFLOPS的FP8運算,經測量每瓦效能比GPU方案高出2.25倍——適合電價高且以氣冷設施為主的歐洲。GPU仍留在同一設施中負責訓練。
I/ONX的Symphony SixtyFour平台是什麼? 一個高密度AI伺服器平台,單一節點最多整合64顆加速器,在異質系統中混合FuriosaAI RNGD NPU與輝達及超微的GPU。I/ONX宣稱它可使機櫃規模的總持有成本降低50%以上。
斯德哥爾摩設施何時開始營運? 首批2MW運算容量預計於2027年初上線,2027年稍晚再增加8MW,整體目標容量為15MW。
註:部署數字、電力數據與每瓦效能結果,取自各公司2026年8月的宣布與LG AI Research公布的評估。本文為產業分析,並非投資建議。
來源:FuriosaAI宣布相關報導(Korea Herald,2026年8月5日);歐盟執委會InvestAI與AI超級工廠計畫文件(2026年7月);I/ONX HPC Symphony SixtyFour平台資料。
📩 訂閱 VLSI Korea 電子報
每日半導體深度分析,第一時間寄到您的信箱。免費訂閱。


