 VLSI Korea
HBM4E引爆記憶體階層戰爭:SK海力士對決三星,誰來定義「後HBM」時代標準
SK海力士與三星在SEDEX 2026同步發表HBM4E,規格不分軒輊,真正的較量是「後HBM記憶體階層」標準之戰。3D堆疊DRAM、HBF對決HBM5、客製化HBM、CXL、PIM——誰將掌握AI記憶體下一個十年的經濟學。


30秒摘要
SK海力士與三星電子於2026年10月14日在首爾COEX舉行的SEDEX 2026上同步發表HBM4E。兩家次世代HBM的每接腳速度均為14〜16 Gb/s,實屬同一級別。真正的較量不在HBM4E的規格表,而是「誰來定義HBM之後的記憶體階層」。SK海力士押注「高度」——以3D堆疊DRAM與HBF(High Bandwidth Flash,高頻寬快閃記憶體)新增階層;三星則押注「速度+全棧」——HBM5、客製化HBM、CXL、PIM與大容量企業級SSD。在AI基礎設施預計2030年較2026年擴張約20倍的前景下(SK海力士,2026年10月14日),寫下後HBM標準的人,將掌握未來十年AI記憶體經濟學。
背景:HBM4E,規格戰的終結
2026年10月14日,SEDEX 2026開幕日。SK海力士與三星電子的展位並排掛出同一個詞:HBM4E。SK海力士HBM4E每接腳16 Gb/s,功耗較HBM4降低20%以上,12層堆疊樣品早在2026年6月即已出貨。三星HBM4E每接腳14〜16 Gb/s,頻寬最高達3.6 TB/s,採用1c世代DRAM搭配4奈米基礎裸晶。
| 項目 | SK海力士 HBM4E | 三星 HBM4E |
|---|---|---|
| 每接腳速度 | 16 Gb/s | 14〜16 Gb/s |
| 峰值頻寬 | 約2.0 TB/s(12層換算)* | 最高3.6 TB/s |
| 功耗 | 較HBM4降低20%以上 | 未公開(強調低功耗設計) |
| DRAM世代 | 未公開 | 1c世代 |
| 基礎裸晶 | 未公開 | 4奈米邏輯 |
| 12層樣品 | 2026年6月出貨 | SEDEX 2026公開 |
| 發表時點 | SEDEX 2026(10/14) | SEDEX 2026(10/14) |
*SK海力士未公開峰值頻寬。16 Gb/s每接腳 × 1024位元介面約等於2.0 TB/s。
規格一字排開,結論只有一個:**HBM4E已不再是技術差異化的武器。**接腳速度、功耗、堆疊層數,兩家都在半年內的差距內互相追上。記憶體產業的HBM競爭,已從「標準規格之戰」進入「誰來書寫下一個標準之戰」。事實上,HBM4E在2027年之前幾乎無法緩解供給——每堆疊DRAM晶粒數增加、基礎裸晶要求最先進邏輯製程、客戶端重新認證(qualification)週期重新啟動。HBM4的2027年合約價預估年增121%(《韓國經濟日報》,2026年,引述產業報導),正源於此結構。供給短缺、需求熾熱——這種結構不是一代HBM的規格提升就能打破的。
同日在SEDEX發表主題演講的SK海力士社長安鉉(Ahn Hyun)如此表示:「HBM alone is not enough.」AI基礎設施到2030年必須較2026年膨脹約20倍,代理式AI(agentic AI)正引爆詞元(token)用量,KV-cache資料搬移成為新瓶頸,而驅動成長的引擎是推論(inference)而非訓練。一句話總結:瓶頸已從HBM頻寬,轉移到整個記憶體階層的架構。
商業深掘:標準戰爭的實質
新的記憶體階層——SK海力士描繪的地圖
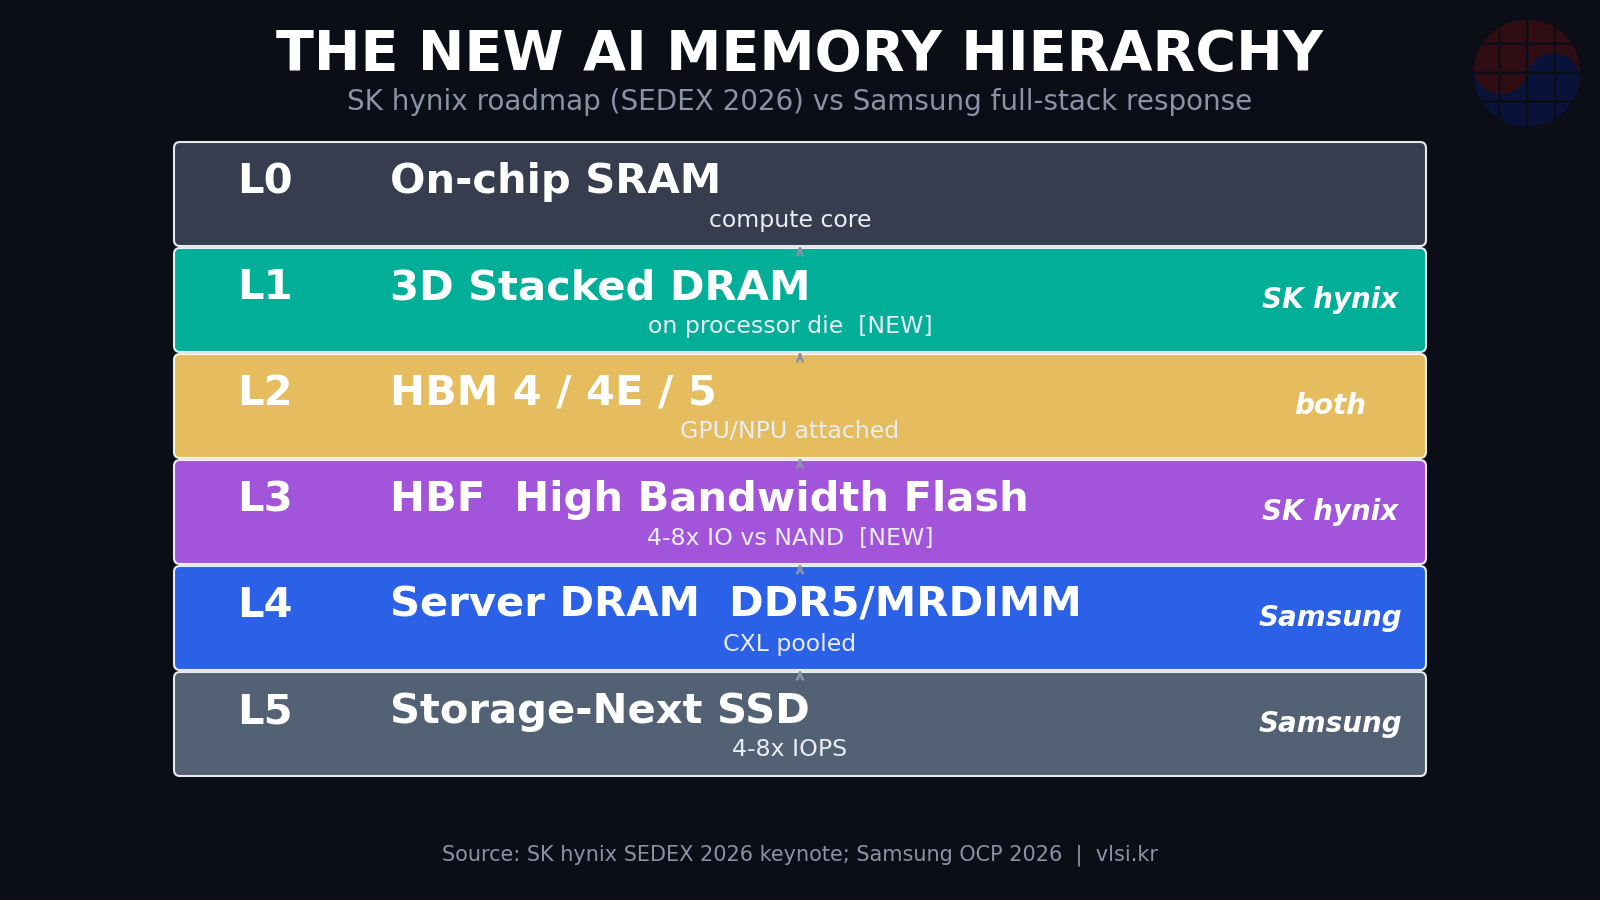
安鉉社長路線圖的核心是「新增階層」。過去的結構相對單純:片上SRAM → HBM → 伺服器DRAM → SSD。SK海力士提出的新階層如下:
| 階層 | 技術 | 角色 | 商業意義 |
|---|---|---|---|
| L0 | 片上SRAM | 運算核心直連快取 | 邏輯業者領域(不變) |
| L1(新增) | 3D堆疊DRAM | DRAM晶粒直接堆疊於處理器晶粒之上 | TSV堆疊技術的延伸,邏輯—記憶體邊界崩解 |
| L2 | HBM(HBM4/HBM4E/HBM5) | GPU/NPU直連高頻寬記憶體 | 標準戰爭的中心,客製化改變利潤結構 |
| L3(新增) | HBF(High Bandwidth Flash) | 較現行NAND高4〜8倍IO | NAND陣營對DRAM主導AI記憶體秩序的反擊 |
| L4 | 伺服器DRAM(DDR5/MRDIMM) | 大容量主記憶體 | CXL記憶體池化改變利用率經濟學 |
| L5 | Storage-Next企業級SSD | 較現行高4〜8倍IOPS | 儲存與記憶體的邊界日益模糊 |
這張表中投資人應關注L1與L3。3D堆疊DRAM是把HBM的TSV堆疊技術拉進處理器封裝內部,可直接複用SK海力士在HBM累積的堆疊與散熱管理 know-how。HBF更大膽:把NAND從「儲存」升格為「記憶體階層的一員」,是NAND業者擠進DRAM中心AI記憶體序列的唯一通道——應解讀為NAND陣營的反擊宣言。
三星的應對:速度+全棧
三星電子在10月12〜15日於美國聖荷西舉行的OCP Global Summit 2026上,與AMD共同展示CXL記憶體擴充,描繪了另一幅圖景。三星戰略有三根支柱:
- 速度(Speed):HBM5,以及在基礎裸晶嵌入客戶專屬邏輯的客製化HBM——結合三星晶圓代工(4奈米級基礎裸晶)與記憶體IDM優勢的一張牌。
- 容量擴充(Capacity):基於CXL的記憶體池化,讓多顆加速器共享伺服器DRAM,提升利用率。
- 儲存(Storage):大容量企業級SSD——從記憶體到儲存一站購足的「一站式」提案。
其上再疊加PIM(processing-in-memory,記憶體內運算)技術,把運算搬進記憶體,從根本上減少資料搬移。
| 戰略軸 | SK海力士 | 三星 |
|---|---|---|
| 核心賭注 | 高度(Height):新增階層(3D DRAM、HBF) | 速度+全棧:HBM5、客製化HBM、CXL、PIM、SSD |
| 差異化來源 | HBM堆疊技術的延伸、NAND子公司(Solidigm)連動 | 晶圓代工+記憶體IDM、基礎裸晶邏輯設計 |
| 客戶對應 | 客製化HBM(基礎裸晶內嵌客戶邏輯) | 客製化HBM+代工連動的一站式方案 |
| NAND戰略 | 以HBF把NAND納入記憶體階層 | 以大容量SSD強化儲存領導地位 |
| 弱點 | 邏輯設計能力(基礎裸晶)遜於三星 | HBM市占率落後SK海力士 |
利潤結構的變化:客製化HBM改變遊戲規則
兩家同步推出的「客製化HBM」,是這場標準戰爭中最被低估的變數。傳統HBM接近大宗商品(commodity):規格固定、價格固定、同一產品賣給眾多客戶。客製化HBM在基礎裸晶嵌入客戶專屬邏輯(控制器、安全、介面最佳化等),是從大宗商品走向客戶專屬矽晶片的移動。
對利潤結構有三層意涵:
第一,定價能力強於標準品。客戶專屬設計產生轉換成本(switching cost),加深供應商鎖定(vendor lock-in)。第二,基礎裸晶的邏輯設計能力成為記憶體業者的核心競爭力——這是擁有晶圓代工與邏輯設計資產的三星更有利的戰場,SK海力士必須從外部引入邏輯設計能力。第三,標準HBM與客製化HBM的二元化使供應鏈複雜化。同一代HBM4E若因客戶而異基礎裸晶,生產計畫與庫存管理難度上升,進而再度推升價格上漲壓力。2027年HBM4合約價年增121%預估的背後,也有這類結構性因素。
CXL池化:利用率的經濟學
基於CXL的記憶體池化開啟「記憶體利用率」的新經濟學。AI伺服器中記憶體按加速器分配,但實際利用率起伏劇烈——某顆GPU記憶體告罄,隔壁GPU卻閒置。透過CXL共享記憶體池,可在減少整體記憶體採購量的同時緩解瓶頸。
對超大規模雲端業者(hyperscaler)而言是TCO(總持有成本)削減的牌;對記憶體業者則是雙面刃:短期內每伺服器記憶體搭載量可能下降,但長期開啟「記憶體池」新市場,並帶動CXL控制器、交換器等新元件需求。三星在OCP與AMD共同展示的原因正在於此:標準不是一個人能制定的。與掌握生態系鑰匙的人共同展示,提案才能成為標準。
市場脈絡:記憶體已超過半導體的一半
產業研究估計,記憶體將占2026年整體半導體營收約54%,較2025年的27%近乎翻倍——每台AI加速器中HBM的金額占比膨脹的結果。這正是記憶體業者競逐「AI記憶體階層定義者」的原因。定義標準者制定價格、規格、認證的規則,制定規則者決定利潤。
Chase's Take:高度 vs 全棧,誰來書寫標準
這場戰爭的本質不是技術,而是標準制定權(standard-setting power)。回顧歷史:DRAM標準名義上由JEDEC制定,但實務上先量產、先通過認證的業者成為標準的實質作者。HBM亦然——SK海力士先把HBM3、HBM3E交給NVIDIA,實質寫下標準,三星在後追趕。
這次形勢不同。SK海力士在「HBM之後」這張白紙上先畫了圖。3D堆疊DRAM與HBF是現行JEDEC標準中不存在的新階層:先定義、先出樣品、先與客戶結盟——那就是標準。三星則反其道而行,在「已驗證的戰場」對決:HBM5的速度、客製化HBM的彈性、CXL生態系、PIM、SSD——單拎任何一項都擋不住SK海力士的新階層攻勢,但以全棧打包,就成為對客戶(尤其超大規模業者)的套裝提案:「把記憶體的煩惱交給我們。」
從韓國視角看頗富意味:兩家都是韓國的國家冠軍。過去DRAM削價競爭時代,彼此的擴產就是對方的價格崩盤;如今兩家卻舉著不同標準,為世界AI記憶體秩序各自繪製藍圖。韓國記憶體雙頭壟斷為全球AI基礎設施繪製設計圖的時代已經到來。但風險同樣清晰:階層越多,系統複雜度與認證負擔越重。HBF能否在真實工作負載中克服NAND的先天限制(耐久度、延遲)、3D堆疊DRAM的散熱問題由誰解決,都尚未被證明。三星的PIM多年來也是「展示精彩、量產未至」的技術。標準戰爭的贏家,很可能不是「最美的簡報」,而是「最先量產的最現實圖景」。
反方論點也值得一提:有人認為HBM4E、HBM5這類漸進式改良足以應付推論需求;若KV-cache瓶頸真趨嚴重,模型架構(注意力機制最佳化、量化)會先改變。有其道理。但對記憶體業者而言那是「等待的戰略」——等待期間,標準制定權就落入他人之手。這正是SK海力士與三星同時出手的原因。
投資與經營啟示
投資人視角: - 在記憶體超過半導體營收一半的結構下,定義HBM之後階層的業者享有結構性溢價。應追蹤路線圖執行力(3D DRAM、HBF、CXL量產時點),而非HBM4E規格的短期交易。 - 客製化HBM普及推升記憶體業者毛利率,但缺乏基礎裸晶邏輯設計能力的業者,將新增委外設計成本這一成本項目。價值鏈受益向邏輯設計、CXL控制器、先進封裝(OSAT/設備)擴散。 - HBM4的2027年合約價年增121%預估是記憶體業者的業績上行因素,同時也是觸發超大規模業者為緩解TCO壓力而加速CXL池化與架構最佳化的開關。須監控價格上漲轉為需求破壞的臨界點。
經營者視角: - 建置或營運AI基礎設施的企業,應把記憶體採購戰略從「買HBM」升級為「設計記憶體階層」。CXL池化導入時點、HBF成熟度、客製化HBM認證前置時間,都成為採購路線圖的變數。 - 對無晶圓廠(fabless)與系統業者而言,基礎裸晶客製化能力是新的談判籌碼。買標準HBM與共同設計客製化HBM,供應鏈權力關係截然不同。 - 對NAND業者而言,HBF是打破「儲存裝置」框架的機會:併入DRAM中心的序列,或以SSD升級走獨立路線——抉擇的岔路口已至。
FAQ
Q1. HBM4E與HBM4有何不同? HBM4E是HBM4的延伸(Extended)世代,每接腳速度提升至16 Gb/s級,電源效率改善。SK海力士主打較HBM4降低20%以上功耗,三星主打最高3.6 TB/s頻寬與4奈米基礎裸晶。但規格差距不大,HBM4E之後的路線圖(HBM5、客製化HBM、新記憶體階層)比HBM4E本身更重要。
Q2. 什麼是HBF(High Bandwidth Flash)? SK海力士在SEDEX 2026提出的新記憶體階層,目標是現行NAND快閃記憶體4〜8倍的IO頻寬。位於HBM與伺服器DRAM之間,瞄準大規模推論工作負載的KV-cache等場景。把NAND從「儲存」升格為「記憶體階層」的嘗試,可解讀為NAND陣營對DRAM主導AI記憶體秩序的挑戰。
Q3. 為何CXL記憶體池化重要? 透過CXL(Compute Express Link)讓多顆加速器共享記憶體池,可吸收各加速器記憶體利用率的落差,減少整體記憶體採購量。它是超大規模業者的TCO削減牌,也是為記憶體業者開啟新市場(CXL控制器、交換器)的技術——這正是三星在OCP 2026與AMD共同展示的背景。
Q4. 「後HBM」標準戰爭的勝負如何判定? 三個標準:第一,量產時點——不是展示,而是誰先通過客戶認證、先放量;第二,生態系——能否與超大規模業者、GPU業者共同制定標準;第三,經濟性——新階層是否真正降低TCO。能運轉的矽晶片,勝過美麗的路線圖。
免責聲明:本文數值與預測基於截至2026年10月17日的公開資料與產業報導,實際產品規格與量產時程可能變動。


