 VLSI Korea
美光結束20年研究,轉向3D DRAM (vHBM・400層NAND路線圖)
美光結束測試約20年的4F-square,將資本轉向3D DRAM。密度提升25%的1-delta、導入鍵合的1-epsilon、高數值孔徑EUV的zeta、vHBM與HBM4E條件,以及超過400層的G11 NAND,本文拆解這份路線圖發言。


美光放棄測試約20年的4F-square儲存單元架構,並將未來資本轉向3D DRAM、晶圓鍵合與400層以上NAND — 以下內容全數為2026年10月22日報導的美光路線圖發言,並非已出貨產品。
30秒摘要
- 美光在測試約20年後結束4F-square cell architecture,並將未來資本轉向3D DRAM (美光路線圖發言,2026年10月22日報導)。
- DRAM路線圖自1-delta出發:第七代10奈米級製程,處於良率生產階段,密度提升25%;接著是導入晶圓鍵合的1-epsilon、使用高數值孔徑EUV的首個10奈米以下節點zeta angstrom (初期開發),以及採用實驗材料的eta angstrom。
- HBM方面,美光提出垂直架構vHBM (vertical HBM)。HBM4在美光的功耗與效能目標上不需要更先進的CMOS,但HBM4E將會需要。
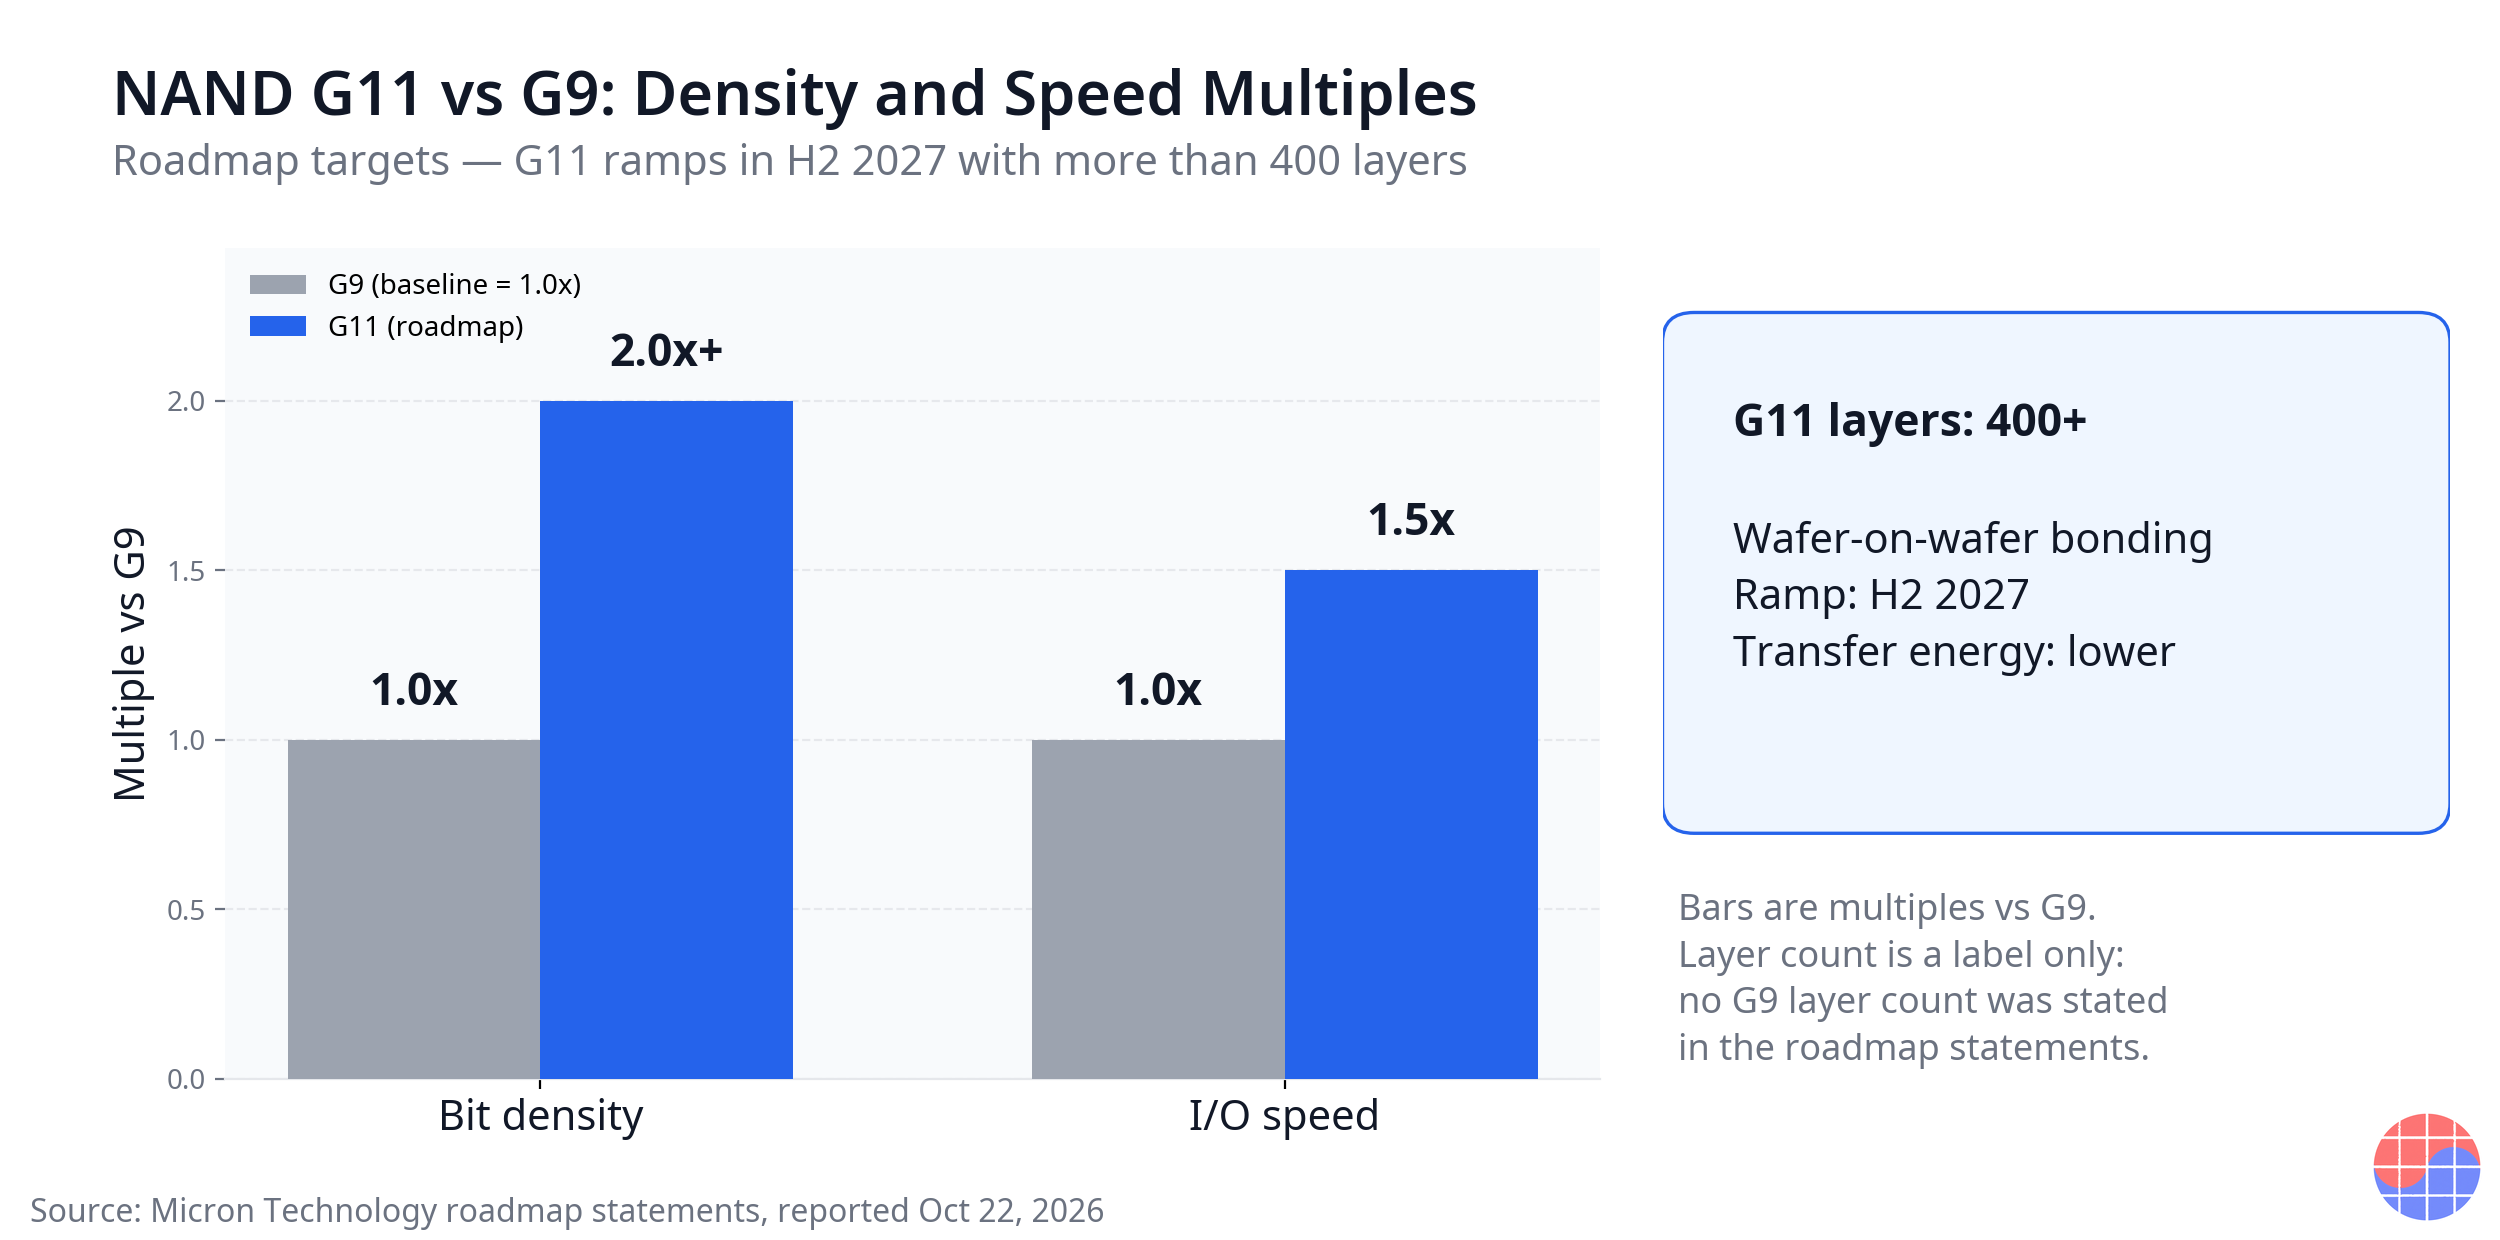
- NAND G11規劃於2027年下半年量產爬坡,超過400層,採用wafer-on-wafer鍵合,位元密度為G9的2倍以上,I/O速度1.5倍,傳輸能耗更低。AI級NAND分為兩路:高IOPS的SLC small-block設計,以及以TSV堆疊NAND並將邏輯晶粒放在運算單元附近的high-bandwidth NAND。
Background
記憶體微縮長久以來的預設很簡單:把平面結構做得更小。儲存單元排得更密、微影印得更精準,同一片晶圓就能得到更多位元。美光測試約20年的4F-square,正屬於這個平面傳統。它試圖把儲存單元面積推近理論下限,但經過多年測試,始終沒有成為量產路徑。
在2026年10月22日報導的路線圖發言中,美光改變的正是這個預設。公司不再只從平面版圖中擠出更多,而是把資本方向轉向向上堆疊結構、把晶圓互相鍵合、把邏輯以三維方式重新排列。這個轉向不限於DRAM。同一份路線圖還包括HBM的垂直化、伺服器RDIMM的容量擴大、超過400層的NAND,以及專為AI系統設計的NAND。它不只是一項製程決定,更接近涵蓋整個記憶體產品組合的結構重置。
全文必須守住一個前提:這裡談的全部是路線圖發言。有些項目已經進入良率生產,例如1-delta;有些則早得多:zeta angstrom處於初期開發,eta angstrom在其之後,G11的量產爬坡規劃在2027年下半年。路線圖由公司本身提出,對於方向與順序具有真實資訊價值;但它不保證量產、出貨或營收,閱讀時必須保留這段距離。
Business Deep Dive
DRAM節點路線圖:從平面走向3D
| 節點 | 階段 (依路線圖發言) | 關鍵變化 |
|---|---|---|
| 1-delta | 良率生產中 | 第七代10奈米級,密度提升25% |
| 1-epsilon | 後續節點 | 導入晶圓鍵合 |
| zeta angstrom | 初期開發 | 首個10奈米以下節點,使用高數值孔徑EUV |
| eta angstrom | zeta之後 | 採用實驗材料 |
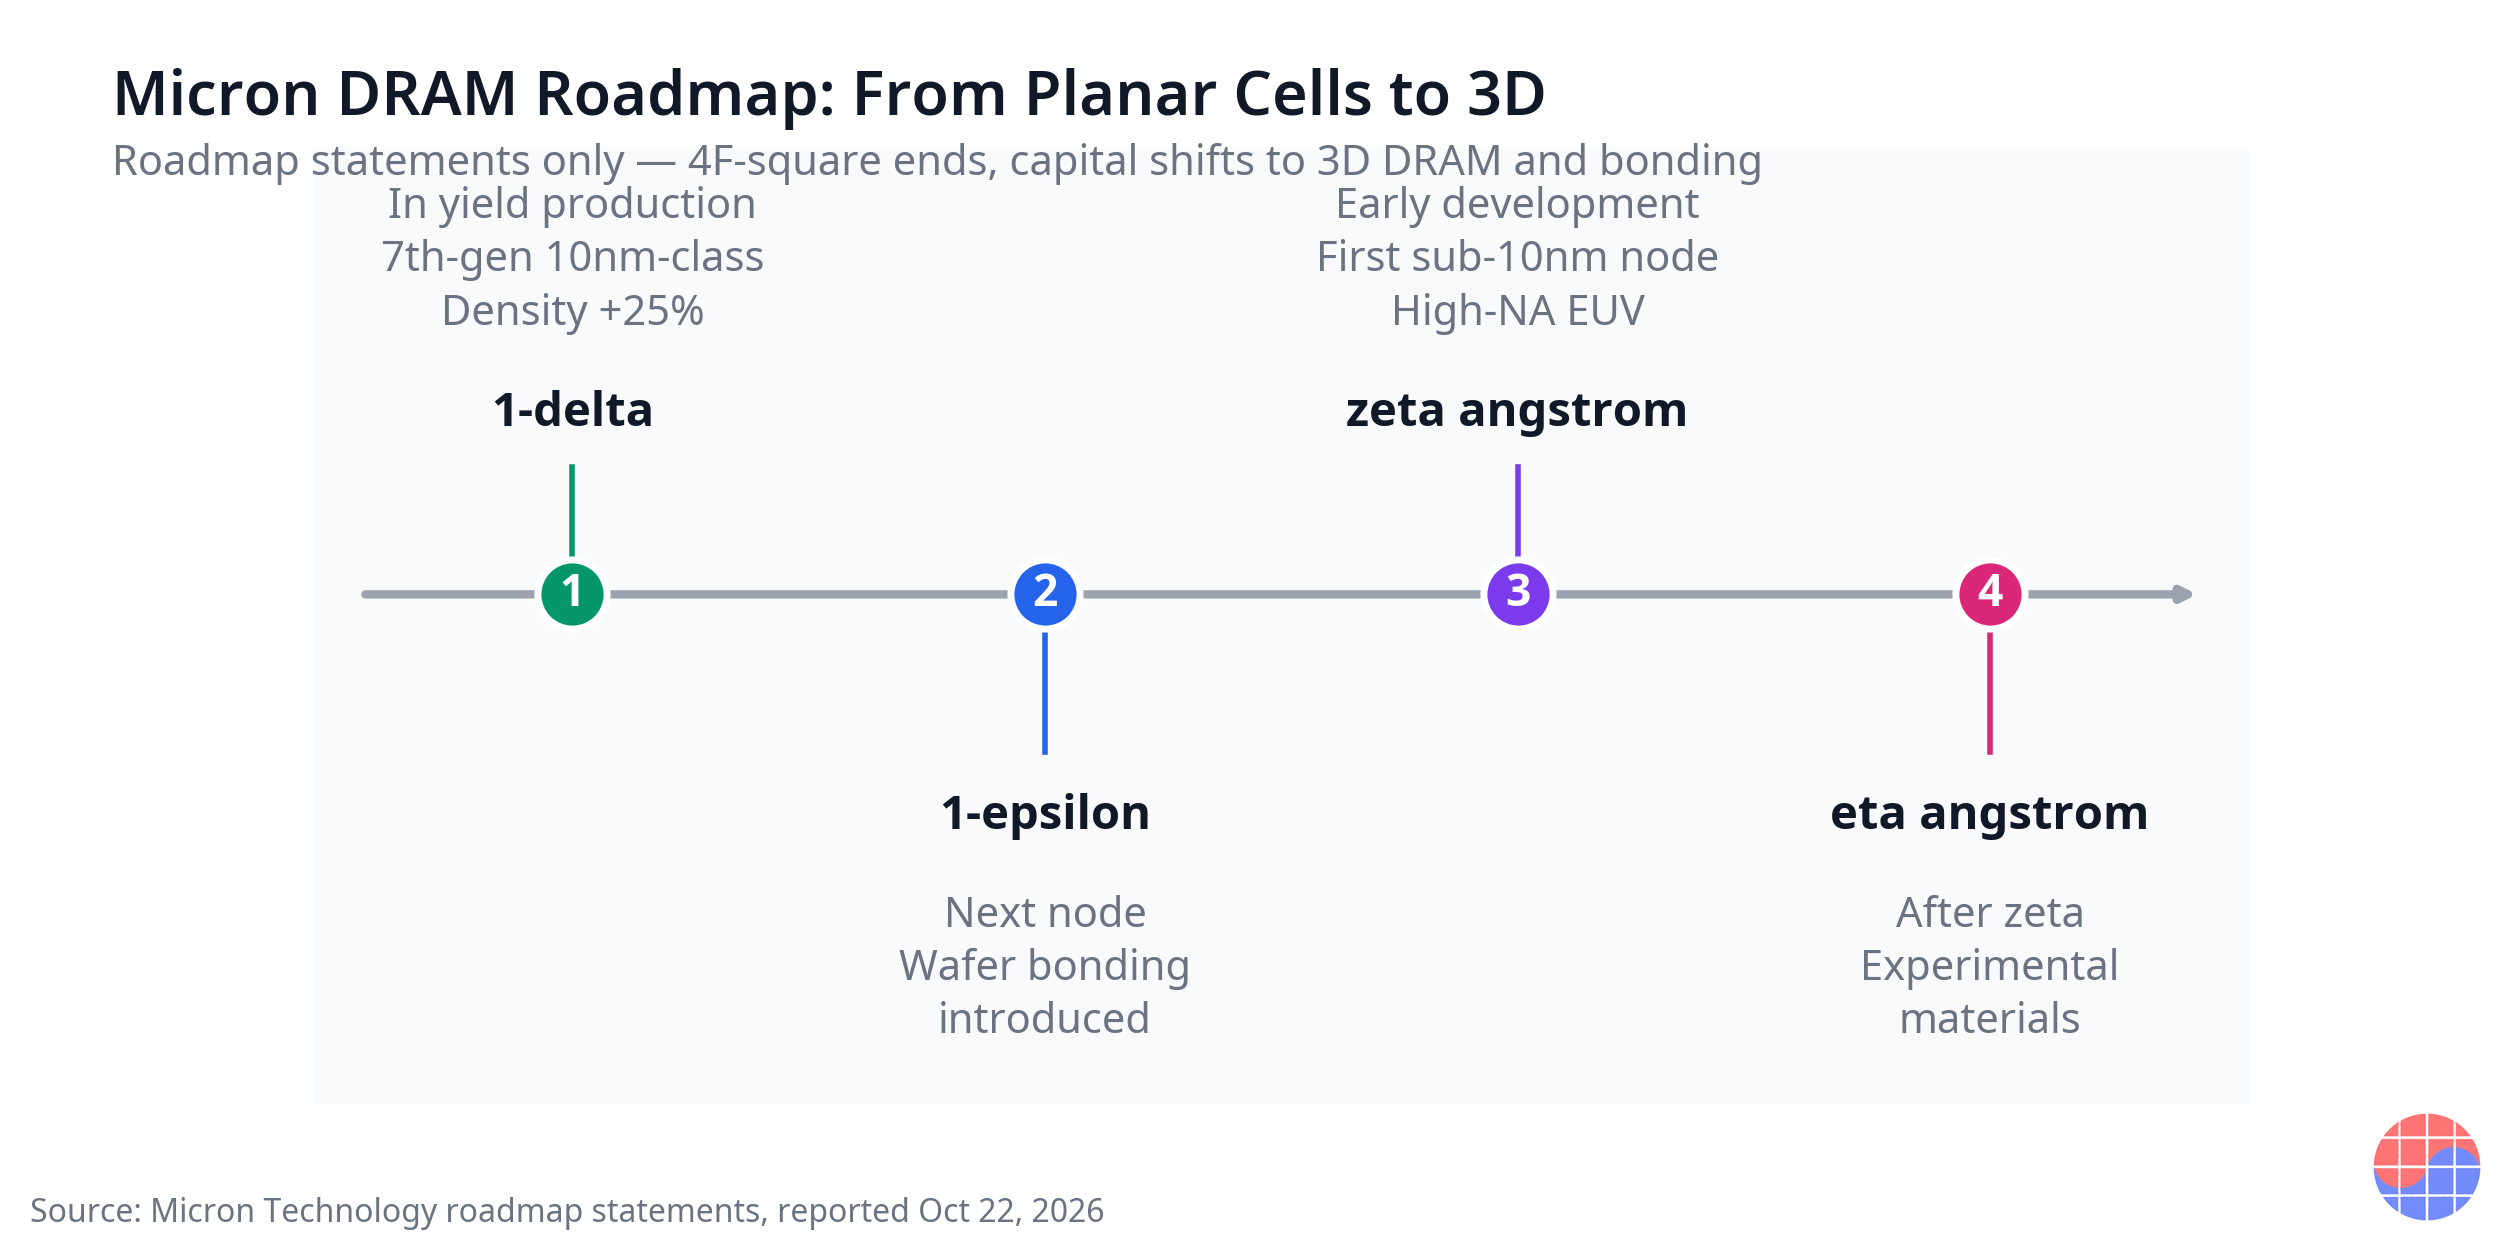
路線圖的起點是生產,而非概念。1-delta是第七代10奈米級節點,處於良率生產階段,密度提升25%。這個錨點很重要:美光描述的序列,是從一個已經在生產的節點開始,而不是從遙遠的研究目標開始。
下一步1-epsilon導入晶圓鍵合。把兩片晶圓鍵合在一起,原本是影像感測器、NAND與先進封裝中的主流技術;把它明確寫入DRAM主線路線圖,才是變化所在。其後是zeta angstrom,美光首個10奈米以下節點,目前處於初期開發,將圍繞高數值孔徑EUV打造。eta angstrom接在zeta之後,採用實驗材料。名稱進入angstrom單位本身,就說明公司如何構想10奈米級標示之後的時代。
節點名稱之外,還有一項結構變化:DRAM的CMOS邏輯正移向3D排列。重點不只是堆疊儲存單元;如果驅動儲存單元的邏輯也以三維方式重新排列,設計者就能一併重新思考繞線長度、面積與電源路徑。把這一點與4F-square的結束放在一起,圖像是一致的:重心從縮小平面儲存單元,移向鍵合與3D邏輯。
HBM:vHBM與HBM4E的CMOS條件
HBM的關鍵詞是vHBM,也就是vertical HBM architecture。HBM本身已經以TSV垂直堆疊DRAM晶粒;美光放上路線圖的,是在垂直方向再往前一步的架構。這次發言沒有提供vHBM的堆疊方式或數字,因此可支持的結論只到方向為止:HBM的下一階段競爭,正在成為結構之爭,而不只是頻寬數字之爭。
CMOS的說法按世代分開。HBM4在美光的功耗與效能目標上,不需要更先進的CMOS;但HBM4E將會需要。這一句話之所以重要,是因為公司本身承認,瓶頸正從DRAM儲存單元移向包括基礎裸晶在內的邏輯CMOS。這也解釋了為何3D DRAM與DRAM CMOS邏輯的3D排列會出現在同一份路線圖上。從HBM4E世代起,記憶體業者的競爭力將由儲存單元微縮、邏輯設計與鍵合技術的總和來評斷,而不再只是儲存單元微縮。
伺服器與行動記憶體:LPDDR6、DDR6與1TB RDIMM
| 產品 | 路線圖發言 | 比較基準 |
|---|---|---|
| LPDDR6 | 功耗改善35% | 相較LPDDR5 |
| DDR6 | 頻寬2倍 | 相較DDR5 |
| DDR5 RDIMM | 512GB模組近期已送樣 | 目前步驟 |
| 下一代RDIMM | 規劃1TB RDIMM | 在512GB送樣之後 |
路線圖也給出產品層級的數字。LPDDR6的功耗比LPDDR5改善35%,DDR6的目標是DDR5的2倍頻寬。伺服器方面,美光近期已送樣512GB DDR5 RDIMM,並規劃其後的1TB RDIMM。當AI伺服器對每台系統的記憶體容量與頻寬需求持續上升,RDIMM容量翻倍,會改變設計者在機櫃層級能配置的總記憶體池。這裡同樣要守住紀律:這些都是目標與規劃,送樣不等於量產,規劃不等於出貨。
📩 在持續關注這個主題嗎?
財報·報告·HBM供需的後續分析,每天10:30(KST)寄到您的信箱。 免費訂閱 →
NAND G11:超越400層的爬坡規劃
| 項目 | G9 (基準) | G11 (路線圖) |
|---|---|---|
| 層數 | 基準世代 | 超過400層 |
| 位元密度 | 1.0倍 (基準) | 2倍以上 |
| I/O速度 | 1.0倍 (基準) | 1.5倍 |
| 傳輸能耗 | 基準 | 更低 |
| 鍵合方式 | — | wafer-on-wafer鍵合 |
| 爬坡時點 | — | 2027年下半年 |
NAND的中心是G11。量產爬坡規劃在2027年下半年,層數超過400層,採用wafer-on-wafer鍵合。效能目標是位元密度達到G9的2倍以上、I/O速度1.5倍、每次傳輸的能耗更低。NAND的層數競爭長期是堆疊高度之爭;G11發言的不同之處,在於明確把位元密度翻倍與wafer-on-wafer鍵合綁在一起。如果儲存單元晶圓與周邊電路晶圓分開製作再鍵合,每片晶圓都能按自己的製程最佳化,而不是把兩者塞進同一套互相妥協的流程。
AI級NAND:速度層與頻寬層
AI資料中心對NAND的要求也在改變。美光提出的AI級NAND有兩路。第一路是高IOPS的SLC small-block設計,它優先追求每秒輸入輸出次數與反應速度,而不是原始容量,適合快取、中繼資料與其他高頻存取層。第二路是high-bandwidth NAND:以TSV堆疊NAND晶粒,並把邏輯晶粒放在運算單元附近。這個設計把NAND從廉價的大容量儲存,重新定義為貼近處理器的另一層記憶體。兩路都還只是路線圖階段的設計方向,不是產品;但作為訊號,它們很清楚:在AI基礎設施中,儲存與記憶體的邊界正在模糊。
Chase's Take
這份路線圖中最重的決定不是推出,而是取消。結束一條走了約20年的研究路徑,既是技術判斷,也是資本配置決定。研究組織在結構上很難親手終結自己長跑多年的路徑:已經投入的金額很大,成功時的圖像又很鮮明,兩者都在主張再多給一年。美光公開表示,它願意承認這筆沉沒成本,把有限資本改投向鍵合與3D結構。以管理角度看,這個取消所含的資訊,比清單上任何單一新技術都多,因為它回答了公司打算在哪裡建立未來10年的成本結構。
成本結構本身也在移動。當鍵合與3D成為中心,競爭軸就從微影微縮的速度,擴大到鍵合良率、堆疊對位與邏輯整合。設備訂單的組成隨之改變。包括高數值孔徑EUV在內的最先進微影的重要性,在zeta這一步其實上升;同時,鍵合、量測與檢測設備也進入DRAM主線流程。對設備業者而言,記憶體業者改路線圖,也就等於改訂單內容。
另一個管理問題是廣度。美光同時推進DRAM、HBM與NAND,而且每一項都推進到結構改變的層級。廣度讓公司能整體面對AI基礎設施,但也分散資本與組織焦點。窄化焦點能提高單一領域做深的機會,卻在市場轉向時失去緩衝。這份路線圖選擇的是廣度,並在每個領域內部做結構改變。這個選擇是否成立,不會由發表本身決定;它將由1-epsilon的鍵合良率、美光如何取得HBM4E所需的先進CMOS,以及G11爬坡是否真的落在2027年下半年來決定。
對韓國競爭對手而言,要看的是競爭文法的改變。當競爭從儲存單元微縮擴大到鍵合與3D整合,結果中越來越大的部分,落在韓國記憶體業者已經建立的微縮領先之外。反過來說,誰先鎖定鍵合良率與邏輯整合,誰就同時拿下下一代的成本與效能。美光的取消不應只被讀成一家美國公司的決定;它是整個記憶體產業評斷標準正在移動的訊號。
Implications
- 看資本配置的先例。 結束20年研究路徑,會向每家記憶體業者提出同一個問題:維持一條老路徑的成本,與關閉它的成本,哪個更大?各公司的答案,將由未來的路線圖揭露。
- 設備訂單組成改變。 晶圓鍵合進入DRAM路線圖,NAND G11又以wafer-on-wafer為前提,鍵合、量測與檢測訂單在記憶體中的占比會結構性上升。高數值孔徑EUV的需求則與zeta這一步綁在一起。
- HBM競爭擴大為邏輯競爭。 HBM4E將需要更先進CMOS的發言,意味著基礎裸晶與邏輯設計能力,會隨著HBM世代推進成為更大的變數。vHBM這類結構提案也屬於同一脈絡。
- 把路線圖與出貨分開。 1-delta處於良率生產,zeta處於初期開發,G11爬坡是2027年下半年的規劃。投資與採購判斷應把每個項目放在自己的階段上讀,不能只憑這份路線圖推斷任何未來時點的供應量。
- AI儲存多出一層。 若高IOPS的SLC設計與貼近運算的high-bandwidth NAND實現,AI伺服器的記憶體與儲存層級,將比HBM、DRAM、NAND這熟悉的三層分得更細。系統設計與軟體最佳化的標準也會隨之改變。
FAQ
Q1. 美光放棄的4F-square是什麼,又由什麼取代? 4F-square是美光測試約20年的平面DRAM儲存單元架構。在2026年10月22日報導的路線圖發言中,美光表示將結束這條路徑,並把未來資本轉向3D DRAM。取代的軸線包括在1-epsilon導入的晶圓鍵合、DRAM CMOS邏輯的3D排列,以及垂直的vHBM架構。
Q2. DRAM節點路線圖如何從1-delta走到eta angstrom? 1-delta是第七代10奈米級節點,處於良率生產,密度提升25%。1-epsilon導入晶圓鍵合。zeta angstrom是首個10奈米以下節點,處於初期開發,使用高數值孔徑EUV。eta angstrom接在zeta之後,採用實驗材料。越後面的步驟開發越早期,這些發言都不是已確認的出貨時程。
Q3. 什麼是vHBM,HBM4與HBM4E的CMOS要求有何不同? vHBM是vertical HBM architecture,作為HBM垂直結構再往前一步的架構提出。在CMOS方面,美光表示HBM4在公司的功耗與效能目標上不需要更先進的CMOS,但HBM4E將會需要。本次發言範圍之外的世代效能數字,本文不作斷言。
Q4. NAND G11與AI級NAND的規劃是什麼? G11規劃於2027年下半年量產爬坡,超過400層,採用wafer-on-wafer鍵合,目標是位元密度達到G9的2倍以上、I/O速度1.5倍、傳輸能耗更低。AI級NAND提出兩路:高IOPS的SLC small-block設計,以及以TSV堆疊NAND晶粒並把邏輯晶粒放在運算單元附近的high-bandwidth NAND。以上全數為路線圖發言,並非已出貨產品。
來源
- Micron Technology,路線圖發言報導,2026年10月22日 — 4F-square結束與轉向3D DRAM;1-delta、1-epsilon、zeta angstrom、eta angstrom各節點;vHBM;HBM4E的CMOS要求;LPDDR6、DDR6與RDIMM規劃;NAND G11與AI級NAND方向
本文僅供資訊參考,不構成任何證券買賣建議。文中路線圖項目為公司發言之報導內容,並非已確認的量產或出貨時程。
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂


