 VLSI Korea
推論走SRAM、訓練靠HBM:5個事實 (Groq 3 LPX·Trainium3)
AI推論正在分裂。解碼轉向沒有HBM的SRAM晶片Groq 3 LPX,訓練留在每顆晶片HBM3e 144GB的Trainium3。以5個事實整理頻寬57倍與容量162倍的不對稱,以及站在兩側的三星。(截至2026年10月24日)


AI推論正分裂為兩條路線。對延遲敏感的解碼正轉向沒有HBM的SRAM晶片,訓練與預填充則原樣留在HBM容量之上。(截至2026年10月24日)
30秒摘要
- NVIDIA Groq 3 LPX已進入量產階段。LP30晶片不使用HBM,每顆晶片提供SRAM 500MB與150 TB/s頻寬 (NVIDIA發表,Hot Chips 2026,2026年8月24-25日)。
- 依自行計算,以機櫃為基準,記憶體頻寬由SRAM側約大57倍,記憶體容量則由HBM側約大162倍。這種不對稱正是分離的本質。
- 訓練陣營正以HBM容量固守。AWS Trainium3每顆晶片搭載HBM3e 144GB,2026年10月19日發表的TorchNeuron降低了PyTorch移植門檻 (AWS發表)。
- 三星站在分離的兩側。它一邊爭取HBM供應,一邊也是沒有HBM的LP30的唯一晶圓代工廠。
- SK海力士純粹曝險於HBM側,但短期HBM需求由訓練支撐。SRAM所限制的,只是推論之中為延遲支付溢價的解碼碎片而已。
背景
推論分為性質不同的兩個階段。預填充是一次讀入長輸入上下文的階段,運算量與記憶體容量至關重要。解碼則是逐一吐出詞元的階段,每生成一個詞元,都必須重新讀取整個模型權重。因此,解碼的速度事實上由記憶體頻寬與延遲決定。
至今,GPU與HBM的組合一直同時承擔這兩個階段。HBM容量大,但它是位於晶片之外的記憶體,在頻寬與延遲上存在物理限制。相反,SRAM位於晶片之內,頻寬壓倒性地快,但容量小,且佔用大量晶粒面積。這種權衡早已為人所知。第一代GroqChip主打SRAM 230MB與最高80 TB/s的晶片上頻寬 (Groq 2022年產品簡報,廠商規格),Cerebras WSE-3則以晶片上SRAM 44GB與21 PB/s頻寬,將同一哲學推到晶圓規模的極致 (Cerebras 2024年公開規格)。
改變格局的契機是一筆授權交易。Groq於2025年12月24日宣布與NVIDIA達成非獨占授權協議,創辦人Jonathan Ross與總裁Sunny Madra等核心團隊加入NVIDIA。Groq本身維持為獨立公司,由Simon Edwards擔任執行長,GroqCloud未包含在交易對象之中 (Groq發表,2025年12月24日)。交易規模約200億美元一事屬於報導內容,並非NVIDIA正式公開的金額。
深度解析:5個事實
- LPX已進入量產階段,晶片上沒有HBM。 NVIDIA在GTC 2026年3月公開Groq 3 LPX,並在Hot Chips 2026 (2026年8月24-25日) 宣布全面量產。LP30晶片提供每顆晶片SRAM 500MB、SRAM頻寬150 TB/s、晶片間鏈路96條且每條112 Gbps、每顆晶片擴展頻寬2.5 TB/s、晶片間延遲350ns (NVIDIA產品與技術資料)。以機櫃為單位,將256顆晶片綁入32個托盤,SRAM合計128GB、合計SRAM頻寬40 PB/s、擴展頻寬640 TB/s、FP8推論運算315 PFLOPS。在平台設計上,這是由Rubin GPU負責長上下文預填充與解碼注意力、由LPU負責解碼中對延遲敏感的前饋與MoE運算的異質配置 (NVIDIA設計)。依廠商主張,NVIDIA表示,LPX與Vera Rubin NVL72結合時,在兆級參數模型上,每百萬瓦的推論吞吐量最高可提升至35倍。在第三方基準測試中,以預先發布的Gemma 4 31B端點 (Google Cloud,上下文100k詞元,並發1,循序請求50次的中位數) 為基準,每秒輸出詞元達3,400個,約為該測試中最接近的替代平台的4倍 (Artificial Analysis測量,NVIDIA引用的結果)。有必要明確指出,這個數值是單一使用者的延遲測試結果,並非批次吞吐量測試。首位客戶是Nebius,雲端供應將透過AWS、Google Cloud、Microsoft Azure、Oracle於2026年下半年開始,NVIDIA表示。製造由Samsung Foundry 4nm獨家負責。Jensen Huang在GTC 2026年3月的舞台上表示,Samsung正在製造Groq 3 LPU晶片,出貨將於下半年、大約第三季開始,Samsung在2026年6月確認LP30正在生產中。根據2026年10月13日的報導,Samsung在OCP 2026展示了Groq LPU晶圓,晶片正在平澤量產。
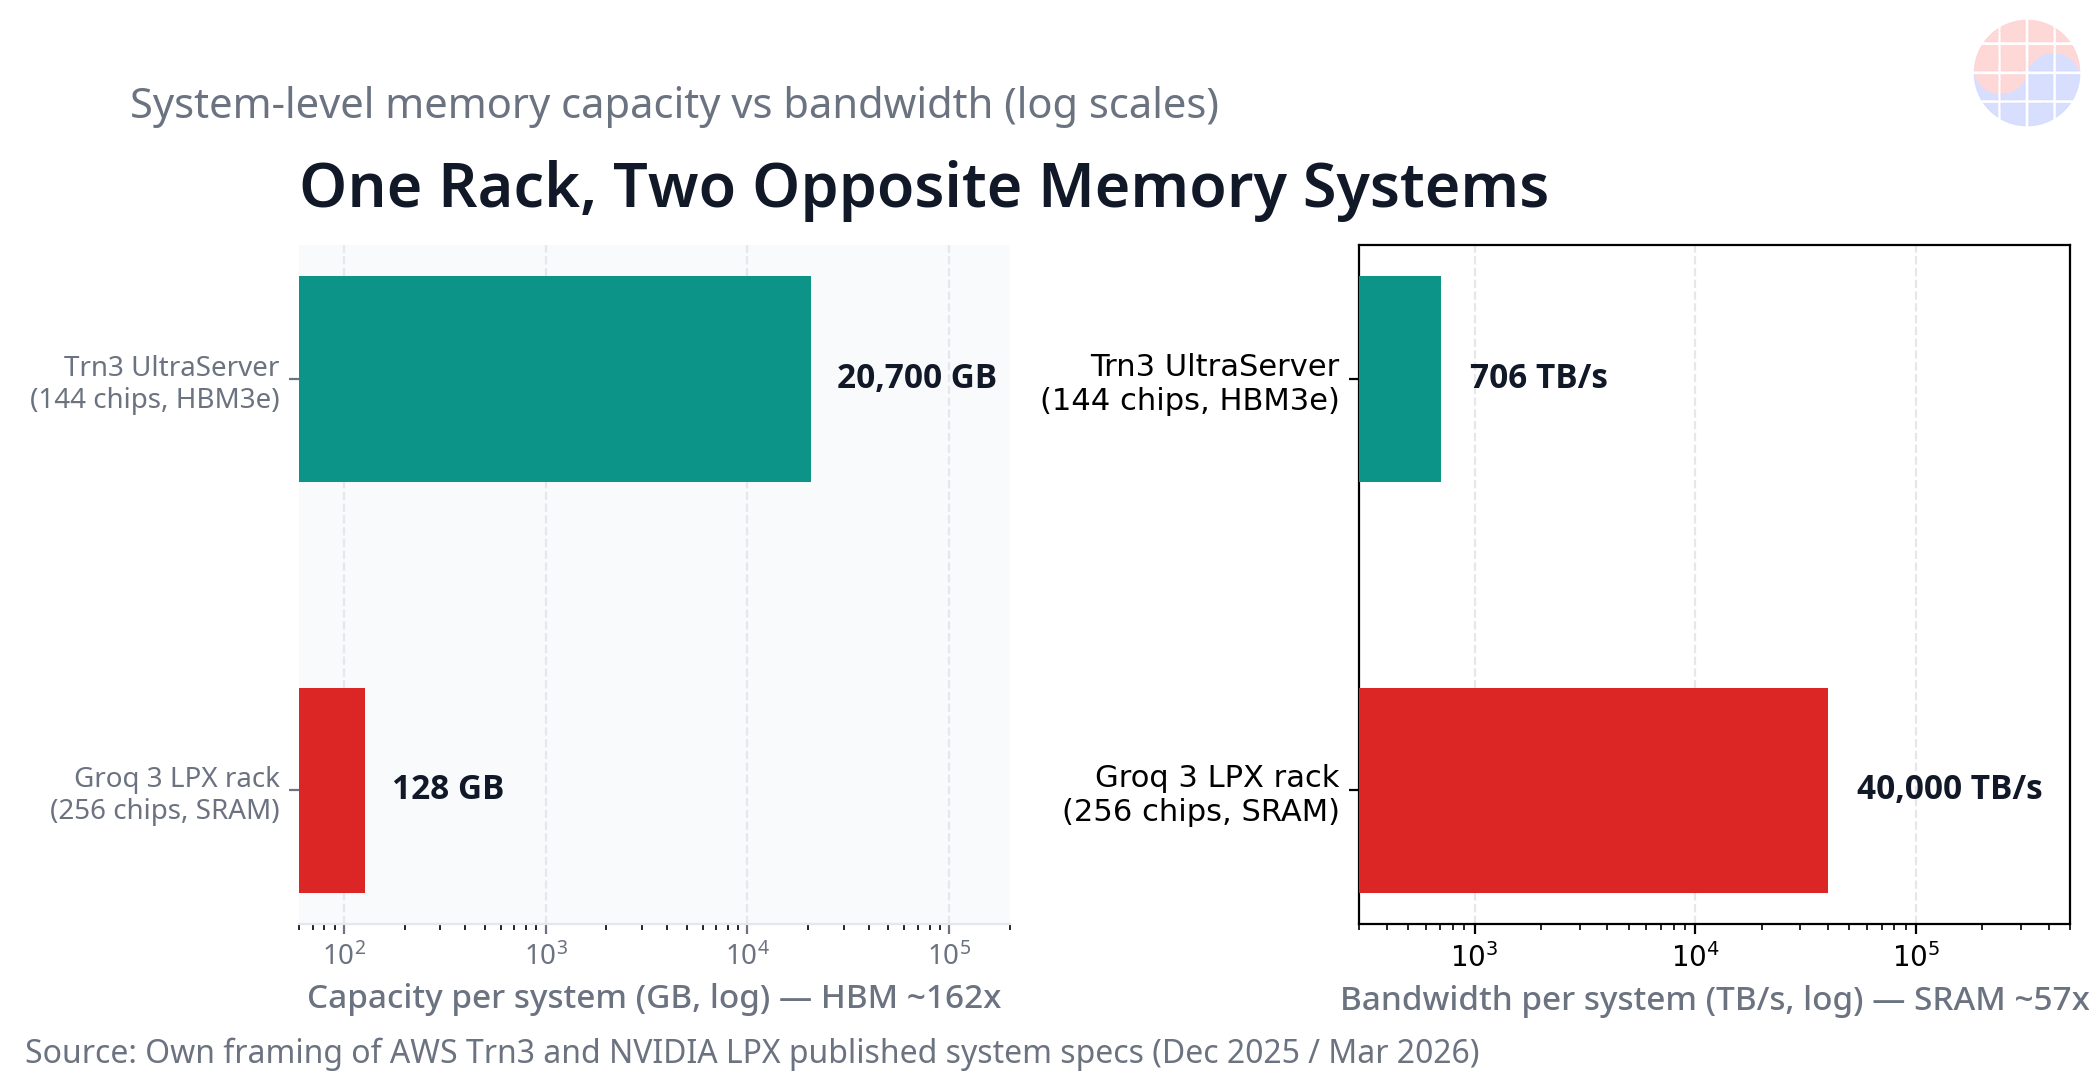
- 頻寬與容量的不對稱正是這場分離的本質 (自行計算)。 以晶片為單位比較,LP30的SRAM頻寬150 TB/s,約為Trainium3的HBM3e頻寬4.9 TB/s的31倍,約為H100的3.35 TB/s的45倍。擴大到機櫃單位,LPX的40 PB/s,也就是40,000 TB/s,約為Trn3 UltraServer合計頻寬706 TB/s的57倍。然而在容量上,圖像正好反轉。Trn3 UltraServer的HBM 20.7 TB,約為LPX機櫃SRAM 128GB的162倍。即使在只看權重的適配計算 (以FP8為基準、每參數1位元組、不含KV快取) 中,這種不對稱也原樣顯現。70B模型的權重為70GB,可以放入1台LPX機櫃,但405B模型為405GB,至少需要4台,一兆參數模型為1,000GB,至少需要8台。相反,三個模型都可以放入1台Trn3 UltraServer,而且留有很大餘裕。與第一代GroqChip (SRAM 230MB) 僅70B模型的權重就需要約305顆晶片相比,LP30的500MB在容量的牆面前依然顯得小。總而言之,SRAM在頻寬上勝出,HBM在容量上勝出,兩者並非一方取代另一方的關係 (截至2026年10月24日自行計算)。
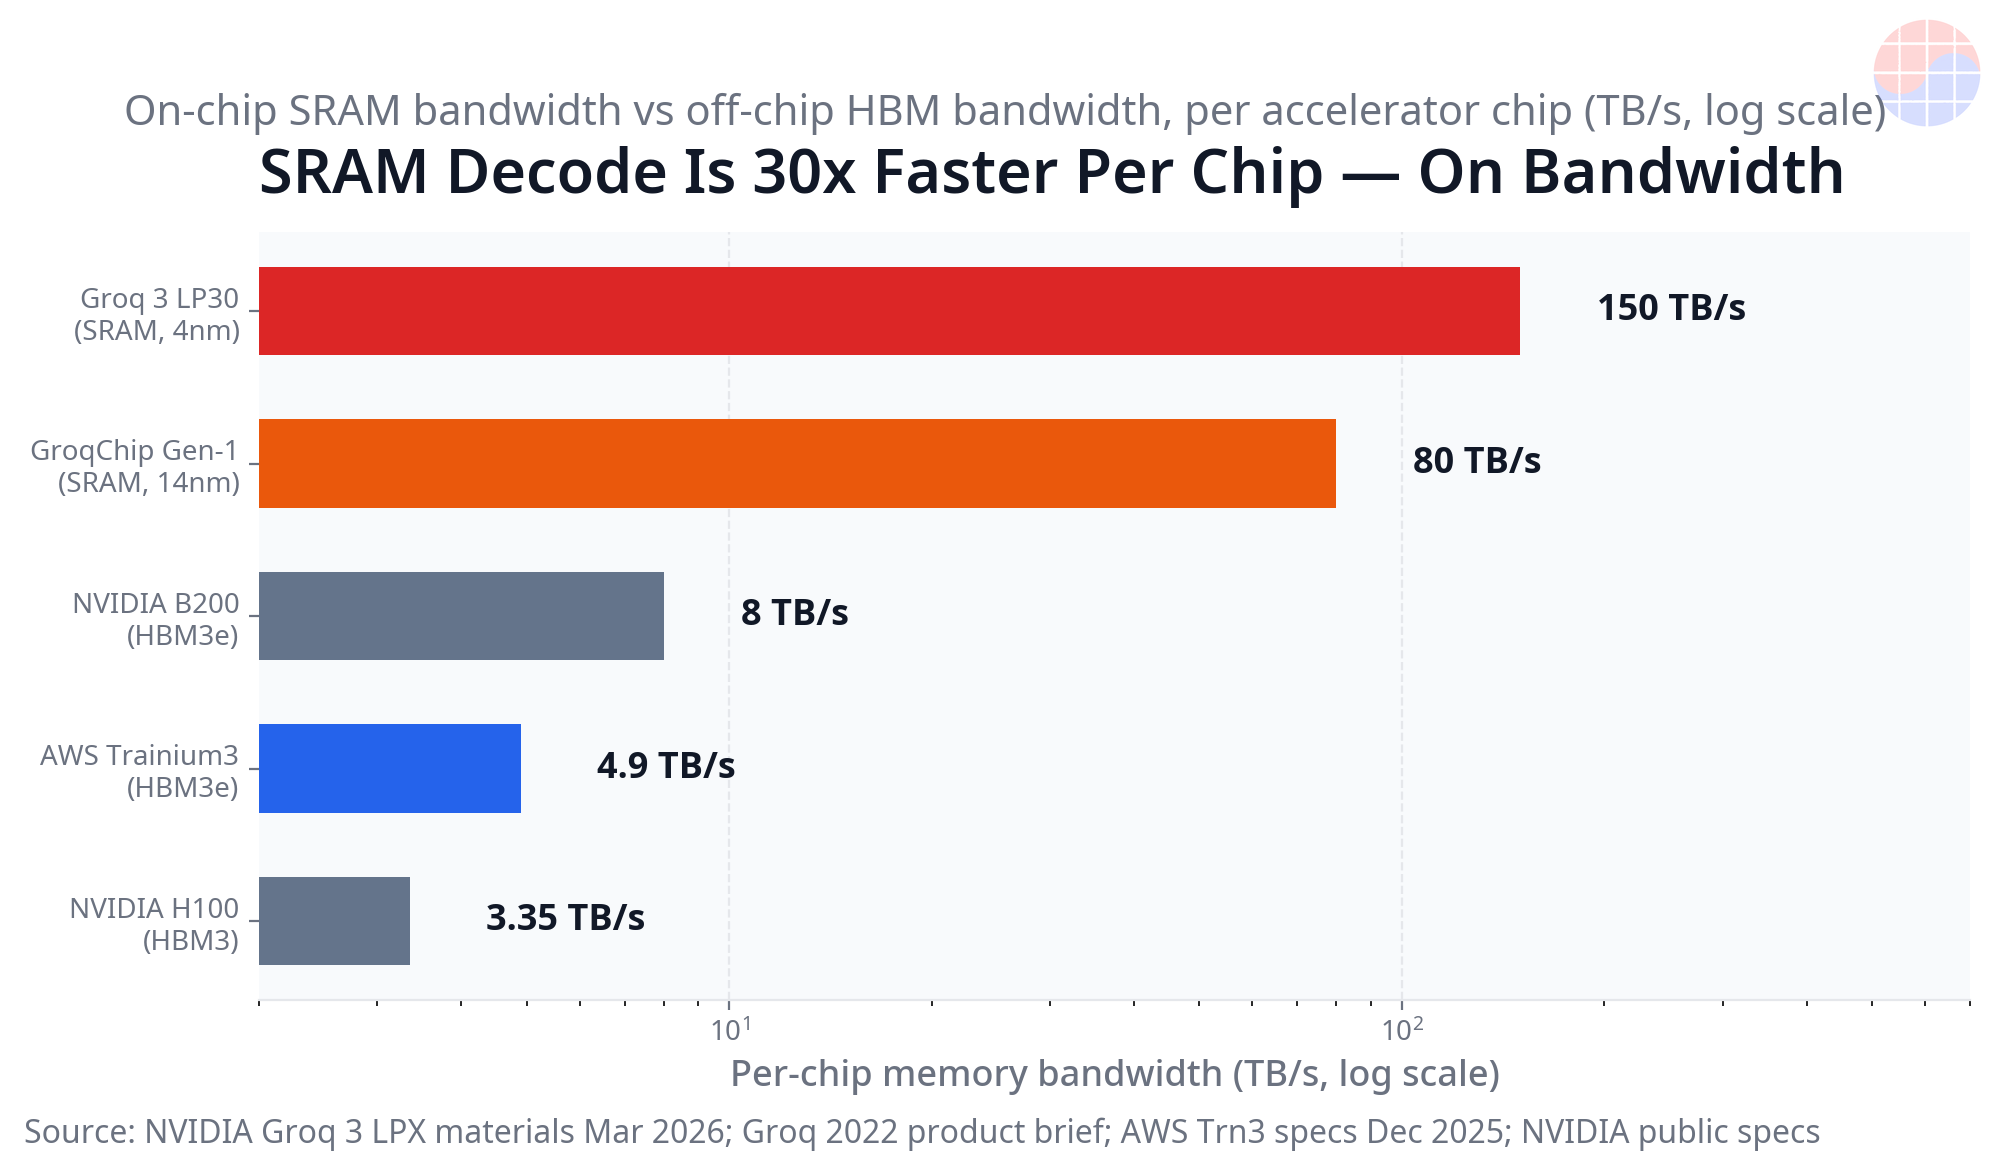
- 訓練陣營正以HBM容量固守,軟體門檻也已降低。 AWS在re:Invent於2025年12月2日正式推出Trainium3。台積電3nm製程、每顆晶片FP8運算2.52 PFLOPS、HBM3e 144GB、頻寬4.9 TB/s是官方規格 (AWS Trn3官方頁面)。綁定144顆晶片的Trn3 UltraServer提供FP8 362 PFLOPS、HBM3e 20.7 TB、合計頻寬706 TB/s。AWS主張相較Trainium2,運算提升4.4倍、記憶體頻寬提升約4倍,這是廠商主張。在數量方面,AWS與Anthropic的Project Rainier於2025年下半年開始運作,以約50萬顆Trainium2訓練Claude,並正在擴展至約100萬顆規模。根據2026年10月的報導,Anthropic簽訂了10年超過1,000億美元的AWS容量承諾,OpenAI的380億美元規模AWS合約中包含了約2GW的Trainium容量,據報導。兩個數值都屬於報導內容。在此之上,又疊加了軟體變化。Amazon於2026年10月19日發表TorchNeuron,並於2026年10月20日在PyTorch Conference North America開始公開測試版。採用Apache 2.0開源授權的TorchNeuron捨棄了既有的XLA路徑,改用PyTorch原生裝置後端,並支援eager模式與torch.compile、FSDP與DTensor。AWS將其定位為消除轉向Trainium訓練時軟體移植門檻的手段。
- 三星站在分離的兩側,SK海力士站在HBM側。 三星在NVIDIA GPU平台上爭取恢復HBM市占率的同時,也是完全沒有HBM的LP30的唯一晶圓代工廠。因此,解碼向SRAM移動,對三星而言並非單純的損失。因為這是一種讓HBM側的部分風險轉換為平澤4nm晶圓代工數量的結構。作為掌握數量感的範例計算 (自行計算,範例),1台LPX機櫃由Samsung製造的4nm LPU 256顆組成,1,000台機櫃即為LPU 256,000顆。相反,SK海力士是純粹曝險於HBM側的結構。但這並不直接意味著HBM需求減少。訓練與預填充會持續消耗HBM。只要Rainier從約50萬顆擴展至約100萬顆晶片,且每一顆次世代Trainium3晶片都搭載HBM3e 144GB,近期HBM需求因SRAM解碼而轉折的理由就很薄弱。SRAM所限制的,只是HBM成長敘事之中的推論區間,其中為延遲支付溢價的解碼碎片而已,這是截至2026年10月24日的解讀。
- 能夠反證這場分離的條件也已經可見。 第一,NVIDIA的設計本身將解碼注意力留在Rubin GPU,也就是HBM側。分離發生在機櫃之內,並非贏家通吃。第二,容量計算在兆級模型上對SRAM側不利。一兆參數模型僅FP8權重就需要至少8台LPX機櫃,再加上在長上下文中膨脹的KV快取,所需台數還會進一步增加。上下文越長,容量的牆就再次變得越大。第三,中國變數。SRAM解碼路徑在理論上不需要先進HBM,可以繞過HBM出口管制的瓶頸,但截至2026年10月24日,尚無已公開量產的中國製SRAM解碼加速器。原因在於結構。以SRAM為主的晶粒佔用大量面積 (LP30在4nm下每顆晶片SRAM 500MB),其先進邏輯製程本身就是管制對象,而且真正的護城河不在記憶體單元,而在於使確定性執行成為可能的編譯器。本段關於中國的評價屬於解讀。
Chase 的觀點
解碼是延遲事業,訓練是容量事業。曾被稱為單一記憶體牆的東西,事實上分裂成了兩道牆。阻擋解碼的頻寬之牆,以及阻擋訓練與預填充、長上下文的容量之牆。每一道牆勝出的矽晶各不相同。
從實務者的觀點來看,令人感興趣之處另有所在。由編譯器預先決定執行順序的確定性晶片,將困難的問題從執行時的硬體仲裁,移到了編譯時的排程。以350ns鏈路綁定的256顆晶片機櫃,整體與一個巨大的static timing問題無異。最終,擁有編譯器的一方,就擁有架構。
接下來要確認的有四點。第一,在2026年第四季的財報發表中,LPX機櫃的出貨台數是否以數字出現。第二,維持獨立公司的Groq,在與NVIDIA內部的自有授權設計競爭的同時,是否能守住雲端推論市占率。第三,在TorchNeuron之後,繼Anthropic與OpenAI的承諾之後,是否有第二家前沿實驗室加入Trainium訓練。第四,在下一代Rubin中,GPU側的解碼比重是變大還是變小。
啟示
看待記憶體供需的問題本身已經改變。不再是多快的HBM,而是必須區分記憶體附著在哪一個區間。訓練與預填充用的HBM需求曲線,與解碼用的SRAM及晶圓代工需求曲線,以不同的速度移動。
從晶圓代工的觀點來看,如平澤案例所示,非最先進的4nm級產線,也可以站在AI數量的中心。解碼晶片的競爭力,不是由最新製程決定,而是由SRAM密度與良率,以及與編譯器的共同最佳化決定。
對模型服務業者而言,混合配置會改變成本結構。這是一種只將有延遲溢價的區間以SRAM分離出來、其餘留在GPU上的方式。但正如兆級模型至少需要8台機櫃的計算所示,在小規模服務中,GPU的預設值並不容易被推翻。
縮小到韓國供應鏈,三星是具備雙面避險的一方,SK海力士是曝險於訓練週期的一方。即使在同一個記憶體分岔點上,兩家公司的風險輪廓也會以不同的方式移動,這是截至2026年10月24日的解讀。
常見問題
Q. 如果SRAM解碼擴散,HBM需求會減少嗎? A. 短期內不會減少。截至2026年10月24日,訓練與預填充,以及解碼注意力都留在HBM上,SRAM所承擔的區間只是對延遲敏感的解碼的一部分。AWS Project Rainier正從Trainium2約50萬顆擴展至約100萬顆,Trainium3每顆晶片搭載144GB的HBM3e。SRAM所限制的,只是HBM成長敘事之中的推論,其中為延遲支付溢價的解碼碎片而已。
Q. 用1台Groq 3 LPX機櫃就能運行一兆參數模型嗎? A. 只看權重的話不行。依自行計算,以FP8為基準,一兆參數的權重為1,000GB,因此SRAM 128GB的機櫃至少需要8台。70B模型為70GB,可以放入1台機櫃,405B模型至少需要4台。相反,搭載HBM 20.7 TB的AWS Trn3 UltraServer,三個模型都可以輕鬆放入1台。
Q. 三星在這場分離中是吃虧還是受益? A. 因為它站在兩側,所以並非單純的吃虧。三星在NVIDIA GPU平台上爭取恢復HBM市占率的同時,也是沒有HBM的Groq 3 LP30的唯一晶圓代工廠。如果解碼轉向SRAM,HBM的部分風險就會轉換為平澤4nm晶圓代工的數量。依自行計算,1台LPX機櫃是Samsung製造的LPU 256顆,1,000台即為256,000顆。
Q. 中國能以SRAM解碼繞過HBM出口管制嗎? A. 在理論上是一條可能的路徑,但截至2026年10月24日,尚無已公開量產的中國製SRAM解碼加速器。因為以SRAM為主的晶粒佔用大量面積,其本身就需要受管制的先進邏輯製程,而且真正的護城河不在記憶體單元,而在編譯器排程。本段的評價屬於解讀。
本文是根據截至2026年10月24日的公開發表與報導所做的分析,並非投資建議。廠商數值以各公司的發表為基準,報導的交易規模與承諾規模並非正式確認的數值。
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂


