 VLSI Korea
Startup Files #1:FuriosaAI — 拒絕 Meta 8 億美元收購的韓國 AI 推論晶片
FuriosaAI 於 2025 年 3 月拒絕 Meta 的 8 億美元收購提案,7 月累計募資 2.46 億美元晉升獨角獸,2026 年 1 月量產 TSMC 5nm 的 RNGD(FP8 512 TFLOPS、HBM3 48GB、TDP 180W),並拿下 LG、Samsung SDS 與 Equinix 客戶。


先講結論。 FuriosaAI 是少數能用矽晶片證明自己有理由拒絕 8 億美元收購提案的韓國 AI 晶片新創。 這家 2017 年在首爾成立的 fabless 公司,於 2025 年 7 月累計募資達 2.46 億美元,企業價值突破 1 兆韓元,晉升獨角獸,並自 2026 年 1 月起開始量產採用 TSMC 5nm 的第二代推論晶片 RNGD。 在 2025 年 3 月拒絕 Meta 的收購提案後,公司陸續取得 LG AI Research、Samsung SDS 與 Equinix 等客戶,正朝 2027~2028 年 IPO 邁進。
Company in a Nutshell
FuriosaAI 是 2017 年成立、總部位於首爾的 fabless 半導體新創。 公司只設計 AI 推論(inference)專用 NPU,生產則委由 TSMC 代工。 海外據點包括美國 Santa Clara 辦公室,並於 2026 年 9 月設立新加坡子公司。
- 創辦人兼 CEO June Paik — 曾在 AMD 設計 GPU,2013 年回到韓國後,在 Samsung Electronics 帶領記憶體新產品開發的小型團隊。 共同創辦人兼 CTO Hanjoon Kim 同樣出身 Samsung Electronics。
- CRO Jeehoon Kang — 由 KAIST 教授(專攻平行系統)擔任研究負責人;VP of Hardware Youngjin Cho 則是前 Samsung Electronics Corporate VP 出身的 SoC 專家。
- 公司名稱取自電影 Mad Max: Fury Road 中的角色 Furiosa。
- CEO June Paik 的持股比例為 17.6%(依 2025 年年中公開申報書)。
Core Technology
FuriosaAI 的核心是 TCP(Tensor Contraction Processor) 架構。 它不以矩陣乘法(matmul)為基本運算,而是把 tensor contraction 本身作為原生運算單位來處理。 這個想法也獲得學術驗證,已公開兩篇論文:「TCP: A Tensor Contraction Processor for AI Workloads」(ISCA 2024)與「FuriosaAI RNGD: A Tensor Contraction Processor for Sustainable AI Computing」(Hot Chips 2024)。
為什麼是 tensor contraction?LLM 推論的解碼階段,瓶頸不在運算,而在記憶體頻寬,屬於 memory-bound 區間。 資料搬移得越少、越有效率,每瓦能產出的 token 就越多。 TCP 正是正面瞄準這個瓶頸的設計。
Warboy(第一代,電腦視覺用)
Warboy 是採用 Samsung Foundry 14nm FinFET 製程的資料中心電腦視覺推論加速器(基於 SEMIFIVE 的 AI Inference SoC Platform 設計)。 2021 年推出首顆矽晶片,2023 年 4 月進入量產,並創下 one-shot silicon success 的紀錄。
- MLPerf Inference v1.1(2021) — 在 object detection 與 image classification 上約為 Nvidia T4 的 1.5 倍。 當時是唯一以矽晶片提交成績的新創公司。
- MLPerf Inference Edge v2.0(2022) — 在同一顆矽晶片上僅靠編譯器改善就把效能提升 2 倍。 SSD-MobileNetV1 offline throughput 為 8,762,對比 Nvidia A2 的 4,856(約 1.8 倍)。
- 已實際部署於韓國主要雲端資料中心,Kakao Enterprise 也曾進行測試(2023 年報導)。
RNGD("Renegade",第二代,LLM 推論用)
這是 2024 年 8 月在 Hot Chips(Stanford)公開的第二代晶片。 與台灣 GUC(Global Unichip)共同開發,採用 TSMC 5nm、1.0GHz 運作,並在 CoWoS-S interposer 上整合 2 堆疊 HBM。 依官方開發者文件(developer.furiosa.ai),核心規格如下。
| 項目 | RNGD |
|---|---|
| 製程 / 運作頻率 | TSMC 5nm / 1.0GHz |
| BF16 / FP8 | 256 TFLOPS / 512 TFLOPS |
| INT8 / INT4 | 512 TOPS / 1024 TOPS |
| 記憶體 | HBM3 48GB, 1.5TB/s(on-chip SRAM 256MB) |
| 互連 | PCIe Gen5 x16 |
| TDP | 180W |
| 外形規格 | PCIe dual-slot, full-height 3/4 length, passive cooling |
| 虛擬化與安全 | Multi-instance 8, SR-IOV 8 VF, ECC, secure boot |
產品型態有 RNGD PCIe 卡與 NXT RNGD 伺服器(2025 年 9 月推出)兩種。 NXT 伺服器是搭載 8 張卡的 4U 伺服器,FP8 基準達 4 petaflops,HBM3 總計 384GB、總頻寬 12TB/s,每台伺服器 3kW。 一個 15kW 機櫃可放入 5 台,相比之下同一機櫃只能放 1 台 Nvidia DGX H100(最高 10.2kW)。
軟體堆疊由編譯器、runtime、模型壓縮器、profiler 與 serving framework 組成,與 PyTorch 2.x 整合,並支援 TensorFlow Lite 與 ONNX。 也支援 Kubernetes、容器與 SR-IOV 環境。
量產已於 2026 年 1 月開始。 公司收到來自 TSMC 的首批量產 4,000 顆,開始以封裝與卡片型態供貨給客戶(TheElec,2026 年 4 月)。
第三代則由 2026 年 5 月宣布的 與 Broadcom 的共同開發夥伴關係負責。 這是一個 chiplet 架構的 rack-scale AI inference 平台,規劃採用 2nm compute die 與 HBM4/4E(依二手消息來源報導)。
Funding & Investors
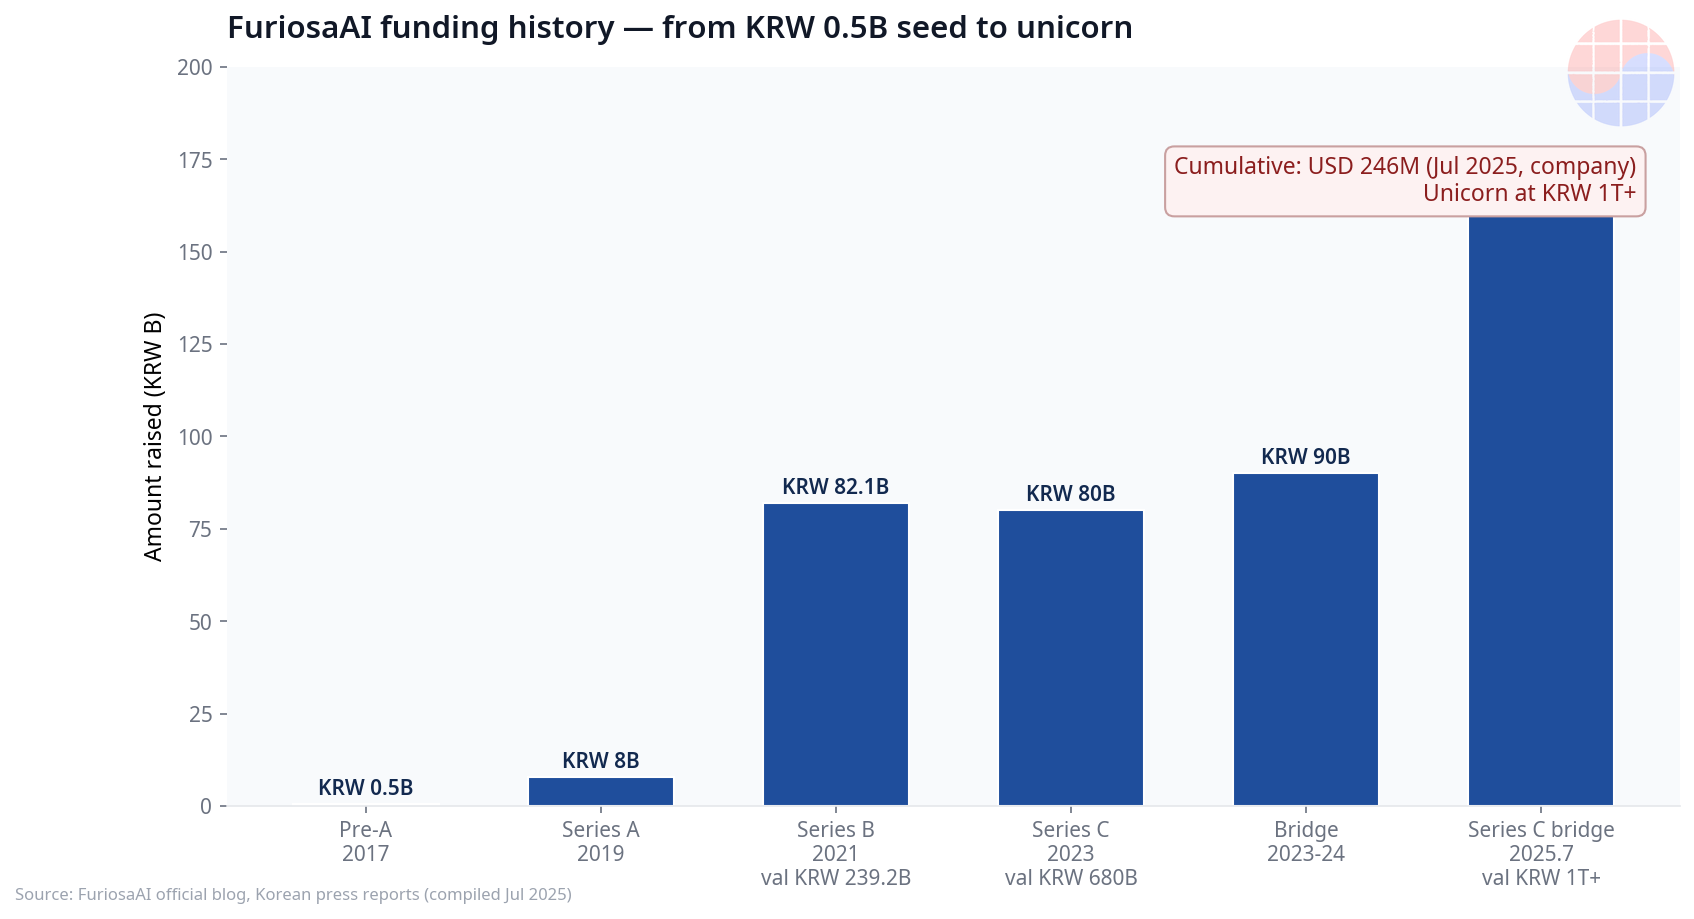
FuriosaAI 的募資歷程,是歷時 8 年、一步步擴大規模的教科書範例。 依公司官方發布,截至 2025 年 7 月,累計募資為 2.46 億美元($246M)。
| 輪次 | 時間 | 金額 | 主要投資人 | 企業價值 |
|---|---|---|---|---|
| Pre-A | 2017 | ₩0.5B | Naver D2SF | — |
| Series A | 2019 | ₩8B | Industrial Bank of Korea, DSC Investment | — |
| Series B | 2021 | ₩82.1B | DSC Investment, IMM Investment | ₩239.2B |
| Series C | 2023 | 約 ₩80B | Mubadala, Qatar Investment Authority | 約 ₩680B |
| Bridge | 2023–24 | 最高 ₩90B | Industrial Bank of Korea | — |
| Series C bridge | 2025.7 | ₩170B(約 $125M) | KDB(₩30B)、Keistone(₩20B)、PI Partners、Kakao Investment 等約 40 家投資人 | ₩1T+(獨角獸) |
2025 年 7 月的 Series C bridge(₩170B,約 $125M — 是 1,700 億韓元,不是「$170M」)讓企業價值突破 1 兆韓元,成為獨角獸。 目前公司正募集中 3 億至 5 億美元規模的 pre-IPO/Series D(由 Morgan Stanley 與 Mirae Asset Securities 共同擔任顧問,企業價值預估 ₩2T~₩3T,Bloomberg 2026 年 1 月報導)。 2026 年 5 月曾有 National Growth Fund 直接投資 ₩800B 的報導,但截至 2026 年 10 月,是否已完成交割尚未獲得確認。
被拒絕的 8 億美元
2025 年 2 月首次傳出 Meta 的收購談判消息,2025 年 3 月 24 日,FuriosaAI 最終拒絕了 8 億美元(約 1.1 兆韓元)的提案(Bloomberg 報導)。 談判破裂的原因不是價格,而是對收購後事業方向與組織結構的意見分歧。 業界的解讀是,Meta 看上的不只是進入 AI 半導體市場本身,更是為了自家 AI 服務的客製晶片開發,取得經過驗證的系統與人才。 拒絕提案 4 個月後,公司成為獨角獸;6 個月後,開始量產。
Traction
FuriosaAI 在 2025~2026 年的客戶名單,對一家推論晶片新創來說異常紮實。
- LG AI Research(2025 年 7 月) — 簽下為 EXAONE LLM 供應 RNGD 的正式合約。 經過數個月評估後獲選,將應用於 EXAONE 3.5 模型與企業級 AI agent ChatExaone。 依公司發布,與 GPU 方案相比,inference performance per watt 為 2.25 倍,在相同功耗的機櫃下 token 產出量為 3.75 倍(company-reported)。
- Samsung SDS(2026 年 10 月) — 在 Samsung Cloud Platform 上提供 RNGD 的 NPU-as-a-Service(韓國首例)。 在東灘 IDC 部署 RNGD,以 1/2/4/8 卡為單位提供 on-demand 執行個體(自 2026 年 7 月起供貨)。
- Equinix Lisbon(2026 年 7 月) — RNGD 在歐洲的首次商用部署。 在里斯本 LS2 資料中心建置了以 RNGD 為基礎的 AI inference hub。
- 斯德哥爾摩 15MW 專案(2026 年 8 月) — 與 Velox、I/ONX HPC 共同打造 15MW 級 AI inference 資料中心。 第一階段 2MW(2027 年初上線)將部署 1,800 顆 RNGD,全面擴充後將投入 8,800 顆以上。
- Kakao「AI for Everyone」聯盟(2026 年 8 月) — 參與由 Kakao 主導、獲科學技術情報通信部選定的專案聯盟。
- Aramco — 正在測試與送樣 RNGD(2024 年 12 月報導)。 這是進軍中東市場的橋頭堡。
公開的 benchmark 數字(company-reported,未經獨立驗證)如下:與 Nvidia H100 相比,inference performance per watt 最高達 3 倍;與 RTX Pro 6000 相比,在相同功耗下可同時服務的使用者數為 7.4 倍(Renegade Summit 2026.3);資料中心 TCO 約降低 40%;以 Llama 3.1 8B 為基準,每張卡 2,000~3,000 TPS。
Moat Analysis — VLSI's View
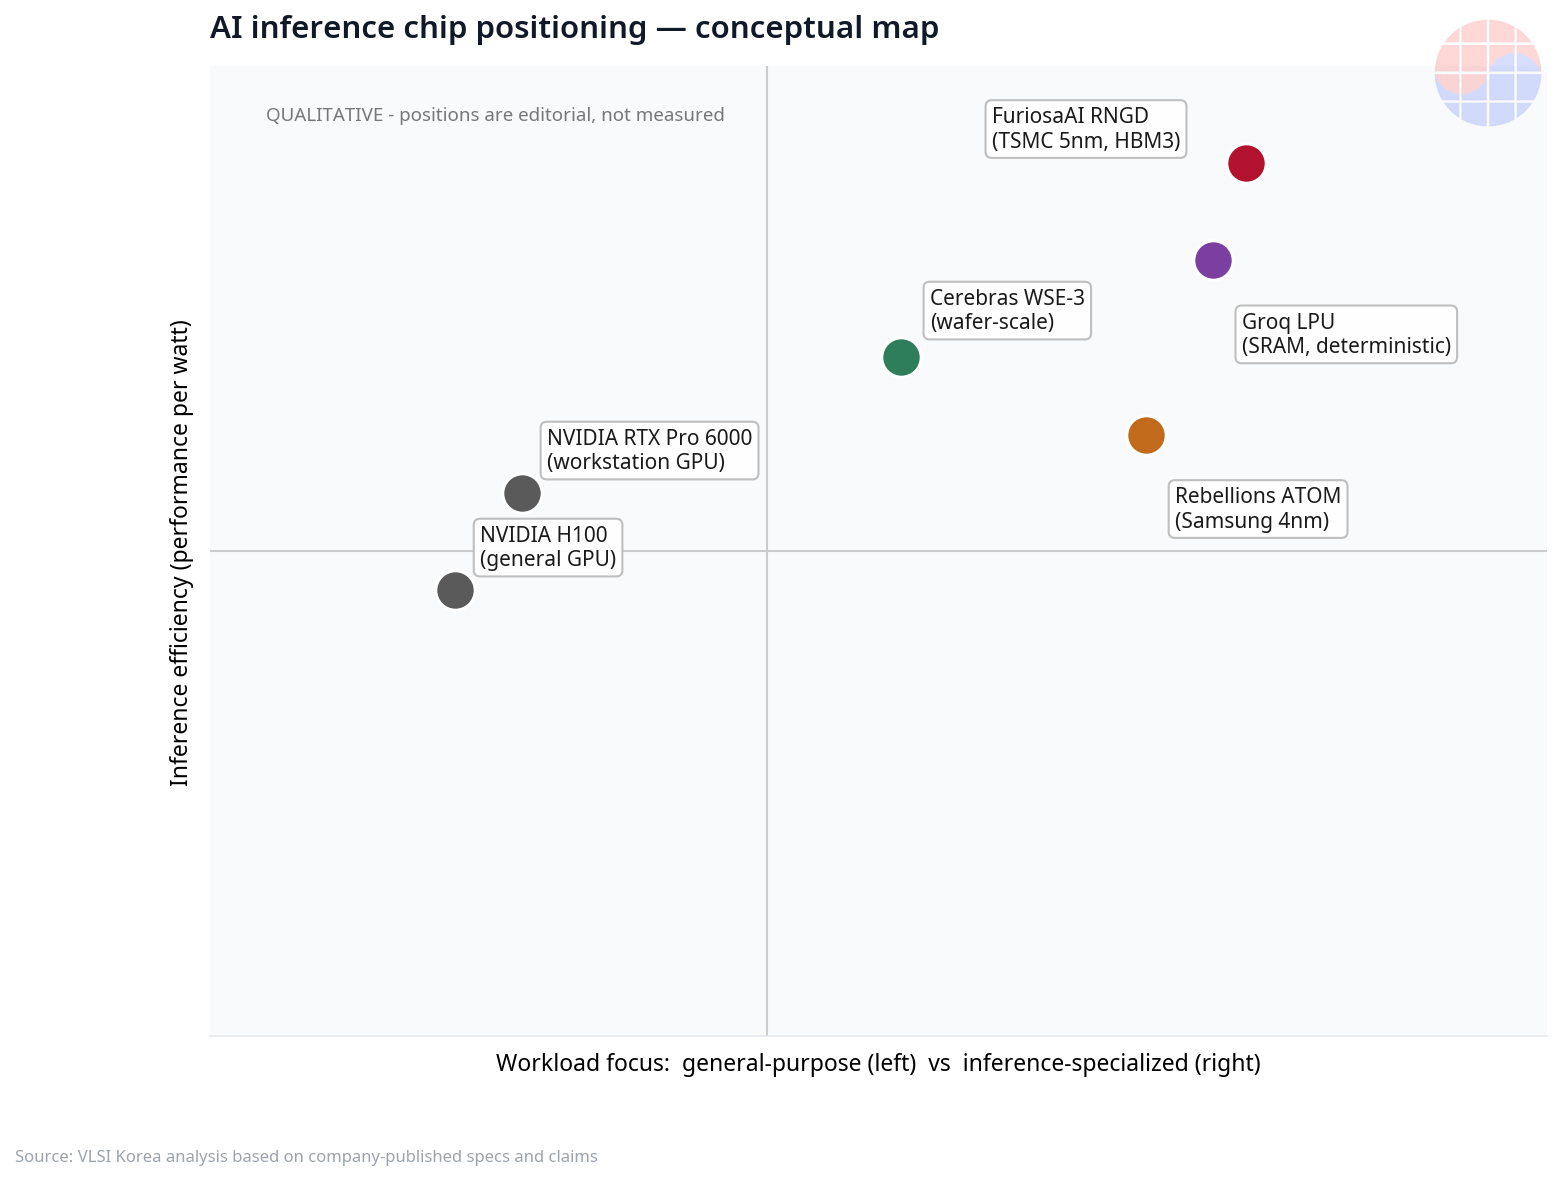
護城河 1 — 架構的學術根基。 TCP 不是行銷口號,而是經 ISCA 2024 論文驗證的架構。 設計的出發點,來自一個判斷:推論市場的勝負不在訓練,而在解碼階段的 memory-bound 區間。 與 Groq 選擇以 SRAM 為中心的 deterministic 路線不同,FuriosaAI 選擇了更務實的路線,用 HBM3 48GB 把 70B 級模型放上單張卡。 兩條路線都成立,但 HBM 路線與既有資料中心的記憶體擴充藍圖方向一致。
護城河 2 — 由編譯器證明的軟體實力。 在 MLPerf 2022 中,公司用同一顆 Warboy 矽晶片、僅靠編譯器改善就榨出 2 倍效能。 推論是一場 software-defined 的競賽,而這家公司用數字證明了,軟體團隊和硬體團隊一樣能打。 從 STA 與 timing 的角度補充一點:在 TSMC 5nm 1.0GHz 上,對 CoWoS-S interposer 與 HBM3 PHY(1.5TB/s)完成 timing closure,絕不是輕鬆的 tapeout。 Warboy 的 one-shot silicon success,以及與 GUC 共同開發 RNGD,都是執行力的證據。
護城河 3 — 每瓦 token 的經濟學。 RNGD 的 TDP 是 180W,對比 H100 的 350W。 CEO June Paik 在 Renegade Summit(2026 年 3 月)上表示:「到 2030 年,全球 AI 資料中心將新增 100GW,其中 70% 將用於 inference。」 推論是每瓦 token 的遊戲,在電力基礎設施成為瓶頸的時代,一張 180W 的卡能改變機櫃設計的自由度。
風險 — 營收必須跟上估值。 2024 年營收為 ₩3B,淨損為 ₩152.2B(公開申報書,Bloomberg 引用)。 ₩1T+ 的估值是對未來營收的押注。 Nvidia 的 CUDA 與供應鏈護城河依然存在,客戶也集中在 LG、Samsung SDS 等少數幾家。 3 億至 5 億美元的 pre-IPO 是否完成交割也尚未確認。 在韓國國內,與 Rebellions 的雙強格局正在形成 — Rebellions 採用 Samsung 4nm,獲得 Samsung 與 SK 的投資,目標在 2027 年上半年於 KOSPI 上市。 不過,推論市場更可能走向依 workload 分割的市場,而非贏者全拿。
Chase's Take。 我關注這家公司的原因,不是它拒絕 8 億美元的膽量。 而是拒絕之後,4 個月內成為獨角獸、6 個月內從 TSMC 拿到量產晶片的執行力。 許多 AI 晶片新創停在簡報階段的那道關卡,FuriosaAI 用矽晶片闖了過去。 接下來要看的指標有三個:斯德哥爾摩的 8,800 顆訂單能否轉化為實際的重複性營收、pre-IPO 輪次是否完成交割,以及在 2027~2028 年 IPO 之前,季度營收能否步上軌道。 這三項若都成立,拒絕 8 億美元將成為傳奇;只要有一項落空,就會變成昂貴的學費。
Verdict
少數能用矽晶片證明自己有技術底氣拒絕 Meta 8 億美元的案例 — 現在缺的,是營收。
FAQ
FuriosaAI 是一家什麼樣的公司?
2017 年在首爾成立的 AI 推論專用 NPU fabless 公司。 由創辦人兼 CEO June Paik(出身 AMD 與 Samsung Electronics)領軍,核心架構是 Tensor Contraction Processor(TCP)。 2025 年 7 月累計募資 2.46 億美元,晉升獨角獸(企業價值 1 兆韓元以上)。
RNGD 晶片的核心規格是什麼?
這是採用 TSMC 5nm、1.0GHz 的第二代推論晶片,支援 FP8 512 TFLOPS、INT8 512 TOPS、INT4 1024 TOPS、HBM3 48GB(1.5TB/s)、TDP 180W 與 PCIe Gen5。 2024 年 8 月在 Hot Chips 公開,2026 年 1 月開始量產。
為什麼拒絕 Meta 的 8 億美元收購提案?
已於 2025 年 3 月 24 日最終拒絕(Bloomberg 報導)。 談判破裂的原因不是價格,而是對收購後事業方向與組織結構的意見分歧。 此後公司走上獨立成長路線,先後達成獨角獸里程碑並開始量產。
募資現況與 IPO 計畫如何?
截至 2025 年 7 月,累計已募資 2.46 億美元,目前正募集中 3 億至 5 億美元規模的 pre-IPO/Series D(企業價值預估 ₩2T~₩3T)。 IPO 目標時間為 2027~2028 年。
證據限制:本文的 performance per watt、TCO 與同時使用者比較數字,皆以公司或客戶(LG AI Research)發布為準(company-reported),尚未經獨立驗證。 2026 年的 pre-IPO 輪次與 National Growth Fund 投資案,截至 2026-10-18,是否完成交割尚未確認。
主要來源: FuriosaAI 官方部落格(Series C bridge 發布) · FuriosaAI 開發者文件(RNGD 規格) · Pulse(獨角獸報導) · Korea Herald(Renegade Summit) · Data Center Dynamics(Samsung SDS NPUaaS) · TheElec(量產數量)


