 VLSI Korea
Tensordyne深度解析:把乘法變加法的LNS推論晶片,與約10億美元估值的真相
檢視Tensordyne以LNS把乘法變加法的Napier晶片與約10億美元估值。累計募資1.76億美元可交叉確認,但估值來自次級市場推估與公司自估,效能數字全屬模擬,尚未有矽晶片實測。


30秒摘要
Tensordyne是一家美國與德國雙據點的AI晶片新創,主張以對數數字系統(LNS, Logarithmic Number System)把乘法變成加法,降低AI推論成本。該公司2017年以Recogni之名創立,原做車用視覺晶片,2025年9月更名為Tensordyne,轉向資料中心推論。2026年6月15日發表的首款資料中心晶片Napier(TDN),已在台積電3奈米製程節點完成投片,進入晶圓生產。公司依自家模擬數據主張,相較於NVIDIA GB300 NVL72機櫃,可達13倍處理量(tokens per second)與17倍能源效率(tokens per watt)。累計募資約1.76億美元(以1美元兌1,400韓元計,約2,464億韓元),此數字已由多家媒體交叉確認。然而約10億美元的估值並非任何一輪主要募資揭露的投後估值,而是次級交易平台推估價(約9.92億美元)加上公司自估的參考數字,未經獨立驗證。本文的核心問題只有一個:對資訊如此稀少的公司,市場價格該如何解讀?
Background — 從車用視覺到資料中心推論
Tensordyne的起點是2017年9月的Recogni。共同創辦人為R.K. Anand(Chief Product Officer)與Gilles Backhus(Head of AI),Emily Stuart亦列名共同創辦人。Anand曾任職Sun Microsystems與Juniper Networks,專長在訊號處理與網路;Backhus畢業於慕尼黑工業大學,曾在史丹佛從事全雙工無線研究。兩人的共同背景,與其說是處理器本身,更接近訊號處理與通訊,這條線索後來也出現在公司的cell-based晶片網路(NoC)與低延遲互連設計上。
早期的Recogni瞄準自駕車視覺推論晶片。2020年12月,該公司發表1 PFLOP級視覺推論產品Scorpio,主打25W以下功耗與10ms以下延遲。但車用半導體從設計到營收的週期長,出貨量也無法與資料中心相比。2022年7月,前ZF Group高階主管Marc Bolitho出任執行長前後,公司開始把重心移向生成式AI推論。
募資歷程相對清楚。2019年A輪2,500萬美元、2021年B輪4,890萬美元之後,2024年2月20日完成1.02億美元C輪,由Celesta Capital與GreatPoint Ventures共同領投,既有投資人Mayfield、DNS Capital、BMW i Ventures,以及新投資人Pledge Ventures、沙烏地主權基金(PIF)旗下Tasaru Mobility Investments參與,HSBC Innovation Banking另提供債務融資。C輪當時公司並未揭露估值。之後資料庫中有未揭露金額的延伸輪次紀錄。2025年9月更名Tensordyne正式確認轉型,2026年6月發表Napier,並表示正準備D輪。總部位於加州Sunnyvale(早期寫為San Jose),另有德國慕尼黑辦公室,員工約120至150人。
在談價格之前必須先講清楚:截至2026年10月,這家公司公開資訊絕大多數來自公司公告、公司白皮書與高階主管訪談。公開紀錄中沒有獨立基準測試、沒有具名量產客戶案例、也沒有經審計的營收數字。本文所有效能數字都必須在這個前提下閱讀。
Business Deep Dive — LNS數字系統賭注的本質
核心想法:乘法變加法
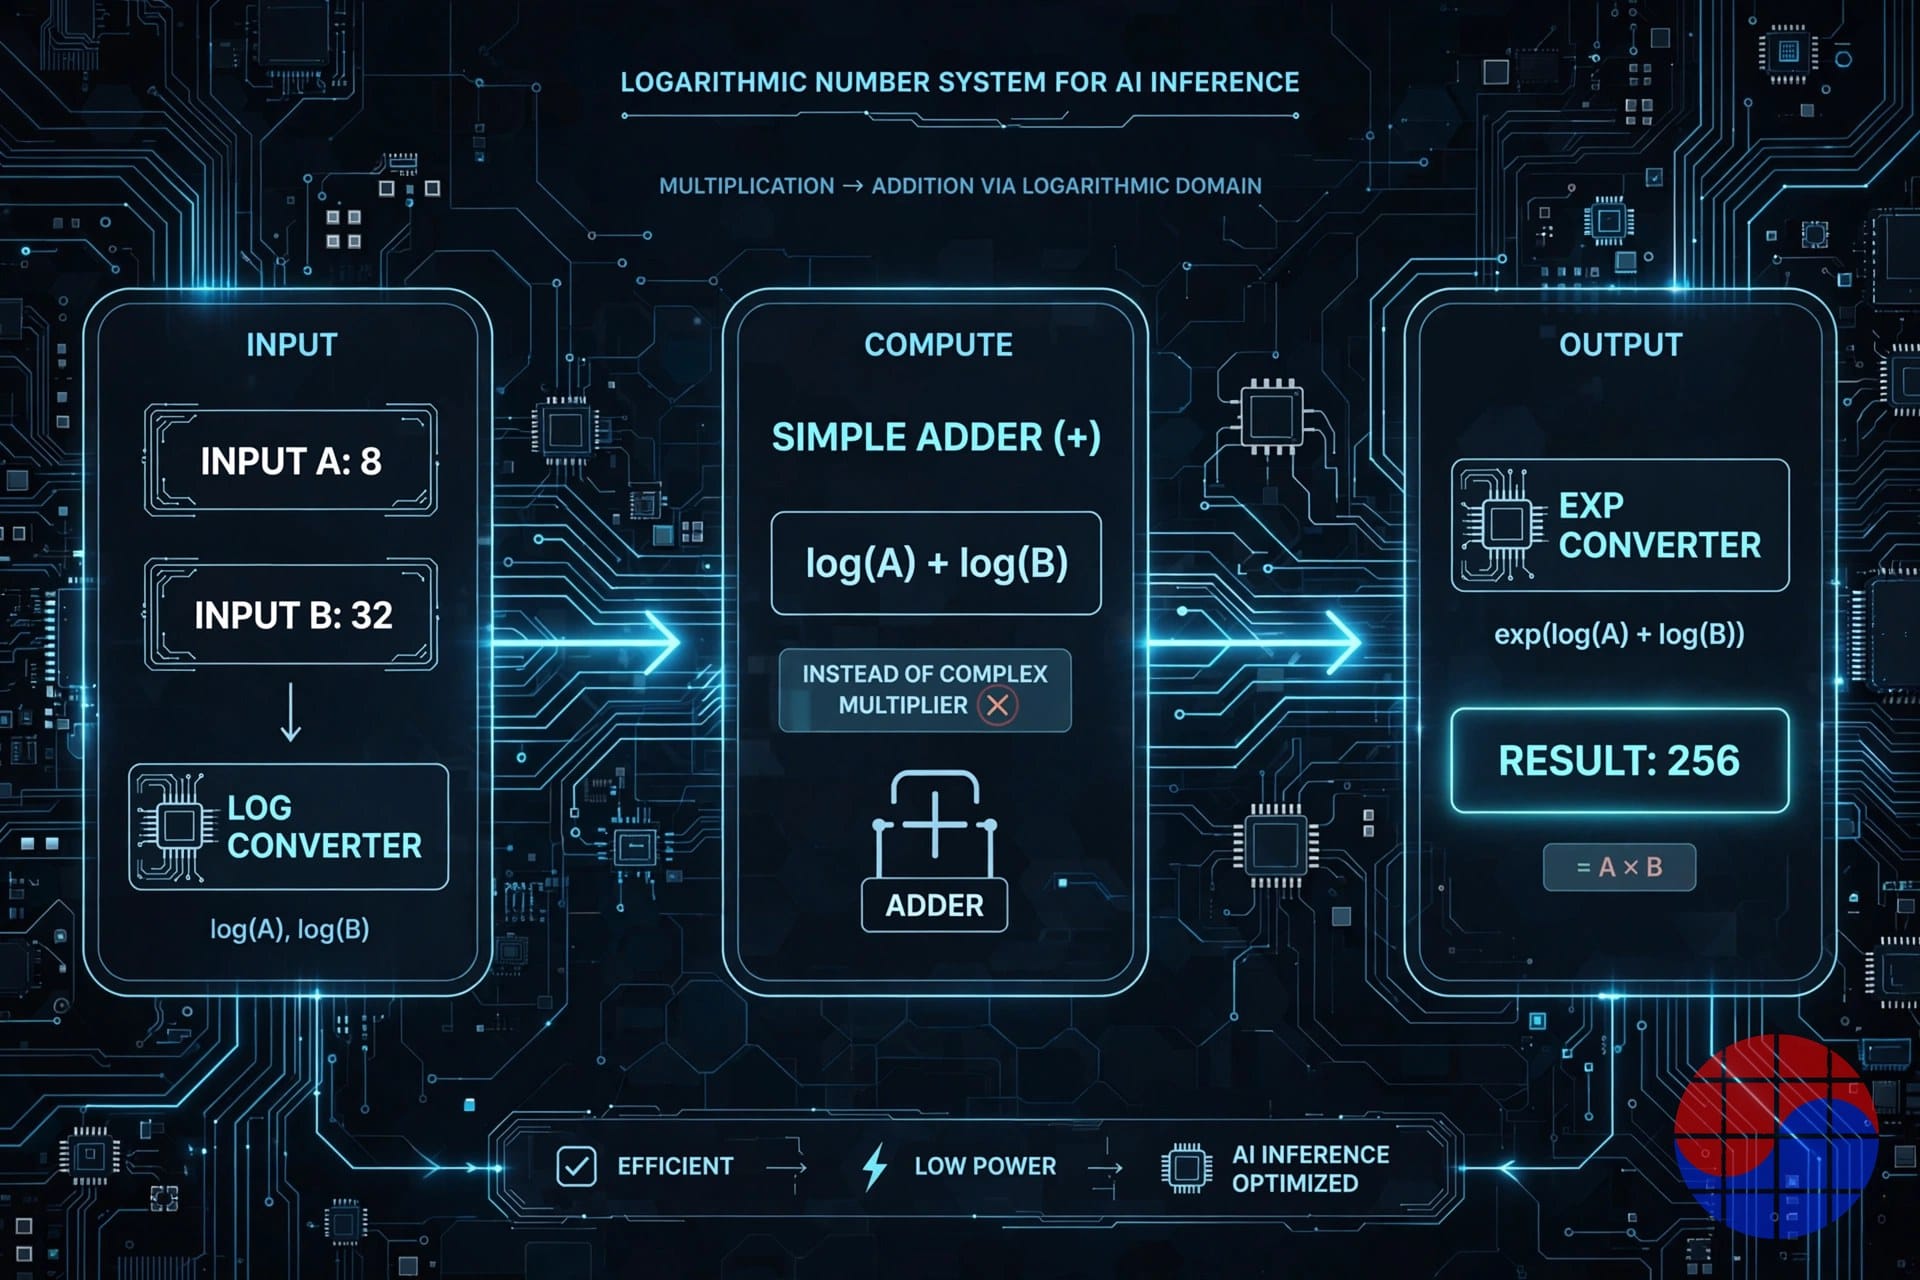
神經網路推論的運算絕大多數是矩陣乘法,也就是乘法與累加(multiply-accumulate)的反覆。浮點乘法器消耗的矽面積與能量遠高於加法器。LNS繞開了乘法:由於log(A×B)=log(A)+log(B),只要先把數字轉換到對數域,乘法就變成加法。這與1614年John Napier為簡化天文計算而製作對數表的原理相同,晶片名稱Napier也由此而來。公司把這項收益稱為「zeroth scaling law」,意指它墊在所有其他設計決策之下。
公司提出的電路層級數字相當醒目:在相同製程下,傳統16-bit浮點乘法約耗1.1 pJ與1,640 µm²,其對數版本據稱只用約0.05 pJ與67 µm²完成相同工作,能量約22倍、面積約25倍差距。但拉到系統層級,宣稱的收益縮小為運算面積約3倍、運算功耗約5倍,與公司白皮書摘要相符。電路數字與系統數字之間的落差,本身就是解讀這場賭注的第一條線索:瓶頸不只在乘法器。
為什麼LNS四十年來從未成為主流
LNS不是新想法。學界研究數十年,卻從未在專用硬體上產品化,原因有三。第一,對數域的加法很難:乘法變加法了,但把乘積再累加起來,在對數域需要昂貴的近似函數(Gaussian logarithm)。第二,線性域與對數域之間的轉換有時間與精度成本,特別是接近零的數值與大量小數累加時的誤差。第三,多數推論工作負載受限於記憶體頻寬而非運算(memory-bound),乘法變便宜並不能解決從HBM取資料的瓶頸。
Tensordyne的智財主張正好落在第一點。其專有數字系統Pareto(TDN Math)的核心,據稱是一種高效近似對數域加法的方式及其硬體實作。公司表示,模型無需重新訓練或校準即可直接上線,並已透過bit-accurate模擬在語言、MoE、影像、音訊與視訊模型上驗證精度,軟體堆疊會隱藏轉換過程並支援PyTorch與Triton。若此說成立,代表跨過了歷史上最大的障礙之一。但目前的證據是公司內部模擬,不是矽晶片實測。
Napier晶片與TDN72系統
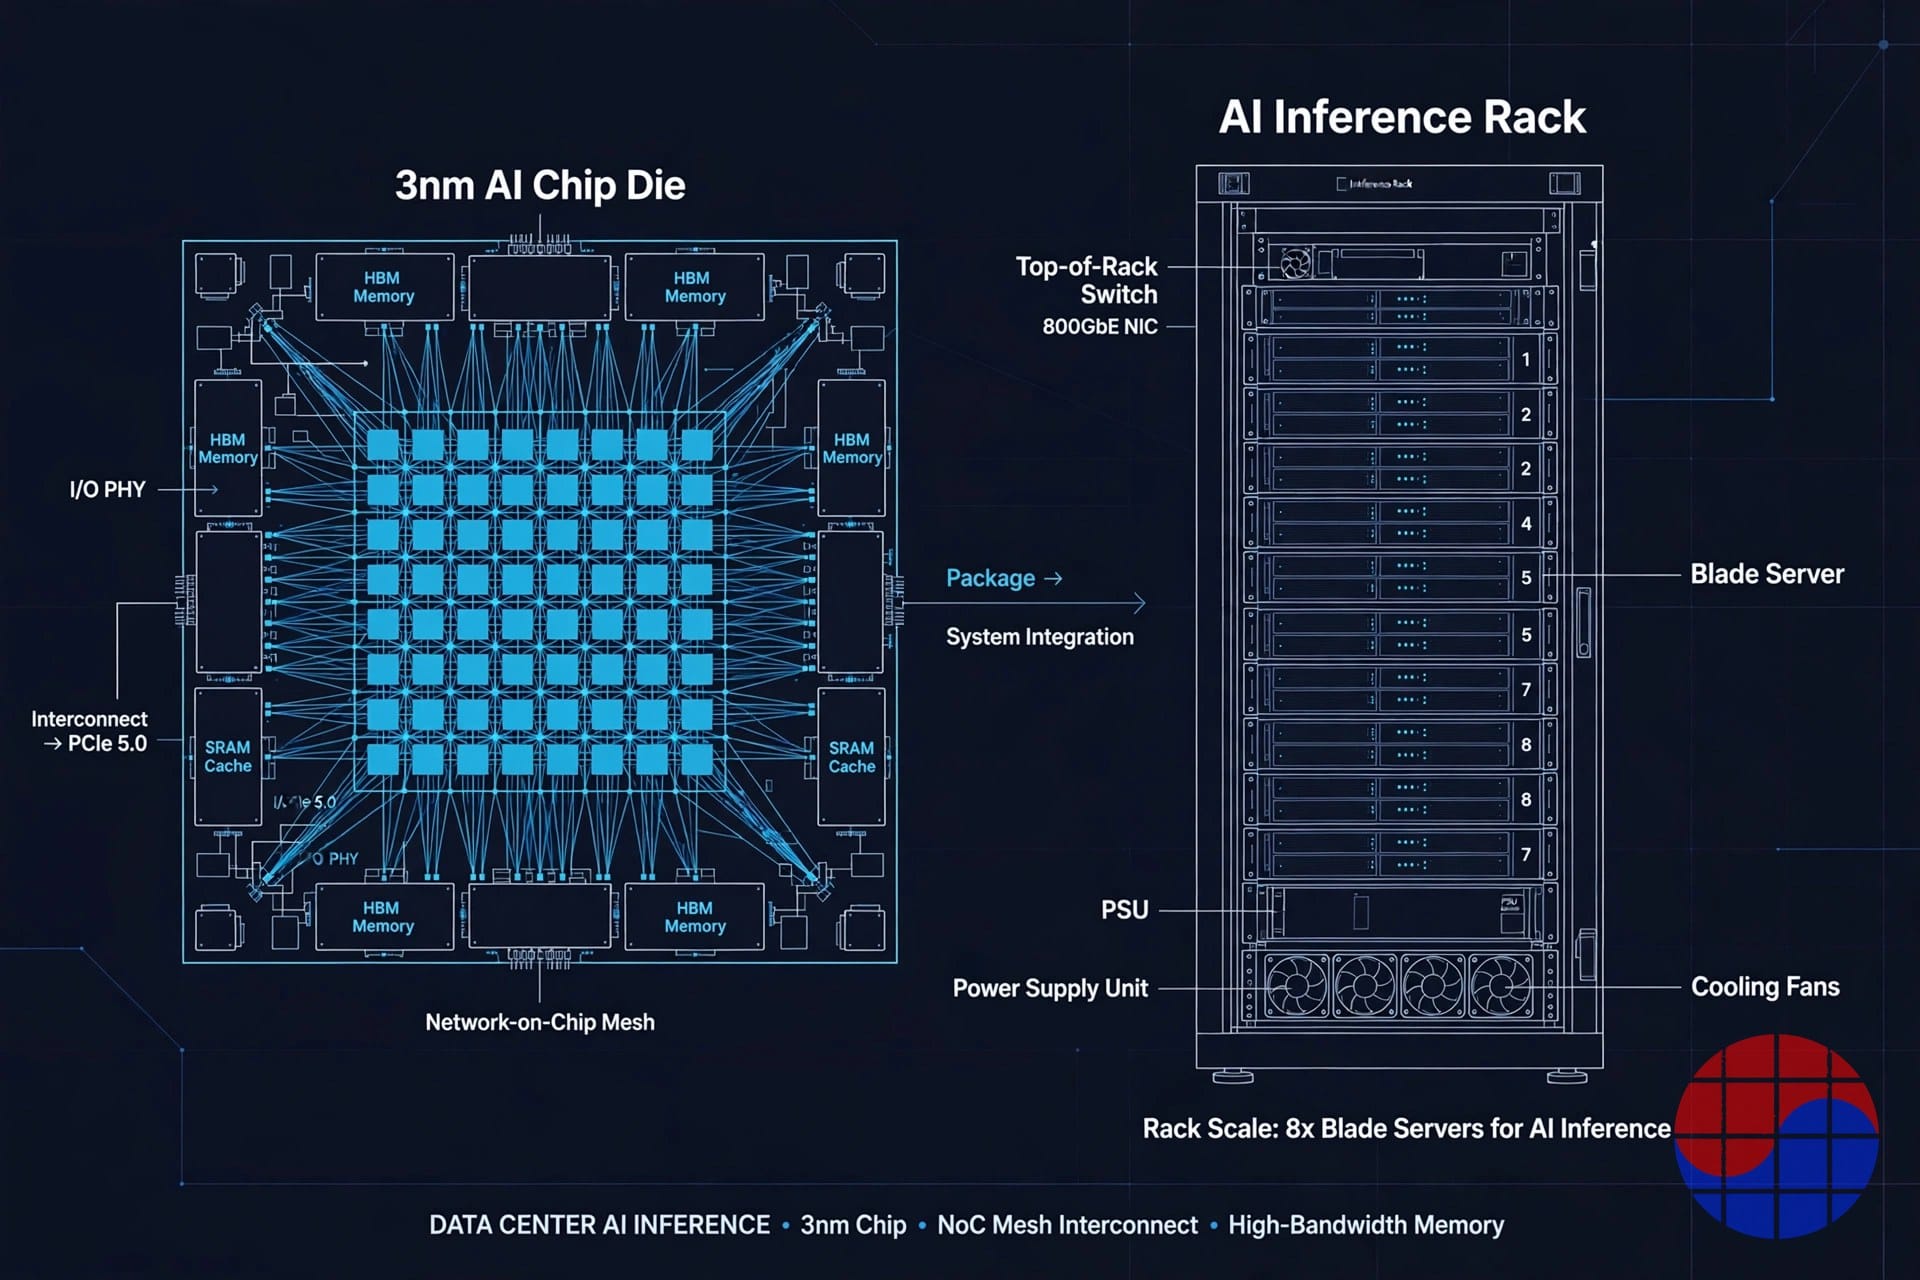
可確認的硬體規格如下。Napier(TDN AIP)採用台積電3奈米,1,380億個電晶體,單封裝300W,dense FP8運算2.11 PFLOPS,256MB SRAM,144GB HBM3e。運算核心48個,RISC-V核心負責MoE路由等迴圈內工作。TDN LINK擴展互連主打單跳延遲低於1µs,把72顆晶片組成一個pod。
| 項目 | Napier(公司數據) |
|---|---|
| 製程 | 台積電3奈米,已投片、晶圓生產中 |
| 運算 | 2.11 PFLOPS dense FP8,300W |
| 記憶體 | 144GB HBM3e,256MB SRAM |
| TDN72 pod(72顆晶片) | 30kW,氣冷,10.4TB HBM |
| 完整機櫃(4 pods,288顆晶片) | 608 PFLOPS FP8,42TB HBM,120kW,氣冷 |
合作夥伴陣容是這家公司少數的硬訊號。矽晶片由博通共同設計、台積電製造,擴展機箱與互連由HPE Juniper提供,Juniper同時也是投資人。3奈米投片與量產要花數千萬美元,且必須通過博通這類ASIC夥伴的審查,因此至少可作為「有能力與資金做出真矽晶片」的間接證據。
效能主張與其性質
公司代表性主張是:在DeepSeek-R1工作負載下,每機櫃363,000 tokens/sec,對比NVIDIA GB300 NVL72機櫃的27,400 tokens/sec,即13倍;每百萬瓦300萬tokens/sec對比18.3萬,即17倍。在2兆參數MoE模型上,公司稱自家1個機櫃能做競品組合9個機櫃的工作,以每百萬token約11美元提供每位使用者1,300 tokens/sec,而競品組合約150美元。這些數字全部來自公司建模與模擬。部分基準數字取自公開測試數據,但Tensordyne一方沒有實測值。晶片才剛出晶圓廠:開發雲端預計2026年底,beta系統2027年第一季,量產出貨2027年下半年(部分報導稱第二季)。
客戶訊號: LOI不是營收
商業訊號可濃縮為「2億美元以上預估需求(forecasted demand)」。公司表示,已有12家以上企業簽署評估beta系統的意向書(LOI),並點名兩家基礎設施業者表達興趣。然而LOI不具購買約束力,公司也未揭露付費量產客戶或營收。從歷史經驗看,AI晶片新創的LOI轉營收比率偏低。這個訊號可以讀作「關注」,不能讀作「需求已確認」。
Chase's Take — 市場為什麼給這個價格
回到正題。「約10億美元」從何而來?經交叉查證,這個估值不是新一輪投資定的價格。連最近的大型輪次、2024年C輪,公司都未揭露估值。最接近的公開數字是次級交易平台在2026年10月的推估估值約9.92億美元。次級市場推估價是根據少數成交與報價得出的參考價格,不是機構投資人盡職調查後簽下的價格。再疊上公司在D輪前釋出的自估數字,就得到「約1B」。區分這兩種性質完全不同的數字,是解讀這家公司的起點。
換成韓元約1.4兆韓元(1美元兌1,400韓元),約為累計募資約2,464億韓元的5.7倍。對一家接近pre-revenue、營收未公開的公司而言,這個價格意味著市場實際上同時在賭三件事:第一,真的跨過了LNS精度障礙;第二,就算實測只有模擬的一半優勢,也足以改變推論成本結構;第三,到2027年出貨時,推論市場會比現在大得多,電力瓶頸會成為採購標準的核心。三者只要錯一個,價格就會快速重估。
平心而論,這場賭注並非全無依據。電力與冷卻在推論成本中的占比確實上升,能以氣冷運轉120kW機櫃,對面臨液冷改造成本的既有資料中心是實在的吸引力。博通、台積電、HPE Juniper的組合也不是紙上公司湊得出來的。反面同樣明確:效能未實測、商業階段尚無營收,而且對比的對象NVIDIA不會停在原地。Napier在2027年下半年出貨時,競品機櫃也已換代。13倍的差距,與其說是「今日機櫃對明日機櫃」,更接近「我方未來機櫃對對方現在機櫃」。
我的判斷是:Tensordyne賭的是「改變數字系統,就能改變推論成本曲線的斜率本身」——一旦驗證,將改寫產業結構。但截至2026年10月,這場賭注的證據是模擬而非矽晶片。因此這家公司的價格應以選擇權價格而非技術價格來讀:這是一項接近二元(binary)的資產,實測數據一出,價值就會階梯式跳升或跳落。約10億美元不必照單全收,也沒有理由斷言是造假。它只是一個參考價,應等待兩件事:D輪裡機構實際簽多少,以及2026年底開發雲端開放後第三方量出什麼數字。
Implications — 接下來要看什麼
投資觀點:三個確認點。(1)D輪實際投後估值與領投者是誰;(2)2026年底開發雲端的獨立量測,特別是tokens per watt與模型精度是否維持;(3)LOI是否轉為付費beta與量產合約。在這三點落地前,10億美元是市場給出的期望值,不是已驗證的價值。
產業觀點:無論Tensordyne成敗,它提出的問題會留下來。在數字系統層級挑戰40年浮點乘法慣例的嘗試,能走到頂級夥伴加持的3奈米投片,本身就顯示推論時代的競爭軸正從「更大的GPU」移向「更便宜的token」。即使不是LNS,圍繞數字格式與量化的競爭仍會繼續。
韓國半導體觀點:每顆Napier晶片搭載144GB HBM3e,完整機櫃達42TB。若這類推論專用ASIC開始形成出貨量,HBM需求將從單一GPU客戶擴散到眾多ASIC廠商。對韓國記憶體業而言,這是客戶多元化的機會,同時也是負擔,因為每家ASIC要求的記憶體規格與認證流程各不相同。
資料限制說明:本文公司資訊已與2026年10月19日前公開的公司公告、白皮書摘要、媒體訪談及交易資料庫交叉核對。所有效能數字均為公司主張,未經獨立驗證;估值非主要募資輪揭露值。無法確認的營收、客戶與訂單數字未列入本文。
FAQ
Tensordyne的10億美元估值是確定數字嗎?
不是。包括2024年C輪在內,公司從未揭露任何一輪的估值。約10億美元的依據是次級交易平台推估價(2026年10月約9.92億美元)與公司自估,屬參考價格,與機構盡職調查後定出的主要募資投後估值性質不同。是否成立,應以D輪揭露為準。
為什麼LNS(對數數字系統)到現在才做成晶片?
原理早已存在,卡關的是對數域的加法近似與轉換精度。乘法變成便宜的加法,但把乘積再累加、以及處理接近零的數值,一直昂貴又不精確。Tensordyne主張其Pareto數字系統的近似方式跨過了這道障礙,但證據是內部模擬,矽晶片實測尚未公布。
Napier的13倍與17倍效能主張可信嗎?
現階段只能當公司模擬數字看待。13倍處理量與17倍能源效率都是DeepSeek-R1基準下的公司建模結果,晶片尚在晶圓廠生產,沒有獨立量測值。2026年底預告的開發雲端釋出第三方數字之時,是第一個驗證點。
Tensordyne的產品何時能買到?
依公司時程:開發雲端2026年底、beta系統2027年第一季、量產出貨2027年下半年。目前能確認的商業訊號僅公司所稱12家以上評估意向書(LOI)與2億美元以上預估需求,具約束力的量產合約與營收均未揭露。
📩 訂閱 VLSI Korea 電子報
每日半導體深度分析,第一時間寄到您的信箱。免費訂閱。


