 VLSI Korea
Microsoft Umumkan Maia 300: Satu Juta Chip AI Sendiri yang Mengubah Bisnis Semikonduktor
Microsoft mengumumkan Maia 300, chip AI generasi ketiga buatannya, dan berencana mengerahkan lebih dari satu juta pada 2027. Pembeli GPU terbesar dunia kini menjadi pesaing — ekonomi token, bukan FLOPS, adalah medan tempur barunya.


Pengumuman chip terpenting pada Oktober 2026 bukan soal akselerator yang lebih cepat. Ini soal siapa yang berhak menjadi perusahaan chip. Pada 12 Oktober 2026, Microsoft memperkenalkan Maia 300, generasi ketiga silikon AI buatannya sendiri, dan menyatakan berencana mengerahkan lebih dari 1 juta chip tersebut pada 2027 sebagai sistem inferensi utama untuk produk dan layanannya sendiri (Reuters, 16 Oktober 2026). Pembeli GPU AI terbesar di dunia kini, pada batasnya, menjadi pesaing GPU — dan setiap kueri inferensi yang berpindah ke Maia adalah belanja yang tidak lagi melewati NVIDIA.
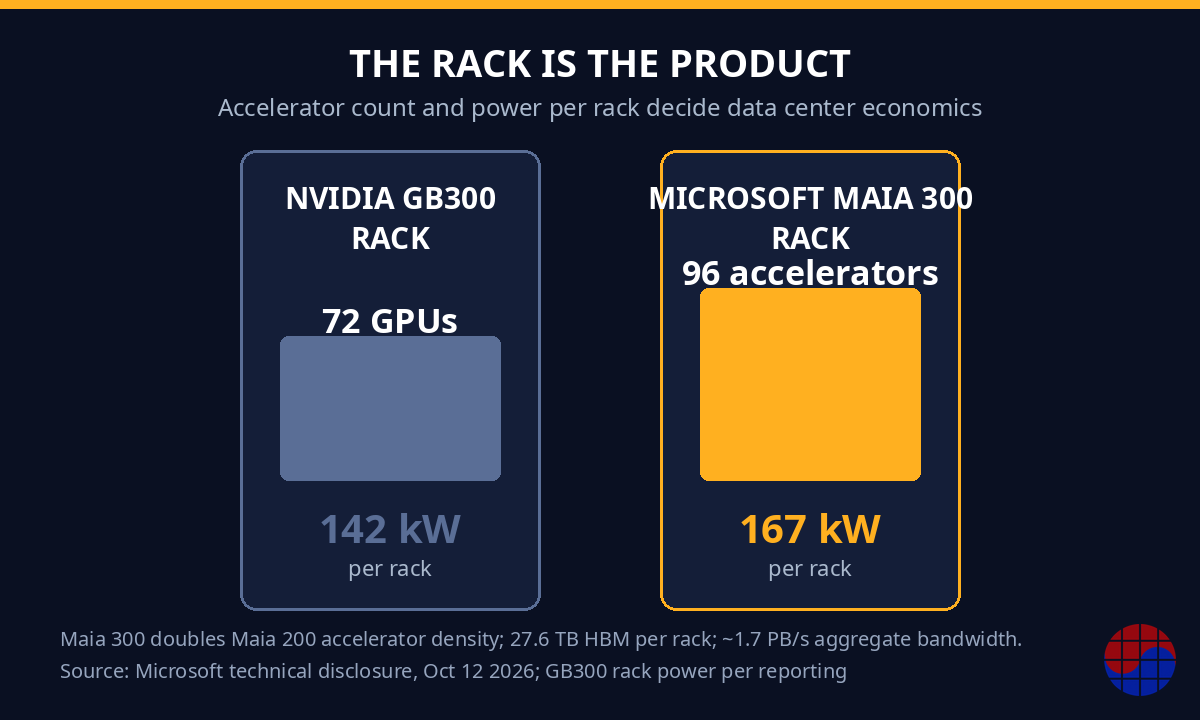
Spesifikasinya berdiri tegak dengan sendirinya: paket chiplet dengan die komputasi di atas silikon kelas 2 nanometer TSMC, delapan tumpukan HBM4 yang menyediakan memori 288 GB dengan lebar pita memori puncak 18,0 TB/s, dalam batasan daya 950 watt, yang dirakit menjadi rack berisi 96 akselerator dengan konsumsi daya sekitar 167 kilowatt (pengungkapan teknis Microsoft, 12 Oktober 2026). Microsoft mengklaim sekitar 40% lebih banyak token per megawatt dibandingkan sistem berbasis GPU terkemuka dan hingga tujuh kali lipat throughput token di tingkat rack dibandingkan pendahulunya, Maia 200. Namun cerita strategisnya lebih besar daripada angka benchmark mana pun: Microsoft mengintegrasikan secara vertikal lapisan termahal dari tumpukan AI — inferensi — dan melakukannya dalam skala yang menulis ulang ekonomi untuk foundry, produsen memori, dan vendor chip merchant.
Apa yang sebenarnya diumumkan Microsoft
Pengumuman disampaikan melalui postingan blog dari Scott Guthrie, wakil presiden eksekutif Cloud dan AI, pada Senin, 12 Oktober 2026. CEO Satya Nadella menyebutnya sebagai "taruhan terbesar kami sejauh ini pada silikon buatan sendiri", dengan menyatakan perusahaan akan memperluas keluarga Maia ke penerapan multi-gigawatt mulai 2027, menjadikannya sistem inferensi utama untuk produk dan layanan Microsoft sendiri (Microsoft, 12 Oktober 2026).
Komitmen-komitmen kunci, semuanya bertanggal dan tercatat:
- Maia 300 mengutamakan inferensi. Berbeda dengan akselerator pelatihan, chip ini dirancang untuk beban kerja yang benar-benar dimonetisasi Microsoft: bantuan pengkodean, penalaran konteks panjang, AI percakapan yang sensitif terhadap waktu, dan tugas agen multi-langkah.
- Penerapan produksi dimulai pada 2027, dengan peningkatan ke skala multi-gigawatt. Reuters melaporkan perusahaan dapat mengerahkan lebih dari 1 juta chip Maia tahun depan.
- Maia 200 sudah dalam tahap produksi, menjalankan model AI internal Microsoft dan model OpenAI yang disediakan di Azure, yang diterapkan di Amerika Serikat, Eropa, dan Australia. Microsoft 365 Copilot berjalan di atasnya saat ini; GitHub Copilot dan Microsoft Foundry dijadwalkan menyusul pada akhir 2026.
- Klaim efisiensi Maia 200 yang diungkapkan: hingga 1,7 kali lebih banyak token per watt dibandingkan sistem berbasis GPU alternatif — garis dasar yang menjadi acuan untuk peningkatan throughput token 7 kali lipat di tingkat rack pada Maia 300.
Dua catatan penting yang perlu diingat oleh pembaca yang serius: klaim 40%-lebih-baik-token-per-megawatt dari Microsoft diukur terhadap "sistem berbasis GPU terkemuka" yang tidak disebutkan namanya, sehingga ini adalah klaim vendor, bukan benchmark independen. Dan Microsoft masih membeli GPU NVIDIA dalam skala besar — dampak jangka pendek terhadap NVIDIA adalah pergeseran komposisi belanja inferensi, bukan penggantian dalam semalam.
Chip ini dalam angka
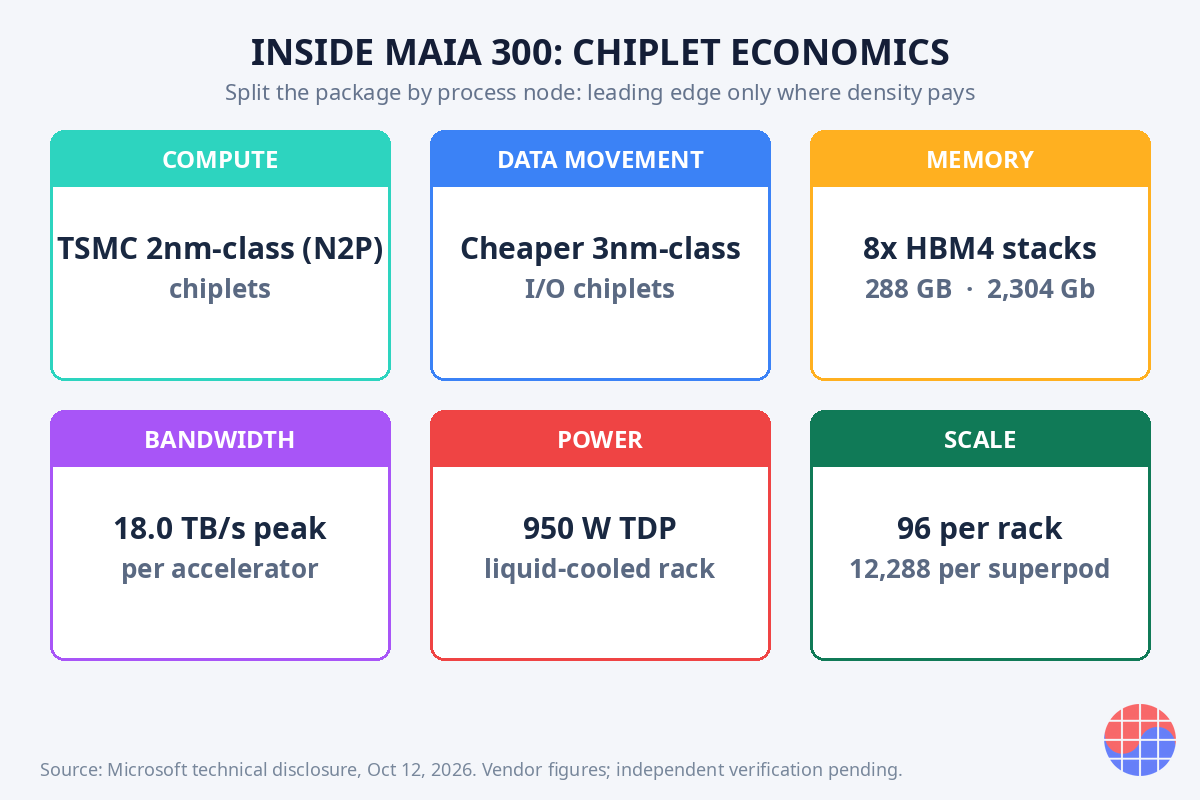
Menurut pengungkapan teknis Microsoft (12 Oktober 2026), Maia 300 adalah paket multi-chiplet yang membagi die berdasarkan ekonomi, bukan sekadar berdasarkan fungsi:
| Blok | Detail |
|---|---|
| Chiplet komputasi | Kelas 2nm TSMC (N2P) untuk fungsi komputasi kunci |
| Chiplet pemindah data | Silikon kelas 3nm yang lebih murah untuk memindahkan data keluar dari prosesor |
| Memori | 8 tumpukan HBM4, 288 GB (2.304 Gb) per akselerator |
| Lebar pita memori | 18,0 TB/s puncak |
| Daya | 950 W TDP per akselerator |
| Rack | 96 akselerator, ~167 kW, 27,6 TB HBM per rack |
| Lebar pita rack | ~1,7 PB/s lebar pita memori agregat |
| Scale-up | Fabrik Ethernet dua tingkat, hingga 128 rack = 12.288 akselerator per superpod |
Tiga angka patut dilihat dua kali. 288 GB HBM4 per chip sama dengan 2.304 Gb — dengan lebih dari 1 juta chip, Microsoft memberi sinyal permintaan lebih dari 8 juta tumpukan HBM4, atau sekitar 288 petabyte HBM4, hanya dari penerapan tahun 2027. 950 watt per akselerator menempatkan Maia 300 dalam kelas termal yang sama dengan GPU merchant kelas flagship, yang berarti rantai pasok pendingin cair dan penyalur daya yang sama. Dan 96 akselerator per rack dengan daya 167 kW menggandakan kepadatan akselerator Maia 200 — unit kompetisi kini bukan lagi chip, melainkan rack.
Fabrik scale-up adalah petunjuk yang tenang namun penting. Maia 300 menggunakan fabrik Ethernet dua tingkat — tautan listrik di dalam rack, tautan optik antar rack — yang menggabungkan hingga 128 rack menjadi superpod berisi 12.288 akselerator, dengan lebar pita yang dapat dialokasikan ulang oleh penjadwal pekerjaan dan kapasitas hot-spare yang dipinjam dari rack tetangga. Ini adalah taruhan arsitektural langsung melawan interkoneksi scale-up proprietary: Ethernet, standar komoditas, versus taman tertutup ala NVLink. Bagi Broadcom, Marvell, dan ekosistem Ethernet, ini adalah kemenangan desain (design win) paling berarti tahun ini.
Mengapa inferensi, mengapa sekarang: logika ekonomi token
Pelatihan mendapat sorotan; inferensi yang membayar tagihan. Setiap kueri Copilot, setiap loop agen, setiap sesi penalaran konteks panjang adalah beban kerja inferensi yang dibebankan langsung pada struktur biaya Microsoft sendiri. Ketika biaya penyajian model turun — kecerdasan semakin murah per token — uang berkumpul pada pihak yang menyajikan token dengan biaya termurah dalam skala besar.
Itulah tepatnya yang dioptimalkan Maia 300: 40% lebih banyak token per megawatt serta format data sub-3-bit dan MXFP4 yang ditingkatkan untuk memeras lebih banyak kerja berguna dari setiap watt. Microsoft tidak berusaha mengalahkan NVIDIA dalam FLOPS puncak. Ia berusaha memenangkan metrik yang menentukan laba ruginya sendiri: biaya per sejuta token yang disajikan, di dalam pusat data yang sudah dimilikinya, pada beban kerja yang sudah dikendalikannya.
Ini adalah logika MBA dalam satu kalimat: ketika Anda memiliki permintaan (Copilot, Azure) sekaligus pasokan (silikon Maia, pusat data), integrasi vertikal mengubah biaya variabel — membeli GPU orang lain dengan margin orang lain — menjadi aset biaya tetap yang Anda susutkan. Rencana 1 juta chip adalah Microsoft mengamortisasi inferensi.
Pandangan insinyur: chiplet adalah keputusan yield
Singkirkan pemasaran dan paket Maia 300 adalah pelajaran klasik ekonomi node mutakhir — jenis pelajaran yang dipelajari di lantai tape-out, bukan di deck strategi.
Menempatkan komputasi di N2P kelas 2nm TSMC sambil mempertahankan fungsi pengontrol memori dan I/O di node kelas 3nm yang lebih murah adalah, pertama-tama, permainan yield dan biaya. Node mutakhir adalah tempat kepadatan cacat paling menyakitkan dan harga wafer paling menggigit; Anda menempatkan di sana hanya logika yang benar-benar membutuhkan kepadatannya, dan menyimpan yang lainnya di node mature beryield tinggi. Ekonomi known-good-die kemudian menentukan yield paket, bukan satu die monolitik raksasa yang menentukannya.
Kedua, antarmuka HBM4 adalah tantangan signoff yang sesungguhnya. Delapan tumpukan pada 18,0 TB/s berarti PHY, routing interposer, dan pekerjaan integritas daya di sekitar subsistem memori mendominasi upaya desain fisik — jauh lebih besar daripada sekadar penutupan timing logika mentah. Siapa pun yang pernah melakukan STA signoff pada SoC besar mengenal polanya: angka utama adalah lebar pita, tetapi risiko tape-out hidup di antarmuka.
Ketiga, co-design tingkat rack adalah floorplan baru. Pendingin cair yang menanggung sebagian besar beban termal rack 167 kW, paket 950 W, tautan optik antar rack — jaringan penyalur daya dan batasan termal kini membatasi arsitektur sebelum RTL. Tim chip yang tidak melakukan co-design dengan tim rack akan mengirimkan komponen yang tidak bisa ditempatkan di pusat data.
Artinya untuk NVIDIA
Risiko jangka pendek bagi NVIDIA terbatas: Microsoft masih membeli GPU-nya dalam skala besar, dan pelatihan — benteng NVIDIA — tidak tersentuh oleh chip yang mengutamakan inferensi. Namun arahnya tidak bisa disalahartikan. Setiap kueri Copilot yang bermigrasi ke Maia adalah pendapatan inferensi yang tidak lagi mengalir melalui tumpukan NVIDIA: bukan GPU, bukan HBM yang terpasang padanya, bukan jaringan.
Lebih struktural lagi, Maia 300 melegitimasi jalur scale-up Ethernet dalam skala terbesar di industri. Jika fabrik Ethernet dua tingkat memberikan hasil pada skala 12.288 akselerator, argumen bahwa hanya interkoneksi proprietary yang dapat menyatukan kluster terdepan akan melemah — dan penguncian interkoneksi adalah pilar parit platform NVIDIA.
Efek tingkat ketiga adalah kekuatan penentuan harga. Alternatif internal yang kredibel mengubah setiap negosiasi pembeli besar dengan vendor merchant. Microsoft tidak membutuhkan Maia untuk mengalahkan GPU merchant terbaik di setiap beban kerja; ia hanya membutuhkan Maia yang cukup baik pada beban kerja Microsoft untuk membatasi harga yang ia bayar untuk sisanya.
Artinya untuk memori dan foundry
Memori: 8 tumpukan HBM4 per chip pada 1 juta+ chip berarti sinyal permintaan tambahan lebih dari 8 juta tumpukan HBM4 untuk 2027 — bagi SK hynix, Samsung, dan Micron, yang semuanya berlomba memenuhi kualifikasi HBM4. Perhatikan disiplin unit: 288 GB per akselerator sama dengan 2.304 Gb, dan hitungan tingkat rack (27,6 TB per rack) adalah cara perencana pusat data benar-benar membeli. Perlombaan pasokan HBM4 baru saja mendapatkan jangkar permintaan terbesarnya.
Foundry: chiplet komputasi di TSMC N2P menjadikan Microsoft salah satu pelanggan skala besar paling awal untuk keluarga N2, sejajar dengan nama-nama mobile dan HPC biasa. Alokasi N2P awal pada volume ini adalah pernyataan teknologi sekaligus negosiasi kapasitas — dan ini memperdalam keunggulan TSMC sebagai foundry era AI.
Klub silikon internal kini semakin ramai. Google memiliki TPU, AWS memiliki Trainium, Meta memiliki MTIA, dan OpenAI mengejar upaya chipnya sendiri. Rencana 1 juta unit Maia 300 adalah komitmen penerapan tunggal terbesar di antara mereka — sinyal bahwa silikon vertikal telah beralih dari eksperimen menjadi strategi pengadaan.
Yang harus diperhatikan selanjutnya
- Benchmark independen. Klaim 40% token-per-megawatt dari Microsoft tidak menyebutkan baseline GPU. Perhatikan pengukuran pihak ketiga dengan batasan daya yang jelas dan beban kerja nyata.
- Pasokan HBM4. Apakah Microsoft dapat mengamankan 8 juta+ tumpukan HBM4 untuk 2027 selagi memori tetap langka — dan vendor HBM mana dari ketiganya yang memenangkan kualifikasi.
- Pelanggan luar. Microsoft menyatakan Maia untuk produk dan layanannya sendiri. Jika pelanggan eksternal pernah mendapat akses, Maia menjadi pesaing merchant, bukan sekadar permainan biaya.
- Taruhan Ethernet. Apakah fabrik scale-up dua tingkat bertahan pada skala 12.288 akselerator — hasilnya akan bergema di roadmap setiap vendor jaringan.
Intinya: Maia 300 bukan peluncuran chip. Ini adalah strategi pengadaan dengan foto die. Microsoft melihat item terbesar dalam laba rugi AI-nya — komputasi inferensi — dan memutuskan untuk memproduksinya. Bagi industri semikonduktor, pesannya adalah pelanggan kini juga pesaing, dan negosiasi terjadi dalam token per megawatt.
FAQ
Apa itu Microsoft Maia 300?
Maia 300 adalah akselerator AI buatan sendiri generasi ketiga dari Microsoft, yang diumumkan pada 12 Oktober 2026 dan dirancang untuk beban kerja inferensi seperti bantuan pengkodean, penalaran konteks panjang, dan tugas agen. Chip ini menggunakan arsitektur chiplet dengan die komputasi di silikon kelas 2nm TSMC, delapan tumpukan HBM4 (288 GB, 18,0 TB/s), dalam batasan 950 W, yang diterapkan dalam rack berisi 96 akselerator.
Berapa banyak chip Maia 300 yang akan dikerahkan Microsoft?
Reuters melaporkan (16 Oktober 2026) bahwa Microsoft berencana mengerahkan lebih dari 1 juta chip Maia pada 2027, memperluas keluarga Maia ke penerapan multi-gigawatt sebagai sistem inferensi utama untuk produk dan layanannya sendiri. Penerapan produksi dimulai pada 2027.
Bagaimana Maia 300 dibandingkan dengan GPU NVIDIA?
Microsoft mengklaim sekitar 40% lebih banyak token per megawatt dibandingkan "sistem berbasis GPU terkemuka" yang tidak disebutkan namanya dan hingga 7 kali lipat throughput token di tingkat rack dibandingkan pendahulunya Maia 200 — keduanya adalah klaim vendor yang menunggu verifikasi independen. Secara arsitektural, Maia 300 bertaruh pada fabrik scale-up Ethernet dua tingkat versus interkoneksi proprietary, dan menargetkan efisiensi biaya inferensi ketimbang FLOPS pelatihan puncak.
Apa artinya Maia 300 bagi pemasok HBM dan foundry?
Dengan 8 tumpukan HBM4 per chip dan rencana 1 juta+ chip, penerapan 2027 menyiratkan permintaan lebih dari 8 juta tumpukan HBM4 (~288 petabyte) — jangkar permintaan besar bagi peningkatan HBM4 dari SK hynix, Samsung, dan Micron. Chiplet komputasi di node N2P TSMC juga menjadikan Microsoft pelanggan awal berskala besar untuk kapasitas kelas 2nm TSMC.
Disclosure: Analisis ini didasarkan pada pengumuman Microsoft tanggal 12 Oktober 2026 dan pemberitaan berikutnya (Reuters, 16 Oktober 2026); angka kinerja adalah klaim Microsoft dan belum diverifikasi secara independen. Penulis tidak memegang posisi di perusahaan-perusahaan yang dibahas. Angka-angka mencerminkan pengungkapan per 17 Oktober 2026.


