 VLSI Korea
Samsung Naik dengan zHBM, SK hynix Menyamping dengan HBF: Pertarungan Lapisan Memori Setelah HBM4E di SEDEX 2026
Di SEDEX 2026, Samsung dan SK hynix sama-sama memamerkan HBM4E, tetapi pertarungan sesungguhnya adalah zHBM yang menumpuk memori di atas GPU versus HBF, lapisan flash baru di antara HBM dan DRAM. Kemacetan inferensi telah bergeser dari kecepatan ke jarak.


Kesimpulannya jelas sejak hari pertama pameran. Pertarungan memori AI tidak lagi hanya soal siapa yang membuat HBM tercepat. Samsung Electronics bertaruh ke arah vertikal: menumpuk HBM di atas GPU melalui konsep bernama zHBM untuk memangkas jarak data. SK hynix bertaruh ke arah horizontal: menciptakan lapisan memori baru bernama HBF (High Bandwidth Flash) di antara HBM dan DRAM, lalu berusaha memiliki standar yang mendefinisikan lapisan itu. Keduanya memamerkan HBM4E, generasi ketujuh HBM, secara berdampingan di SEDEX 2026. Namun pesan strategisnya berbeda. Samsung menjual integrasi. SK hynix menjual definisi kategori. Dalam bisnis memori, posisi standar sering bertahan lebih lama daripada keunggulan kecepatan satu generasi.
Apa yang Diperlihatkan di SEDEX 2026
SEDEX 2026, Pameran Semikonduktor ke-28, berlangsung pada 14–16 Oktober 2026 di COEX, Seoul, dengan partisipasi sekitar 300 perusahaan. Pada 15 Oktober 2026 dilaporkan bahwa Samsung dan SK hynix sama-sama memperkenalkan HBM4E secara berdampingan di ajang tersebut. HBM4E adalah produk yang akan menghasilkan uang dalam waktu dekat. zHBM dan HBF adalah taruhan untuk lapisan berikutnya.
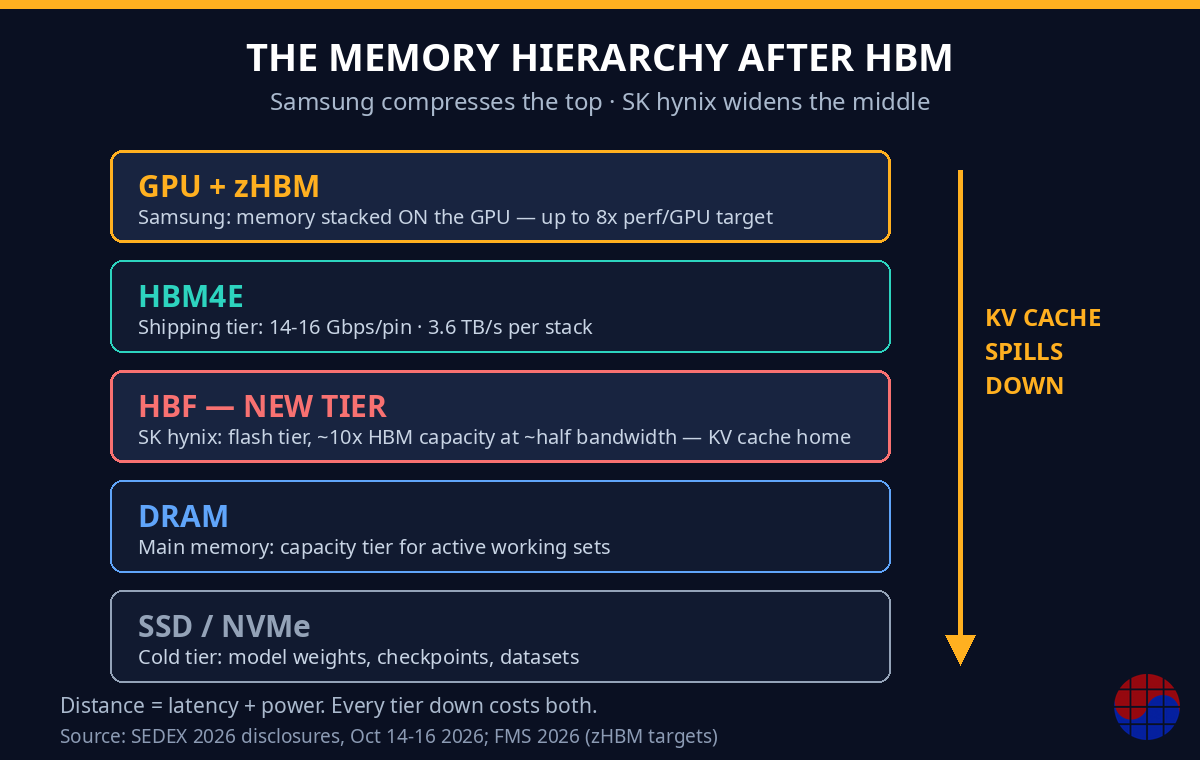
HBM4E versi Samsung memakai DRAM 1c, yaitu DRAM kelas 10nm generasi keenam, dengan base die yang dibuat pada proses foundry 4nm. Kecepatan per pin berada di kisaran 14–16 Gbps, lebih dari 20% di atas HBM4, dengan lebar pita memori maksimum 3,6 TB/s.
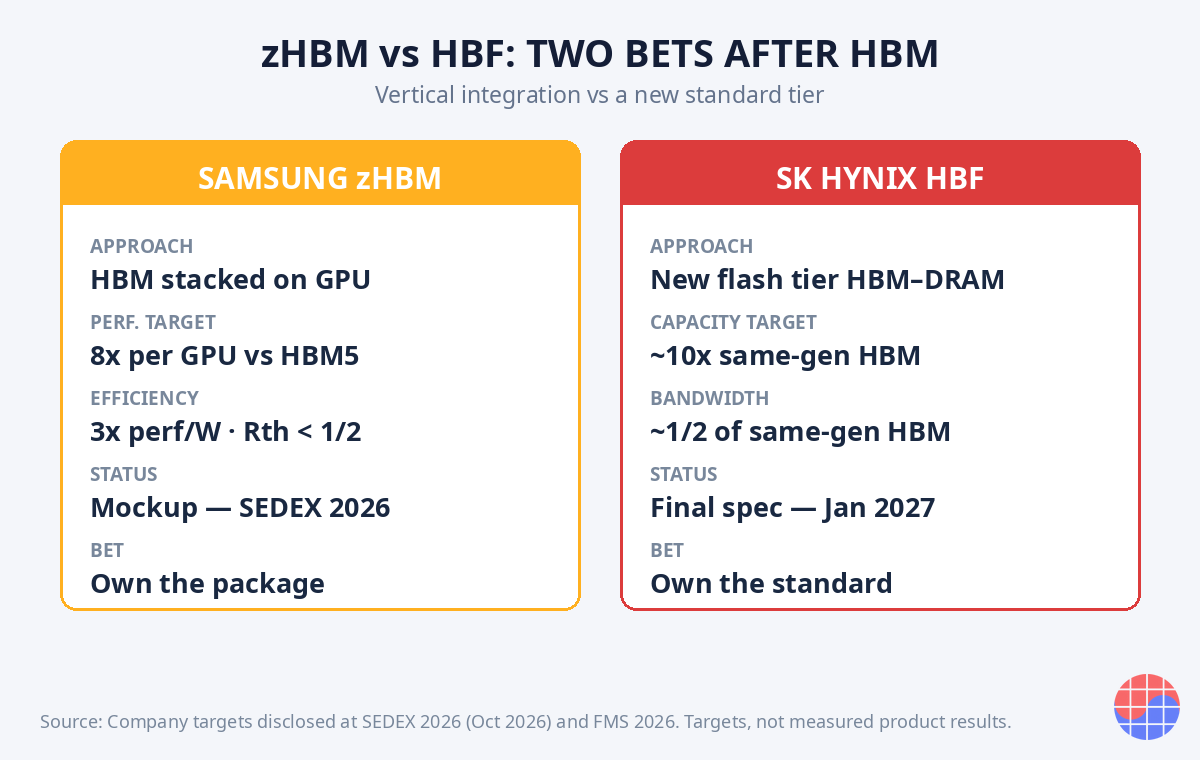
Di samping HBM4E, Samsung menampilkan zHBM. Konsep ini menumpuk HBM secara vertikal di atas GPU, bukan menempatkannya di samping GPU seperti susunan HBM konvensional. Terhadap target HBM5, Samsung menyebut zHBM menargetkan kinerja per GPU hingga 8 kali lipat, kinerja per watt hingga 3 kali lipat, dan resistansi termal kurang dari setengahnya. Angka tersebut adalah target yang dinyatakan perusahaan, bukan hasil produk yang sudah diproduksi massal. zHBM pertama kali ditampilkan di FMS 2026 pada Agustus 2026, dan di SEDEX statusnya masih tahap mockup.
SK hynix menampilkan arah yang berbeda melalui HBF. HBF menyisipkan lapisan memori baru di antara HBM dan DRAM. Targetnya adalah lebar pita sekitar setengah dari HBM pada generasi yang sama, dengan kapasitas sekitar 10 kali lipat. Standardisasi bersama SanDisk sudah dimulai, spesifikasi pertama diterbitkan pada Agustus 2026, dan spesifikasi final direncanakan pada Januari 2027 bersama mitra termasuk Google. Peluncuran produk ditargetkan pada akhir 2027. Jadwal itu, terutama tanggal spesifikasi final, adalah salah satu tanggal terpenting untuk diamati di industri memori tahun depan.
Samsung juga disebut tengah mengembangkan HBM5, dengan target produksi massal pada 2029 dan rencana hybrid bonding untuk tumpukan lebih dari 20 lapis, sebagaimana dilaporkan sebagai rencana, bukan sebagai fakta produksi yang sudah terjadi.
Satu Tabel, Dua Arah yang Berlawanan
| Aspek | Samsung zHBM | SK hynix HBF |
|---|---|---|
| Arah pendekatan | Vertikal: HBM ditumpuk di atas GPU | Horizontal: lapisan baru antara HBM dan DRAM |
| Masalah utama yang disasar | Jarak fisik antara GPU dan memori | Kesenjangan kapasitas antara HBM dan DRAM |
| Teknologi inti | Tumpukan HBM di atas GPU, integrasi pengemasan | Flash NAND berlebar pita tinggi sebagai lapisan baru |
| Target yang dinyatakan | Hingga 8x kinerja per GPU, hingga 3x kinerja per watt, resistansi termal kurang dari setengah vs target HBM5 | Lebar pita sekitar setengah HBM segenerasi, kapasitas sekitar 10x |
| Status pada Oktober 2026 | Mockup, pertama ditampilkan di FMS 2026 (Agustus 2026) | Spesifikasi pertama diterbitkan Agustus 2026 |
| Tonggak berikutnya | Bergerak melampaui mockup menuju sampel nyata | Spesifikasi final direncanakan Januari 2027, produk ditargetkan akhir 2027 |
| Kekuatan yang dijual | Bundel memori, foundry, dan pengemasan dalam satu perusahaan | Kepemilikan standar dan ekosistem mitra |
| Risiko utama | Jalur termal, yield pengemasan, KGD, kepemilikan integrasi di atas GPU | Controller, tumpukan perangkat lunak, adopsi standar oleh industri |
Tabel ini menunjukkan perbedaan yang sesungguhnya. zHBM tidak menciptakan lapisan baru; ia memindahkan lapisan yang sudah ada ke posisi yang jauh lebih dekat. HBF tidak memindahkan HBM; ia menciptakan tempat baru dalam hierarki dan mengundang industri untuk menyepakati tempat itu. Satu pendekatan menang jika eksekusi pengemasan unggul. Pendekatan lain menang jika definisinya diadopsi banyak pihak.
Mengapa Jarak Menggantikan Kecepatan sebagai Bottleneck
Selama bertahun-tahun, pertanyaan utama memori AI adalah lebar pita. Pertanyaan itu belum hilang, tetapi pusat masalahnya bergeser. Dalam keynote di SEDEX 2026, CTO SK hynix Ahn Hyun menyatakan bahwa perpindahan data antarlapisan memori kini menjadi bottleneck terpenting. Ia juga memproyeksikan skala infrastruktur AI mencapai sekitar 20 kali lipat pada 2030 dibandingkan saat ini. Jika skala tumbuh sebesar itu sementara setiap perpindahan data tetap mahal, maka biaya sistem akan didominasi oleh pergerakan data, bukan oleh komputasi itu sendiri.
Mekanismenya terlihat jelas pada inferensi konteks panjang. Model menghasilkan dan membaca kembali KV cache yang terus membesar. Selama KV cache muat di HBM, GPU bekerja efisien. Begitu cache meluber ke DRAM, latensi naik. Begitu ia meluber lagi ke SSD, latensi dan konsumsi daya naik lebih jauh. Masalahnya bukan hanya seberapa cepat satu lapisan bekerja, melainkan seberapa sering data harus menyeberang antarlapisan, dan seberapa jauh jarak yang ditempuh setiap penyeberangan itu, baik secara fisik di dalam paket maupun secara logis di dalam hierarki.
Di sinilah pengamatan kedua dari keynote tersebut menjadi penting. Beban kerja inferensi bersifat dominan baca. Data dibaca berulang kali jauh lebih sering daripada ditulis. Sifat ini membuat flash NAND kembali berguna, meskipun kinerja tulisnya lemah. Kelemahan tulis yang selama ini membuat NAND dianggap tidak cocok di dekat GPU menjadi kurang menentukan ketika pola aksesnya didominasi pembacaan. HBF adalah kesimpulan logis dari pengamatan itu: jika inferensi dominan baca, maka lapisan berkapasitas besar berbasis flash, yang ditempatkan lebih dekat daripada SSD, dapat menampung luberan KV cache dengan hukuman yang jauh lebih kecil.
Sebaliknya, zHBM menjawab masalah jarak dari ujung yang berlawanan. Jika perpindahan data adalah biayanya, maka cara paling langsung menurunkannya adalah memperpendek jarak itu sendiri. Menumpuk memori di atas GPU memangkas jalur yang harus ditempuh data. Kedua perusahaan sebenarnya mendiagnosis penyakit yang sama. Mereka hanya memilih organ yang berbeda untuk dioperasi.
Pandangan Insinyur: Masalah Nyata Bukan di Siaran Pers
Dari sudut pandang insinyur yang bekerja pada signoff timing dan tape-out, kedua konsep ini terlihat jauh lebih sulit daripada yang disarankan oleh angka target.
Masalah nyata zHBM ada tiga. Pertama, jalur termal. Menumpuk memori di atas GPU berarti panas GPU dan panas memori berbagi jalur pembuangan yang sama, dan target resistansi termal kurang dari setengahnya harus dibuktikan pada paket nyata, bukan pada mockup. Kedua, yield pengemasan dan KGD (known good die). Tumpukan vertikal menggabungkan die GPU dan die memori yang mahal; jika satu bagian gagal setelah penumpukan, kerugian yield jauh lebih besar. Pengujian KGD sebelum penumpukan menjadi penentu ekonomi, bukan sekadar prosedur. Ketiga, kepemilikan integrasi. Siapa yang memiliki integrasi di atas GPU: pembuat GPU, pembuat memori, atau pihak pengemasan? Pertanyaan kepemilikan ini menentukan siapa yang menanggung risiko yield dan siapa yang mengambil margin.
Masalah nyata HBF berbeda jenisnya. NAND itu sendiri bukan bagian tersulit. Bagian tersulit adalah controller dan tumpukan perangkat lunak: bagaimana sistem operasi, runtime, dan framework AI memutuskan data apa yang tinggal di HBM, apa yang turun ke HBF, dan apa yang boleh dibuang. Tanpa kebijakan penempatan data yang matang, lapisan baru hanya menambah kompleksitas. Masalah kedua adalah adopsi. Lapisan memori hanya berguna jika perancang GPU, penyedia cloud, dan pembuat perangkat lunak merancangnya sejak awal. Itulah sebabnya daftar mitra spesifikasi, termasuk Google, lebih penting daripada spesifikasi NAND itu sendiri.
Perbedaan jenis risiko ini penting untuk penilaian. Risiko zHBM sebagian besar berada di dalam pabrik dan ruang pengemasan Samsung sendiri, sehingga dapat dikelola dengan investasi dan waktu. Risiko HBF tersebar di seluruh ekosistem, sehingga tidak dapat diselesaikan oleh SK hynix sendirian, tetapi jika terselesaikan, hasilnya jauh lebih sulit ditiru pesaing.
Analisis Bisnis: Standar Melawan Integrasi
Dari sudut pandang MBA, ini adalah pertarungan klasik antara dua sumber keunggulan yang tahan lama.
Taruhan Samsung adalah integrasi. Samsung adalah satu-satunya pemain yang dapat menawarkan bundel memori, foundry, dan pengemasan tingkat lanjut dari satu perusahaan. Base die HBM4E yang dibuat pada proses foundry 4nm miliknya sendiri sudah menunjukkan bundel itu bekerja. Jika zHBM berhasil, pelanggan membeli satu paket terintegrasi, dan beralih ke pemasok lain menjadi lebih mahal. Integrasi memperdalam ketergantungan pelanggan dan melindungi margin di banyak titik rantai pasok sekaligus.
Taruhan SK hynix adalah standar. Sejarah industri semikonduktor menunjukkan bahwa keunggulan manufaktur satu generasi selalu dikejar dan sering tertutup, sedangkan posisi dalam standar bertahan selama standar itu dipakai. Siapa pun yang mendefinisikan spesifikasi sebuah lapisan pada dasarnya ikut mengalokasikan pasar lapisan itu: antarmuka, parameter, dan urutan kualifikasinya mengikuti definisi penulis spesifikasi. Dengan memulai standardisasi bersama SanDisk, menerbitkan spesifikasi pertama pada Agustus 2026, dan menjadwalkan spesifikasi final pada Januari 2027 bersama mitra termasuk Google, SK hynix berusaha memastikan bahwa jika lapisan HBF ada, lapisan itu berbicara dalam bahasanya.
Kesimpulan bisnisnya bukan bahwa salah satu pasti menang. Keduanya bisa berjalan bersamaan, karena keduanya menyerang titik berbeda dalam hierarki yang sama. Kesimpulan yang lebih berguna adalah soal daya tahan. Keunggulan kecepatan satu generasi, seperti selisih lebar pita HBM4E, menghasilkan uang dengan cepat tetapi terkikis dengan cepat. Posisi standar menghasilkan uang lebih lambat, tetapi terkikis jauh lebih lambat. Investor yang menilai kedua perusahaan dengan kerangka waktu yang sama untuk kedua jenis keunggulan ini akan salah menilai salah satunya.
Apa yang Masih Menghasilkan Uang Hari Ini: HBM4E
Di tengah semua pembicaraan tentang lapisan masa depan, konteks pasar minggu yang sama mengingatkan di mana uang sebenarnya berada. TSMC melaporkan hasil kuartal ketiga 2026 pada 15 Oktober 2026: pendapatan NT$1,494 triliun (US$46,7 miliar) dan laba bersih NT$763,06 miliar, naik 68,7% dibandingkan tahun sebelumnya, dengan manajemen menyatakan permintaan AI masih melampaui pasokan. Pandangan industri yang dilaporkan menyebutkan kelangkaan memori dapat berlanjut hingga 2028.
Artinya sederhana. Dalam jangka pendek, tidak ada zHBM dan tidak ada HBF yang membayar tagihan. Yang membayar adalah HBM4 dan HBM4E yang lolos kualifikasi, dikirim dalam volume, dan dihargai dalam kondisi kelangkaan. Dengan kecepatan per pin 14–16 Gbps dan lebar pita maksimum 3,6 TB/s, HBM4E adalah produk tempat kedua perusahaan sebenarnya bersaing untuk pendapatan 2027. Konsep lapisan baru menentukan valuasi jangka panjang; kualifikasi HBM4E menentukan arus kas jangka pendek. Keduanya harus diamati, tetapi jangan tertukar urutannya.
Daftar Pantauan
- Januari 2027, spesifikasi final HBF. Apakah spesifikasi final terbit sesuai jadwal, dan mitra mana saja yang tercantum di dalamnya. Keterlambatan atau daftar mitra yang menyusut adalah sinyal negatif pertama untuk strategi standar.
- Kualifikasi HBM4E. Kecepatan kualifikasi di pelanggan GPU utama menentukan siapa yang mengambil pendapatan siklus berikutnya dalam kondisi kelangkaan yang dilaporkan dapat berlanjut hingga 2028.
- zHBM melampaui mockup. Sampel nyata, data termal pada paket nyata, dan nama pelanggan pertama akan mengubah zHBM dari cerita pengemasan menjadi produk.
- CXMT pada DRAM komoditas. Pengejaran pada DRAM komoditas mengubah harga dan kapasitas cadangan kedua pemimpin memori untuk mendanai taruhan lapisan baru.
FAQ
Apa perbedaan utama zHBM Samsung dan HBF SK hynix?
zHBM memindahkan HBM yang sudah ada ke atas GPU untuk memangkas jarak data secara fisik, dengan target hingga 8 kali kinerja per GPU dan hingga 3 kali kinerja per watt terhadap target HBM5. HBF menciptakan lapisan memori baru berbasis flash NAND di antara HBM dan DRAM, dengan target lebar pita sekitar setengah HBM segenerasi dan kapasitas sekitar 10 kali lipat. Keduanya diumumkan di SEDEX 2026, 14–16 Oktober 2026.
Kapan produk HBF diperkirakan tersedia?
Menurut linimasa yang diumumkan di SEDEX 2026, spesifikasi pertama HBF diterbitkan pada Agustus 2026, spesifikasi final direncanakan pada Januari 2027 bersama mitra termasuk Google, dan peluncuran produk ditargetkan pada akhir 2027. Standardisasi dikerjakan bersama SanDisk. Jadwal ini adalah target perusahaan, bukan komitmen yang sudah terpenuhi.
Mengapa perpindahan data disebut bottleneck terpenting saat ini?
CTO SK hynix Ahn Hyun menyatakan dalam keynote SEDEX 2026 bahwa perpindahan data antarlapisan memori telah menjadi bottleneck terpenting, seiring proyeksi skala infrastruktur AI sekitar 20 kali lipat pada 2030. Pada inferensi konteks panjang, KV cache yang meluber dari HBM ke DRAM lalu ke SSD menambah latensi dan konsumsi daya pada setiap perpindahan, sehingga jarak dan frekuensi perpindahan kini menyaingi lebar pita mentah sebagai penentu kinerja sistem.
Apakah zHBM dan HBF menggantikan HBM4E dalam waktu dekat?
Tidak. HBM4E, dengan kecepatan per pin 14–16 Gbps dan lebar pita maksimum 3,6 TB/s pada versi Samsung, adalah produk generasi ketujuh yang sedang menuju kualifikasi dan pendapatan, dalam pasar yang dilaporkan mengalami kelangkaan hingga 2028. zHBM masih tahap mockup pada Oktober 2026 dan HBF ditargetkan meluncur akhir 2027, sehingga keduanya adalah taruhan setelah HBM4E, bukan penggantinya.
Disclosure: Artikel ini ditulis dari sudut pandang insinyur signoff PrimeTime di Synopsys dan mantan insinyur tape-out SiFive, untuk tujuan informasi berdasarkan pengumuman publik SEDEX 2026 per 16 Oktober 2026, dan bukan merupakan rekomendasi investasi.


