VLSI Korea
Alibaba Hanguang 800: 공개된 한 세대와 보이지 않는 다음 세대
Hanguang 800의 검증된 1세대와 공개되지 않은 후속 세대를 분리하고, Alibaba가 Lingjun system으로 옮긴 경계를 분석합니다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
이 글은 cloud AI accelerator의 세대별 architecture와 system economics를 비교해 구매·투자·공급망 판단을 내리려는 독자를 위한 글이다. 읽고 나면 peak 수치와 실제 model-level TCO를 분리하고, 다음 세대에서 검증할 지표를 선택할 수 있다.
자료 기준일: 2026-08-02
TL;DR
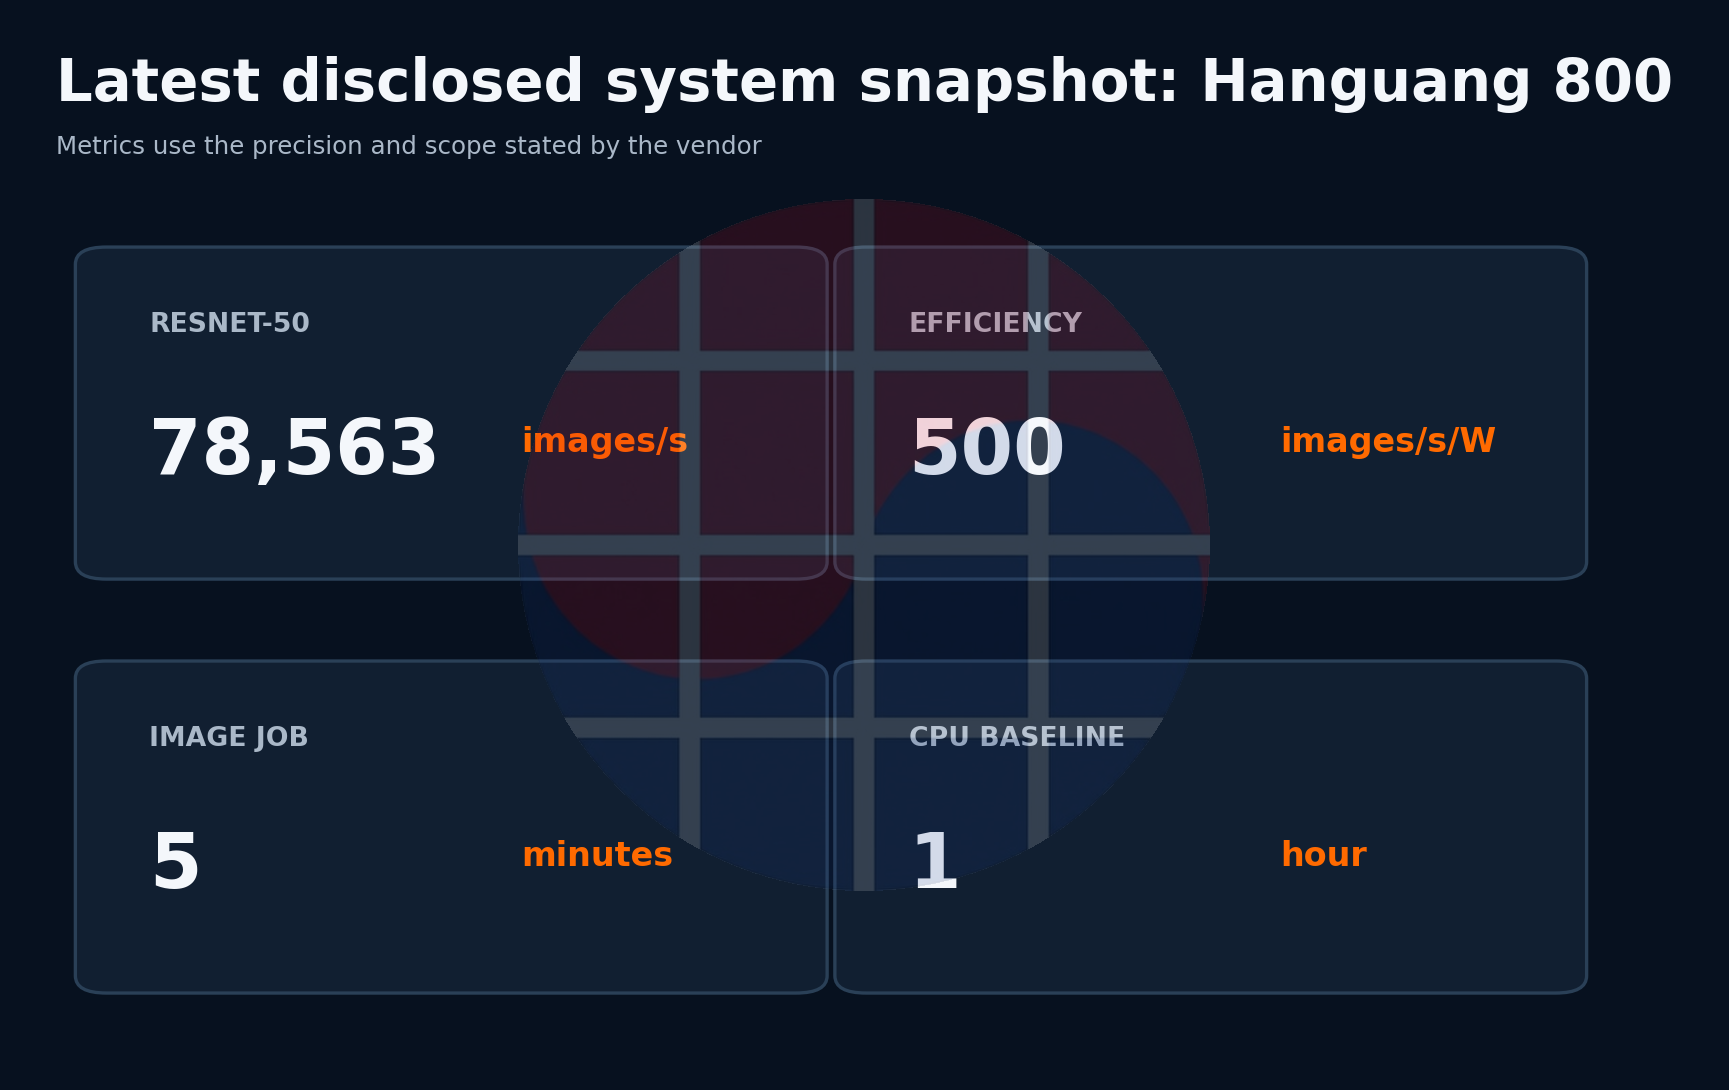
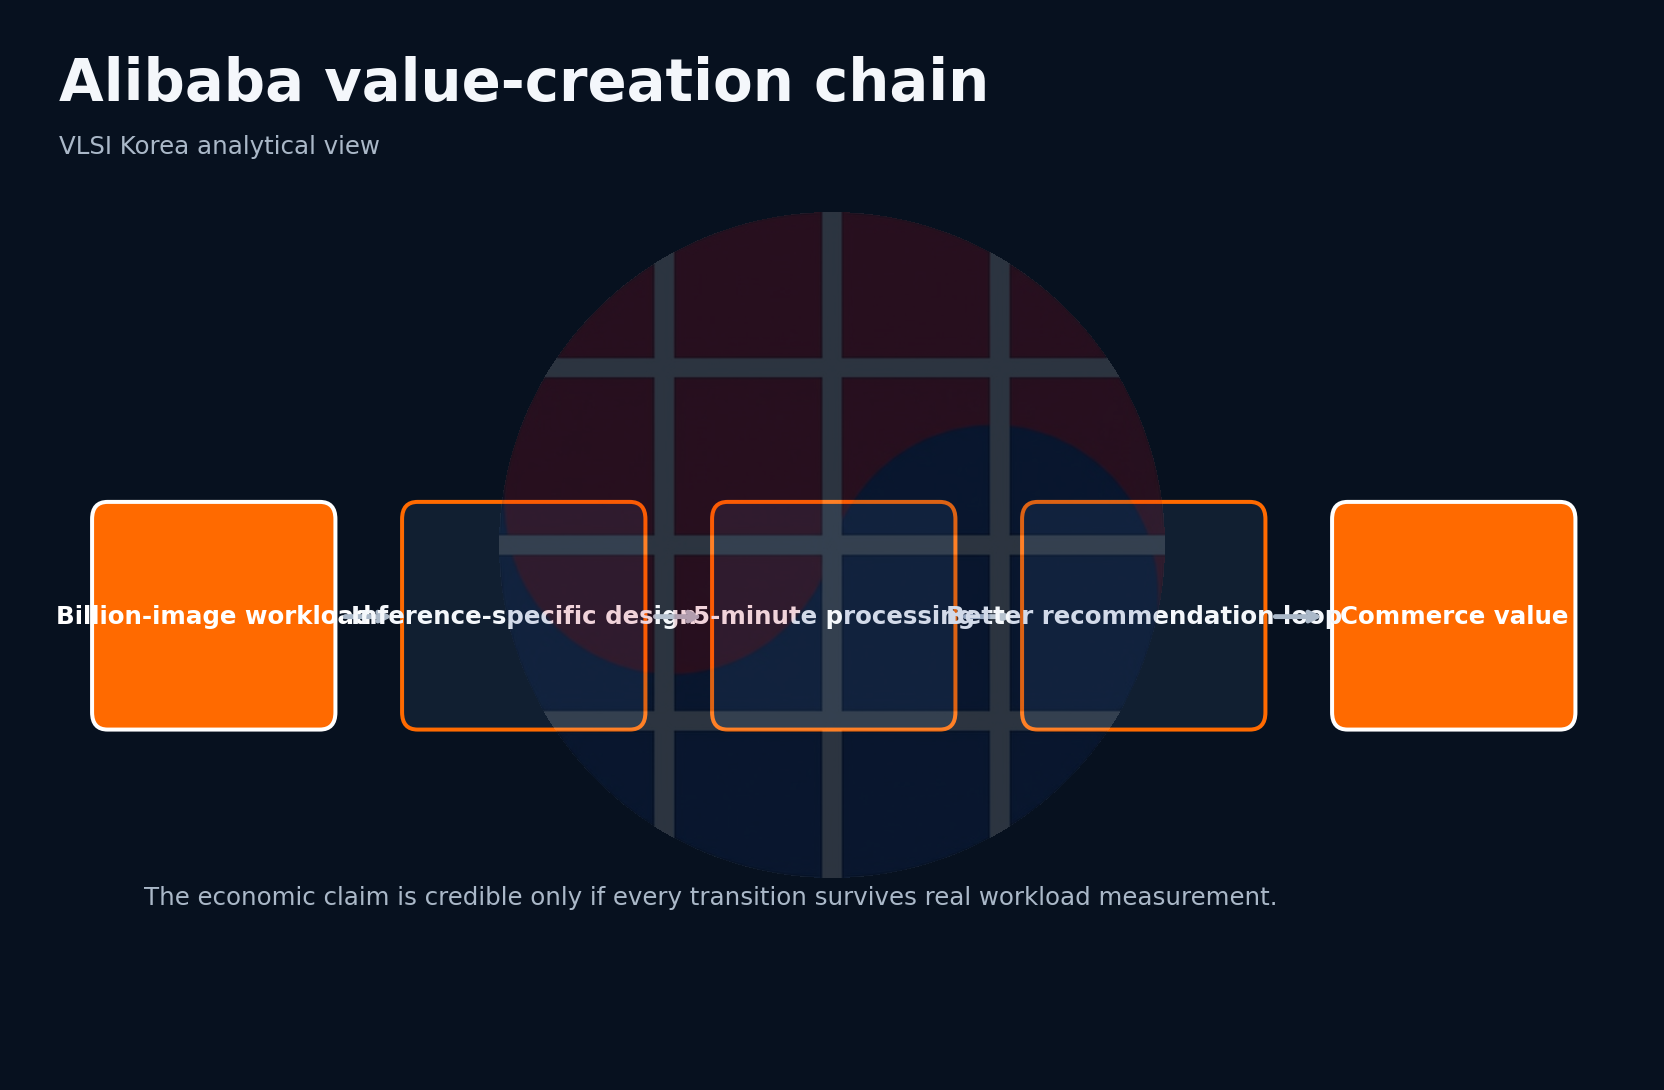
Alibaba의 Hanguang 800은 2019년 당시 cloud company custom inference ASIC의 모범 사례였다. T-Head가 설계하고 Alibaba의 image search, recommendation, City Brain과 public cloud inference에 즉시 배치했다. 공개 수치는 ResNet-50 78,563 images/s, 500 images/s/W였고, Hangzhou City Brain workload는 GPU 40개를 Hanguang 4개로 줄이면서 latency를 300 ms에서 150 ms로 낮췄다고 회사가 발표했다. Taobao의 10억 장 상품 image 처리 시간도 1시간에서 5분으로 단축했다고 밝혔다.
그러나 더 중요한 결론은 이후다. 2026-08-02 현재 Alibaba가 공식적으로 세대 이름, process, memory, compute와 interconnect를 충분히 공개한 후속 Hanguang은 확인하기 어렵다. 보도와 소문을 이어 붙여 Hanguang 2를 만들기보다, Hanguang 800을 상용화가 입증된 1세대로 두고 그 후 Alibaba가 Lingjun heterogeneous cluster, AIACC software와 GPU·NPU 통합 scheduling에 무게를 둔 것으로 읽는 편이 정확하다.
Hanguang은 실패한 칩이라기보다 공개 전략이 달라진 칩이다. captive inference에서 ASIC의 경제성을 입증했지만, 생성형 AI 시대의 training과 LLM serving에서 같은 lineage가 어디까지 확장됐는지는 공개 evidence가 부족하다. Alibaba의 현재 경쟁력은 한 chip의 peak가 아니라 workload, cloud platform, network와 heterogeneous accelerator를 조달·운영하는 능력에 더 가깝다.
Generation map
| Stage | Public product | Workload | Public evidence | Analytical status |
|---|---|---|---|---|
| Pre-silicon | Alibaba inference stack | Search, recommendation, image and city services | Large captive workloads | Workload foundation |
| First generation | Hanguang 800 | Datacenter inference | Launched in 2019 and deployed internally and in cloud service | Confirmed silicon generation |
| Service evolution | Hanguang-based cloud inference | Managed and containerized inference | Commercial cloud integration | Confirmed platform evolution |
| Cluster evolution | Lingjun heterogeneous AI infrastructure | Training and inference across GPU and NPU resources | 800G RDMA platform documentation | Confirmed system evolution |
| Successor silicon | Not sufficiently disclosed | Unknown | No comparable official datasheet | Do not infer a generation |
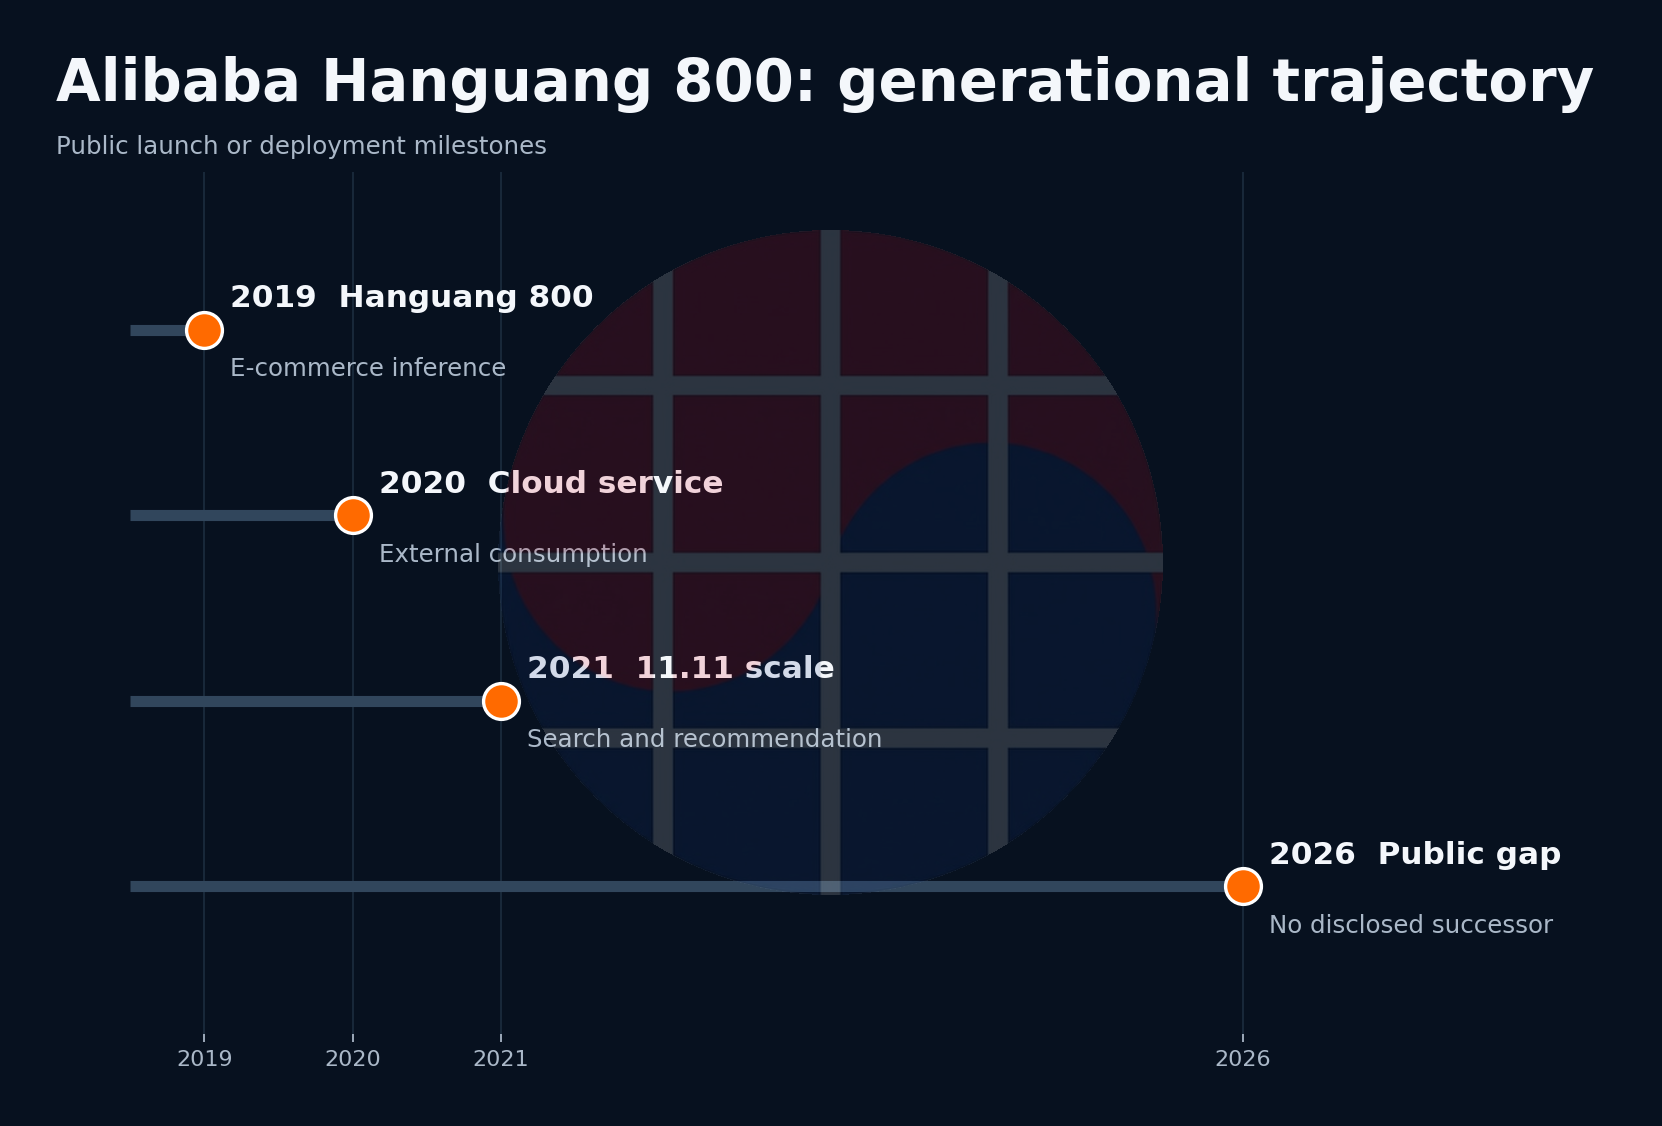
이 표의 마지막 행이 분석의 핵심이다. Hanguang 800 이후 chip이 전혀 없다고 단정하는 것이 아니라, public evidence만으로 세대별 architecture를 비교할 수 없다는 뜻이다. confidential internal silicon, renamed product와 아직 공개하지 않은 design이 있을 수 있지만 공개 자료의 빈칸을 사실로 채워서는 안 된다.
왜 Alibaba에 inference ASIC이 자연스러웠나
Alibaba의 commerce workload는 custom ASIC과 잘 맞는다. 상품 image classification, image search, recommendation ranking과 OCR은 매일 반복되고 tensor shape와 SLO가 비교적 안정적이다. 같은 model family가 수백만 request를 처리하므로 silicon 개발비를 큰 volume에 상각할 수 있다. peak training cluster와 달리 inference fleet은 24시간 지속되며 작은 전력·latency 개선이 전체 TCO에 누적된다.
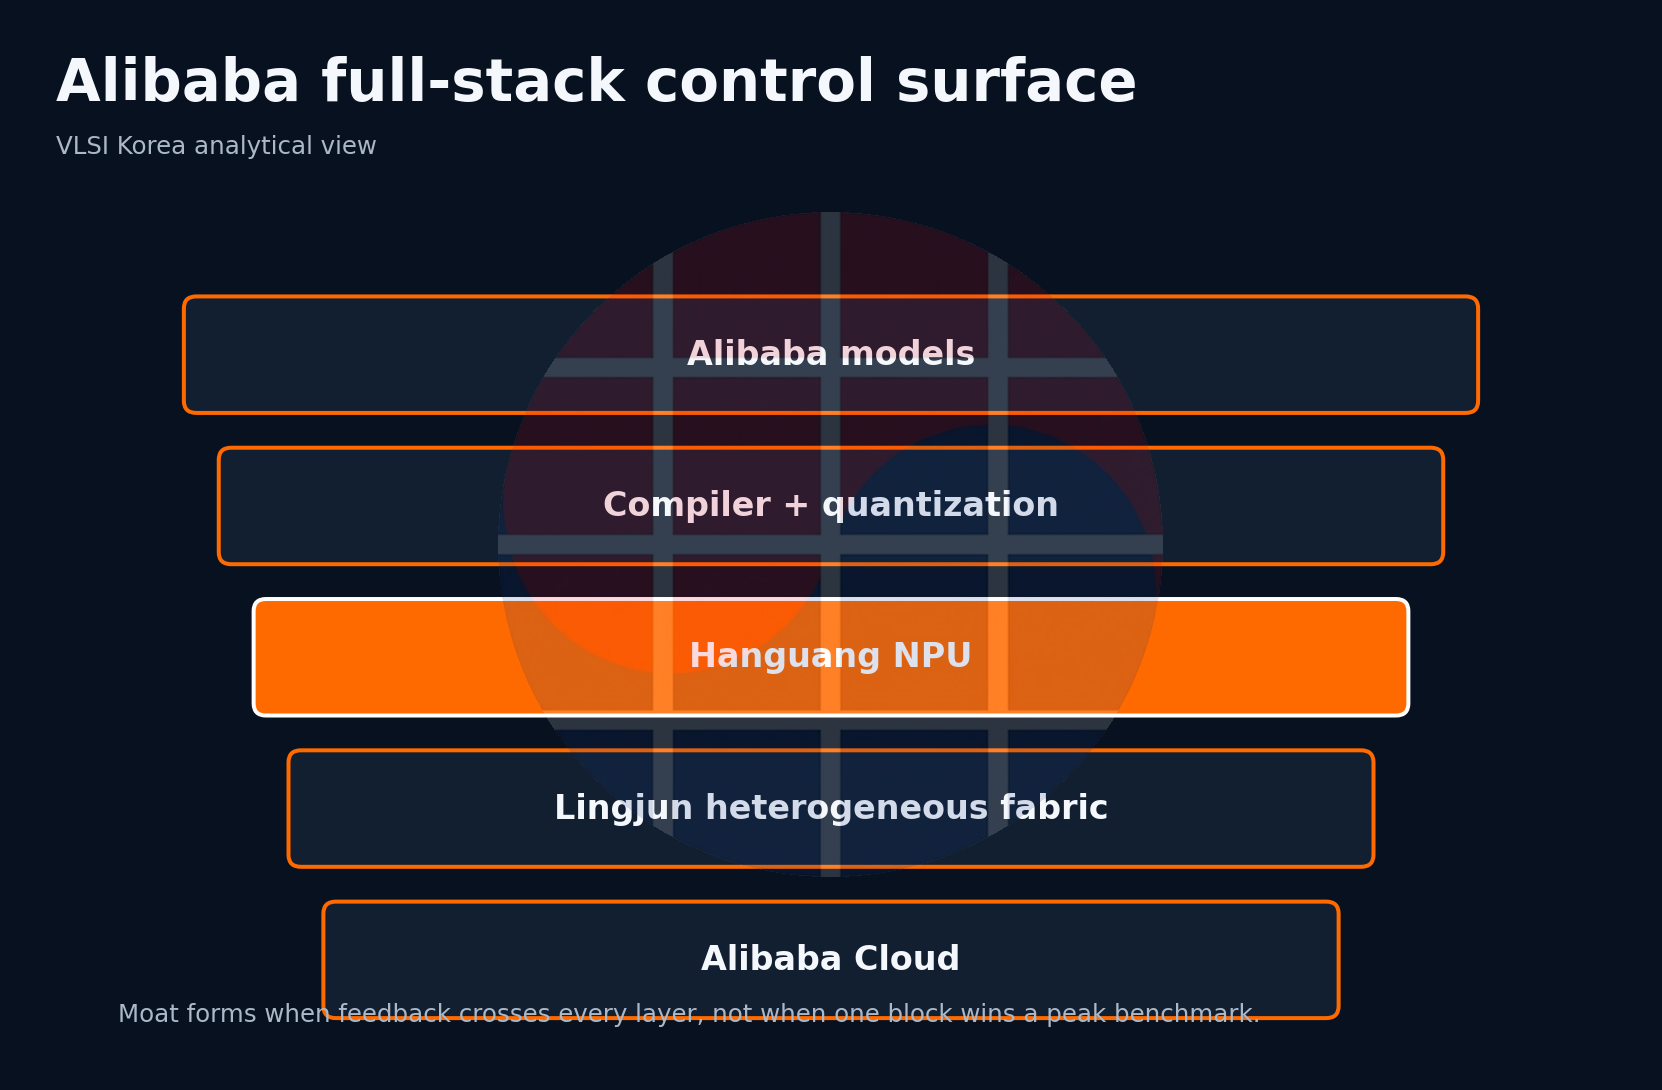
또한 Alibaba는 model, compiler, service와 datacenter를 모두 통제한다. 어떤 operator가 unsupported인지 알 수 있고, 일부 graph를 CPU나 GPU로 fallback하며, 가장 높은 ROI workload부터 옮길 수 있다. 외부 accelerator vendor가 모든 framework와 model을 첫날 지원해야 하는 것과 다른 조건이다.
T-Head의 역할은 이 workload를 silicon으로 고정하는 것이다. Hanguang 800은 universal GPU의 graphics·general-purpose 기능을 줄이고 inference에 필요한 tensor, vector, pooling과 data movement를 중심에 둔다. Hot Chips 공식 발표는 chip이 여러 compute core와 large on-chip memory, dedicated tensor·vector·memory engine을 사용해 data reuse와 operator fusion을 높이는 방향을 설명한다. 상세 block 수와 용량은 논문 revision과 조건을 확인하지 않은 2차 자료 대신 공식 논문을 기준으로 읽어야 한다.
Hanguang 800 architecture: arithmetic보다 data movement
inference accelerator의 성능은 multiply-accumulate 개수만으로 결정되지 않는다. convolution과 matrix multiplication 사이에는 activation, pooling, normalization, layout conversion, quantization과 memory transfer가 있다. 이 연산을 host나 off-chip memory로 왕복하면 tensor engine이 놀게 된다.
Hanguang 800은 large local memory와 operator-specific engine을 chip 내부 fabric으로 연결해 intermediate tensor를 가능한 한 on-chip에 남기는 방향이다. tensor engine은 convolution과 matrix, vector engine은 elementwise와 activation, pooling engine은 reduction과 downsampling, memory engine은 data layout과 transfer를 맡는다. compiler가 graph를 쪼개고 각 engine의 실행을 겹쳐야 peak가 sustained throughput으로 이어진다.
이는 TPU v1의 단순한 systolic array와 같은 문제의식에서 출발하지만 더 heterogeneous하다. TPU v1은 deterministic latency를 위해 큰 matrix unit과 explicit instruction을 사용했다. Hanguang은 다양한 commerce vision graph를 처리하므로 operator mix와 data movement를 더 넓게 고정했다. flexibility를 높일수록 control과 compiler 복잡성은 커지고, 너무 고정하면 model 변화에 취약해진다.
Hanguang의 public benchmark는 ResNet-50 throughput이다. 당시 image workload와 잘 맞지만 현재 LLM의 attention, KV cache, dynamic sequence, MoE routing을 대표하지 않는다. 한 세대의 vision inference 성공을 modern generative AI 능력으로 연장할 수 없는 이유다.
78,563 images/s를 어떻게 읽어야 하나
Alibaba는 Hanguang 800이 ResNet-50에서 78,563 images/s와 500 images/s/W를 기록했고 차순위 업계 solution보다 throughput 4배, energy efficiency 3.3배라고 발표했다. 이 수치는 batch, precision, accuracy threshold, preprocessing, host와 software version에 매우 민감하다. MLPerf와 같이 동일 rule로 재현된 독립 제출이 아니라 vendor 발표이므로 absolute product claim으로 읽어야 한다.
오히려 production case가 더 흥미롭다. Hangzhou City Brain의 video analysis에서 40 GPU를 4 Hanguang으로 바꾸고 latency를 절반으로 줄였다는 사례는 chip뿐 아니라 model compile, video pipeline과 deployment를 함께 최적화했음을 뜻한다. Taobao 10억 image 처리 시간이 1시간에서 5분으로 줄었다는 사례도 batch pipeline의 end-to-end 개선이다.
다만 40 GPU 대 4 ASIC은 세대, 전력, redundancy, model accuracy와 utilization이 같다는 뜻이 아니다. 특정 pipeline을 고정한 ASIC의 장점은 맞지만 모든 inference workload의 10배 density로 일반화하면 안 된다. 올바른 질문은 이 workload가 전체 inference spend에서 얼마나 크고, 이후 model 변화에도 silicon이 계속 사용됐는가다.
Cloud service로의 전환
Alibaba Cloud는 Hanguang을 내부 전용 칩에 머물지 않고 cloud inference service로 제공했다. 공식 자료는 Hanguang 기반 service에서 0.0739 ms의 single-image inference latency를 제시하고 AIACC acceleration stack과 연결한다. Kubernetes scheduling과 resource sharing을 통해 hardware를 service abstraction 아래 숨기는 방식도 설명한다.
고객에게 중요한 것은 instruction set이 아니라 model import, supported operator, latency SLO, autoscaling, billing과 fallback이다. Hanguang이 TensorFlow·PyTorch graph를 모두 native로 빠르게 처리하지 못해도 cloud compiler가 supported subgraph만 offload하고 나머지를 CPU·GPU에서 실행할 수 있다. 이때 실제 성능은 offload ratio와 tensor transfer overhead가 결정한다.
cloud abstraction은 hardware opacity를 장점으로 바꿀 수 있다. Alibaba가 chip generation을 공개하지 않아도 API의 price-performance가 좋아지면 고객은 사용할 수 있다. 반대로 dedicated instance를 선택하거나 capacity plan을 세우는 고객에게는 memory, precision, determinism과 lifecycle 공개 부족이 risk다.
후속 세대 공백의 세 가지 해석
첫 번째 해석은 내부 전용 진화다. 후속 silicon이 존재해도 Alibaba가 외부에 이름과 spec을 공개하지 않았을 수 있다. cloud API가 product boundary라면 chip marketing의 필요가 작다.
두 번째 해석은 workload-specific success 이후 범용성 한계다. Hanguang 800은 CNN inference에 강했지만 Transformer training과 LLM serving은 HBM capacity, high-speed scale-up, low precision과 rapidly changing kernels가 필요하다. 완전히 새 architecture와 software investment가 필요해 기존 lineage를 연장하는 경제성이 낮을 수 있다.
세 번째 해석은 procurement portfolio다. 자체 ASIC 하나에 모든 workload를 맞추기보다 NVIDIA·AMD·국산 GPU·NPU를 Lingjun cluster에서 함께 운영하고 scheduling·network에 차별화를 두는 편이 공급 risk와 model 변화에 유리할 수 있다. 이 경우 merchant silicon 구매력이 약점이 아니라 전략적 flexibility다.
공식 자료만으로 어느 해석이 맞는지 확정할 수 없다. 따라서 Hanguang 2의 성능이 몇 배 같은 서술보다 후속 instance, compiler release, board 인증, customer case와 cluster 구성의 등장 여부를 추적해야 한다.
Lingjun: chip에서 heterogeneous system으로
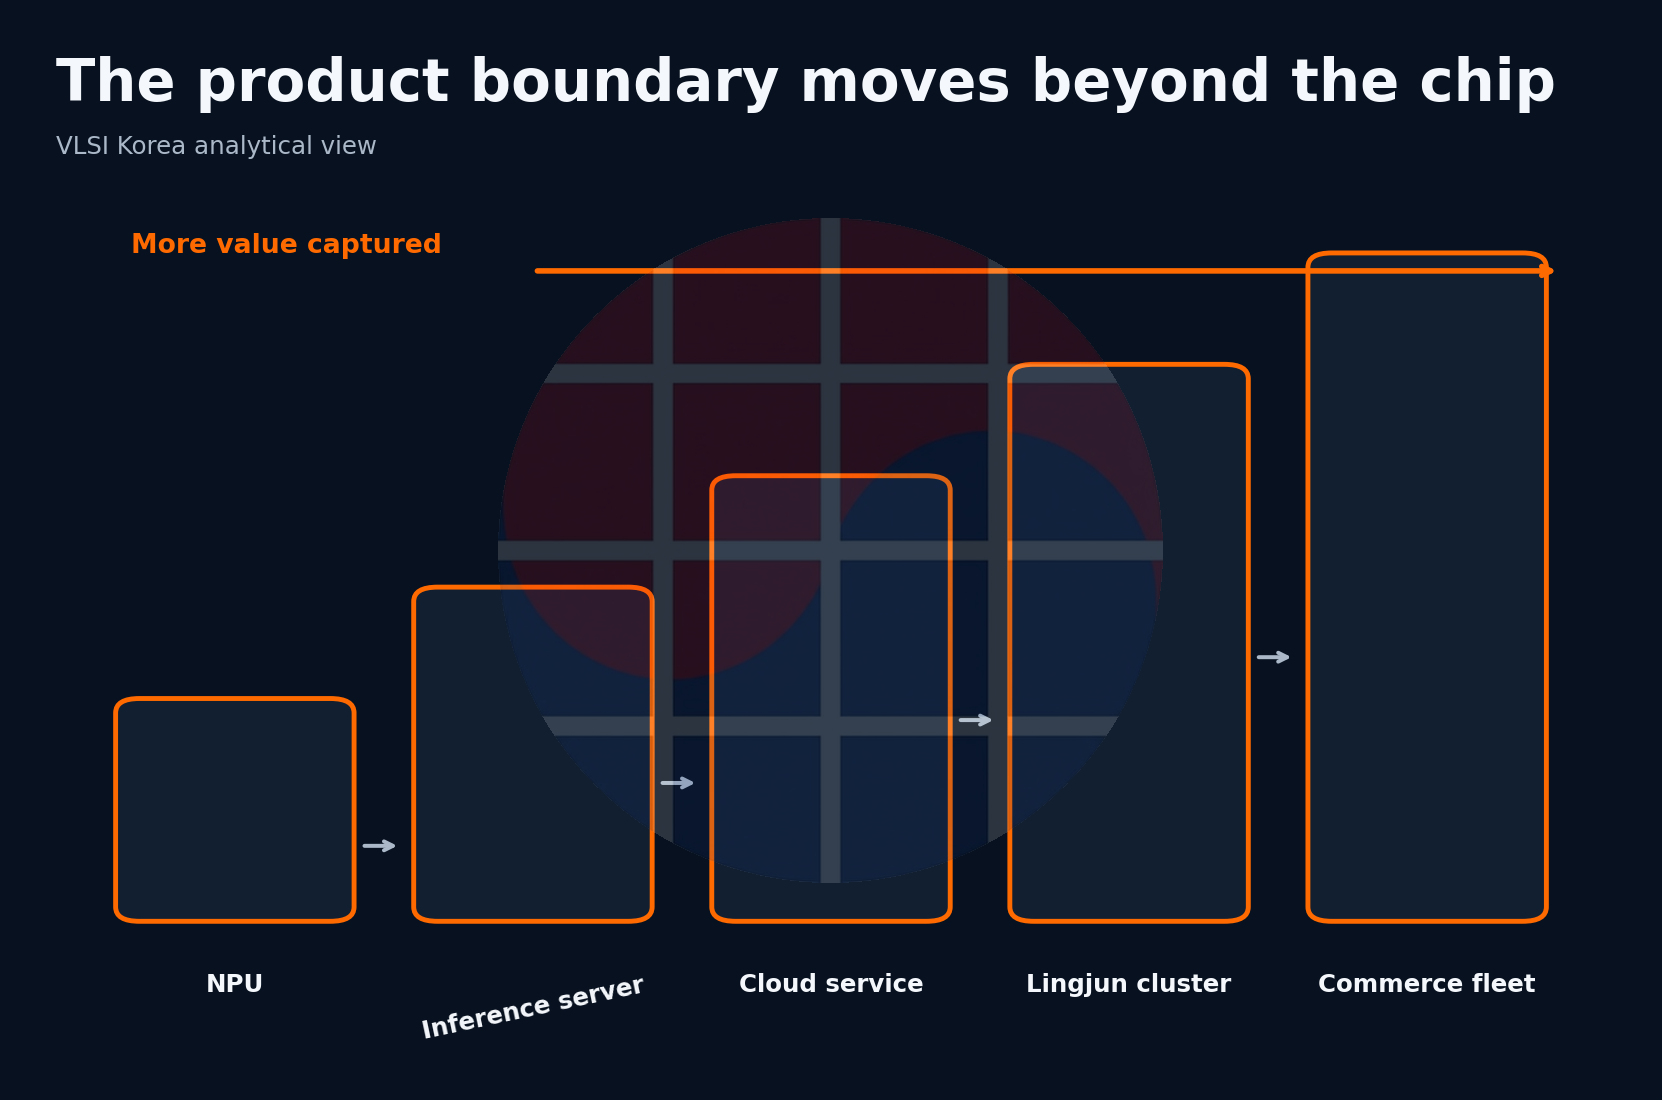
Alibaba Cloud의 Lingjun Intelligent Computing Service는 AI용 compute, high-performance network, storage와 scheduling을 묶는다. 공식 자료는 Lingjun node 간 800G RDMA network와 GPU·accelerator resource를 설명한다. 이는 custom chip이 없어졌다는 뜻이 아니라 AI infrastructure의 product boundary가 cluster로 올라갔다는 뜻이다.
800G network는 theoretical link rate일 뿐 application bandwidth가 아니다. topology, congestion control, collective library, packet loss, storage와 placement가 model scaling을 결정한다. heterogeneous fleet에서는 device별 kernel, memory capacity와 collective 성능이 달라 scheduler가 job을 잘못 배치하면 utilization이 급락한다.
Alibaba의 advantage는 commerce traffic과 cloud fleet을 함께 볼 수 있다는 점이다. stable inference는 Hanguang 같은 ASIC, rapidly changing model은 GPU, domestic availability가 중요한 workload는 다른 NPU에 배치할 수 있다. software layer가 graph와 job을 분리할수록 silicon 선택을 숨길 수 있지만, cross-device portability와 numerical consistency를 유지하는 비용이 커진다.
Technical reality: Hanguang의 moat와 한계
moat는 첫째, enormous captive inference volume이다. 칩이 완벽하지 않아도 내부 workload가 utilization과 feedback을 제공한다. 둘째, T-Head의 chip design과 Alibaba Cloud의 delivery가 한 회사 안에 있다. 셋째, commerce graph의 data locality와 business priority를 함께 최적화할 수 있다.
한계는 첫째, public roadmap 부재다. 고객과 supply chain이 lifecycle을 예측하기 어렵다. 둘째, 공개 benchmark가 2019년 CNN에 집중돼 modern LLM relevance가 불명확하다. 셋째, closed compiler와 service abstraction은 external developer ecosystem을 얕게 만들 수 있다.
Hanguang이 장기 성공인지 판단하려면 wafer shipment보다 offloaded inference share를 봐야 한다. Alibaba 전체 inference compute 중 자체 silicon 비중, supported model mix, token 또는 request당 비용과 세대 교체가 공개돼야 한다. 지금은 1세대 성공은 강하게 입증되지만 지속적 lineage는 입증되지 않았다.
Watch points
- Hanguang 후속 chip의 official name, process, memory와 supported precision이 공개되는가.
- Alibaba Cloud가 LLM serving에서 자체 silicon instance를 명시하는가.
- Hanguang compiler가 attention, KV cache, MoE와 low-precision format을 지원하는가.
- Lingjun의 800G RDMA가 model-level effective bandwidth와 job completion time으로 검증되는가.
- 자체 silicon, imported GPU와 domestic accelerator 사이의 workload placement가 고객에게 얼마나 투명한가.
Contrarian read: 후속 칩을 공개하지 않는 것이 합리적일 수 있다
반도체 회사라면 세대 roadmap 공개가 판매에 필요하지만 cloud operator는 API 결과만 좋으면 된다. architecture를 공개하면 competitor에게 workload priority와 cost structure를 보여주고 고객은 아직 안정화되지 않은 roadmap을 확정 약속으로 받아들일 수 있다. Alibaba가 내부에서 조용히 silicon을 반복하면서 service layer만 판매하는 전략은 충분히 합리적이다.
반대 가능성도 같다. public silence가 기술적 stealth가 아니라 후속 project의 낮은 scale을 가리는 것일 수 있다. Hanguang 800의 impressive launch가 one-off optimization이었다면 생성형 AI의 급변하는 workload에서 custom silicon investment를 회수하지 못했을 수 있다. 이 둘을 구분하는 유일한 방법은 새로운 production instance와 반복된 deployment evidence다.
Korean lens
한국 cloud·commerce 회사가 자체 NPU를 검토할 때 Hanguang의 lesson은 명확하다. 첫 제품은 가장 큰 stable inference workload에 고정하고, external general-purpose market을 처음부터 노리지 않는 편이 adoption risk를 낮춘다. image, ranking, speech처럼 volume과 operator가 충분히 고정된 영역에서 compiler와 service까지 한 팀으로 책임져야 한다.
동시에 single-generation publicity trap을 피해야 한다. 첫 chip의 benchmark보다 후속 tape-out cadence, software backward compatibility와 deployed workload share를 KPI로 둬야 한다. 자체 칩이 전략이라면 2세대부터 진짜 economics가 드러난다.
Sources
- Alibaba Cloud Apsara Conference 2019 and Hanguang 800 launch
- Hanguang 800 Hot Chips paper
- Alibaba Cloud Hanguang inference service
- Alibaba Cloud Lingjun concepts
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.